对比JVS-Rules界面化拖拽+函数计算器与Drools需Java编码+DRL部署的技术路径,分析业务人员能否独立完成规则配置、测试与上线的实操差异,聚焦贷前筛查等场景下分钟级迭代与技术闭环的成本本质。
业务人员零编码配置:不是'能看懂',而是'能交付'
在风控系统落地中,'业务人员能否零编码上手'不是体验性指标,而是可量化的交付能力分水岭。它要求业务角色能独立完成规则新增、条件调整、在线测试、灰度发布与日志验证全流程------不依赖Java语法、Maven构建、DRL文件编写或KIE容器重启等技术动作。
高频变更场景(如季度贷前政策收紧)下,协作链路越长,信息衰减越严重:需求→开发→测试→运维的串行流程常耗时数小时;而界面化配置将操作收敛至单次点击+公式编辑+实时预览,响应压缩至3--5分钟内。
这一差异本质是'业务意图到系统判断'的信息保真度问题:技术门槛越高,策略失真风险越大。
JVS-Rules:面向业务交付的三层技术实现
JVS-Rules通过决策编排、规则表达、函数计算三层次解耦,提供可工程化落地的业务自助能力:
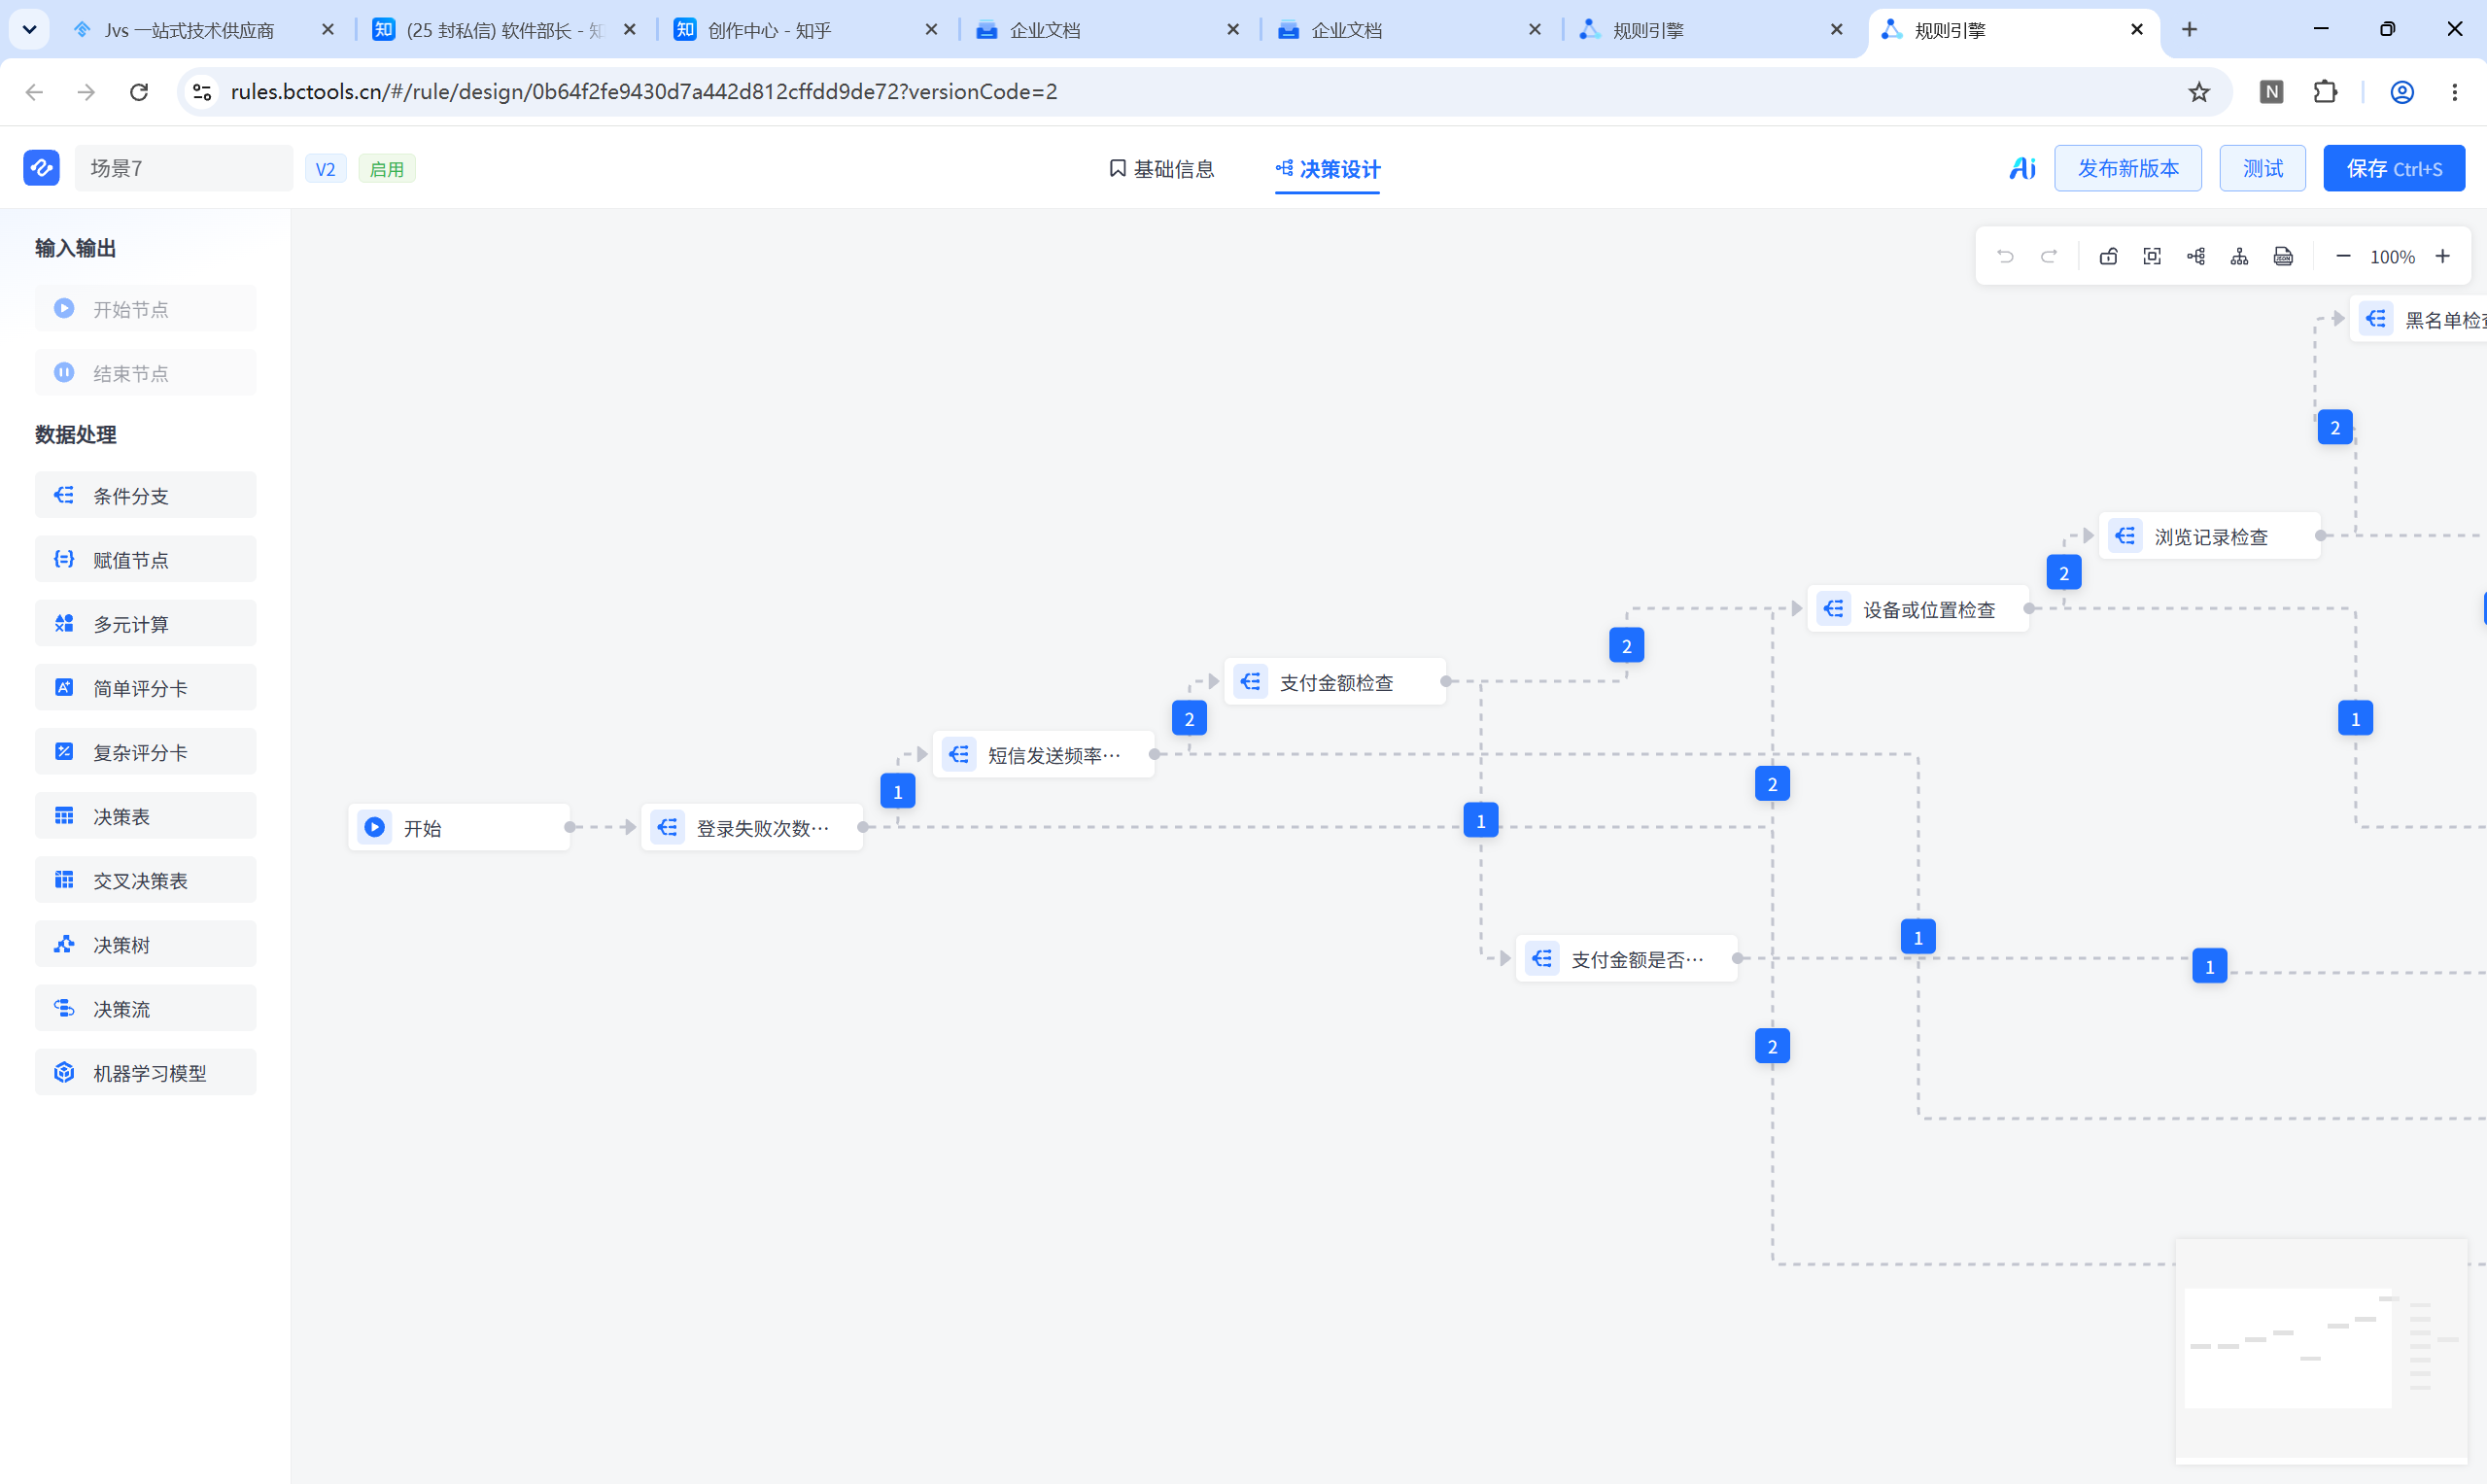
- 决策编排层 :采用Vue+Draggable实现可视化流程图编辑,支持条件分支、评分卡节点、模型调用等组件拖拽组装;业务人员定义策略拓扑,技术人员仅需绑定变量(如
user.creditScore)与数据源(MySQL/API/Excel),实现逻辑与执行分离;
- 规则表达层:内置决策表(支持多条件组合覆盖)、决策树(节点可导出为JSON Schema)、评分卡(权重+阈值可视化配置),替代硬编码if-else,输出结构化规则DSL供运行时解析;
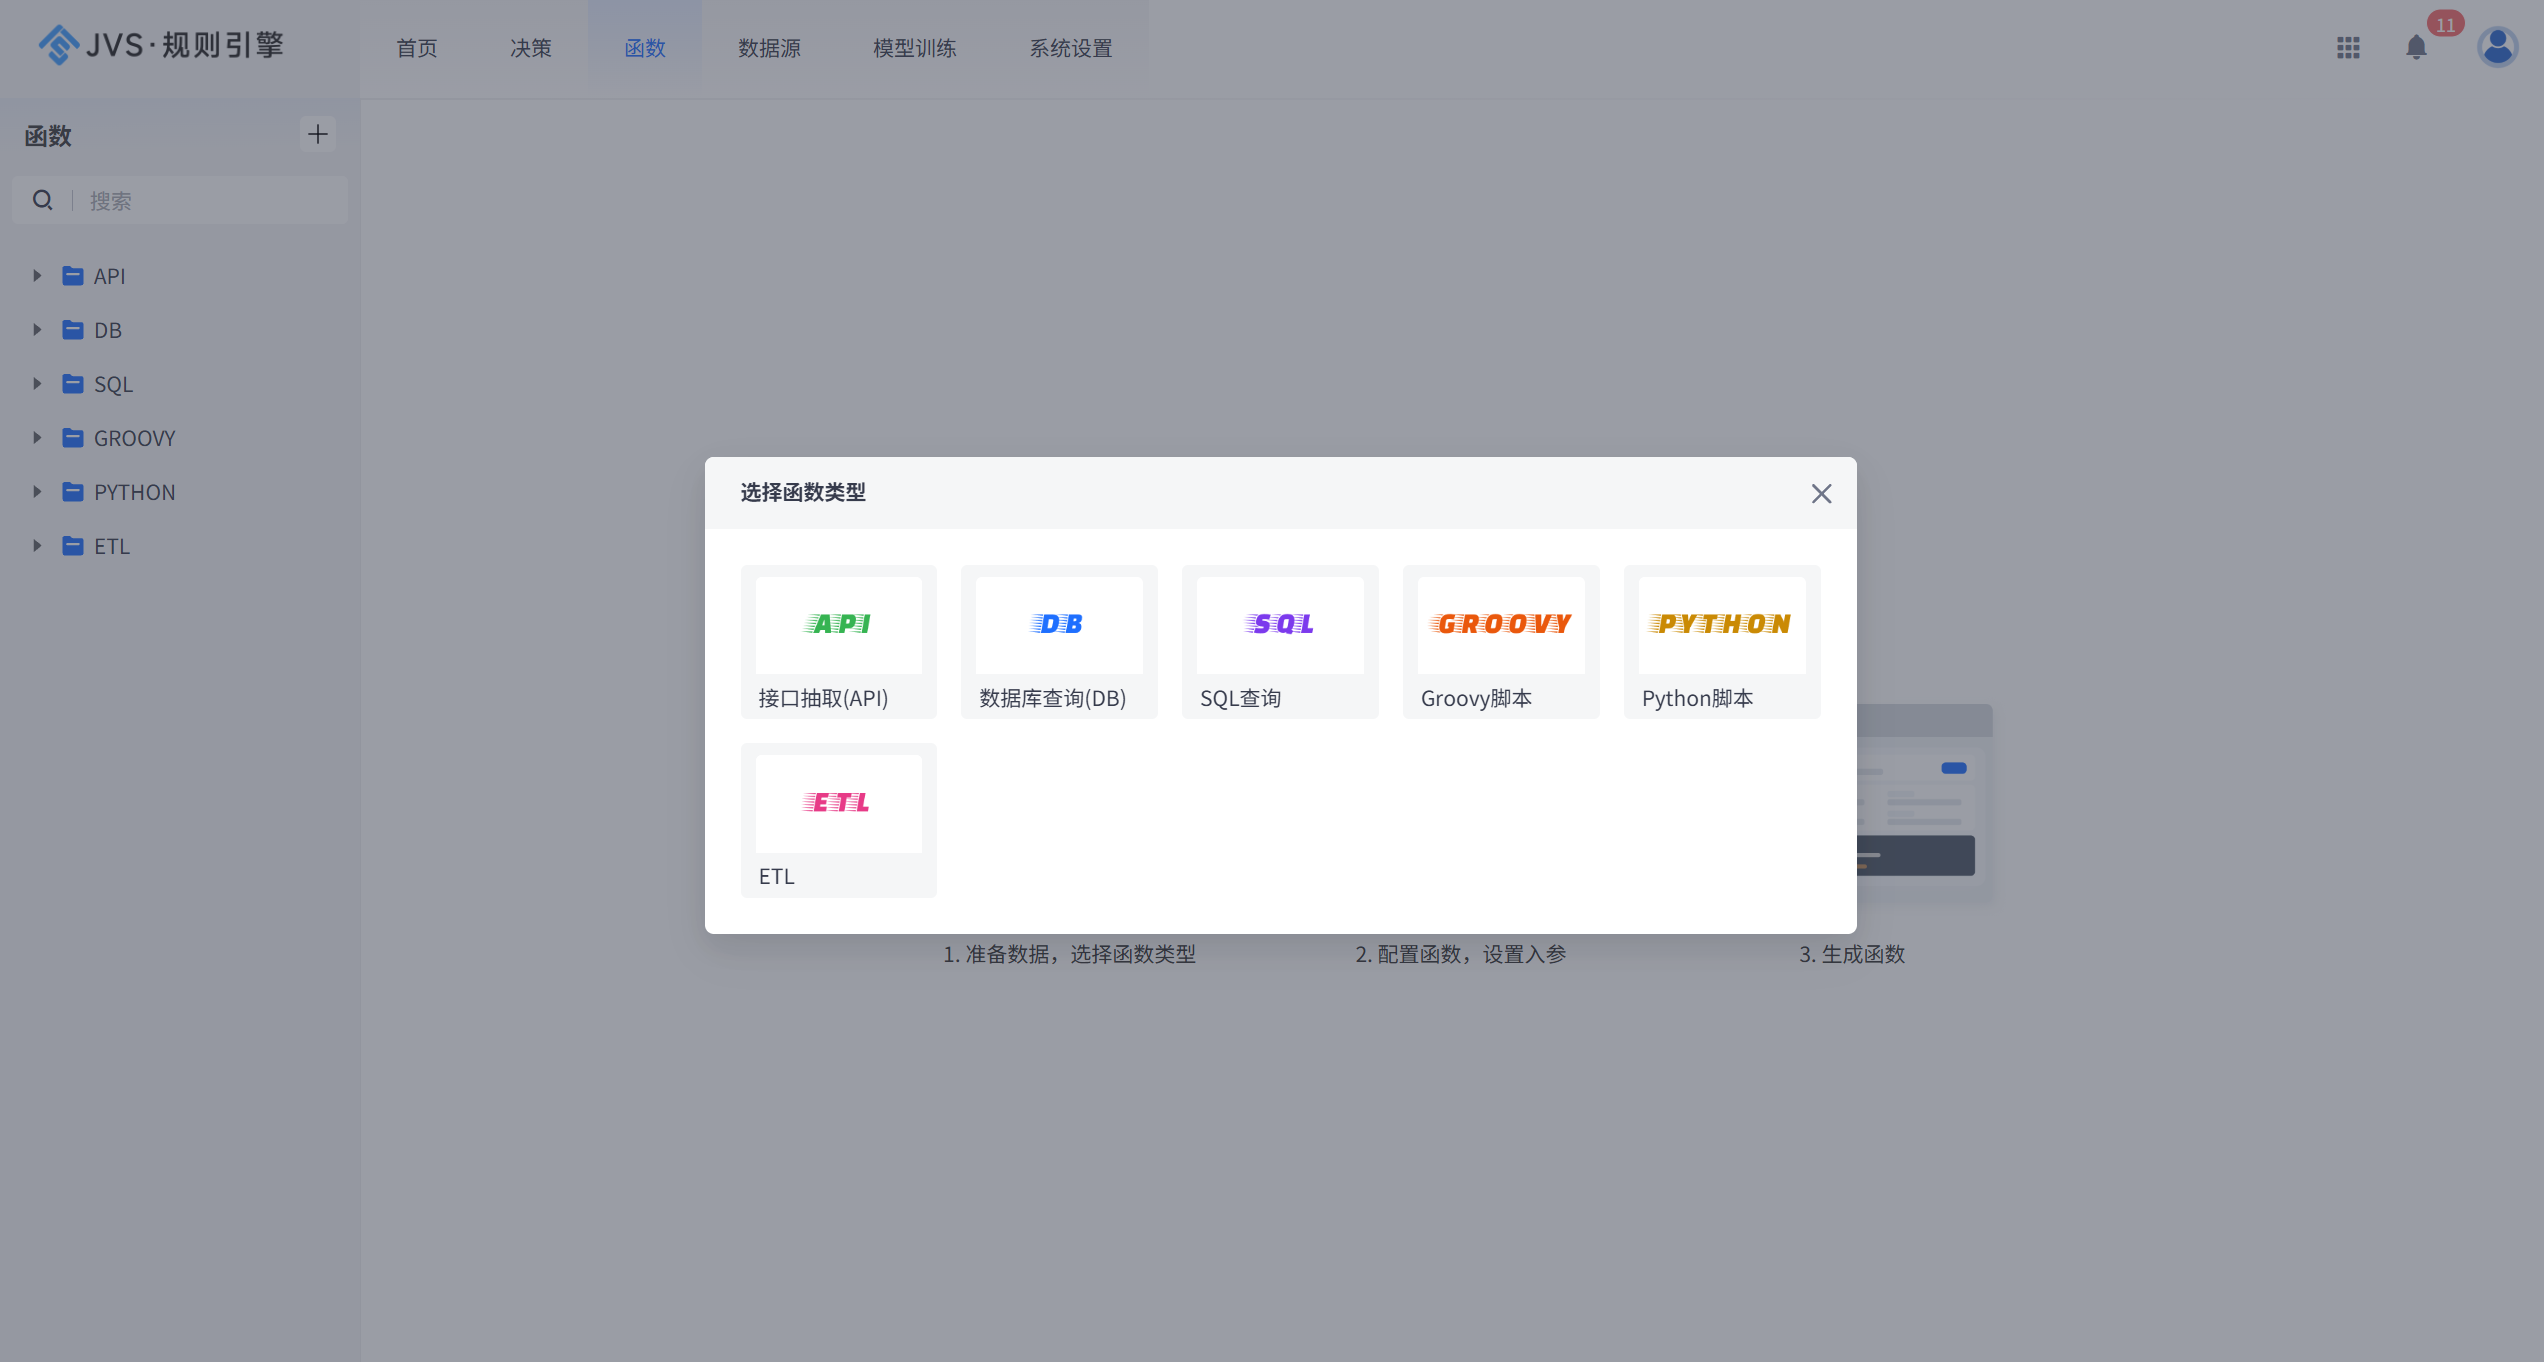
- 函数计算器层 :类Excel语法引擎(如
=DIVIDE(SUM(overdueCount), 12)),支持聚合、多源拼接、嵌套调用;底层基于ANTLR4构建语法树,经AST转换后生成Java字节码动态执行,避免脚本解释器性能瓶颈;
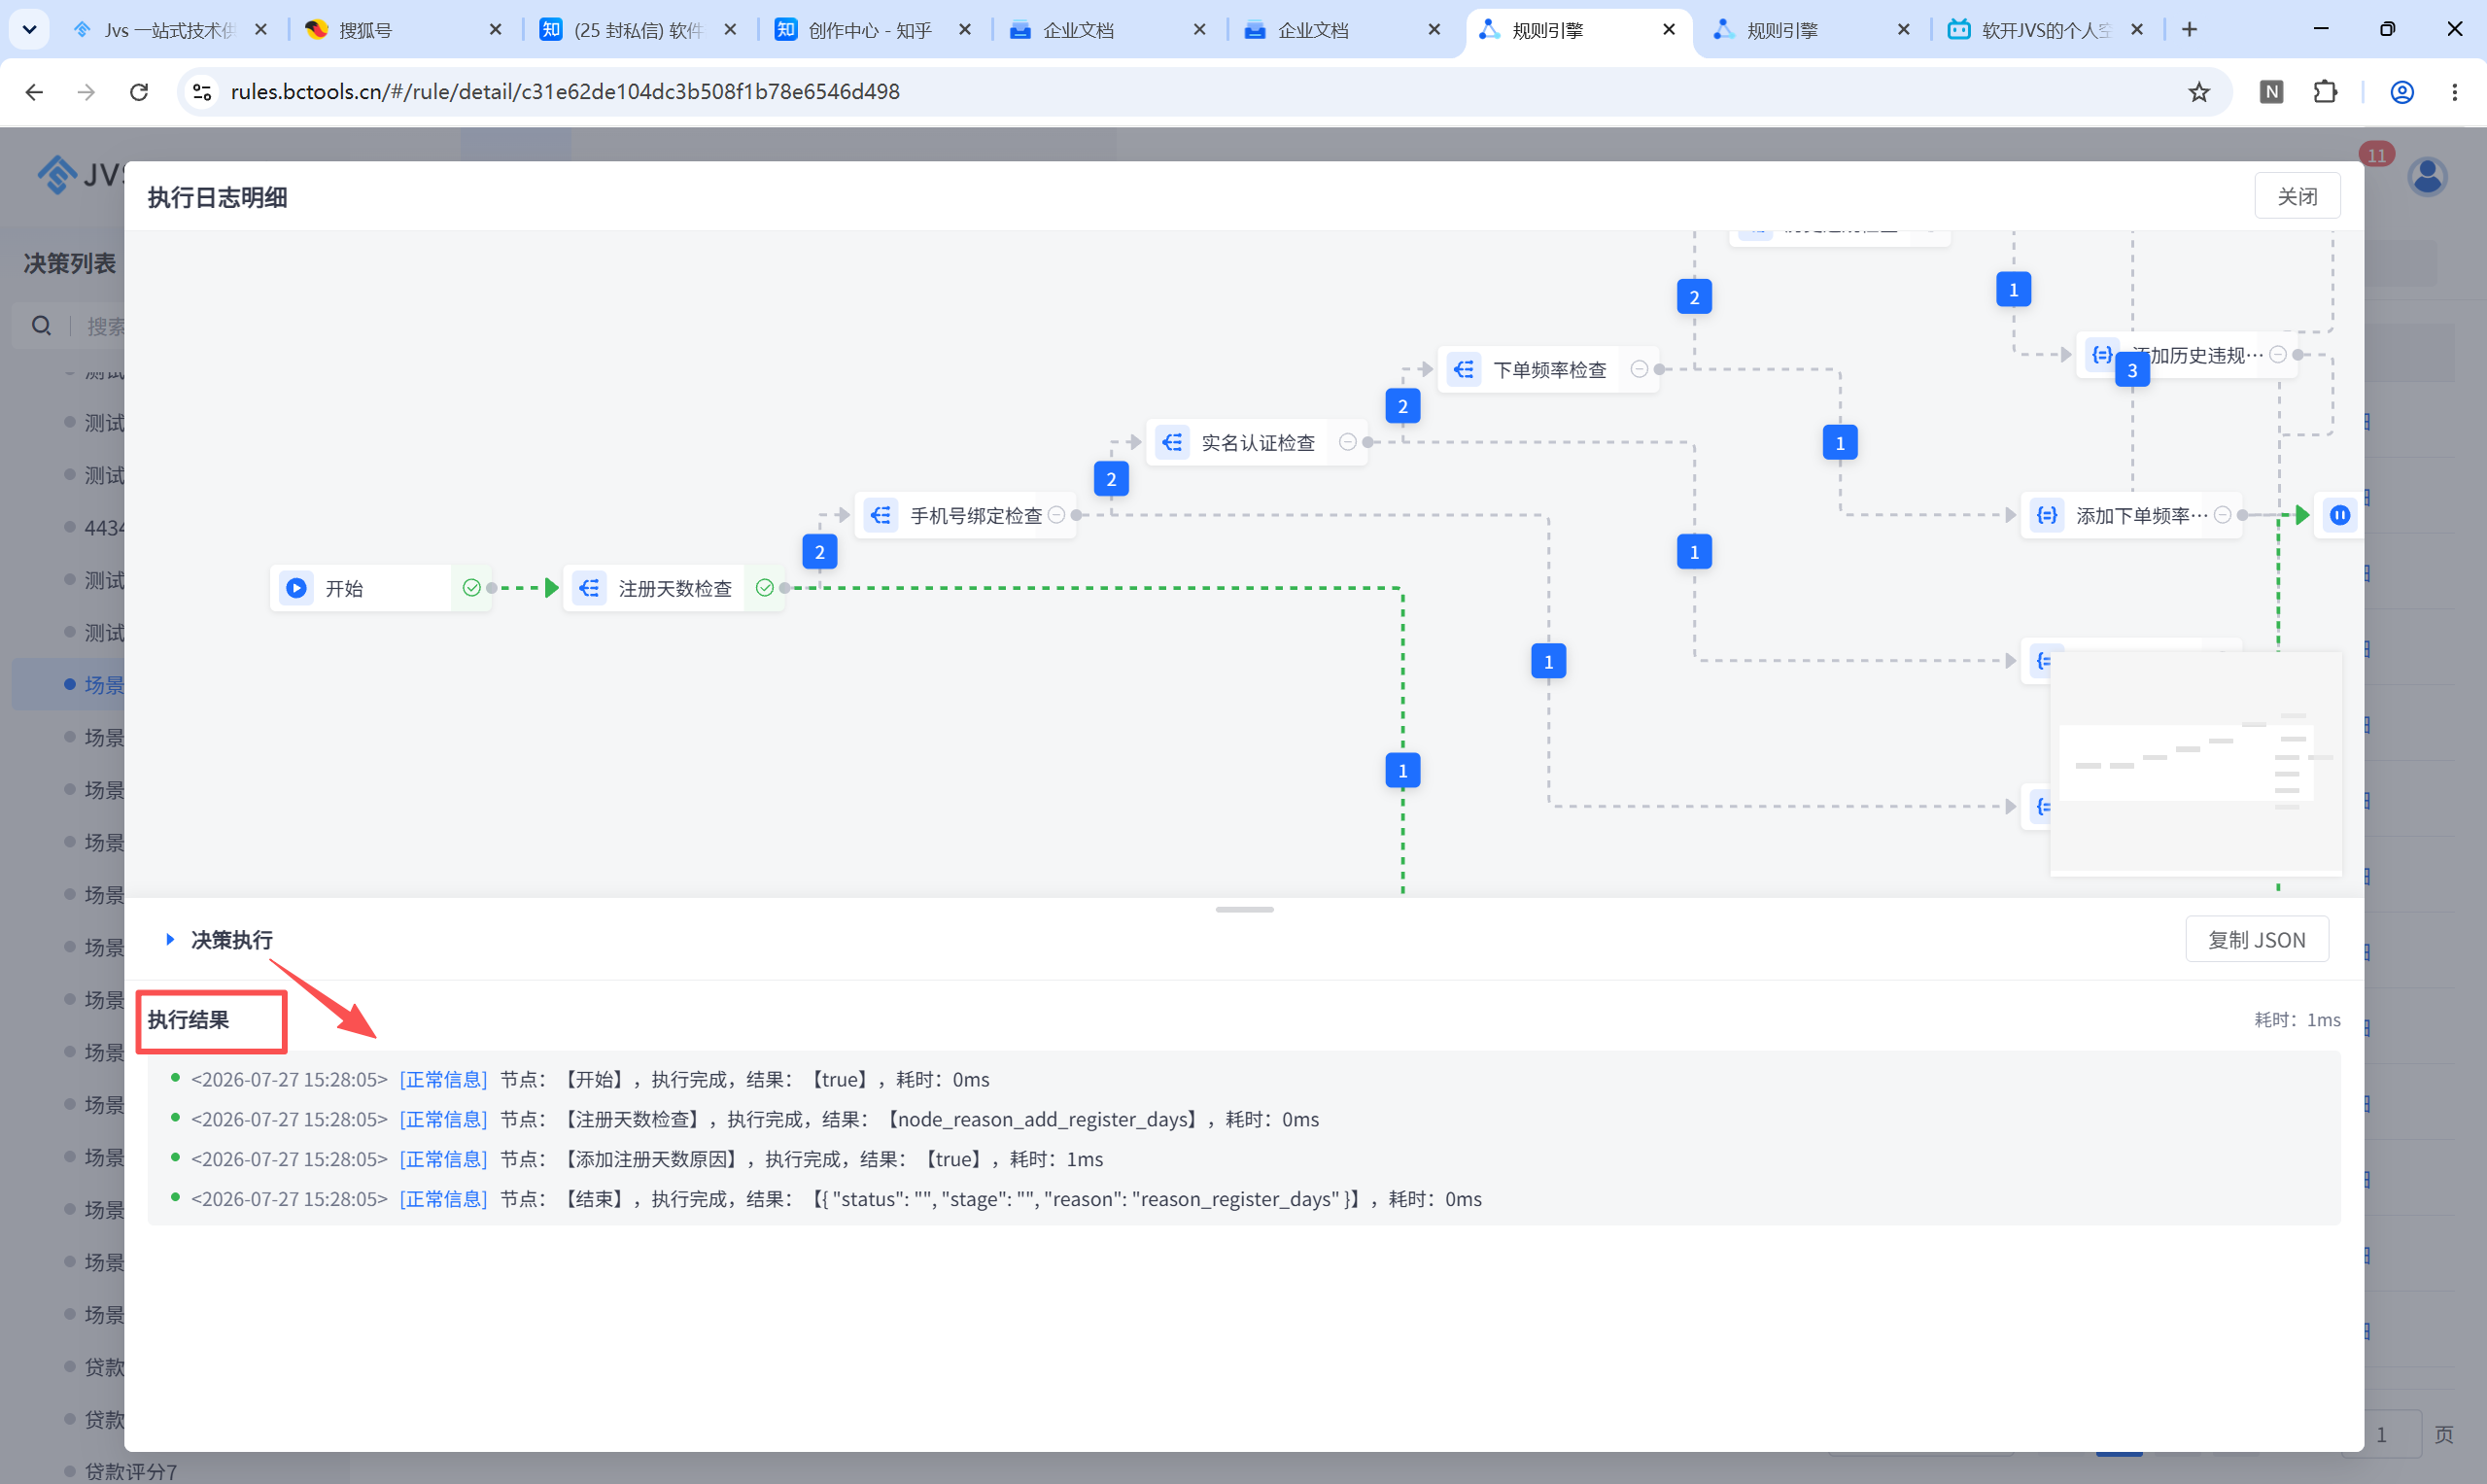
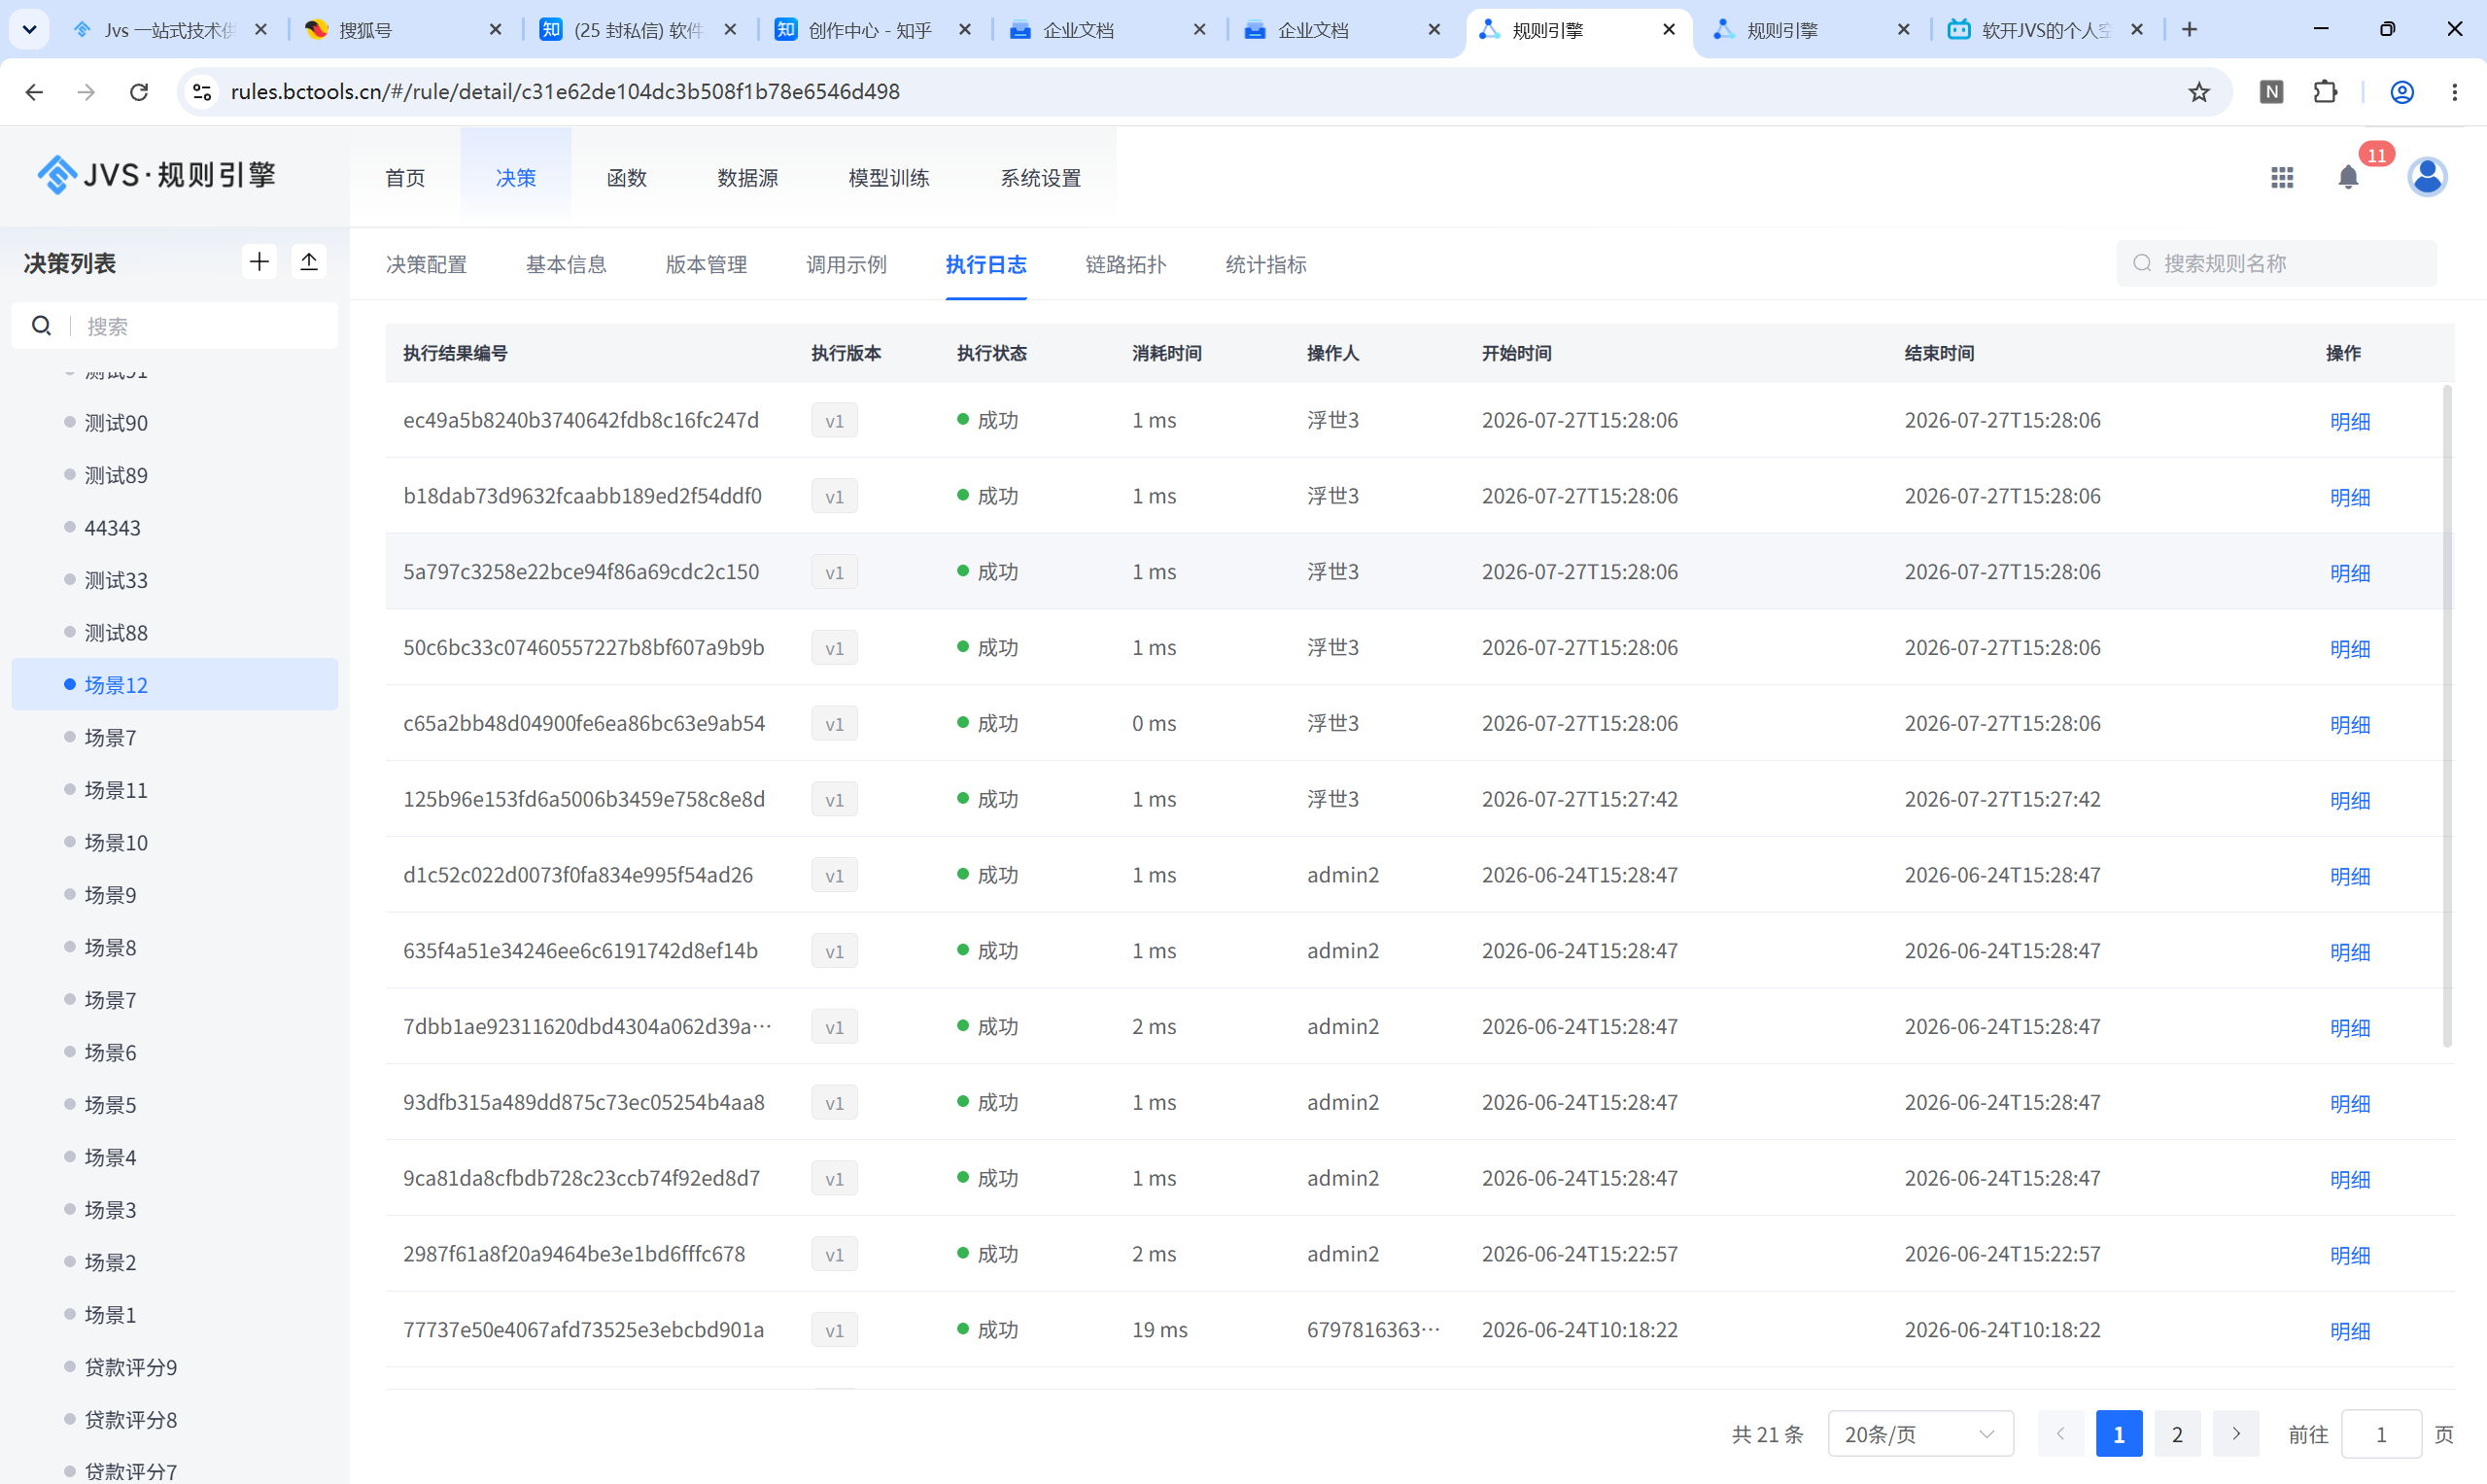
配合全链路可观测能力:每个节点记录入参快照、出参结果、执行耗时(ms级)、异常堆栈,日志可按traceId关联追溯,形成'配置→加工→判断→验证→留痕'闭环。
Drools:强执行力背后的业务交付断点
Drools 7.x+虽具备成熟的Rete算法与Java生态集成能力,但其设计范式天然面向开发者:
-
规则必须以DRL文件编写,依赖Java POJO建模(如
rule "HighRiskLoan" when $u: User(creditScore < 600) ...),无法脱离IDE与编译环境; -
每次变更需完整走通:修改
.drl→mvn compile→kie-maven-plugin打包KJAR → KIE Server部署 → REST API触发服务重启 → 手动回归测试;无热更新机制,平均耗时≥25分钟; -
缺失开箱即用的企业级能力:细粒度权限控制(如仅允许业务组修改'准入规则表')、节点级执行日志(Drools默认仅输出
fireAllRules()总耗时)、多源数据连接器(需自研DataSourceProvider扩展)均需二次开发;
这意味着:当业务提出'将黑名单字段blacklist_flag加入准入判断'时,实际仍需开发介入建模、写DRL、联调API------技术可用 ≠ 业务可用。
{{narrivo-image-slot:c69368350bbade8f7ab6047505e215bd}}
四步技术选型法:从协同效率出发
选型不应比参数,而应验证业务IT能否真正协同交付。建议按以下步骤实证评估:
{{narrivo-image-slot:a37ef2cdc2f96173bc405ba4730e82e1}}
-
统计规则变更频率与角色意愿:若月均调整>5次,且业务方明确拒绝'每次提Jira',则JVS-Rules类低代码路径更适配;
-
评估技术栈承载能力:已有成熟Java团队且存在超复杂推理需求(如嵌入Prolog规则链)时,可保留Drools为执行内核,但必须同步建设可视化配置层(如基于Kie Workbench定制前端);
-
验证合规性可观测需求 :金融/银行等强审计场景需节点级入参出参、毫秒级耗时、异常堆栈,JVS-Rules原生支持;Drools需重写
AgendaEventListener并持久化Match对象,开发成本高; -
实测典型场景端到端闭环 :选取贷前准入场景,用同一组客户数据(含
income、overdueMonths、blacklistFlag字段),分别在JVS-Rules和Drools中完成:-
配置规则(业务人员独立操作)
-
在线调试(输入JSON样本,查看逐节点输出)
-
发布REST接口(
POST /api/v1/rule/execute) -
调用并回溯完整执行链路日志 对比两者业务人员操作耗时与结果可解释性差异。
-