还在每个项目里复制粘贴接口日志切面?我把它做成了零配置的 Spring Boot Starter
前置链采集 → 限流 → 后置链统计,AOP 只 proceed 一次;本地/Redis 两种限流、令牌桶/滑动窗口两种算法、SpEL 按参数限流、钉钉/企微/飞书告警、Micrometer 指标桥接------引入一个依赖,什么都不配就生效。
一、从一个大家都写过的类说起
先看一段你大概率写过的代码:
java
@Aspect
@Component
public class ApiLogAspect {
    @Around("execution(* com.example..controller..*(..))")
    public Object around(ProceedingJoinPoint pjp) throws Throwable {
        long start = System.currentTimeMillis();
        try {
            Object result = pjp.proceed();
            log.info("[API] {} 耗时 {}ms", pjp.getSignature(), System.currentTimeMillis() - start);
            return result;
        } catch (Throwable e) {
            log.error("[API] {} 失败", pjp.getSignature(), e);
            throw e;
        }
    }
}
每个项目都有一份,长得还不太一样:有的统计了耗时没统计成功率,有的日志打了但接口一多没法看,想限流的时候再加一个切面、想上报 Prometheus 再加一个------切面越叠越多,pjp.proceed() 被调了四五次,出了问题没人说得清执行顺序。
我更烦的是另一件事:换一家公司,这套东西要从零再写一遍。
所以我把这几年重复写的部分抽成了一个 Starter:api-governance-spring-boot-starter。这篇文章先给你 30 秒能跑起来的效果,然后重点讲它背后的设计取舍------尤其是分布式限流里那些文档不告诉你的坑。
二、30 秒上手:什么都不配就生效
引入依赖:
xml
<dependency>
    <groupId>io.github.biglv666</groupId>
    <artifactId>api-governance-spring-boot-starter</artifactId>
    <version>0.5.0</version>
</dependency>
然后写一个普通的 Controller,不加任何注解、不改任何代码:
java
@RestController
@RequestMapping("/api/users")
public class UserController {

    @GetMapping("/{id}")
    public User get(@PathVariable Long id) {
        return userService.findById(id);
    }
}
每个请求会自动输出:
bash
[API] GET /api/users/{id} - com.x.UserController#get - 成功 - 耗时: 12ms同时管理接口 GET /api-governance/metrics 已经能查到这个接口的调用次数、成功率、慢方法明细。想要限流、关闭某接口日志,也只加三个注解:
java
@RateLimit(limit = 100)                 // 类级默认限流
@RateLimit(limit = 5, window = 60, key = "#request.username")  // 按参数独立配额
@NoLog                                  // 关日志,统计仍保留
@Skip                                   // 完全放行(健康检查之类)
到这里是"能用"。下面是这篇文章真正想聊的:它内部是怎么设计的,以及分布式限流这个看似简单的功能里藏了多少坑。
三、核心设计:切面只做一次,其余全是管道
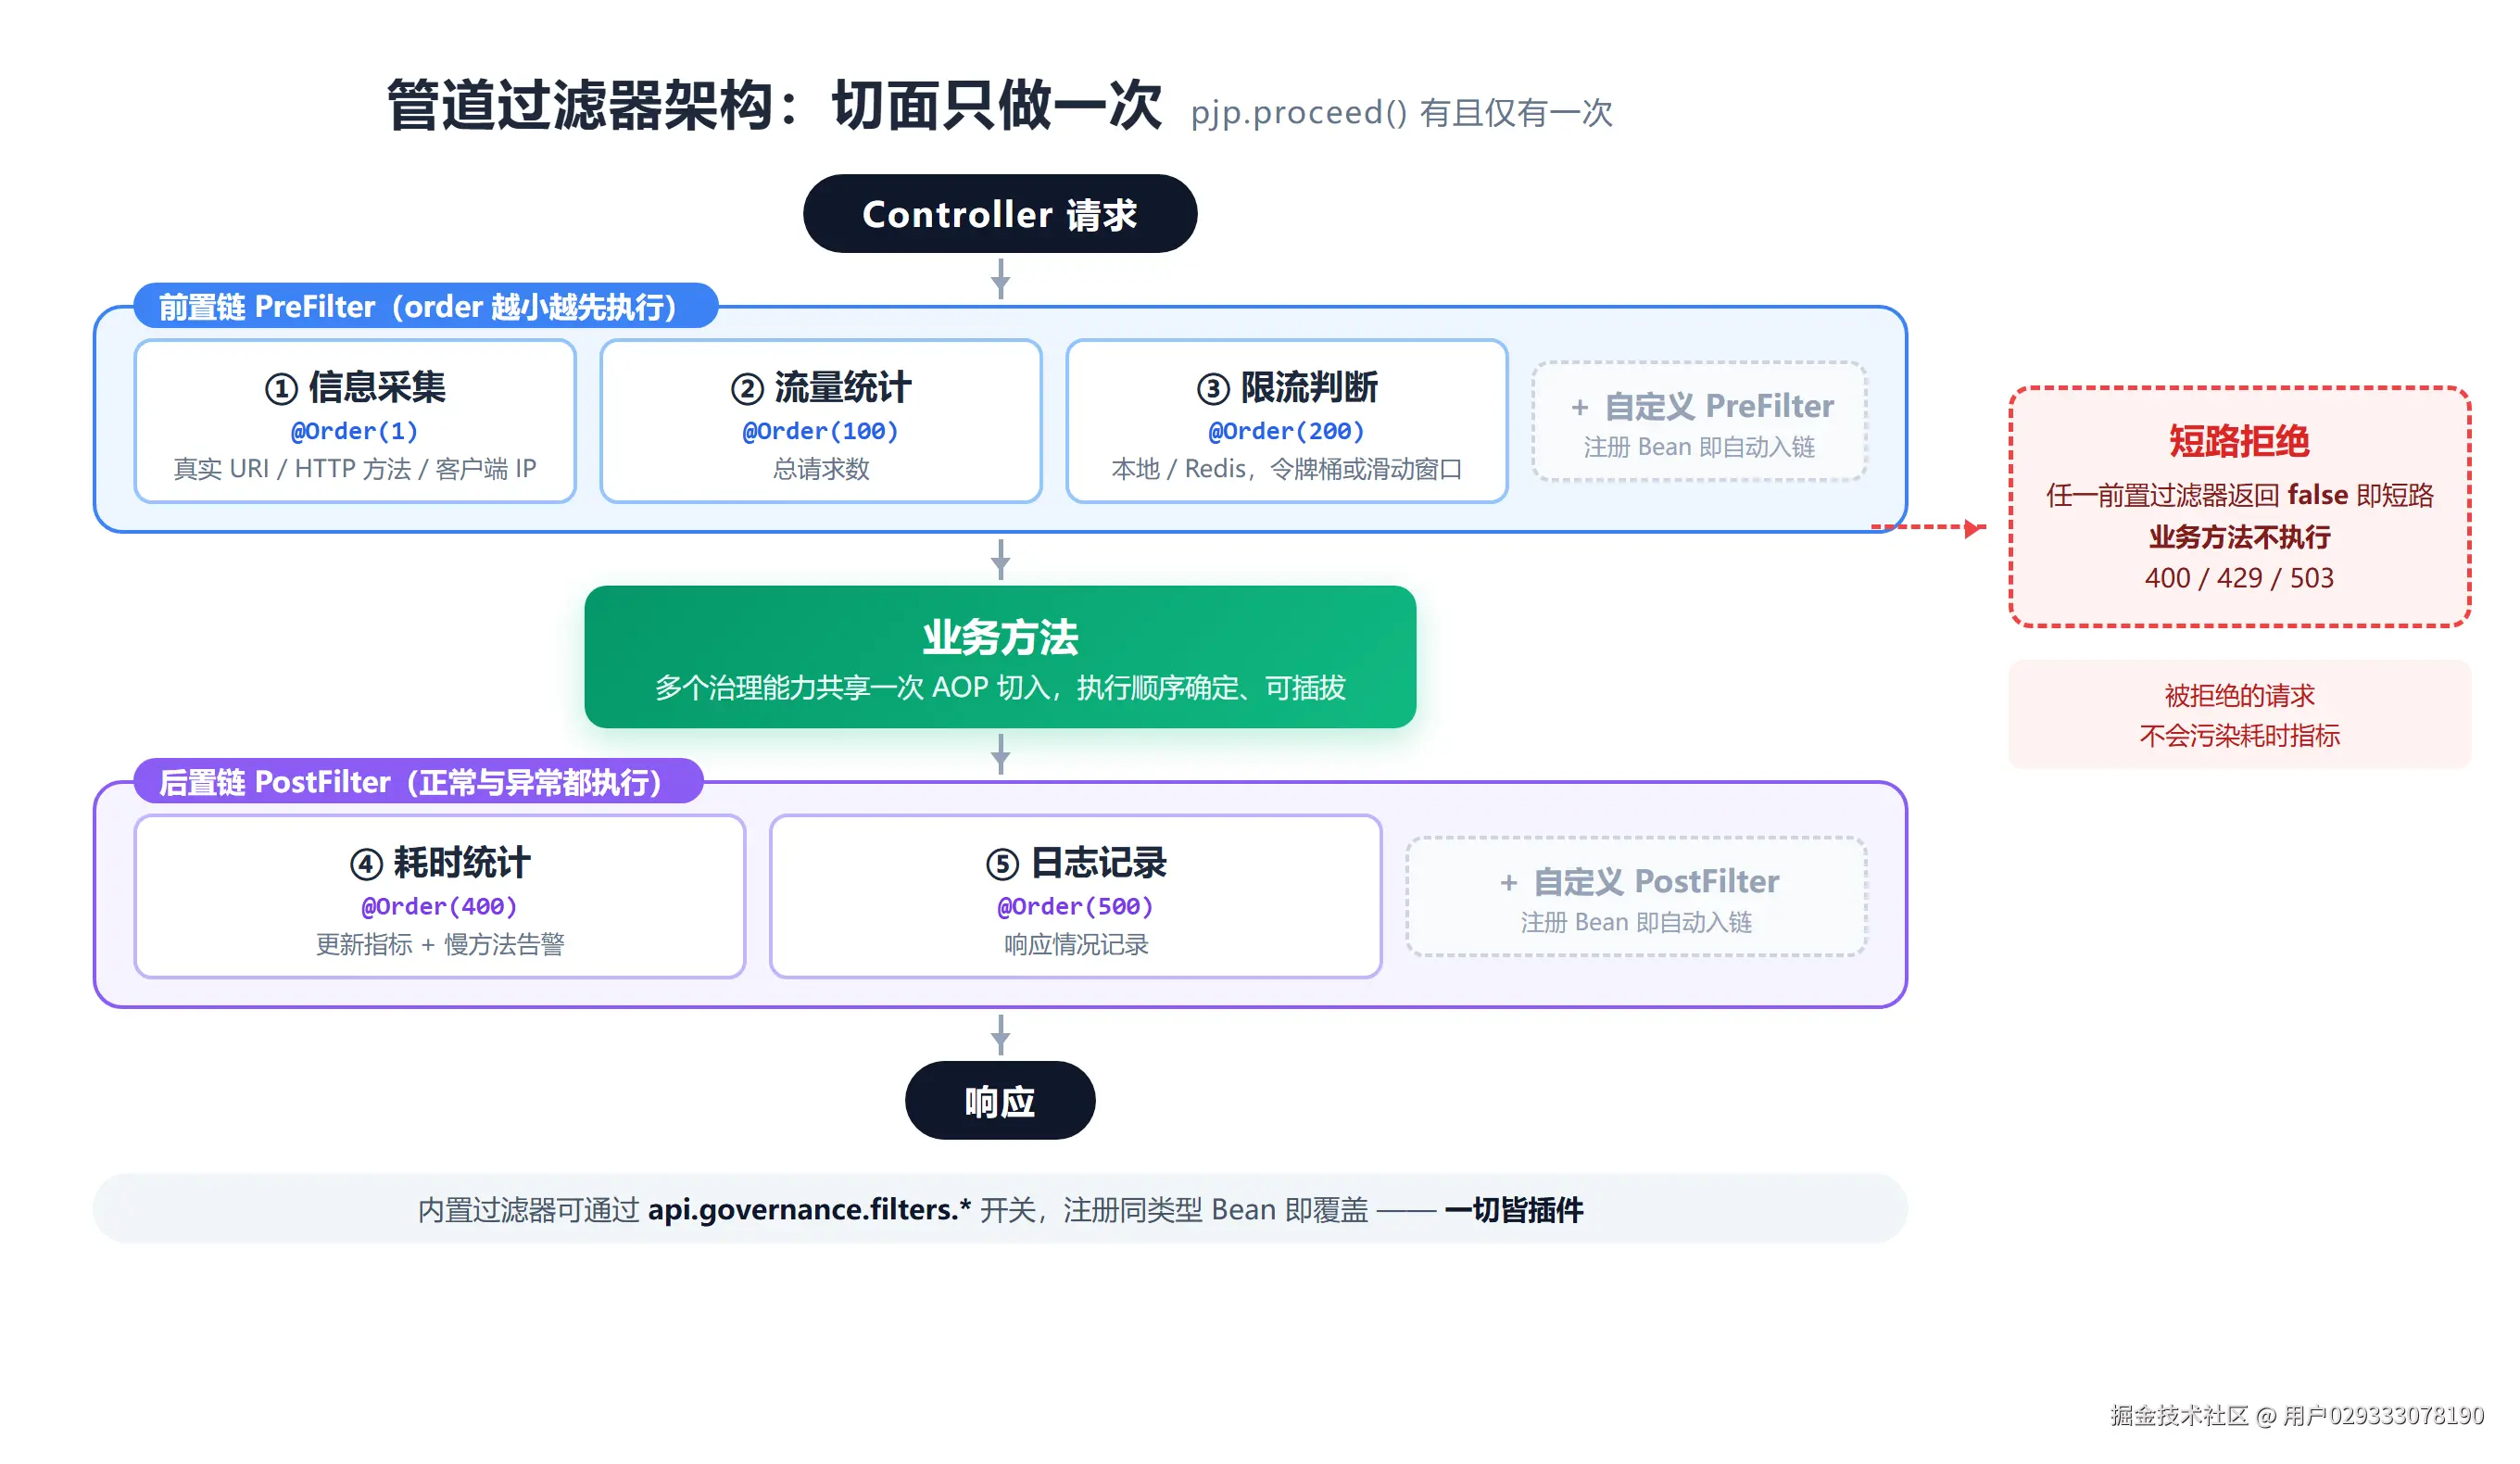
多数"日志切面 + 限流切面 + 指标切面"的方案,本质是多个 AOP 切面叠在同一个方法上,执行顺序靠 @Order 猜。这个 Starter 的做法是只有一个切面,切面内部把一次请求的完整生命周期拆成两条过滤器链:
scss
前置链:信息采集(1) → 流量统计(100) → 限流判断(200) → 自定义
                              ↓ 任一过滤器返回 false 即短路,业务方法不执行
业务方法(pjp.proceed() 有且仅有一次)
                              ↓
后置链:耗时统计(400) → 日志记录(500) → 自定义
这样带来三个直接好处:
- 语义清晰:限流发生在统计之前,被拒绝的请求不会污染耗时指标(Micrometer Timer 只记真正执行的请求);
- 可插拔 :实现一个
PreFilter/PostFilterBean 就自动进管道,@Order排序,返回false即短路拒绝(可以自定义 400/429/503):
java
@Component
@Order(300)
public class ParamCheckFilter implements PreFilter {
    @Override
    public boolean doFilter(FilterContext ctx) {
        if (ctx.getArgs() == null || ctx.getArgs().length == 0) {
            ctx.setRejectStatus(400);
            ctx.setRejectReason("参数缺失");
            return false;
        }
        return true;
    }
}- 内置过滤器可关可换 :5 个内置过滤器都能通过
api.governance.filters.*开关,注册同类型 Bean 即覆盖,不用改源码。
自定义过滤器还能直接拿到真实请求上下文:getRequestUri()(路径变量实际值)、getClientIp()(X-Forwarded-For → X-Real-IP → remoteAddr),不用自己去解 RequestContextHolder。
四、分布式限流:三个文档不会告诉你的坑
本地限流没什么好讲的,ConcurrentHashMap + 惰性过期就够。有意思的是 Redis 分布式限流,我踩了三个坑。
坑一:窗口判定不能用客户端时间
滑动窗口最直觉的实现:Lua 脚本里用 ARGV 传入应用服务器的时间戳,ZREMRANGEBYSCORE 清理窗口外的 member,再 ZCARD 计数。
问题在于多实例时钟漂移:A 机器快 200ms,B 机器慢 200ms,同一时刻两台机器对"当前时间"的判断差了 400ms,窗口边界上的计数就不准了------而分布式限流恰恰是为了多实例一致才存在的,用客户端时间等于自废武功。
正确做法是在 Lua 脚本里用 TIME 命令取 Redis 服务器时间 ,窗口判定和令牌补充都基于它。但 TIME 是非确定性命令,Redis 4.x 及之前的逐字复制模式下,主从复制的是整段脚本而不是效果,从库重放时会产生不同的结果。
所以脚本开头必须显式调用:
lua
redis.replicate_commands()  -- 切换为效果复制,Redis 3.2~4.x 可用
local t = redis.call('TIME')
local now = t[1] + t[2] / 1000000
Redis 5+ 默认就是效果复制,这个调用幂等无害。这一行,很多 Redisson 之外的手写限流实现都漏了。
坑二:同毫秒并发,ZSET 的 member 会互相覆盖
滑动窗口用 Sorted Set 计数时,member 得保证唯一。我最开始用「毫秒时间戳 + 线程 ID」,结果写测试时发现计数偏松------同一毫秒内、线程池复用导致的同线程两次请求,member 完全相同,后一次 ZADD 把前一次覆盖了。换成 UUID 才彻底消除。
坑三:Redis 挂了,限流器该放行还是拒绝?
这是个纯架构决策题,没有标准答案,但必须显式回答:
fail-open(放行):可用性优先,Redis 故障时退化为不限流,但业务不受影响;fail-close(拒绝):配额优先,Redis 故障时全部返回 503------注意是 503 而不是 429,429 语义是"你请求太快",503 语义是"我这边限流组件故障",运维看监控能一眼区分,而不是把系统故障误判成用户刷接口。
无论哪种策略,故障都会触发 RATE_LIMITER_FAILURE 告警(可以直接推钉钉群)。
五、SpEL 按参数限流:好用,但有个安全边界你必须知道
@RateLimit(key = "#id") 一个注解就能按参数值独立配额:
java
@GetMapping("/users/{id}")
@RateLimit(limit = 10, key = "#id")
public User get(@PathVariable Long id) { ... }
实现上用的是受限的 SimpleEvaluationContext:不允许类型引用、构造器调用和 Bean 引用,表达式解析失败自动回退接口级限流,只打 warn 不影响业务。这套防御是为了杜绝 SpEL 注入------StandardEvaluationContext 加上客户端可控输入,是可以直接打出 RCE 的。
但这里有一个更隐蔽的问题,值得单独说:当表达式结果由客户端可控输入派生时(用户名、IP、任意 ID),每个新取值都从满配额开始 。攻击者只要遍历一万个不同的 id,就等于拥有一万个独立的 10 次配额。所以:
- 「按参数限流」的正确用途是租户间公平性(防止一个租户耗尽共享配额);
- 它不能作为防爆破等安全边界使用;
- 防爆破场景应该叠加接口级总配额,或者实现
RateLimitKeyResolverBean 组合 IP 等低基数维度。
另外高基数 key 还有内存风险,本机限流器的键数量上限(max-entries)就是为这个准备的,键超限会淘汰。
六、指标、告警、可观测性:治理不只是拦请求
- Micrometer 桥接 :
api.governance.requests(Counter,outcome 分 success/error/reject)、api.governance.request.duration(Timer)、api.governance.apis.tracked(Gauge)。api标签是全限定类名#方法名,基数上限就是 Controller 方法数,不会标签膨胀。容器里有MeterRegistry就自动注册,对接 Prometheus/Grafana 零配置。 - 告警 :慢方法 / 限流拒绝 / 限流器故障 / 异步任务被拒四类事件,内置 Webhook 通知器基于 JDK HttpClient(零第三方依赖),钉钉支持加签(HMAC-SHA256)。同一个
(类型, apiKey)默认 10 秒内只发一次,防告警风暴把群刷爆。 - 内存指标防膨胀:每个 API 的最近记录是有界滑动窗口(条数 + 时长双上限),全局 API 数量 LRU 淘汰。内存型指标组件不做这个,运行久了就是一个 OOM 定时炸弹。
- 异步钩子 (0.5.0):
@AsyncAction+@AsyncHandler可以给任意 Spring Bean 方法挂四阶段旁路任务(写日志、发通知之类),带启动期校验------Handler 引用了不存在的 action 直接启动失败,拼写错误不再静默失效。
七、写在最后
完整代码和文档(中文注释、升级指南、最小可运行示例工程都在):
Maven Central 可直接引入,坐标见文首。欢迎提 issue 和 PR。
最后留两个问题,评论区聊聊:
- 你们线上的限流故障策略是 fail-open 还是 fail-close?有没有因为选错吃过亏?
- 接口治理(日志/指标/限流)在你司是框架组统一做,还是每个业务组自己写切面?
下一篇计划拆 SpEL 限流键的完整安全模型(含一个可复现的绕过案例),感兴趣的关注一下不迷路。