从原理到代码,10 分钟跑通英伟达 LocateAnything,看懂它为什么比同级模型快。
它到底能干什么?
LocateAnything 只做一件事------定位。但这一件事,它能分五种方式来做:
- 目标检测:每个目标的框
- 指代定位:符合描述的目标框
- 文字检测:图中所有文字的位置
- 界面定位:按钮/图标的位置
- 点定位:目标中心的坐标点
用代码说,就是下面这五行:
python
from PIL import Image
from locateanything_worker import LocateAnythingWorker

worker = LocateAnythingWorker("nvidia/LocateAnything-3B")
img = Image.open("example.jpg").convert("RGB")

worker.detect(img, ["person", "car"])                            # 目标检测
worker.ground_multi(img, "people wearing red shirts")            # 指代定位
worker.detect_text(img)                                          # 文字检测
worker.ground_gui(img, "the search button", output_type="point") # 界面定位
worker.point(img, "the traffic light")                           # 点定位
一个模型、一套 API 覆盖五类需求,这是它和"通用大模型 + 专业检测器"拼接方案最大的区别。
一个框,应该一次画完
老办法有多笨
传统做法把检测框拆成四个数字,让模型一个一个往外吐:
text
传统方式(NTP,逐字生成)

  x1  →  y1  →  x2  →  y2     共 4 步,四个数字互相独立

  问题:中间任意一个数字出错 → 整个框歪掉
这四个数字本来是一体的,它们共同描述同一个框,却被当成四个不相干的任务分开学。结果就是又慢又容易出错。
举个例子:如果模型先写出了 x1 和 y1,却在 x2 上跑偏了一点点,前后两个数字就对不上了,最后画出来的框要么拖出一条长尾巴,要么整个偏出目标。更麻烦的是,这种错误在密集场景里会被放大------画面里人挨着人、车挨着车,一个框歪掉,就可能盖住旁边好几个目标。所以逐字生成不只是慢,它和定位任务本身的结构是冲突的。
新办法:平行框解码
LocateAnything 提出了 Parallel Box Decoding(PBD,平行框解码):
text
LocateAnything(PBD,平行框解码)

  ┌─────────────┐
  │ x1 y1 x2 y2 │          1 步,整框一起出
  └─────────────┘

  好处:整框一次成型,几何关系不被打散,速度成倍提升
打个比方:过去是四个人各写一个数字再拼起来,现在是同一个人一次写完整张纸条。
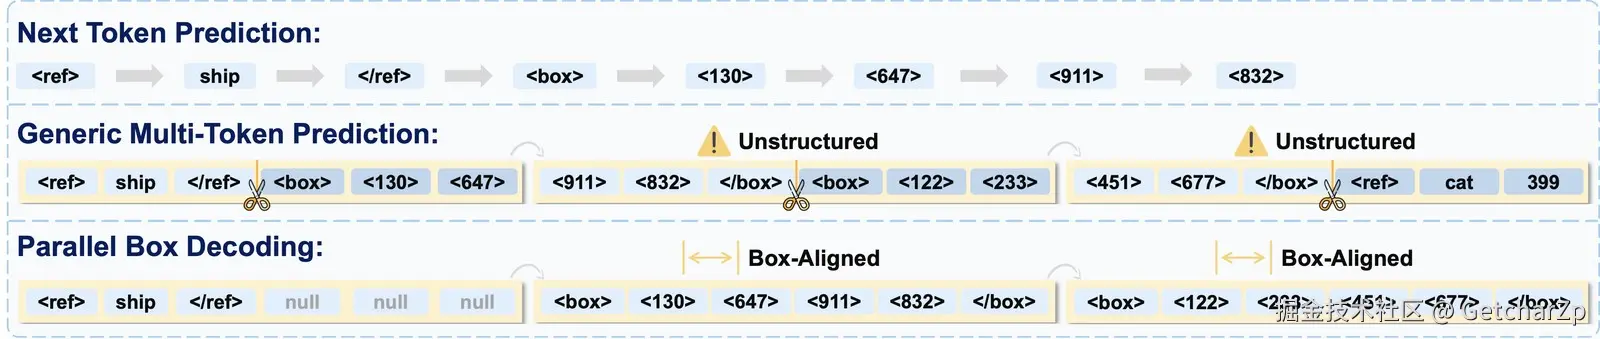
三种解码方式对比。从上往下依次是 NTP、MTP、PBD。
出错了怎么办?
并行解码偶尔会遇到格式异常或坐标含糊的情况。这时它会回退到上一个可靠节点,用传统的逐字模式重新生成这一个框,然后切回并行模式:
text
PBD 输出 ──► 检测到异常 ──► 回退重生成这一个框 ──► 继续并行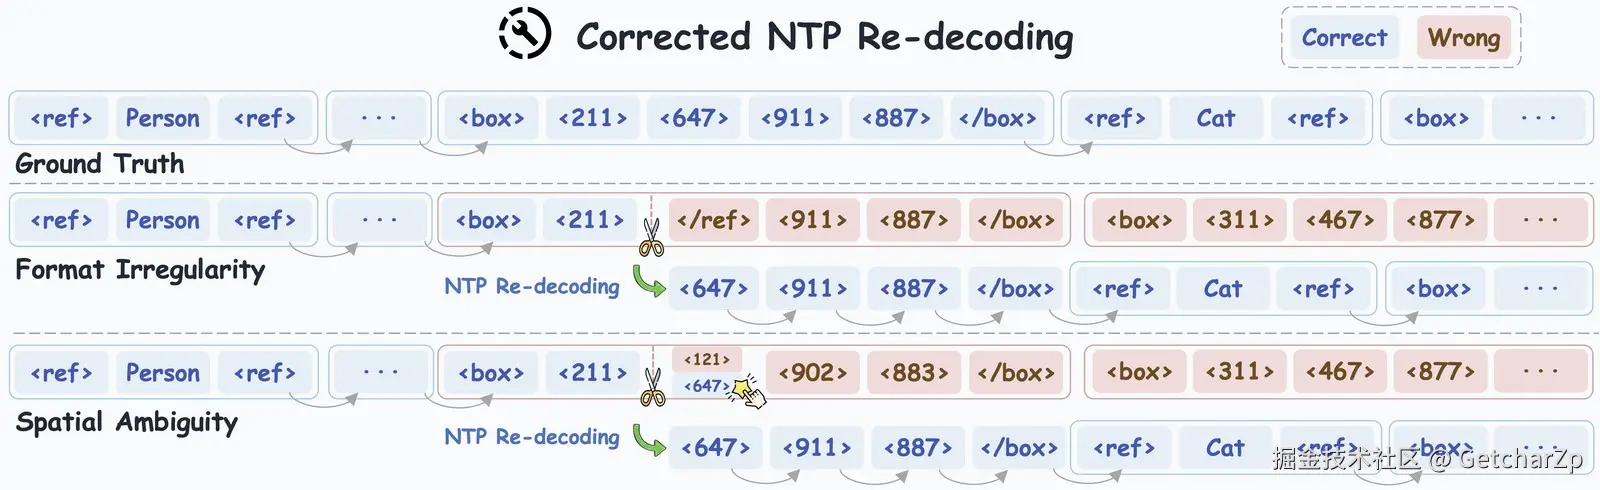
出错重解码机制。速度和稳定兼顾,不是二选一。
三种推理模式,怎么选?
- Fast:并行解码,速度最快、精度高,适合机器人、端侧实时场景
- Slow:逐字生成,速度慢但精度最高,适合离线标注、评测
- Hybrid:默认快,出错时回退,速度快、精度高,适合绝大多数场景
结论:除非你有明确理由,否则一律用默认的 Hybrid。
python
worker.predict(img, prompt, generation_mode="hybrid") # 默认,推荐架构:其实就是三段式
text
图片
│
▼
┌─────────────────┐ ┌──────────┐ ┌───────────────┐ ┌─────────────────┐
│ MoonViT-SO-400M │───►│ MLP 投影 │───►│ Qwen2.5-3B │───►│ <box>...</box> │
│ 视觉编码器 │ │ 对接层 │ │ 语言解码器 │ │ 坐标输出 │
└─────────────────┘ └──────────┘ └───────────────┘ └─────────────────┘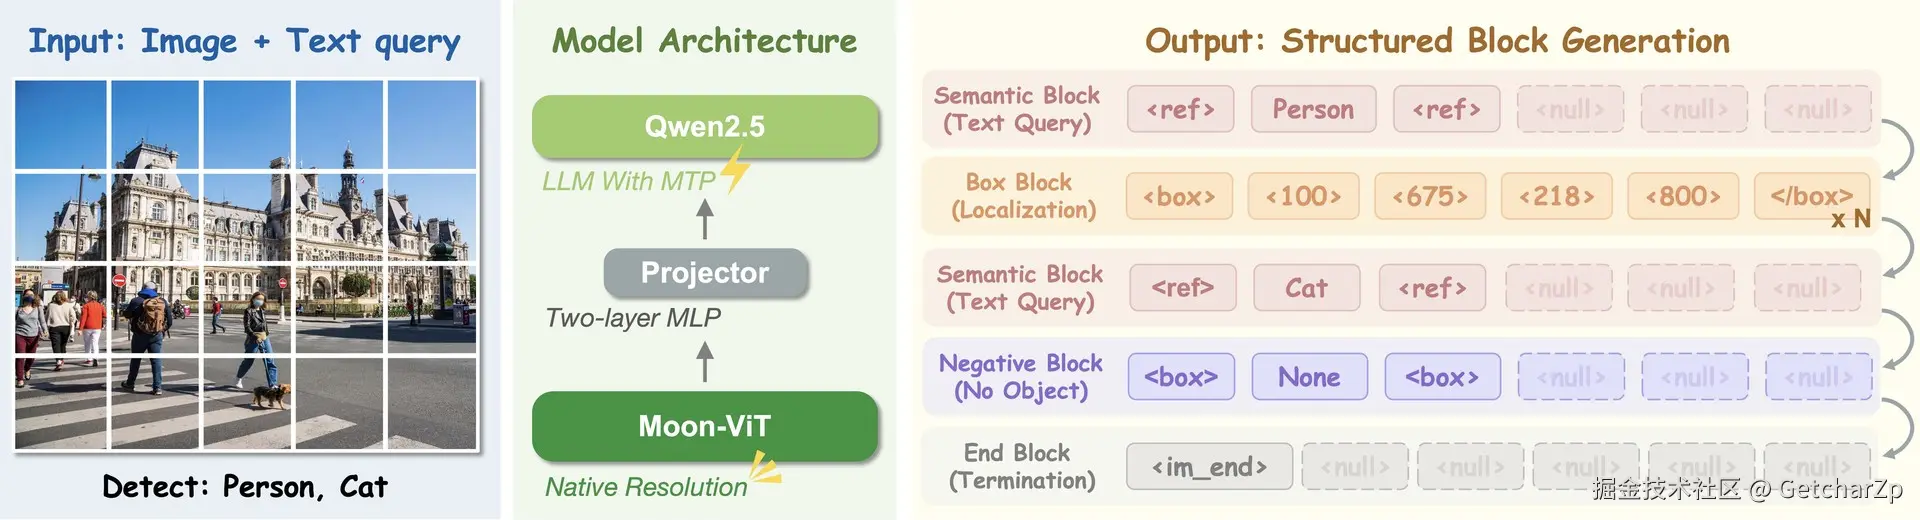 整体架构。视觉编码器 + 投影层 + 语言解码器,结构清晰,没有花活。
为什么 3B 很重要:单卡就能部署,不用提前准备多卡集群。对比动辄几十 B 的通用模型,这才是中小团队最实际的优势。
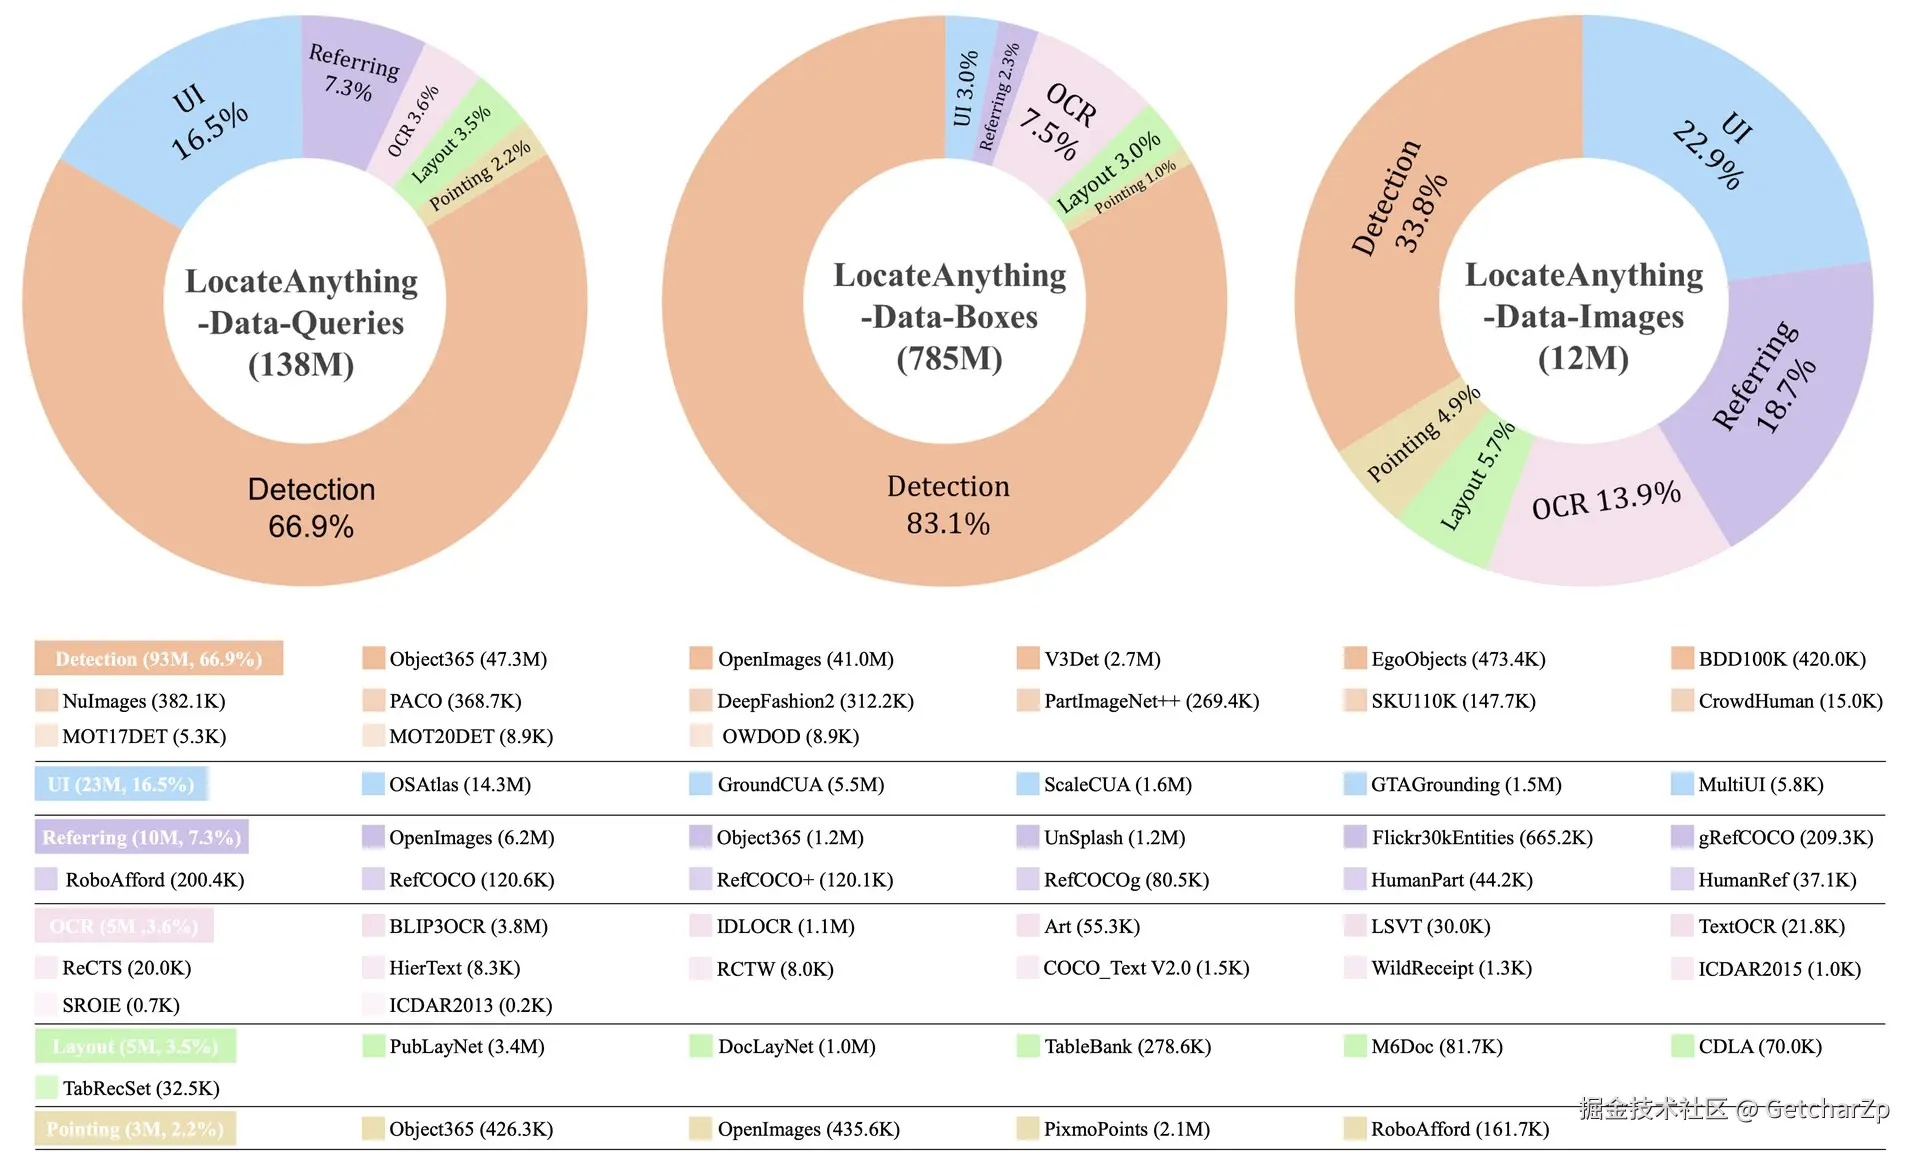
训练数据长什么样
1200 万张图 · 1.38 亿条查询 · 7.85 亿个标注框
上手实战
第 1 步:装环境
bash
git clone https://github.com/NVlabs/Eagle.git eagle
cd eagle/Embodied
pip install -e . --no-deps
依赖会自动装好,包括 transformers、timm、liger_kernel 等。
第 2 步:加载模型
第一次运行的时候会自动下载模型,等待它下载好即可。
python
from PIL import Image
from locateanything_worker import LocateAnythingWorker

worker = LocateAnythingWorker("nvidia/LocateAnything-3B")
img = Image.open("street.jpg").convert("RGB")
第 3 步:调用检测
推荐按这个顺序试,不用写新代码,只换图片和提示词:
python
# 1.先试检测,验证框的数量和位置是否符合直觉
print(worker.detect(img, ["person", "car", "traffic light"])["answer"])

# 2.再试自然语言描述,验证指代能力
print(worker.ground_single(img, "the man on the left")["answer"])

# 3.最后试点定位,感受精度
print(worker.point(img, "the traffic light")["answer"])
十分钟,你就能对它的能力边界有直观判断。
第 4 步:解析坐标
模型输出的是带特殊 token 的字符串,长这样:
text
# box 里面为坐标:x1,y1,x2,y2
<ref>person</ref><box><120><340><280><720></box>
坐标是 0--1000 的归一化整数,除以 1000 再乘图片宽高就是像素坐标:
python
answer = worker.detect(img, ["person"])["answer"]
boxes = worker.parse_boxes(answer, img.width, img.height)

for b in boxes:
    print(b["x1"], b["y1"], b["x2"], b["y2"])   # 已经是像素坐标
常见问题(FAQ)
Q:需要多少显存?
官方推荐 24G 起步。如果用批量运行时的 la_flash 后端,A100 上跑 4K 图的峰值显存约 12G,消费级显卡也有机会跑起来。
Q:目标类别是固定的吗?
不是。类别完全由你用自然语言指定,detect 传类别清单,ground_multi 传一句描述,不需要重新训练。
Q:它和 YOLO 这类检测器有什么区别?
YOLO 只能识别训练时见过的固定类别;LocateAnything 走开放词汇路线,你说什么它就找什么,还能顺带做界面定位和文字检测。
写在最后
定位为什么一直难?因为过去大家把"理解"和"精确定位"混在同一个生成框架里,用最笨的方式一个数字一个数字地输出。
LocateAnything 的价值在于------它把框当成框本身来建模。就这一个改动,让 3B 的小模型在速度和精度上同时越级。
如果你手头有 GPU,又正好在做上面那些场景,它大概是目前最值得先试一把的开源定位模型。