GPU 小常识
GPU 基础知识入门:
一、GPU 是什么,为什么需要它
GPU 是为了大规模数据,并行计算而生:
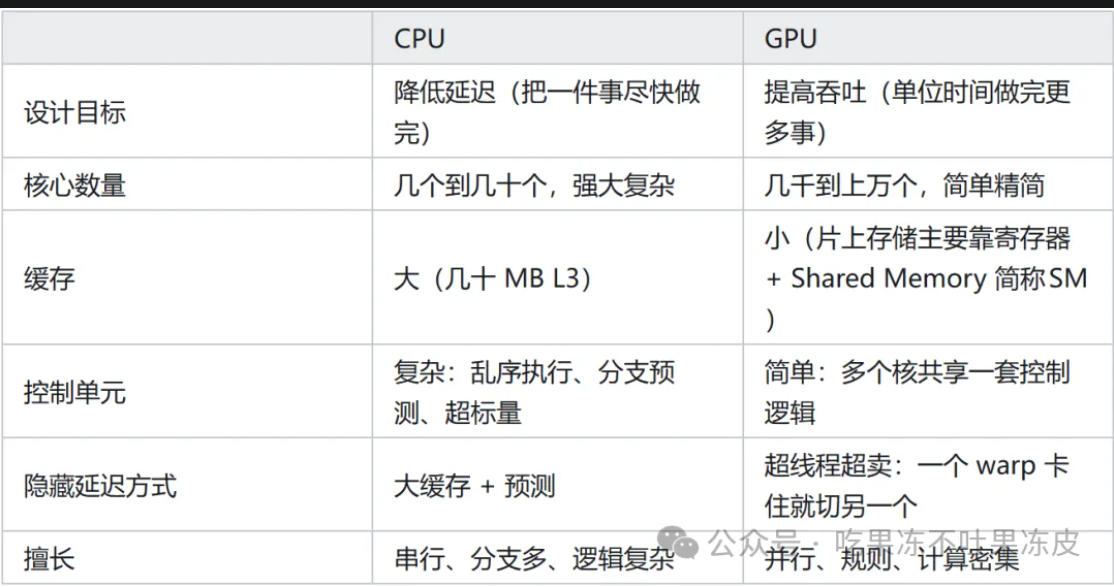
关键结论:GPU 快不是因为单核,通常单指令运行速度不如 CPU,核多 + 访存带宽大 + 用并行掩盖延迟,吞吐大,处理多数据多计算比 CPU 总用时少。运行慢的大火车。
二、GPU 硬件架构
2.1 层次结构(以 NVIDIA 为例)
GPU 芯片
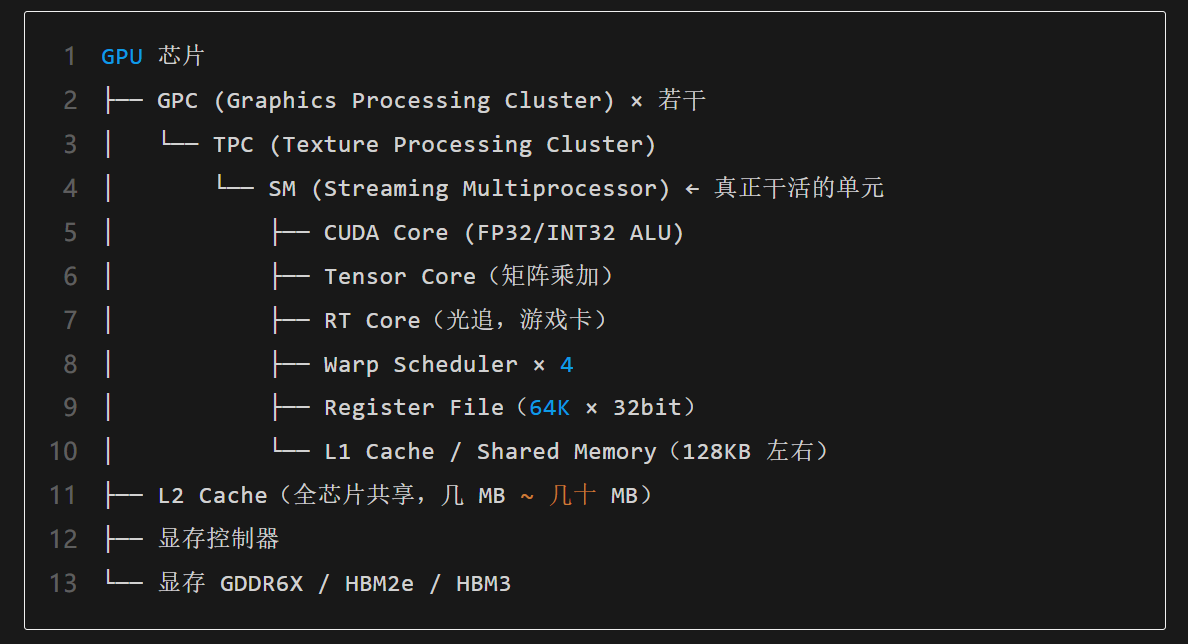
2.2 CUDA Core 数量怎么算
CUDA Cores = SM 数量 × 每 SM 的 FP32 单元数
例如 RTX 3090:82 个 SM × 128 = 10496 个 CUDA Core。
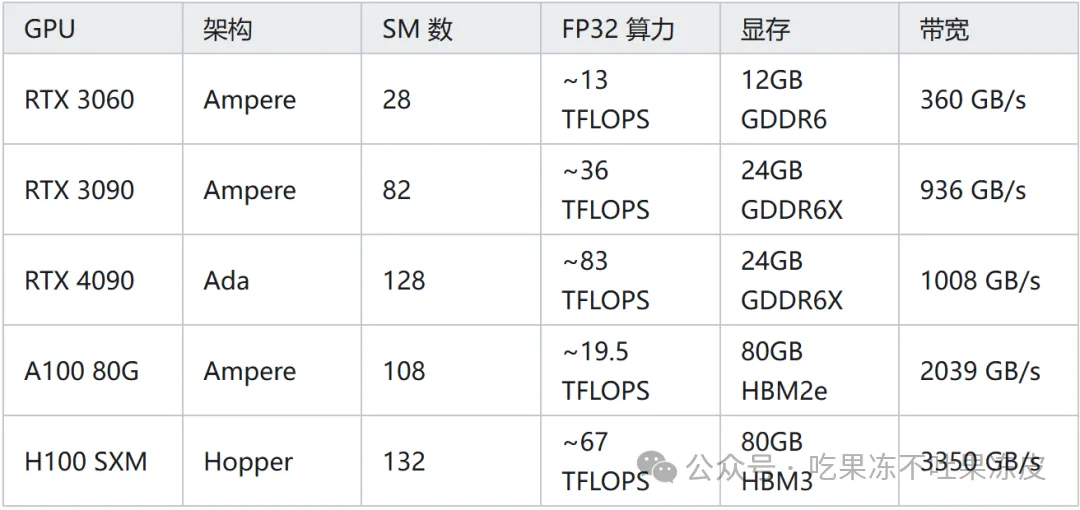
2.3 常见 GPU 规格对比
三、内存层次(性能优化的核心)
这是 GPU 编程里最重要的一张表:
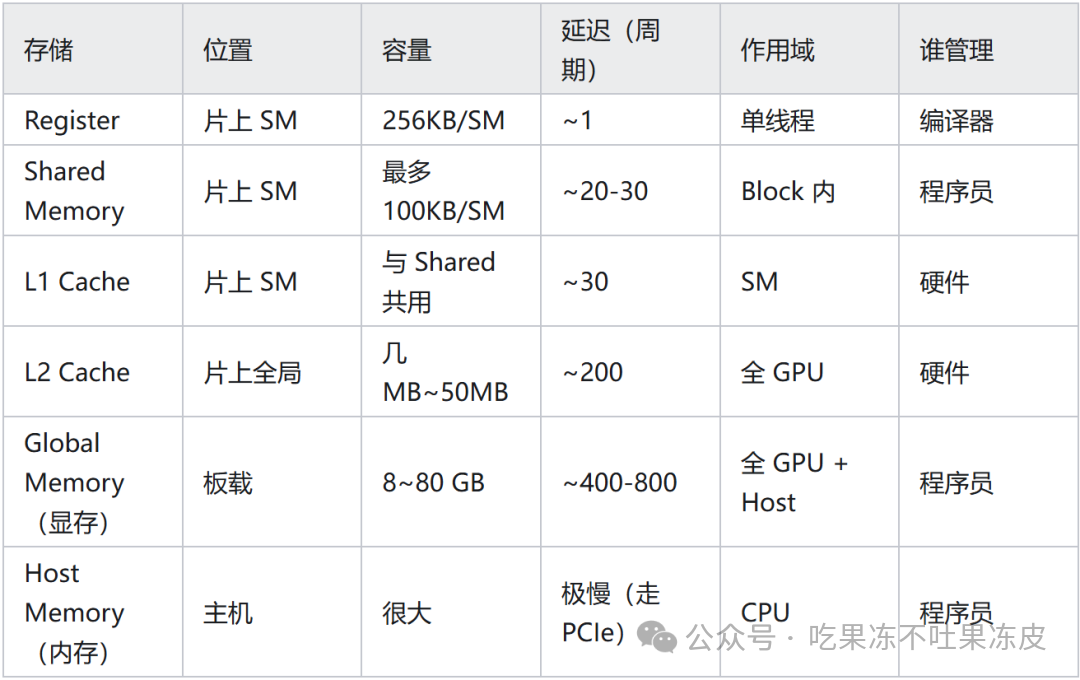
几个关键认知
- 访问全局显存比计算慢几百倍
现代 GPU 算力增长远快于带宽增长,因此绝大多数实际程序是"访存受限"(memory-bound)而非"计算受限"(compute-bound)。
优化的第一原则往往是"减少访存 / 提高访存效率",而不是"减少计算量"。
- PCIe 是大瓶颈
GPU 显存带宽: 2000 GB/s (A100 HBM2e)
NVLink: 600 GB/s
PCIe 4.0 x16: 32 GB/s ← CPU↔GPU 传输
相差 60 倍以上。所以能不在 CPU 和 GPU 之间来回搬数据就不搬,这是很多"GPU 用了却不快"的根本原因。
- Shared Memory 是手动管理的缓存
矩阵乘法之类的算法,靠把数据先搬到 Shared Memory 再复用(tiling 分块),能带来数倍加速。
四、执行模型:SIMT 与 Warp
4.1 线程层级
Grid(一次 kernel 启动)
└── Block(线程块,最多 1024 线程) → 分配到一个 SM,不迁移
└── Warp(32 个线程) → 硬件调度的最小单位
└── Thread → 有自己的寄存器和程序计数器
Block 内的线程可以通过 Shared Memory 通信,可以 __syncthreads() 同步
Block 之间默认无法同步,这保证了 GPU 可以任意顺序调度 block(可扩展性的来源)
4.2 SIMT(Single Instruction, Multiple Threads)
一个 warp 里 32 个线程共享一个指令流。这带来一个重要陷阱 ------ 分支发散(Warp Divergence):
if (threadIdx.x % 2 == 0) {
A(); // 偶数线程执行时,奇数线程被屏蔽(空转)
} else {
B(); // 反之亦然
}
// 结果:耗时 = A + B,而不是 max(A, B)
优化建议:让分支尽量以 warp 为粒度对齐(如 if (threadIdx.x / 32 == 0)),而不是相邻线程走不同路径。
4.3 延迟隐藏
GPU 不靠大缓存降低延迟,而是靠"人海战术":
Warp0 发起访存 → 等待 400 周期
↓ 调度器立刻切到
Warp1 计算 → Warp2 计算 → Warp3 ...
↓ 400 周期后
Warp0 数据到了,继续
Warp 切换是零开销的(寄存器都是各自独立预分配的)。所以 SM 上驻留的 warp 越多,越能填满流水线 ------ 这就是 Occupancy(占用率) 的意义。
五、CUDA 编程模型入门
5.1 最小完整例子:向量加法
#include
// global 表示这是在 GPU 上执行、由 CPU 调用的核函数
global void vecAdd(const float* a, const float* b, float* c, int n) {
int i = blockIdx.x * blockDim.x + threadIdx.x; // 全局唯一线程 ID
if (i < n) { // 边界检查必不可少
ci = ai + bi;
}
}
int main() {
int n = 1 << 20; // 1M 元素
size_t bytes = n * sizeof(float);
// 1. 主机端分配与初始化
float h_a = (float )malloc(bytes);
float h_b = (float )malloc(bytes);
float h_c = (float )malloc(bytes);
for (int i = 0; i < n; i++) { h_ai = 1.0f; h_bi = 2.0f; }
// 2. 设备端分配
float *d_a, *d_b, *d_c;
cudaMalloc(&d_a, bytes);
cudaMalloc(&d_b, bytes);
cudaMalloc(&d_c, bytes);
// 3. 拷贝 Host → Device
cudaMemcpy(d_a, h_a, bytes, cudaMemcpyHostToDevice);
cudaMemcpy(d_b, h_b, bytes, cudaMemcpyHostToDevice);
// 4. 启动 kernel:<<<block数, 每block线程数>>>
int threads = 256;
int blocks = (n + threads - 1) / threads; // 向上取整
vecAdd<<<blocks, threads>>>(d_a, d_b, d_c, n);
// 5. 拷回 Device → Host(cudaMemcpy 隐含同步)
cudaMemcpy(h_c, d_c, bytes, cudaMemcpyDeviceToHost);
printf("c0 = %f\n", h_c0); // 3.0
// 6. 释放
cudaFree(d_a); cudaFree(d_b); cudaFree(d_c);
free(h_a); free(h_b); free(h_c);
return 0;
}
编译运行:
nvcc -arch=sm_86 -O3 vecadd.cu -o vecadd
./vecadd
5.2 三个函数修饰符
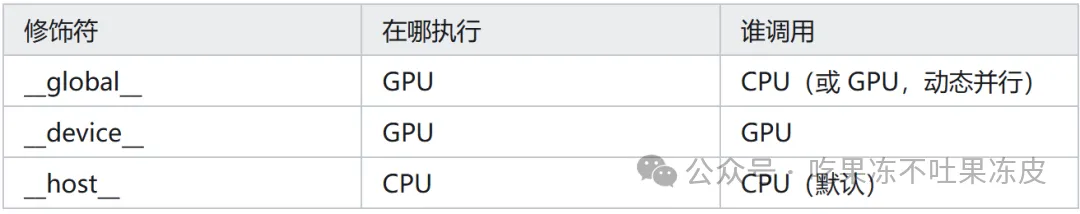
5.3 异步与 Stream
Kernel 启动是异步的(CPU 发完就返回),这是新手常见的坑:
kernel<<<b, t>>>(...);
cudaDeviceSynchronize(); // 计时或读结果前必须同步!
// 错误检查(异步错误只能同步后拿到)
cudaError_t err = cudaGetLastError();
if (err != cudaSuccess) printf("%s\n", cudaGetErrorString(err));
用 Stream 可以让拷贝和计算重叠:
cudaStream_t s1, s2;
cudaStreamCreate(&s1); cudaStreamCreate(&s2);
cudaMemcpyAsync(d_a, h_a, bytes, cudaMemcpyHostToDevice, s1);
kernel<<<b, t, 0, s1>>>(d_a, ...); // s1 内串行,s1 与 s2 并行
六、性能优化的核心概念
6.1 Roofline 模型:先判断瓶颈在哪
计算强度 (Arithmetic Intensity) = 浮点运算次数 / 访存字节数 (FLOP/Byte)
强度低(如向量加法:3 次访存换 1 次加法,约 0.08)→ 访存受限,优化访存
强度高(如大矩阵乘法)→ 计算受限,优化指令与 Tensor Core 利用
A100 的临界点约为 19.5 TFLOPS / 2 TB/s ≈ 10 FLOP/Byte。多数深度学习算子(激活、归一化、element-wise)都远低于这个值,属于访存受限,这也是算子融合(kernel fusion)如此有效的原因。
6.2 合并访存(Coalescing)
一个 warp 的 32 个线程如果访问连续对齐的地址,硬件可以合并成少数几次内存事务:
// 好:线程 i 访问 datai,连续
float v = datablockIdx.x \* blockDim.x + threadIdx.x;
// 坏:跨步访问,一次 warp 触发 32 次事务,带宽利用率降到 1/32
float v = datathreadIdx.x \* 32;
这通常是性能差异最大的单个因素。相应地,数据布局上 SoA(结构体数组)优于 AoS(数组结构体)。
6.3 Shared Memory 与 Bank Conflict
Shared Memory 分为 32 个 bank。同一 warp 内多个线程访问同一 bank 的不同地址会串行化。经典解法是 padding:
shared float tile3233; // 33 而非 32,错开 bank
6.4 Occupancy(占用率)
Occupancy = 实际驻留 warp 数 / SM 支持的最大 warp 数
限制因素:每线程寄存器数、每 block 的 Shared Memory 用量、block 大小。
注意:占用率不是越高越好,60%~70% 通常就足够隐藏延迟;有时降低占用率换取更多寄存器(提高 ILP)反而更快。
6.5 优化优先级清单
如下:
减少 CPU↔GPU 数据传输
保证全局内存合并访问
用 Shared Memory 复用数据(tiling)
算子融合,减少 kernel 启动和中间结果读写
避免 warp 分支发散
调整 block size(通常 128/256,为 32 的倍数)
用 Tensor Core / 低精度
用 Stream 重叠计算与传输
七、Tensor Core 与精度
Tensor Core 是专门做 D = A × B + C 小矩阵乘加的单元,比 CUDA Core 做同样的事快一个数量级。
常见数值格式:
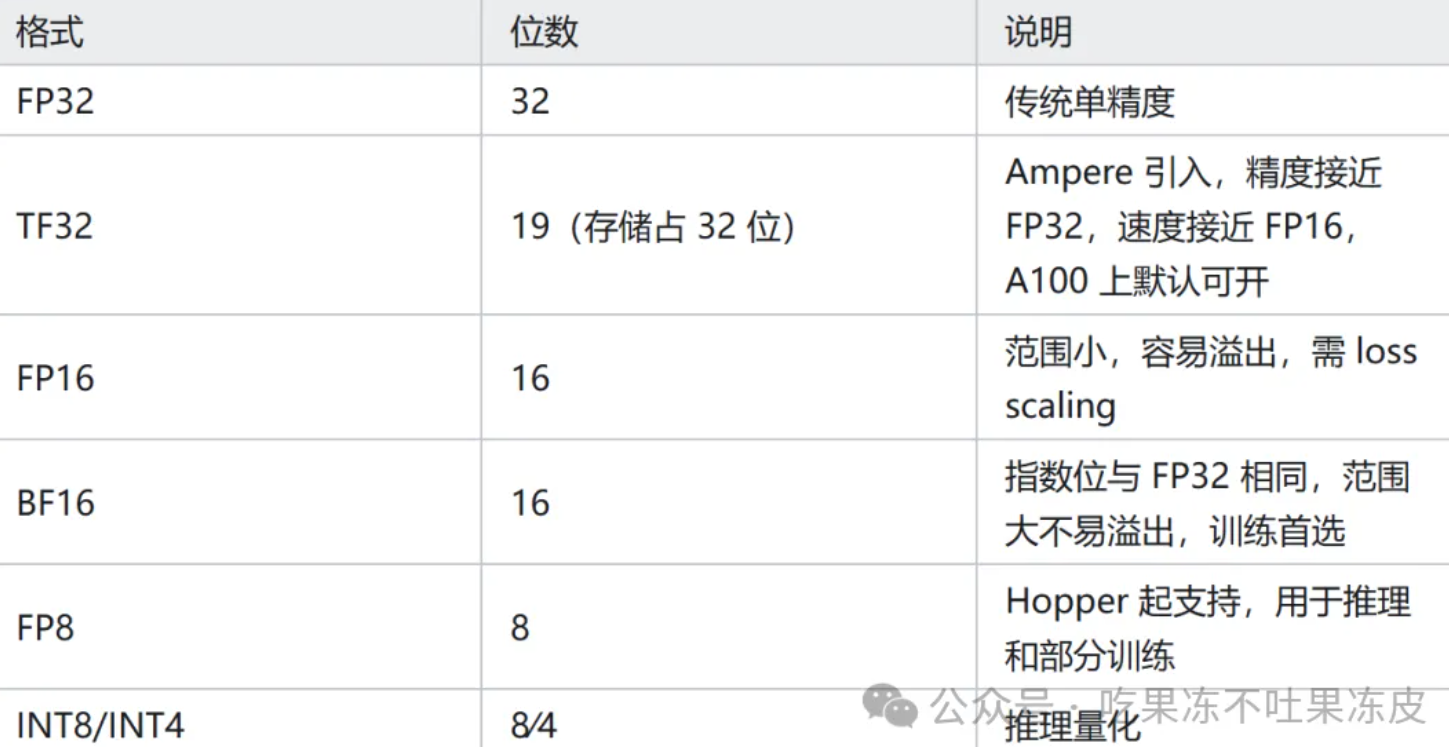
PyTorch 中启用混合精度:
from torch.amp import autocast, GradScaler
scaler = GradScaler()
for x, y in loader:
with autocast('cuda', dtype=torch.bfloat16):
loss = model(x, y)
scaler.scale(loss).backward()
scaler.step(optimizer)
scaler.update()
另外可打开 TF32(对 Ampere+ 有效):
torch.backends.cuda.matmul.allow_tf32 = True
torch.backends.cudnn.allow_tf32 = True
八、多 GPU 与互联
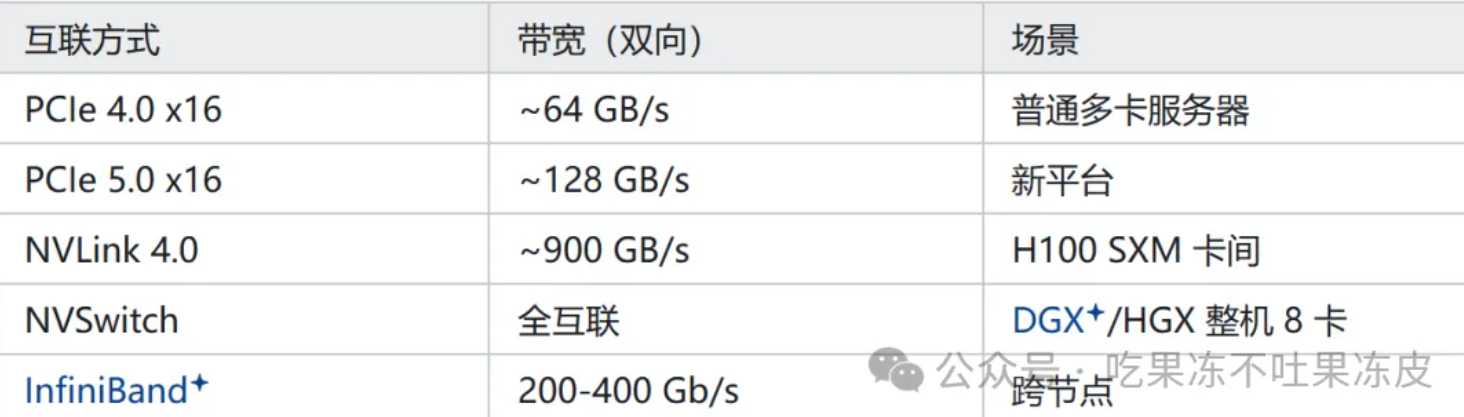
常见并行策略:
数据并行(DDP):每卡一份完整模型,切分数据,梯度 AllReduce
张量并行(TP):把单层的矩阵切开放到多卡,通信频繁,需 NVLink
流水线并行(PP):不同层放不同卡
ZeRO / FSDP:切分优化器状态、梯度、参数,省显存
九、软件生态
应用层 PyTorch / TensorFlow / JAX / vLLM
↓
库层 cuBLAS(矩阵) cuDNN(卷积) cuFFT NCCL(多卡通信)
CUTLASS(模板库) Thrust(类STL) TensorRT(推理)
↓
编程层 CUDA C++ / Triton / OpenAI Triton / CUDA Python
↓
驱动层 CUDA Runtime → CUDA Driver → GPU
版本关系要点:
显卡驱动版本 决定支持的最高 CUDA 版本(nvidia-smi 右上角显示的是驱动支持的最高版本)
CUDA Toolkit 版本(nvcc -V 显示)是你编译用的版本,可以低于驱动支持的
PyTorch 的 pip 包自带 CUDA runtime,本机不装 CUDA Toolkit 也能跑,只要驱动够新
常用工具:
nvidia-smi # 查看显存占用、利用率、驱动版本
nvidia-smi dmon -s u # 实时监控 SM/显存/编解码利用率
nsys profile ./app # Nsight Systems:整体时间线,找 CPU/GPU 空隙
ncu --set full ./app # Nsight Compute:单 kernel 级别深度分析
compute-sanitizer ./app # 检测越界、竞态(替代旧的 cuda-memcheck)
PyTorch 内置分析器:
from torch.profiler import profile, ProfilerActivity
with profile(activities=ProfilerActivity.CPU, ProfilerActivity.CUDA) as prof:
model(x)
print(prof.key_averages().table(sort_by="cuda_time_total", row_limit=15))
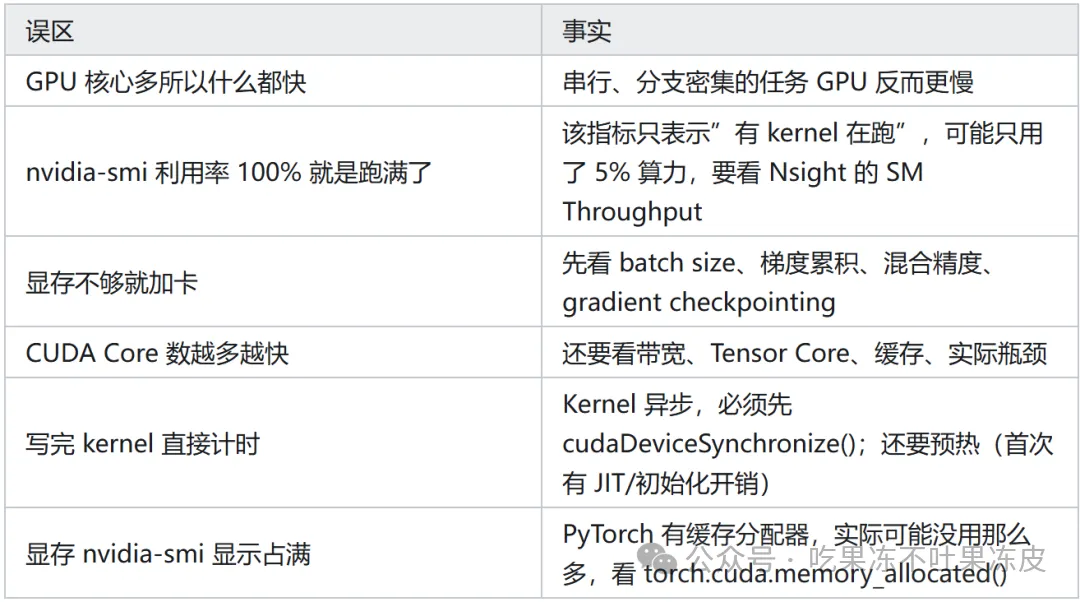
十、常见误区
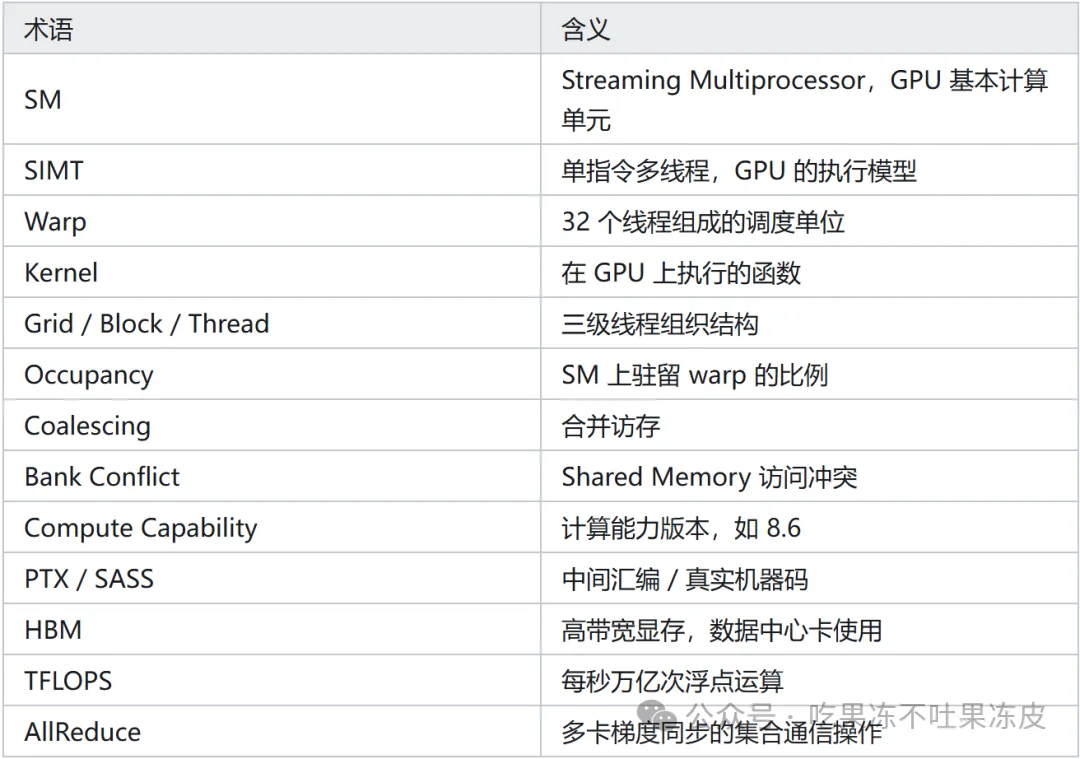
 十一、术语速查
简单来说:RL 的训练不是"模型训一次",而是"模型先生成一堆样本(Rollout),再拿这些样本训一次(Update)"的循环。
PPO 是这样,GRPO 更是把这个循环放大了(一次要生成一组 G 条回答),所以对基础设施(Infra)的设计压力主要就集中在:怎么平衡"生成"(推理/rollout)和"训练"(更新)的算力、显存和时间。
本文以 GRPO 为例,讲清楚当前主流 RL 框架在 Infra 层(基础架构)是怎么设计的。
一、GRPO 决定了 RL Infra 的需求
先看 GRPO 和 PPO 的差异,这个差异直接决定了框架怎么分配 GPU。
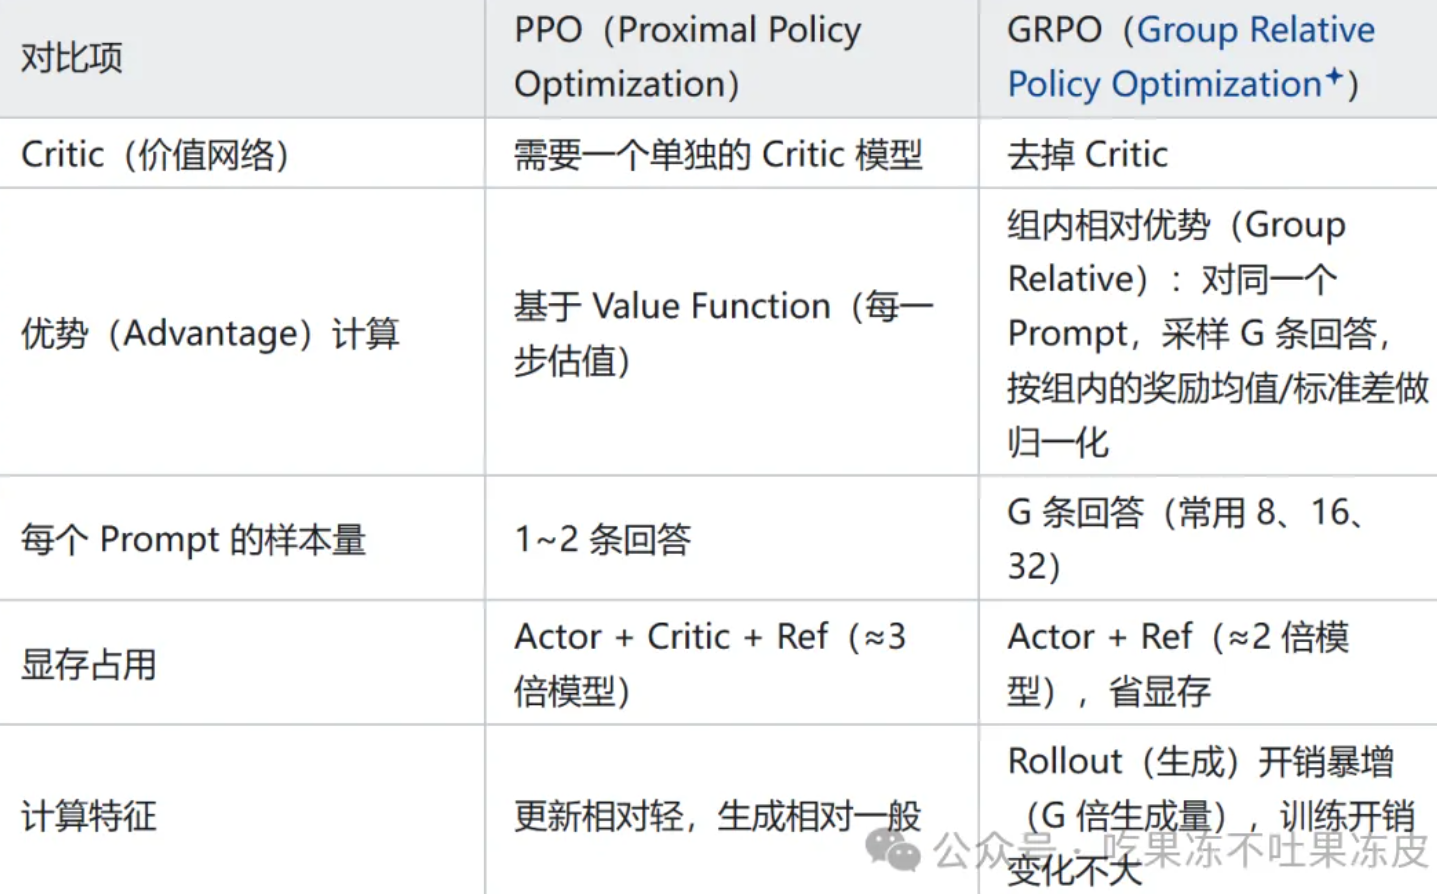
DeepSeek-R1 的实践也印证了这一点:GRPO 的瓶颈大部分时候是 Rollout(采样生成),而不是 Policy Update(参数更新)。
所以 GRPO 的 Infra 设计核心是:如何高效地完成"大规模采样(Rollout)"这个阶段。
二、RL 训练的核心组件
一个 RL 训练流程可以拆成下面几个关键组件:
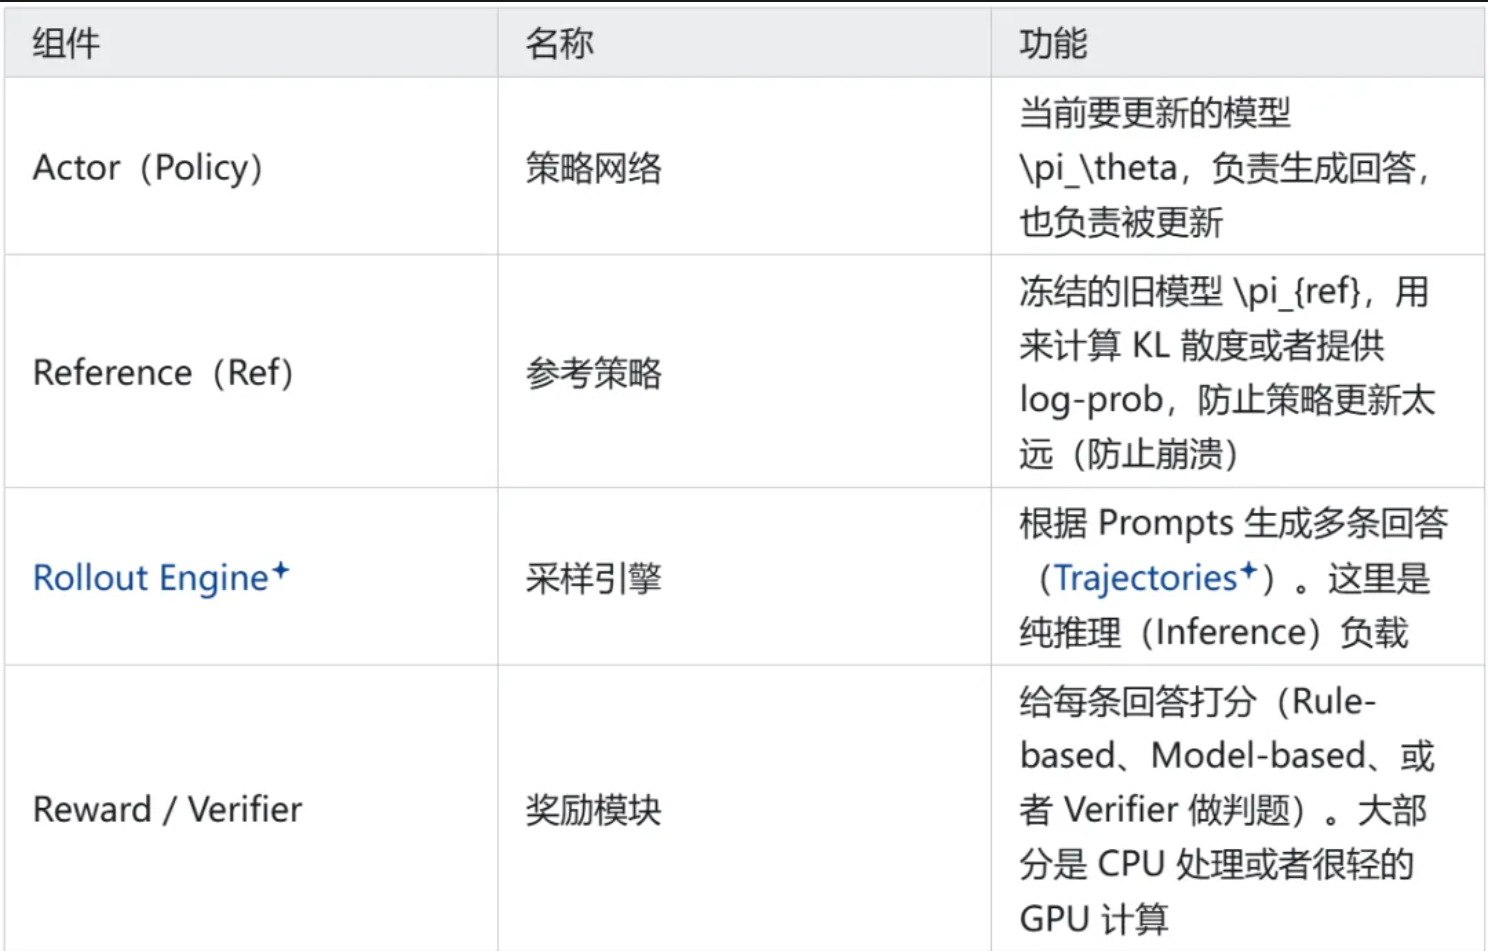
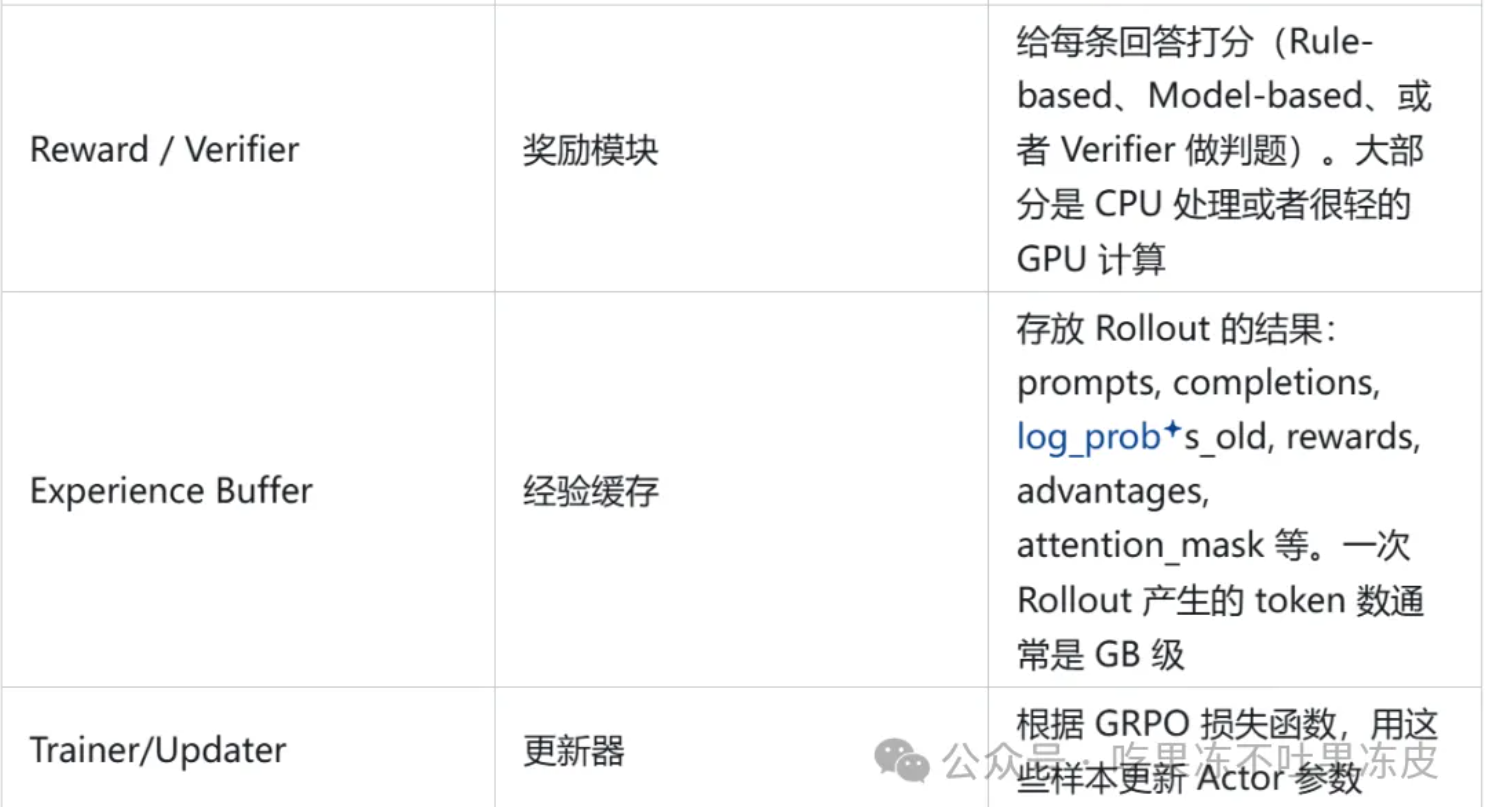
GRPO 的一个训练步(Step)大致是:
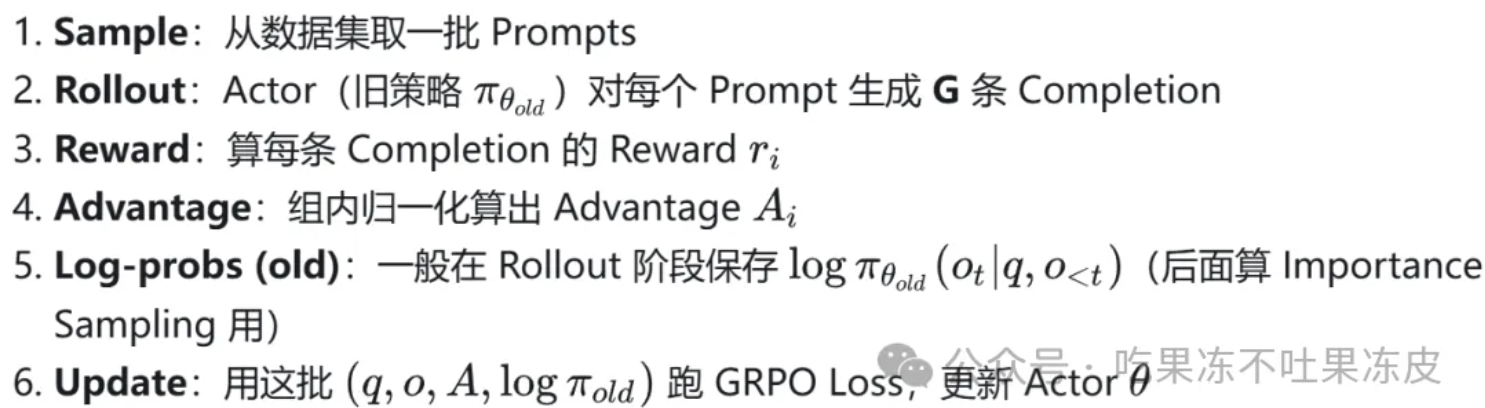
问题在于:Step 2(Rollout)是自回归生成(串行 token-by-token),Step 6(Update)是大矩阵并行训练(批处理)。这两个阶段的计算特征完全不同(推理 vs 训练),硬件利用方式也不同。
三、Colocated vs Decoupled(耦合 vs 解耦)
当前主流 RL 框架最核心的 Infra 架构决策,就是:Rollout 和 Training 用同一批 GPU,还是用不同批 GPU?
3.1 解耦(Decoupled / Training-Inference Separated)
思路:把"推理(Rollout)"和"训练(Update)"完全分开,在两组 GPU(甚至两组机器)上跑。
Rollout 集群:只跑推理引擎(vLLM、SGLang、TensorRT-LLM),追求吞吐(tokens/s)和延迟,通常开 Tensor Parallel(TP)、Continuous Batching、PagedAttention 等推理优化。
Training 集群:只跑训练(FSDP/Megatron),追求显存利用率和计算效率(ZeRO/FSDP、TP/PP、梯度累积等)。
优点:
资源利用专业化:推理和训练的配置(batch size、并行方式、内存分配策略)互相冲突。分开后各自调优空间大,GPU 利用率更稳定。
扩展性好:Rollout 特别吃生成吞吐,可以单独横向扩展 Rollout 节点(应对 G 很大的场景,比如 G=64)。
不内存争抢:vLLM/SGLang 跑时要占 KV Cache + 模型权重,训练要占模型权重 + 优化器状态 + 梯度 + 激活值。分开就不会互相挤显存。
缺点:
需要参数同步/搬运:每一轮 RL Step,Actor 更新完参数之后,必须把新权重同步到 Rollout 引擎。对于 7B/32B/70B 参数量,这个同步是一次显著的开销(尤其是跨节点走网络)。
GPU 空泡(Bubble):Training 跑完 Update 要等 Rollout 跑完一轮;Rollout 跑完要等 Training 同步完参数再下一轮。两边耗时不一定匹配,很容易有一边空闲。
代表框架:早期的 OpenRLHF(支持 decoupled),部分生产场景也用这个思路。
3.2 耦合(Colocated / Training + Inference Shared GPUs)
思路:让同一批 GPU 既跑 Rollout(推理),也跑 Training(训练)。核心是:同一轮里,先用这些 GPU 做生成,生成完再立刻切换成训练模式做参数更新。
优点:
零参数跨机搬运(Weight Sharing):Actor 的权重就在 GPU 显存里,Rollout 用完直接切到 Training,不需要 broadcast/push weights 到另一组集群,省去了大量网络传输和同步等待时间。
显存利用更充分:理想情况下,可以减少"整组 GPU 只做生成时的空闲算力"。尤其是生成结束到更新开始之间的空档更小。
硬件成本更低:同样规模的模型,不用拆成两套集群,用一套 GPU 就能跑。
缺点:
显存极度紧张:一块 GPU 上要同时扛住两种峰值内存:
推理峰值:模型权重 + KV Cache(长上下文+大 batch+G 条回答时 KV Cache 非常吓人)
训练峰值:模型权重 + 优化器状态(Adam 2~3x) + 梯度 + 激活值(Activation)
资源争抢与切换开销:vLLM/SGLang 是独立的推理引擎(C++/CUDA 执行图),FSDP/Megatron 是训练框架。
要在同一批 GPU 上"轮流运行",通常需要重载权重(weight reloading)或者引擎内部分时复用,实现起来复杂,容易有内存碎片。
调优困难:推理和训练的并行策略(TP/DP/PP)往往是冲突的。比如训练想要大 DP 提升吞吐,推理想要 TP 降低单卡显存压力,很难两全。
代表框架:veRL(主推 HybridFlow + Colocated),SkyRL 也偏向 colocated 思路,Slime 则探索了"异步(Async)"的方式来缓解空泡。
3.3 主流选择
目前业界共识是:7B~14B 小模型更适合 Colocated(省同步开销,显存压力勉强能顶),32B~70B+ 大模型更倾向 Decoupled(显存太吃紧,宁可忍受参数同步开销)。
这也是为什么 veRL(字节/火山)在主流规模(7B/14B RLVR)里大幅采用 Colocated,而一些大规模训练(70B+)还是会选 Decoupled 架构。
四、veRL 的 Infra 设计(最具代表性)
veRL 是目前 GRPO 研究和落地里最常用的框架之一。它的核心设计思想叫 HybridFlow(混合流程),本质上是:用 Ray 做分布式编排 + Worker 抽象封装不同角色 + 支持 Colocated/Decoupled 灵活切换。
4.1 整体架构:Ray + Worker
veRL 用 Ray 作为全局控制器(Orchestrator)。Ray 的好处是可以把不同的任务(Rollout、Reward、Update)调度到不同 GPU/节点上,处理异步、容错和资源分配都比较方便。
核心是把系统拆成一堆 Worker(工作单元),每个 Worker 绑定一组 GPU,负责某个角色:
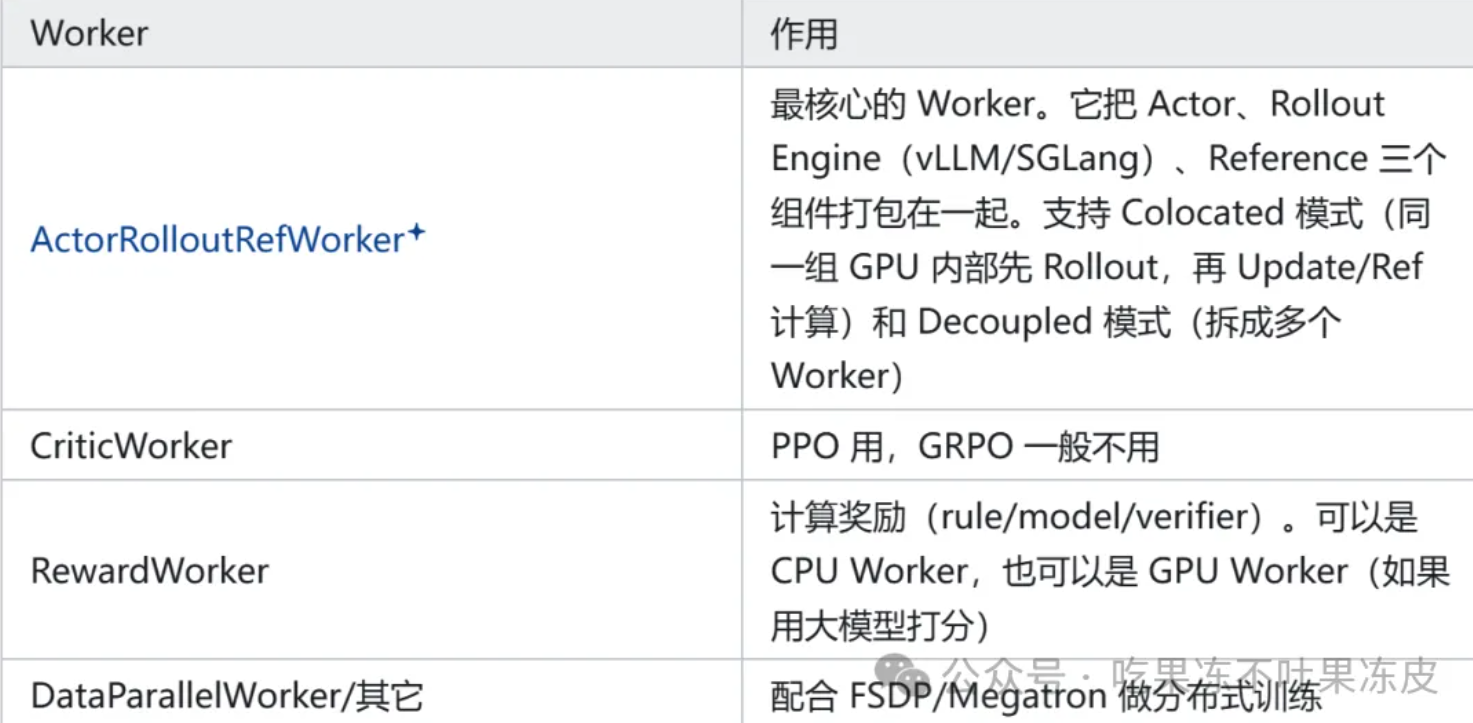
4.2 Colocated 模式下的时序(GRPO Step)
以 ActorRolloutRefWorker Colocated 为例,一步 GRPO 的时序大致如下:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
T0: Prompts (Ray Data/Buffer)
↓
GPU 组: Rollout 阶段(推理模式)
- 加载/切换到推理态(vLLM/SGLang 接管执行)
- 每个 Prompt 采样 G 条 Completion(自回归,吞吐主导)
- 同时保存 log_probs_old(π_{θ_old} 在生成时的对数概率,避免后面重算生成路径的 logprob)
- 输出 Trajectories(tokens, logprobs_old, response_ids...)
↓
GPU 组: 计算 Reward + Advantage - RewardWorker(可异步)算分,组内归一化得到 A_i
- 拼成训练 Batch(Experience)
↓
GPU 组: Training/Ref 阶段(训练模式) - 切回 FSDP/Megatron 训练态(权重仍在显存,无需跨卡搬运)
- 计算 Ref log-probs(冻结 Ref,前向即可,显存/算力开销小)
- 用 GRPO Loss 计算 π_θ/π_{θ_old} 的 Importance Sampling Ratio,做 Clip,反向更新 Actor
↓
下一轮 Step,用更新后的 θ_{new} 直接做 Rollout(权重已在显存)
关键点:log_probs_old 在 Rollout 阶段一边生成一边顺带算出来(vLLM/SGLang 支持返回采样路径的 log-prob),而不是生成完再让 Actor 重算一遍整段序列的 log-prob。这样既省计算,又保证是 πold 在真正采样时的概率(数值更一致)。
4.3 Decoupled 模式下的时序
1
2
3
4
5
6
7
Rollout GPUs(vLLM/SGLang,推理)
-> 生成 G 条回答,产出 trajectories + log_probs_old
-> 通过 Ray/Object Store 或网络把 Experience Batch 推送到 Training Group
Training GPUs(FSDP/Megatron,训练)
-> 收到 Batch,计算 Advantage、Ref Log-probs、GRPO Loss,更新 Actor 权重 W_{t+1}
-> 将 W_{t+1} 同步(Weight Sync)回 Rollout GPUs(Broadcast/Checkpoint+Load 或直接 NCCL/Ray)
-> 下一轮用新权重 W_{t+1} 做 Rollout
这里的权重同步(Weight Synchronization)是 Decoupled 架构的最大开销点。
veRL、OpenRLHF 等框架会尽量用 NCCL(GPU 间高速互联)做同步,而不是走 CPU 存中转来减少延迟。
五、关键 Infra 设计点(GRPO 场景)
GRPO 对 Infra 提出了几个特别的工程挑战,主流框架基本都围绕这些点优化。
5.1 Rollout 引擎的选择
Rollout 是生成密集型,必须用高吞吐的推理引擎,而不是直接用 PyTorch eager 做自回归。
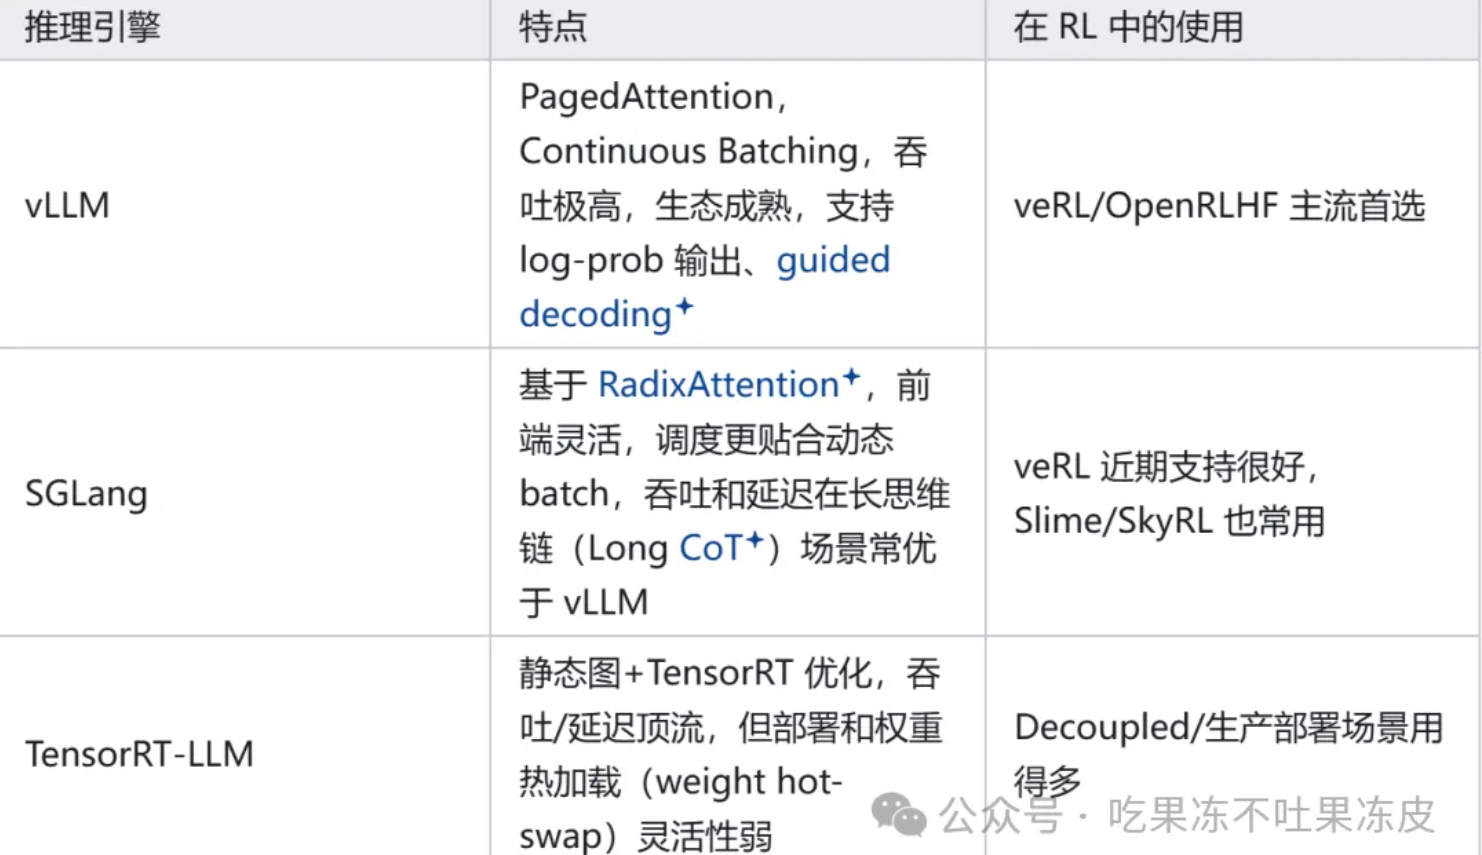
GRPO 的一个细节:需要 Rollout 阶段返回每个 token 的 log_prob(给 Importance Sampling 用)。
vLLM/SGLang 都原生支持 logprobs/token_logprobs,这也是它们能成为 RL Rollout 引擎事实标准的原因。
5.2 Colocate 的显存管理
Colocated 最大痛点是显存竞争。主流做法是"推理时优先保证 KV Cache + 权重,训练时优先保证激活+优化器",框架层会做显存预估和时序切换。
一些优化思路:
Offload/Swap:训练时暂时把 vLLM 的 KV Cache offload 到 CPU/显存空闲区域(或者直接释放引擎占用的缓存),等下一轮 Rollout 再重新预分配。代价是 CPU-GPU 拷贝开销。
Paged KV 管理:vLLM 的 PagedAttention 本身就大幅降低 KV 峰值,减轻了与训练的内存冲突。
序列长度动态变化:GRPO 生成的回答长度差异很大(长短 CoT),容易导致显存波动,Continuous Batching + 动态分配就很关键。
权重共享不复制:Colocated 的核心优势就是"权重常驻显存"。理想做法是 Actor 权重(训练格式 FSDP/Megatron)和 Rollout 权重(推理格式 FP16/FP8,TP 切分方式不同)复用同一份显存权重,避免内存 double。
veRL 在 FSDP + vLLM(同 DP/Shard 或权重统一)这条路径上有这方面的优化。
5.3 数据流与 Experience Buffer
Rollout 一次产出是 (Prompts × G) 条 trajectories,token 数量可达数千万 token/step。如何高效传递给 Trainer 是个工程问题。
主流做法:
内存共享(Zero-Copy):用 Ray 的 Object Store(分布式共享内存)或者 GPU Direct,避免把大批 token 数据从 GPU 拷到 CPU 再拷回 GPU。
就地(In-Place)传递:在 Colocated 模式下,Trajectories 还在同一组 GPU 的显存上,Trainer 直接读取对应张量,减少拷贝。
打平(Flatten)+ Padding/Mask:不同回答长度不一,需要做 padding + attention mask + loss mask(GRPO 通常是只算 completion 部分的 loss)。
5.4 并行策略的兼容(TP/DP/FSDP/Megatron)
训练和推理的并行方式天然不同:
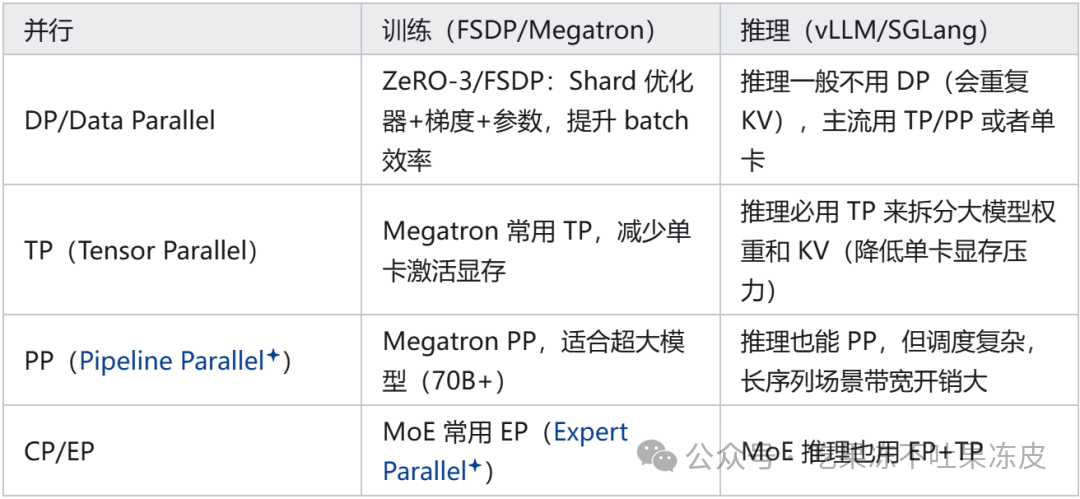 Colocated 的难点:同一批 GPU 同时要跑 FSDP(Sharded Data Parallel)和 vLLM(Tensor Parallel)。
这两种并行的切分方式不一致,权重在显存的布局(Layout)不同。如果强行共用,需要做权重重排(Weight Resharding)。
veRL 在某些组合(FSDP + vLLM TP)下会做权重转换/同步,Decoupled 则直接各自用最合适的并行方式,靠 Weight Sync 解决布局差异。
六、主流 RL Infra 框架对比(GRPO 场景)
下面按架构思路对主流框架做个对比,便于理解当前设计趋势。
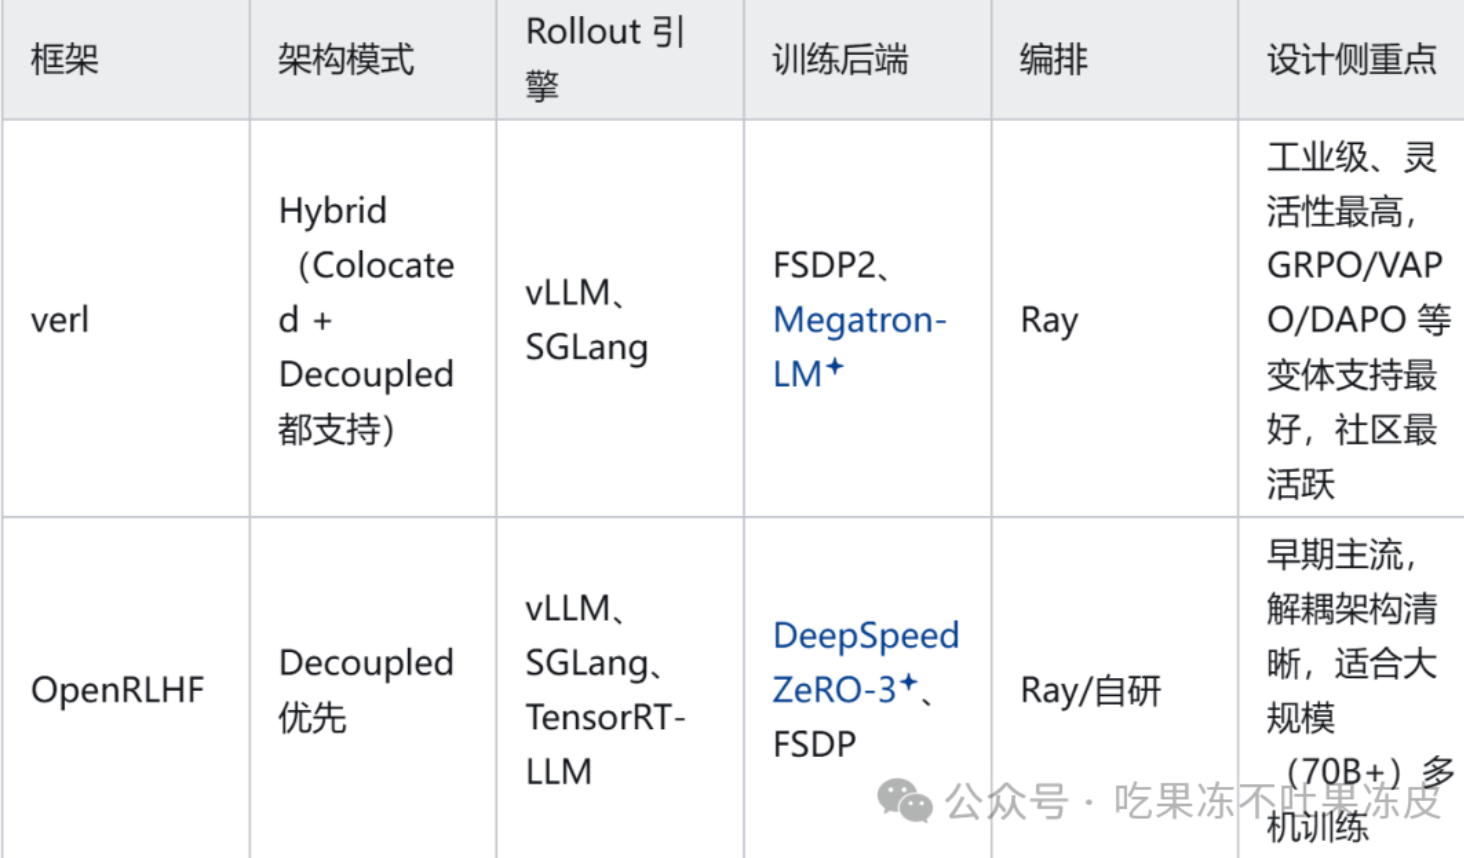
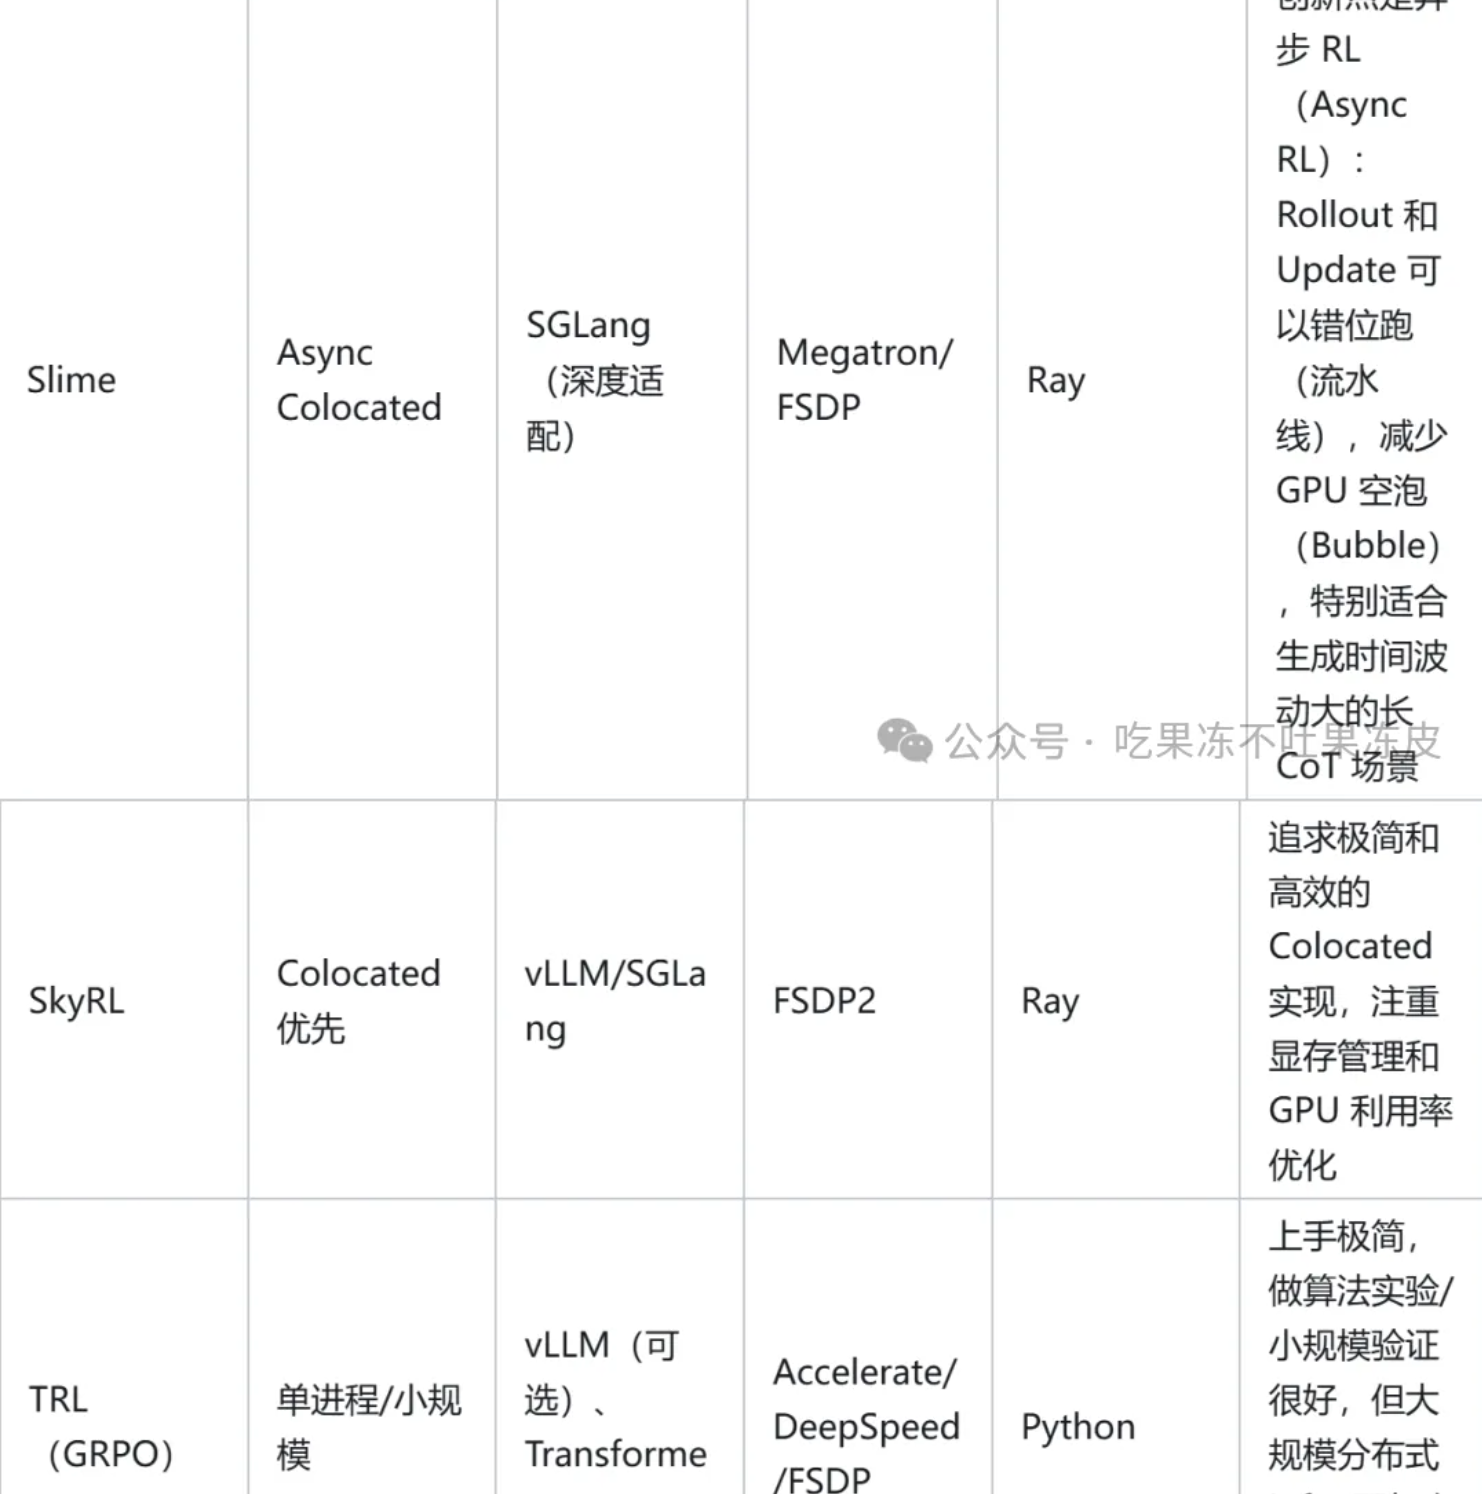
七、Colocated vs Decoupled 的核心权衡总结
简单概括成一张表:
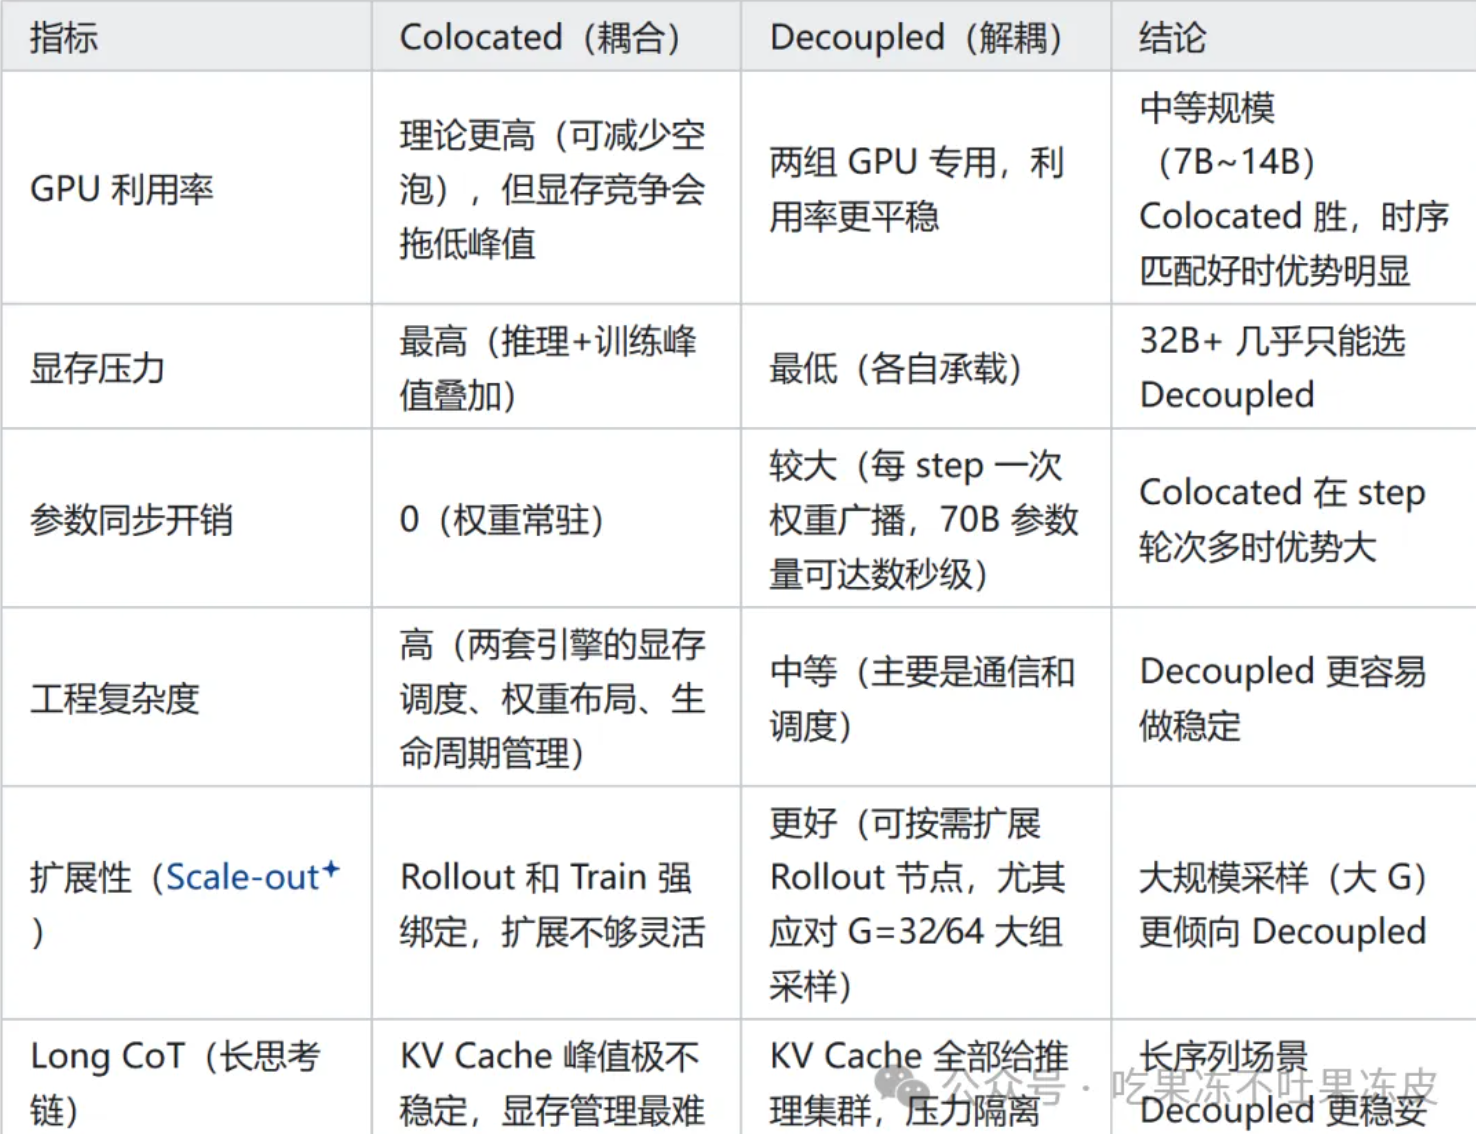
八、Infra 设计趋势
目前 GRPO/RLVR 的 Infra 正在朝两个方向演进:
向 Colocated 优化:想尽办法解决显存竞争(PagedAttention、引擎显存预留、动态 offload、权重格式统一)。veRL/SkyRL 都在往这个方向打磨,目标是"能跑起来 32B Colocated"。
向 Async(异步)演进:Slime 提出的思路是打破严格 On-Policy 的 Step 同步约束,让 Rollout 和 Update 流水线化(Pipeline),旧策略 Rollout 和新策略 Update 可以错开执行,以此掩盖空泡(Bubble)。
这类做法是牺牲一点 On-Policy 严格性,换取更高的 GPU 吞吐利用率,在长 CoT 场景特别有效。
简单总结:GRPO 的 Infra 核心矛盾是"生成(串行、自回归) vs 训练(并行、批处理)"这两种完全不同的负载如何高效共处。
Colocated = 想省去"参数搬运"这个代价,代价是"显存打架"。
Decoupled = 想省去"显存打架"这个代价,代价是"参数搬运 + 同步空泡"。
主流框架(尤其是 veRL)选择的是"HybridFlow":给你两种都能选,让你根据模型规模(7B/32B/70B)、回答长度(短回答 vs 长 CoT)、采样组数 G 去权衡这个 trade-off。这才是当前 RL Infra 设计最贴合实际落地的思路。
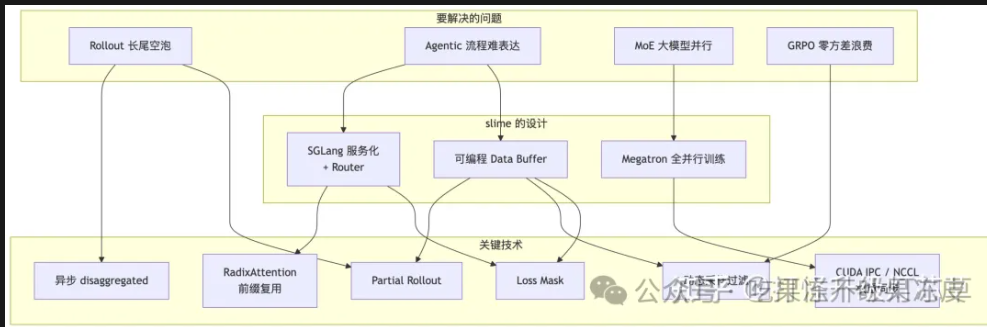
slime:SGLang-native 的 RL Scaling 框架
slime 是 THUDM(清华 / 智谱)开源的 LLM 后训练框架,专为 RL Scaling 设计,是 GLM 系列模型(GLM-4.5 / 4.6 / 4.7 及后续版本)实际 RL 后训练所用的框架。
它的定位很明确:Megatron 做训练 + SGLang 做 rollout,中间用一个可编程的 Data Buffer 连接,三者由 Ray 统一编排。
两大核心能力:
高性能训练:通过连接 Megatron 与 SGLang,支持多种模式下的高效训练;
灵活的数据生成:通过自定义数据生成接口和「服务化」的推理引擎,可以实现任意复杂的训练数据生成流程(多轮对话、工具调用、代码沙箱、搜索、多智能体......)。
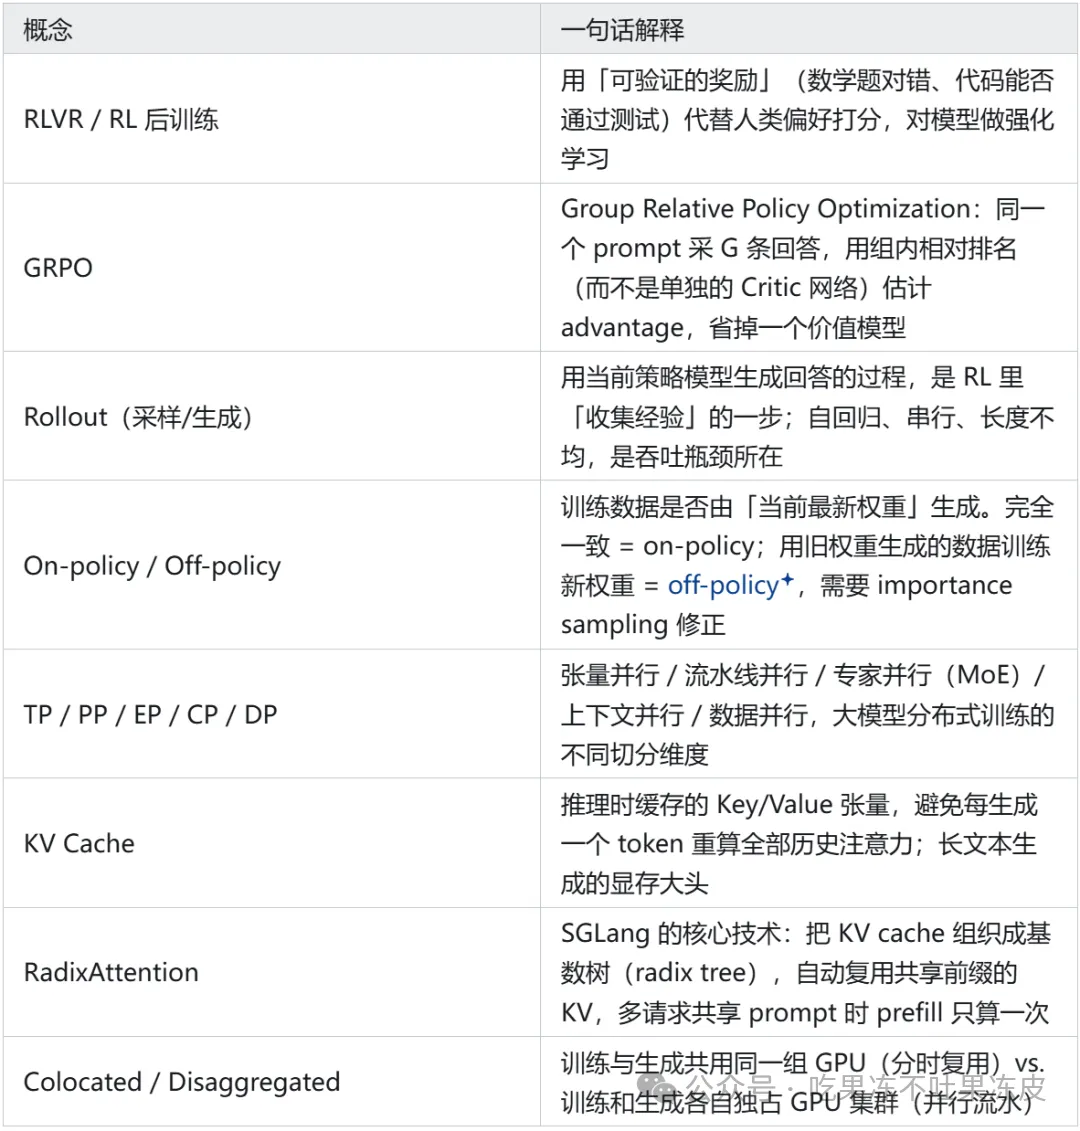
一、slime 的设计出发点
RL 后训练 Infra 的核心矛盾是 生成(自回归、串行、长尾)vs 训练(批处理、并行):
生成端:一个 token 一个 token 往外吐,单条序列长度不可预知,GPU 并行度再高也得等「这一条写完」;
训练端:一切讲究整齐------定长 batch、大规模矩阵乘、多维并行切分,最怕数据不齐、GPU 空等。
slime 观察到的几个具体痛点:
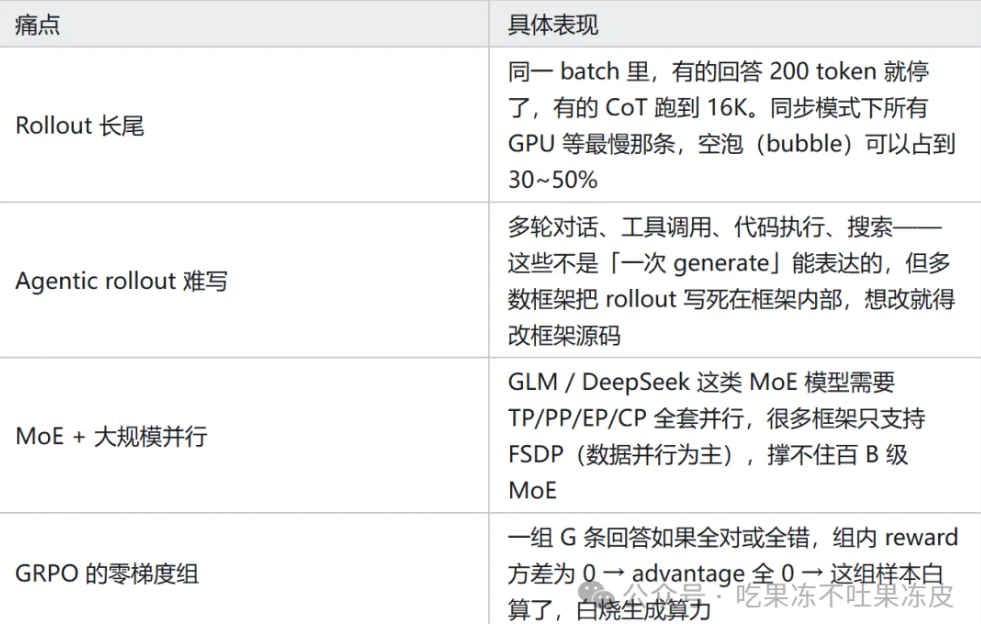
slime 的回答是:把 rollout 彻底解耦成「一个可以任意编程的异步服务调用」,训练端保持 Megatron 的全部并行能力,中间用 Buffer 解耦时序。
这句话拆开看有三个决定,每一个都对应一个痛点:
Rollout 服务化(SGLang as a service)→ 解决「agentic rollout 难写」:生成变成普通 HTTP 调用,用户爱怎么编排怎么编排;
训练端坚持 Megatron → 解决「MoE 大规模并行」:TP/PP/EP/CP 全套保留;
Buffer 做中间人 → 解决「长尾 + 时序耦合」:生成和训练节奏解耦,还能顺带做样本过滤、partial rollout 缓存。
二、三模块架构
slime 把系统拆成三个角色,用 Ray 编排(Ray 负责跨节点的进程调度、资源分配与 actor 间通信):
数据流(一次 RL 迭代的视角):
Data Buffer 从数据集取出 prompt,交给用户自定义的 rollout 函数;
rollout 函数通过 Router 向 SGLang Server 发起生成请求(可能多轮、带工具调用),拿到回答 + token 级 logprob;
reward/verifier 打分后,样本写回 Data Buffer;
Buffer 攒够一个训练 batch(过滤、打包、padding、loss mask),交给 Megatron;
Megatron 完成一次梯度更新后,把新权重同步回所有 SGLang Server,进入下一轮。
2.1 Training(Megatron-LM)
承担 Actor 更新 + Reference 模型 log-prob 计算(GRPO 里用于 KL 正则);保留 Megatron 完整的并行能力:TP / PP / EP / CP / VPP;
这是 slime 相对很多 FSDP-only 框架的硬优势:MoE 大模型(如 GLM-4.5 的 MoE 结构、DeepSeek-V3 结构)能真正跑起来。
FSDP 以数据并行为主,对 MoE 的专家并行(EP)支持很弱,而 EP 恰恰是 MoE 模型训练的刚需------每个专家只放在部分卡上,All-to-All 通信调度由 Megatron 成熟实现;
后续也加入了 FSDP 后端作为轻量选项,方便中小模型快速上手;
slime 的一个设计理念是「参数直通」:Megatron 的参数直接透传,SGLang 的参数以 --sglang- 前缀暴露,上游引擎的新优化可以直接用,框架本身不做一层「最大公约数」式的封装。
为什么不用「训推一体」的框架? 训练和推理对引擎的要求完全不同:训练要反向传播、优化器状态、梯度通信;推理要 KV cache 管理、连续批处理(continuous batching)、前缀缓存。
强行在一个引擎里同时做好两件事,往往两头不讨好。slime 的选择是让两个各自最强的引擎各干各的,代价是引入「权重同步」这个工程难题(见 4.2)。
2.2 Rollout(SGLang + Router)
关键设计:SGLang 以「服务」形式存在,而不是以「库」形式被调用。
起若干个 SGLang Server(每个 server 内部可以 TP/DP/EP),推理侧也能吃满 MoE 并行;
前面挂一个 Router 做负载均衡,把请求分发到各 server;
训练侧通过 OpenAI 兼容的 HTTP 接口 请求生成------chat/completions 那套,任何语言、任何 agent 框架都会调。
这一步看似简单,影响却很大------它把 rollout 从「框架内嵌的一段 generate 代码」变成了「任何 Python 代码都能调用的服务」:
你想做多轮工具调用?写个 while 循环调 API 就行;
你想接外部搜索、代码沙箱?在两次调用之间插入任意逻辑;
你想用现成 agent 框架(LangGraph 之类)?它本来就会调 OpenAI 接口。
对比「库形式」的方案(框架内部直接调推理引擎的 Python API):引擎升级要动框架,自定义逻辑要改框架源码,agentic 流程更是寸步难行。
2.3 Data Buffer(最有特色的部分)
Buffer 不只是个队列,它是用户可编程的 rollout 编排层。用户通过实现一个 generate_rollout 函数来完全控制数据怎么生成:
伪代码:用户自定义的 rollout 函数
async def generate_rollout(args, rollout_id, data_buffer, evaluation=False):
prompts = data_buffer.get_samples(args.rollout_batch_size)
tasks = \[\]
for p in prompts:
for _ in range(args.n_samples_per_prompt): # GRPO 的 G:每个 prompt 采 G 条
tasks.append(rollout_one§)
samples = await asyncio.gather(*tasks) # 全部并发跑
return post_filter(samples) # 过滤(见 4.3)
async def rollout_one(prompt):
msgs = {"role": "user", "content": prompt}
for turn in range(MAX_TURNS): # 多轮 / agentic
resp = await sglang_client.chat(msgs,
return_logprob=True) # GRPO 需要 old logprob 算 ratio
if has_tool_call(resp):
obs = await run_tool(resp) # 工具 / 代码沙箱 / 搜索
msgs += resp, obs
continue
break
reward = await verifier(prompt, resp) # rule / model / sandbox 打分
return Sample(tokens=..., logprobs=..., reward=reward,
loss_mask=mask_out_tool_output()) # 关键:屏蔽环境返回(见 4.4)
注意 return_logprob=True 这一行:GRPO/PPO 类算法需要计算 importance ratio πθ/πold,其中分母是生成时策略的 logprob,必须在 rollout 阶段就记录下来,不能事后重算(推理引擎和训练引擎的数值实现有差异,事后重算会引入偏差)。
Buffer 同时负责:
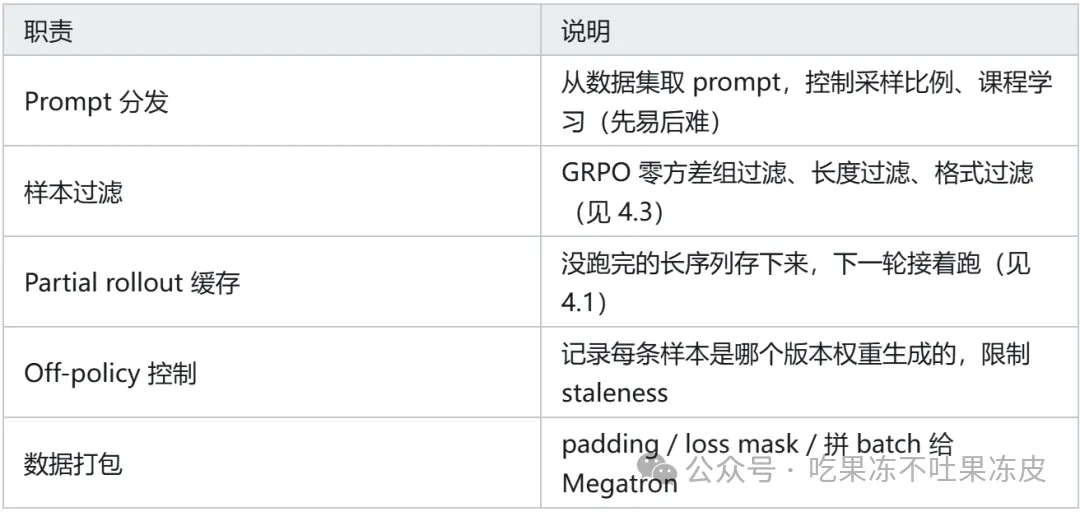 三、两种运行模式
slime 同时支持同步 colocated 和异步 disaggregated,这是它的核心灵活性。
先理解这两个维度是独立的:
Colocated vs Disaggregated:训练和生成是否共用 GPU(空间维度);
同步 vs 异步:生成和训练是否等待彼此(时间维度)。
3.1 Colocated + Synchronous(同 GPU、同步)
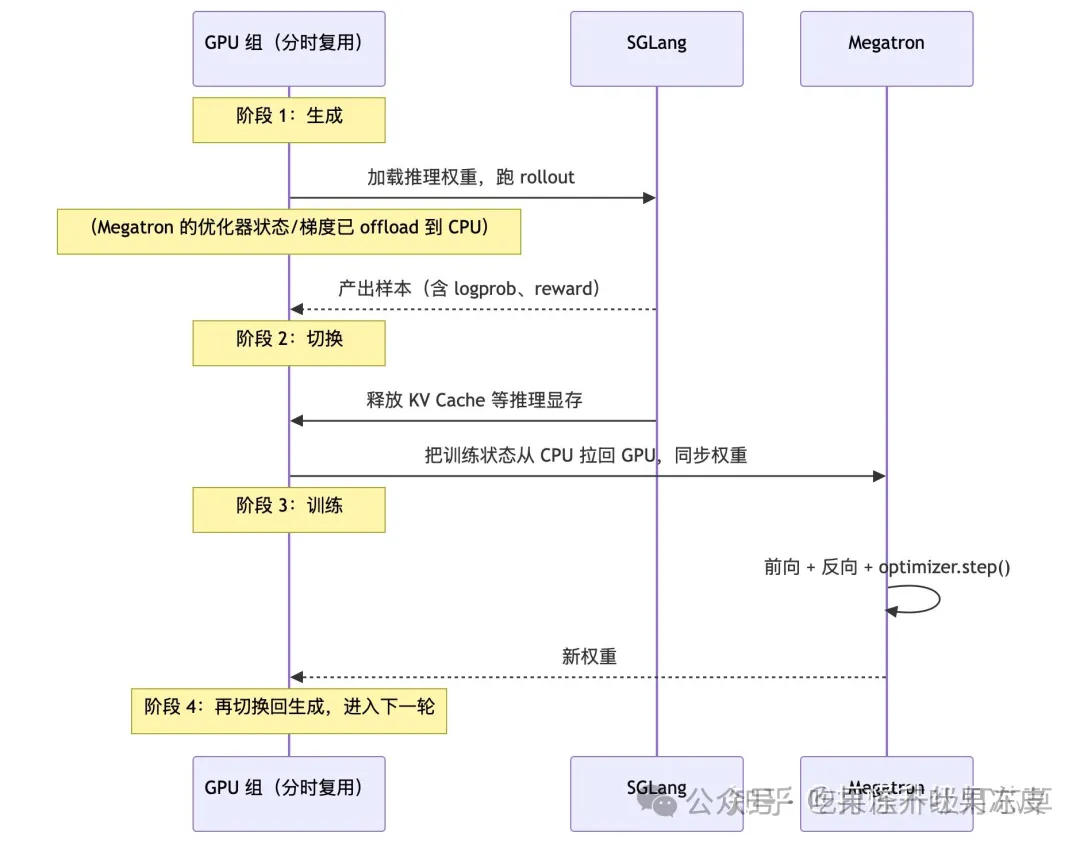
一组 GPU 分时复用:生成时把 Megatron 的优化器状态/梯度 offload 到 CPU,训练时释放 SGLang 的 KV Cache;
严格 on-policy:生成用的权重和训练用的权重严格一致,算法行为最干净;
适合:中小规模、算法研究、需要严格复现的场景。
3.2 Disaggregated + Asynchronous(分离、异步)
这是 slime 最主打的模式:
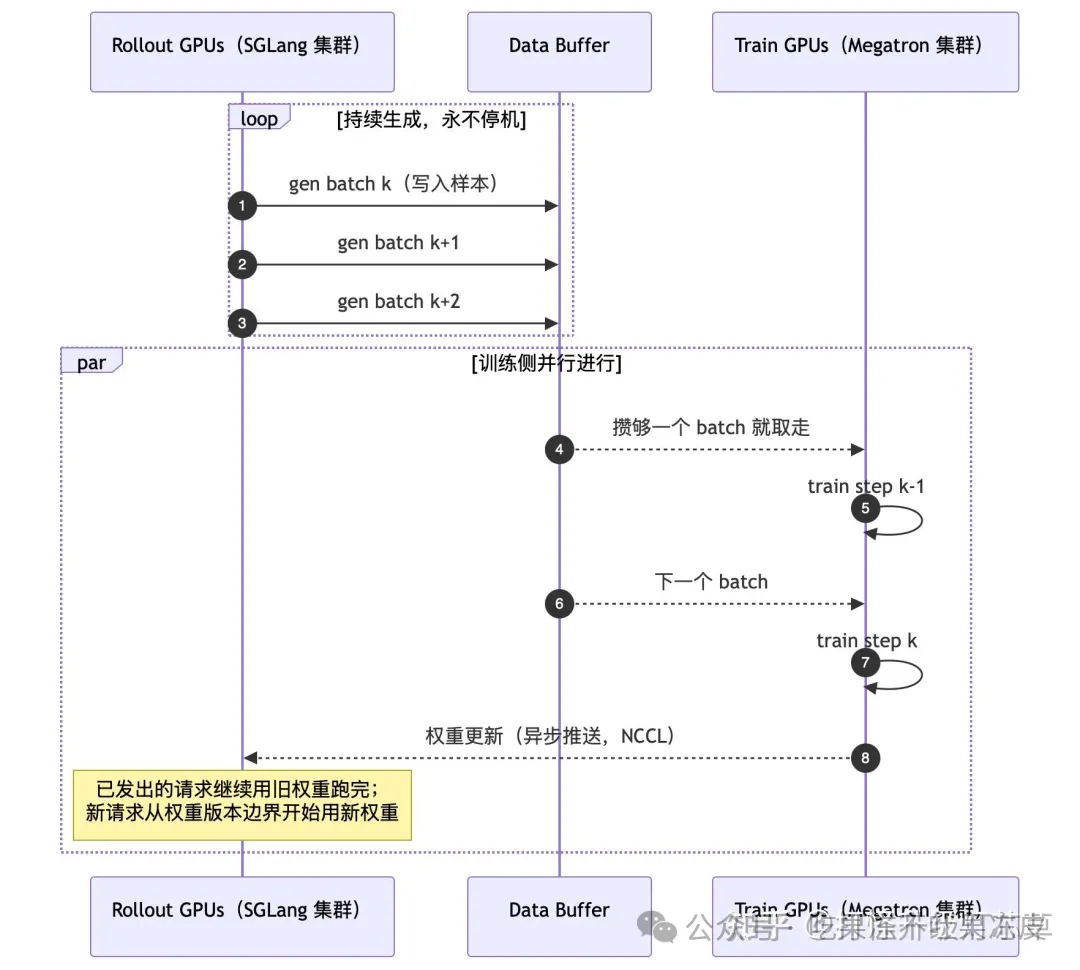
关键:Rollout 不等训练,训练不等 Rollout。
Rollout 集群持续满负荷生成,永远有活干;
训练集群一攒够一个 batch 的数据就更新;
权重更新后异步推给 Rollout,Rollout 在下一条请求开始用新权重(已在飞行中的请求继续用旧权重跑完,保证单条样本内部一致性)。
代价是引入 off-policy 偏差:训练时用的样本可能是 1~2 个版本之前的权重生成的。
slime 的处理方式:
Staleness 上限约束:比如最多落后 1 个 step,把偏差控制在可接受范围(对应参数如 --async-buffer-size、--update-weights-interval,控制缓冲多少批数据、隔几次采样同步一次权重);
算法自带容忍度:GRPO/PPO 本身就有 importance sampling ratio
- clip 机制,clip 会把 ratio 偏离 1 太远的样本梯度截掉,对轻度 off-policy 有一定容忍度;
实践验证:1-step 异步对最终效果影响很小,但吞吐提升显著。
直观理解 staleness:想象你在教一个不断进化的学生做题。同步模式 = 学生每学会一点就立刻用新水平出新题给自己做;异步模式 = 老师(训练端)和学生(生成端)各干各的,学生做的题可能基于「稍微过时」的水平。
只要别落后太多(staleness ≤ 1),教学效果几乎不变,但两边都不用等对方,总吞吐接近翻倍。
四、slime 的几个关键技术点
4.1 Partial Rollout(长尾杀手)
这是针对 long CoT 最有效的优化之一。
问题:一个 batch 里 95% 的回答 2K token 就结束,剩下 5% 要跑到 32K。同步等待意味着 95% 的算力在最后阶段闲置------GPU 数量没变,但干活的人从几百个变成几个。
做法:给 rollout 设一个「预算」(时间或 token 数)。到点还没生成完的序列不硬等,而是截断、缓存、下一轮接着生成:
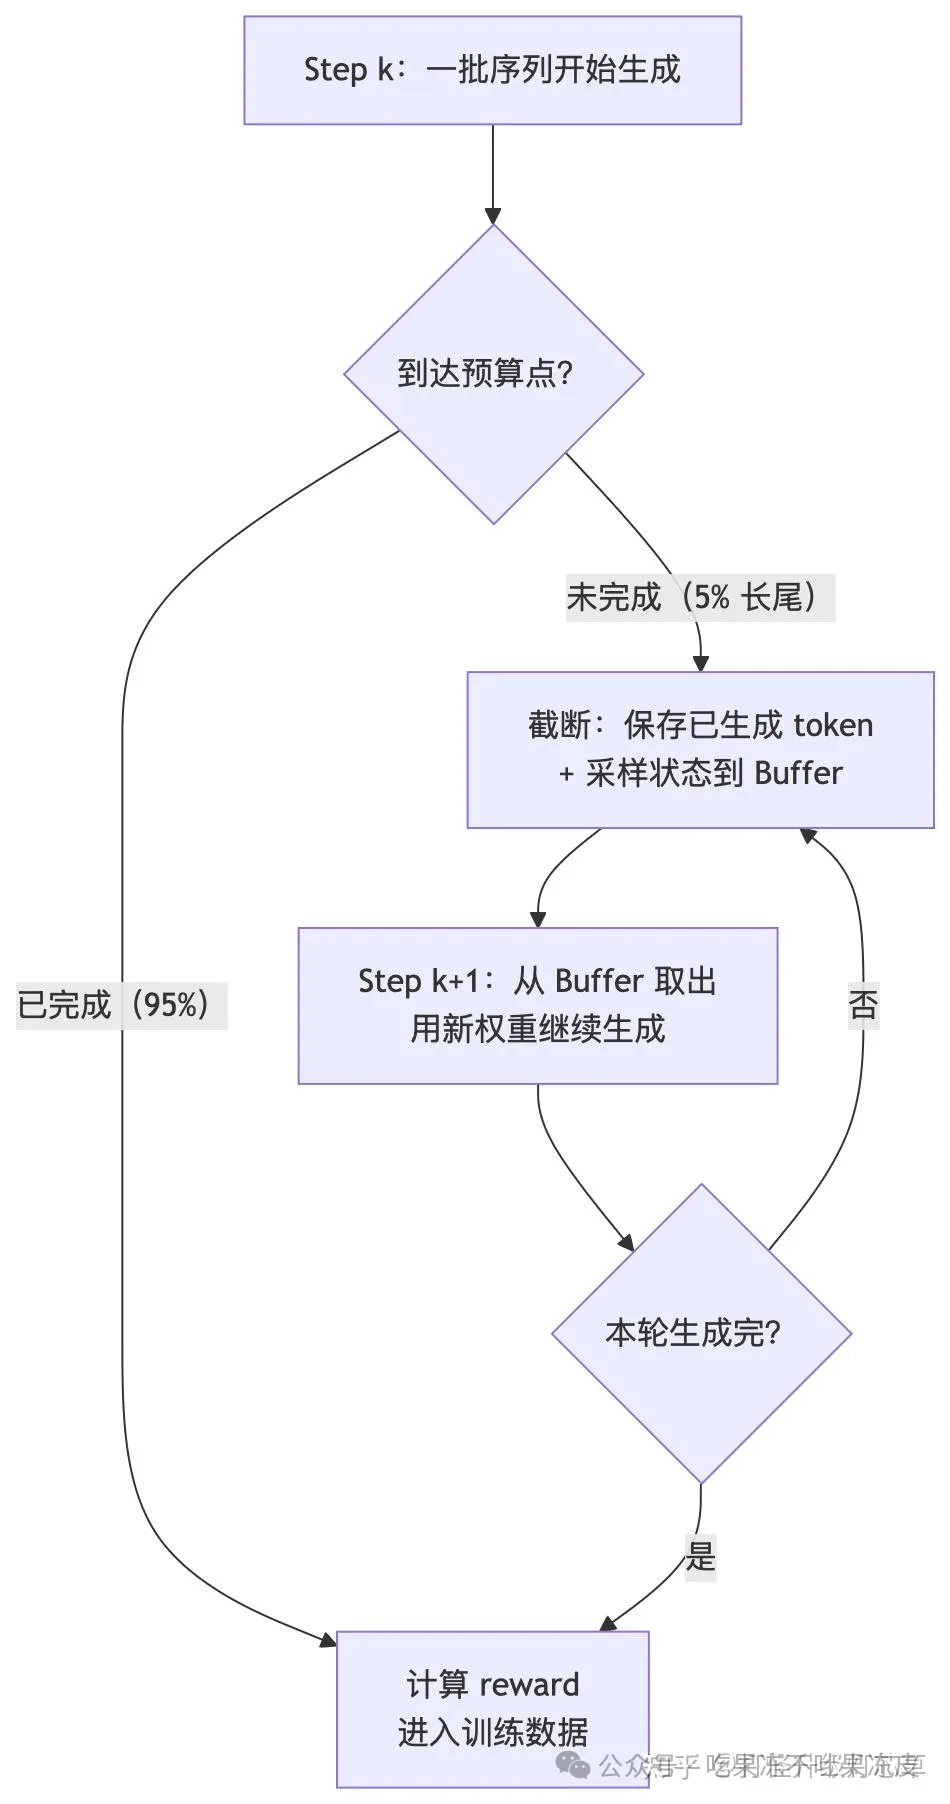
效果:
消除长尾等待:每个 step 的生成都按时长/token 预算「齐步走」,GPU 利用率大幅提升;
副作用:一条序列可能横跨多个权重版本(「缝合」样本------前半段是权重 k 生成的,后半段是权重 k+1 生成的),是一种更强的 off-policy,需要配合 staleness 控制和 importance ratio 处理;
本质上这是把「按样本同步」改成了「按预算同步」,用一点点算法上的近似换巨大的吞吐收益。
4.2 参数同步:Megatron → SGLang
这是 disaggregated 架构的关键开销点。两边权重布局完全不一样,不能直接拷:
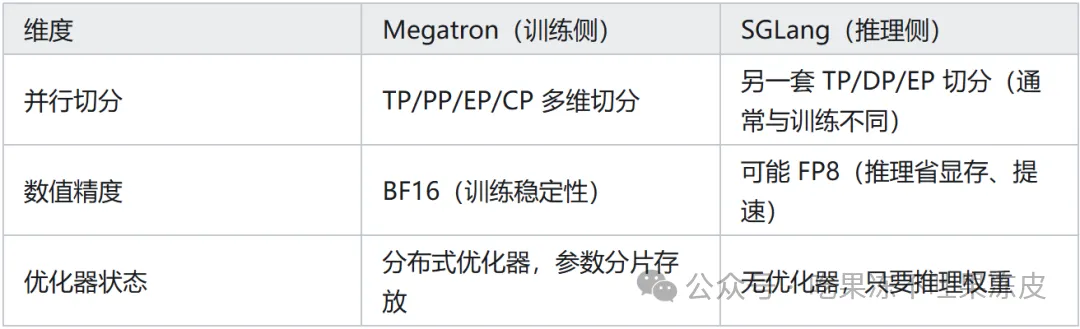
slime 的处理(两种模式走不同的 API 路径):
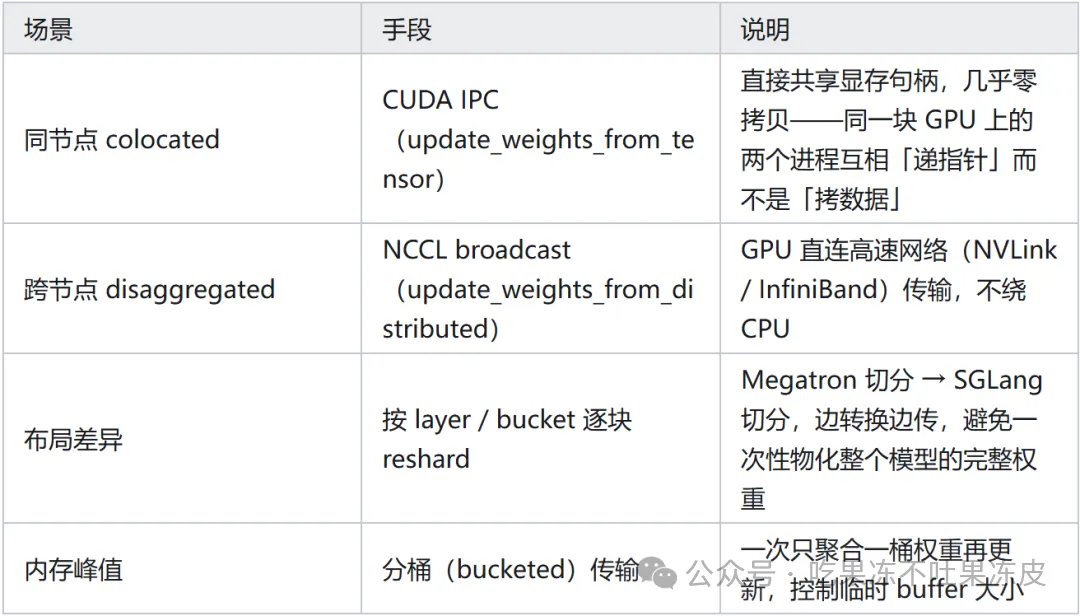
工程上还有一串针对 MoE 的优化(MoE 模型有大量小张量------每个专家的权重都不大但数量多):
异步聚合:训练端合并 DP/TP/EP 分片时流水线化,聚合和传输重叠,吃满带宽;
桶更新:SGLang 侧通过请求更新权重,按桶批量更新,避免「一个 tensor 一次请求」的开销;
合并小张量:减少 CUDA IPC 句柄的频繁创建和清理;
缓存元信息:重复的切分查询只算一次。
对 100B+ MoE 模型,这块工程量很大,也是 slime 相对成熟的地方------权重同步如果做得粗糙,每步可能要花几分钟,直接抵消异步架构的收益。
4.3 GRPO 专属:零方差组过滤/动态采样
GRPO 的 advantage 计算(组内归一化):
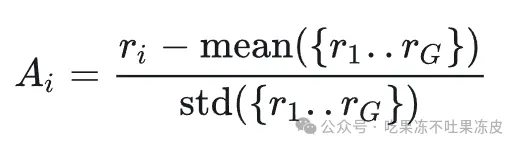
如果一组 G 条全对(reward 全 1)或全错(全 0)→ std=0,advantage 全为 0,梯度为零。
直觉上:模型从「大家都一样」的组里学不到任何东西------没有比较就没有方向。
在数学/代码 RLVR 里,简单题全对、难题全错的比例可能高达 40%+,意味着近一半的生成算力被浪费。
slime 在 Buffer 层做 over-sampling + dynamic filtering(DAPO 的思路):
valid = \[\]
while len(valid) < target_batch_size:
batch = await rollout(oversample_ratio * target) # 多采一些
for group in group_by_prompt(batch):
if std(group.rewards) > eps: # 组内有区分度才保留
valid.extend(group)
为什么这个策略在异步架构下特别自然:同步框架里,过滤掉的样本意味着训练侧干等重采------GPU 空转;而在 slime 的异步架构里,Rollout 集群本来就在持续产出、Buffer 里永远有存货,过滤只是「从更大的池子里挑好的」,训练侧完全无感。
这是「架构红利」的一个典型例子:同样的算法技巧,换个架构就从「昂贵」变成「免费」。
4.4 Loss Mask 与多轮/工具场景
agentic rollout 里,序列 = 用户输入 + 模型输出 + 工具返回 + 模型输出 + ...。
工具返回的 token 不是模型生成的,绝不能算 loss------否则模型会学着「模仿工具返回格式」,而不是学会「决定什么时候调工具」。
slime 让用户在自定义 rollout 函数里直接构造 loss_mask(1 = 算 loss,0 = 跳过),把环境 token 屏蔽掉:
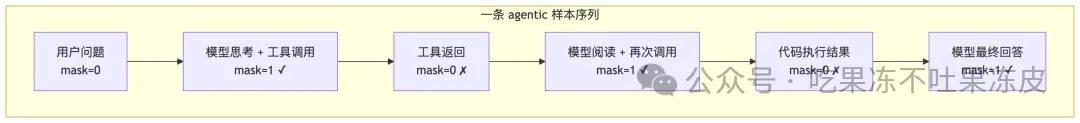
这在把 rollout 写死在框架里的方案中往往需要改框架源码,而在 slime 里只是用户函数里多写几行。
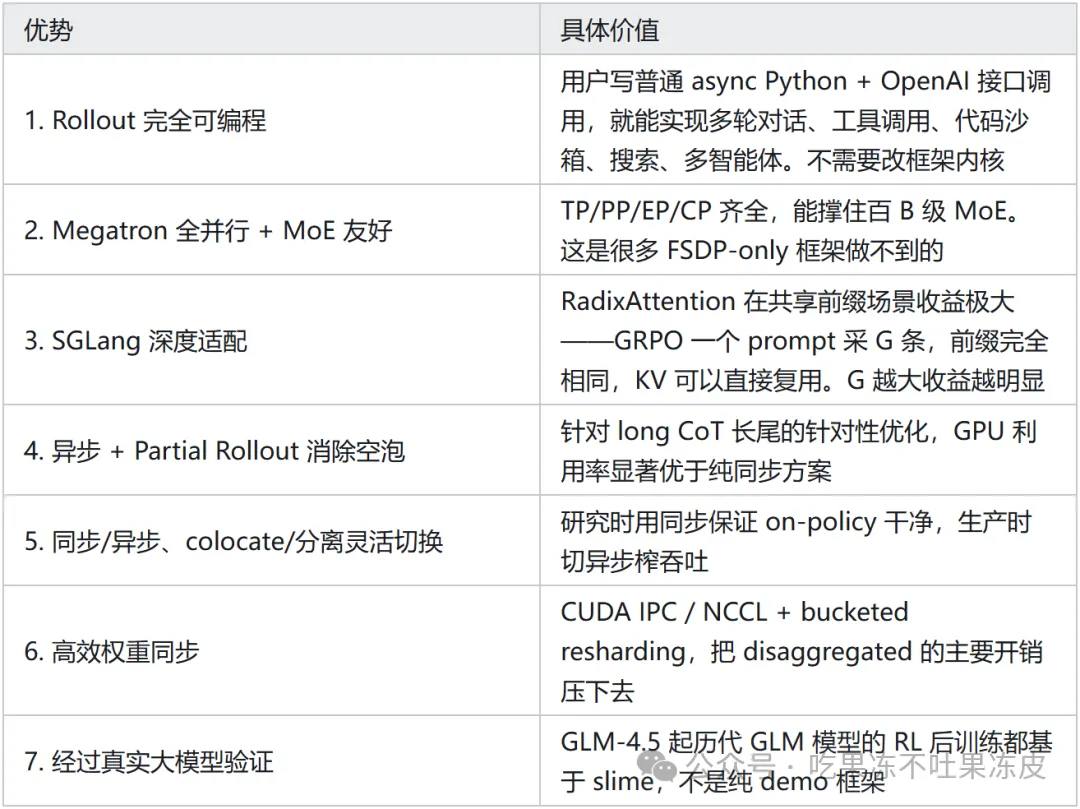
五、slime 的优势总结
RadixAttention 对 GRPO 的意义(值得单独说)
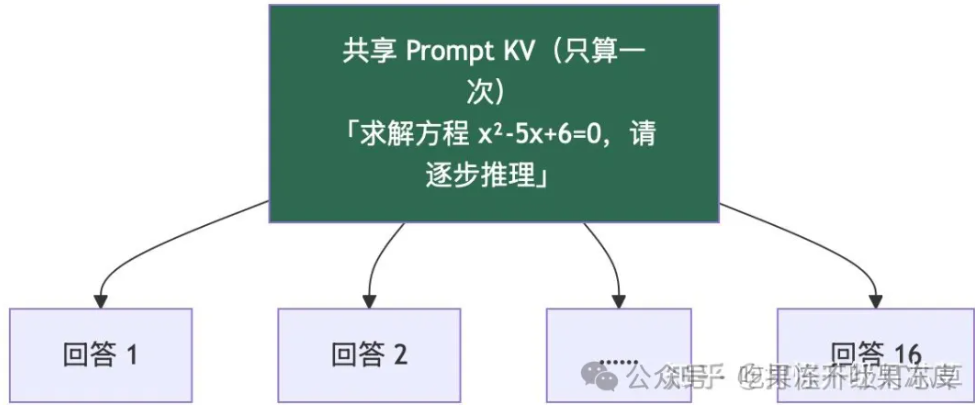
在 GRPO 里 G 通常 8~32,prompt 又常常很长(few-shot 示例、系统提示、题目描述)。
如果没有前缀复用,G 条回答要重复 prefill G 次同样的 prompt------G=16 意味着 15⁄16 的 prompt prefill 是纯浪费。
RadixAttention 把 KV cache 组织成基数树,相同前缀自动命中缓存:
• 省 prefill 计算:prompt 只算一次,G 条样本共享;
• 省 KV 显存:前缀的 KV 只存一份;
G 越大、prompt 越长,优势越明显------这恰好就是 RLVR 的典型负载形态。
可以说 GRPO 和 RadixAttention 是「天作之合」,这也是 slime 选择深度绑定单一推理引擎(而不是抽象适配多个引擎、落到最大公约数能力)的核心回报之一。
六、与 verl/OpenRLHF 的定位对比
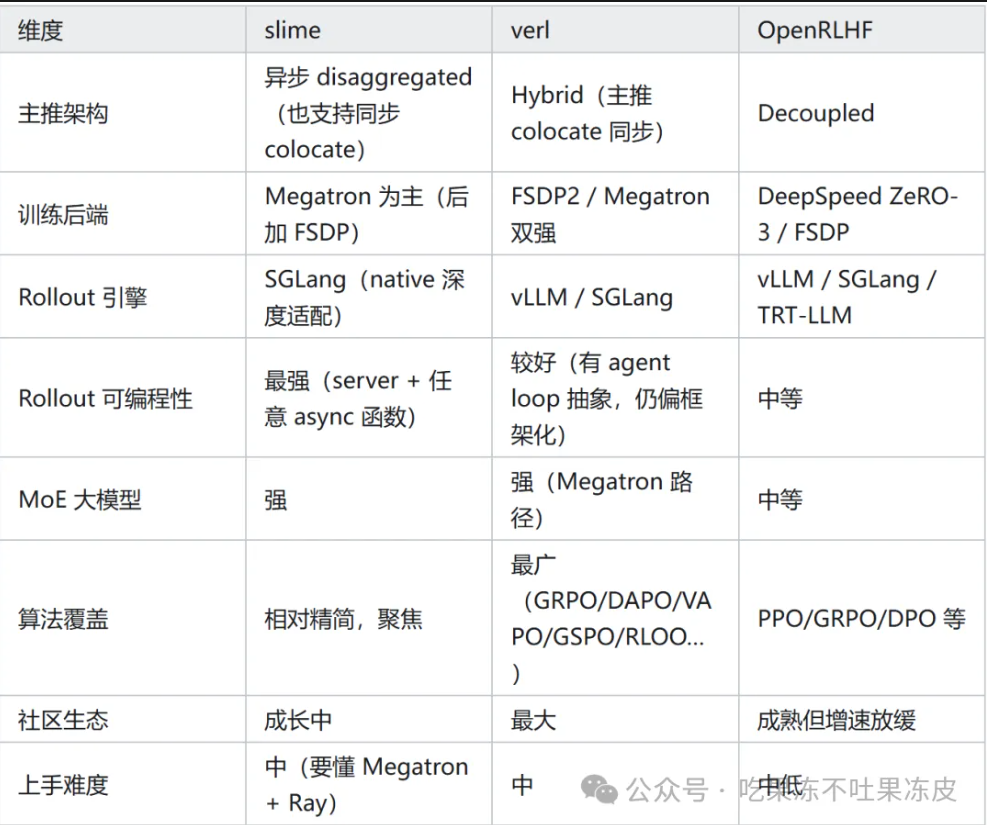
三者背后的设计哲学差异:
slime:押注「单一最优组合」(Megatron + SGLang),用深度绑定换极致性能和简洁抽象面;
verl:押注「最大灵活性」,用混合执行引擎(hybrid engine)和广泛适配换生态广度;
OpenRLHF:押注「经典 RLHF 流程的易用性」,DeepSpeed 栈对很多团队更熟悉。
02
选型建议
选 slime:
要做 agentic RL(多轮工具调用、代码执行、搜索、环境交互);
训 大规模 MoE 模型;
long CoT 长尾严重,需要异步 / partial rollout 榨 GPU 利用率;
已有 Megatron + SGLang 技术栈。
选 verl:
想尝试多种 RL 算法变体、跟进最新论文实现;
需要最大的社区支持和文档;
中等规模 dense 模型(7B~32B)的标准 RLVR。
选 OpenRLHF:
经典 RLHF 流程(SFT → RM → PPO);
团队熟悉 DeepSpeed。
七、需要注意的代价
slime 的优势不是免费的:
异步 = off-policy。partial rollout 更是让单条序列跨版本。
虽然有 clip + staleness 控制,但在某些任务上仍可能影响收敛稳定性,需要调 staleness 上限、监控 importance ratio 分布(如果大量样本 ratio 被 clip,说明 off-policy 程度已经影响学习了)。
Megatron 门槛。并行配置(TP×PP×EP×CP 怎么组合才不把显存/通信打爆)、checkpoint 转换、debug 难度都高于 FSDP。FSDP 是「一键切分」,Megatron 是「手动调琴」。
调试复杂度。Ray + 多进程 + HTTP server + 异步,出问题时定位链路长(是 rollout 慢?权重没同步?还是 buffer 卡住?)。
slime 提供了 rollout-only / train-only 的独立调试路径和 trace 工具,但最稳妥的建议仍然是:先用同步 colocate 模式跑通,再切异步。
算法生态相对精简。想直接用某个冷门算法变体,可能得自己实现------好在 GRPO 家族的变体大多只需要改 advantage 计算和 Buffer 过滤逻辑,改起来不算深。
八、一张图回顾全文