让故障自己找到主人:前端错误的归并、反解与分派系统
线上出现一条 TypeError,并不等于团队已经知道了问题:它可能来自哪个异步 chunk,影响了哪一批灰度用户,是否与刚刚发布的版本有关,应该交给订单域还是基础组件团队,修复后是否真的消失。
因此,错误治理的核心目标不应是"上报一个错误",而是让原始信号在有限时间内转换为一个可定位、可归并、可分派、可验证的问题对象。
本文关注的不是如何证明某个错误属于某次发布,而是:错误已经发生后,系统如何让它找到正确的主人,并避免同一根因裂变成成百上千个告警。
一、先把错误入口拆开:捕获不是一个开关
浏览器中的错误来自多条通道。只依赖 window.onerror,会遗漏未处理的 Promise 拒绝;只依赖框架错误边界,又会遗漏框架之外的运行时错误、资源错误和业务语义错误。
| 错误通道 | 典型例子 | 主要采集层 | 采集层职责 |
|---|---|---|---|
| 同步运行时异常 | 事件处理器中的 throw、脚本执行错误 |
window 的 error 监听 |
收集异常、文件、行列号与堆栈 |
| 未处理 Promise 拒绝 | async 函数抛错后无人处理 |
unhandledrejection,必要时结合 rejectionhandled |
收集 rejection 原因,并处理延迟挂载的拒绝处理器 |
| 资源加载失败 | script、link、img、异步 chunk 加载失败 |
捕获阶段的 error 监听、加载器封装 |
标明资源 URL、类型和加载上下文 |
| 框架渲染错误 | React 渲染树失败、Vue 生命周期异常 | Error Boundary、Vue errorHandler |
恢复局部 UI,并补充组件和框架上下文 |
| 网络与业务失败 | 超时、5xx、GraphQL errors、关键接口返回非法状态 | 请求拦截层、业务适配层 | 判断是否是真正需要治理的故障 |
| 主动上报 | 关键流程无法继续、领域不变量被破坏 | 业务代码 | 提供机器无法推断的业务语义 |
Window 的 error 事件主要用于脚本执行异常,也会接收资源加载错误;没有 rejection handler 的 Promise 通常会触发 unhandledrejection。对于跨域脚本,浏览器可能不会向宿主页面暴露足够的信息,甚至不会触发宿主可以利用的 rejection 事件。因此,第三方脚本、远程模块和微前端子应用不能假设宿主页面能够兜底捕获一切。(developer.mozilla.org)
这里应坚持三条职责边界:
- 全局层负责发现:尽可能保留异常原貌,不擅自解释业务含义。
- 框架层负责恢复与补充上下文 :例如 React Error Boundary 用于捕获子树渲染异常并展示 fallback;Vue 的
app.config.errorHandler可以补充组件实例和错误来源。它们不是全局采集的替代品。(react.dev) - 业务层负责判定影响:支付提交失败与可重试的列表刷新失败,不应获得相同严重度。
对 Promise rejection 还要区分两个时点:浏览器通常在当前任务检查不到拒绝处理器时触发 unhandledrejection;如果之后又挂载了处理器,可能触发 rejectionhandled。SDK 可以利用这两个事件标记事件状态,但不应假设所有异步链都能可靠地产生"恢复信号"。更稳妥的做法是:先将事件标为 provisional,短暂观察后再决定是否创建正式 Issue;对于已经明确影响用户流程的 rejection,则不应为了等待状态变化而延迟必要告警。
二、把异常变成可计算对象,而不是一段 message
可扩展系统不应把版本、用户、路由和请求信息都塞进 message 或零散标签里。可以把事件划分为 error、runtime、release、navigation、request、ownership 六个命名空间,再单独设置隐私控制字段。
ts
interface FrontendErrorEvent {
  eventId: string
  occurredAt: string
  channel: 'runtime' | 'promise' | 'resource' | 'framework' | 'network' | 'business'

  error: {
    type: string
    message: string
    stack?: string
    causeChain?: Array<{ type: string; message: string }>
    handled: boolean
  }

  runtime: {
    appId: string
    browser: string
    os: string
    locale?: string
    networkType?: string
  }

  release: {
    releaseId: string
    buildId: string
    deploymentId?: string
    cohortId?: string
  }

  navigation: {
    routeTemplate: string
    previousRoute?: string
    // pageUrl 如需保留,应先移除 query、fragment 和敏感路径参数
    pageUrl?: string
  }

  asset?: {
    url: string
    contentHash?: string
    debugId?: string
    chunkName?: string
  }

  request?: {
    method: string
    routeTemplate: string
    status?: number
    traceId?: string
    retryCount?: number
  }

  ownership?: {
    app?: string
    domain?: string
    candidateOwner?: string
  }

  privacy?: {
    redactionVersion: string
    fieldsRedacted: string[]
  }
}
异常对象至少应保留 type、message 和 stacktrace;这是 OpenTelemetry 对异常事件建议采用的核心字段。请求关联则应优先使用低基数的路由模板、方法、状态码和链路标识,而不是默认采集完整查询参数、请求体、Cookie 或认证头。(opentelemetry.io)
字段并不都服务于同一种决策:
- 展示与排查:完整堆栈、面包屑、近期操作、浏览器环境。
- 归并:错误类型、规范化消息、反解后的首个应用帧、必要的路由域。
- 归因:源码路径、子应用、业务域、发布批次、代码所有者。
- 隐私控制:字段来源、脱敏状态、保留期限和访问级别。
例如,把订单号拼入错误消息,会让同一根因被拆成大量 Issue;把完整请求体作为默认上下文,则可能使错误平台成为敏感信息汇集点。pageUrl 也不应默认等同于原始地址,至少要移除 query、fragment 以及可识别用户的路径参数。
三、归并要分两阶段:先去重,再在反解后重算
错误分组常见的失败包括:动态 ID 使消息不断变化;压缩函数名和位置让同一根因看起来不同;包装异常掩盖了真正的 cause;框架层与全局层重复上报;同一错误因路由差异被错误拆分,或不同业务故障被错误合并。
解决方式不是寻找一个"完美哈希",而是建立两阶段归并。
阶段一:原始事件去重
客户端生成短时去重键,避免同一次异常被多个监听器重复发送:
text
raw_dedupe_key = hash(
  channel + error.type + normalize(error.message) +
  topGeneratedFrame.file + topGeneratedFrame.line + topGeneratedFrame.column +
  navigation.routeTemplate + timeBucket(3s)
)
它只负责抑制重复传播,不能作为最终 Issue 指纹。客户端还应维护一次事件的作用域标记:框架 Error Boundary、请求拦截器和全局监听器若观察到同一异常,应通过事件 ID、错误对象弱引用或作用域 ID 关联,而不是依赖某一种冒泡行为。
在 React 中,被 Error Boundary 捕获的错误不会继续冒泡到祖先 Error Boundary;事件处理器中的错误也不属于 Error Boundary 的捕获范围。因此,SDK 不能把"是否冒泡到全局"当成重复判断的唯一依据。(react.dev)
阶段二:Source Map 反解后归并
服务端拿到原始堆栈后,先确认产物身份,再进行反解,最后计算稳定指纹:
text
issue_fingerprint = hash(
  canonicalErrorType +
  normalizedRootCauseMessage +
  firstInAppSourceFrame.file +
  firstInAppSourceFrame.function +
  routeDomain
)
其中:
canonicalErrorType:优先取可解释的内层cause类型,但要保留外层异常链;normalizedRootCauseMessage:删除订单号、UUID、时间戳和动态数字片段,同时避免过度清洗导致不同根因相撞;firstInAppSourceFrame:跳过浏览器、框架和明确标记为第三方的依赖帧,取首个业务源码帧;routeDomain:只在确有行动价值时参与拆分,不能把完整 URL 纳入指纹。
指纹应允许受控覆盖。例如,同一底层 SDK 错误同时影响支付和登录,可能需要按业务域拆成两个可行动的问题;反之,浏览器文案差异不应生成数百个 Issue。每次覆盖都应记录规则版本和命中原因,便于审计与回滚。
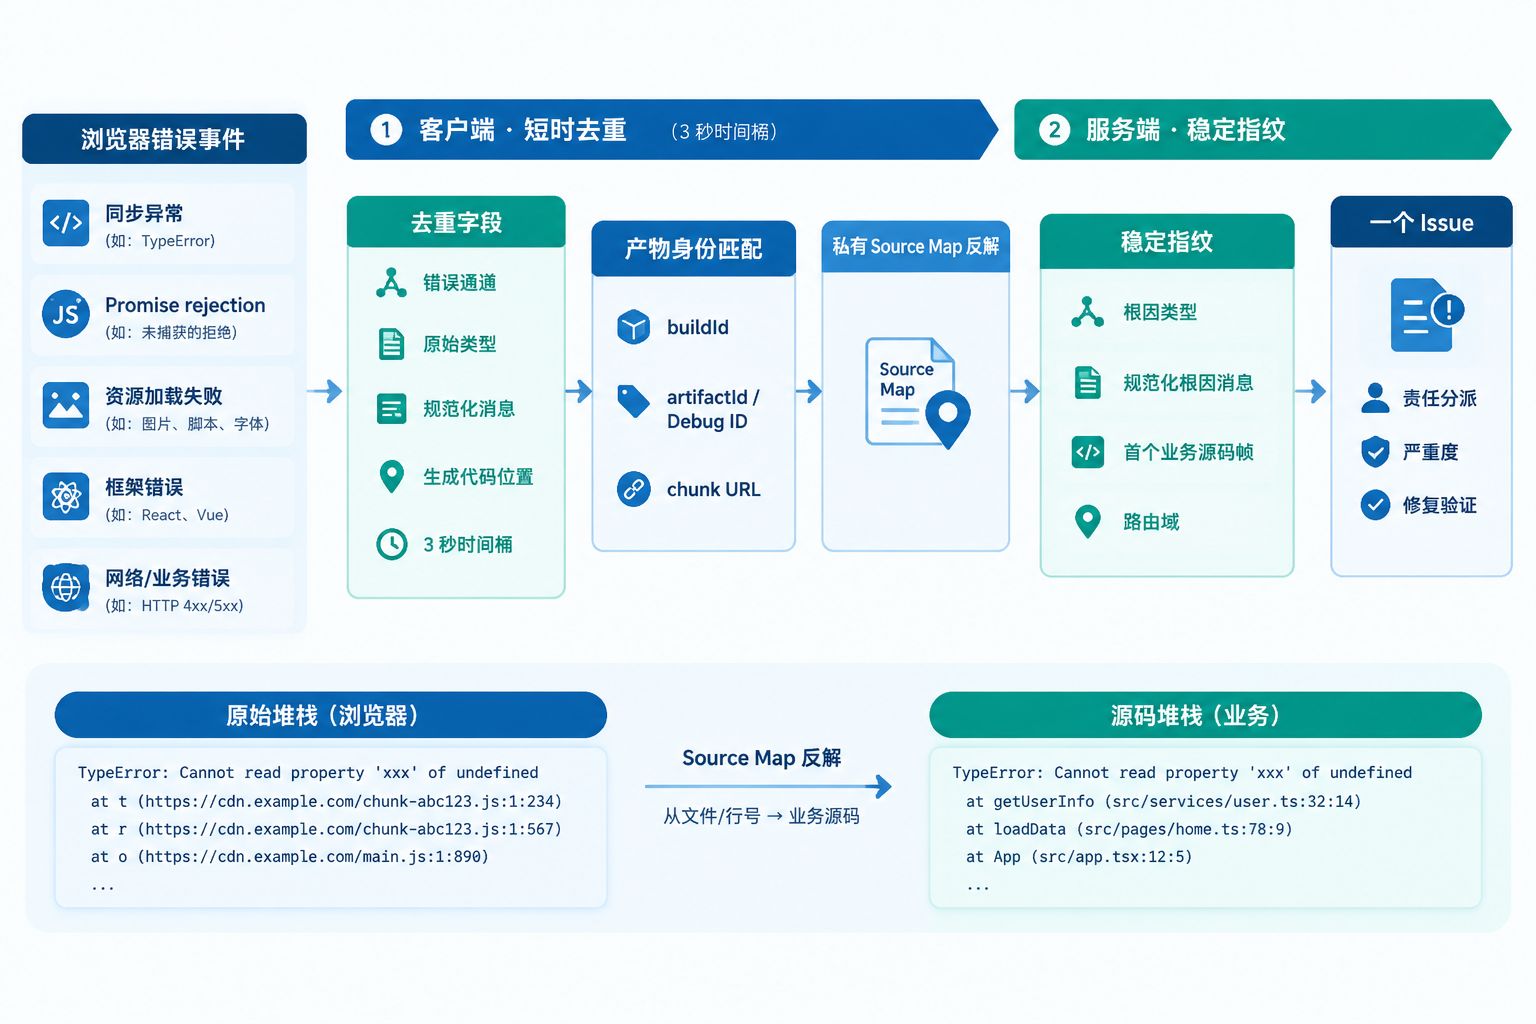
四、Source Map 不是附件,而是发布资产
Source Map 用于把生成代码中的行列位置映射回原始源码。其标准格式为 JSON,常见字段包括 file、sourceRoot、sources、sourcesContent、names 与 mappings;生成文件可以通过 SourceMap 响应头或 sourceMappingURL 注释关联映射文件。(tc39.es)
但治理系统真正依赖的不是"存在一份 map",而是下面这个不变量:
线上堆栈中的生成文件,必须能够唯一匹配到它实际执行时对应的 JavaScript 产物和 Source Map。
因此,releaseId 不应承担所有身份职责。推荐至少区分:
| 标识 | 回答的问题 |
|---|---|
releaseId |
这次代码逻辑属于哪个发布版本? |
buildId |
这份构建产物是哪次构建生成的? |
artifactId / 内容哈希 / Debug ID |
这个具体 chunk 对应哪份 map? |
deploymentId |
它被部署到哪个环境、区域或批次? |
cohortId |
哪一组灰度用户实际拿到了它? |
为什么映射会失效
Source Map 失效通常不是简单地"忘了上传 .map",而是身份链条某处断裂:
- 上传的是
build-101的 map,但 CDN 实际提供的是build-102的 chunk; - 异步 chunk 文件名复用,内容却被覆盖;
- 压缩器或 loader 转换代码后没有正确传递 map;
- 错误事件中的资源 URL 与符号服务保存的产物路径不一致;
- 回滚后旧 HTML、旧 CDN 缓存和新入口文件形成混合版本;
- 微前端子应用独立发布,但错误仍被宿主的版本号覆盖。
webpack 文档指出,缺少列映射的 cheap 类 Source Map 不适合压缩代码的精确定位;转换代码却未返回 map 的 loader 也会造成栈位置偏移,而构建未必报错。(webpack.js.org)
推荐的发布顺序
将 Source Map 管理纳入 CI/CD 的不可逆步骤:
text
构建产物
  → 注入 buildId / artifactId
  → 校验 JS 与 map 的一一对应
  → 上传 JS、map 与产物清单到私有符号服务
  → 通过校验后部署静态资源
  → 激活发布与灰度批次
错误平台要完成反解,需要同时具备实际执行的压缩 JavaScript 与对应 Source Map,且资源路径和调试元数据能够精确匹配。(docs.sentry.io)
五、生产环境的 Map 应私有保存,而非默认公开
"生成 Source Map"与"把 Source Map 部署到公网"是两件事。
对于只服务于错误反解的生产应用,更稳妥的策略是:生成 map、上传至私有符号服务,并从公开静态资源中移除 map。Vite 的 build.sourcemap: 'hidden' 会生成 map 但不在 bundle 中加入映射注释;webpack 的 hidden-source-map 也适用于只供错误上报反解的场景。(vite.dev)
需要注意,nosources-source-map 只能避免嵌入 sourcesContent,仍可能暴露文件路径和工程结构。因此安全策略至少应包括:
- Source Map 与原始源码由私有对象存储或符号服务保存;
- 反解权限与源码下载权限分离;
- CI 上传令牌仅拥有最小权限,且不进入前端构建产物;
- 对
sourcesContent、源码路径和环境变量做构建前扫描; - 为符号访问、源码下载和人工导出保留审计记录;
- 按发布保留期限清理过期产物,而不是无限存储。
Source Map 的私有化不是绝对的安全边界。只要浏览器能够执行生成后的 JavaScript,攻击者仍可分析公开产物,因此还需要依赖代码分割、敏感逻辑后移服务端和密钥不入前端等措施。
六、多版本并存时,按产物找 map,不按"当前最新版"猜
灰度、回滚、CDN 缓存和异步加载会让同一时刻存在多个真实版本。最危险的做法,是拿"当前线上最新 release"去反解所有堆栈;这样可能得到一段看似合理、实际属于另一版本的源码位置。
正确的匹配优先级应是:
- artifactId、Debug ID 或内容哈希精确匹配;
- 生成文件 URL 与文件内容身份匹配;
- releaseId + dist/buildId + 规范化资源路径匹配;
- 无法匹配时,保留原始压缩堆栈并标记
symbolication_status=unresolved,禁止伪造源码位置。
入口脚本属于 release-42,并不意味着用户稍后加载的 order-review.8a91.js 也一定来自同一部署批次。错误事件必须携带具体失败帧或资源的身份,符号服务则应按该身份查找 map。
微前端中,宿主和子应用都应独立注入 appId、releaseId、buildId,并共享事件协议,而不是共享一个模糊的"前端版本"。若远程子应用无法被宿主全局监听覆盖,应在子应用自身初始化采集 SDK,并通过受控消息协议把归属信息带回宿主。
七、反解以后,责任归属应有明确优先级
反解到源码位置,不等于已经找到负责人。自动归因应当是有证据强弱顺序的规则系统:
text
显式业务域 / 路由归属
  > 源码路径对应的代码所有者
  > 子应用或包归属
  > 发布批次负责人
  > 人工待分诊队列
例如:
/checkout/**的关键流程错误,优先进入交易域;- 反解后落在
packages/order-review/**,再根据仓库 ownership 数据选择团队; - 若错误来自
remote-coupon-app,优先交给该子应用,而不是宿主团队; - 没有可靠归属时进入"待分诊",不能因为最近一次提交者恰好存在就盲目派单。
CODEOWNERS 可以作为源码路径到个人或团队的一个权威输入,但它只是归因数据源之一,不能替代业务域、运行中应用归属和组织服务目录。(docs.github.com)
人工改派应成为规则的反馈数据:若同一类错误连续从"基础设施"改派给"订单域",就应补充路由或包归属规则;若一个路径对应多人轮转,则归因系统应指向团队队列,而不是固定到个人。
八、优先级不能只看次数
单纯按错误次数排序,容易让高频但无感知的异常挤掉低频却阻断支付的问题。可以将 Issue 严重度拆成影响、业务关键性、回归、趋势和可恢复性几类信号:
text
priority = weighted(
  affectedUsers,
  journeyCriticality,
  regressionSignal,
  growthRate,
  recoverability
)
这不是一个必须照搬的数学公式,而是一个需要经过历史数据校准的决策模型。其中:
affectedUsers:受影响独立用户数和受影响会话比例;journeyCriticality:是否位于登录、下单、支付、提交等关键旅程;regressionSignal:是否仅在新releaseId或新cohortId出现;growthRate:错误率是否持续上升;recoverability:是否可自动重试、是否存在可用 fallback、是否持续跨会话发生。
告警阈值与工单优先级也应分离。新版本中影响比例快速上升的问题应立即告警;长期低频、可恢复的问题可以进入治理队列,避免值班人员被告警噪声淹没。
九、治理系统本身也必须可控
错误采集 SDK 不应影响业务可用性。遥测系统的通用原则是:宁可丢失部分遥测,也不能让采集库向业务代码抛出未处理异常。(opentelemetry.io)
因此,SDK 与服务端应共同设置保护机制:
- 客户端限流:同一指纹在单会话内只发送首条与有限摘要;
- 服务端配额:按应用、环境、版本和错误类型分别限流;
- 采样分层:保留首次出现、关键旅程和新版本回归,对已知低优先级问题抽样;
- 递归熔断:上报请求失败时,不再次把"上报失败"无限上报;
- 离线队列上限:网络恢复后只发送有限数量的高价值事件;
- 隐私默认拒绝:请求头使用白名单,query 参数脱敏,用户标识采用可撤销或不可逆方案;
- 规则可观测:记录一次归并、降噪、丢弃或自动分派由哪条规则造成。
十、关闭一个问题,必须证明它被修复
推荐将 Issue 状态设计为:
text
detected → grouped → triaged → assigned → mitigated → fixed → verified → closed其中最容易被跳过的是 verified。关闭条件不应是"开发提交了修复"或"告警暂时没了",而应至少满足:
- 修复版本已进入目标环境和目标灰度批次;
- 在约定观察窗口内,受影响用户比例显著下降;
- 同时排除采样规则变化、SDK 上报中断和路由流量消失造成的假下降;
- 若涉及异步 chunk 或缓存,验证旧缓存用户完成版本切换后的表现;
- 若采用临时降级,明确降级解除条件与后续根因修复责任人。
十一、端到端案例:灰度后的订单页异步 chunk 异常
假设 release-2026.09.28 进入 10% 灰度后,订单确认页偶发白屏。
- 用户进入
/orders/:orderId/review,动态加载order-review.8a91.js。 - chunk 内一个异步回调访问了空对象属性,触发未处理 Promise rejection。
- 子应用 SDK 上报
channel=promise、appId=order-review、cohortId=gray-10、chunk URL、生成堆栈和路由模板。 - 客户端短时去重阻止框架层与全局层重复发送;服务端根据事件状态和观察窗口决定是否创建正式 Issue。
- 符号服务根据 chunk 的
artifactId找到对应私有 Source Map,反解到packages/order-review/src/useCoupon.ts。 - 两阶段指纹将不同订单号、不同浏览器文案归并为同一个 Issue,同时保留"仅发生于
gray-10"这一回归信号。 - 路由规则先判定订单域,源码路径再匹配 ownership 数据,Issue 自动进入订单团队队列。
- 由于影响的是确认订单关键旅程,且只出现在新灰度批次,系统提升严重度并触发止损:暂停扩大灰度,而不是立刻全量回滚。
- 修复版本发布后,按
cohortId比较同一路由的受影响比例;确认新批次下降、旧版本无新增异常、SDK 发送量正常,Issue 才进入verified与closed。
这个案例的关键不是"成功捕获了 TypeError",而是每个字段都参与了后续决策:channel 决定处理策略,artifactId 决定反解正确性,routeTemplate 与源码路径决定归属,cohortId 决定是否属于灰度回归,受影响比例决定优先级,观察窗口决定是否可以关闭。
结语:可扩展性来自边界清晰
一套可持续演进的错误治理体系,应将以下模块解耦:
- 采集 SDK:负责安全发现与最小上下文;
- 传输层:负责缓冲、采样、限流与脱敏;
- 处理层:负责标准化、反解与归并;
- 符号服务:负责私有 Source Map 与产物身份匹配;
- 规则引擎:负责归因、分级、告警与工单;
- 验证系统:负责比较修复前后的真实影响。
这样,无论团队替换监控供应商、迁移构建工具、引入微前端,还是调整组织边界,都不必改变"一个错误事件如何被识别、定位、归并、分派与验证"的核心契约。