摘要
iPhone 照片传到电脑上打不开,多半是因为它存成了 HEIC。HEIC 不是一整张图。它是几十块 HEVC 编码的小图块外面套一个 HEIF 容器,再附上一份「怎么拼、拼完转多少度」的说明书。我在课设里做图片上传时撞上了这个问题,后来用合成样本把它从头到尾拆了一遍。这篇按我自己的学习顺序写。先打开一个 HEIC 看它里面装了什么。再看 Chromium、WebKit、Firefox 三个内核构建原生能不能读。读不了的时候怎么在网页里用 WASM 解码器自己解。最后是转成 JPG 之后要检查的三件事:方向、颜色和体积。关键的数都是我在一台 Apple M4 上实测的。比如 12MP 的样本由 48 块 512×512 的图块拼成。又比如在 headless Chromium 149 里,libheif 解一张 12MP 大约 377 毫秒,而转 JPG 只要 65 毫秒。
这篇写给刚开始做前端的人。每个术语第一次出现我先用人话说一遍,我自己一开始没搞懂的地方也会直说。文中有四段实验代码都在本机跑过;输出是真实的,我只删掉了重复的字段和行。
版本声明
全部测量跑于 2026-09-24。浏览器是 Playwright 1.61.1 自带的三个内核构建:Chromium 149.0.7827.55、WebKit 26.5、Firefox 151.0。全程 headless,也就是不开窗口的无界面模式。机器是 Apple M4 加 16 GB 内存的 Mac,系统是 macOS 26.5.2。样本由 macOS 自带的 sips 命令行工具编码。结构分析用的是我自己写的几十行 Node 脚本,没装任何第三方库。
有两点要先说清楚。第一点是 Playwright 的 WebKit 构建不等于你手机上的 Safari。Playwright 的 Firefox 构建也不等于你下载的 Firefox 正式版。下文写「WebKit」「Firefox」的地方指的都是这两个测试构建。第二点是所有耗时只代表这台 M4、headless 模式和这几张合成图。换一台机器或者换一部手机数字都会不一样,浏览器一升级结论也可能跟着过期。
适用边界
这篇只回答一个问题:iPhone 存的 HEIC 照片为什么在电脑和网页里打不开,前端该怎么把它读出来。范围是浏览器里的读取和转成 JPG、PNG、WebP 这一段。不讲怎么在网页里写出 HEIC。不讲服务端转码的方案。也不讲 HDR、实况照片和深度图。这些我都没测。
样本全部是程序生成的合成图。画面是渐变加噪声,四个角各放一个纯色方块,底下是一排 12 个色块。我先把它存成 PNG 再用 sips 编成 HEIC。它们只是「用 sips 从合成图编出来的 HEIC」而不是 iPhone 拍的照片。样本里的 GPS 是我填的一个太平洋海面上的虚构点。这样做的好处是每个像素的真值我都知道。坏处是真 iPhone 原片里的 HDR 增益图和 10 bit 色深这些东西它都没有。数字请当作量级和方向来看。
文章目录
一、iPhone 照片为什么在电脑上打不开
- 1.1 组员传上来的照片成了裂图
- 1.2 HEIC、HEIF、HEVC 分别是什么
- 1.3 我怎么测的
二、HEIC 文件里装了什么:拆开看图块
- 2.1 代码一:不装库读出 HEIC 的盒子
- 2.2 为什么一张照片要切成 48 块
三、浏览器能直接读 HEIC 吗:三个内核构建对照
- 3.1 代码二:先问浏览器自己能不能读
- 3.2 改 MIME 类型为什么没用
- 3.3 WebKit 构建能读靠的是什么
四、读不了怎么办:用 WASM 在网页里解 HEIC
- 4.1 WASM 是什么,libheif 又是什么
- 4.2 代码三:用 libheif 解码并画到画布
- 4.3 HEIC 解码器要下载多少
- 4.4 解一张 HEIC 要多久,会不会卡页面
五、HEIC 转 JPG 之后要检查什么
- 5.1 方向:为什么竖图会被转两次
- 5.2 颜色:为什么转完偏色
- 5.3 代码四:转完自己查一遍 JPG
- 5.4 体积:HEIC 转 JPG 是变大还是变小
六、我现在读取 HEIC 的顺序
七、适用边界与风险提示
八、测量方法自身的坑
九、还没解决的
参考资料
一、iPhone 照片为什么在电脑上打不开
1.1 组员传上来的照片成了裂图
事情是这样的:我们课设做的是一个社团活动相册网站,每次活动后要传几张现场照片。我用最普通的 <input type="file"> 加 <img> 做预览,在自己电脑上测试时都没问题。结果组员用 iPhone 一传预览框里就是一个裂开的图标。控制台没报错,文件也确实传上来了:扩展名是 .heic,大小有一两兆。我当时的第一反应是文件坏了,还让他重传了两次;后来才意识到文件没坏而是浏览器根本不认这个格式。他的 iPhone 相机设置里默认存的就是 HEIC。我自己用的是安卓机。在这之前我压根没见过这个扩展名。
我查了一圈得到的信息很零碎。有人说用 JS 库转;有人说让用户改相机设置;也有人说交给后端转。每条单看都对,可没有一条告诉我 HEIC 到底是什么、浏览器为什么不认、自己在前端转要付出什么代价。这篇就是我把这几个问题一个个搞清楚的过程。
1.2 HEIC、HEIF、HEVC 分别是什么
这三个缩写我一开始完全分不清。后来才发现它们说的是三层不同的东西。HEVC 是视频编码标准,也就是常说的 H.265。它负责把一块像素压成很短的一段二进制。你可以把它理解成一种压缩算法。它和 JPEG 里那套压缩是同一类角色,只是更新也压得更狠。HEIF 是一种容器格式,容器的意思是它不管压缩只管「装」。它规定文件里有哪些部分、每部分叫什么、存在哪个位置。一个 HEIF 文件里可以装一张或好几张图,也可以装缩略图和 EXIF 元数据。它还能装「这些图块怎么拼」「显示时转多少度」这类说明。
HEIC 就是「用 HEVC 压缩、装在 HEIF 容器里」的那种文件。iPhone 相机存的就是它。换句话说 HEIC 是 HEIF 家族里的一个具体组合。换成别的编码装进 HEIF 就是别的名字了,AVIF 走的也是同一套容器思路。搞清楚这三层之后「浏览器为什么打不开」就能拆成两个问题。浏览器看不看得懂 HEIF 这个容器?浏览器有没有 HEVC 解码器?两样缺一样都读不了。
1.3 我怎么测的
我没有拿组员的照片做测试。一是照片里带定位。二是我需要知道每个像素原本是什么值才能判断解码对不对。我用 Python 造了五张合成图再用 sips 编成 HEIC。三档分辨率分别是 3MP 的 2016×1512、12MP 的 4032×3024 和 48MP 的 8064×6048。12MP 另外做了两张竖拍,它们的 EXIF 方向分别是 6 和 8。每张图的四个角各放一个纯色块:左上红、右上绿、左下蓝、右下黄。看四个角的颜色就能判断方向对不对。像素按 Display P3 色彩空间编码,文件里也嵌了 P3 的 ICC 配置文件。
测试分三块:第一块是我自己写的小实验,也就是文中的四段代码。第二块是用 Playwright 驱动三个内核构建跑同一个页面并对比各自的行为。第三块是找一个现成的线上工具做对照,看一条完整链路在真实网页里是什么样子。对照我用的是图映 ImgIng(imging.cn/)的 HEIC 转换,内核是 Playwright 自带的 Chromium 149,样本就是上面这五张 sips 编出来的合成图。我主要看它的网络请求、解码耗时和转出来的文件。
二、HEIC 文件里装了什么:拆开看图块
2.1 代码一:不装库读出 HEIC 的盒子
HEIF 容器的基本单位叫「盒子」,英文是 box。每个盒子开头 4 个字节是长度,接着 4 个字节是类型名,再往后才是内容。有的盒子里面还套着盒子。这个设计和 MP4 是同一个祖宗,读过 MP4 结构的人会觉得眼熟。我之前没读过,是对着规范一层层试出来的。下面这段脚本只做一件事:把盒子一层层走一遍,数出里面有几张图、每张多大、要转多少度。
js
import { readFileSync } from 'node:fs';

const buf = readFileSync(process.argv[2]);
const out = { top: [], items: {}, ispe: [], irot: [] };

function walk(start, end, depth) {
  let p = start;
  while (p + 8 <= end) {
    let size = buf.readUInt32BE(p);
    if (size === 1) size = Number(buf.readBigUInt64BE(p + 8));   // mdat 常用 64 位长度
    const type = buf.toString('latin1', p + 4, p + 8);
    const stop = size === 0 ? end : p + size;
    if (depth === 0) out.top.push(`${type} ${size}`);
    if (type === 'ftyp') out.brand = buf.toString('latin1', p + 8, p + 12);
    if (type === 'meta') walk(p + 12, stop, depth + 1);          // meta 是 full box,多 4 字节
    if (type === 'iinf') walk(p + 14, stop, depth + 1);          // version 0:条目数占 2 字节
    if (type === 'iprp' || type === 'ipco') walk(p + 8, stop, depth + 1);
    if (type === 'infe') {                                        // version 2:id 2 + 保护 2 + 类型 4
      const kind = buf.toString('latin1', p + 16, p + 20);
      out.items[kind] = (out.items[kind] || 0) + 1;
    }
    if (type === 'ispe') out.ispe.push(`${buf.readUInt32BE(p + 12)}x${buf.readUInt32BE(p + 16)}`);
    if (type === 'irot') out.irot.push((buf[p + 8] & 3) * 90);
    p = stop;
  }
}
walk(0, buf.length, 0);
console.log('品牌', out.brand);
console.log('顶层', out.top.join(' | '));
console.log('条目', JSON.stringify(out.items));
console.log('尺寸', [...new Set(out.ispe)].join(' '), '旋转', out.irot.join(' ') || '无');
json
== s12mp_o6(12MP 竖拍,EXIF 方向 6)
品牌 heic
顶层 ftyp 32 | meta 3309 | mdat 1307544
条目 {"hvc1":48,"grid":1,"Exif":1,"mime":1}
尺寸 512x512 4032x3024 旋转 270
== s48mp_o1(48MP 横拍)
品牌 heic
顶层 ftyp 32 | meta 3585 | mdat 5801959
条目 {"hvc1":54,"grid":1,"Exif":1,"mime":1}
尺寸 896x1024 8064x6048 旋转 0
代码说明 。顶层只有三个盒子:ftyp 写着品牌 heic,程序靠它认出这是什么文件。meta 是说明书且只有 3309 字节。mdat 装的是真正的图像数据,一共 1307544 字节,差不多占了整个文件的 99.7%。条目那一行是关键:12MP 这张图里有 48 个 hvc1 条目和 1 个 grid 条目。hvc1 就是一块 HEVC 编码的小图。grid 本身没有像素,它只写「这 48 块按几行几列拼」。ispe 记的是尺寸,这里出现了两种:512×512 是每一块的大小,4032×3024 是拼完的大小。竖拍这张的 irot 是 270,意思是拼好之后还要再转 270 度才是正的。脚本里那几个写死的偏移量是照规范数出来的。比如 meta 属于带版本号的 full box,因此内容前面要多跳 4 个字节。
2.2 为什么一张照片要切成 48 块
这是我读到这里最大的疑问。一张照片为什么不整张存而要切成几十块再拼?
我能确认的只有现象。12MP 的样本是 48 块 512×512:横着 8 块、竖着 6 块,拼起来是 4096×3072。比 4032×3024 多出来的那一圈在拼完之后裁掉。48MP 的样本却是 54 块 896×1024,块的尺寸变了。至少对 sips 来说块尺寸不是一个固定值。至于为什么要切块,我读到的解释大多和硬件解码器对单帧尺寸的上限有关,也有说分块之后可以并行解码的。这些说法我没法在这台机器上验证,先不当结论。
对前端来说切块有一个很实际的后果:解码器必须理解 grid 并把 48 块逐一解开再拼起来。一个只会解「单张 HEVC 帧」的解码器拿到这种文件只会给你第一块。另一个后果是方向。文件同时带着 irot 和 EXIF 里的 Orientation。这个放到第五章讲,因为它是转完之后最容易出错的地方。
三、浏览器能直接读 HEIC 吗:三个内核构建对照
3.1 代码二:先问浏览器自己能不能读
回到课设那个裂图。我最先做的是问浏览器能不能自己读。能读就不用多下载一个解码器。问法很简单:把文件交给 <img> 再调用 img.decode() 等结果。
js
async function tryNative(file) {
  const img = new Image();
  img.src = URL.createObjectURL(file);
  try {
    await img.decode();
    return { ok: true, w: img.naturalWidth, h: img.naturalHeight, img };
  } catch (e) {
    return { ok: false, err: e.name };
  }
}
json
chromium 149.0.7827.55 {"name":"s12mp_o6","native":"fail EncodingError","native_ms":1, ...}
webkit 26.5            {"name":"s12mp_o6","native":"ok 3024x4032","native_ms":107, ...}
firefox 151.0          {"name":"s12mp_o6","native":"fail EncodingError","native_ms":32, ...}
代码说明 。img.decode() 返回一个 Promise,图片解码成功它就 resolve,解不了就 reject。比起监听 onerror 它能直接拿到错误名。Chromium 149 和 Firefox 151 构建都报 EncodingError,也就是「这段数据解不了」。WebKit 26.5 构建成功了,宽高是 3024×4032。注意它已经是竖的:原始存储是 4032×3024 而 WebKit 自己按方向转正了。失败的两个内核几乎是瞬间返回,只花了 1 到 32 毫秒。这点对体验很友好:探测本身不花什么时间,失败了马上就能走下一步。
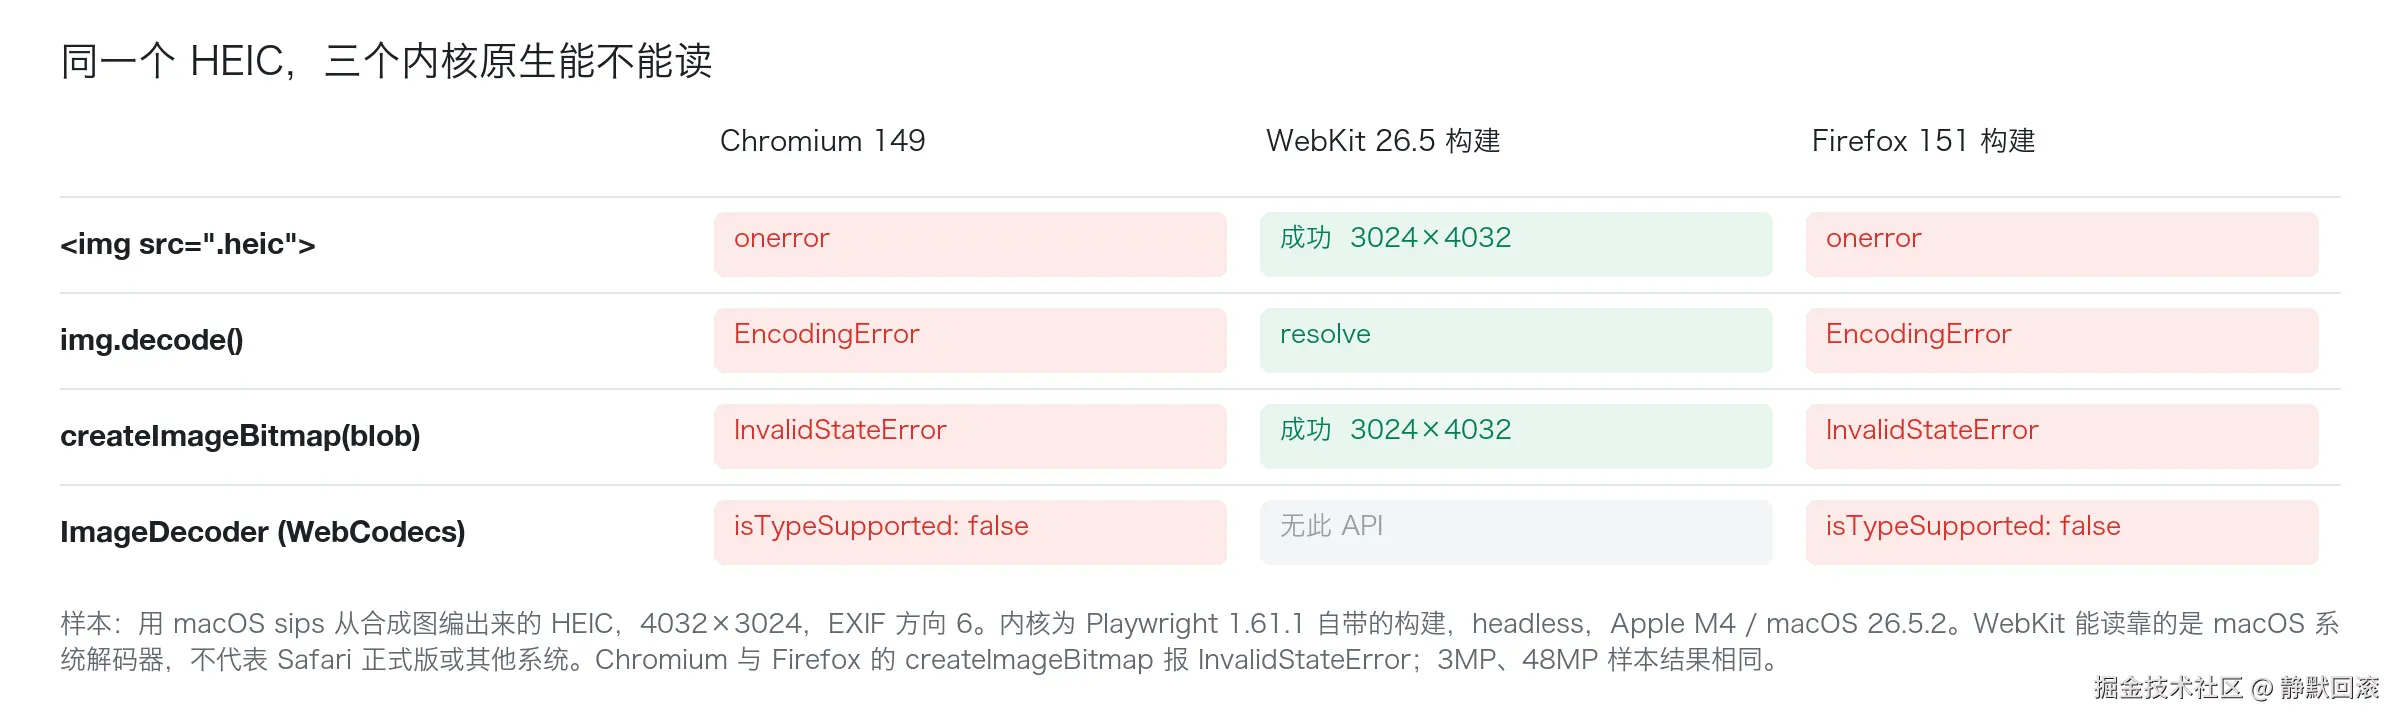
这张图要看什么 。横着看是三个内核构建而竖着看是四种原生读图方式:<img>、img.decode()、createImageBitmap() 和 WebCodecs 的 ImageDecoder。关键是红绿分布:Chromium 和 Firefox 两列的四行全红。WebKit 那一列除了没有 ImageDecoder 这个 API 之外全绿。报错名值得记一下,排查时会用到。createImageBitmap 在两个内核上报的都是 InvalidStateError,跟 decode() 的 EncodingError 不一样。ImageDecoder.isTypeSupported('image/heic') 在两个内核上都是 false。同样的调用换成 image/avif 却是 true,也就是说这两个内核构建认 AVIF 而不认 HEIC。3MP 和 48MP 样本的结果和图里完全一样。
3.2 改 MIME 类型为什么没用
我当时的第二个想法是浏览器会不会没认出文件类型。<input> 拿到的 File 对象的 type 有时是空的。本地测试服务器给 .heic 返回的 Content-Type 也是 application/octet-stream 而不是 image/heic。
这个猜测试一下就能排除。把 Blob 的 type 显式改成 image/heic 再交给 <img> 和 createImageBitmap 之后,Chromium 和 Firefox 构建照样失败而且错误名都不变。WebKit 构建照样成功。浏览器解码图片时看的是文件开头的字节而不是你贴上去的类型标签。标签改对了解码器不存在还是不存在。
3.3 WebKit 构建能读靠的是什么
WebKit 构建能读是因为它在 macOS 上调用了系统自带的图像解码器。macOS 本身能解 HEIC,而 WebKit 借用了这个能力。这意味着同一份 WebKit 代码到了别的系统上未必能读。iOS 上的 Safari 以及 Windows 或 Linux 上的 WebKit 我都没有测。我手上没有能说明它们行为的数据,这里就不往外推了。
那 Chromium 和 Firefox 为什么不内置一个 HEVC 解码器?我没找到浏览器厂商给过的正式说明。我读到的讨论大多指向 HEVC 的专利授权问题,但这是我核实不了的说法,只能先记在这里。对写代码的人来说结论更简单:在这两个内核上只能自己带一个解码器。
四、读不了怎么办:用 WASM 在网页里解 HEIC
4.1 WASM 是什么,libheif 又是什么
WASM 是 WebAssembly 的缩写,它是一种能在浏览器里跑的二进制程序格式。可以这样理解:别人用 C 或 C++ 写好的程序被编译成浏览器能执行的形式再由 JavaScript 加载调用。它的意义在于很多成熟的编解码库本来就是 C 写的,没必要用 JS 重写一遍。
libheif 就是这样一个专门读写 HEIF 的开源 C++ 库。它自己不做 HEVC 解码而是调用另一个开源库 libde265。libheif-js 是把这两个库一起编译成 WASM 再包一层 JS 接口的版本。我这次用的就是这样一份打包文件,里面能看到 1.19.8 和 libde265 1.0.15 的字样。
4.2 代码三:用 libheif 解码并画到画布
下面是我在 Chromium 里跑通的最小写法。先按需导入模块并拿到解码器。再把文件的 ArrayBuffer 交给它并取出第一张图。最后把像素填进一个 ImageData 再用 putImageData 画到画布上。
js
let lib = null;
async function decodeWasm(file) {
  if (!lib) {
    const mod = await import('../out/codec/libheif-bundle.mjs');
    lib = await mod.default();
  }
  const dec = new lib.HeifDecoder();
  const list = dec.decode(await file.arrayBuffer());
  const first = list[0];
  const w = first.get_width(), h = first.get_height();
  const out = new ImageData(w, h);
  await new Promise((ok, bad) => first.display(out, r => (r ? ok() : bad(new Error('display 失败')))));
  return { n: list.length, out };
}

const c = document.getElementById('c');
const ctx = c.getContext('2d');
// 解码后:c.width = out.width; c.height = out.height; ctx.putImageData(out, 0, 0);
function corners() {
  const at = (x, y) => Array.from(ctx.getImageData(x, y, 1, 1).data.slice(0, 3)).join(',');
  return { 左上: at(40, 40), 右上: at(c.width - 40, 40), 左下: at(40, c.height - 40), 右下: at(c.width - 40, c.height - 40) };
}
json
chromium 149.0.7827.55 {"name":"s12mp_o6","wasm_ms":412,"images":1,"size":"3024x4032",
  "corners":{"左上":"230,30,30","右上":"30,200,41","左下":"29,60,230","右下":"239,220,20"}, ...}
chromium 149.0.7827.55 {"name":"s48mp_o1","wasm_ms":1504,"images":1,"size":"8064x6048", ...}
webkit 26.5            {"name":"s12mp_o6","native":"ok 3024x4032",
  "corners":{"左上":"252,0,0","右上":"0,203,0","左下":"15,61,239","右下":"244,219,0"}, ...}
firefox 151.0          {"name":"s12mp_o6","wasm_ms":5115,"images":1,"size":"3024x4032", ...}
代码说明 。这里有三个地方我一开始没想到。第一是 decode() 返回的是一个数组而不是一张图。HEIC 可以装好几张图,我这里简单取了第一张。这个做法对多图文件对不对我没有样本验证,放到最后「还没解决的」里。第二是真正的解码发生在 display() 里。decode() 只把容器解析一遍因而很快。display() 才去解那 48 块 HEVC 再拼起来,它也因此做成了异步回调的形式。第三是 display() 给出的尺寸已经是 3024×4032,说明竖图已经转正了。libheif 按 irot 转了 270 度。四个角的颜色也证明了这一点:左上红、右上绿、左下蓝、右下黄,和正立时一致。wasm_ms 是从导入模块到解码完成的总时间并且包含模块加载。12MP 竖拍跑了 3 次,分别是 412、426、411 毫秒。
输出里还有一个我当时没看懂的细节。libheif 解出来的左上角是 (230,30,30),跟我造样本时写进去的 P3 数值几乎一样。WebKit 原生解出来的却是 (252,0,0);两边解的是同一个文件而数值却差这么多。原因留到第五章讲颜色时展开。简单说就是一个给的是没有换算过的原始数值,另一个已经换算成了 sRGB。
4.3 HEIC 解码器要下载多少
自己带解码器就得让用户下载它。这个代价具体多大,我是看图映的网络请求量出来的。它的做法是先试原生而原生失败才出现一个「加载解码器」按钮。点了之后下载两个文件:一个 2 KB 左右的 heic.js 和一个 libheif-bundle.mjs。WebKit 构建因为原生能读而全程不下载任何解码文件。
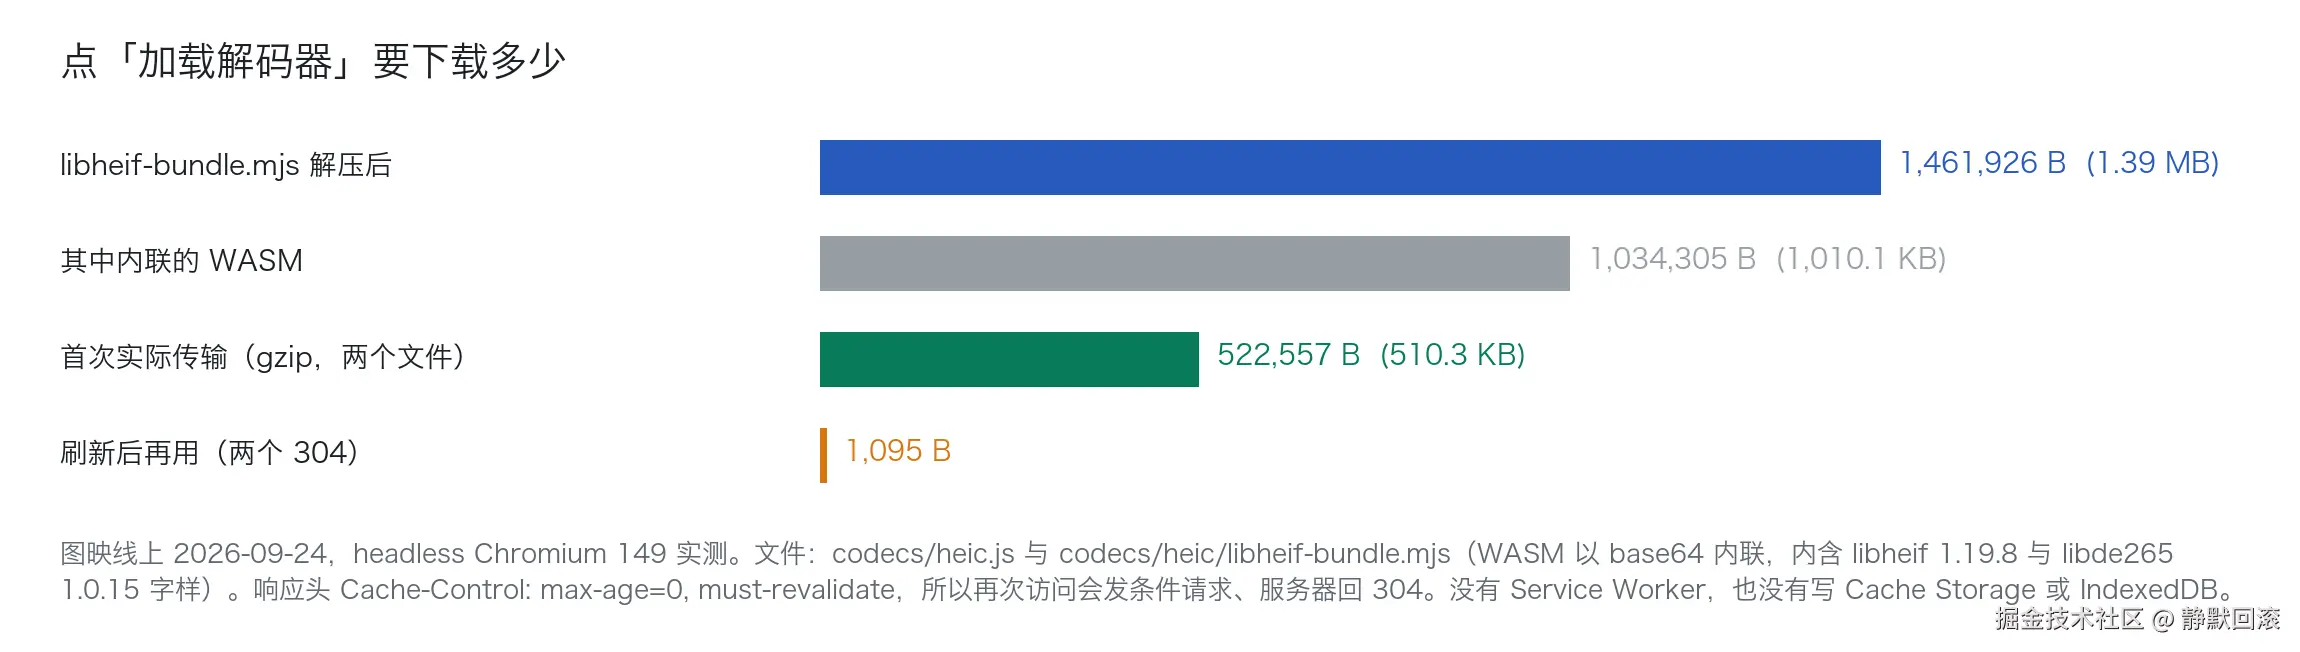
这张图要看什么 。四根条从上到下是同一个解码器的四种「大小」。最上面那根是 bundle 解压后的体积 1,461,926 字节。第二根是其中内联的 WASM 本体 1,034,305 字节。「内联」的意思是 WASM 没有单独放成 .wasm 文件而是转成 base64 文本直接写在 JS 里。第三根是用户第一次真正要下载的量。两个文件 gzip 之后一共 522,557 字节,约合 510 KB。最值得看的是最下面那根:刷新后再用只花了 1,095 字节。
这个数我一开始以为是浏览器把文件缓存在了磁盘上。其实不是。这两个文件的响应头是 max-age=0, must-revalidate,意思是每次都要回服务器问一句文件变了没有。服务器回一个 304 表示没变,浏览器就直接用本地那份。两个 304 一共 546 + 549 = 1,095 字节。它还把「用过 HEIC 解码器」记进了 localStorage。刷新后它会自动静默加载解码器,下次上传 HEIC 就不用再点按钮。它没有用 Service Worker、Cache Storage 或 IndexedDB。这个做法对课设这种规模的项目很好抄:第一次按需加载,之后靠 HTTP 协商缓存加一个 localStorage 标记。
还有一件我比较关心的事是文件有没有被传走。我在 Chromium、WebKit、Firefox 三个构建上一共跑了 120 次图映的读取和转换用例。非 GET 请求一共 0 次,而页面里 fetch、XHR 和 sendBeacon 的上行也是 0 次。唯一新增的网络流量就是上面那两个解码器文件的下载。注意这只覆盖读取 HEIC 和转成 JPG、PNG、WebP 这一段。选 HEIC 作为输出格式时界面把它归为服务端处理。那一段我没有拿到任何请求,也就不能说它同样在本地完成。
4.4 解一张 HEIC 要多久,会不会卡页面
下载只是第一笔账,第二笔账是解码本身。我把同一份 libheif 单独拿出来在三个内核构建上各解 5 次取中位数。这里的时间只算 decode() 加 display() 而不含下载和初始化。
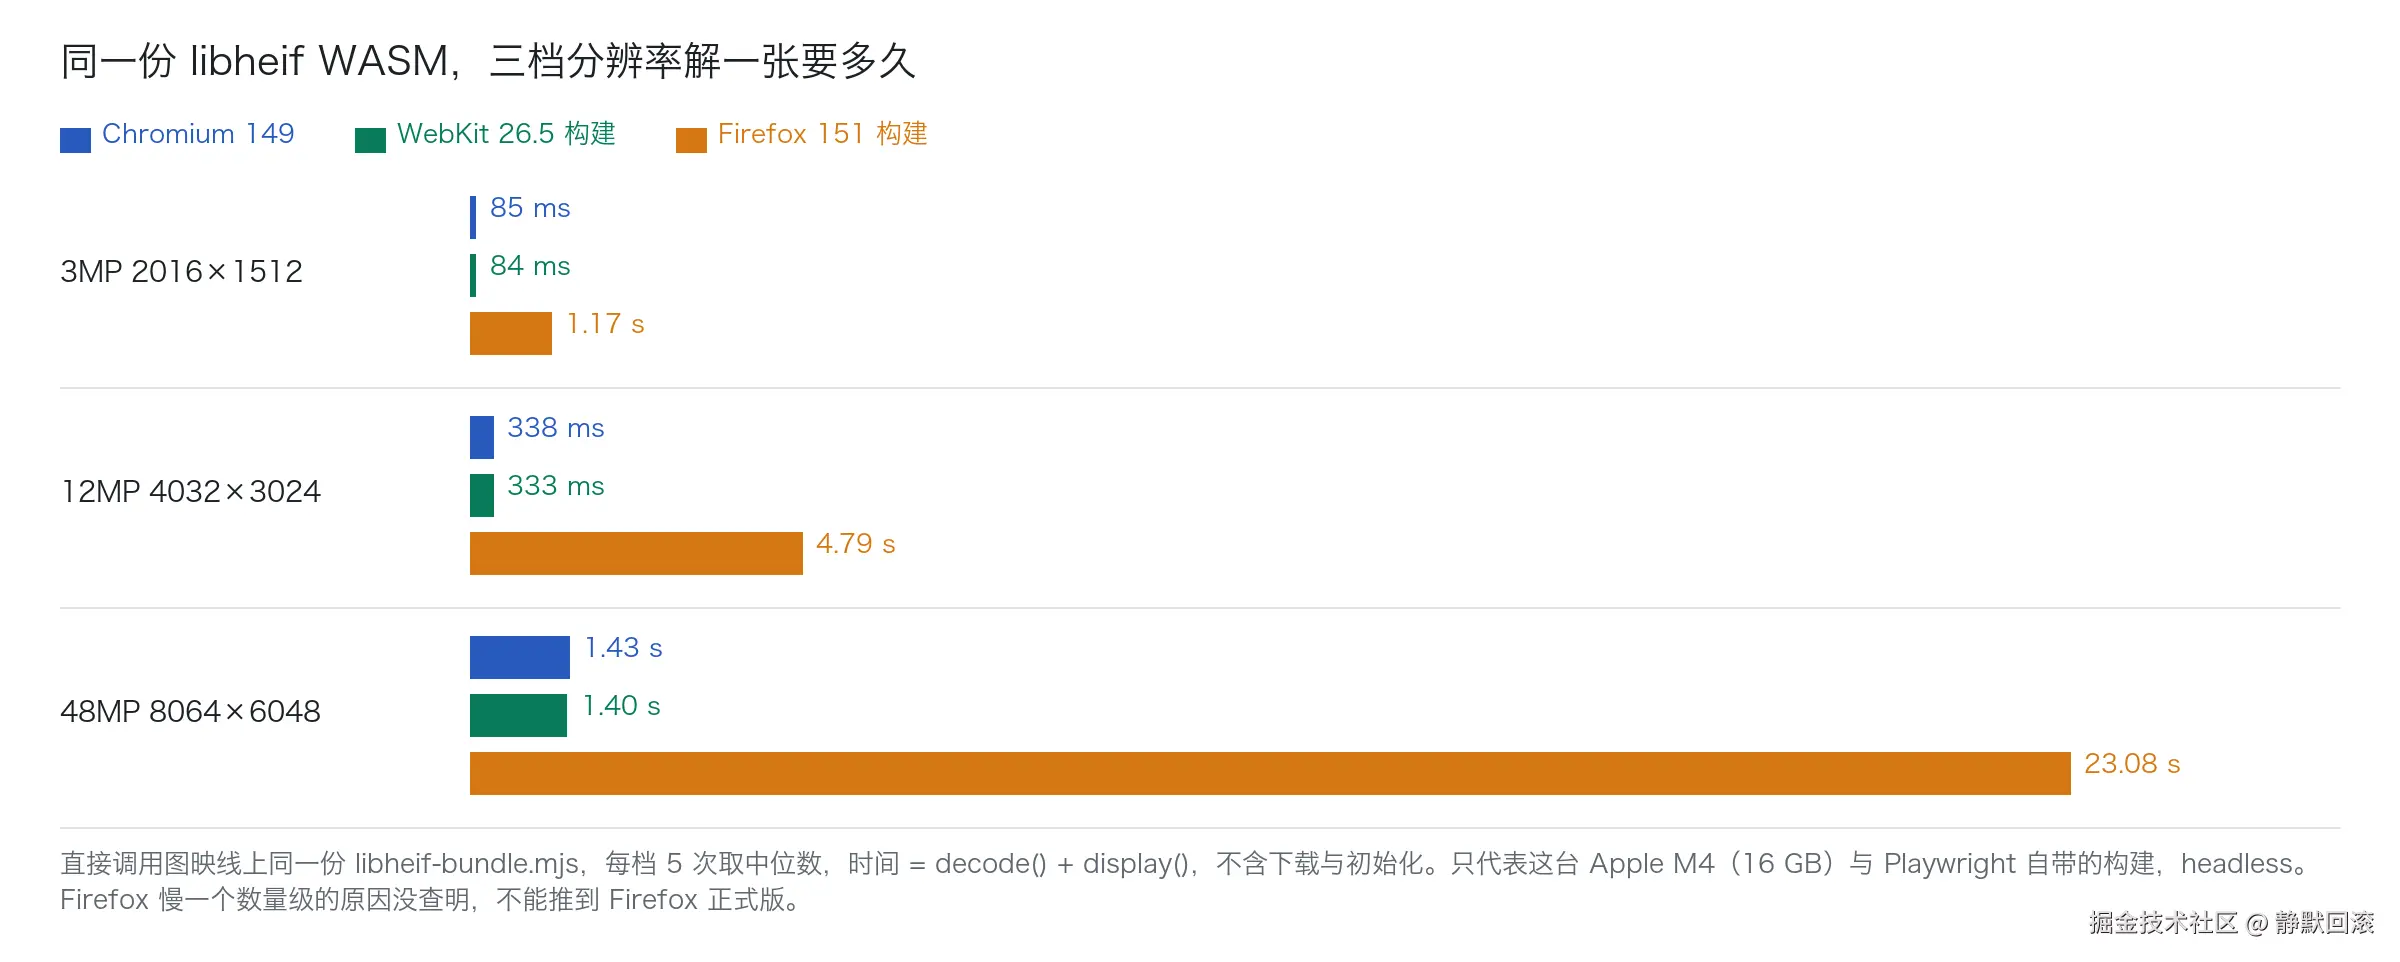
这张图要看什么。每一档有三根条:蓝是 Chromium 149、绿是 WebKit 26.5 构建、橙是 Firefox 151 构建。前两根几乎一样长:12MP 是 338 和 333 毫秒,48MP 是 1.43 和 1.40 秒。橙色那根长得离谱:12MP 要 4.79 秒而 48MP 要 23.08 秒。同一份 WASM 放到 Playwright 的 Firefox 151 构建上,在这台机器上慢了 14 到 16 倍。原因我没查到也不敢乱猜。三个内核解出来的像素抽样哈希完全一致,差别只在快慢。还有一点是解码时间和像素数大致成正比。3MP 到 12MP 像素多了 4 倍而时间也差不多是 4 倍。我的代码三在 Firefox 构建上跑出来是 5,115 毫秒,和这个量级对得上。
比「多久」更要紧的是「卡不卡」:图映的解码是在主线程上同步做的。它用的是 new WebAssembly.Module 和 new WebAssembly.Instance 这两个同步接口,也没有放进 Web Worker。Worker 是浏览器提供的后台线程,放进去就不会挡住页面的点击和滚动。放在主线程上跑的话解码这段时间页面就是冻住的。
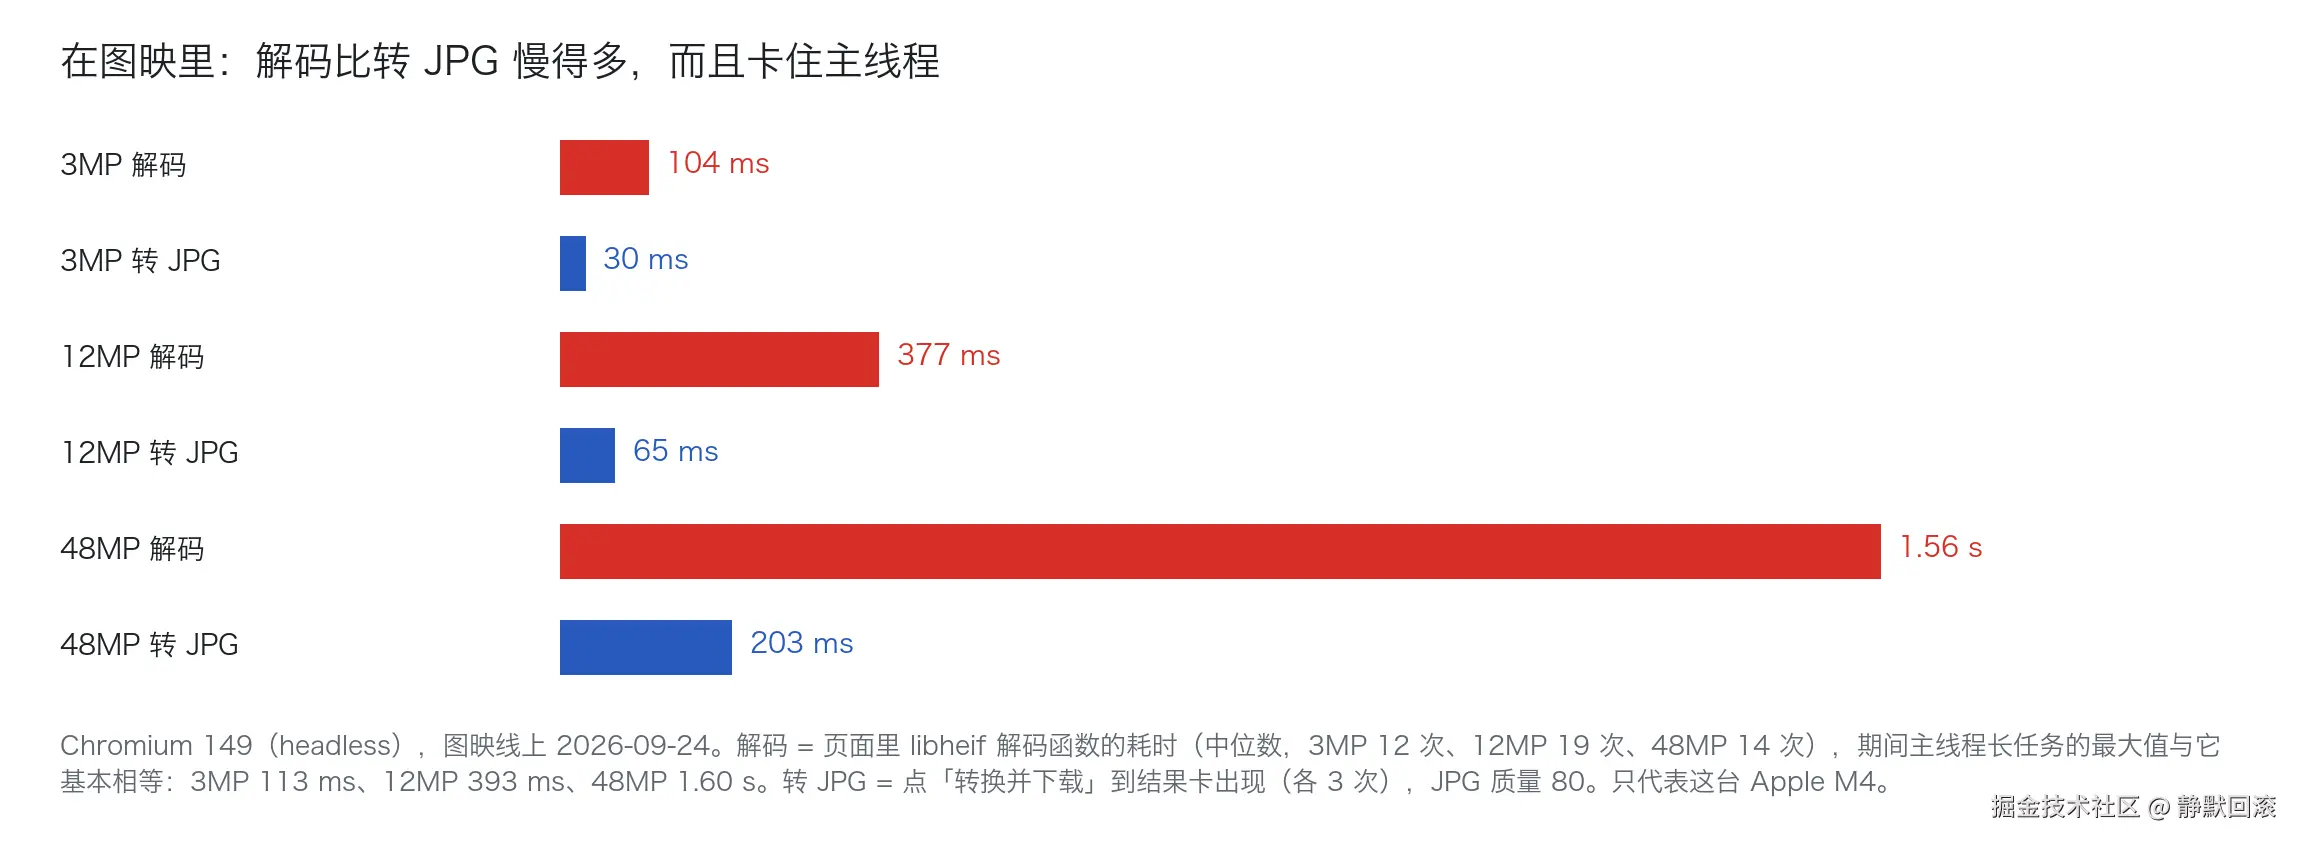
这张图要看什么。红条是解码而蓝条是转 JPG,三档分辨率上下成对排。每一档的红条都比蓝条长得多。12MP 解码约 377 毫秒而转 JPG 质量 80 只要 65 毫秒,前者大约是后者的 5.8 倍。48MP 解码 1.56 秒而转 JPG 是 203 毫秒。图注里还有一组数值得看。解码期间主线程的最长长任务是 112.5 毫秒、393 毫秒和 1.60 秒,与解码时间几乎相等。「长任务」是浏览器的一个统计概念,指一段超过 50 毫秒而中间不让出主线程的代码。它和解码时间相等说明整段解码都卡在主线程上。48MP 那一档页面会卡住约 1.6 秒。另外图上 12MP 解码标的是 376 毫秒而我记录表里的中位数是 377 毫秒。差的这 1 毫秒出在哪一步取整我没去追。
这组数改了我的一个直觉。我原先以为「转格式」是重活,因为要重新压缩;实际上贵的是解码而编码反而便宜。对前端来说这有一个直接的推论。优化的重点不在选什么输出格式而在解码放不放主线程、要不要先缩小再处理。
五、HEIC 转 JPG 之后要检查什么
解出来、能显示只完成了一半。转成 JPG 交给后端或者让用户下载之前我现在都会查三件事:方向、颜色、体积。这三件事出错时代码一行报错都没有,只能靠自己去查。
5.1 方向:为什么竖图会被转两次
代码一已经显示,竖拍样本同时带着两个方向信息。一个是 HEIF 容器里写着 270 度的 irot。另一个是 EXIF 里写着 6 的 Orientation,而 EXIF 是照片里记拍摄信息的那段元数据。Orientation 是其中一个字段,它告诉查看器显示时要转多少度。这两个说的是同一件事,只是写在了两个地方。
问题就出在这里:只认其中一个的解码器没事。两个都认的解码器会先按 irot 转一次再按 EXIF 转一次,竖图就被转成了倒着的横图。libheif 的做法是按 irot 转、不读 EXIF。它解出来的像素已经是正的,代码三的四个角就是证据。接下来最容易犯的错是自己再按 EXIF 转一次或者把原 EXIF 原样写进新的 JPG。原 EXIF 里 Orientation 还是 6,查看器看到了会再转一次。
两种做法的结果我都对照看了。图映在三个内核构建上转出的 25 个文件覆盖方向 1、6、8。它们全部是正的而 Orientation 全部改写成了 1。macOS 的 sips 转 PNG 是另一种思路:像素不转而保留 EXIF 6 和 8,靠查看器按 EXIF 去转。两种在认 EXIF 的查看器里看起来一样,可如果下游有一个不认 EXIF 的环节第二种就会显示成横的。我自己选的是前一种:像素转正,Orientation 写 1 或者干脆不写。
5.2 颜色:为什么转完偏色
这是我花时间最长的一节,也是我觉得最容易被人忽略的一节。
先说一个概念:色彩空间。同样一组数字 (230,30,30) 在不同的色彩空间里代表的颜色不一样。网页默认的色彩空间是 sRGB,它能表示的颜色范围比较小。Display P3 的范围更大,尤其是更鲜艳的红和绿。iPhone 照片常见的就是它,这一点我没有拿原片验证过。一张图用的是哪个色彩空间要靠文件里嵌的 ICC 配置文件说明。ICC 可以理解成一张「这些数字该怎么理解」的对照表。
libheif 解出来的是没有做过色彩管理的原始数值,P3 的 HEIC 解出来就是 P3 数值。代码三里左上角的 (230,30,30) 就是样本写进去的那个 P3 红。可画布默认按 sRGB 理解像素。如果导出 JPG 时没有把 P3 的 ICC 带上的话这些 P3 数值就会被当成 sRGB 数值显示。结果就是颜色偏淡、偏灰。
偏多少我是量过的:色差用 CIEDE2000 公式算,简称 ΔE。常用的经验线是 ΔE 在 1 以下人眼基本分辨不出来,到 2、3 以上并排比较就能看出不同。把源文件里的 P3 ICC 原样带上导出,在 Chromium 和 Firefox 构建上 12 个色块的 ΔE 全部不超过 0.31,WebP 则是 0.48。同一批像素如果导出时不带这个 ICC 而按 sRGB 去看,sRGB 范围内的色块偏 2.36 到 3.33,P3 高饱和的色块最大偏到 6.91。
浏览器原生解码的路径正好相反。WebKit 构建原生解码时已经做了色彩管理并直接把 P3 换算成了 sRGB 数值。这就是代码三里 WebKit 那组四角读出 (252,0,0) 的原因。P3 的红超出了 sRGB 的范围而被裁到了 sRGB 能表示的最红。画到默认画布后 sRGB 范围内的色块 ΔE 不超过 0.51,P3 高饱和色最大偏到 7.91,偏得最多的是那个 P3 橙。sRGB 本来就装不下这些颜色。
把两条路径放在一起规律就出来了:数值是什么空间 ICC 就得标成什么空间。libheif 路径给的是 P3 数值就要带 P3 的 ICC。原生解码路径给的是 sRGB 数值就不能再贴 P3 的 ICC。
5.3 代码四:转完自己查一遍 JPG
光知道道理不够,我想要一个能在自己项目里随手调用的检查。下面这段在转出 JPG 后读它的前 64 KB,看宽高、有没有 ICC、ICC 标的是什么、有没有 EXIF。
js
function checkJpeg(bytes) {
  const s = new TextDecoder('latin1').decode(bytes.subarray(0, 65536));
  let w = 0, h = 0;
  for (let i = 2; i < bytes.length - 9; i++) {
    if (bytes[i] === 0xff && bytes[i + 1] === 0xc0) {
      h = (bytes[i + 5] << 8) | bytes[i + 6];
      w = (bytes[i + 7] << 8) | bytes[i + 8];
      break;
    }
  }
  let icc = '无';
  if (s.includes('ICC_PROFILE')) icc = s.includes('D\0i\0s\0p\0l\0a\0y\0 \0P\x003') ? 'Display P3' : s.includes('s\0R\0G\0B') ? 'sRGB' : '其他';
  return { size: bytes.length, w, h, icc, exif: s.includes('Exif\0\0') };
}

// 用法:画布导出后检查
// const blob = await new Promise(ok => c.toBlob(ok, 'image/jpeg', 0.8));
// checkJpeg(new Uint8Array(await blob.arrayBuffer()));
json
chromium 149.0.7827.55 s12mp_o6 "jpeg":{"size":676993,"w":3024,"h":4032,"icc":"sRGB","exif":false}
chromium 149.0.7827.55 s48mp_o1 "jpeg":{"size":2111636,"w":8064,"h":6048,"icc":"sRGB","exif":false}
webkit 26.5            s12mp_o6 "jpeg":{"size":1800471,"w":3024,"h":4032,"icc":"无","exif":true}
firefox 151.0          s12mp_o6 "jpeg":{"size":753179,"w":3024,"h":4032,"icc":"无","exif":false}
代码说明 。0xFF 0xC0 是 JPEG 里记录宽高的那一段的标记,后面第 5 到第 8 个字节就是高和宽。ICC 在 JPEG 里放在一个以 ICC_PROFILE 开头的段里。配置文件的名字用两个字节表示一个字符,搜的时候字母之间要插 \0。这段代码把画布直接 toBlob 出来的 JPG 查了一遍而三个内核的结果各不一样。Chromium 自己塞了一段标着 sRGB 的 ICC。WebKit 构建没有 ICC 但有一段只含色彩空间和像素宽高这类标签的 EXIF。Firefox 构建两样都没有。三家都没有把源文件的 P3 ICC 带过来。原 EXIF 里的拍摄时间和 GPS 也都没有带过来。
Chromium 那一行最容易骗人。我第一版只判断了「有没有 ICC」,看到 true 就以为颜色保住了。后来把名字读出来才发现是 sRGB;libheif 给的是 P3 数值却被标成 sRGB。这就等于上一节说的「按 sRGB 看 P3 数值」。想让颜色对就得自己把源文件的 P3 ICC 写回 JPG。这一步画布 API 做不了,要自己拼 JPEG 的段。我还没写出一个满意的版本。
5.4 体积:HEIC 转 JPG 是变大还是变小
我原以为这个问题一句话就能答完。
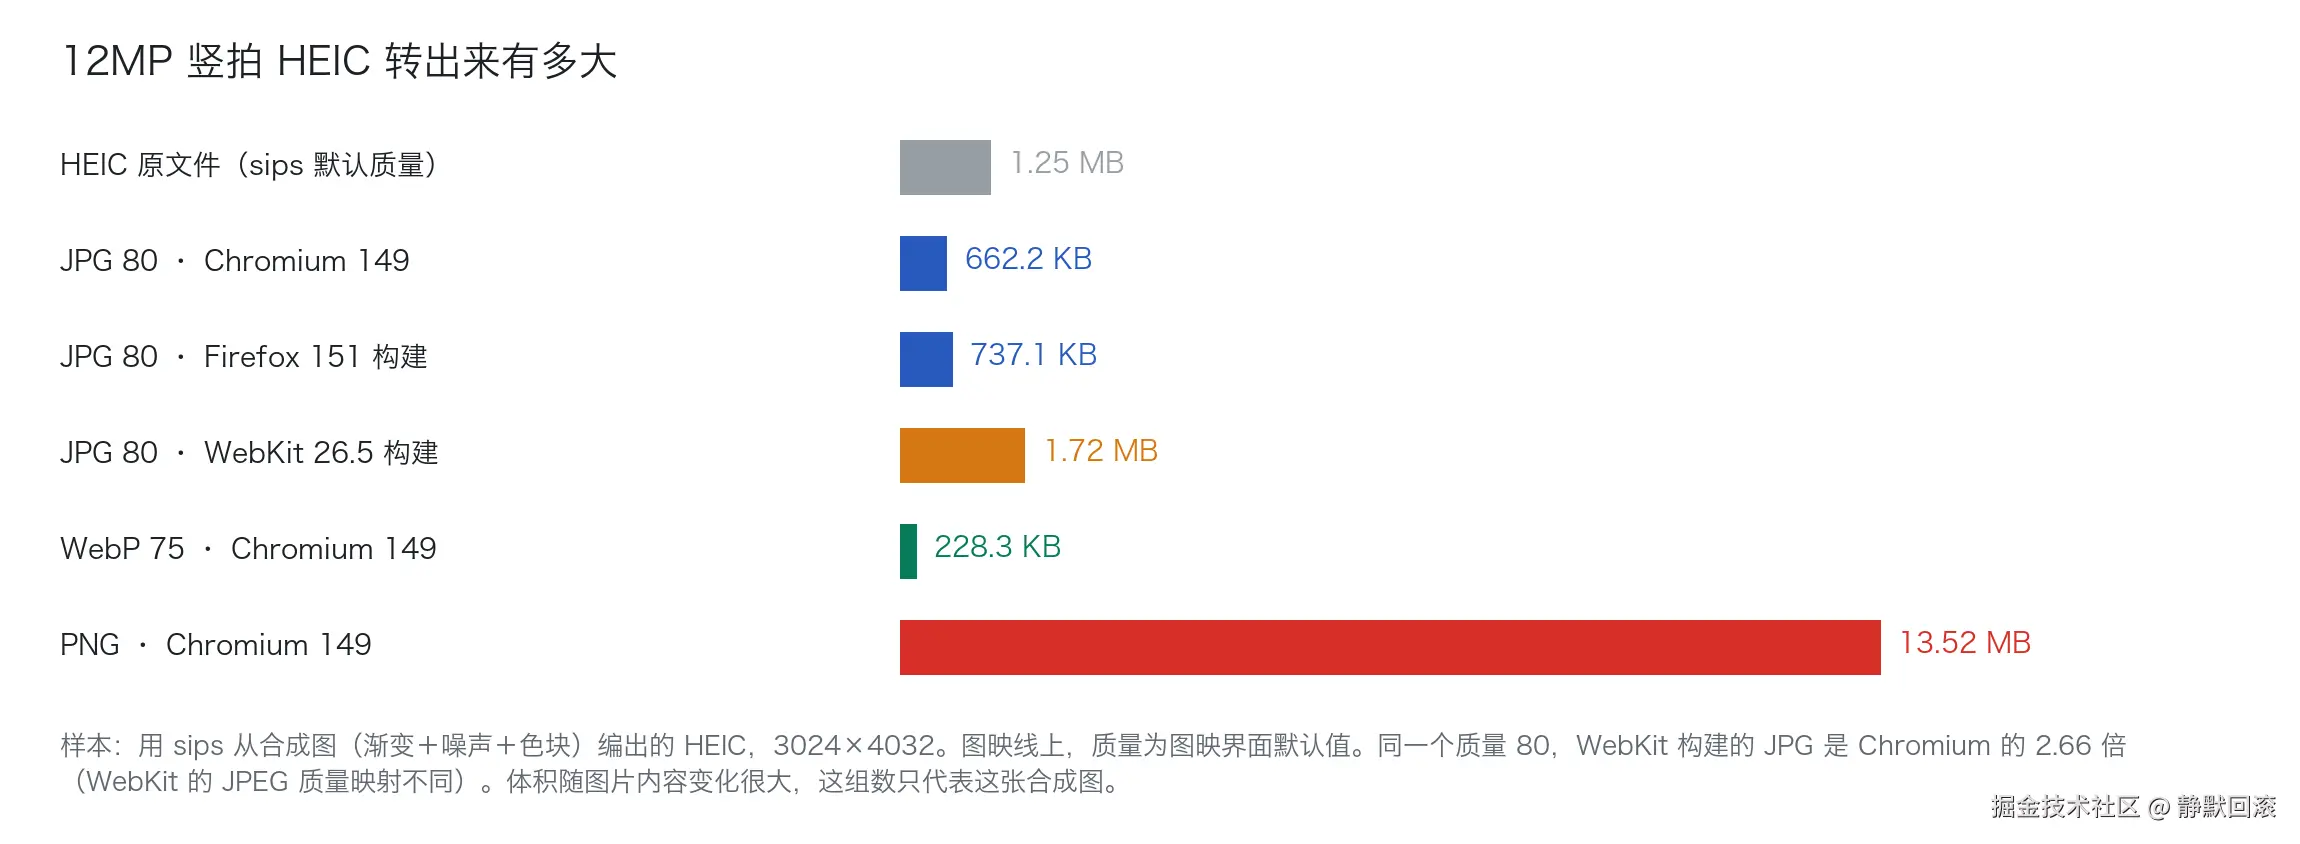
这张图要看什么。最上面的灰条是 1.25 MB 的 HEIC 原文件。下面依次是三个内核构建转出的 JPG 质量 80 以及 Chromium 转出的 WebP 75 和 PNG。最显眼的是最下面那根红条。PNG 有 13.52 MB,约是 HEIC 的 10.8 倍。在我的五个样本里 PNG 是 HEIC 的 9.4 到 10.8 倍。PNG 是无损格式。一张 1200 万像素的照片按无损存就是会这么大。第二处要看的是三根 JPG。同样填的是质量 80,WebKit 构建转出的 1.72 MB 是 Chromium 那份 662.2 KB 的 2.66 倍。原因是各家对「质量 80」的换算方式不一样。同一个数字跨浏览器不能直接比。
那 HEIC 转 JPG 到底会变大还是变小?在这组合成样本上 JPG 80 比 HEIC 小。可这跟样本有关:sips 的默认质量偏高而画面又带噪声,HEIC 本身就不算小。另一轮测试用的是公开照片经 sips 转成的 HEIC,转 JPG 后反而大了 37% 到 61%。我现在不下一般结论,只在转完之后直接看新文件多大再决定用哪个。
六、我现在读取 HEIC 的顺序
前面五章是拆开讲的。串起来之后我在课设里最后是这么写的:
- 用户选了文件先看扩展名或文件头是不是 HEIC。文件头第 4 到第 12 字节是
ftyp加品牌名,我的样本是ftypheic。 - 调用
tryNative()让浏览器先试一次,成功就直接用而且一个字节都不多下载。 - 失败了再按需
import()解码器并告诉用户正在加载解码器。能放进 Worker 就放进 Worker,否则大图会卡页面。 - 解码后读四个角或者看一眼预览来确认图是正的。转出的文件里 Orientation 写 1 或者不写。
- 导出时确认 ICC 和数值是同一个色彩空间。libheif 路径要写回 P3 的 ICC 而原生路径保持 sRGB。
- 转完看体积和宽高。宽高应该是转正以后的宽高。PNG 大到离谱是正常现象,要不要用 PNG 看需求。
第 3 步我在课设里还没来得及挪进 Worker,现在仍是主线程解。按 M4 上的数 12MP 大约会卡 0.4 秒,我先这样放着。第 5 步我也还没做完,现在导出的 JPG 标的还是 sRGB。
七、适用边界与风险提示
这些结论适用于什么。适用于在浏览器里读取 HEIC、再转成 JPG、PNG、WebP 的前端链路。适用于 libheif-js 这一类 WASM 解码器以及对 Chromium、WebKit、Firefox 三类内核行为的判断。四段代码可以直接拿去做自己的实验,改成自己的文件路径就能跑。
不适用于什么 。不适用于真 iPhone 原片的全部情况。iPhone 原片常见的 HDR 增益图、实况照片、深度图、10 bit 色深和 nclx 色彩描述我的样本一样都没有。不适用于 iOS Safari、Safari 正式版、Firefox 正式版、Edge 和微信内置浏览器。不适用于手机上的耗时,因为我只有 M4 的数。也不适用于在网页里写出 HEIC,这一段我没测到任何实际行为。
风险提示。第一是解码放在主线程会卡页面。48MP 在 M4 上就卡了约 1.6 秒,手机上只会更久而具体多久我没测。第二是内存我没测。48MP 解成 RGBA 光像素就要 8064×6048×4 字节,大约 195 MB。这是算出来的而不是测出来的,WASM 自己的堆还要另算。低内存手机会不会崩我不知道。第三是元数据:画布直接导出的 JPG 会连同 GPS 一起丢掉原 EXIF。而如果你用的工具会把 EXIF 写回,GPS 也可能一起带过去。我对照的图映就是这样:转换后 7 个 GPS 标签全部保留,界面上也没有关掉它的开关。发到公开场合之前位置信息要自己另外处理。第四是 libheif 解出的像素和 macOS 系统解码的结果并不逐个相同。只有 28% 到 36% 的像素值完全一样而平均差不到 1。肉眼看不出来,可做像素级比对时要知道有这回事。
八、测量方法自身的坑
这一章记的是测量过程里会把人带偏的地方,有的是我自己踩的,有的是这轮测试记录里留下来的。它们不会出现在最终的数字里而只会出现在测量过程中。
8.1 本地服务器给的 MIME 类型会干扰判断
本地服务用的是 Python 的 http.server。它给 .heic 返回的 Content-Type 是 application/octet-stream。如果只测这一种情况,看到 Chromium 读不了就很容易怀疑是不是 MIME 不对。这轮测试另外用 type 设成 image/heic 的 Blob 测了一遍,结果一样失败才排除了这个可能。任何「读不了」的结论都要先排除测试环境本身的干扰。
8.2 HEIC 转没转正不能只看宽高,也不能只看 EXIF
判断方向最直觉的办法是看宽高:竖拍的宽比高小就算对了。这个办法会被骗:sips 转出的 PNG 宽高没变、EXIF 还是 6,像素其实是横的而要靠查看器转。图映的输出像素已经转过且 EXIF 改成了 1。两种在认 EXIF 的查看器里看起来完全一样。这轮测试是在四个角放纯色块再读四个角的像素判方向。这是唯一不依赖任何元数据的判法,我的代码三也照着用了。
8.3 色差要按文件自带的 ICC 去读
同一份 libheif 路径的产物按 P3 解读时 ΔE 不超过 0.31;按 sRGB 解读则最大 6.91。原生解码路径的像素正好反过来,按 sRGB 读才对。如果只看像素数值而不管文件里嵌的 ICC,就会把对的判成错、把错的判成对。我现在算色差之前一定先读 ICC。
8.4 过滤条件写成子串匹配,把有效数据删了
这轮测试记录里有一个很典型的坑。为了排除页面探测能力时用的 4×4 小画布,第一版过滤条件写的是尺寸字符串里含 4x4 就删。结果 3024×4032 写成字符串是 3024x4032 而中间正好也有 4x4。竖拍样本的记录全被当成探测画布删掉了。改成比对完整的尺寸字符串才对。我看到这条之后专门回去查了自己的脚本,还好没犯。
8.5 HEIF 盒子长度字段为 1 的时候
代码一的第一版没有处理 64 位长度,跑出来顶层是 mdat 1,后面还跟着几个乱码盒子。规范里规定长度字段写 1 时真正的长度放在后面 8 个字节里。mdat 装的是全部图像数据,常常用这种写法。加上一行判断之后三个顶层盒子的长度加起来正好等于文件大小:32 + 3309 + 1307544 = 1310885。以后解析二进制格式我都会核对一次各段加起来等不等于文件大小。
8.6 「有 ICC」不等于「颜色保住了」
这就是 5.3 里说的那件事。第一版代码四只返回 icc: true。Chromium 那几行全是 true,我差点就写下「Chromium 导出会保留色彩配置」。再往下读一层 ICC 的名字才看到是 sRGB。现在代码四会把 ICC 的名字一起打出来。
九、还没解决的
真 iPhone 原片 。上面说的 HDR 增益图、实况照片、深度图、10 bit 和 nclx 全部没覆盖。代码三固定取 list[0],对多图 HEIC 来说取到的是不是主图我没有样本验证。
为什么块的尺寸会变 。12MP 是 512×512,48MP 是 896×1024。sips 按什么规则选块尺寸、iPhone 原片是不是一样我都不知道。
Firefox 构建为什么慢 14 到 16 倍。同一份 WASM 在 Chromium 和 WebKit 构建上几乎一样快,只有 Firefox 构建差了一个数量级。我没查出原因也没在 Firefox 正式版上验证。
P3 的 ICC 怎么写回 JPG。我知道该写也知道画布 API 做不了。自己拼 APP2 段的代码还没写好,写好之后要再量一次 ΔE 才算数。
Worker 版本。把解码挪进 Worker 之后卡顿能降多少、传回像素要多花多少时间我还没测。下一步我会先把代码三原样搬进 Worker 再用长任务的数对照一次。
参考资料
- ISO/IEC 23008-12(HEIF,高效图像文件格式)。
ftyp、meta、iinf、grid、ispe、irot等盒子与条目的定义。 - ISO/IEC 14496-12(ISO 基础媒体文件格式)。盒子的通用结构,含长度字段为 1 时的 64 位长度写法。
- ITU-T H.265 / ISO/IEC 23008-2(HEVC)。HEIC 图块使用的编码标准。
- libheif 与 libde265 的开源项目文档,以及 libheif-js 的接口说明(
HeifDecoder、decode、display)。 - HTML Standard(WHATWG)。
HTMLImageElement.decode()、createImageBitmap()、canvas.toBlob()的行为定义。 - WebCodecs(W3C)。
ImageDecoder.isTypeSupported()的定义。 - ICC.1 规范(International Color Consortium)。ICC 配置文件的结构,以及它在 JPEG 里以
ICC_PROFILE段嵌入的方式。 - CIE 142-2001。CIEDE2000 色差公式。
- Long Tasks API(W3C)。长任务的定义与 50 毫秒阈值。
全部样本、脚本与原始输出都留在本机的证据目录里。四段代码可以原样复跑。