一、抽取图片特征和坐标
- 给定任意一张图片,可以将图像中的所有包含的物体信息抽取出来,并获得其对应在图像上的坐标信息
1.1 任务一:抽取图像包含的所有物品
使用 RAM 完成上述任务。与 CLIP 不同,RAM 默认提供了可识别的物体类别列表,详见:https://github.com/xinyu1205/recognize-anything/blob/main/ram/data/ram_tag_list.txt(共计 4,585 类标签的识别) 需要pip的话打开这个开源项目然后按照他上面的pip安装
py
import argparse
import numpy as np
import random
import os
import torch

from PIL import Image
from ram.models import ram_plus, ram
from ram import inference_ram as inference
from ram import get_transform

device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
print(device)

image_size = 384  # 一般来说,图像分辨率越大,可识别的图像内容精细程度越高。但是随之可能带来的风险是提升识别错误的概率。
transform = get_transform(image_size=image_size)

# model = ram(pretrained="models/ram_swin_large_14m.pth",
#                 image_size=image_size,
#                 vit='swin_l')

model = ram_plus(pretrained="models/ram_plus_swin_large_14m.pth",
                 image_size=image_size,
                 vit='swin_l')
model.eval()
model = model.to(device)
py
from IPython.display import display
from PIL import Image

image_path = "data_examples/test.jpg"
image_pil = Image.open(image_path)
image = transform(image_pil).unsqueeze(0).to(device)
recog_res = inference(image, model)


display(image_pil)
print("Image Tags: ", recog_res[0])
print("图像标签: ", recog_res[1])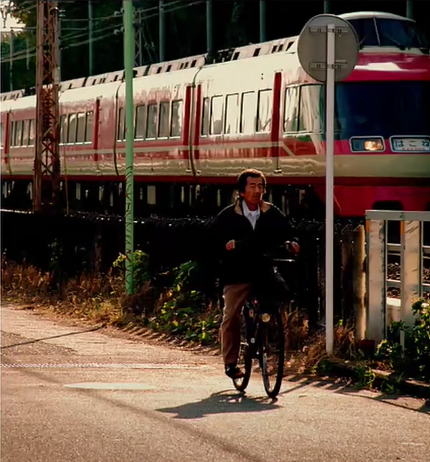
Image Tags: bicycle | man | passenger train | railroad | ride | rural | track | train | train track
图像标签: 自行车 | 男人 | 旅客列车 | 铁道 | 骑/搭乘 | 农村的 | 跑道 | 火车 | 火车轨道
1.2 任务二:根据抽取出来的物体列表,获取其在图像中的位置信息
使用 GroundingDINO 完成上述任务。
shell
pip uninstall groundingdino -y
pip install -e ./GroundingDINO
py
from groundingdino.util.inference import load_model, load_image, predict, annotate, Model
import cv2

CONFIG_PATH = "GroundingDINO/groundingdino/config/GroundingDINO_SwinT_OGC.py"
CHECKPOINT_PATH = "models/groundingdino_swint_ogc.pth"
model = load_model(CONFIG_PATH, CHECKPOINT_PATH)

image_path = "data_examples/test.jpg"
image_source, image = load_image(image_path)
# "bicycle. man. passenger train. railroad. ride. rural. track. train. train track" 你需要先告诉它识别出来哪些标签出来
TEXT_PROMPT = recog_res[0].replace(" | ", ". ")
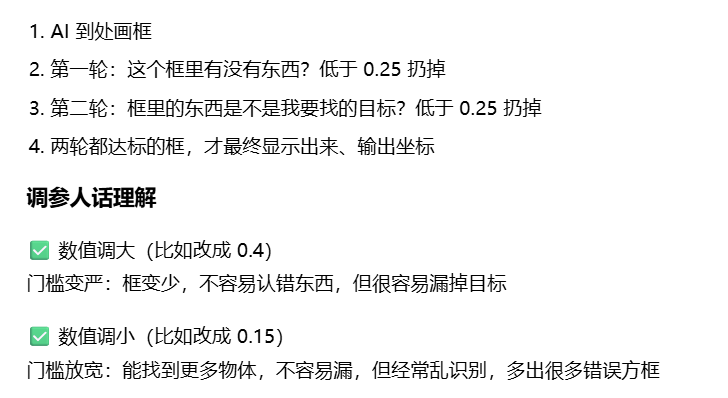
BOX_TRESHOLD = 0.25 # 执行度 下面有大白话解释
TEXT_TRESHOLD = 0.25
boxes, logits, phrases = predict(
    model=model,
    image=image,
    caption=TEXT_PROMPT,
    box_threshold=BOX_TRESHOLD,
    text_threshold=TEXT_TRESHOLD,
    device=device,
)
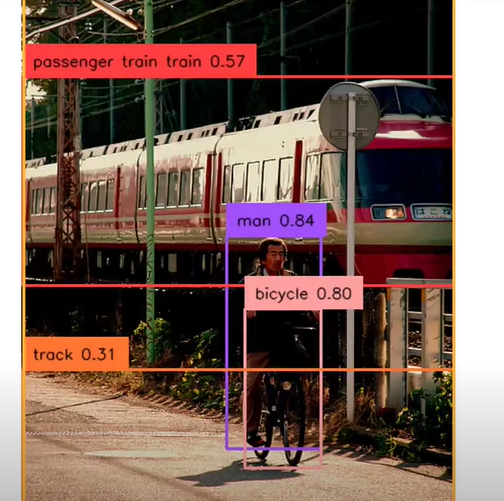
annotated_frame = annotate(image_source=image_source,
                           boxes=boxes, logits=logits, phrases=phrases)
annotated_frame = cv2.cvtColor(annotated_frame, cv2.COLOR_BGR2RGB)
annotated_frame = Image.fromarray(annotated_frame)
print(TEXT_PROMPT)
print(boxes, logits, phrases)
输出内容 做了归一化 只有0-1之间
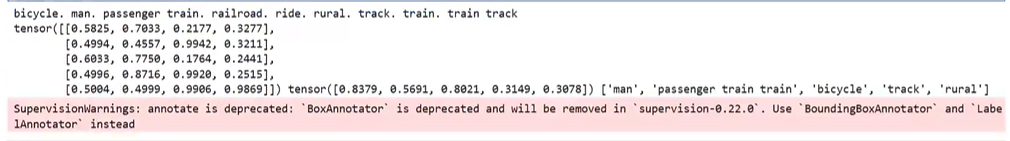
检测结果
1.2.1 两个阈值讲解大白话
1.2.1 读取出来的内容
py
def convertDINO2GPT(boxes, phrases):
    return ", ".join(f"{phrases[i]}: {boxes[i].numpy()}" for i in range(len(phrases)))

bbox_query = convertDINO2GPT(boxes, phrases)
print(bbox_query)
二、生成 LLaVA 所需训练数据(有了上述图片信息和文本信息后)
准备 GPT4 API 调用函数:
- query_gpt4_vision:调用 gpt-4v 接口,生成详细图像描述;
- query_gpt4_text:调用 gpt4 文本模型接口,生成对话语料以及复杂逻辑推理问题。
py
from openai import OpenAI
import io
import base64
import os

# Function to encode the image to base64
def encode_image_to_base64(image):
    buffered = io.BytesIO()
    image.save(buffered, format="JPEG")
    return base64.b64encode(buffered.getvalue()).decode('utf-8')

# Function to query GPT-4 Vision
def query_gpt4_vision(messages, api_key=os.getenv('OPENAI_API_KEY')):
    client = OpenAI(api_key=api_key)
		response = client.chat.completions.create(
		    model="gpt-4o",
		    messages=messages,
		    max_tokens=4096,
		)
		return response.choices[0].message.content
# Function to query GPT-4 Vision
def query_gpt4_text(messages, api_key=os.getenv('OPENAI_API_KEY')):
    client = OpenAI(api_key=api_key)

    response = client.chat.completions.create(
        model="gpt-4",
        messages=messages,
        max_tokens=2048,
    )
    return response.choices[0].message.content
2.1 数据类型一: 生成文本描述
当初心名人场景,比如蔡徐坤,这些等等图像资料,那么在生成文本的话,它会自动带入中分背带裤等信息更加丰富,可以把你图像资料带入到提示词中
py
from IPython.display import display
from PIL import Image

# 系统提示词:引导GPT4o生成精细图像描述
system_message_description = """你是一个功能强大的中文图像描述器。请创建详细的描述,阐述给定图片的内容。包括物体的类型和颜色、计算物体的数量、物体的动作、物体的精确位置"""

image_path = "data_examples/test.jpg"
image = Image.open(image_path)
base64_image = encode_image_to_base64(image)

# 组装多模态messages结构(gpt-4o/gpt4v标准格式)
messages = [
    {"role": "system", "content": system_message_description},
    {
        "role": "user",
        "content": [
            {
                "type": "image_url",
                "image_url": {"url": f"data:image/jpeg;base64,{base64_image}"}
            }
        ]
    }
]

# 调用视觉接口,得到长文本图像摘要
gpt4v_description = query_gpt4_vision(messages)

display(image)       # Notebook里展示原图
print(gpt4v_description) # 打印GPT生成的图像详细描述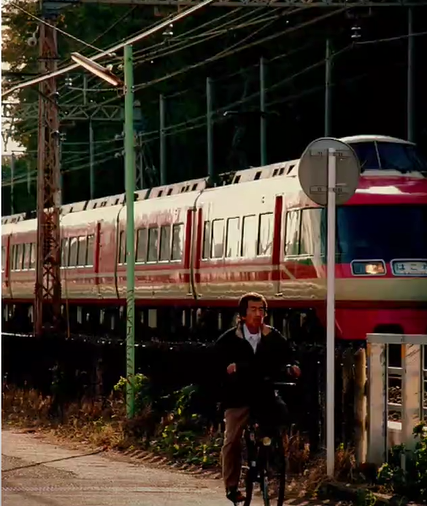
描述结果:这张照片展示了一位骑自行车的男子,他在一个铁路道口附近。男子穿着深色上衣和浅色裤子,正骑着一辆黑色自行车,位于图片的前景偏右。铁路上可以看见铁轨,铁路上方有许多电线和支架。铁路的左侧有一个绿色的柱子和一些铁架结构。前景中右侧有一个圆形标志牌,标志牌的具体内容不可辨认。旁边还可见一些灌木,整体环境显得相对安静。
2.2 数据类型二:带有对话类的数据(从数据类型一中结果来生成对话类型数据)
py
system_message_conversation = f"""你是一个AI视觉助手,你正在观看一张图片。你看到的可能是描述一副图片的若干句子,它们描述了你正在看的同一张图片。回答所有问题时,你要像图像专家一样识别
(1) 可以在图片中看到问题所询问的内容,并能给出自信地回答;
(2) 可以明确在图像中看不到的内容。不要提出任何无法自信回答的问题。

还要包括与图片内容相关的复杂问题,例如询问图片中物体的背景知识,讨论图片中正在发生的事件等。同样,不要询问不确定的细节。在回答复杂问题时提供详细答案。例如,给出详细的例子"""

fewshot_samples = [{
    "context": "这是一家电影院,放映时间显示在门上方。一个红色的消防栓深埋在雪中。消防栓位于一条最近刚刚清扫过的人行道旁的雪地里。这个城市经历了一个雪量非常大的严冬。",
    "response": f"""问题:
图片中的消防栓是什么颜色?
===
答案:
图片中的消防栓是红色的。
===
问题:
消防栓是否被雪完全覆盖还是部分可见?
===
答案:
消防栓部分可见,其大部分被深雪覆盖。
===
问题:
消防栓附近的人行道状况如何?
===
答案:
人行道最近刚刚清扫过。"""
},{"context": "一名男子正在开阔的雪地山丘上滑雪。一名滑雪者正滑入雪地。滑雪者位于一座巨大山脉的山麓。一名滑雪者站在小山上",
"response": f"""问题:
这个滑雪者在做什么?
===
答案:
这个滑雪者正在雪覆盖的山丘上滑雪,他穿越雪地,享受着美丽的山景。他们还站在一块指示他们在山上位置的小路标识牌旁边。
===
问题:
图片中有其他人或滑雪者可见吗?
===
答案:
不,图片中只有一个人在滑雪,他们被许多灌木丛所包围。
===
问题:
这个人在做什么类型的滑雪?越野滑雪还是高山滑雪?
===
"""
}]

messages = [{"role": "system", "content": system_message_conversation}]
for sample in fewshot_samples:
    messages.append({"role": "user", "content": sample['context']})
    messages.append({"role": "assistant", "content": sample['response']})
messages.append({"role": "user", "content": '\n'.join(gpt4v_description)})
py
from IPython.display import display
from PIL import Image

gpt4t_conversation = query_gpt4_text(messages)

display(image)
print(gpt4t_conversation)
返回的结果如下:
text
问题:
图片中的男子穿着什么颜色的衣服?
===
答案:
照片中的男子穿着深色的上衣和浅色的裤子。
===
问题:
男子正在骑什么颜色的自行车?
===
答案:
男子正在骑一辆黑色的自行车。
===
问题:
列车的颜色是什么?
===
答案:
列车的颜色是红色和白色相间的。
2.3 数据类型三:生成复杂推理类问题(例如带有位置远近,比如火车旁边是一个人在骑自行车)
这里需要结合图像解析过程最终得到的物体在图像上的坐标信息bbox_query,来辅助构建一些复杂推理类问题。
py
import json
system_message_reasoning = f"""你是一个可以分析单张图片的AI视觉助手。你收到了若干句子,每个句子都描述了你正在观察的同一张图片。
任务是利用提供的标题和边界框信息,创建一个关于图片的合理问题,并详细提供答案。

创建超出描述场景的复杂问题。要回答这样的问题,首先需要理解视觉内容,然后根据背景知识或推理,解释为什么会发生这种情况,或者
在描述场景时,不要直接提及边界框坐标,而是利用这些数据用自然语言解释场景。包括物体的数量、物体的位置、物体之间的相对位置等
在使用标题和坐标的信息时,直接解释场景,不要提及信息来源是标题或边界框。始终回答得好像你是直接在看这幅图片。

要求'问题'和'答案'交替输出,中间用单独一行'==='隔开
"""
# 下面这个案例就举例几个自己加入案例即可
fewshot_samples = [
{
"context": f"""一个戴着多根领带的男人做鬼脸。
一个穿着白衬衫戴着很多领带的男人。
一个戴着领带的男人摆姿势照相。
一个脖子上戴着多根领带的男人。
一个年轻男子戴着几条领带微笑着。
tie: [0.574, 0.298, 0.752, 0.704]
tie: [0.464, 0.339, 0.639, 0.789]
tie: [0.349, 0.363, 0.563, 0.732]
tie: [0.259, 0.255, 0.668, 0.805]
person: [0.019, 0.065, 0.962, 0.988]
person: [0.0, 0.24, 0.214, 1.0]
tie: [0.316, 0.778, 0.443, 0.867]
tie: [0.386, 0.707, 0.496, 0.801]
tie: [0.251, 0.354, 0.402, 0.747]
tie: [0.44, 0.318, 0.63, 0.397]
tie: [0.566, 0.33, 0.655, 0.543]
tie: [0.25, 0.409, 0.359, 0.556]""",
"response": f"""问题:
这张照片有什么不寻常之处?
===
答案:
在照片中,这个男人脖子上戴了多条领带。这被认为是不寻常的,因为通常情况下,一个人只会戴一条领带。这个男人傻笑的表情也增加了"""
},
{
"context": f"""一群人站在一辆黑色车辆外面,带着各种行李。
行李散落在地下停车场的一辆车周围。
人们试图把所有的行李都塞进一辆SUV中。
这辆运动型多用途车停在公共车库里,正在为一次旅行做准备。
一些人带着行李靠近一辆用于运输的货车。
# 下方这里后续还会跟上 person、car、luggage 对应的 bbox 坐标列表(截图未展示完整)
""",
# 这里省略第二条的response,结构和第一条保持一致
},
]
# 1. 初始化消息列表,先放入系统提示词(推理任务system prompt)
messages = [{"role": "system", "content": system_message_reasoning}]

# 2. 遍历所有少样本示例,组装 user/assistant 对话对(Few-shot 上下文学习)
for sample in fewshot_samples:
    # 把样本context作为用户输入
    messages.append({"role": "user", "content": sample['context']})
    # 把标准答案response作为模型回复
    messages.append({"role": "assistant", "content": sample['response']})

# 3. 添加【当前待推理图片】的输入:图片描述 + bbox检测信息
messages.append({"role": "user", "content": '\n'.join([gpt4v_description, bbox_query])})

# 4. 格式化打印完整对话报文
print(json.dumps(messages, indent=2, ensure_ascii=False))
py
# 1. 导入jupyter交互显示工具(仅在Notebook环境生效:Jupyter / Colab)
from IPython.display import display
# 2. PIL图像处理库,用来加载图片对象image
from PIL import Image

# 3. 调用封装好的接口函数,把上一步组装完成的messages对话报文送入大模型
# query_gpt4_text:自定义封装的GPT文本接口函数(调用gpt-4-turbo等纯文本模型)
# gpt4t_reasoning:接收模型返回的推理文本结果
gpt4t_reasoning = query_gpt4_text(messages)

# 4. 在Notebook里展示原始图片
display(image)

# 5. 控制台打印模型输出的推理答案
print(gpt4t_reasoning)
输出结果如下:
问题:
骑自行车的男子离行驶中的列车有多近?
===
答案:
尽管这个男子正在靠近一个铁路道口骑自行车,但他与行驶中的列车之间仍有足够的距离。这可能是由于他知道列车的存在,并且在保持一定的安全距离以防止任何意外。因此,尽管他在铁路道口骑自行车,他并未站在靠近列车的轨道上,他是在安全的地方。然而,尽管他保持了安全的距离,但他应始终保持警惕,并遵守相关的安全规定,以防止任何不测。
py
import re
def parser_gpt4_return(input_string, first_block=True):
    # Split the input string into blocks based on the question and answer pattern
    blocks = re.split(r"===\n", input_string.strip())

    # Create a list to hold conversation elements
    conversations = []

		# Process each block to extract questions and answers
		for block in blocks:
		    lines = block.split("\n")
		    if lines[-1] == "":
		        lines = lines[:-1]
		    if lines:
		        if lines[0][:3] == "问题:":
		            if first_block:
		                conversations.append({"from": "human", "value": "<image>\n" + "\n".join(lines[1:])})
		                first_block = False
		            else:
		                conversations.append({"from": "human", "value": "\n".join(lines[1:])})
		        elif lines[0][:3] == "答案:":
		            conversations.append({"from": "gpt", "value": "\n".join(lines[1:])})
		        else:
		            raise ValueError(f"lines[0] should be Answer: or Question. Unexpected: -{lines[0]}-")
		return conversations
py
# 调用示例
parsed_json = parser_gpt4_return(gpt4t_conversation)
parsed_json += parser_gpt4_return(gpt4t_reasoning, first_block=False)
print(json.dumps(parsed_json, indent=2, ensure_ascii=False))
json
[
  {
    "from": "human",
    "value": "<image>\n图片中的男子穿着什么颜色的衣服? "
  },
  {
    "from": "gpt",
    "value": "照片中的男子穿着深色的上衣和浅色的裤子。"
  },
  {
    "from": "human",
    "value": "男子正在骑什么颜色的自行车? "
  },
  {
    "from": "gpt",
    "value": "男子正在骑一辆黑色的自行车。"
  },
  {
    "from": "human",
    "value": "图片背景里可以看到树木吗?"
  },
  {
    "from": "gpt",
    "value": "可以看到,画面的背景中有绿色的树木。"
  },
  {
    "from": "human",
    "value": "男子是在白天骑行吗?"
  },
  {
    "from": "gpt",
    "value": "是的,光线充足,可以判断是白天。"
  }
]
三、训练
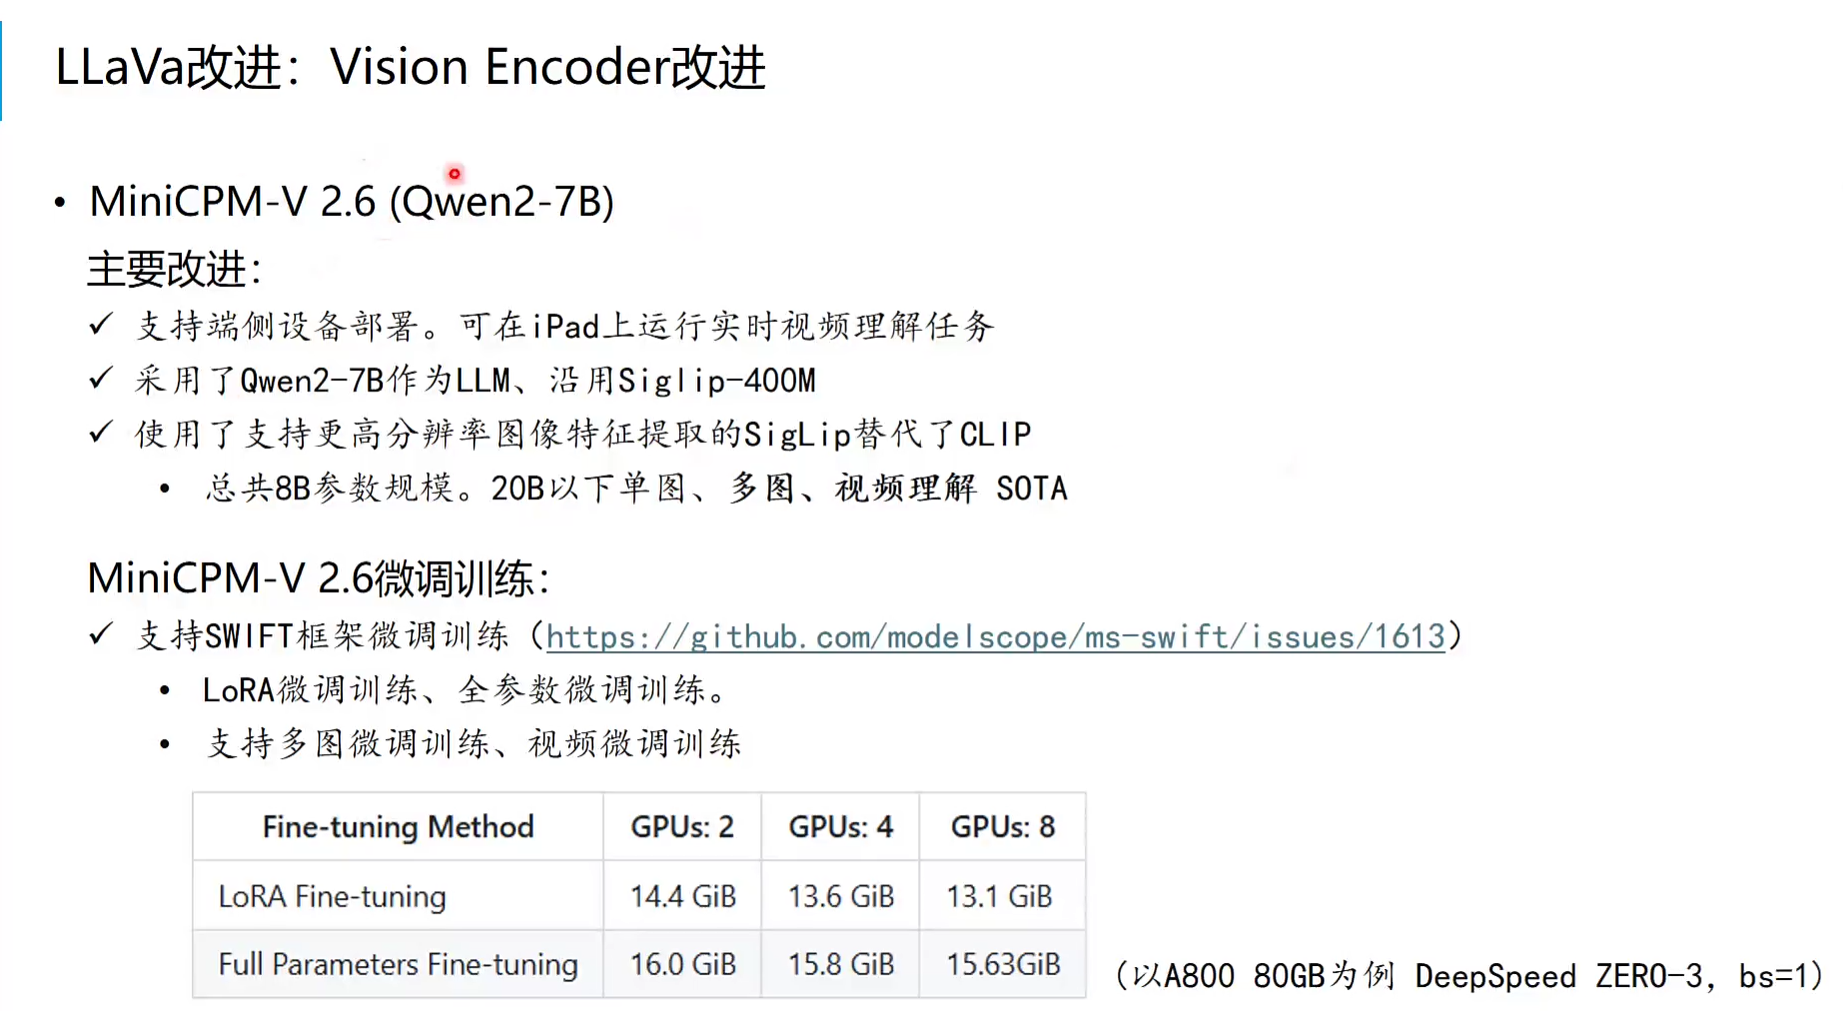
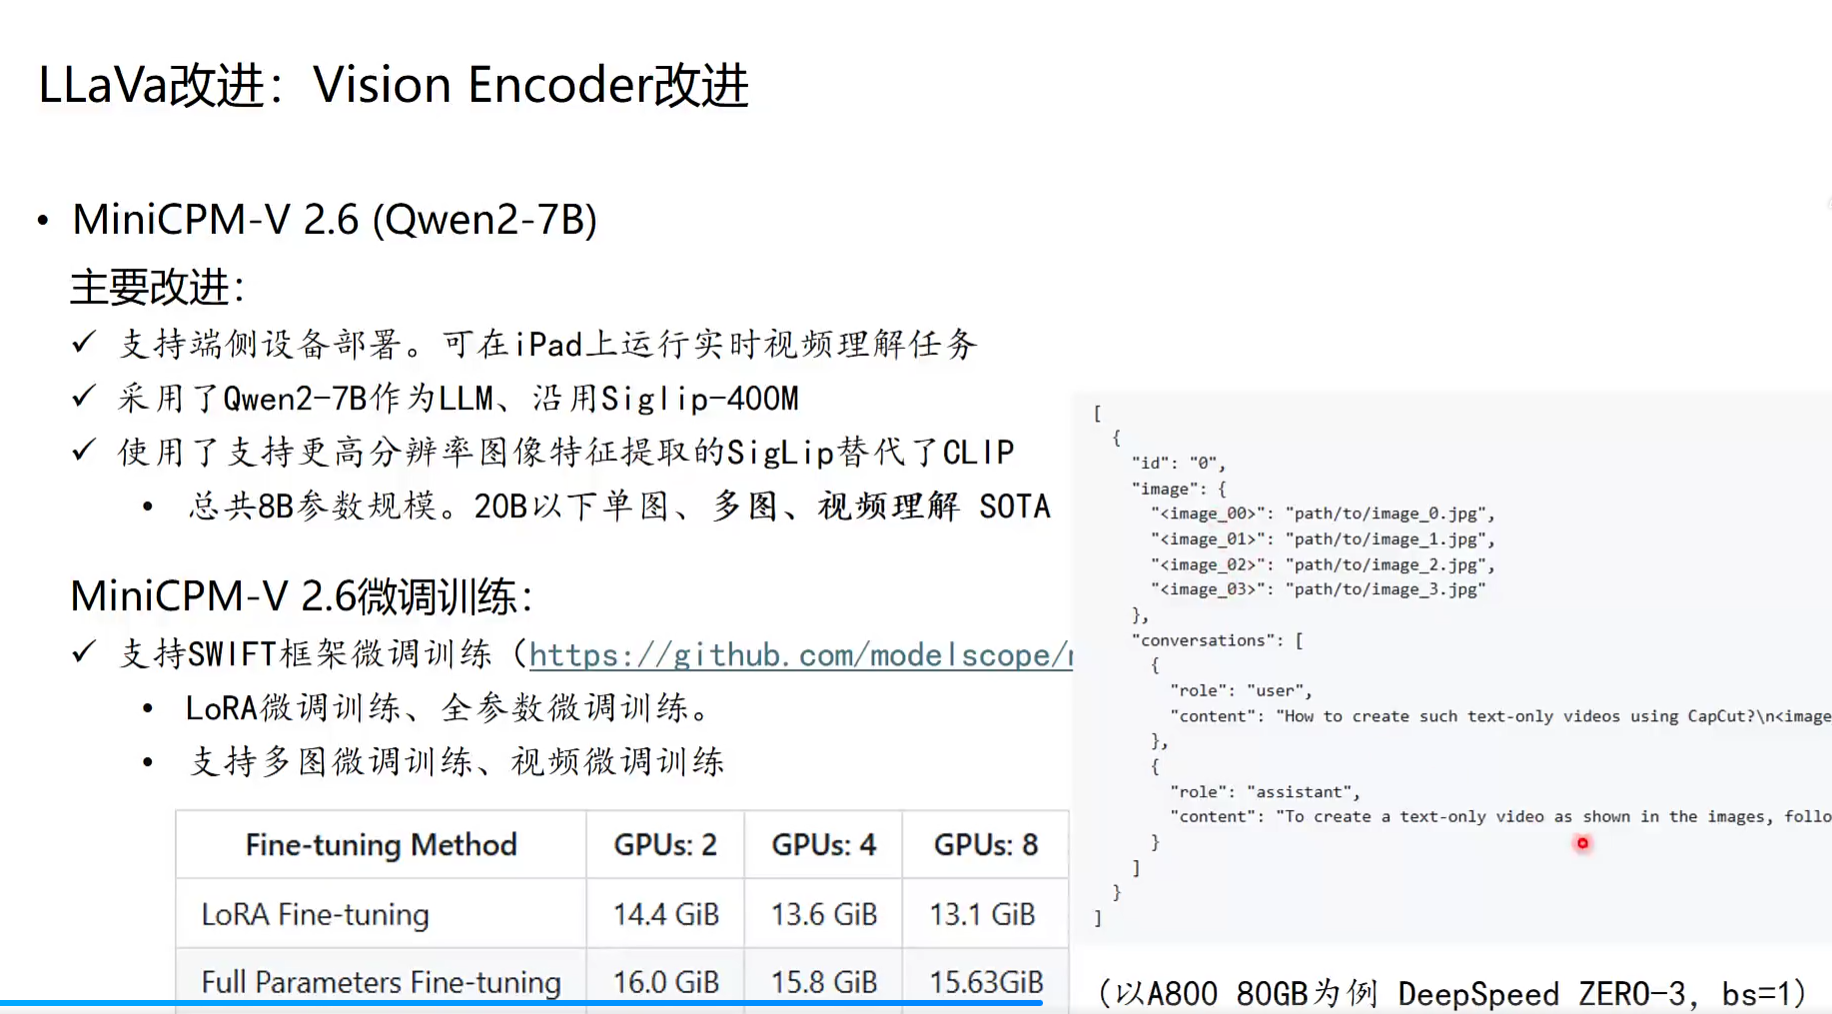
3.1 模型介绍
3.1.1 单张图片的理解
3.1.1 多张图片的理解
3.2 训练过程介绍
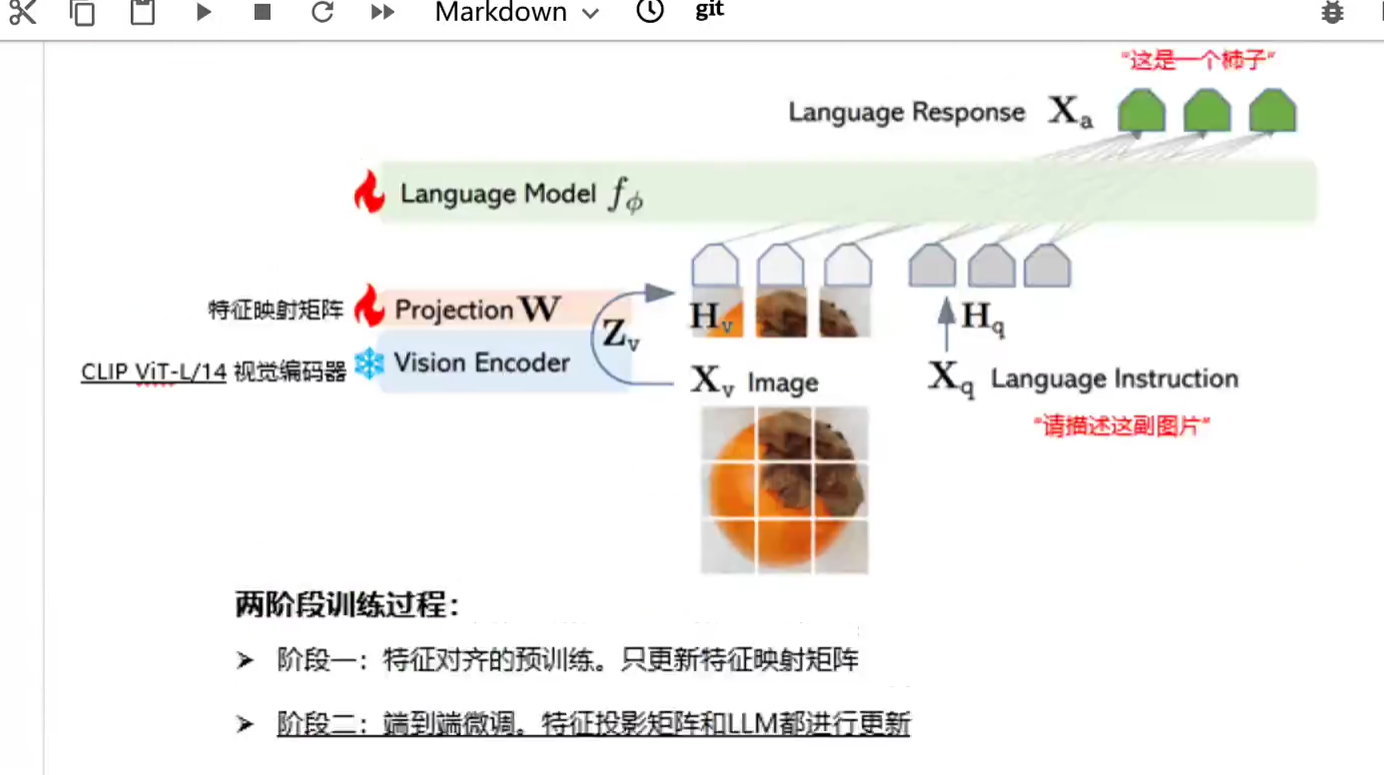
LLaVA 模型的训练分为两个主要阶段:
- 特征对齐的预训练。只更新特征映射矩阵
- 端到端微调。特征投影矩阵和 LLM 都进行更新
3.2.1 阶段一:图文特征对齐与训练
基本数据格式
json
{
    "id": "任意一个非重复id,例如 0888888",
    "image": "",
    "conversations": [
        {
            "from": "human",
            "value": "请简要描述这幅图像。\n<image>"
        },
        {
            "from": "gpt",
            "value": "这张图片中显示了一名男子骑自行车和一列正在行驶的火车。前台的男子穿着深色上衣和裤子,看起来有亚洲面孔,他正骑着一辆深色自行车,从左向右穿过画面,并且与镜头形成了接近正面的视角。他的表情专注,似乎正在前往某个目的地。

在他的后方,可以看到一列红色和白色相间的高速火车,火车车身上有几个窗户,火车上方有电网。火车左边的树木使得场景给人一种自然的氛围。在图片的左上角部分,还有一个路牌,上面有日文和英文的混合文本,但具体内容不清晰。整个场景是在室外拍摄的,光线来自自然光,可能是在傍晚或清晨,因为阳光有点斜射到场景中。

整体上,这张照片创造了一种行驶中的火车与骑自行车的人共同构成的动态场面,可能在日本的城市郊外或者乡村地区拍摄。。"
        }
    ]
}
开始训练
- 8xA100(80GB)耗时 5.5h
- 基于DeepSpeed ZeRO2
- 输入图像分辨率336 px
- 训练参数:特征映射层结构(2层全连接)
shell
deepspeed llava/train/train_mem.py \
    --deepspeed ./scripts/zero2.json \
    --model_name_or_path lmsys/vicuna-13b-v1.5 \
    --version plain \
    --data_path ./playground/data/LLaVA-Pretrain/blip_laion_cc_sbu_558k.json \
    --image_folder ./playground/data/LLaVA-Pretrain/images \
    --vision_tower openai/clip-vit-large-patch14-336 \
    --mm_projector_type mlp2x_gelu \
    --tune_mm_mlp_adapter True \
    --mm_vision_select_layer -2 \
    --mm_use_im_start_end False \
    --mm_use_im_patch_token False \
    --bf16 True \
    --output_dir ./checkpoints/llava-v1.5-13b-pretrain \
    --num_train_epochs 1 \
    --per_device_train_batch_size 32 \
    --per_device_eval_batch_size 4 \
    --gradient_accumulation_steps 1 \
	  --evaluation_strategy "no" \
		--save_strategy "steps" \
		--save_steps 24000 \
		--save_total_limit 1 \
		--learning_rate 1e-3 \
		--weight_decay 0. \
		--warmup_ratio 0.03 \
		--lr_scheduler_type "cosine" \
		--logging_steps 1 \
		--tf32 True \
		--model_max_length 2048 \
		--gradient_checkpointing True \
		--dataloader_num_workers 4 \
		--lazy_preprocess True \
		--report_to wandb
3.2.2 阶段二:图-文指令微调训练
基本数据格式:
json
{
    "id": "任意一个非重复id,例如 0999999",
    "image": "图像文件路径,例如: my_data/hongyadong.jpg ",
    "conversations": [
        {
            "from": "human",
            "value": "<im图中的男子正在做什么?拍摄于哪里?"
        },
        {
            "from": "gpt",
            "value": "图中的男子正在骑自行车,他的视线专注,看起来他正在前往某个目的地。市洪崖洞景区的照片."
        },
        {
            "from": "human",
            "value": "图中有什么可以识别的文字内容?"
        },
        {
            "from": "gpt",
            "value": "图片右下角墙体上写着\"洪崖洞\"三个字."
        }
    ]
},
开始训练
- 8x A100 (80GB) 耗 20h
- 基于 DeepSpeed ZeR3
- 输入图像分辨率 336 px
- 训练参数:特征映射层结构(2 层全连接层以及 LLM
训练脚本: finetune.sh LoRA 训练脚本: finetune_lora.sh
shell
#!/bin/bash

deepspeed llava/train/train_mem.py \
    --deepspeed ./scripts/zero3.json \
    --model_name_or_path lmsys/vicuna-13b-v1.5 \
    --version v1 \
    --data_path ./playground/data/llava_v1_5_mix665k.json \
    --image_folder ./playground/data \
    --vision_tower openai/clip-vit-large-patch14-336 \
    --pretrain_mm_mlp_adapter ./checkpoints/llava-v1.5-13b-pretrain/mm_projector.bin \
    --mm_projector_type mlp2x_gelu \
    --mm_vision_select_layer -2 \
    --mm_use_im_start_end False \
    --mm_use_im_patch_token False \
    --image_aspect_ratio pad \
    --group_by_modality_length True \
    --bf16 True \
    --output_dir ./checkpoints/llava-v1.5-13b \
    --num_train_epochs 1 \
    --per_device_train_batch_size 16 \
    --per_device_eval_batch_size 4 \
    --gradient_accumulation_steps 1 \
    --evaluation_strategy "no" \
    --save_strategy "steps" \
    --save_steps 50000 \
    --save_total_limit 1 \
    --learning_rate 2e-5 \
    --weight_decay 0. \
    --warmup_ratio 0.03 \
    --lr_scheduler_type "cosine" \
    --logging_steps 1 \
    --tf32 True \
    --model_max_length 2048 \
    --gradient_checkpointing True \
    --dataloader_num_workers 4 \
    --lazy_preprocess True
    --report_to wandb
需要注意的是这几个参数
shell
   --version v1 \ # 进行阶段2的训练了
   --data_path ./playground/data/llava_v1_5_mix665k.json \ # 是阶段二指令微调的数据了
   --pretrain_mm_mlp_adapter ./checkpoints/llava-v1.5-13b-pretrain/mm_projector.bin \# 是上一阶段产物
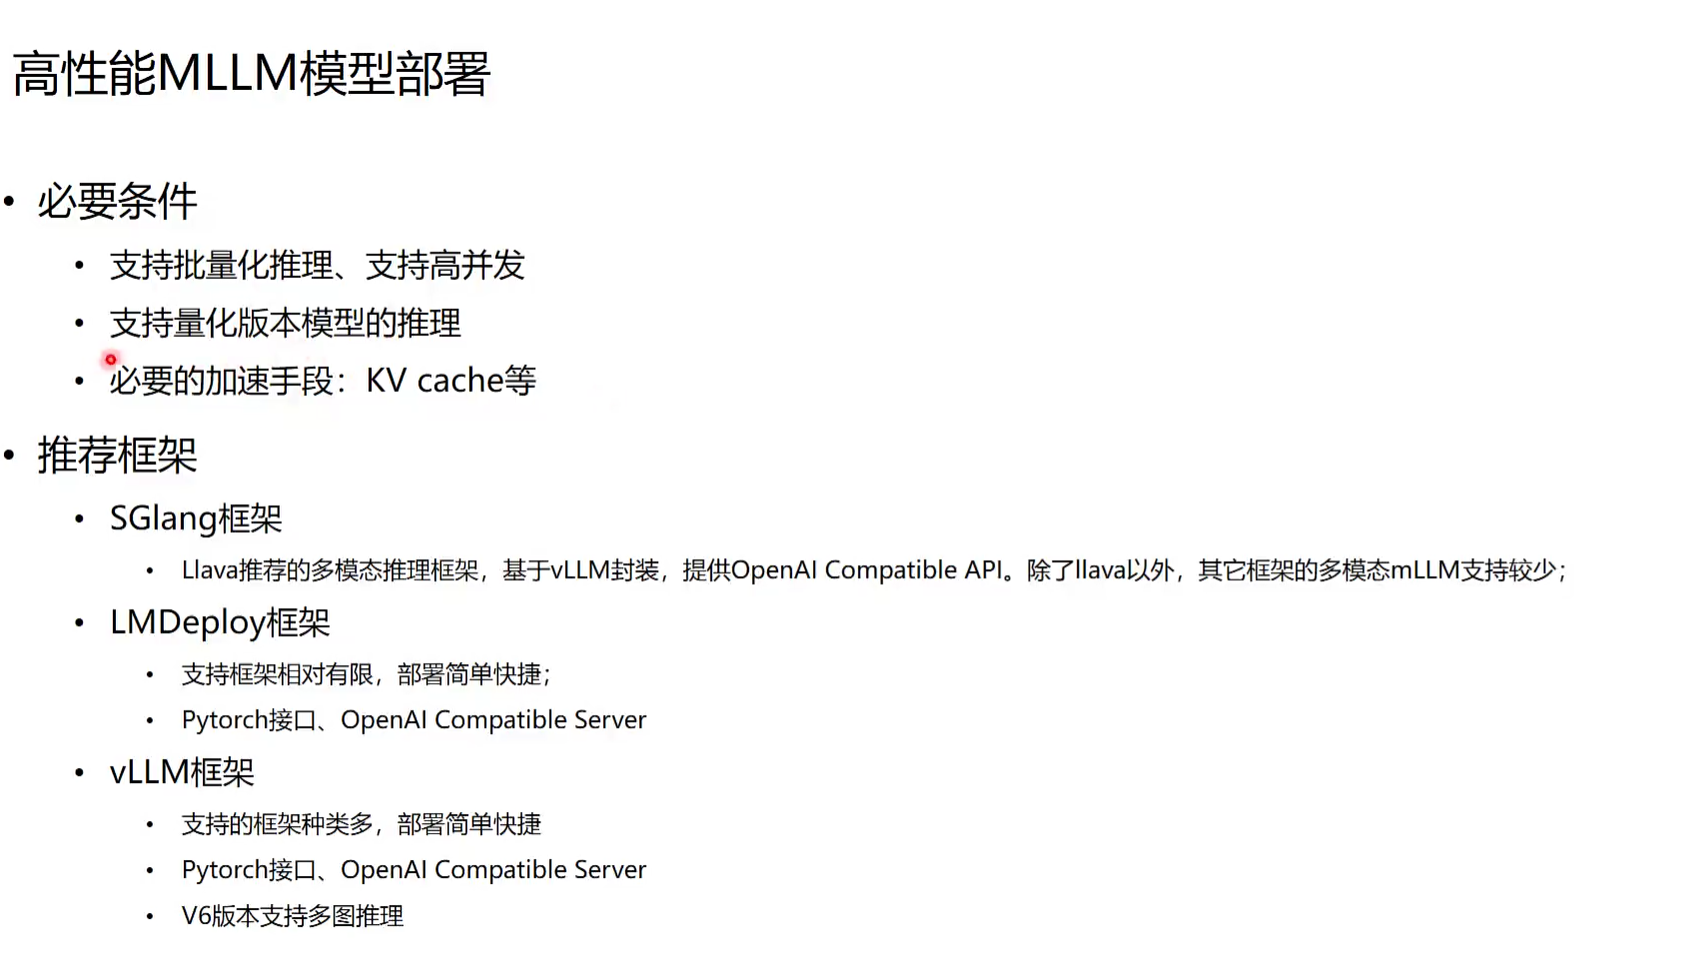
四、高性能模型部署推荐
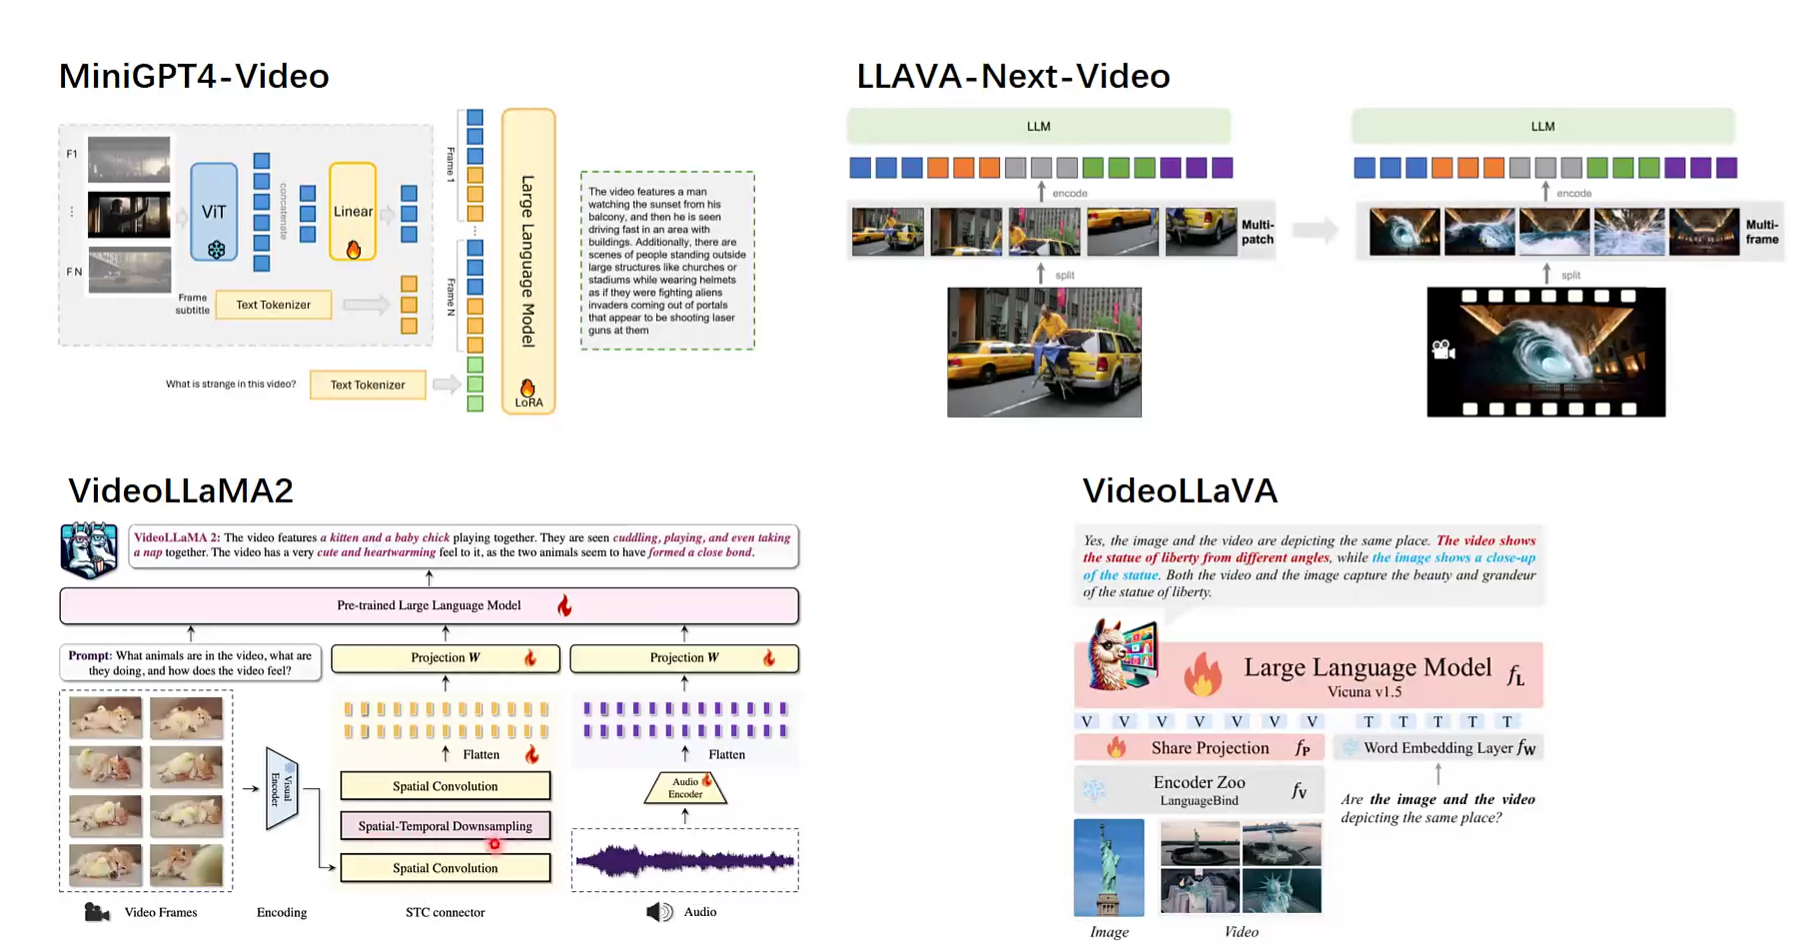
五、支持视频输入的MLLM
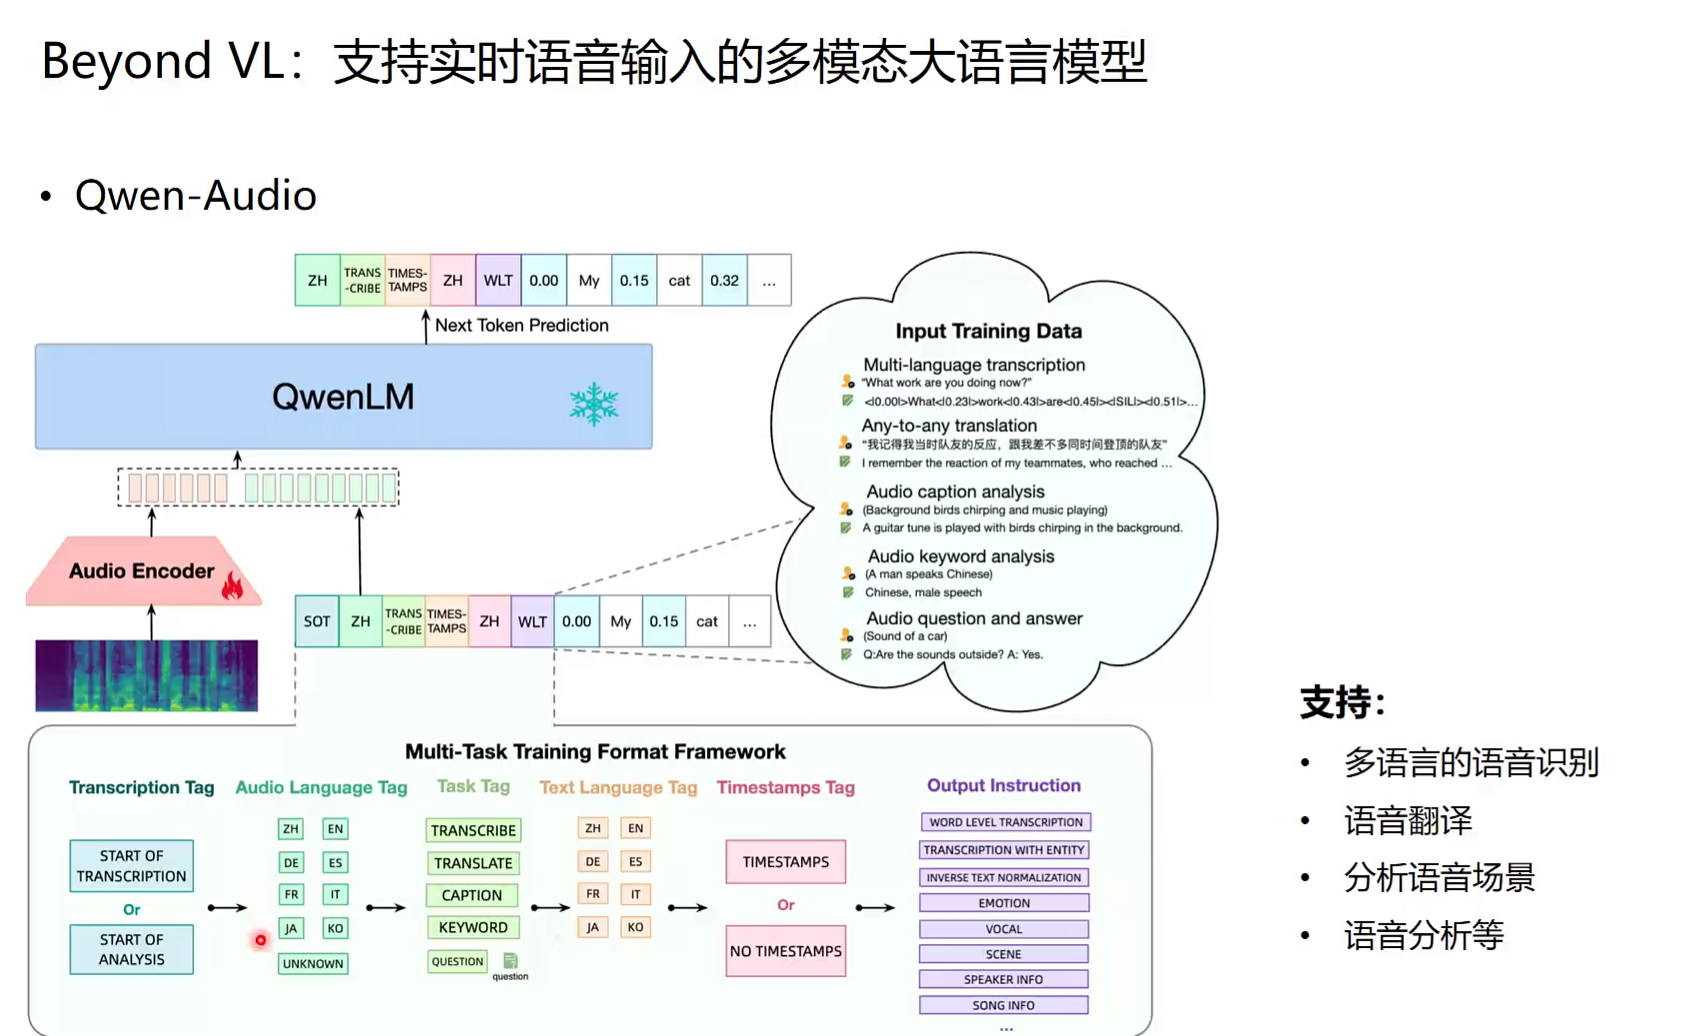
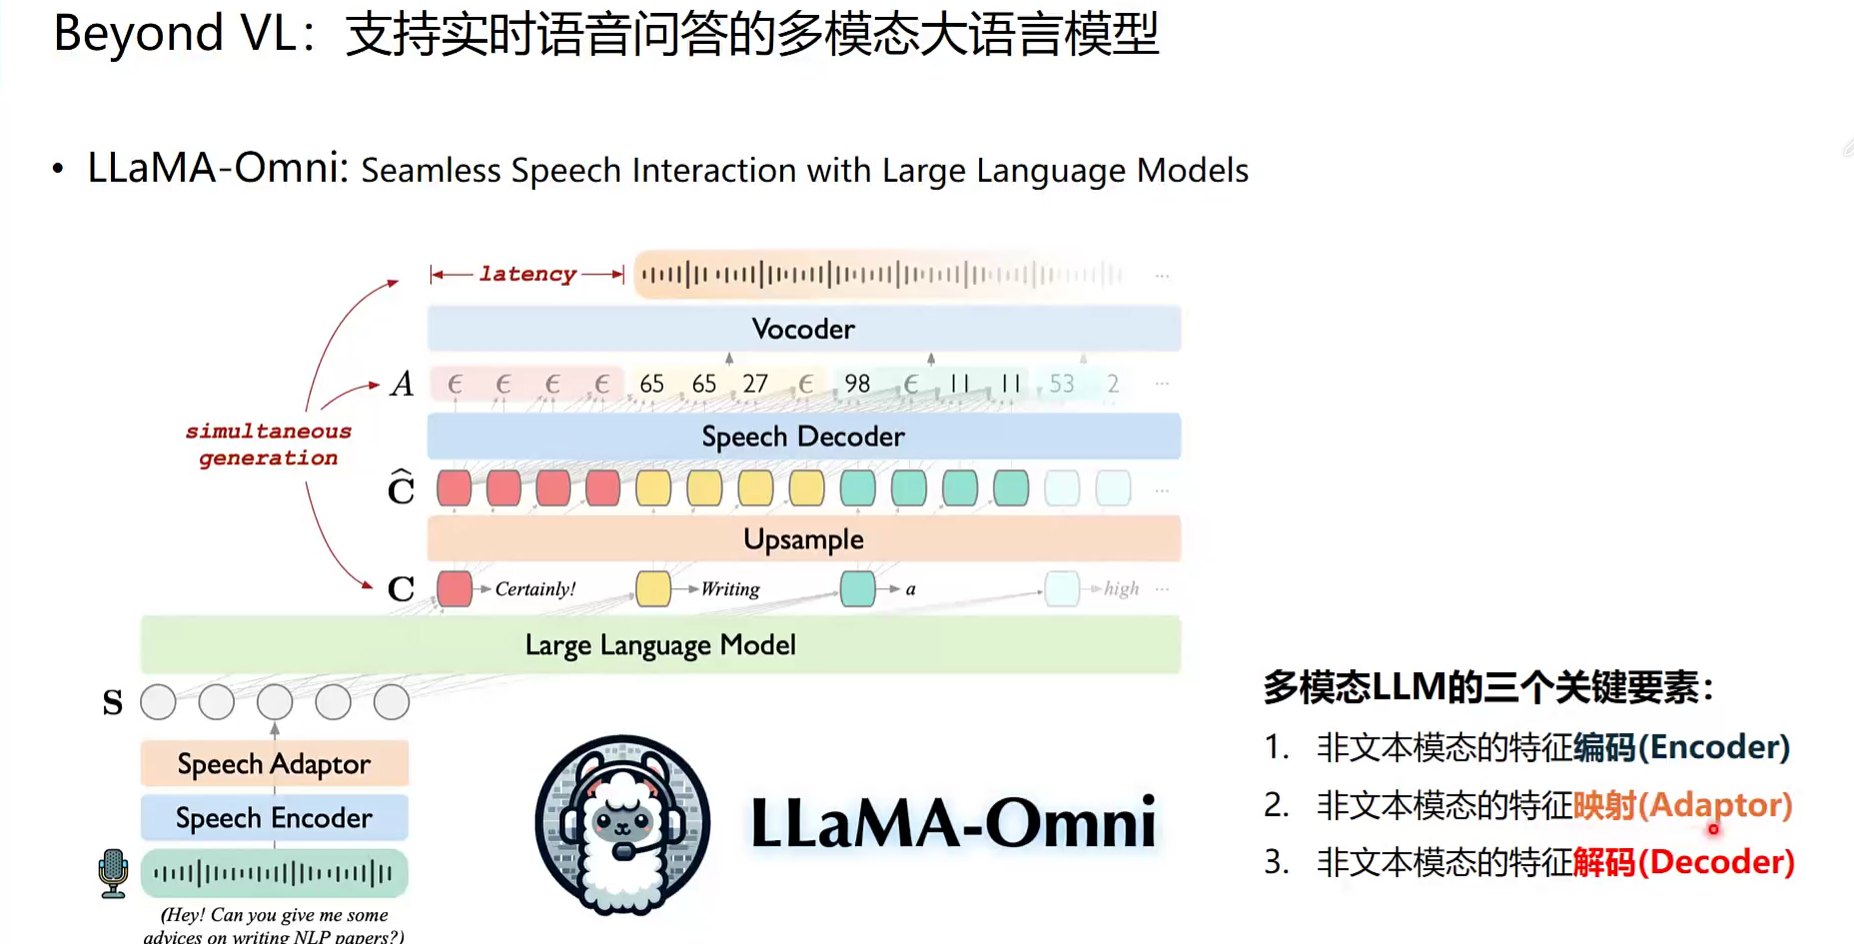
六、支持音频的多模态
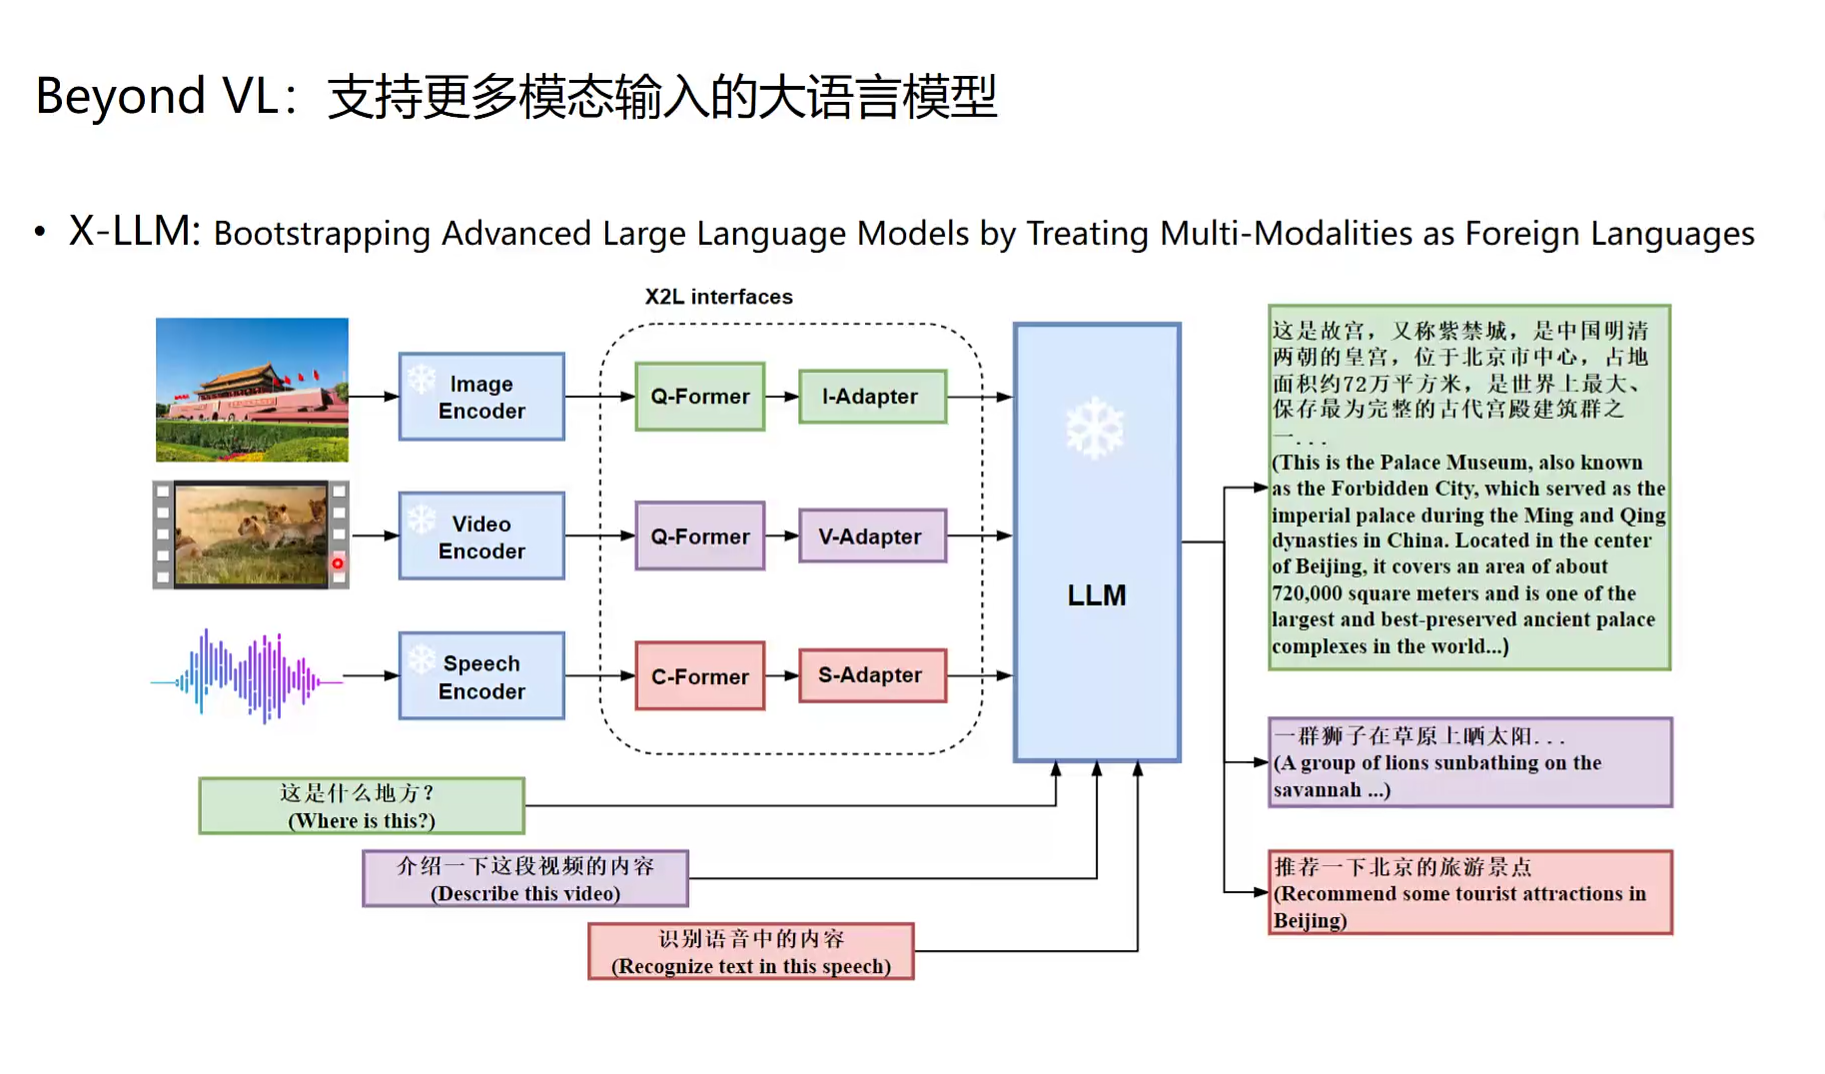
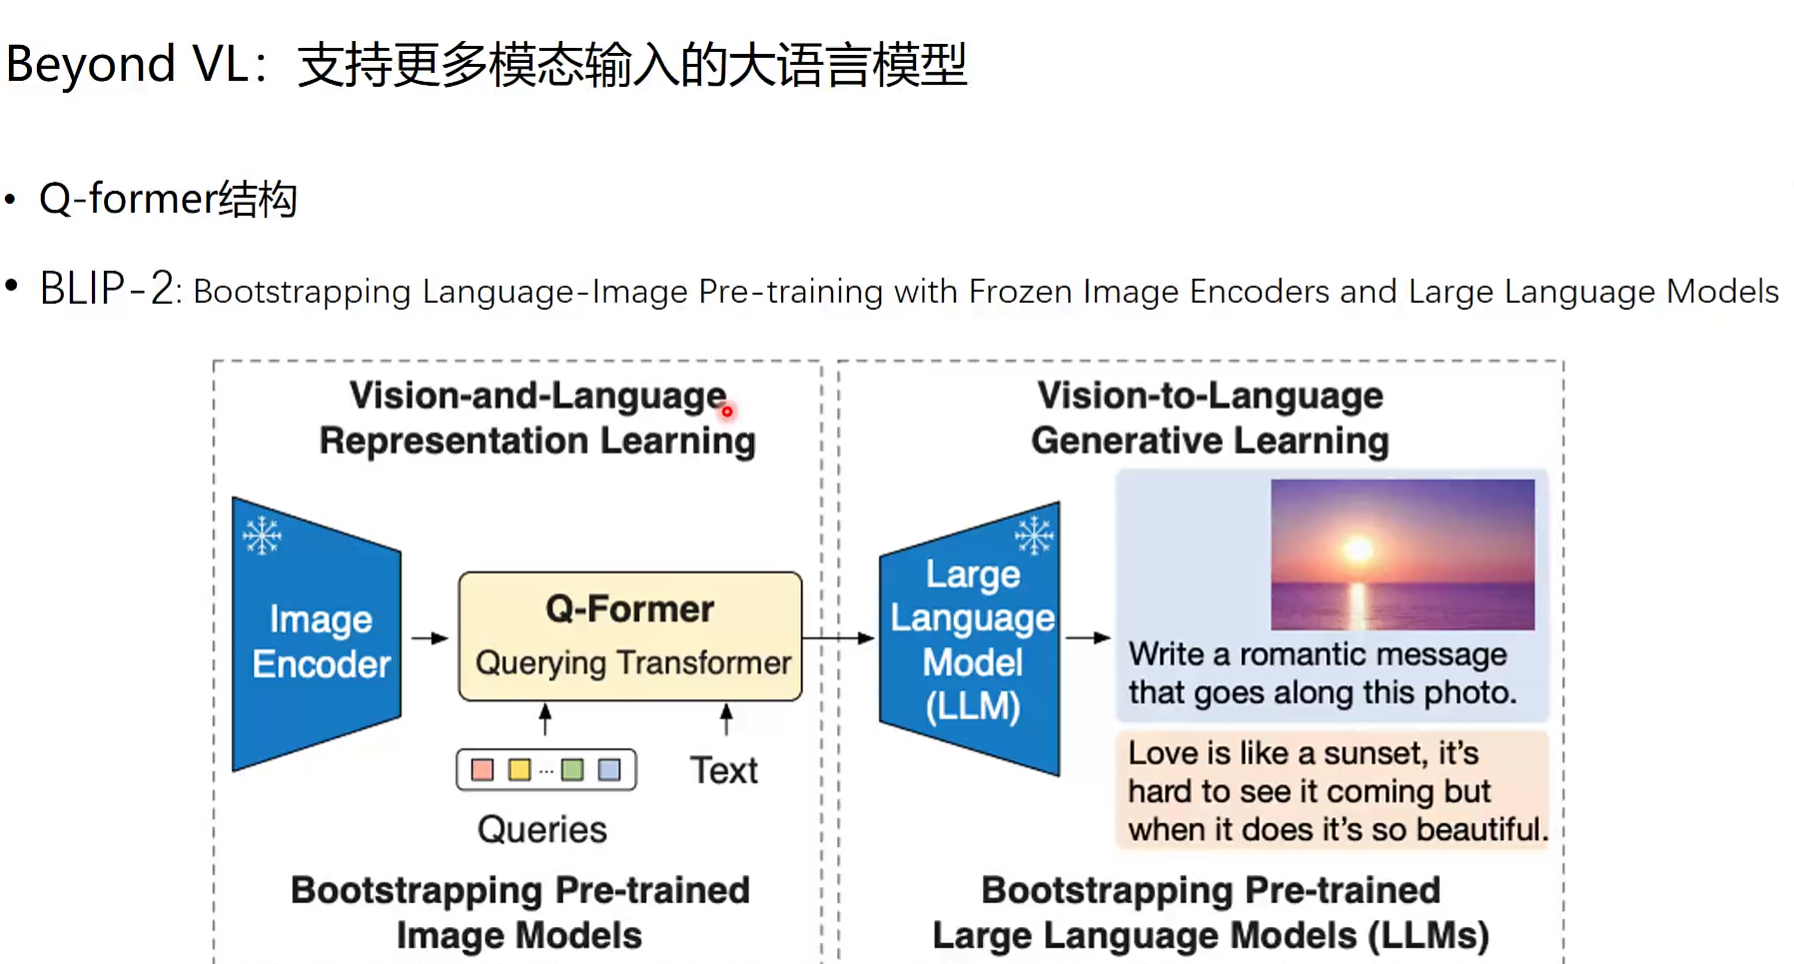
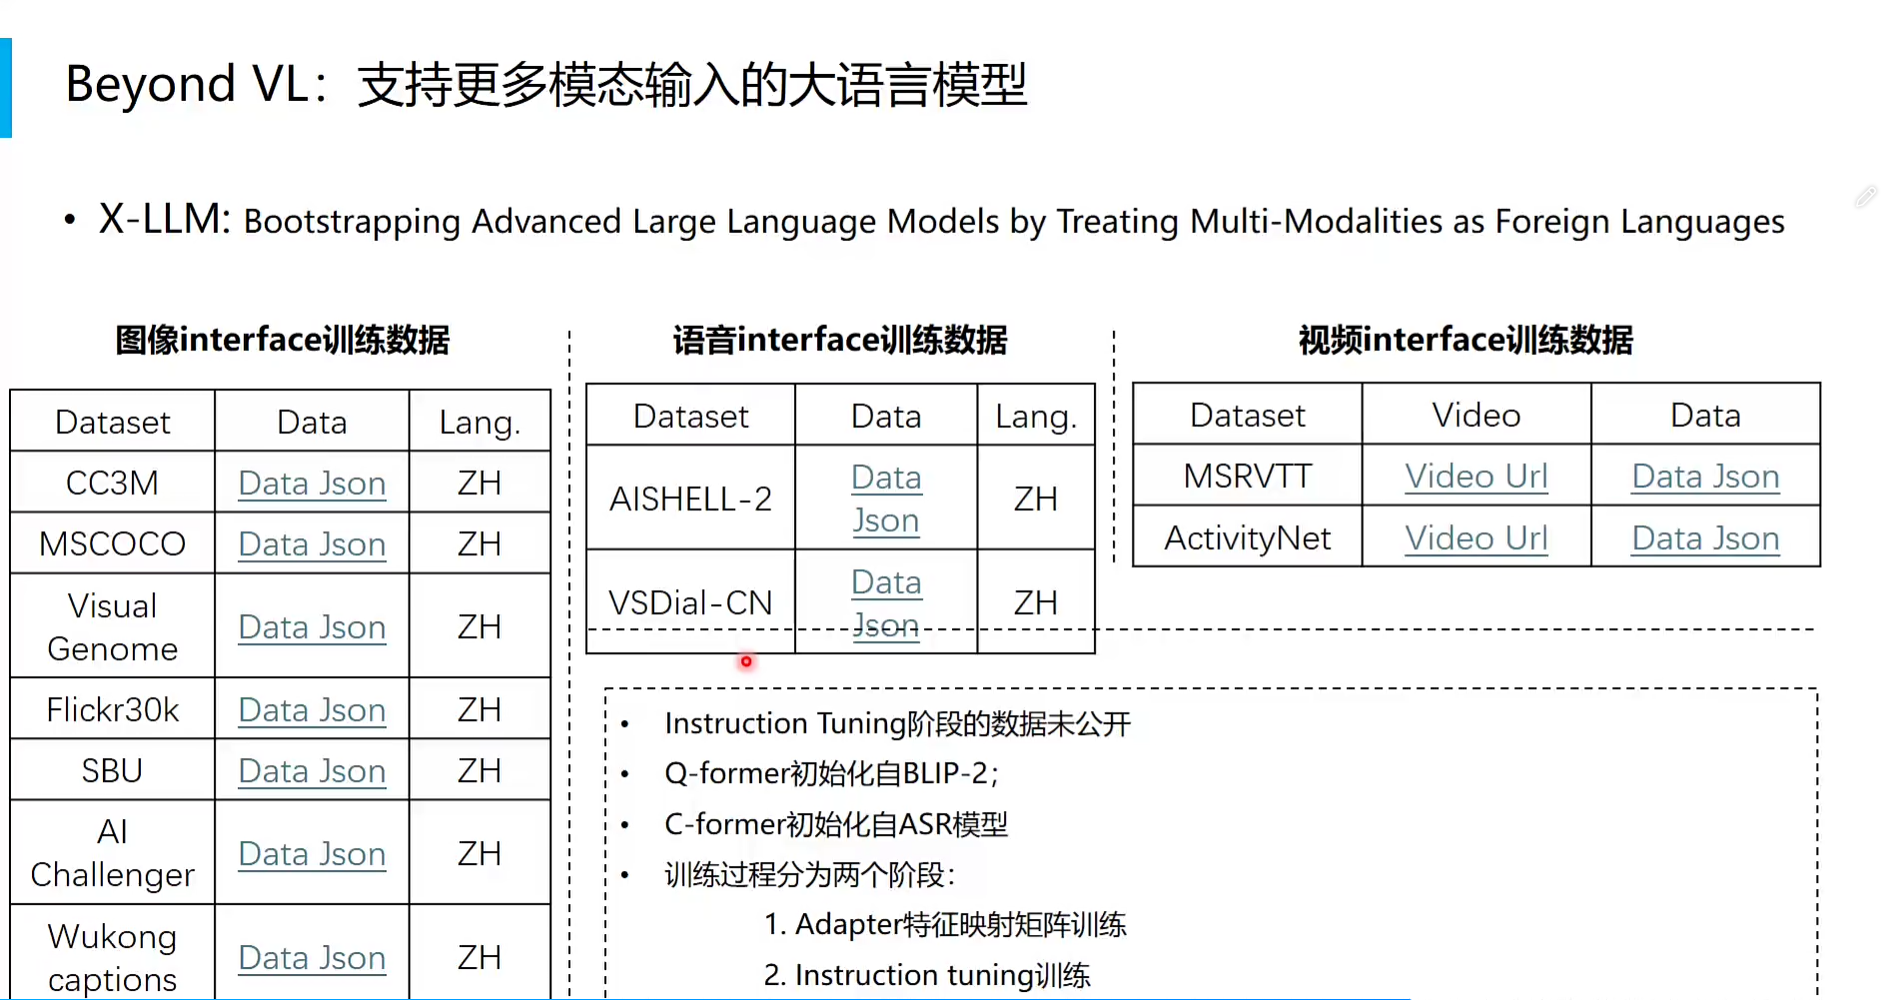
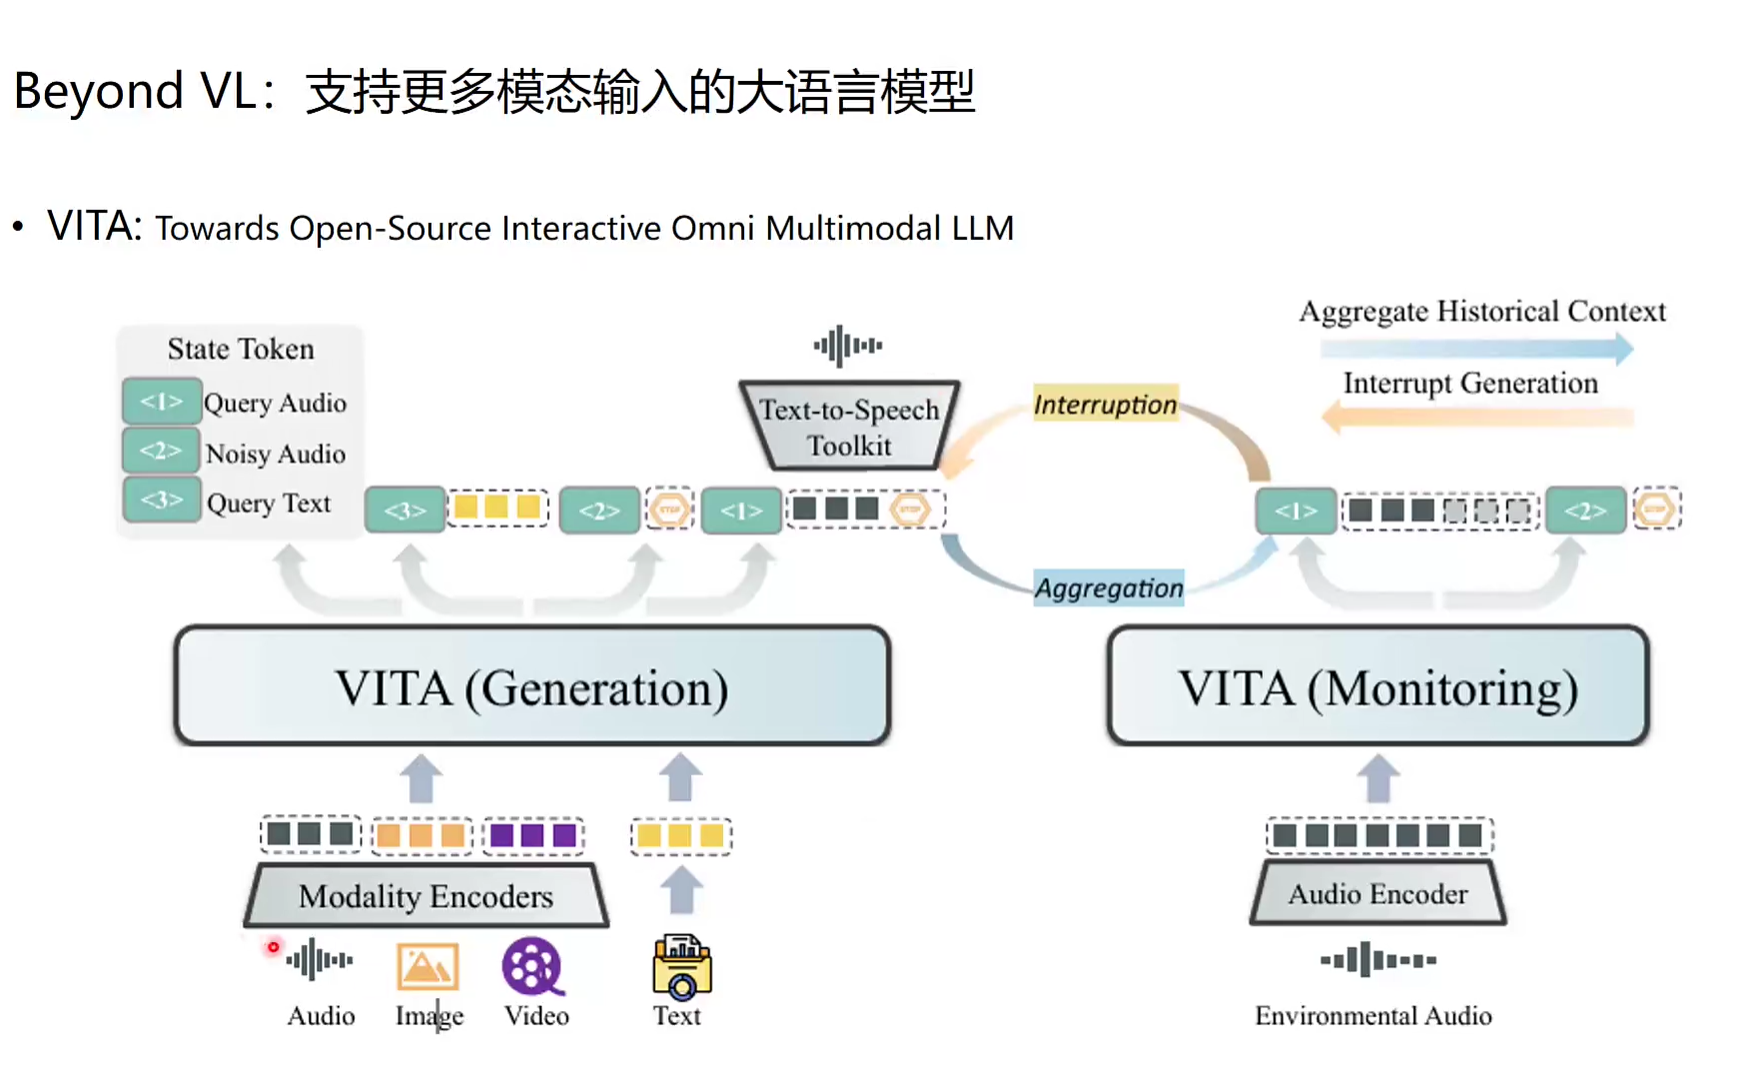
七、更多模态输入的大语言模型
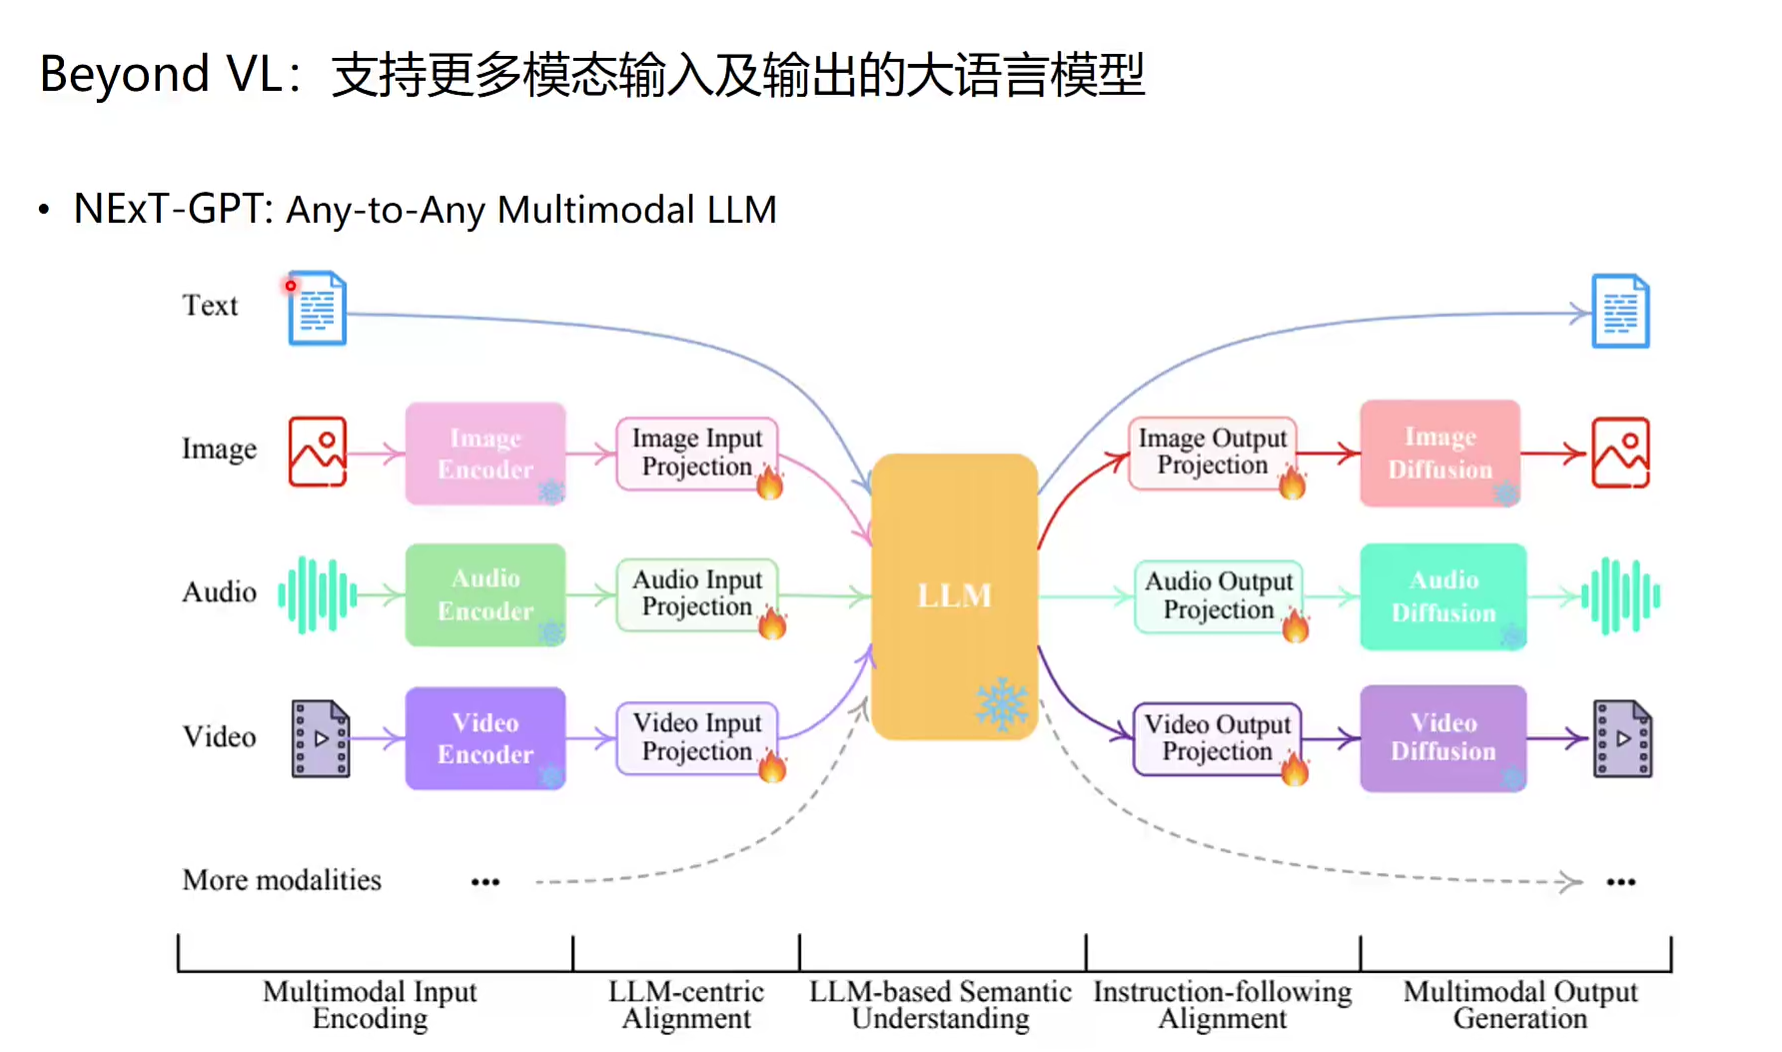
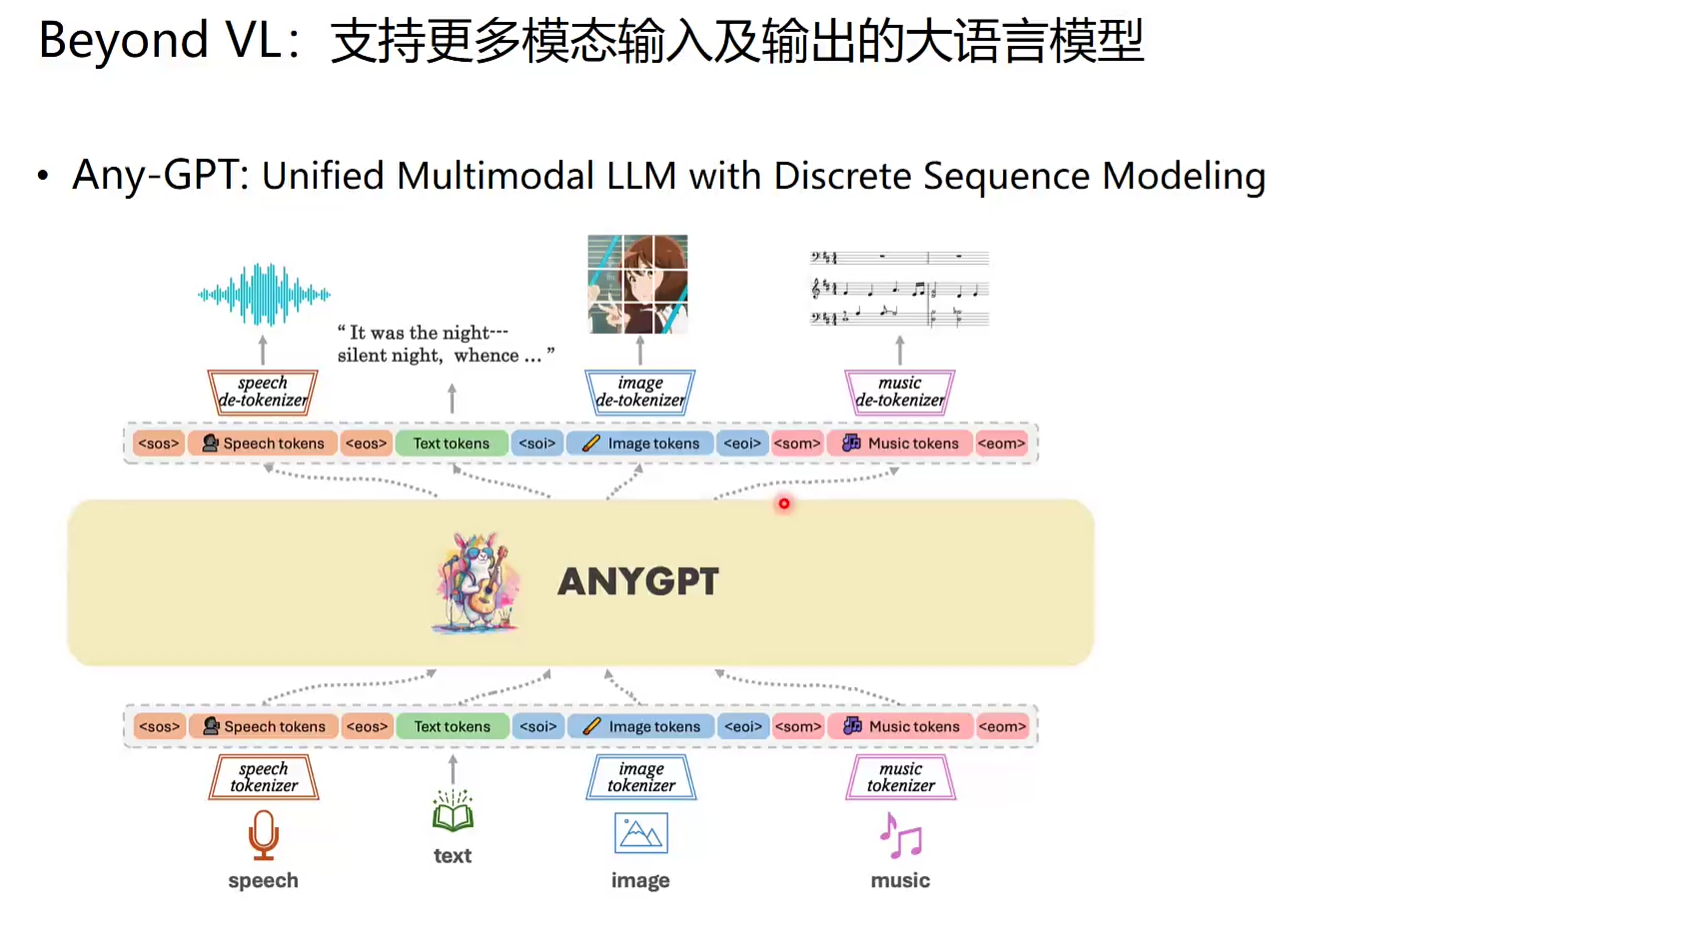
八、支持多模态的输入和输出
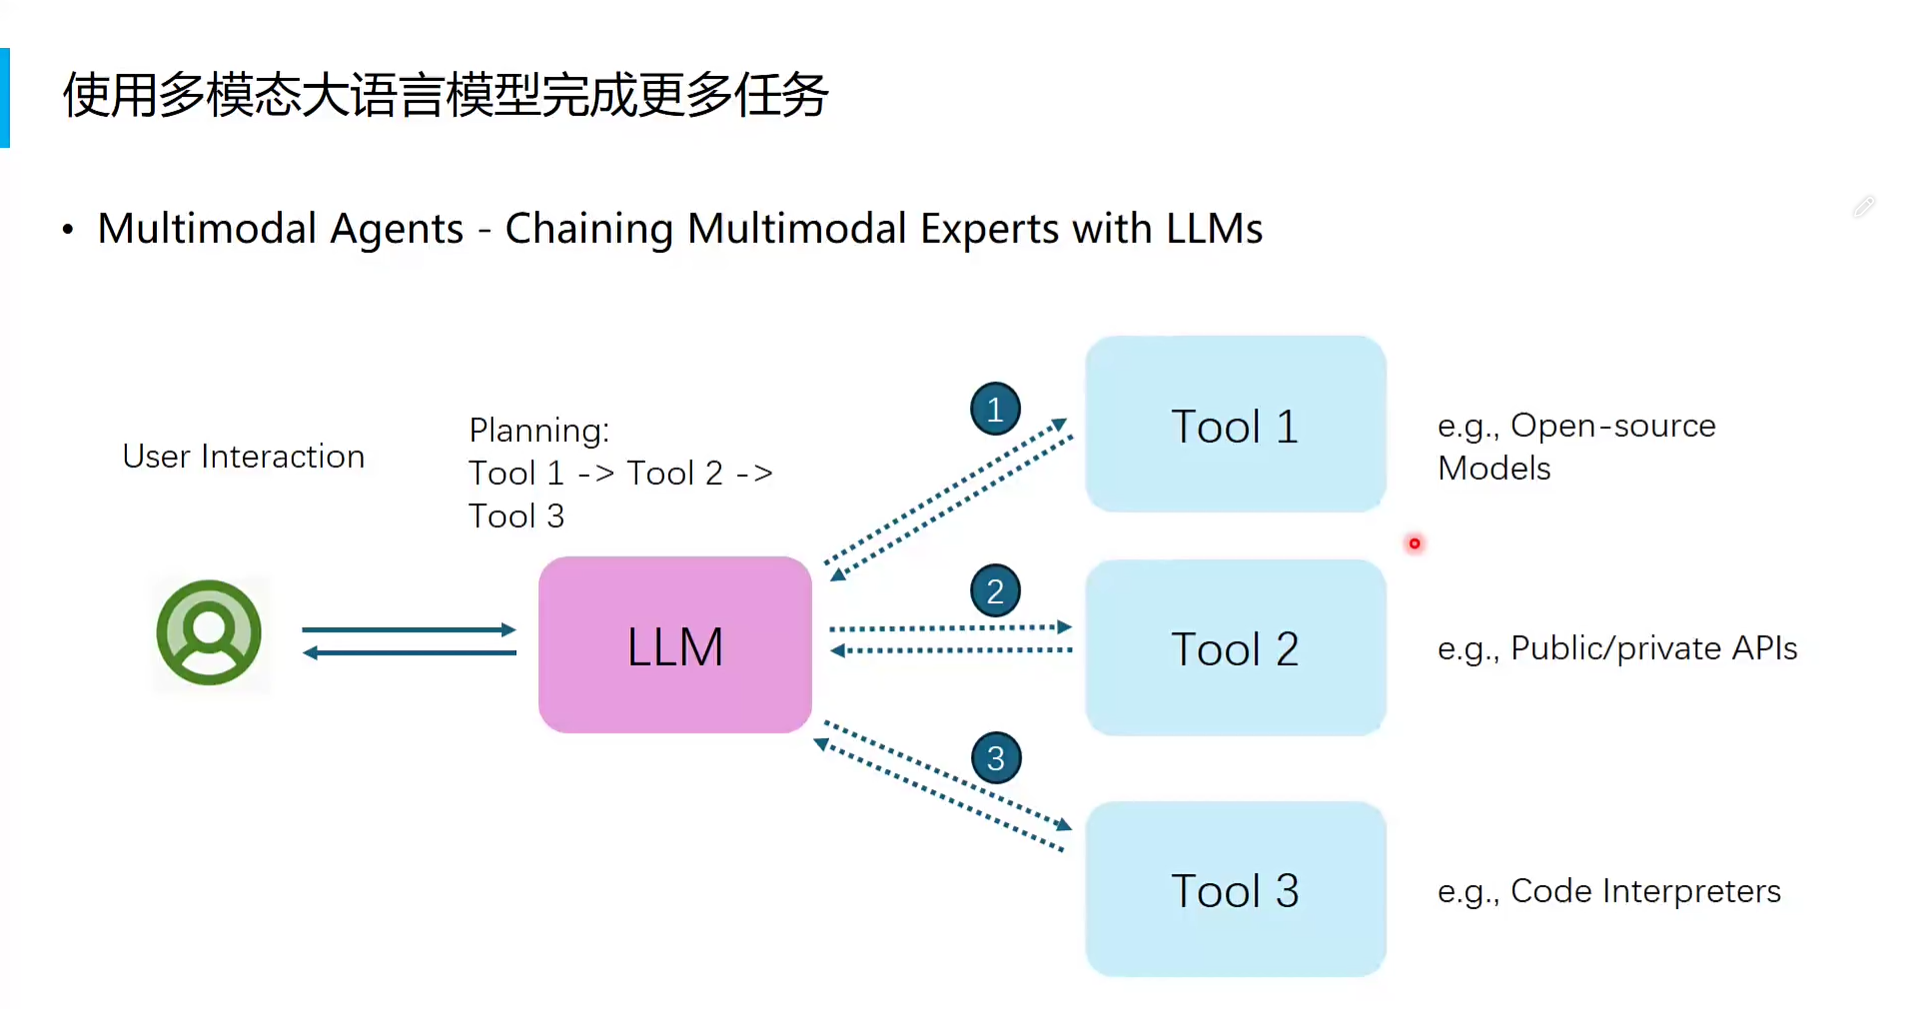
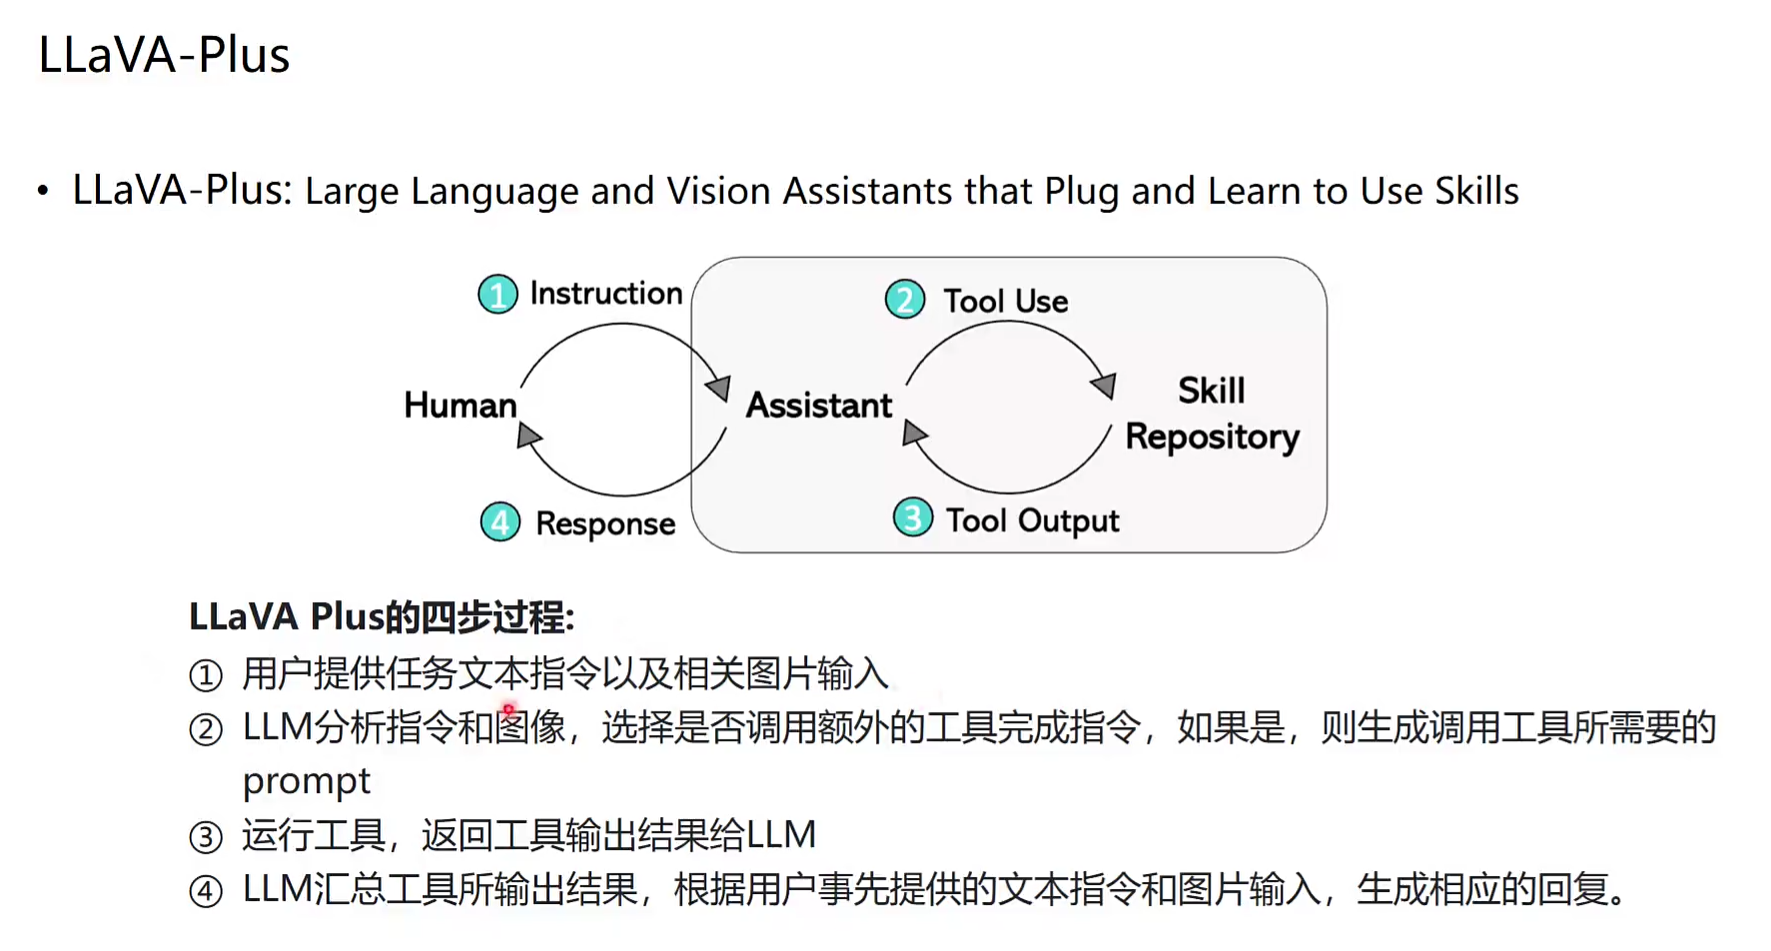
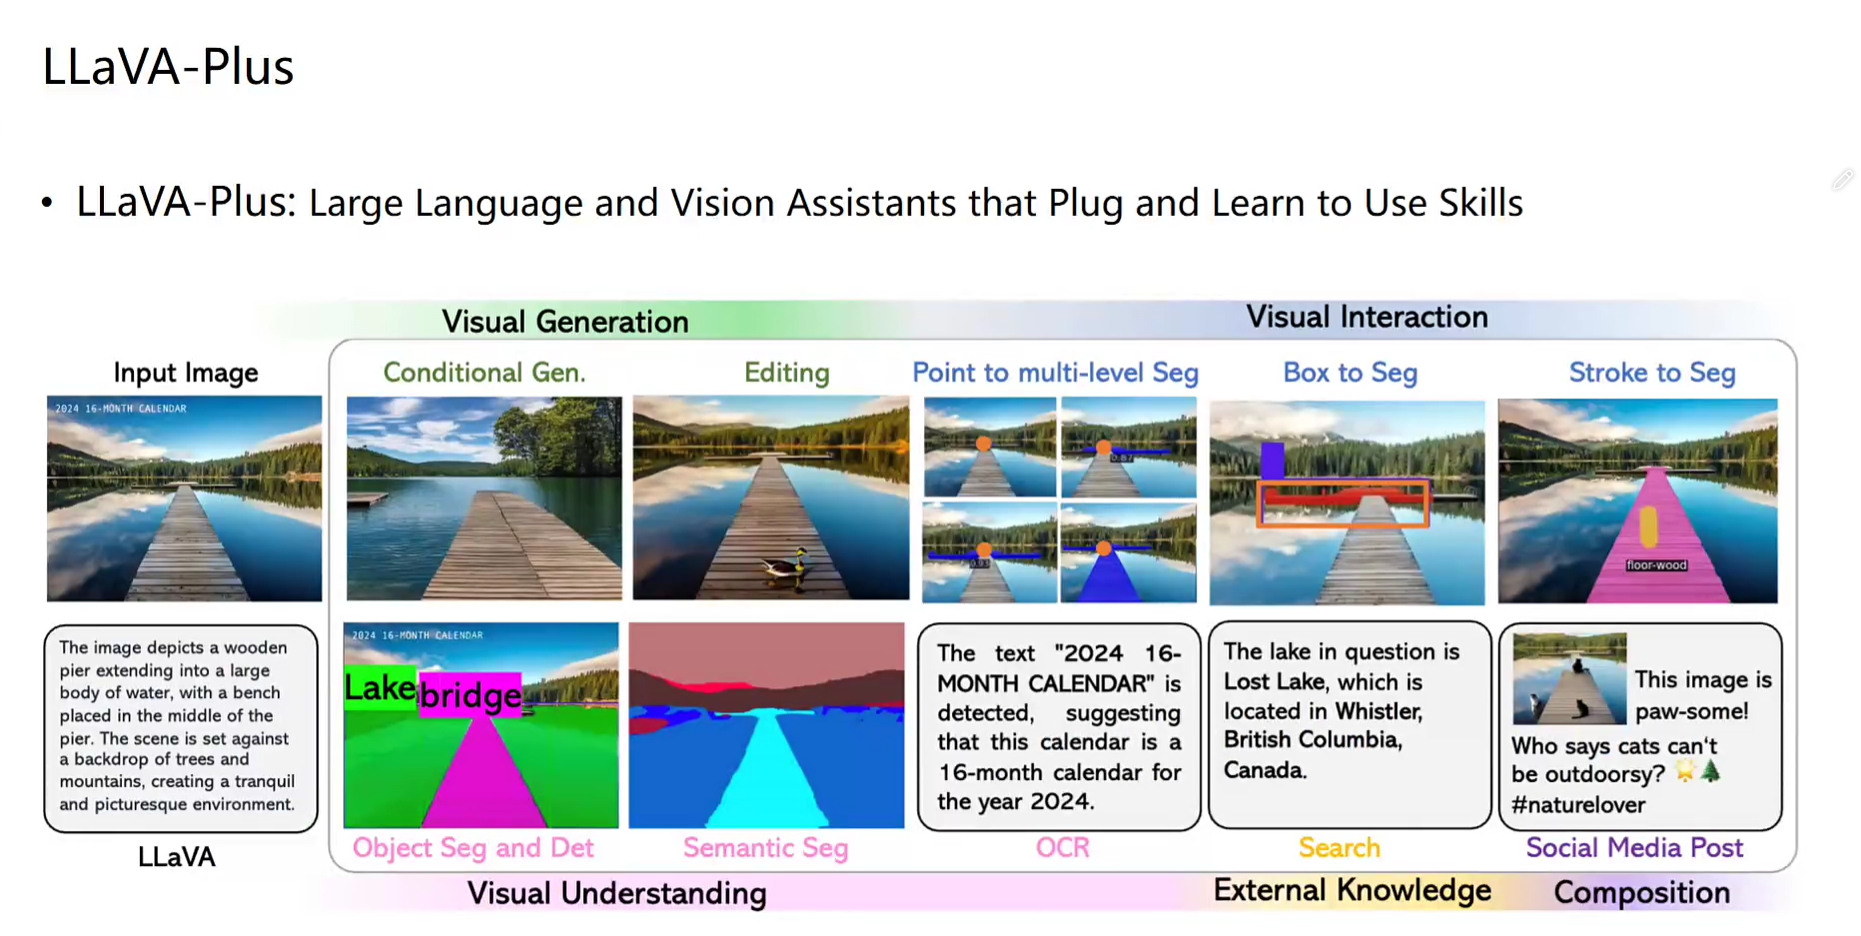
九、如何使用多模态完成更多任务
十、总结
现在模型都很厉害了,想怎么集成然后直接问ai,我发现我这堂课并没有学到什么实质性的东西,只有开头一二三才是实质性的东西