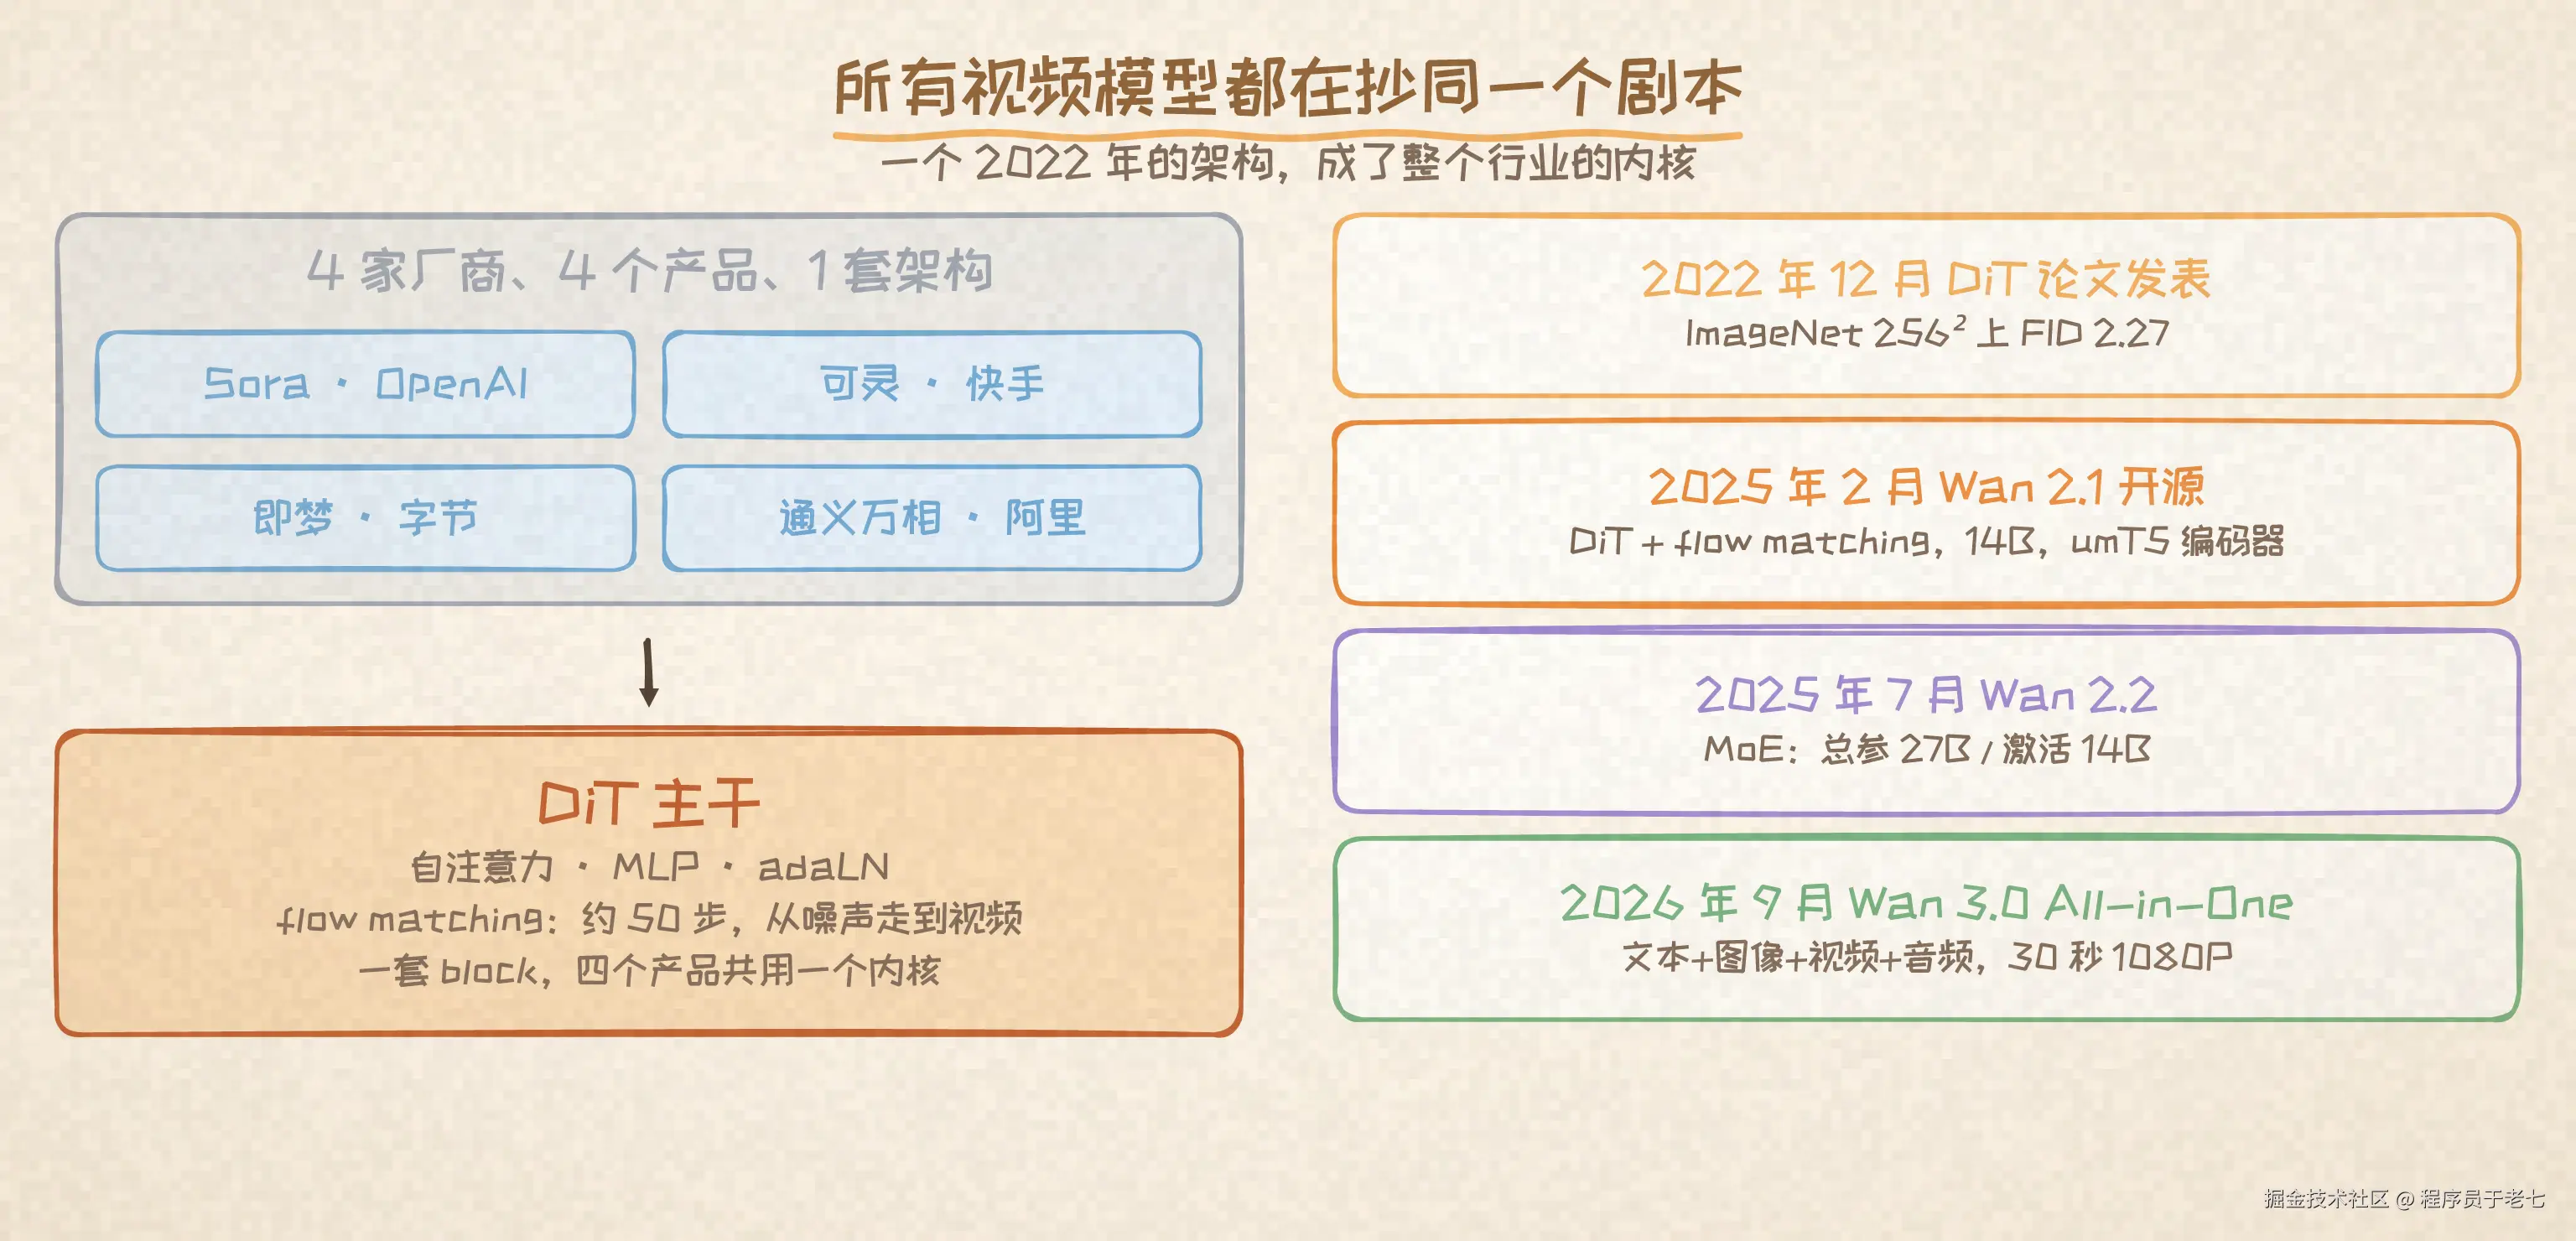
2024 年 2 月,Sora 发布,全世界第一次看到 AI 生成的 60 秒连贯视频。
同一年,一篇 2022 年的老论文突然被翻出来顶礼膜拜。这篇论文叫《Scalable Diffusion Models with Transformers》,作者是两位刚从博士毕业的年轻人 William Peebles 和 Saining Xie。他们在论文里提出了一种叫 DiT(Diffusion Transformer,扩散 Transformer)的架构。
当时没人太在意。两年后,它成了整个视频生成行业的"标准答案"。
现在市面上的视频模型------Sora、可灵、即梦、通义万相 Wan 系列------不管宣传得多花哨,内核都是同一个东西:DiT。
为什么一个架构能统治整个行业?它到底解决了什么问题?
一、先理解:AI 是怎么"画"出一张图的
视频生成的前身是图像生成,图像生成的主流范式是扩散模型(Diffusion Model)。
扩散模型的思想很反直觉:先学会把画涂脏,再学会把画擦干净。
训练时,拿一张清晰的照片一步步加噪声,直到它变成一团纯随机雪花;模型要学的,就是在每一步把噪声去掉一点,从雪花一步步"擦"回清晰照片。生成时反过来:从随机噪声出发,几十步到上百步之后,一张清晰的图就出来了。
这个"去噪器"就是整个系统的核心,它决定生成质量的上限。
二、U-Net 时代:去噪器是个流水线工人
2022 年之前,去噪器的主干是 U-Net------一种基于卷积的架构,形状像个 U 字。
U-Net 的工作方式像流水线:先把图像一层层压缩变小 (下采样,抓大轮廓),再一层层放大恢复(上采样,补细节),中间用"抄近道"的跳跃连接把细节直接送过去。
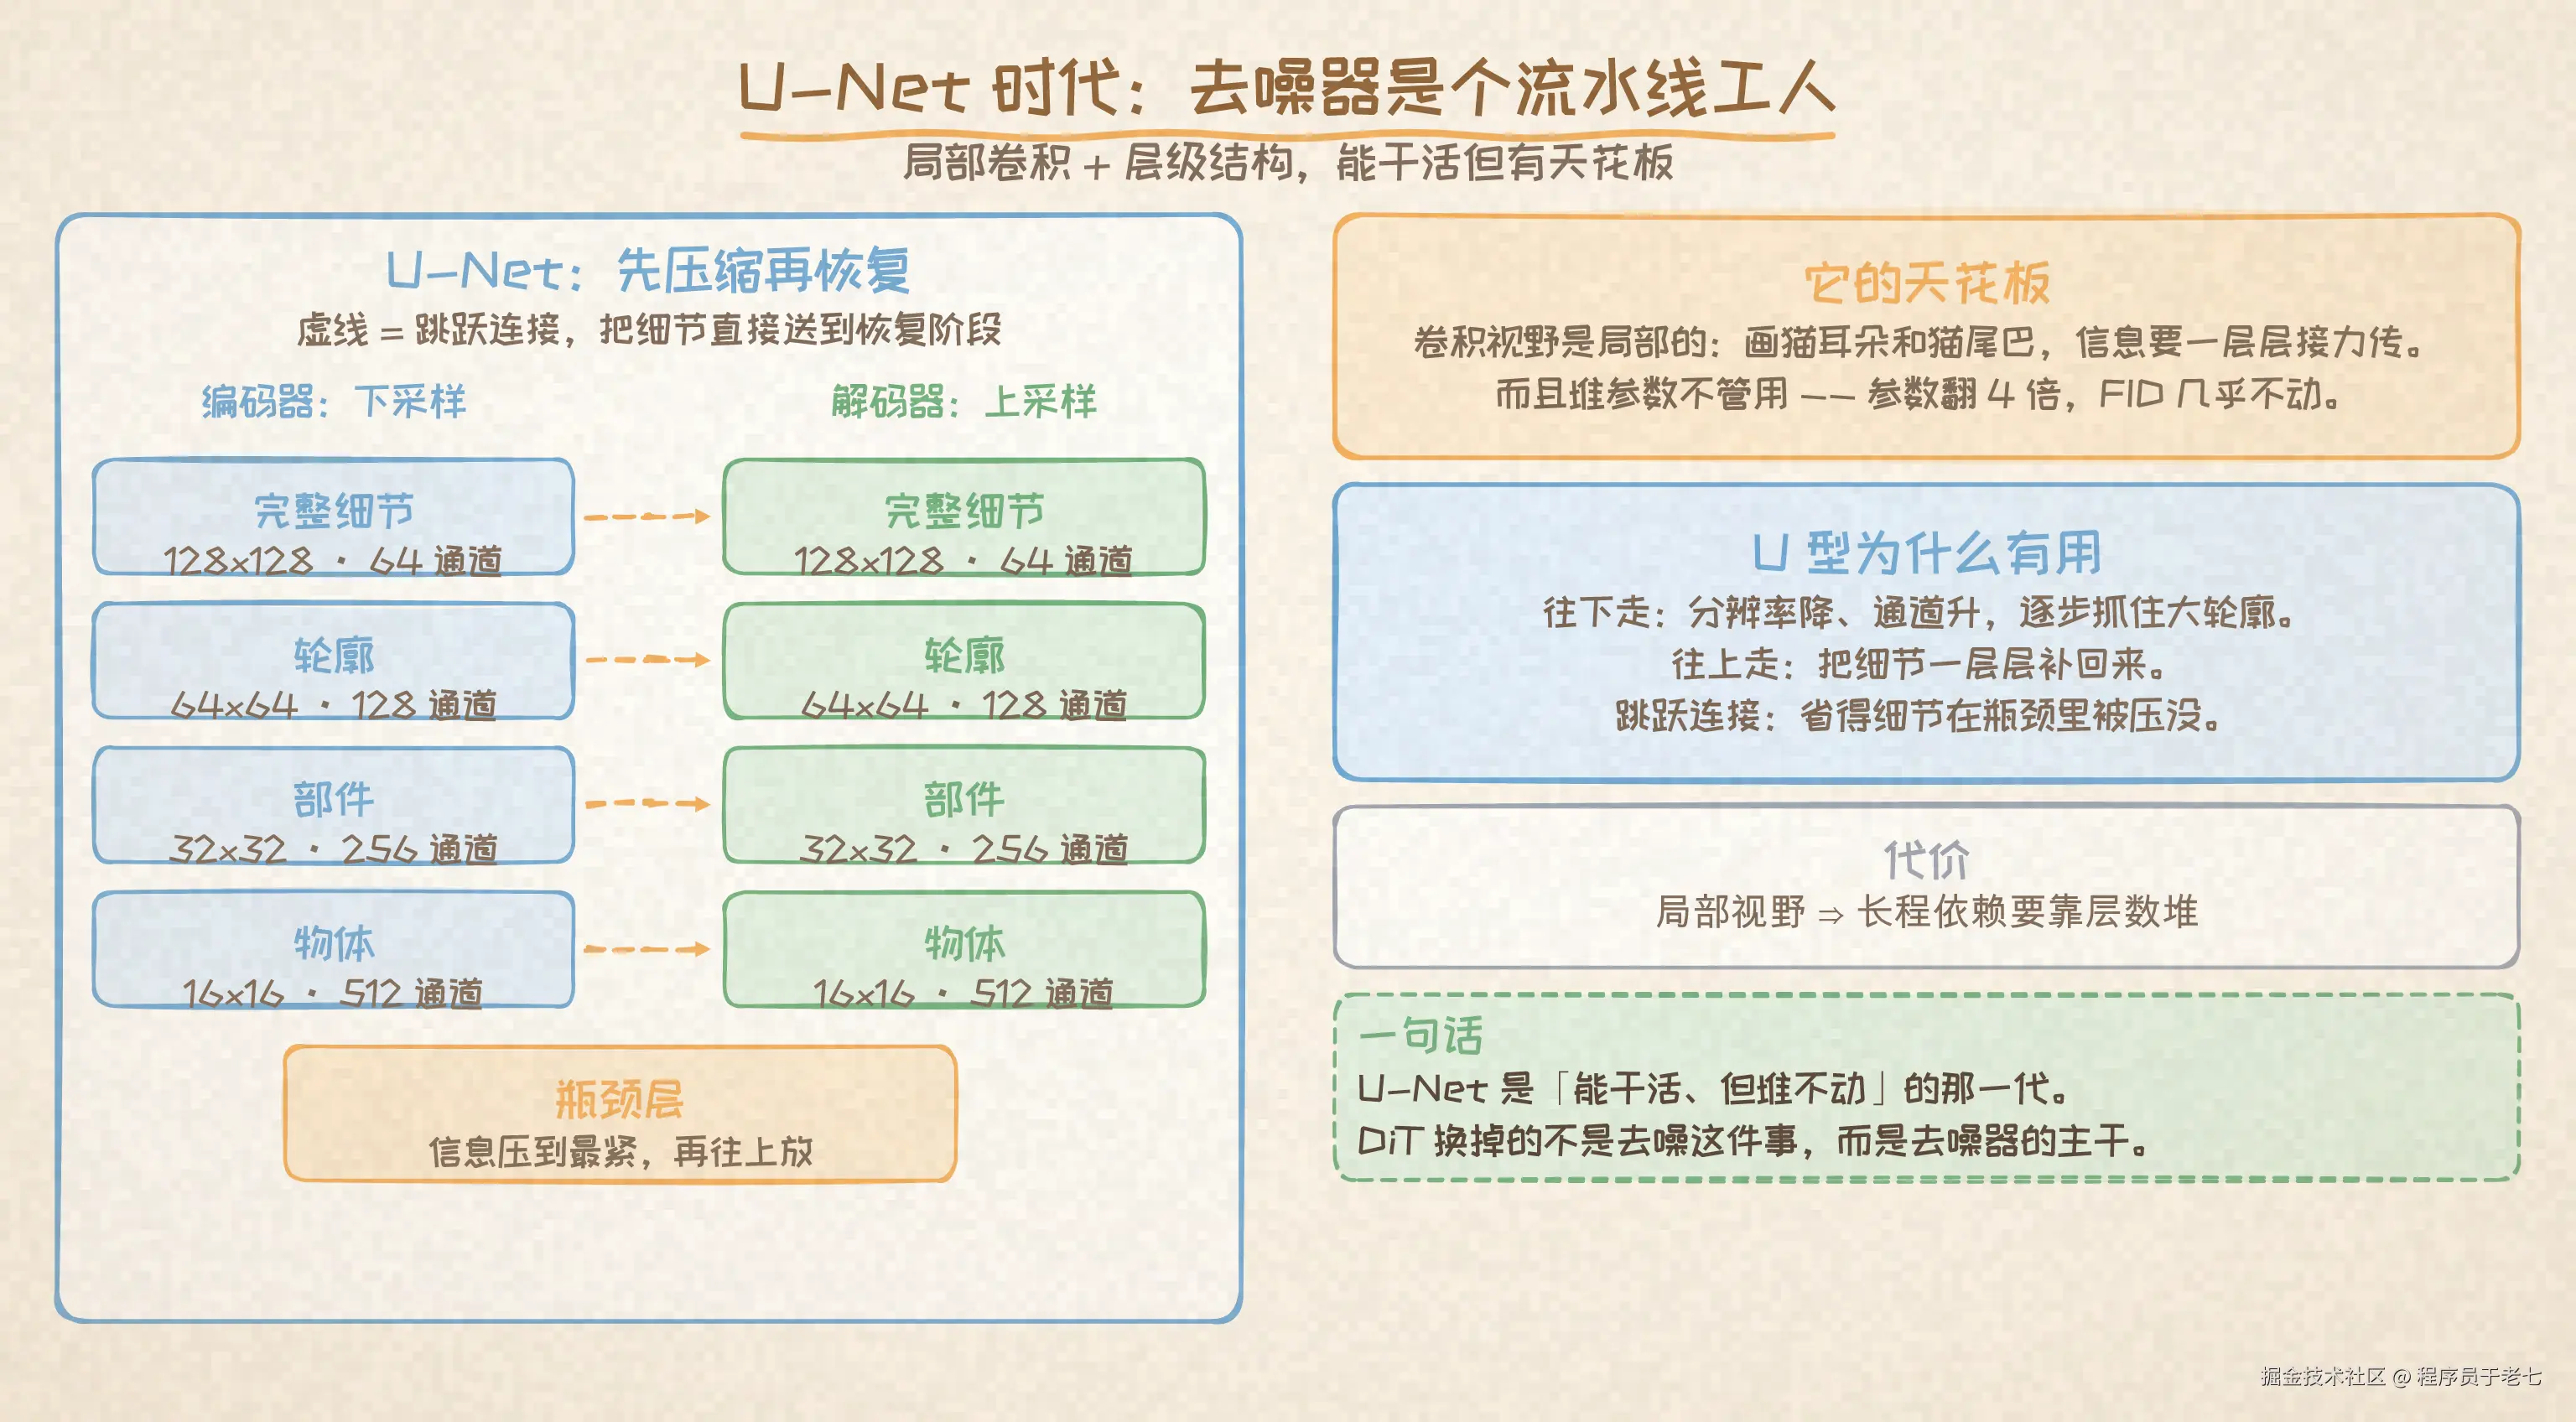
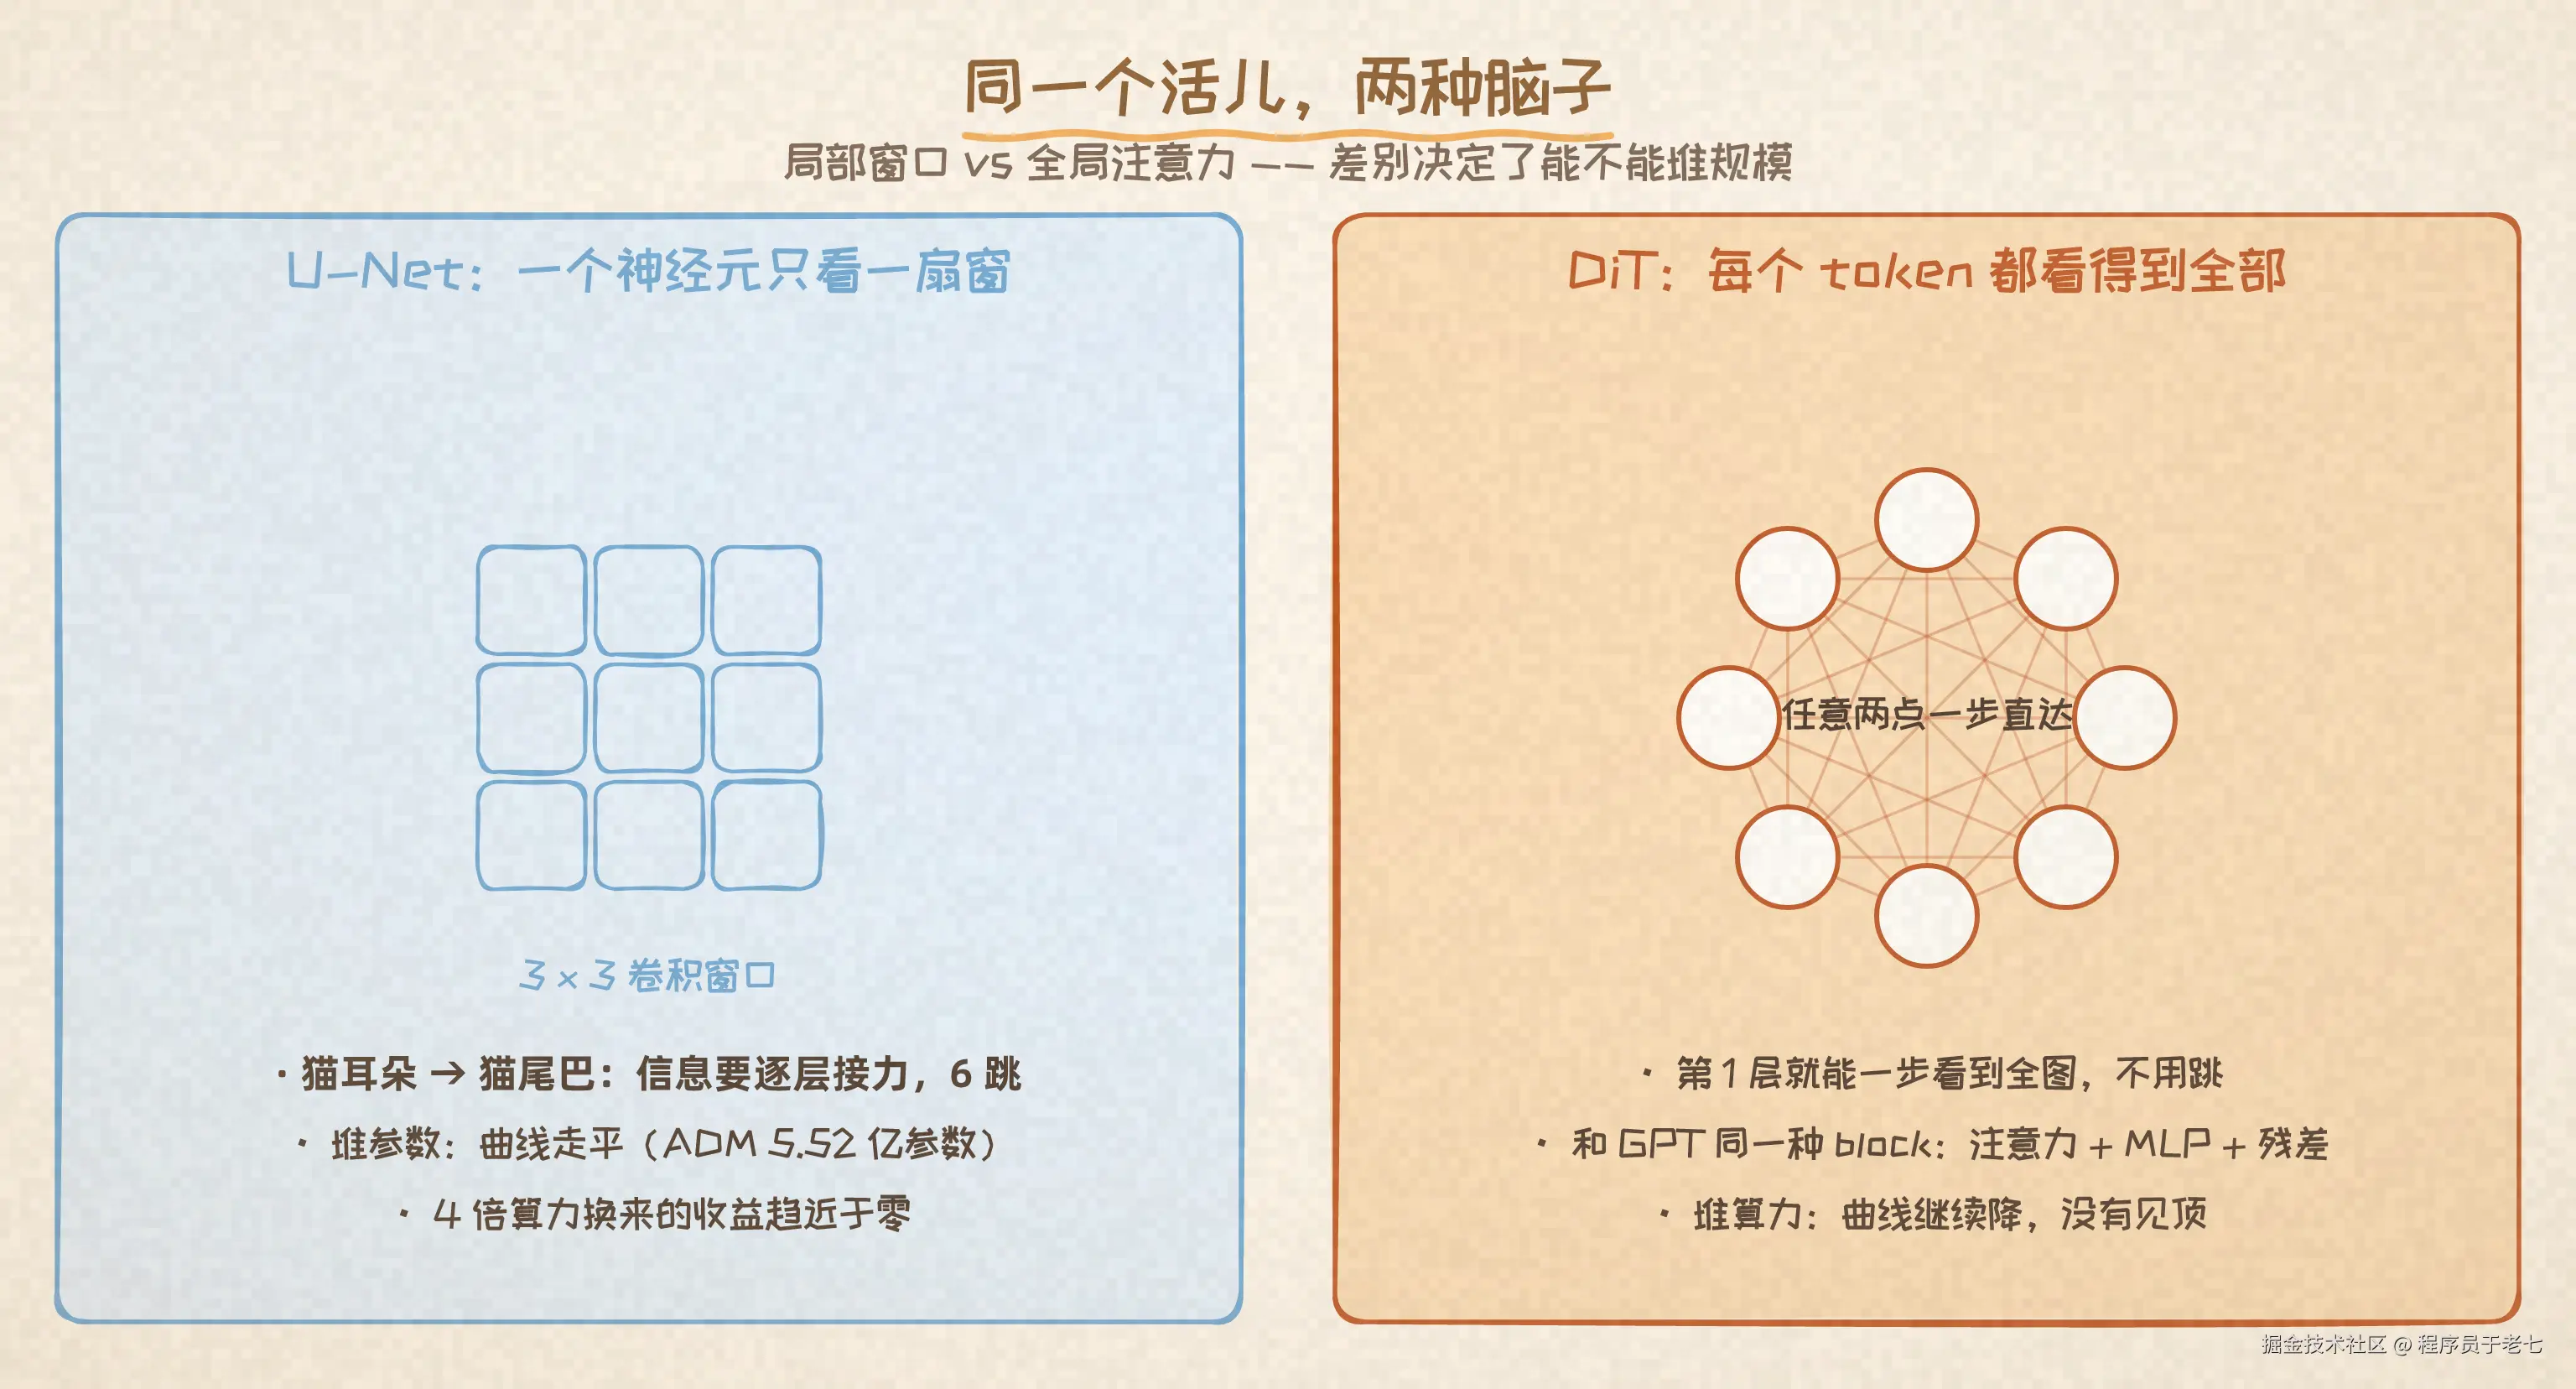
它很能干,但有个天花板:卷积的视野是局部的。 每个神经元只看自己周围一小块,看全局要靠很多层堆叠传递。
画一只猫,U-Net 要一层层传递"猫耳朵在哪""猫尾巴在哪"的信息。画一张复杂的街景,局部信息传递的路径更长,更容易出错。
更要命的是:U-Net 加参数不管用。研究者发现 U-Net 堆到一定程度就堆不动了,再加算力收益骤减。这堵死了"暴力堆规模"这条路。
三、DiT 登场:把去噪器换成 Transformer
Peebles 和 Xie 的洞察很简单:为什么不用 Transformer 当去噪器?
Transformer 在文本领域已经证明了自己------参数越多、数据越多、算力越多,效果就越好,从 1 亿参数到 1 万亿参数,规律一致。这种"可扩展性"(scalability)是 U-Net 梦寐以求的。
DiT 做的三件事:
第一,把图像切成 token。 和 ViT 一样,把图像切成小块(patch),每块线性投影成一个向量,变成一串序列。Transformer 不吃图片,只吃序列------那就把图片"翻译"成序列。
第二,全局自注意力。 序列里每个 patch 都能直接"看到"所有其他 patch。猫耳朵和猫尾巴之间的距离不再需要层层传递,注意力机制一步直达。画全身像时,"手在身体两侧""手指有五根"这种全局约束,一次注意力就搞定。
第三,把"第几步去噪"喂进网络。 去噪过程有几十上百步,每一步该擦多少噪声完全不一样。DiT 用 adaLN(自适应层归一化)机制,把"现在擦到第几步"变成一组缩放和偏移参数,注入每一层;文字指令则走另一条路------交叉注意力(cross-attention),稍后细讲。一个管"擦多狠",一个管"擦成什么"。
这三板斧下来,DiT 展现出了 LLM 式的 scaling law:参数翻倍,质量稳定提升。 这是 U-Net 给不了的。
DiT 内部长什么样:一次完整的"去噪之旅"
光讲概念不够,我们钻进 DiT 内部,跟踪一张图从进到出的完整旅程。
第 1 步:切块。 一张 256×256 的图,先经 VAE 压缩,长宽各缩 8 倍,变成 32×32 的隐变量。DiT 再把隐变量切成 2×2 的小块(patch),得到 16×16 = 256 个 token。每个小块展平成一个向量,经过一个线性层投影成 1152 维。此刻,图片变成了 LLM 熟悉的语言------一个长度为 256 的序列。(论文里 patch 大小可取 2、4、8,块越小 token 越多、算力越高。)
第 2 步:注入"进度"和"指令"。 去噪有几十上百步,DiT 必须知道"现在擦到第几步了"。时间步 t 经过一个小 MLP,变成一组缩放和偏移参数,通过 adaLN (自适应层归一化)注入每一个 block。文字指令走的是另一条通道 :"一只戴帽子的猫"先被文本编码器变成一串向量,再用交叉注意力(cross-attention)让 256 个图像 token 各自去"查询"这串文字向量。
第 3 步:堆叠的 Transformer block 反复加工。 每个 block 做两件事:先让 256 个 token 互相"看"一眼(多头自注意力------猫耳朵的 token 直接询问猫尾巴的 token),再各自经过前馈网络加工。重复 N 次(DiT-XL 是 28 层)。
第 4 步:还原成图。 加工完的 256 个 token,经过输出层投影回像素空间,重新拼成一张 256×256 的图。这张图就是"擦掉一步噪声"的结果。再喂回网络,开始第 2 步去噪------循环往复,直到画面清晰。
arduino
图片 → VAE ÷8 → 切 2×2 块 → 256 个 token ┐
                                            ├→ Transformer × 28 层 → 还原图片
时间步 t → MLP → adaLN 参数(γ, β, α)      ┤   (每层注入"擦多狠")
文字指令 → 文本编码器 → 交叉注意力 ──────────┘   (每层注入"擦成什么")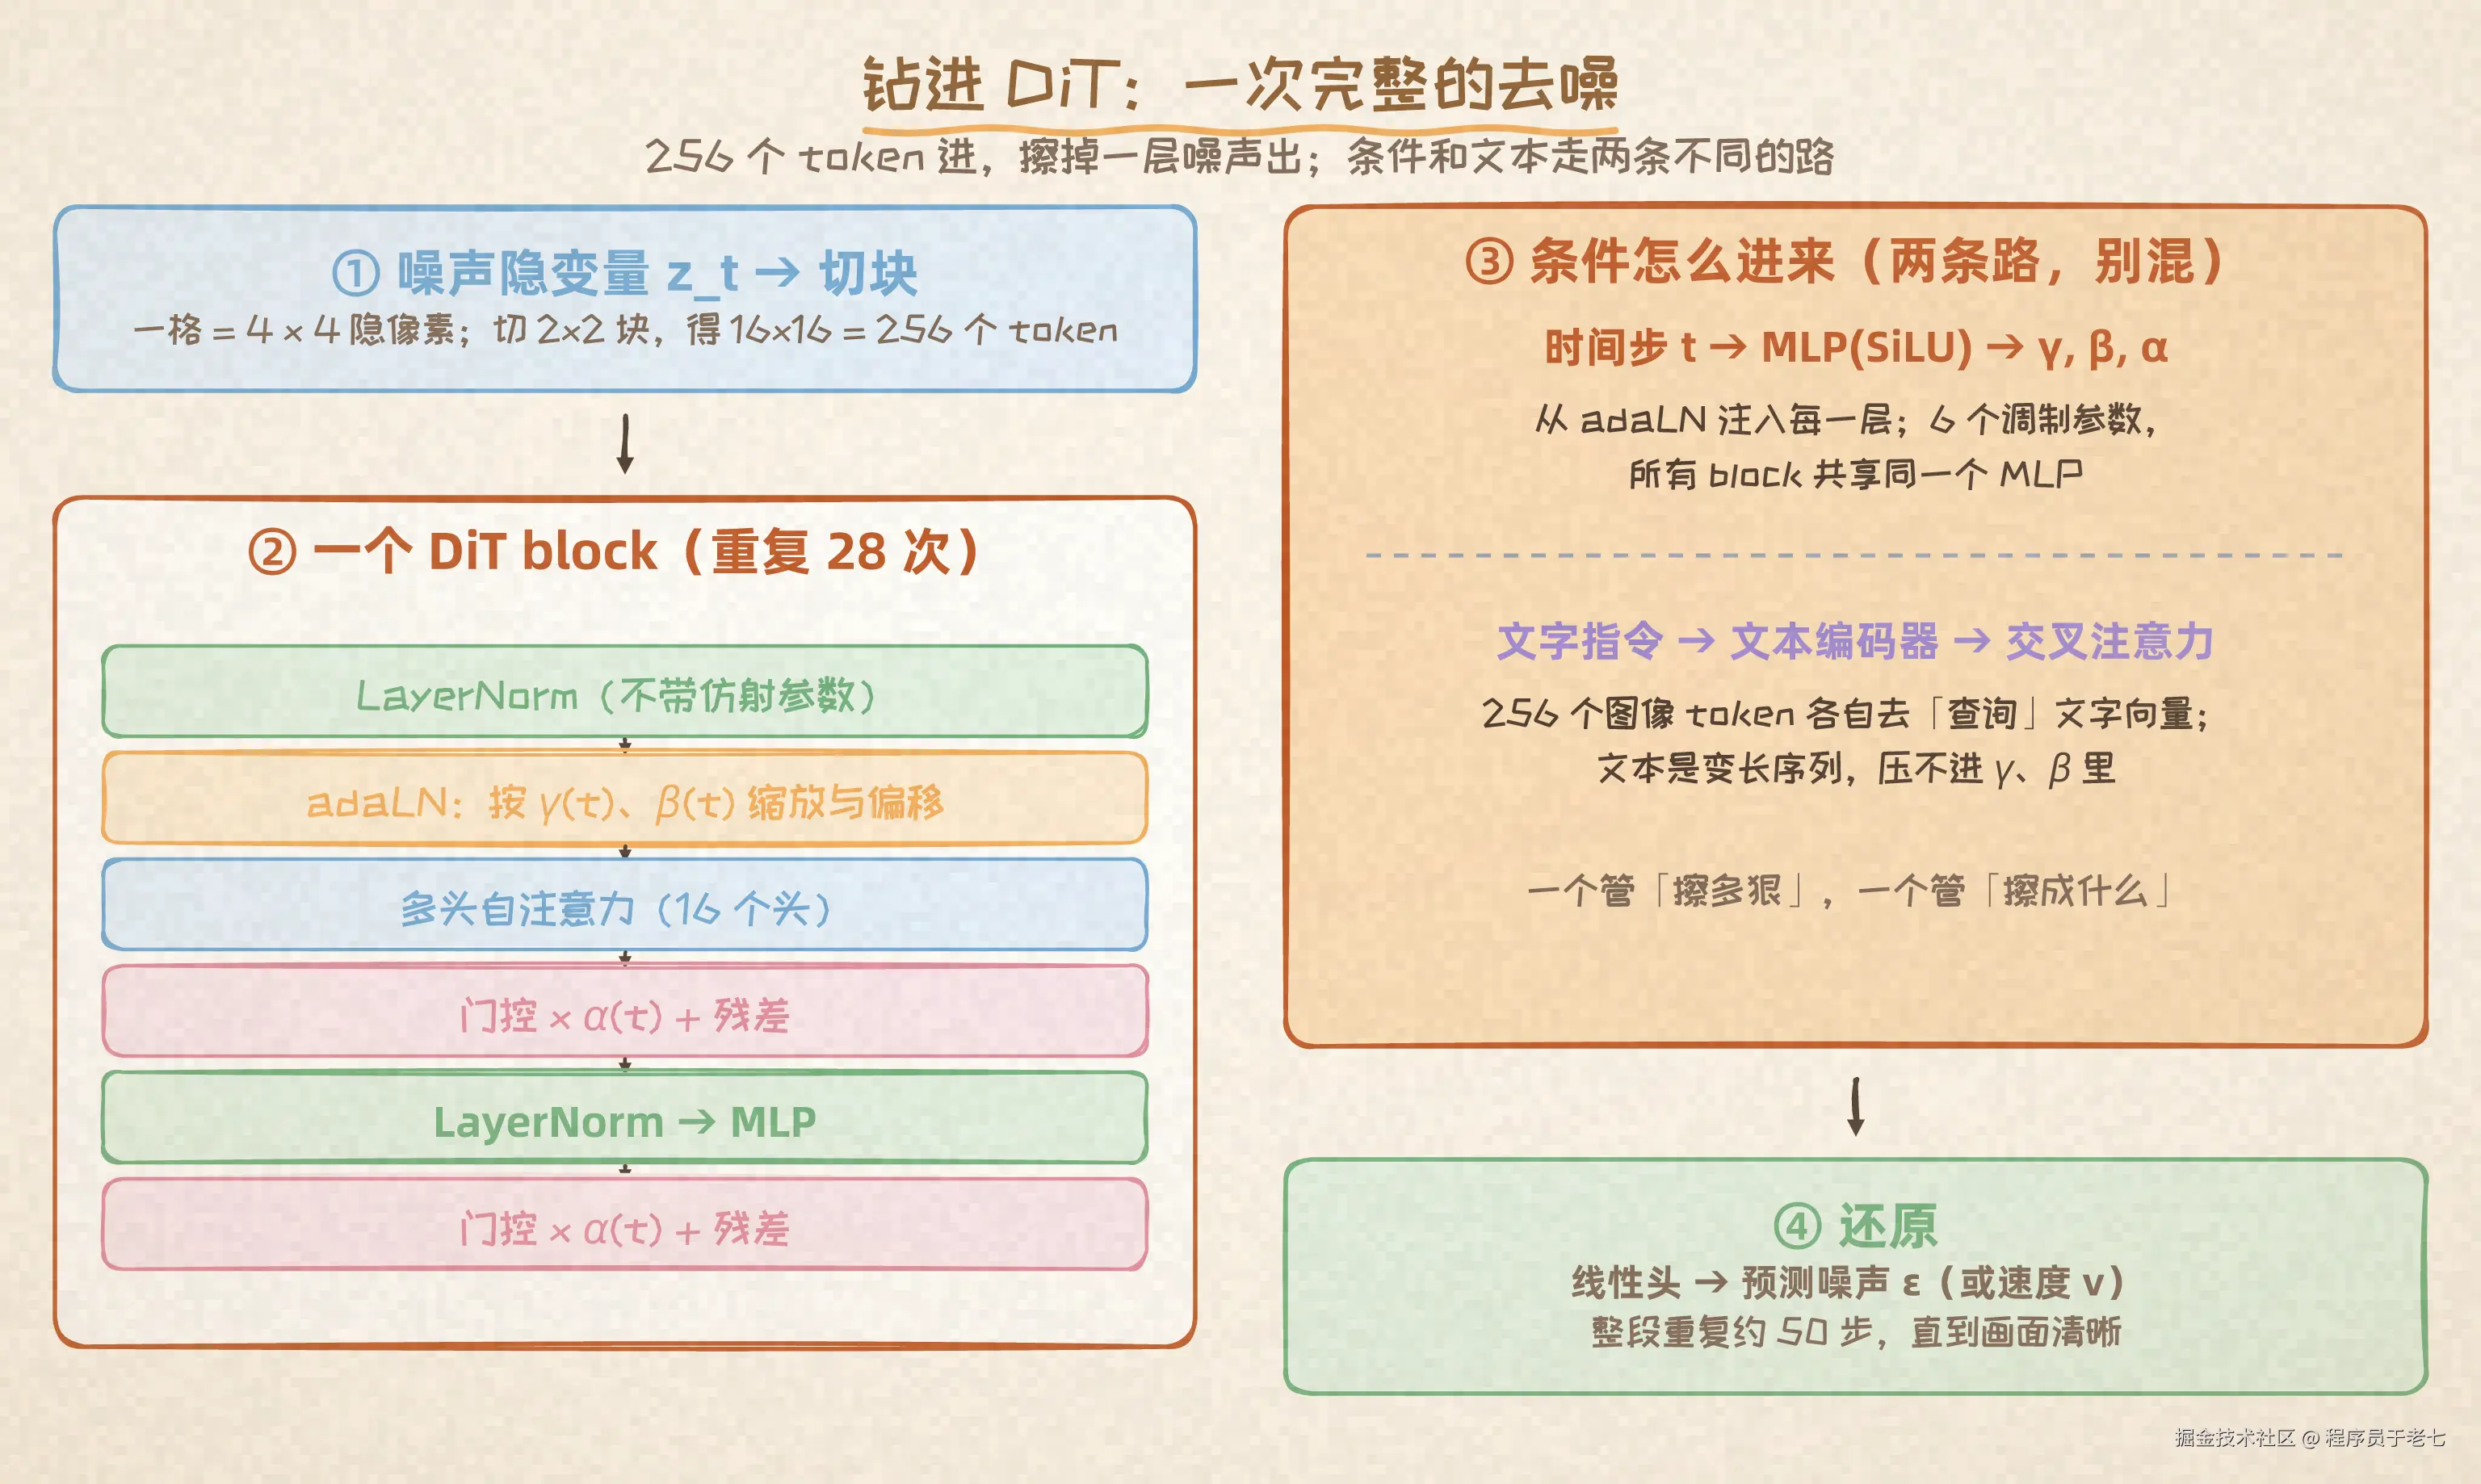
这个流程和 LLM 几乎一模一样,只有一个区别:LLM 的序列是"词",DiT 的序列是"图像块"。把图片当语言处理------这就是 DiT 的全部魔法。
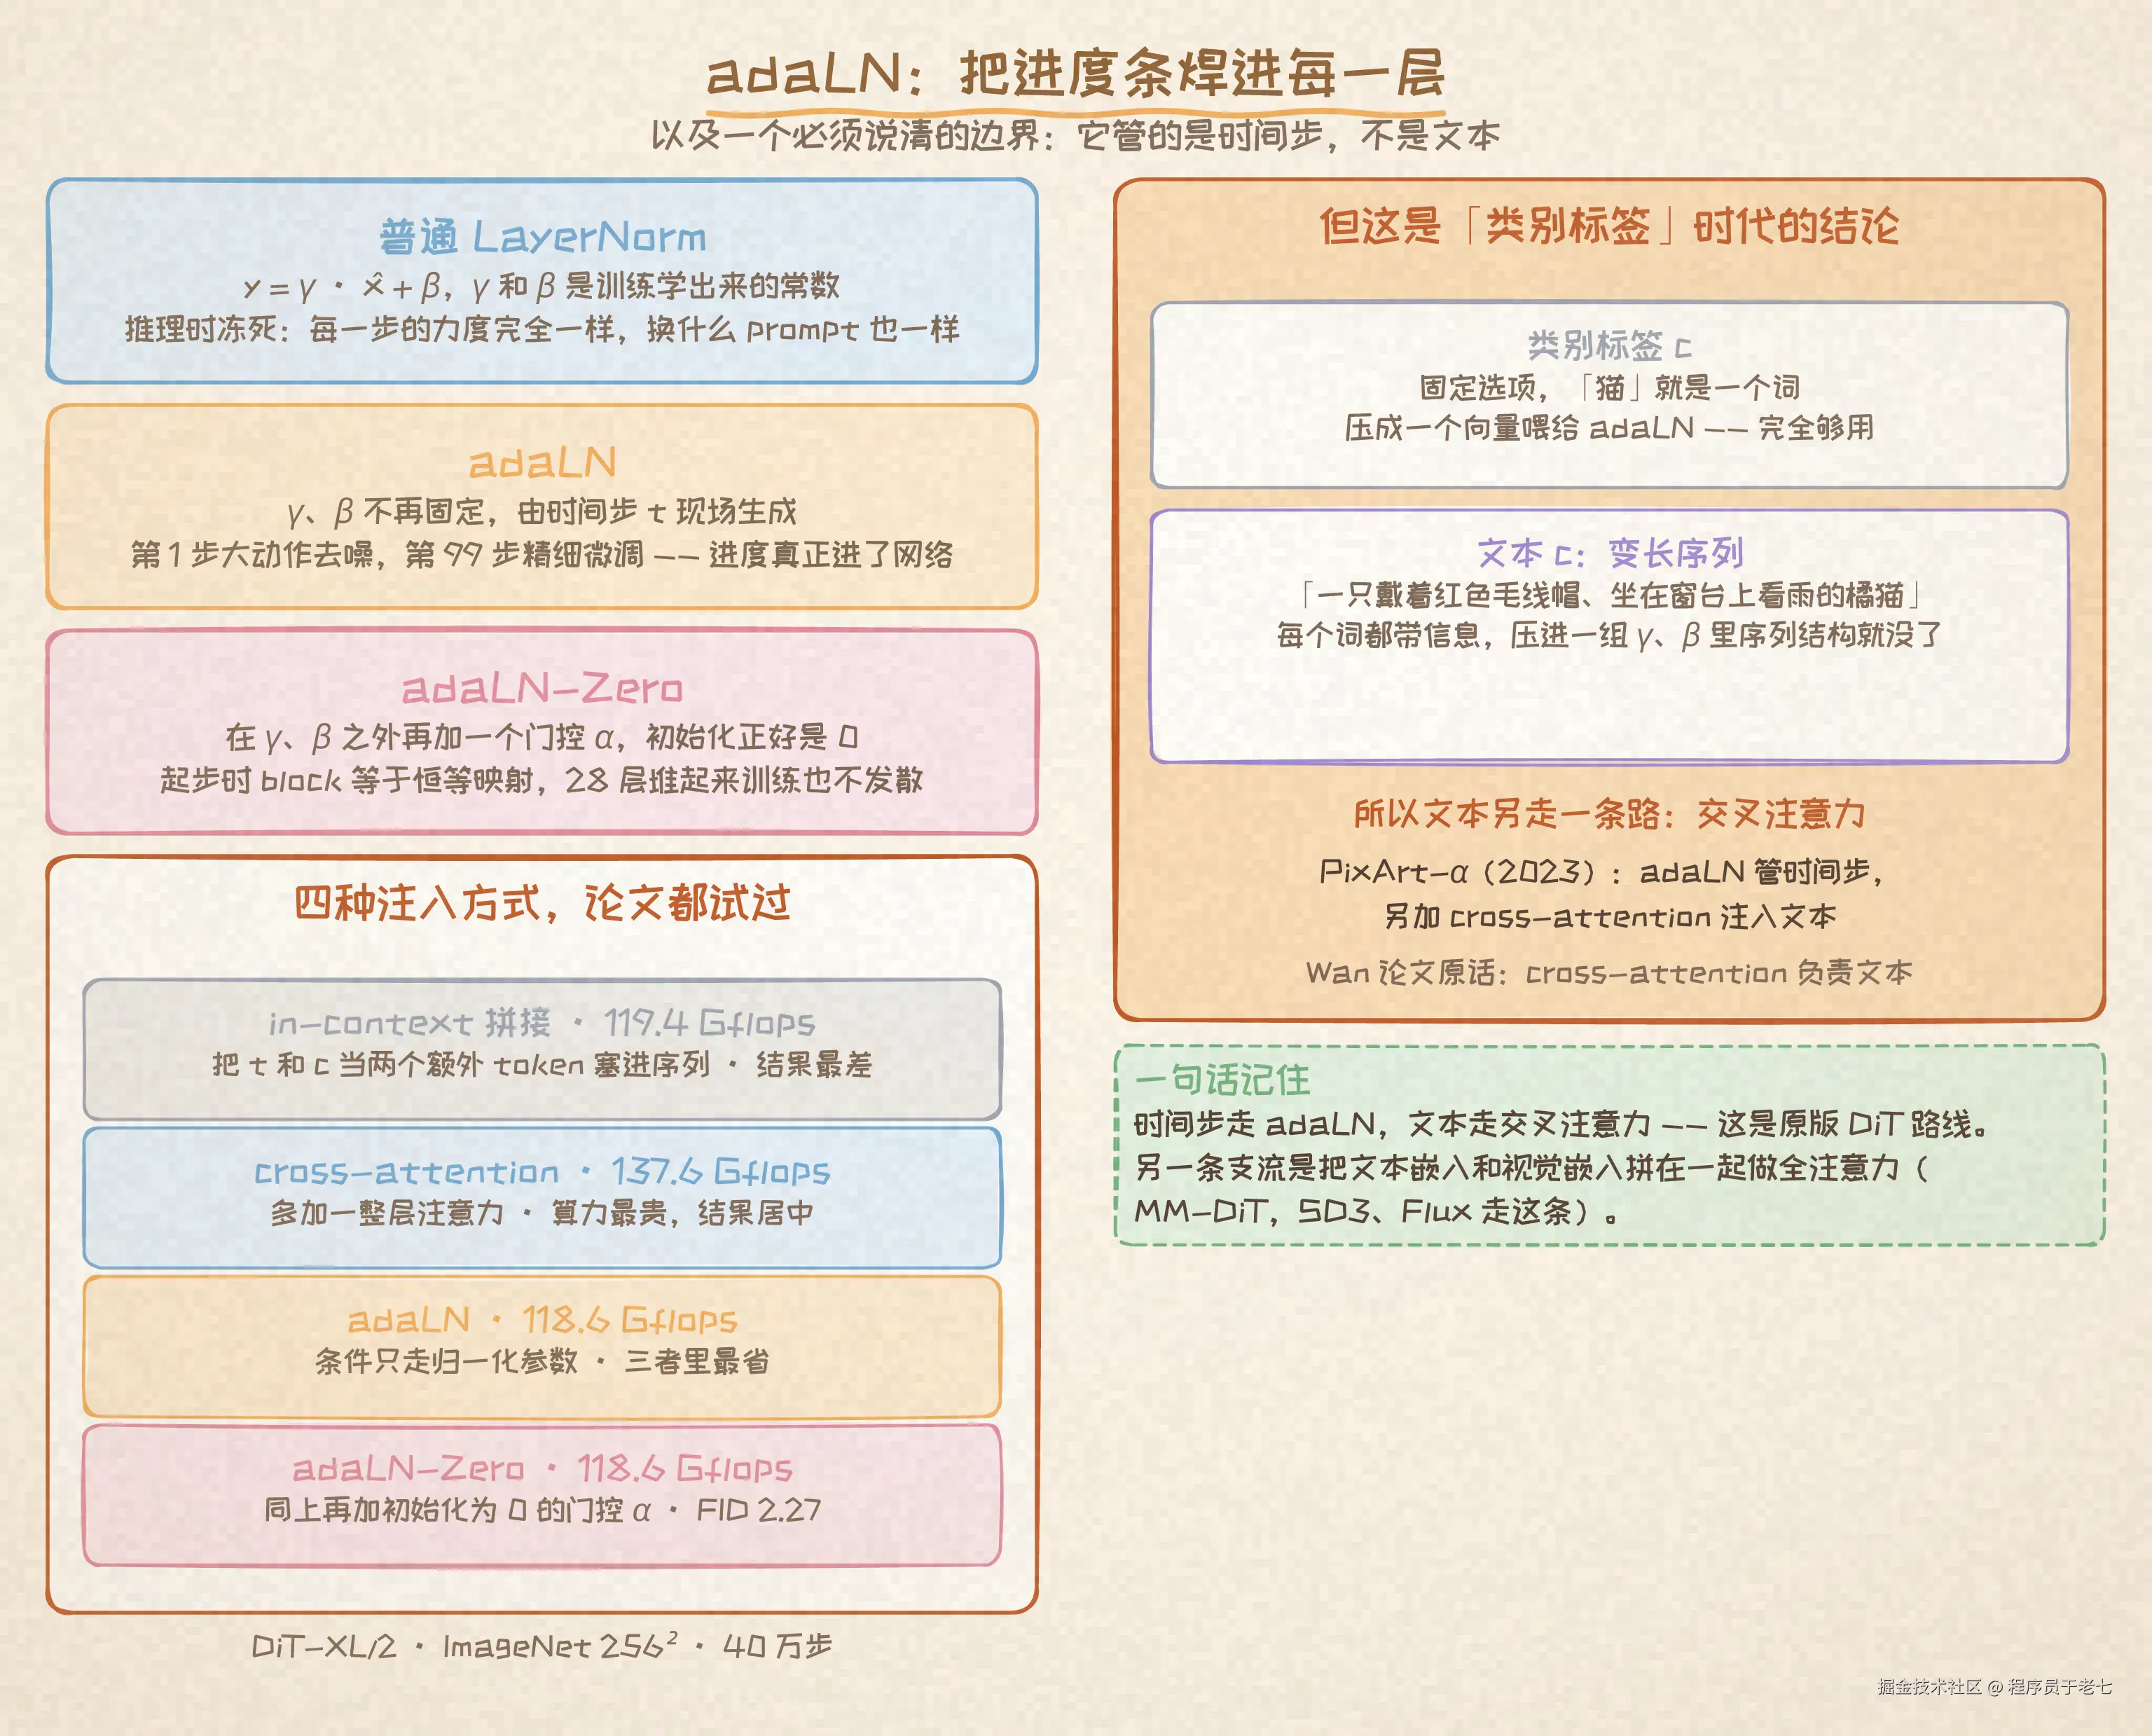
adaLN 到底是什么:把"进度条"焊进每一层
前面两次提到 adaLN,这里把它彻底讲透。
先看普通的 LayerNorm(层归一化)。
Transformer 的每一层里都有归一化操作,作用是把数据"拉回标准范围",防止数值越滚越大。它的公式里有两个可学习的固定参数:
归一化后的值 = γ × 标准化的数据 + βγ(缩放)和 β(偏移)是训练时学出来的固定参数------训完就冻死,推理时对所有输入一视同仁。LLM 就是这样:不管输入什么文本,归一化的"力度"都一样。
adaLN 的改造:让 γ 和 β"活"起来。
DiT 面临一个 LLM 没有的问题:去噪有几十上百步,每步的条件都不同。 第 1 步画面是一团雪花,该大刀阔斧地擦;第 99 步画面已经基本成形,该小心翼翼地精修。如果所有步骤共用同一套固定参数,"擦多狠"这个信息就丢了。
adaLN 的解法:γ 和 β 不再固定,而是由条件动态生成。
scss
时间步 t → 小 MLP → 生成 γ(t) 和 β(t) → 注入每一层每层归一化的"力度"由"现在是第几步"决定:第 1 步生成的参数让网络大动作去噪,第 99 步生成的参数让网络精细微调。相当于每一层都装了一个由"进度"控制的感应旋钮。
DiT 论文还加了临门一脚:adaLN-Zero。
作者发现,光动态生成 γ、β 还不够稳。他们在每层的输出上又乘了一个初始化为零的门控参数 α(t,c):
r
层的输出 = 输入的残差 + α(t,c) × 处理过的数据因为 α 一开始是零,训练初期每个 block 的输出就等于输入------整个网络从一个"啥也不干"的恒等映射起步,再一点点"学会做事"。这个技巧让大模型训练极其稳定,如今已是扩散 Transformer 的标配。
三种注入方式,论文都试过。
不过得先说清楚:DiT 原论文做的是 ImageNet 类条件生成,这里的"条件"指的是类别标签(比如"猫"或"狗"),不是自然语言。 它对比了三种把条件"喂"给网络的方式:
- 拼接法:把时间步和文字编码成 token,直接塞进输入序列------最简单,效果一般
- 交叉注意力:条件作为额外的注意力输入------有效但增加计算量
- adaLN:条件通过归一化参数注入------不增加序列长度、不增加注意力计算,效果还最好
实验结果:adaLN(尤其 adaLN-Zero)胜出,算力还最省(118.6 Gflops,交叉注意力要 137.6)。
但这是"类别标签"时代的结论。换成文本条件,情况就反过来了。
类别标签是个固定选项------"猫"就是一个词,压成一个向量喂给 adaLN 完全够用。文本却是变长序列:"一只戴着红色毛线帽、坐在窗台上看雨的橘猫",每个词都带信息,压进一组 γ、β 里,序列结构就没有了。
于是文本条件另走一条路。PixArt-α 在 2023 年就把方向改了过来:adaLN 继续管时间步,另加交叉注意力模块注入文本 (论文原话:we incorporate cross-attention modules to inject text conditions)。Wan 沿用这条路线,并在论文里写明:cross-attention is employed to embed text conditions。
所以准确的说法是:时间步走 adaLN,文本走交叉注意力。另一条支流是把文本嵌入和视觉嵌入拼在一起做全注意力(业内叫 MM-DiT,SD3、Flux 这一系走的是它)。DiT 论文自己也提到,文本条件有这两种常见变体。
四、视频来了:问题暴涨到另一个量级
DiT 在图像上成功了。但视频是另一个怪物。
一张 1080P 图大约 200 万像素。一段 10 秒 30fps 的 1080P 视频是 300 帧,加起来 6.2 亿像素------是单张图的 300 倍。如果直接在像素空间做扩散,10 秒视频的每一步去噪都要处理 6 亿维数据,算力需求直接爆炸。
解法是先压缩,再扩散。
先用一个叫 3D VAE 的组件,把视频压缩进一个"隐空间"(latent space)。通义万相的 Wan-VAE 能做到时间上 4 倍、空间上 8×8 的压缩------一段 10 秒视频,被压成一小段"视频种子",数据量骤降。
然后 DiT 在这个压缩后的隐空间里做去噪。最后再用 VAE 的解码器,把隐空间结果"放大"回完整视频。
这就是现代视频生成的完整流水线:
原始视频 → 3D VAE 压缩 → 隐空间 token → DiT 去噪 → VAE 解码 → 新视频视频 token 化的方式也很有意思:把视频切成时空块(tube),一个块横跨若干帧------就像把一叠扑克牌切成小方块。这样 DiT 看到的 token 序列,既包含空间信息也包含时间信息,全局注意力自然就学会了"前后帧要连贯"。
把上面所有组件拼起来,就是 Wan 3.0 的完整架构。文本经文本编码器编码后,走交叉注意力进主干;图像视频走 3D VAE 压进隐空间;音频也有自己的编码器,最后全部汇入 DiT 主干:
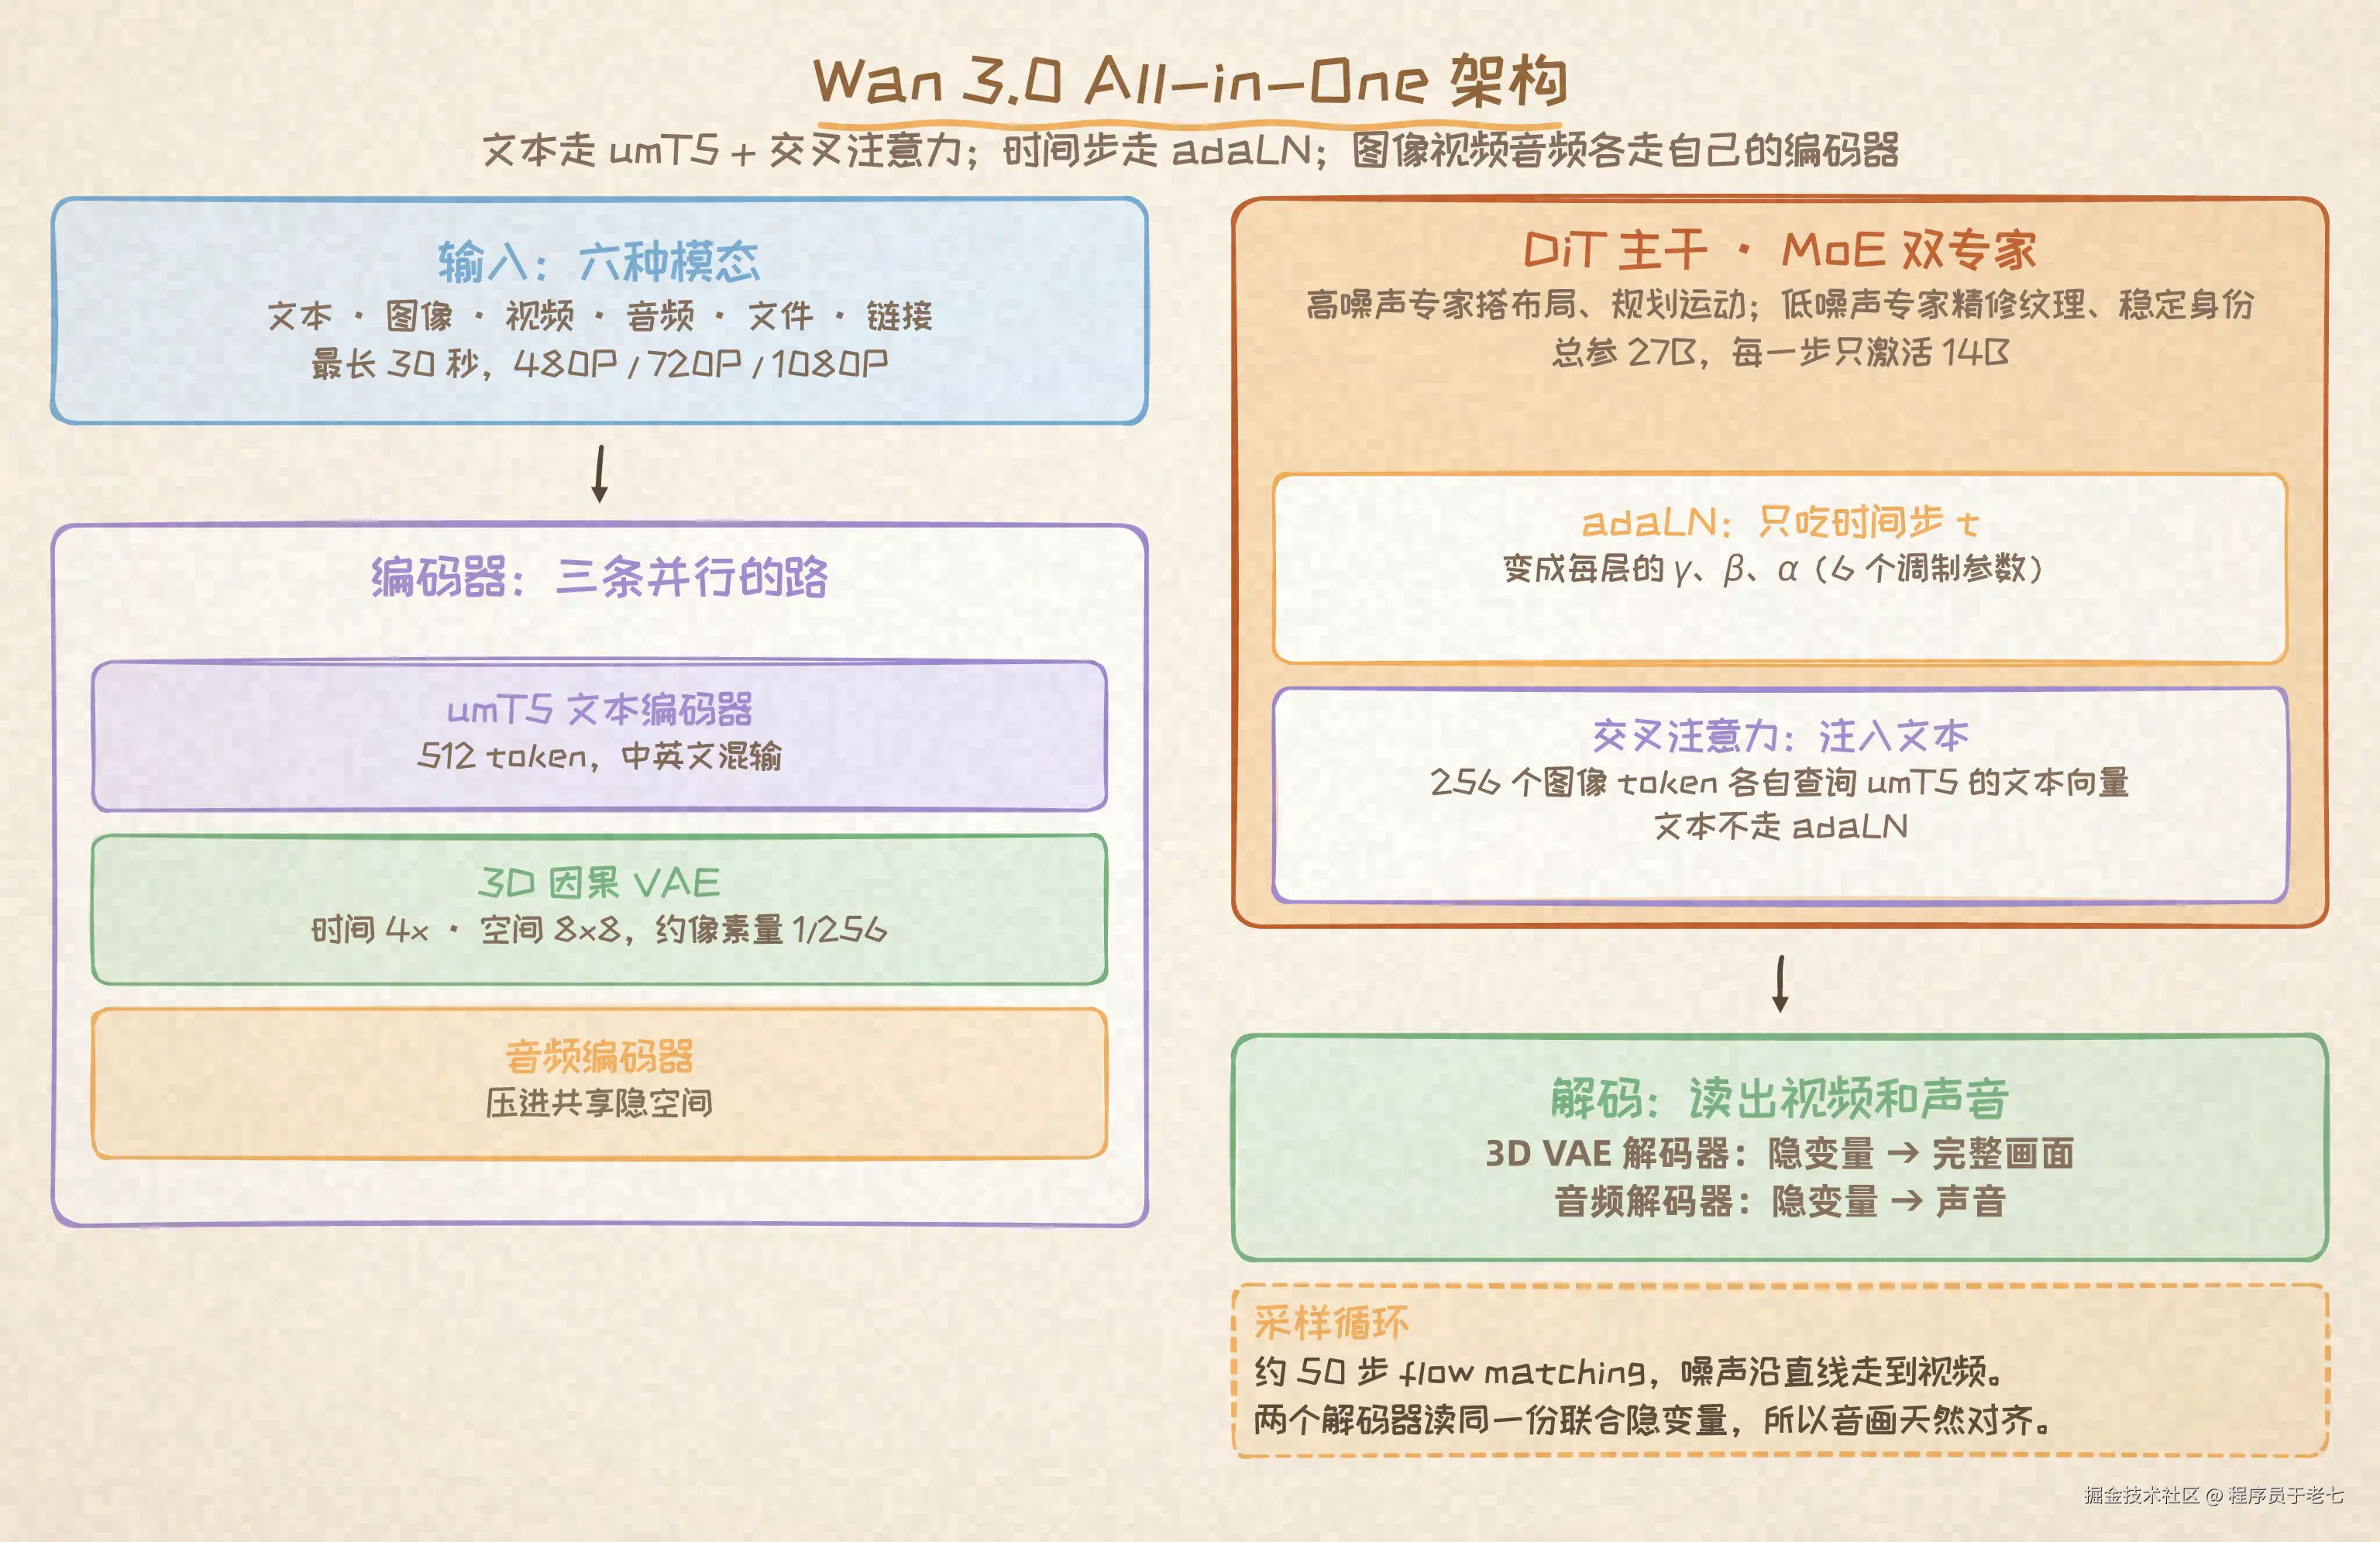
几个值得注意的细节:隐空间 Patchify 把压缩后的视频切成时空块(tube),一个块横跨多帧;adaLN 只把去噪时间步变成每一层的"旋钮",文本条件通过交叉注意力注入;Flow Matching 的去噪循环用虚线标出------重复几十步,噪声逐步变清晰,最后交给 3D VAE 解码器放大回完整视频。
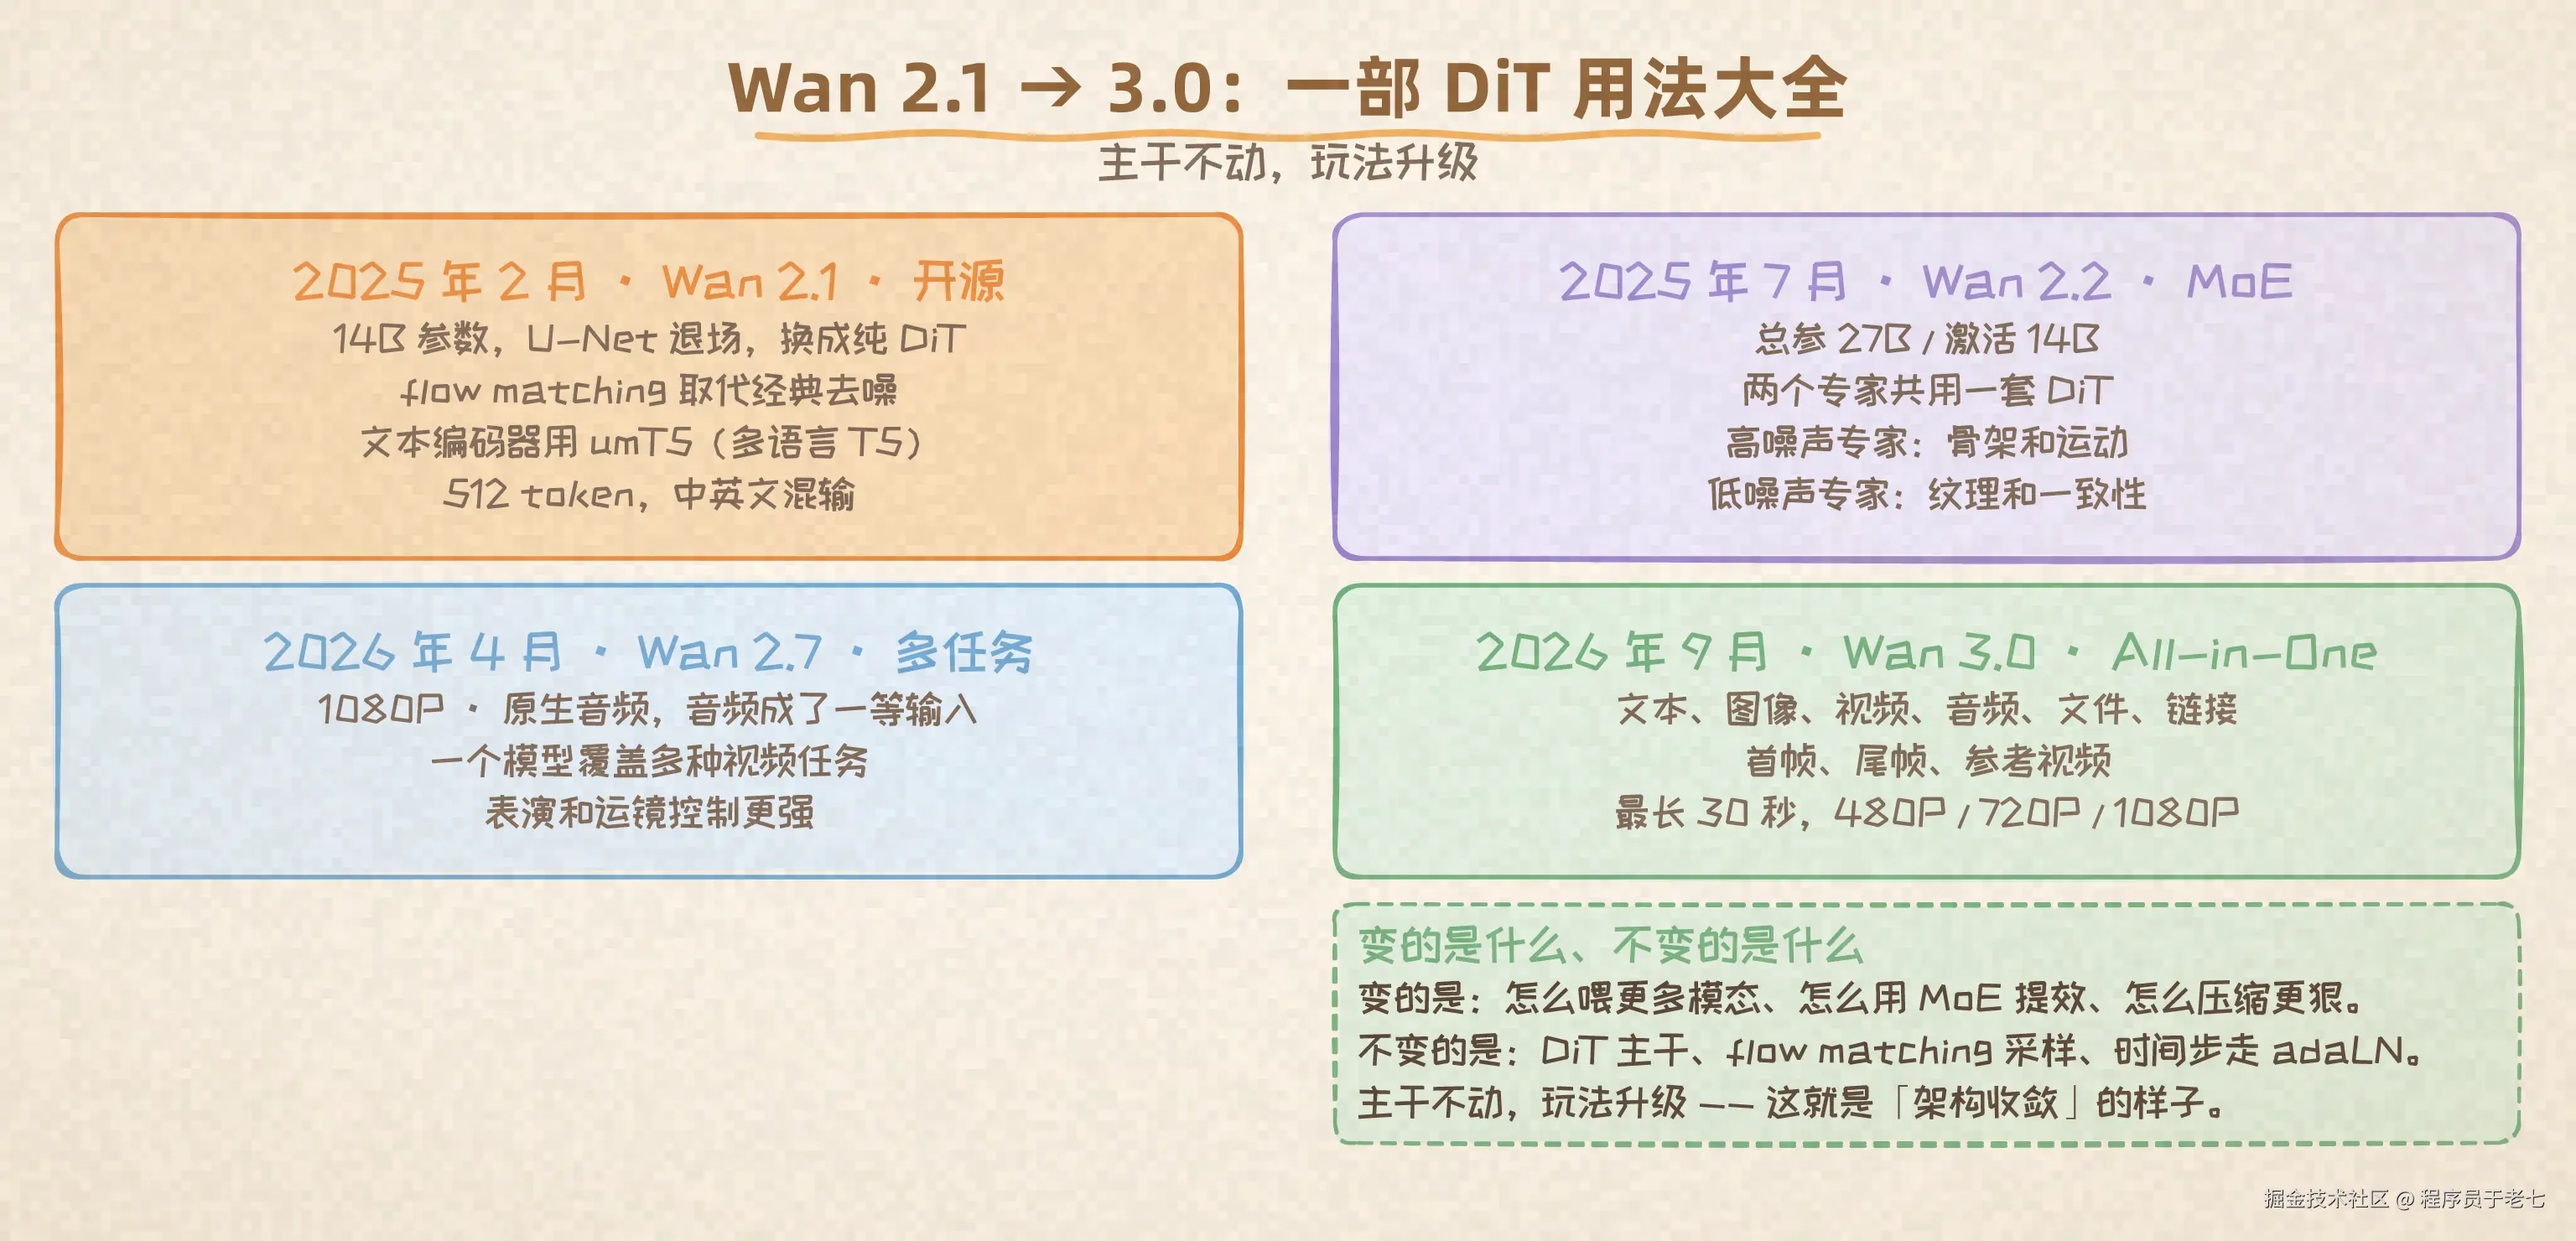
五、Wan 系列的进化:DiT 的四种玩法
理解了 DiT,回头看通义万相的 Wan 系列进化,就是一部 DiT 的"用法大全"。
Wan 2.1(2025 年 2 月,开源) :标准 DiT + Flow Matching,14B 参数。视频生成不再用传统的"预测噪声",而是用 Flow Matching ------学习从噪声到清晰画面的直线路径 ,采样更快更稳。文本编码器用的是 umT5(多语言 T5),中英文混合提示词支持到 512 个 token。论文里做过对比:umT5 的多语言能力、组合能力和收敛速度都优于其他方案,最终选了它。
Wan 2.2(2025 年 7 月) :进化出 MoE DiT------把 DiT 拆成两个专家:一个专门处理高噪声阶段(负责搭场景骨架、规划运动轨迹),一个处理低噪声阶段(负责精修纹理、保证画面一致性)。总参数 27B,但每次推理只激活 14B------用一半的算力,拿到更好的质量。
Wan 2.7(2026 年 4 月):走向多任务统一,原生支持音频,分辨率提到 1080P,时长约 15 秒。
Wan 3.0(2026 年 9 月,All-in-One) :输入彻底放开------文本、图片、视频、音频都能作为参考;支持首尾帧、参考视频;最长 30 秒,1080P 输出。一句话:一个 DiT 主干,吃下所有模态的输入。
进化路线很清晰:DiT 的主干不变,变的只是怎么喂它更多模态、怎么用 MoE 提效、怎么压缩更狠。主干不动,玩法升级------这就是"架构收敛"的样子。
六、为什么 DiT 赢了
最后回到开头的问题:为什么 DiT 统治了视频生成?
三个原因:
Scaling law 友好。 Transformer 的"参数越多越好"规律在扩散模型上依然成立。DiT 原论文的图就很直白:模型越大,FID(生成质量指标)越低,且曲线没有见顶。这意味着砸钱就能变强------对工业界来说,这是最可靠的路线。
全局注意力天然适合视频。 视频的核心难题是"时空一致性"------第 1 帧的猫和第 100 帧的猫必须是同一只猫。卷积的局部视野处理不了这种长程依赖,全局自注意力一步直达。DiT 处理视频,就像 LLM 处理长文本一样自然。
架构收敛降低试错成本。 同一套架构下,工程经验(怎么切 patch、怎么压缩、怎么采样)能快速积累,新玩家不用从零探索------这也是国产视频模型能快速追平的底层原因之一。
七、一个开放的悬念
DiT 的统治地位看起来很稳固,但有个问题悬而未决:扩散模型的"几十上百步去噪"是不是必要的?
每生成一段视频,DiT 要跑几十上百次前向推理。有人尝试把步数压到 20 步、10 步、甚至 1 步(蒸馏),也有人尝试另起炉灶,做自回归视频生成------**不过要说清楚:扩散(DiT + Flow Matching)仍是当下的绝对主流,自回归还只是探索分支。**如果未来出现一个"一步生成视频"的架构,DiT 的神话会不会重演 U-Net 的故事------从主角变成前浪?
技术迭代的剧本我们见过太多次了。
参考资料:
- Scalable Diffusion Models with Transformers (DiT), Peebles & Xie, 2022
- PixArt-α: Fast Training of Diffusion Transformer for Photorealistic Text-to-Image Synthesis, Chen et al., 2023
- Wan: Open and Advanced Large-Scale Video Generative Models (arXiv 2503.20314)
- Wan3.0-Video 模型信息 --- 阿里云百炼
- Wan 3.0 深度解析:从开源破局到 30 秒时代