"For we can enormously extend the record; yet even in its present bulk we can hardly consult it."
"记录日益浩繁,取用举步维艰。"
------ Vannevar Bush,《As We May Think》,1945 [1]
引言
八十年前,麻省理工学院的前校长范尼瓦尔·布什写上面这句话时,就开始有了"人类关心科学发展带来的信息量激增,能否被人及时查用"的历史记录。
现今,AI 应用正逐步从离线知识检索,走向在线交互。Agent 在对话中不断积累记忆,知识库持续接收新内容,工具库也随业务扩充。 数据一边写入,检索一边发生 ,读写混合成为了这类应用的日常负载。
持续写入,意味着向量索引也在不断变化。同步维护索引,会让一次写入承担更多索引更新工作;查询扫描增量数据,也会产生额外开销。读写同时发生时,这些开销会大大影响写入响应和检索效率。
数据持续写入,检索能力需要及时跟上。 对于业务来说,也需要分清两个时刻: 数据已经写入,和新数据已经可以通过向量索引搜到。
OceanBase seekdb [2] 基于 Change Stream 框架 [3] ,将事务写入与向量索引更新解耦:写入事务提交后即可返回,后台持续更新向量索引,查询使用已经更新的索引进行搜索。Agent 记忆系统、动态知识库和工具库等,由此可以在持续接收新数据的同时,提供在线检索服务。
欢迎大家关注 OceanBase 社区公众号 "老纪的技术唠嗑局"。在这里,我们会持续为大家更新与 #AI 和 #Data 相关的技术内容~
OceanBase seekdb 异步索引核心能力:减少写入等待,提升检索效率
将向量索引更新移到后台,带来三个变化。
1. 写入无需等待向量索引更新
写入事务提交后,客户端即可收到响应,无需等待异步向量索引完成这次更新。Agent 提交新记忆后,可以继续处理后续任务。
2. 检索准实时
查询通过已经更新的 HNSW 图索引搜索候选数据。在基于堆表的 HNSW 异步索引中,查询会跳过 Delta Buffer 中的增量数据扫描,减少持续写入带来的查询开销。随着后台更新,新数据逐步进入可检索范围。
3. 索引最终一致
Change Stream 持续处理已提交变更,将新增、修改和删除反映到异步索引中。主表保留正常事务语义,向量索引在后台逐步追上主表进度。如果业务需要立即检索刚提交的数据,可以调用刷新接口等待索引就绪。
技术原理:Change Stream 计算框架
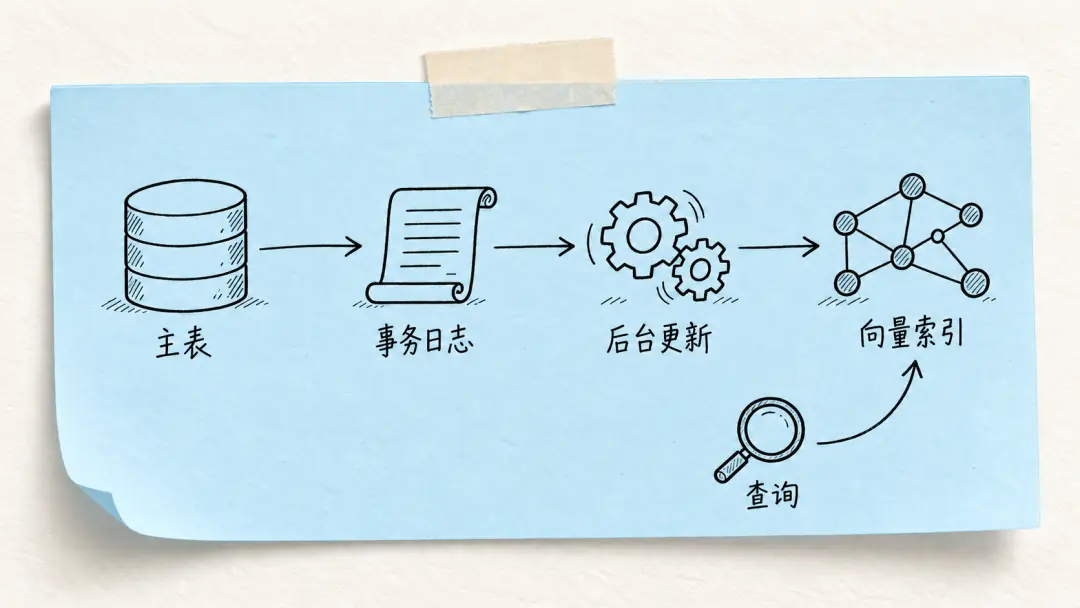
基于 Change Stream 的 HNSW 异步索引,可以从写入、索引更新和检索三个阶段来理解。
阶段一:写入主表
INSERT 、 UPDATE 、 DELETE 更新主表,维护必要的同步索引,并记录事务日志(CLOG)。主键唯一性等约束仍正常检查。事务提交后向客户端返回,向量索引更新交由后台推进。
阶段二:消费变更并更新索引
Fetcher 提取已提交变更,Dispatcher 负责调度与分发,Worker 执行 HNSW 索引更新。新增、修改和删除沿这条路径逐步反映到索引中。
阶段三:准实时检索
查询通过 HNSW 搜索候选数据,并按需回表获取字段。前台使用已经更新的索引提供查询服务,后台继续处理后续变更。
这套设计将向量索引更新移出写入请求的等待过程,并通过异步查询路径减少增量扫描开销。后台索引维护仍需要 CPU、内存和 I/O,部署时应根据写入负载配置相应资源,避免变更持续积压。
性能评测
我们分别测试批量写入下同步与异步模式的差异,以及逐条写入下 seekdb、Milvus 和 Chroma 对固定应用负载的处理表现。
服务端绑定 8 物理核、内存上限 16 GiB,客户端独立绑核。Cohere-100K,HNSW/COSINE,M=16、EF=200、Top-100;三轮中位数。版本:seekdb 1.4.0.0、Milvus 2.6.9、Chroma 1.5.9。
批量写入:异步与同步模式对比
采用 VectorDBBench Streaming 场景,以每秒 200 行、每批 100 行持续写入,写入进度达到 90% 后开始查询。QPS 和并发 P99 对应固定 16 并发。
| seekdb 模式 | QPS | 串行 P99(ms) | 并发 P99(ms) | Recall |
|---|---|---|---|---|
| 异步 | 4350 | 3.9 | 16.00 | 0.8797 |
| 同步 | 300 | 29.2 | 96.06 | 0.9019 |
Recall 按全量数据计算,含尚未写入近邻;同步组并发窗口为 11.1--14.4 秒。图中短线表示三轮范围。
异步模式的查询吞吐约为同步模式的 14.51 倍 ,并发 P99 从 96.06 ms 降至 16.00 ms ,下降约 83.3% 。
逐条写入:每秒 200 行写入与 2,000 次查询
模拟 Agent 记忆逐条更新,设置每秒 200 行写入、2,000 次查询 的目标负载。每轮查询到达窗口为 30 秒 ,结果如下:
| 产品 | 实际完成 QPS | 实际写入(行/秒) | API P99(ms) | 响应 P99(含排队) |
|---|---|---|---|---|
| seekdb 异步 | 1999.9 | 200.0 | 7.43 | 8.10 ms |
| Milvus | 1297.6 | 200.0 | 19.72 | 16.17 s(积压) |
| Chroma | 614.7 | 42.7 | 40.42 | 65.72 s(积压) |
说明:
预载 9 万行、等待 30 秒;1 个写入客户端、16 个查询客户端。
速率统计 30 秒,P99 覆盖全部 6 万次计划查询;API P99 不含调用前排队,响应 P99 包含。
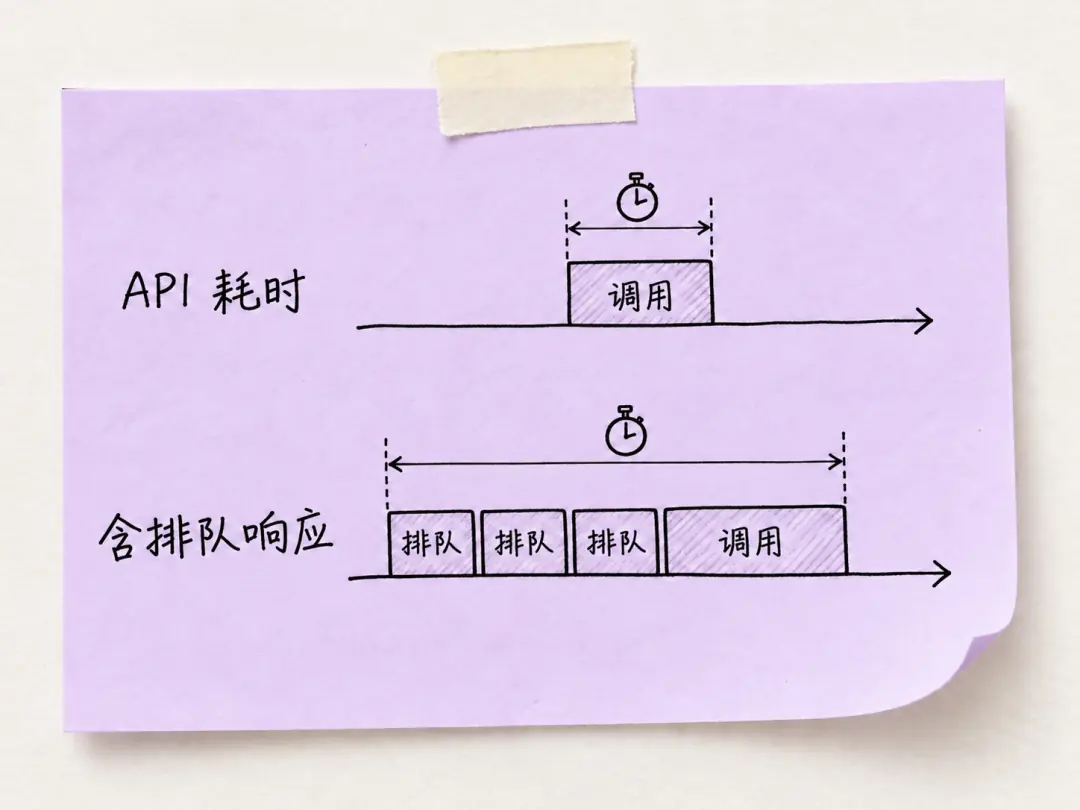
seekdb 三轮均基本维持目标读写速率,含排队的响应 P99 为 7.81--8.90 ms 。Milvus 的查询出现积压;Chroma 的读写均未维持目标速率。 表中的秒级响应包含积压等待时间。 按查询前已确认写入的数据计算,三者抽样 Recall@100 分别为 97.23%、97.90%、97.25% 。
以上结果对应本次逐条写入负载。此前每批 100 行、固定 16 并发的测试中,Milvus 的并发 P99 为 11.86 ms ,低于 seekdb 异步模式的 16.00 ms 。
写入响应与新数据可检索时间
在另一组每秒逐条写入 200 行的测试中,写入请求 P99 为 3.45 ms ;从写入响应返回到新增数据首次出现在检索结果中,延迟 P99 为 212.45 ms 。
独立轻量查询测试;可检索延迟包含轮询和查询时间。
应用场景
场景一:AI Agent 的长期记忆系统
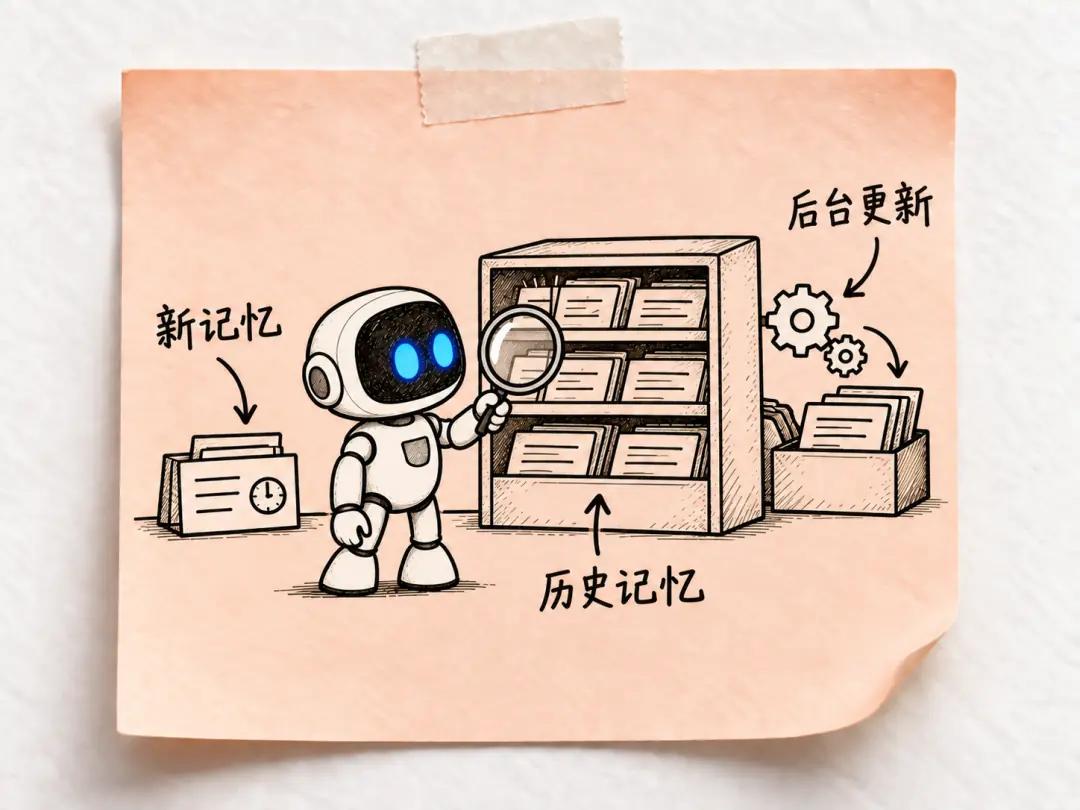
Agent 在对话中不断生成上下文摘要、用户偏好和工具调用结果。新记忆持续写入,历史记忆通过向量检索参与后续推理。索引在后台更新,Agent 可以在积累新记忆的同时,继续利用已有记忆开展检索和推理。
场景二:RAG 系统的知识持续更新
新闻、产品资料和业务知识不断变化,在线问答也在持续发生。新文档完成向量化并写入后,由后台更新相应索引。在线问答通过已更新的索引检索内容,让知识更新与问答服务并行进行。
场景三:API 工具库的动态扩充
Agent 可以通过向量检索,从工具描述中寻找与当前意图匹配的候选 API。工具不断新增或调整时,后台处理相应的索引更新,在线路由继续通过已更新的索引匹配工具。
场景四:多模态内容的增量入库
应用将图像、文本或音频转换为向量后,可以沿用这套异步索引流程处理新增与修改。内容解析与 Embedding 生成由应用完成,seekdb 负责向量数据的存储、索引和检索。
快速上手
seekdb 从 1.3.0 版本开始支持异步向量索引。创建索引时,将 sync_mode 设为 async ,并使用堆表( ORGANIZATION HEAP )。
下面以一张四维向量表为例,演示建表、写入和检索的完整流程:
plain
CREATE TABLE t_async (
    id INT PRIMARY KEY,
    vec1 VECTOR(4),
    VECTOR INDEX idx1(vec1)
        WITH (type=hnsw, distance=l2,
              sync_mode=async)
) ORGANIZATION HEAP;

INSERT INTO t_async VALUES (1, '[1,0,0,0]');

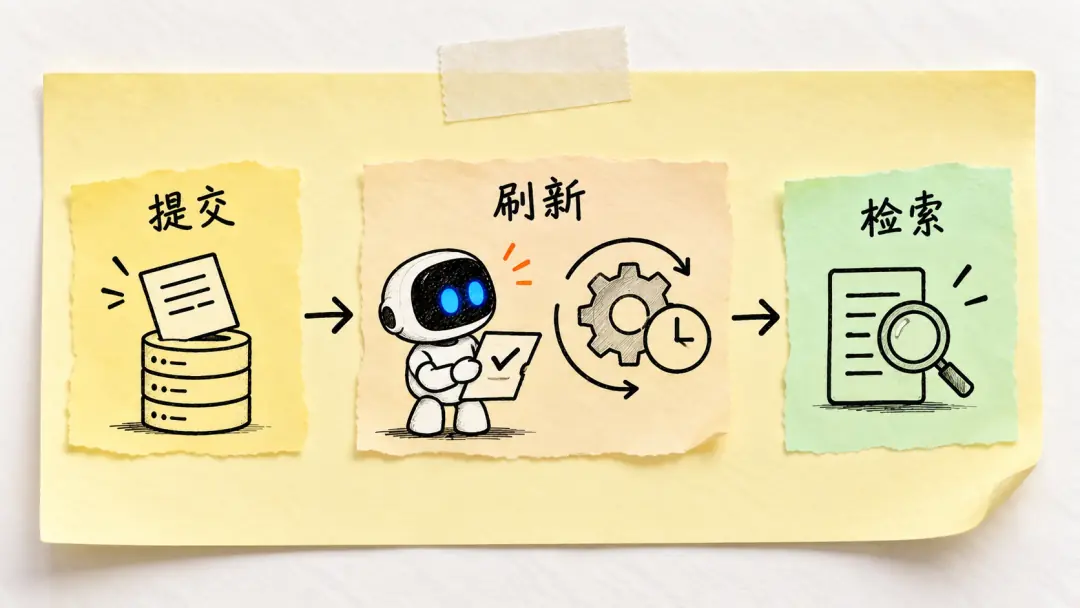
CALL dbms_index_manager.refresh();

SELECT id FROM t_async
ORDER BY l2_distance(vec1, '[1,0,0,0]')
APPROXIMATE LIMIT 1;
示例使用自动提交。如果使用显式事务,需要先执行 COMMIT ,再调用 refresh() 等待索引更新。
调用会阻塞,超时会返回错误。后续查询依赖刚写入的数据时,可以在提交后调用它;允许数据稍后可检索的业务,可以直接继续处理其他任务。
使用 Python 嵌入式接口
通过 pyseekdb,可以将 seekdb 嵌入 Python 应用。在 Linux、Python 3.11 或更高版本环境中,安装 pyseekdb 及其内核依赖:
plain
pip install pyseekdb==1.4.0.post1 \
    pylibseekdb==1.4.0.post1
选择一个新的本地数据目录,运行以下代码。示例创建集合、写入两条记忆,并检索与输入向量最接近的一条:
plain
from pyseekdb import (
    Client, HNSWConfiguration,
)

with Client(
    path="./async_demo.db"
) as client:
    memory = client.create_collection(
        "memory",
        configuration=HNSWConfiguration(
            dimension=4, distance="l2"
        ),
        embedding_function=None,
    )
    memory.add(
        ids=["1", "2"],
        embeddings=[
            [1, 0, 0, 0], [0, 1, 0, 0]
        ],
        documents=["one", "two"],
    )
    memory.refresh_index()
    result = memory.query(
        query_embeddings=[[1, 0, 0, 0]],
        n_results=1,
    )
    print(result["ids"][0])  # ["1"]
示例直接传入四维向量。实际应用中,可以替换为 Embedding 模型生成的向量,并相应设置集合的向量维度。
结语
持续写入与在线检索并行,是 Agent、动态知识库和工具库共同面对的需求。seekdb 通过 Change Stream 将向量索引更新放到后台,减少写入等待,并优化持续写入下的查询路径。
在本文的批量写入测试中,异步模式的查询吞吐约为同步模式的 14.51 倍 ,并发 P99 降低约 83.3% 。在每秒逐条写入 200 行、发起 2,000 次查询的测试中,seekdb 三轮均基本维持目标速率,包含客户端排队的响应 P99 为 7.81--8.90 ms 。这些结果为持续产生新数据的 Agent 和在线知识库提供了具体的性能参考。
说明:
异步索引从 seekdb 1.3.0 版本 [4] 开始支持,该功能也即将合入到 OceanBase AI 数据库 [5] 中。
参考资料
1
《As We May Think》,1945: web.mit.edu/STS.035/www...
2
seekdb: github.com/oceanbase/s...
3
Change Stream 框架: www.mongodb.com/zh-cn/docs/...
4
seekdb 1.3.0 版本: github.com/oceanbase/s...
5
OceanBase AI 数据库: www.oceanbase.com/product/ai-...