一、引言
大数据平台发展到一定规模后,数据质量问题通常会从"偶发故障"变成"系统性工程问题"。在离线链路中,源表与目标表的记录数可能不一致,字段可能出现空值、重复值或非法值;在实时链路中,Kafka 数据可能延迟、乱序、丢失或与下游结果不一致。
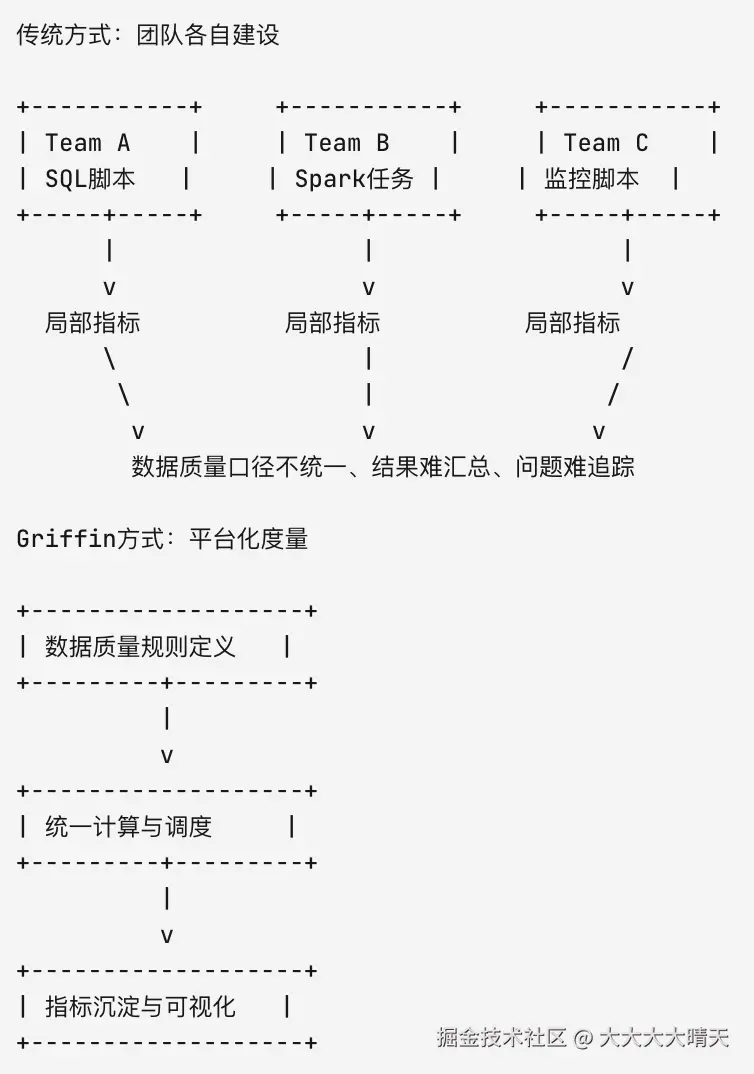
Griffin 出现的核心背景可以概括为三点:第一,跨数据源、跨链路的数据质量缺少端到端统一视图;第二,流式数据质量缺少自助式、平台化度量系统;第三,不同团队重复建设检测脚本、任务调度和指标展示能力,造成维护成本上升。
可以用一张简单图理解 Griffin 要解决的问题:
二、Griffin核心定位
Apache Griffin 是一个面向大数据场景的数据质量解决方案,定位为一个模型驱动的数据质量服务平台,构建在 Apache Hadoop 和 Apache Spark 之上,支持批处理和流式两类数据质量度量任务。所谓"模型驱动",不是指机器学习模型,而是指它抽象了数据质量领域中的常见度量模型,让用户围绕 Accuracy、Completeness、Timeliness、Profiling 等维度描述质量要求,然后由平台把这些要求转换为 Spark 上可执行的计算逻辑。
Apache Griffin 试图把数据质量从"各团队自建脚本、各查各的指标"提升为一个统一的平台化能力:统一定义质量模型,统一调度质量计算,统一输出质量指标,并通过服务和可视化能力支撑后续监控与分析。这意味着它不是一个单点校验库,而更像一个"数据质量平台骨架":规则、执行、存储、服务和展示都在同一个框架中被考虑。
从适用对象看,Griffin 更贴近数据平台团队、数据治理团队和大数据基础设施团队,而不是只想在单个任务里写几条断言的业务开发者。它适合把质量规则沉淀为平台能力,也适合用于教学和架构参考,帮助理解大数据质量系统如何组织规则、计算和指标。
三、Griffin架构原理
Griffin 的处理过程可以概括为三步:Define Data Quality、Measure Data Quality、Metrics。用户先定义准确性、完整性、及时性、数据探查等质量需求;随后 Griffin 将源数据摄入计算集群并执行质量度量;最后把质量报告作为指标输出到指定目标。
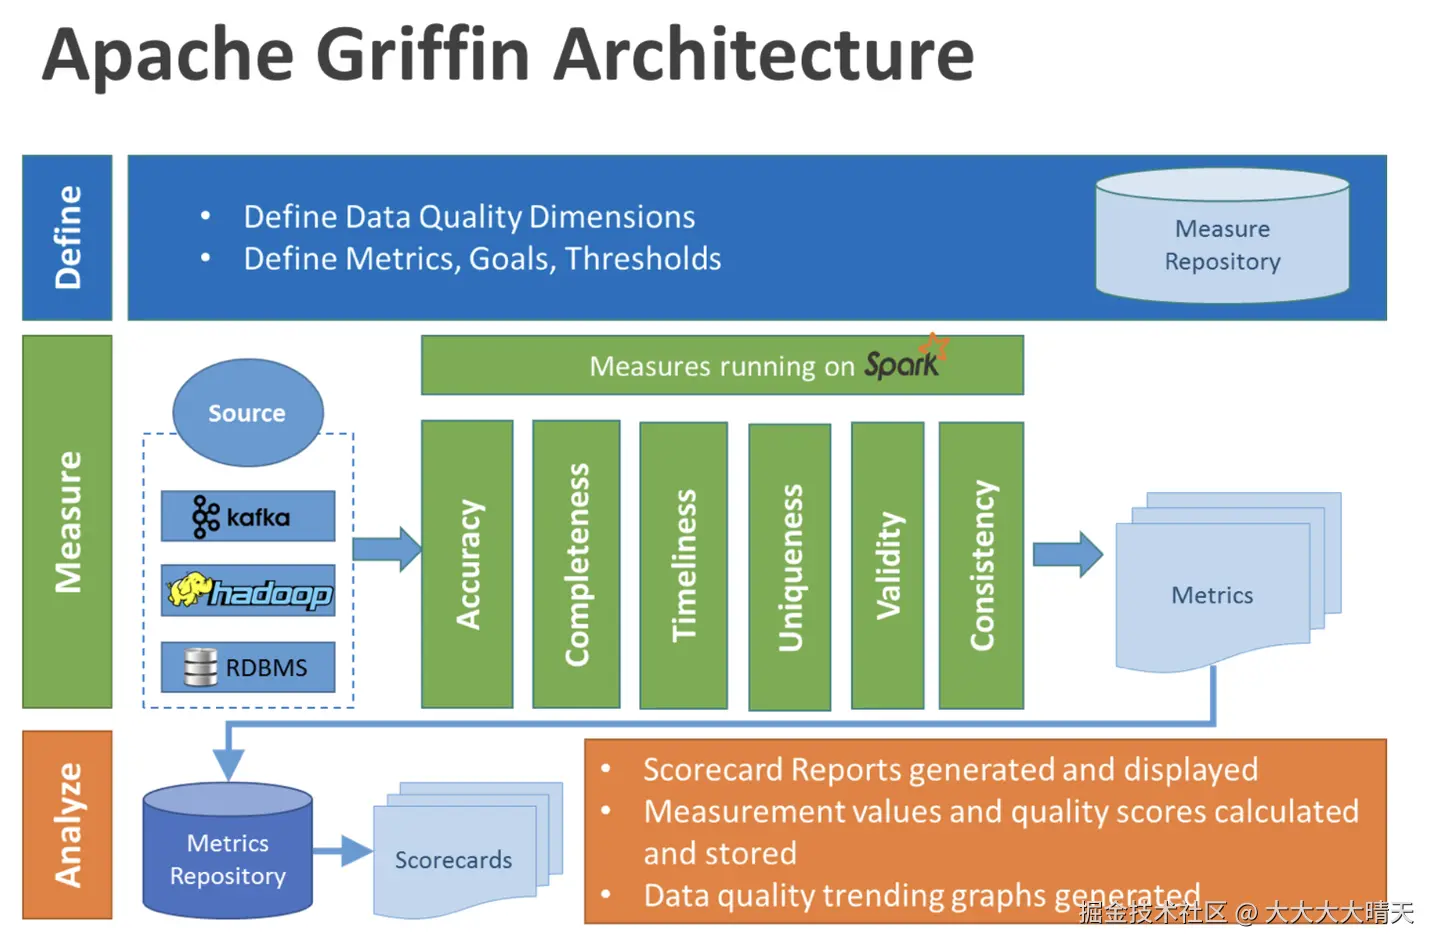
从 Griffin 的架构看,可以理解为五层:数据接入层、规则定义层、计算执行层、指标存储层和服务展示层。批处理场景通常从 Hadoop/Hive 中读取数据,流式场景可从 Kafka 等消息系统接入数据;计算层主要依赖 Spark;指标可以写入 HDFS、Elasticsearch 或 Console;服务层提供 RESTful 能力,用于数据集探索、质量度量创建、指标发布和查询等。
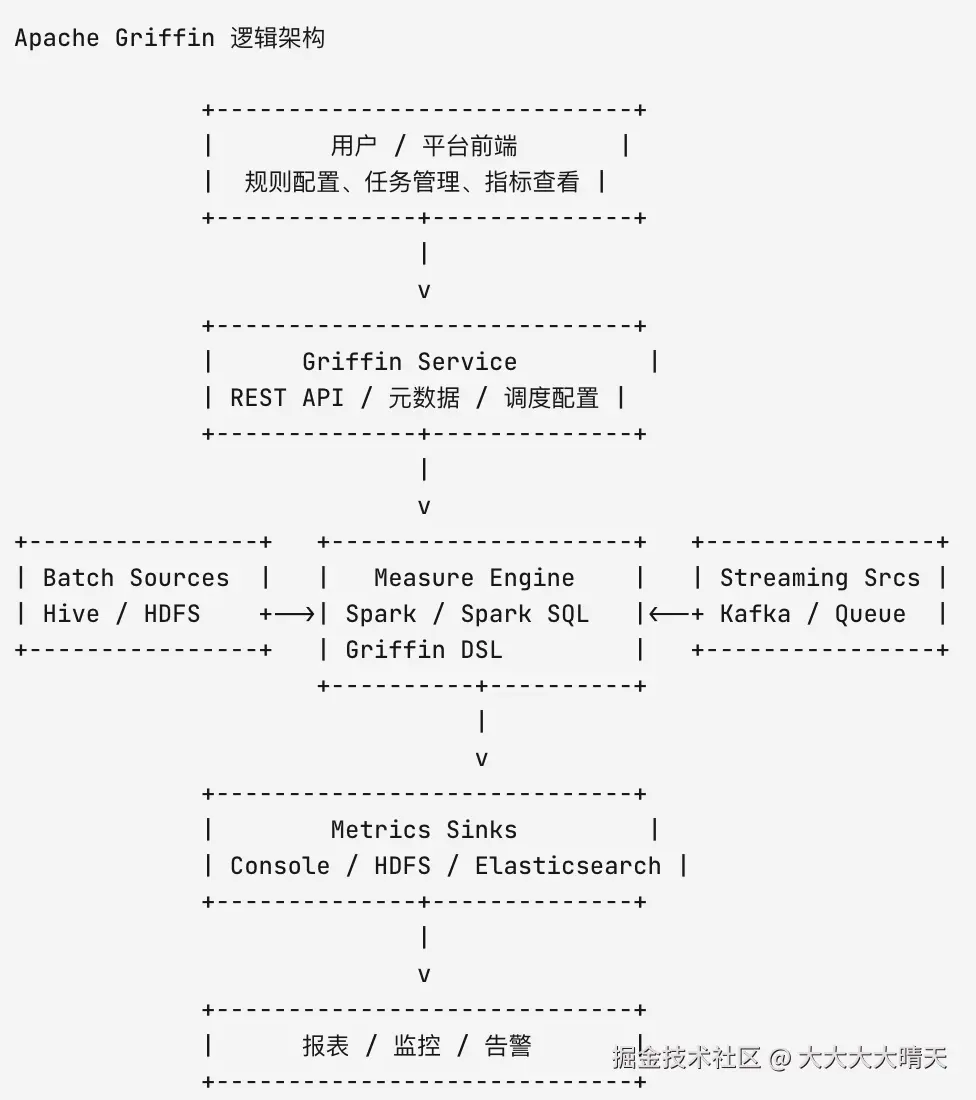
Griffin 的一个关键设计是 DSL。Griffin DSL 是一种面向数据质量度量的类 SQL 语言,支持逻辑运算、数学运算、where 、group by 、having 、order by 、limit 等语义,也支持 Accuracy、Profiling、Distinctness、Uniqueness、Completeness、Timeliness 等规则表达。
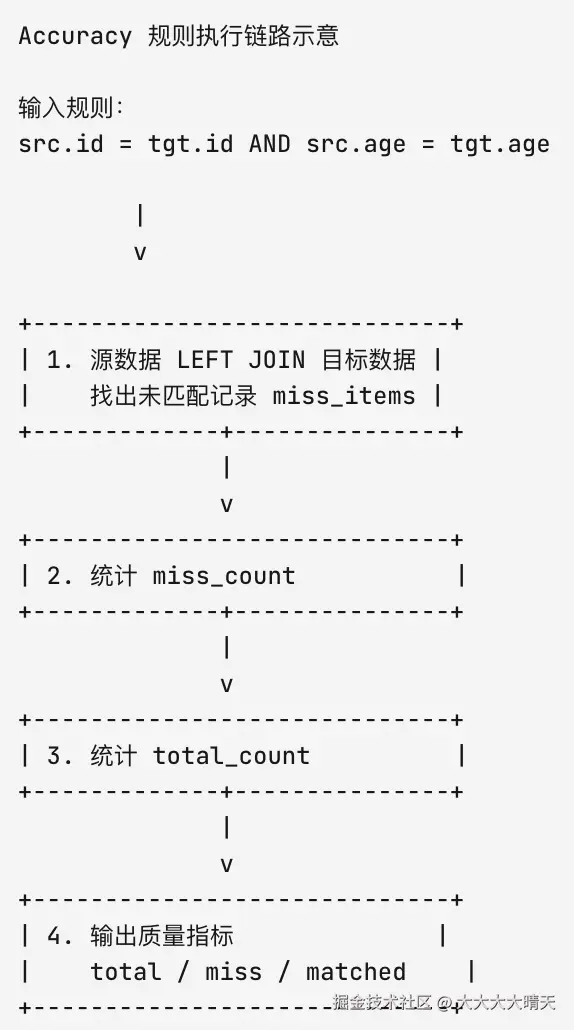
更重要的是,Griffin 并不直接"解释"质量规则得出结果,而是把 DSL 翻译为 Spark SQL 执行。例如 Accuracy 规则会被转换为若干 SQL:先通过源表和目标表关联找出 miss items,再计算 miss count、total count,最后得到 matched、miss、total 等指标。
四、Griffin功能特性
- 同时支持批处理和流式质量度量,Griffin 是面向 Batch and Streaming 的大数据质量解决方案。
- 质量维度比较完整,如Accuracy、Completeness、Validity、Timeliness、Anomaly Detection、Data Profiling 等能力。
- 规则表达相对贴近 SQL,类 SQL 的 DSL 比嵌入式代码规则更容易理解,也更适合平台化存储和可视化配置;对于复杂需求,Griffin 支持直接使用 Spark SQL。
| 能力维度 | Griffin 中的含义 | 典型例子 |
|---|---|---|
| Accuracy | 对照源数据或基准数据验证目标数据是否匹配 | 源表与目标表按主键和字段比对 |
| Completeness | 检查必要字段是否存在或非空 | user_id、event_time 不为空 |
| Validity | 判断字段值是否符合业务域约束 | 状态值只能属于合法枚举 |
| Timeliness | 衡量数据从产生到可用之间的延迟 | 事件时间与处理时间差值 |
| Profiling | 对数据分布做统计分析 | 最大值、最小值、Top N、唯一值数量 |
| Distinctness / Uniqueness | 识别重复或唯一性问题 | 主键重复、组合键重复 |
五、Griffin特性优势
Griffin 的优势首先来自"统一口径"。在没有平台化工具时,团队通常会用 SQL、Spark、Shell、Airflow 任务或自研脚本分别检查数据,这会导致指标命名、规则粒度、输出格式和故障定位方式不一致。Griffin 用统一的数据质量模型和 DSL 把规则表达标准化,再通过 Spark 统一计算,有利于形成跨团队可复用的质量资产。
其次,它天然适配大数据技术栈。Griffin部署使用依赖JDK、Hadoop、Spark、Hive 等环境,还涉及 Livy、Elasticsearch、PostgreSQL/MySQL、Scala 等组件。Griffin 的设计目标不是轻量级本地校验,而是嵌入 Hadoop/Spark 生态中的平台型能力。
第三,Griffin 把质量结果沉淀为指标,而不是只在任务失败时打印日志。官方Quick Start 中的env.json 示例展示了 Console、HDFS、Elasticsearch 三类 sink;计算完成后,指标可被写入hdfs:///griffin/persist/<job name>/<timestamp>/_METRICS 。这对数据治理很重要,因为质量问题需要长期观察趋势,而不是只关注一次任务是否通过。
sql
Griffin 的工程优势

+----------------+--------------------------------+
| 统一规则        | DSL / Spark SQL 描述质量条件     |
+----------------+--------------------------------+
| 统一执行        | Spark 批处理或流式计算           |
+----------------+--------------------------------+
| 统一输出        | Console / HDFS / Elasticsearch |
+----------------+--------------------------------+
| 统一服务        | REST API 支撑平台集成            |
+----------------+--------------------------------+
| 可扩展          | 可扩展 DSL、函数和处理逻辑        |
+----------------+--------------------------------+
不过,优势需要结合当前状态理性看待。由于 Griffin 已退休并迁入 Apache Attic,官方项目资源进入只读保存状态,生产使用时不能默认期待活跃社区持续修复依赖兼容、安全漏洞或新版本生态适配问题。
六、Griffin适用场景
Griffin 适合用于数据仓库链路中的源目标一致性校验。例如 ODS 到 DWD、DWD 到 DWS、Hive 表到下游应用表之间,可以使用 Accuracy 规则比对关键字段,并输出 matched、miss、total 等指标。
它也适合用于数据探查和日常质量画像。Profiling 规则可以对字段分布、最大值、最小值、计数、Top N 等做统计,帮助工程师在接入新表、迁移任务或排查异常时快速了解数据状态。
在实时链路中,Griffin 可以用于 Kafka topic 之间的数据质量比对。
| 场景 | 是否适合 Griffin | 原因 |
|---|---|---|
| Hive 离线表对账 | 适合 | 官方 Quick Start 覆盖类似场景 |
| Kafka 流式质量比对 | 适合但需谨慎 | 官方有示例,但 Kafka 示例版本较旧 |
| 数据分布探查 | 适合 | DSL 支持 Profiling 聚合 |
| 轻量级单表断言 | 不一定适合 | 部署链路偏重,可能用 SQL/Great Expectations 更轻 |
| 新生产系统选型 | 谨慎 | 项目已进入 Apache Attic |
| 学习数据质量平台架构 | 适合 | 架构模型完整,具有参考价值 |
七、Griffin部署使用
Griffin 的部署复杂度高于普通数据质量库,因为它依赖一组大数据基础设施。部署流程可以抽象为四步:先准备 Hadoop、Hive、Spark、Livy、Elasticsearch 和数据库;再配置 Griffin Service 的数据库、Hive Metastore、Elasticsearch、Livy、YARN 等连接;随后构建 Griffin,得到 service 包和 measure jar;最后把 measure jar 上传到 HDFS,并启动 Griffin 管理服务。
sql
部署链路简图

+------------------+
| 1. 准备基础环境   |
| JDK/Hadoop/Hive  |
| Spark/Livy/ES/DB |
+---------+--------+
          |
          v
+------------------+
| 2. 修改配置       |
| application.properties
| sparkProperties.json
| env_batch.json   |
+---------+--------+
          |
          v
+------------------+
| 3. 构建 Griffin   |
| mvn clean install|
+---------+--------+
          |
          v
+------------------+
| 4. 上传 measure jar|
| hdfs dfs -put    |
+---------+--------+
          |
          v
+------------------+
| 5. 启动服务       |
| griffin.sh start |
+------------------+一个最小批处理任务通常包含两个配置文件:env.json 和dq.json 。env.json 负责定义 Spark 配置和指标输出位置,例如 Console、HDFS、Elasticsearch;dq.json 负责定义任务名称、处理类型、数据源、质量规则和输出内容。
批处理提交方式如下:
lua
spark-submit \
  --class org.apache.griffin.measure.Application \
  --master yarn \
  --deploy-mode client \
  --queue default \
  --driver-memory 1g \
  --executor-memory 1g \
  --num-executors 2 \
  <path>/griffin-measure.jar \
  <path>/env.json \
  <path>/dq.json
任务完成后,质量指标会打印到 Console,并保存到 HDFS 的hdfs:///griffin/persist/<job name>/<timestamp>/_METRICS 路径下。
八、常见问题
- 问题一:Griffin 现在还能不能用于生产?
能否使用取决于团队的维护能力。官方 Attic 页面已经确认 Griffin 于 2025 年退休并迁入 Attic,这意味着它不再是活跃 Apache 项目。如果用于生产,建议把它视为可二次维护的开源代码库,而不是持续演进的社区项目。
- 问题二:为什么 Griffin 部署这么重?
Griffin 的目标是大数据质量平台,而不是单机校验工具。部署依赖 Hadoop、Hive、Spark、Livy、Elasticsearch 和数据库,原因是它要完成数据接入、Spark 计算、任务调度、指标存储和服务化展示。
- 问题三:DSL 和 Spark SQL 怎么选?
常见质量维度优先使用 Griffin DSL,因为它面向 Accuracy、Completeness、Profiling、Timeliness 等数据质量语义封装了翻译逻辑;复杂计算可以直接写 Spark SQL。
- 问题四:流式场景有什么坑?
官方 Streaming Use Cases 使用的大数据组件版本与今天常见的大数据栈存在代差,因此新环境接入时需要重点验证 Kafka connector、Spark Streaming、依赖包冲突和 checkpoint 行为。
- 问题五:Griffin 和数据治理平台是什么关系?
Griffin 更接近数据质量度量引擎和服务平台的一部分。它能生成质量指标,但不等同于完整数据治理平台;元数据管理、血缘分析、权限治理、资产目录、质量工单和 SLA 管理等能力仍需要和其他平台集成。