写在前面
PL/SQL 是 KingbaseES 在 SQL 上做的过程化扩展,把 SQL 操作数据的能力和过程语言控制流程的能力揉到了一块。跟纯 SQL 比,它能写更绕的业务逻辑,出了错也能把控制权转给异常处理块,不至于让程序直接崩掉。
知识库这块内容不少,我按四条线理:异常处理怎么捕获和传播错误、数据类型分哪几类、调试优化靠什么工具找瓶颈、过程和语句怎么写函数跟存储过程。下面一条条说。
一、异常处理:出错也能体面收场
1.1 异常是什么
异常说白了就是 PL/SQL 运行时报的错。设计疏忽、编码 bug、硬件故障,都可能导致。你没法提前堵住所有异常,但可以写一段处理程序,让程序踩到坑之后还能继续往下走。任何一个 PL/SQL 块都能挂一个异常处理部分。
异常分两类,一类是系统预定义异常,一类是用户自定义异常。前者 PL/SQL 已经给常见错误起了名,运行时出错自动抛,比如除零对应的是 DIVISION_BY_ZERO。后者得你自己在匿名块、子程序或包的声明区里声明。
1.2 系统预定义异常
KingbaseES 预定义了一批异常,还跟 Oracle 的命名做了对应。这张表建议留着,报错名对不上号的时候翻一翻:
| KingbaseES 异常名 | Oracle 对应名 | 触发说明 |
|---|---|---|
CASE_NOT_FOUND |
CASE_NOT_FOUND |
CASE 语句没有任何 WHEN 满足,也没有 ELSE |
COLLECTION_IS_ |
COLLECTION_IS_ |
对未初始化的嵌套表/可变数组调方法(EXISTS 除外)或赋值 |
DUPLICATE_CURSOR |
CURSOR_ALREADY_OPEN |
打开一个已经打开的游标 |
UNIQUE_VIOLATION |
DUP_VAL_ON_INDEX |
给有唯一约束的字段存了重复值 |
INVALID_CURSOR_NAME |
INVALID_CURSOR |
操作了不合法的游标,比如关闭没打开的游标 |
INVALID_TEXT_REPRESENTATION |
INVALID_NUMBER |
运算、转换、截位或长度约束出错 |
NO_DATA_FOUND |
NO_DATA_FOUND |
没查到数据 |
INTERNAL_ERROR |
PROGRAM_ERROR |
PL/SQL 内部错误 |
SELF_IS_ |
SELF_IS_ |
对空对象调 MEMBER 方法 |
OUT_OF_MEMORY |
STORAGE_ERROR |
内存溢出 |
SUBSCRIPT_BEYOND_COUNT |
SUBSCRIPT_BEYOND_COUNT |
下标超出元素总个数 |
SUBSCRIPT_OUTSIDE_LIMIT |
SUBSCRIPT_OUTSIDE_LIMIT |
下标不在合法范围,比如 -1 |
TOO_MANY_ROWS |
TOO_MANY_ROWS |
返回太多结果行 |
NUMERIC_VALUE_OUT_OF_RANGE |
VALUE_ERROR |
数值超出定义域 |
DIVISION_BY_ZERO |
ZERO_DIVIDE |
除零错误 |
用法不难,直接 WHEN 异常名 THEN,名字大小写无所谓:
sql
\set SQLTERM /
DECLARE
  stock_price   NUMBER := 9.73;
  net_earnings  NUMBER := 0;
  pe_ratio      NUMBER;
BEGIN
  pe_ratio := stock_price / net_earnings;  -- 触发除零异常
  DBMS_OUTPUT.PUT_LINE('Price/earnings ratio = ' || pe_ratio);
EXCEPTION
  WHEN DIVISION_BY_ZERO THEN
    DBMS_OUTPUT.PUT_LINE('Company had zero earnings.');
    pe_ratio := NULL;
END;
/
\set SQLTERM ;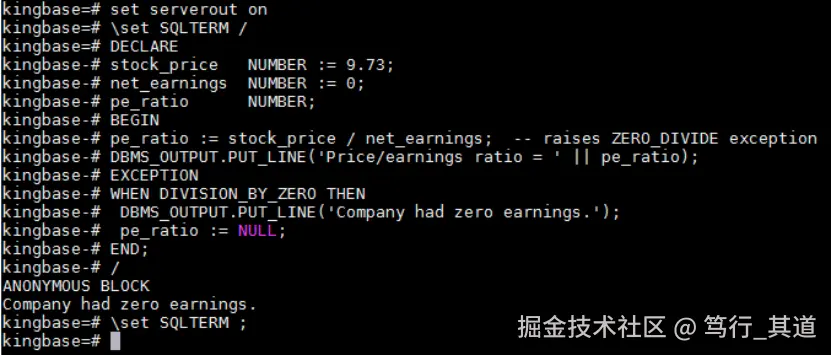
1.3 用户自定义异常
自己声明异常,语法是 exception_name EXCEPTION;。想跟错误码绑定就用 PRAGMA EXCEPTION_INIT,错误码得是大于 -1000000 且小于 0 的整数。拿一个到期账户检查的例子说:
sql
\set SQLTERM /
CREATE PROCEDURE account_status (due_date DATE, today DATE) AUTHID DEFINER AS
  past_due  EXCEPTION;
BEGIN
  IF due_date < today THEN
    RAISE past_due;              -- 显式抛出
  END IF;
EXCEPTION
  WHEN past_due THEN
    RAISE NOTICE 'Account past due.';
END;
/
\set SQLTERM ;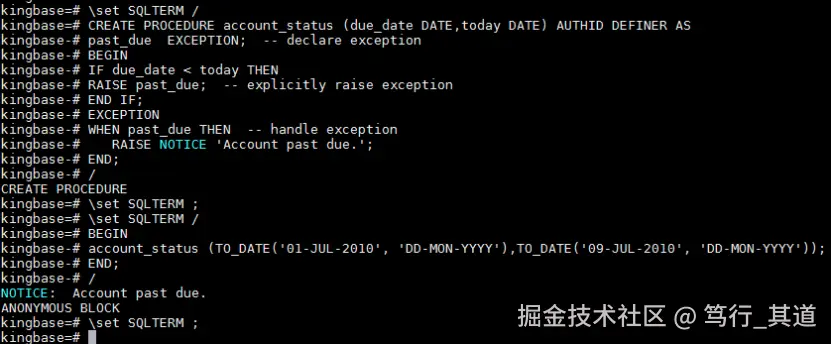
1.4 捕获与传播
捕获靠 EXCEPTION ... WHEN ... THEN,OTHERS 兜底。有两个细节容易忘:一是处理语句里又抛了新异常,当前这个 EXCEPTION 子句接不住,会继续往外抛;二是异常被捕获时,局部变量保持触发时的值,但块里对数据库的改动默认会回滚,除非开了单语句回滚。
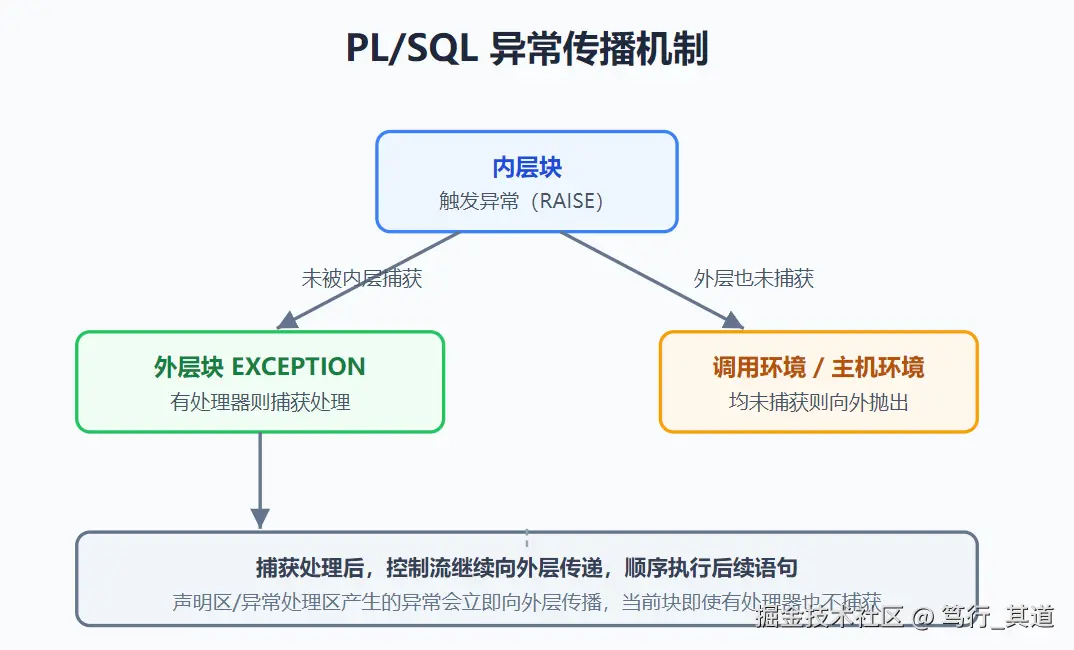
传播规则也直白:先在当前块找处理器,找不到就往封闭块层层上抛,直到有块接住,或者抛回调用环境。声明区和异常处理区产生的异常比较特殊,会立刻往外层传播,就算当前块有处理器也不拦。
1.5 异常信息检索
在异常处理块里,一组系统变量和函数能拿到当前异常的详情。SQLSTATE 和 SQLERRM 分别是 SQL 标准错误码和错误信息,只在异常处理模块里能用。SQLCODE() / SQLERRM() 是 Oracle 兼容的错误码和消息。剩下还有 ERROR_LINE()、ERROR_PROCEDURE()、ERROR_NUMBER()、ERROR_MESSAGE()、ERROR_STATE()、ERROR_SEVERITY(),分别拿行号、对象名、错误号、消息、状态号和严重级别。写日志告警的时候,这几个函数能帮你精确定位到是哪个函数哪一行出的问题。
二、数据类型:标量、记录、集合、对象
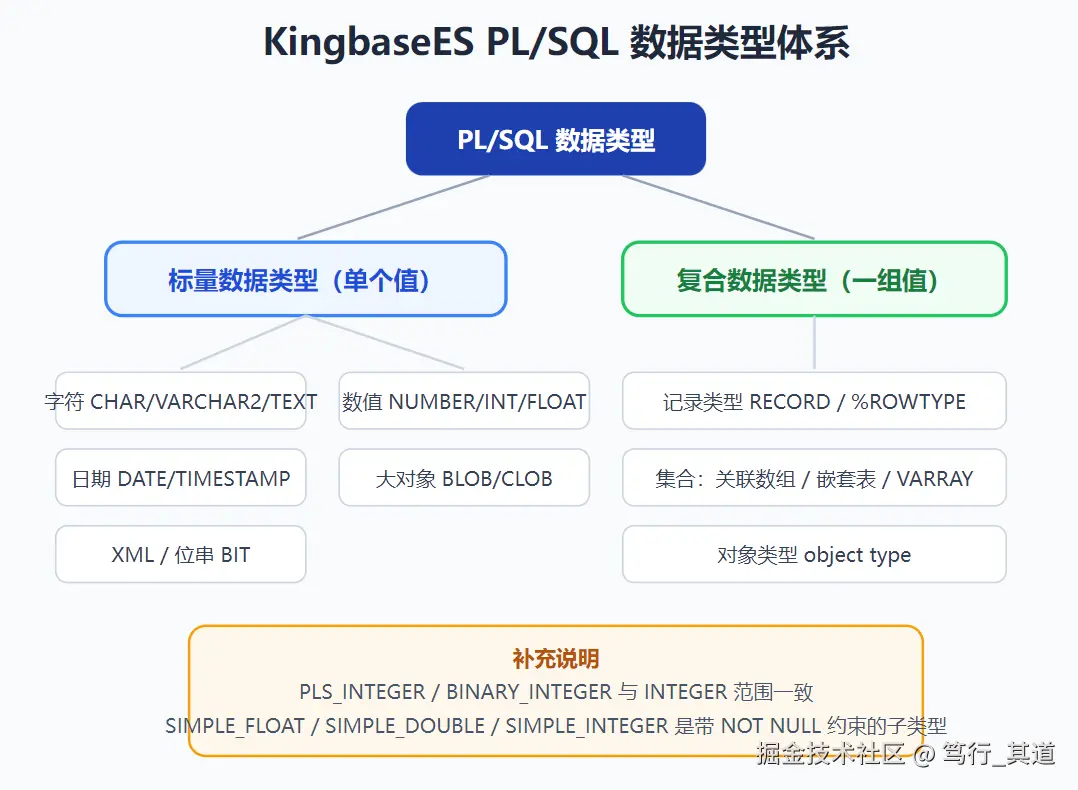
PL/SQL 数据类型分两大类------标量(存单个值)和复合(存一组值)。复合下面又分记录、集合、对象三种。
2.1 标量类型
字符类型里,CHAR 定长、不够了右侧补空格,VARCHAR2 变长不补,TEXT 最大 1G 适合存长文本。数值类型里 NUMBER(p,s) 用得最多,p 是有效位总数、s 是小数位,NUMBER(8,2) 最大表示 999999.99。PLS_INTEGER 和 BINARY_INTEGER 等价,范围跟 INTEGER 一致。日期时间有 DATE、TIMESTAMP、TIME、INTERVAL,大对象有 BLOB/CLOB/NCLOB/BFILE 这些,另外还有 XML 和位串 BIT/BIT VARYING。
有个点容易忽略:SIMPLE_FLOAT、SIMPLE_DOUBLE、SIMPLE_INTEGER 这几个子类型在基本类型上加了 NOT NULL 约束,变量永远不会 NULL 的时候可以用它们。
2.2 记录类型
记录类型内部元素可以不同数据类型,靠字段名访问。定义方式三种:显式指定字段的 RECORD、用 %TYPE 跟随已有变量或列的类型、用 %ROWTYPE 直接套整张表或游标结果集的结构。记录能嵌套,也能当子程序参数或函数返回值传。
sql
TYPE student_info IS RECORD(
  id INT,
  name VARCHAR,
  grade INT
);
student student_info;                        -- 字段默认 NULL
student2 student_info := (1, 'Zhang San', 90);  -- 声明并初始化
2.3 集合类型
集合是同质元素的组合,三种,适用场景不一样:
| 类型 | 下标 | 是否限制个数 | 可用范围 |
|---|---|---|---|
| 关联数组 | String 或 PLS_INTEGER | 不限制 | 仅 PL/SQL 块/包 |
| 嵌套表 | PLS_INTEGER(从 1 起) | 不限制 | 块/包/模式 |
| VARRAY | PLS_INTEGER(从 1 起) | 需指定上限 | 块/包/模式 |
关联数组像哈希表,适合稀疏集合或快速查找;嵌套表元素数量不定的时候好用;VARRAY 适合预先知道最大数量、得保持顺序的场景。集合还带了一批内置方法,DELETE/TRIM/EXTEND 做增删,EXISTS/FIRST/LAST/COUNT/LIMIT/PRIOR/NEXT 做查询遍历。
2.4 对象类型
对象类型把面向对象那套搬进了数据库,由属性、方法、构造函数三部分组成。方法分成员方法(MEMBER,依赖具体实例)和静态方法(STATIC,依赖类型本身)。每个成员方法和构造函数都隐式带一个 self 参数指向实例自己。
有个特性我挺喜欢,就是 object type 的多段连续调用。以前想连调多个方法,得先写中间变量,比如 objvar2 := objvar1.func1(); 然后再 result := objvar2.func2();,两行才搞定。现在直接 objvar1.func1().func2() 一步到位。它底层会把这种链式调用重写成 ty3.func3(ty2.func2(a.func1())) 这种嵌套形式,代码看着清爽多了。
三、调试与优化:找性能瓶颈的两把利器
3.1 plsql_plprofiler
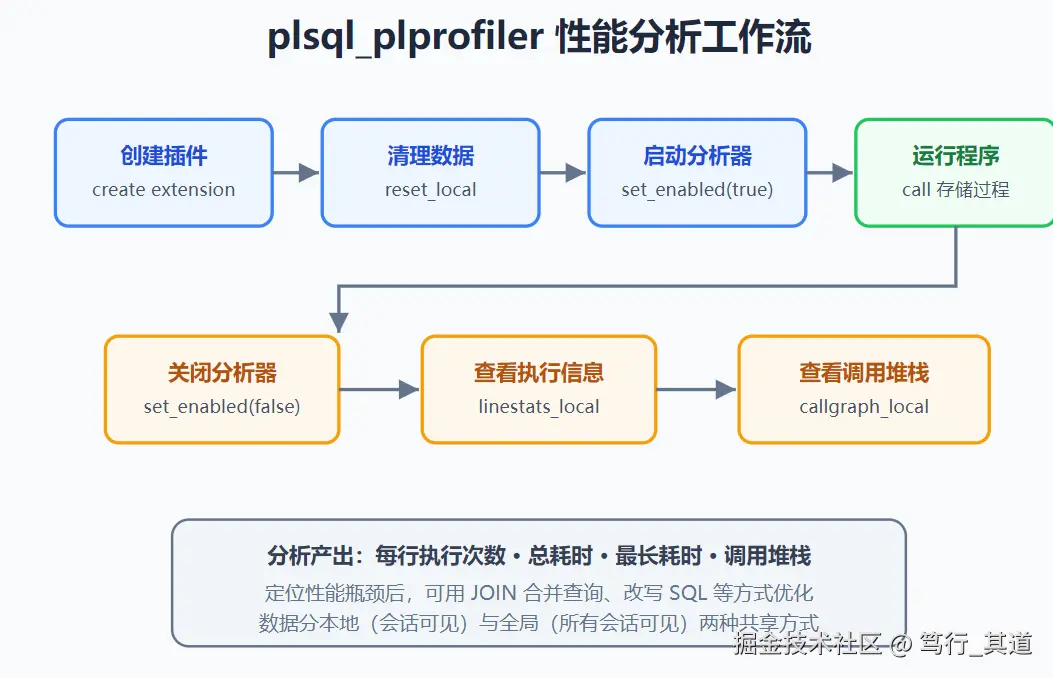
plsql_plprofiler 是 KingbaseES 的扩展插件,能分析函数、存储过程、包、触发器、嵌套函数、匿名块和对象类型的执行性能。它采三类数据:执行信息(对象 oid、行号、执行次数、总耗时、最长耗时)、堆栈信息(调用次数、自身耗时、调用对象耗时)、源码信息(oid、行号、源码)。
流程不复杂:建插件 → 清旧数据 → 启动分析器 → 跑目标程序 → 关分析器 → 查结果。数据分本地(当前会话可见)和全局(所有会话可见)两种。
看个挺典型的例子。一个存储过程先查基本工资、再查奖金、最后更新,跑完分析发现最耗时的是那两条 SELECT 和一条 UPDATE:
sql
create extension plsql_plprofiler;
select pl_profiler_reset_local();
select pl_profiler_set_enabled_local(true);
call cal_salary(7);
select pl_profiler_set_enabled_local(false);

SELECT L.func_oid::regproc AS funcname, L.line_number,
       sum(L.exec_count)::bigint AS exec_count,
       sum(L.total_time)::bigint  AS total_time,
       max(L.longest_time)::bigint AS longest_time,
       S.source
FROM pl_profiler_linestats_local() L
JOIN pl_profiler_funcs_source(pl_profiler_func_oids_local) S
  ON S.func_oid = L.func_oid AND S.line_number = L.line_number
GROUP BY L.func_oid, L.line_number, S.source
ORDER BY L.func_oid, L.line_number;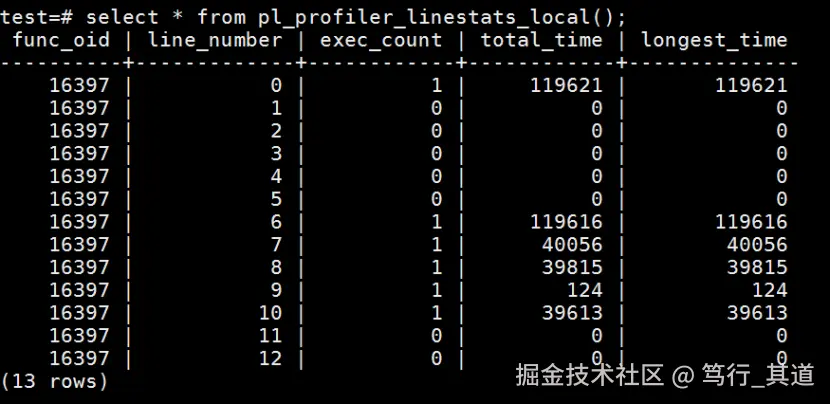
定位到瓶颈后,把两次单独查询改成一条 JOIN 合并查询,速度明显上来了。这就是 profiler 的价值------不用猜,数据直接告诉你慢在哪一行。
3.2 plsql_pldbgapi
plsql_pldbgapi 是专门给 PL/SQL 做的调试插件,用法跟 GDB 很像,要开两个会话:一个应用端跑被调试的程序,一个调试端发命令。
基础的断点、单步进入、单步跳过、继续、查看断点,对应 plsql_pldbg_set_breakpoint、step_into、step_over、continue、get_breakpoints 这几个函数。高级的更值得说:get_variables 能一次性打印所有变量和参数,get_stack 看调用堆栈,step_out 直接跳出当前堆栈,还有 run_to_next_exception 能让程序停在异常发生的地方------排查运行时错误时尤其好用,因为就算没打断点它也会停。条件断点也支持,set_breakpoint_src 可以设命中次数和断点描述。
3.3 对象状态与 auto_explain
KingbaseES 的 PL/SQL 对象(函数、存储过程、触发器、包、类型)都有有效/无效状态。编译报错的对象会被标无效,但错误只降级成警告,不影响后面操作。这个功能用 GUC 参数 ora_func_style(默认 false)控制。状态分被动刷新(调用时检查)和主动刷新(ALTER ... COMPILE),依赖对象状态变了还会引起「状态蔓延」。
排查存储过程内部 SQL 的性能,auto_explain 是 explain 的补充。它是 session 级的,几个关键参数值得记:log_min_duration 只记录超阈值的慢 SQL,log_analyze 输出真实执行计划,log_nested_statements 开了能把函数内部嵌套 SQL 的计划也打出来。有个实战案例是存储过程跑着跑着 CPU 打满,靠 auto_explain 日志发现是某条 INSERT 语句走了 Nested Loop Left Join 导致死循环,关掉 enable_nestloop 才定位到问题。
3.4 找最耗时的 SQL
除了上面两个工具,直接查 sys_stat_statements_all 视图按 total_exec_time 排序,也能找出函数里最耗时的语句,配合 \timing on 看整体耗时。三层手段下来,基本没有藏得住的慢 SQL。
四、过程与语句:函数、存储过程、聚合、游标
4.1 程序结构与流程控制
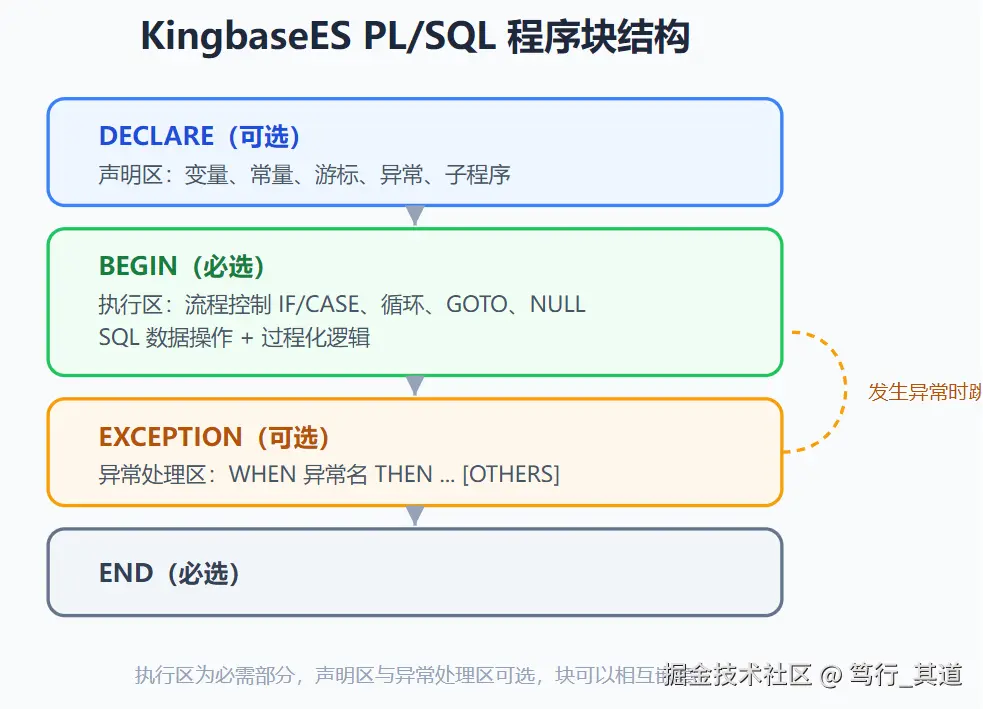
PL/SQL 源程序分执行部分(必选)和异常处理部分(可选)。执行部分的流程控制分两类:条件选择(IF / 简单 CASE / 搜索 CASE)和顺序控制(GOTO / NULL)。简单 CASE 在所有分支都不匹配又没写 ELSE 时会抛 CASE_NOT_FOUND,这个坑容易踩。
4.2 函数:事务、嵌套、三态
KingbaseES 的函数支持事务操作,带 COMMIT/ROLLBACK 的函数能用在赋值、条件、循环表达式里。两个进阶点值得单独说。
先讲自治事务。声明了 PRAGMA AUTONOMOUS_TRANSACTION 之后,函数内部事务就独立于主事务了:内部 rollback 不影响主事务的 DML,主事务提交与否也管不到它。
再讲嵌套函数。在匿名块、函数或存储过程的声明里定义子程序就行。嵌套函数能引用父程序的变量,反过来不行;也能重载(形参个数/类型不同即可),但参数只有 mode 不同、或只有返回值不同时不能重载。
函数三态这事值得单独说,它是优化器层面的东西。VOLATILE、STABLE、IMMUTABLE 三个级别,说白了就是告诉优化器这个函数有多「纯」。VOLATILE 最不纯,能改数据,同样参数可能返回不同结果,优化器拿它没办法,函数索引也建不了。STABLE 好一点,不能改数据,同样参数结果一致,优化器可以少调几次,也能用在索引扫描里,但函数索引还是建不了。只有 IMMUTABLE 最纯,结果恒定,优化器会直接把结果算出来替换成常量,也只有它能建函数索引。
所以一句话:函数稳定性设得越「稳」,优化器能做的文章越多。能标 STABLE 的别写成 VOLATILE,能标 IMMUTABLE 的别只写 STABLE。
4.3 函数与存储过程的调用区别
这个点小但实用。函数能用 select 或 call 调,存储过程只能用 call。拿 select 去调存储过程会直接报 is a procedure,提示你用 CALL。
4.4 RETURN 与结果集
函数返回数据有 5 种 RETURN 写法:RETURN(提前退出,函数类型须 void)、RETURN expression(退出并返回值)、RETURN NEXT expression(不退出,逐行追加,配 RETURNS SETOF)、RETURN QUERY query(把查询结果整个追加)、RETURN QUERY EXECUTE ... USING ...(动态 SQL 变体)。
返回结果集也有好几种路子,自定义类型加 PIPELINED、RETURNS TABLE、RETURNS SETOF,各有各的适用场景,看你要不要提前定义类型、要不要控制返回结构。
4.5 自定义聚合函数
Oracle 的自定义聚合函数靠 ODCIAggregate 接口,有初始化、迭代、合并、终止四个方法。KingbaseES 走的是 CREATE AGGREGATE 语法。核心子句几个:SFUNC 是每行迭代函数,STYPE 是状态值类型,FINALFUNC 是每组最终函数(可选),COMBINEFUNC 加 PARALLEL = SAFE 是并行聚合必须的。
并行这块的流程是:把每组数据切成多个小份,各自用 SFUNC 迭代,结果交给 COMBINEFUNC 合并,最后每组调一次 FINALFUNC。实测数据量大时并行能快一倍左右。
4.6 游标
游标在 PL/SQL 里跨事务有个坑:原生 plpgsql 的游标 COMMIT 后会被自动释放,而 kes-plsql 默认支持跨事务用。隐式游标靠 SQL%attribute 拿最近一条 SELECT/DML 的执行信息,一共四个属性:SQL%ISOPEN、SQL%FOUND、SQL%NOTFOUND、SQL%ROWCOUNT。注意 KingbaseES 里动态 SQL 的执行信息不会回填隐式游标属性,得用 GET DIAGNOSTICS ... ROW_COUNT 来取。
五、迁移兼容:从 Oracle 过来要留意的差异
最后补几个 Oracle 迁到 KingbaseES 容易踩的坑,都有解法:
- 语句级回滚:Oracle 默认语句级回滚(只回滚出错那条),KingbaseES 默认整个事务回滚。开
ora_statement_level_rollback = on后跟 Oracle 一致,但只有异常被正确捕获时才生效。 - 触发器:视图上的触发器带转换表、多事件触发器都会报错,得改成触发器函数。
- 对象类型:早期的
UNDER继承、treat转换、ORDER函数、OVERRIDING重载不支持,改造思路是把父类属性下移到子类、把 order 函数独立出来。 - 参数模式:Oracle 的
IN参数不能在过程体里重新赋值,KingbaseES 可以;OUT/IN OUT带默认值要开comp_v7_program_para_def;KingbaseES 还支持INOUT连写,Oracle 只认IN OUT。
总结
捋下来,KingbaseES 的 PL/SQL 在功能覆盖和 Oracle 兼容上都做得挺扎实。异常处理机制完整(预定义 + 自定义 + 传播 + 信息检索),数据类型层次清晰(标量 → 记录/集合/对象),调试工具体系成熟(profiler + pldbgapi + auto_explain 三件套),过程语句能力也丰富(函数、存储过程、嵌套、三态、聚合、游标全都有)。
学习路线的话,建议先把程序块结构和异常处理吃透,这是写任何 PL/SQL 的地基;再补数据类型的体系认知;然后掌握调试工具,遇到性能问题能自己定位;最后把函数、存储过程、聚合函数的进阶用法练熟。这套东西消化完,日常的 KingbaseES PL/SQL 开发基本就顺了。