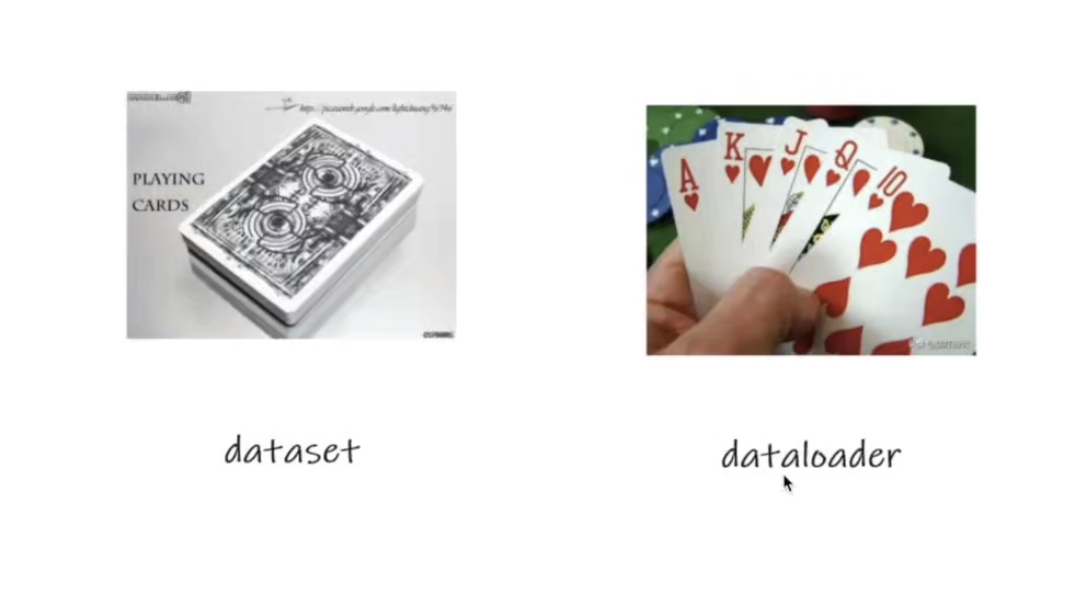
dataset vs dataloader
Dataset概念
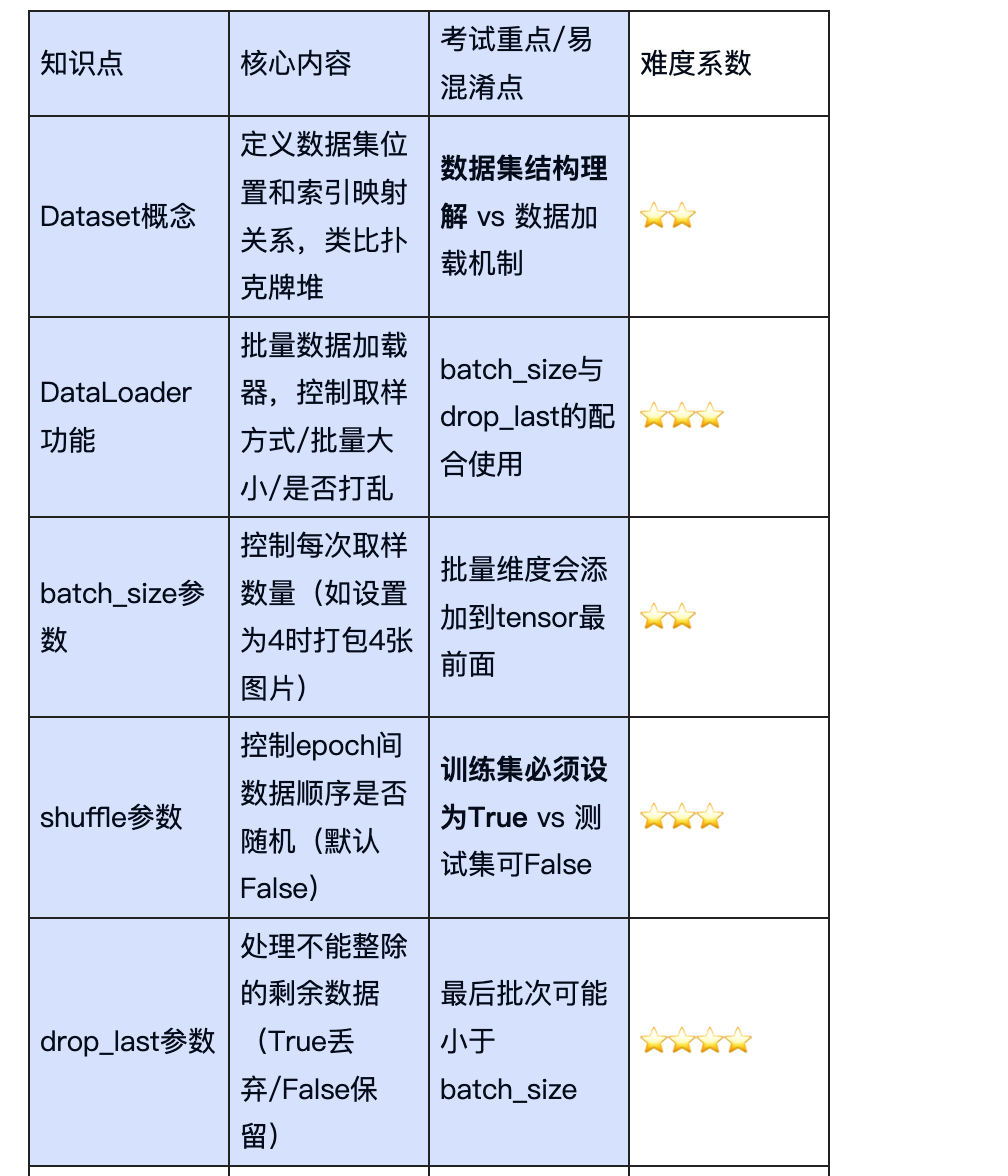
定义数据集位置和索引映射关系,类比扑克牌堆
一摞扑克牌是数据集,每张是我们的数据,
我们知道第一张牌长什么样。
DataLoader功能
是加载器,把我们的数据加载到一个神经网络当中。我们的手就可以当成一个神经网络。dataloader所做的事情就是每次从dataset中去取数据,每次取多少,怎么取,是由dataloader当中的参数进行设置的。比如我们可以控制每次从dataset当中取四张牌,或者我们取的过程中是用一只手去抓牌还是两只手去抓牌。
dataloader文档
dataloader是批量数据加载器,控制取样方式/批量大小/是否打乱。
我们在pytorch官网,搜索dataloader即可查看torch.utils.data.DataLoader的文档。
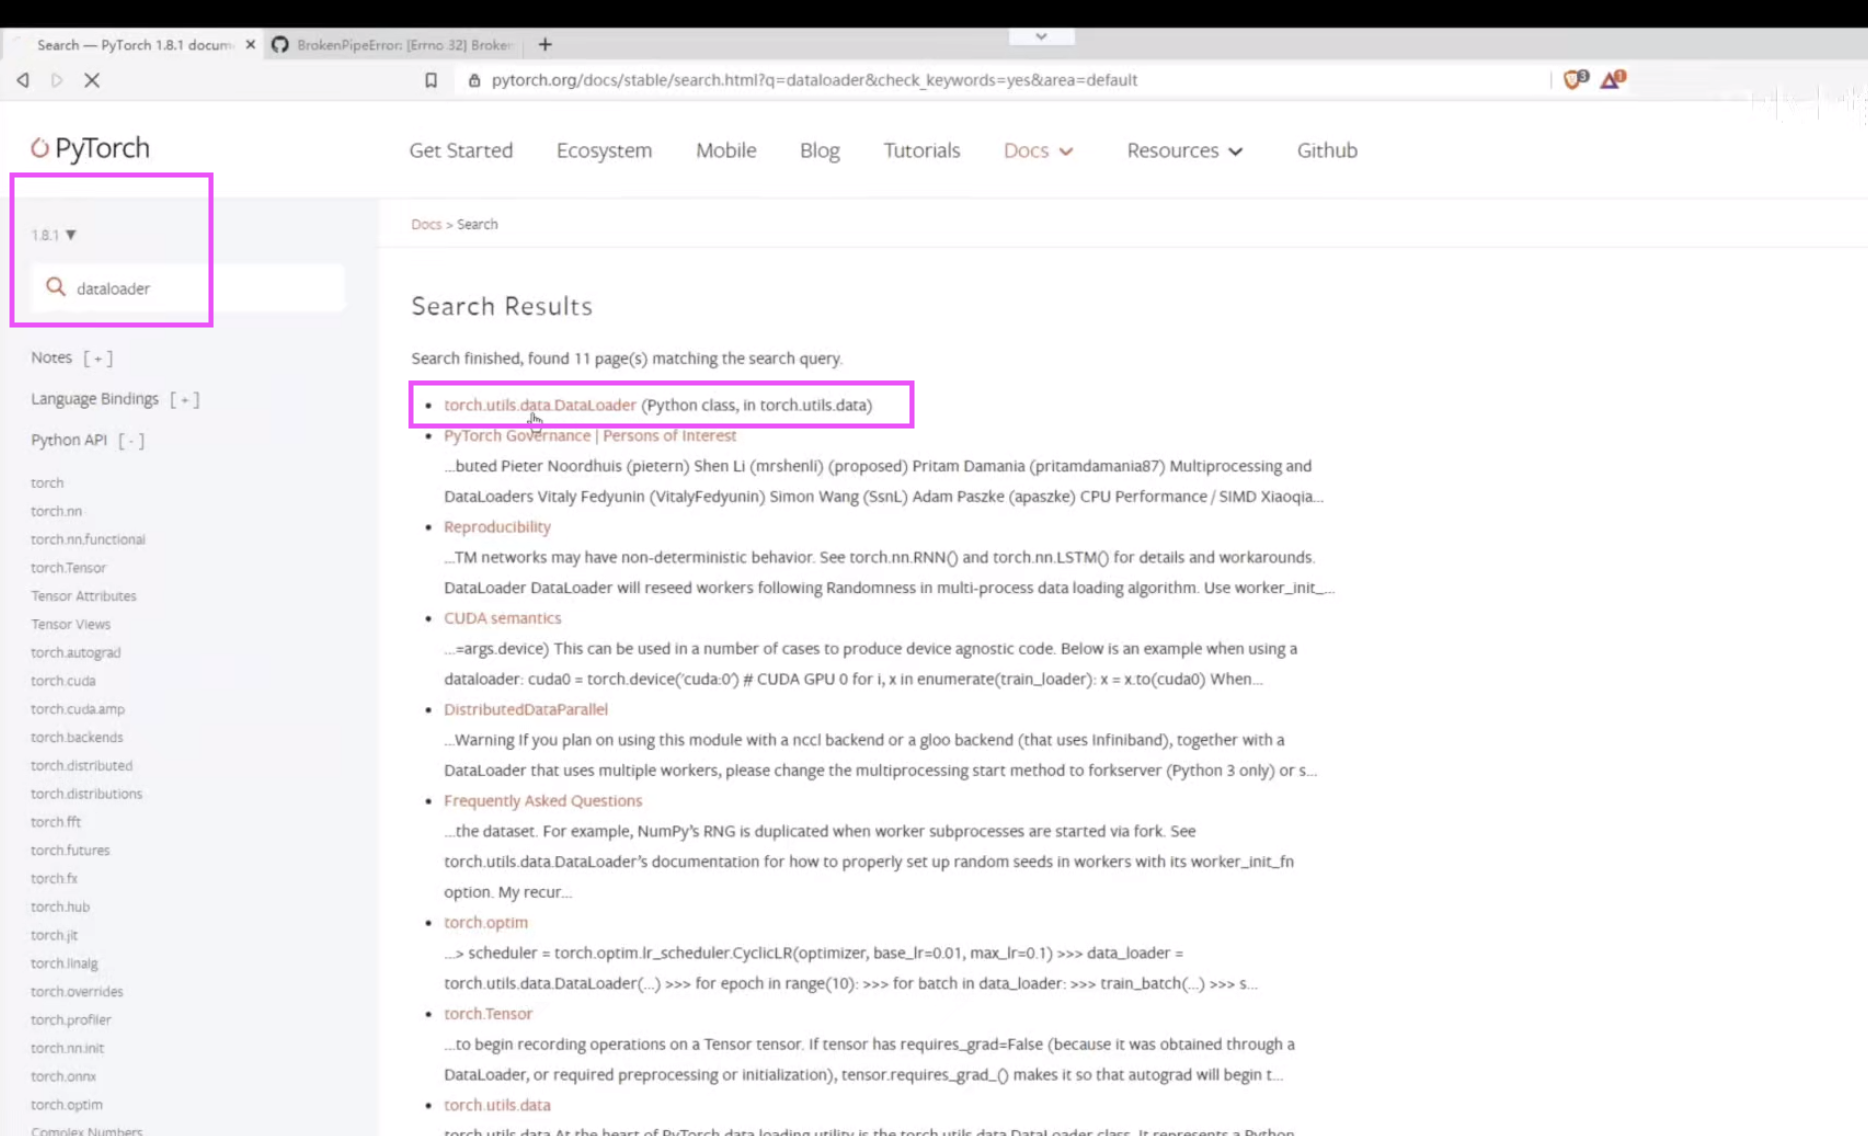
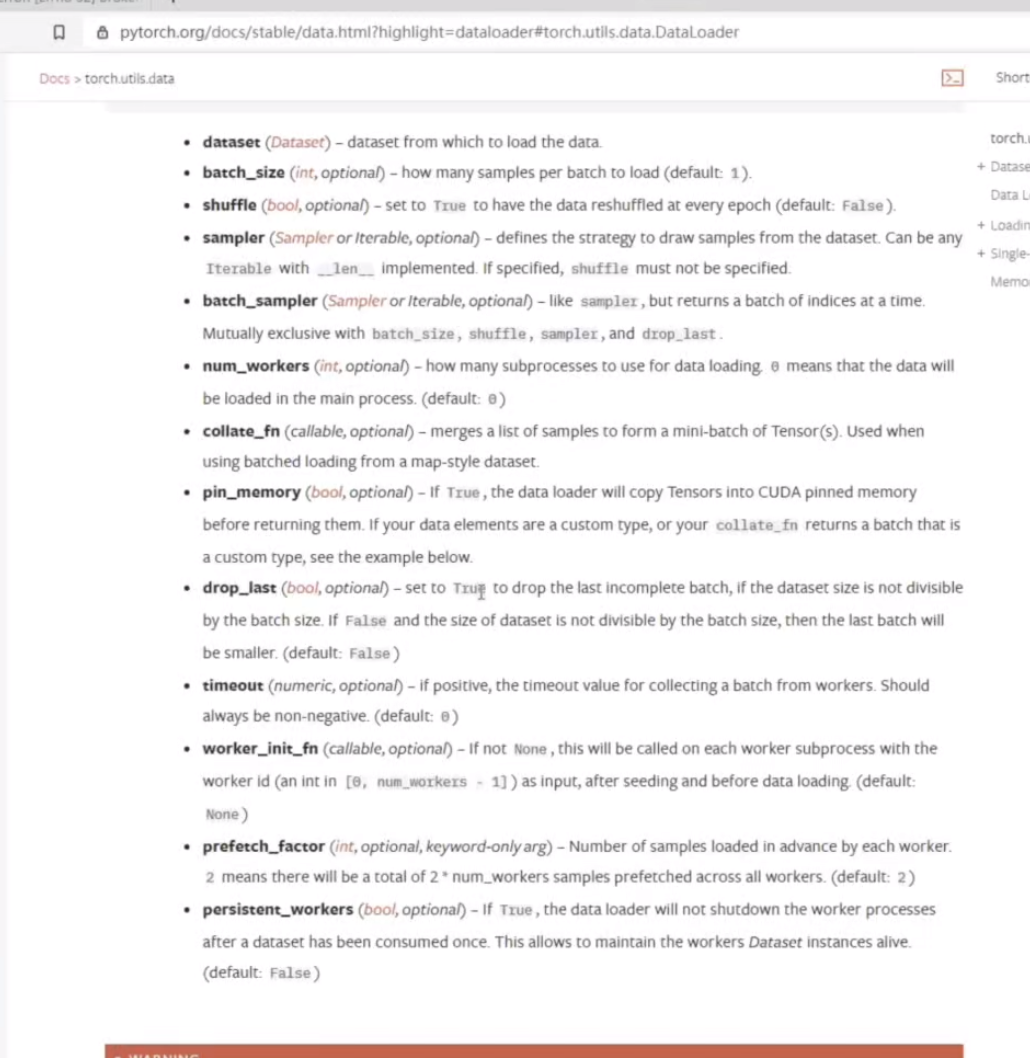
核心参数:
dataset: 必需参数,指定自定义数据集
功能:定义数据集位置、数据索引方式、数据总量
其他参数: 大多有默认值,实际使用只需设置少量参数
典型用法
python
data_loader = torch.utils.data.DataLoader(dataset)
for epoch in range(10):
    for batch in data_loader:
        train_batch()
参数介绍
batch_size
定义:表示每次从数据集中加载的样本数量
功能:控制每次迭代返回的数据量大小
示例:当batch_size=2时,每次会从数据集中抓取2个样本
默认值:默认为1,即每次加载单个样本
shuffle
定义:控制是否在每个epoch开始时打乱数据顺序
功能:
True:每次epoch数据顺序不同(类似洗牌效果)
False:保持数据原始顺序
默认值:默认为False
实际应用:通常建议设置为True以获得更好的训练效果
类比:类似打牌时的洗牌过程,True表示每局牌的顺序都不同
num_workers
定义:控制数据加载使用的子进程数量
功能:值为0表示在主进程加载数据(默认)
注意事项:
在Windows系统下可能出现问题(BrokenPipeError)
遇到错误时可尝试设置为0来解决
默认值:默认为0
性能影响:数值越大通常加载速度越快,但需考虑系统兼容性
drop_last
功能:控制当数据集大小不能被batch_size整除时,是否舍弃最后不完整的批次
取值:
True:舍弃最后不足一个batch的数据
False(默认):保留最后不完整的batch
示例:100张图片,batch_size=3时,100÷3=33余1
drop_last=True:只取前99张(33个完整batch)
drop_last=False:取全部100张(33个完整batch+1个不完整batch)
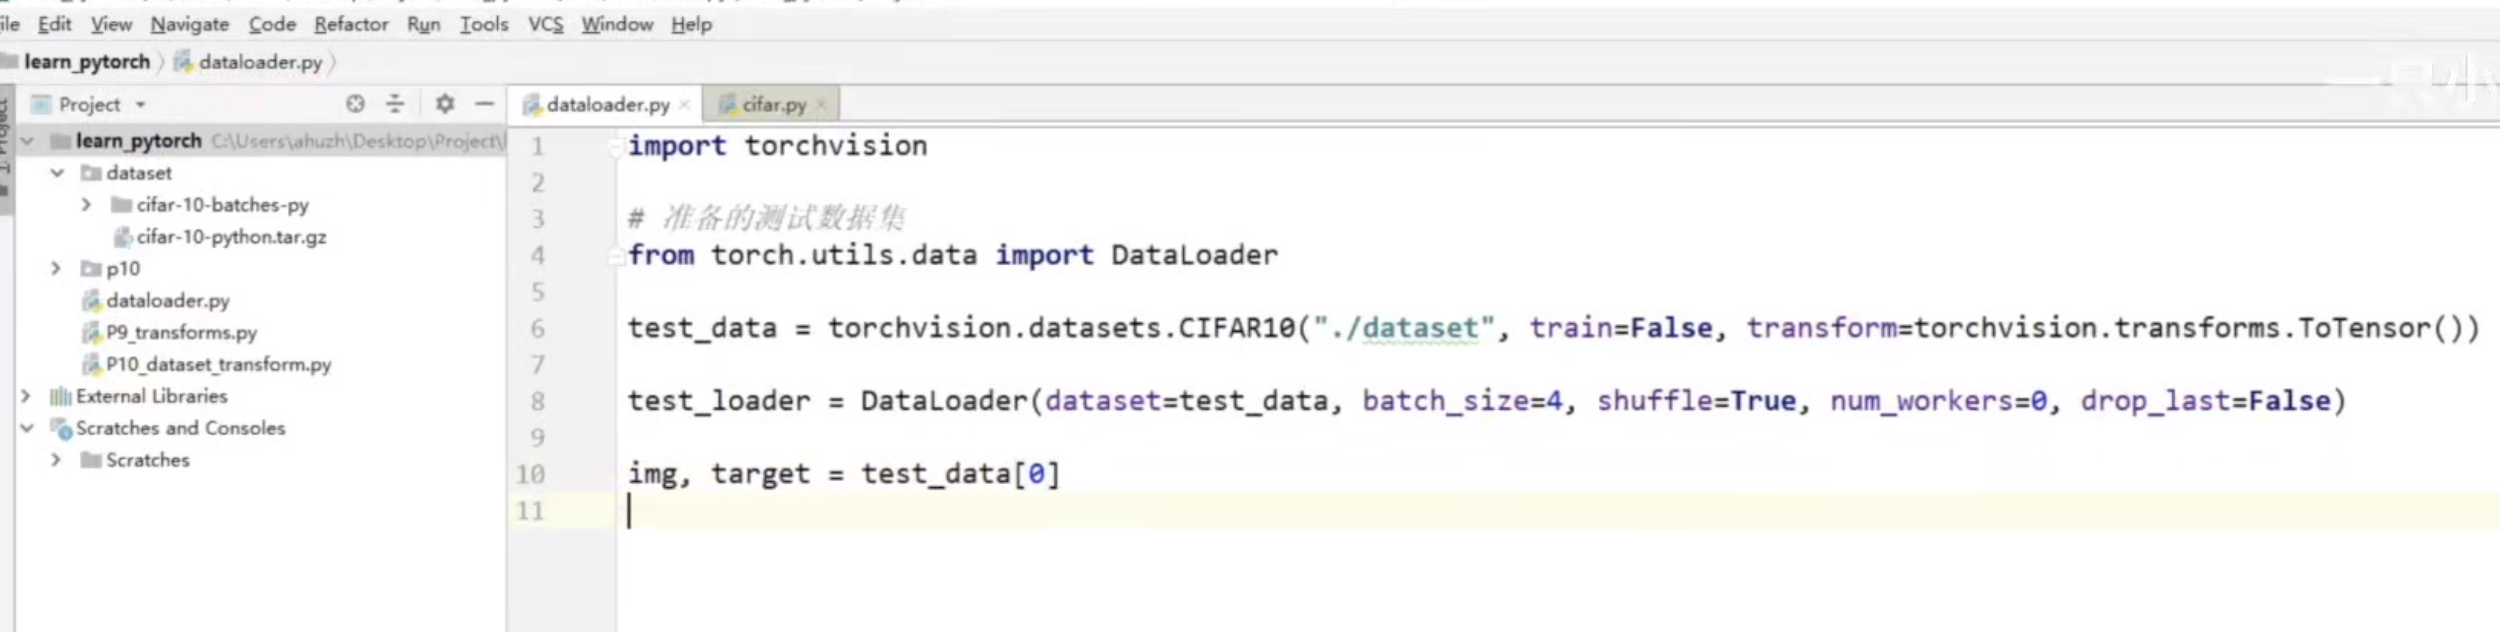
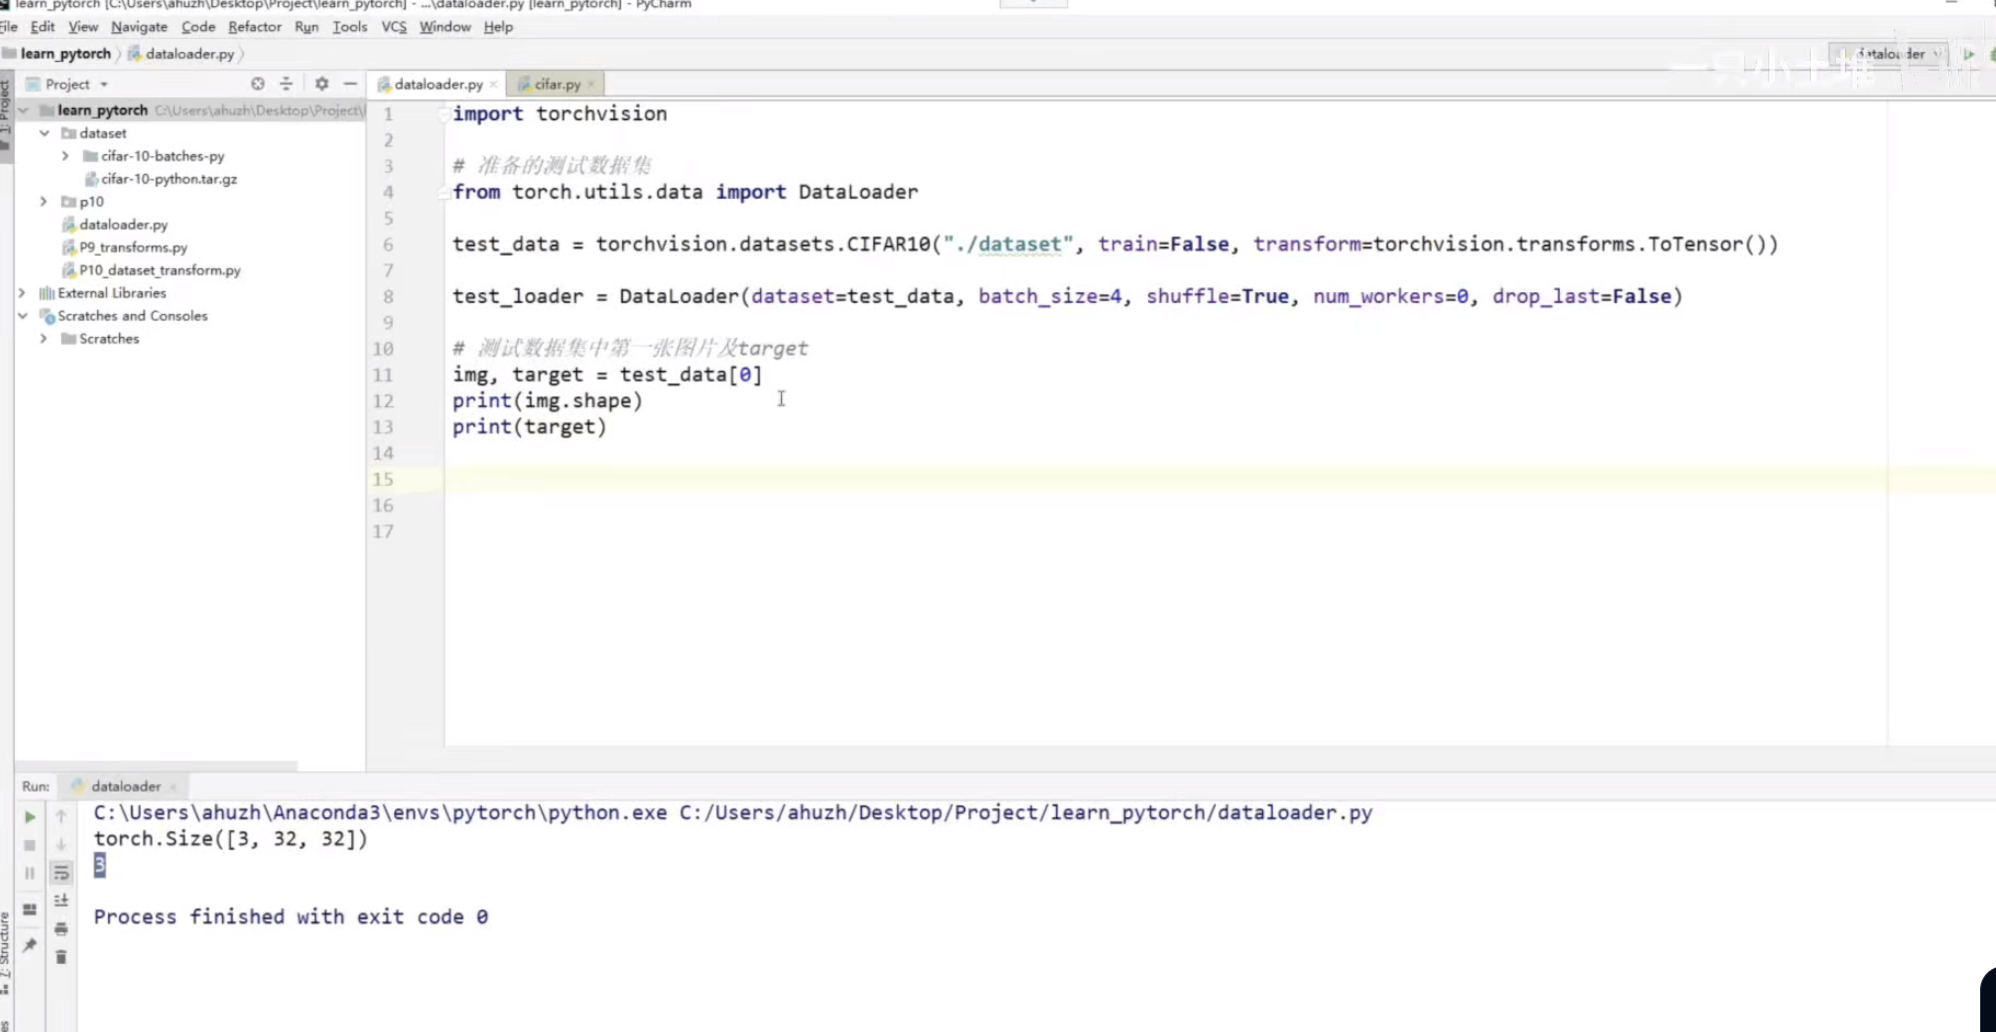
注意:如何查看test_data返回的数据格式,我们按住command键+鼠标点击在CIRAR10上,查看其getItem定义的返回格式。
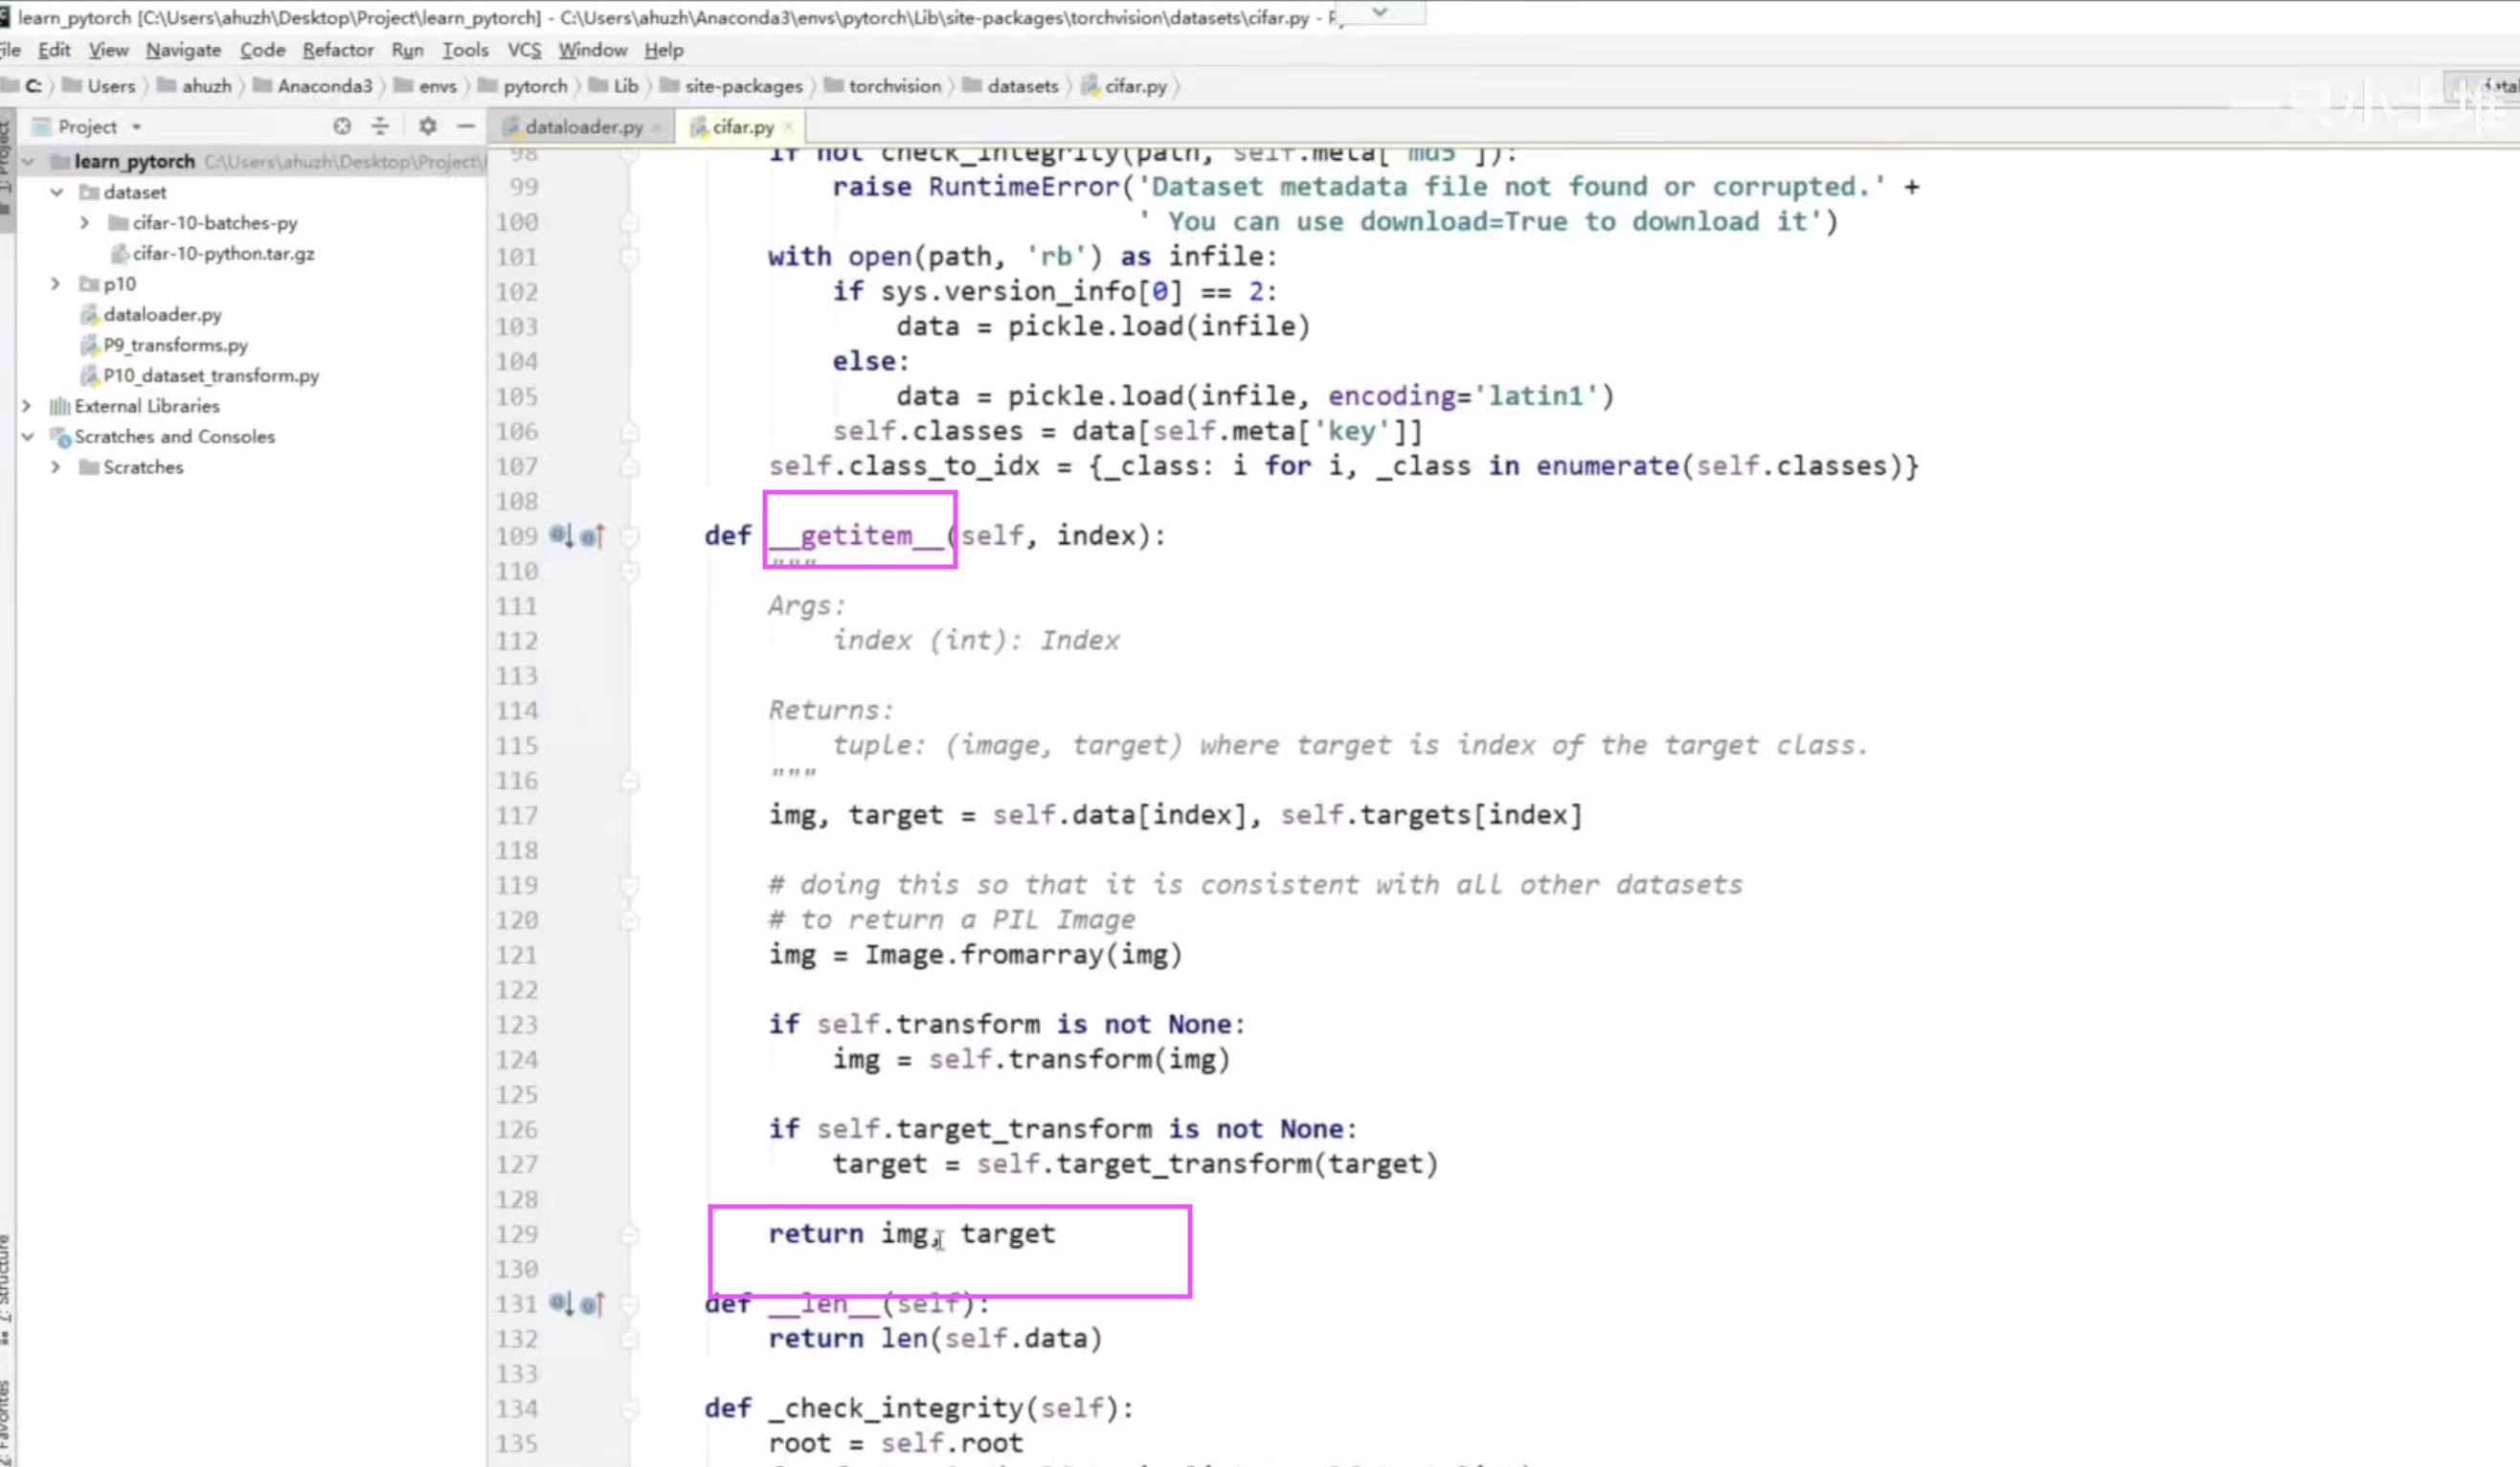
我们可以看到返回的 是一个元祖,有img和target.
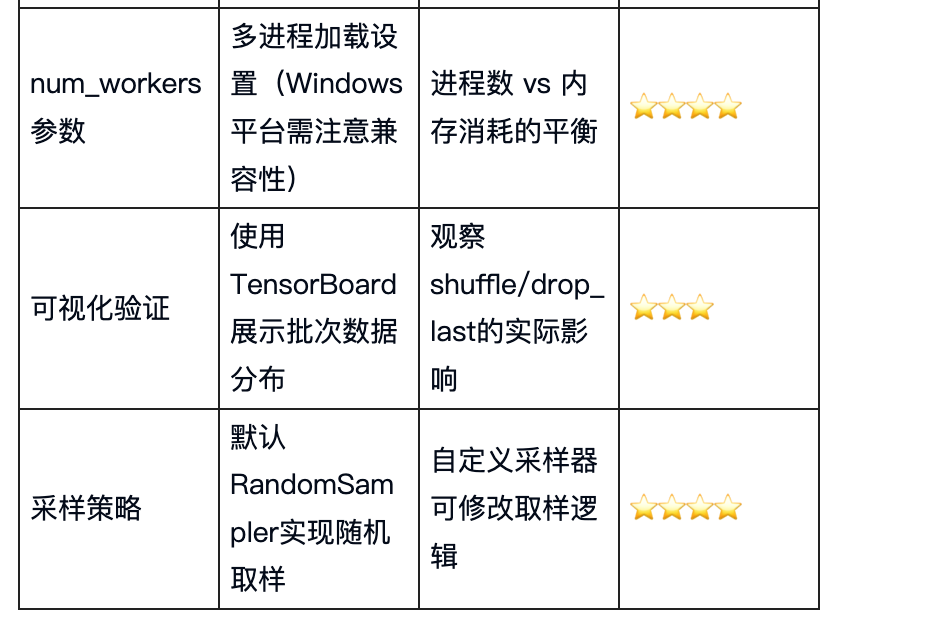
batchsize为4,那么dataloader会将4个样本的img打包成imgs,target打包成targets.
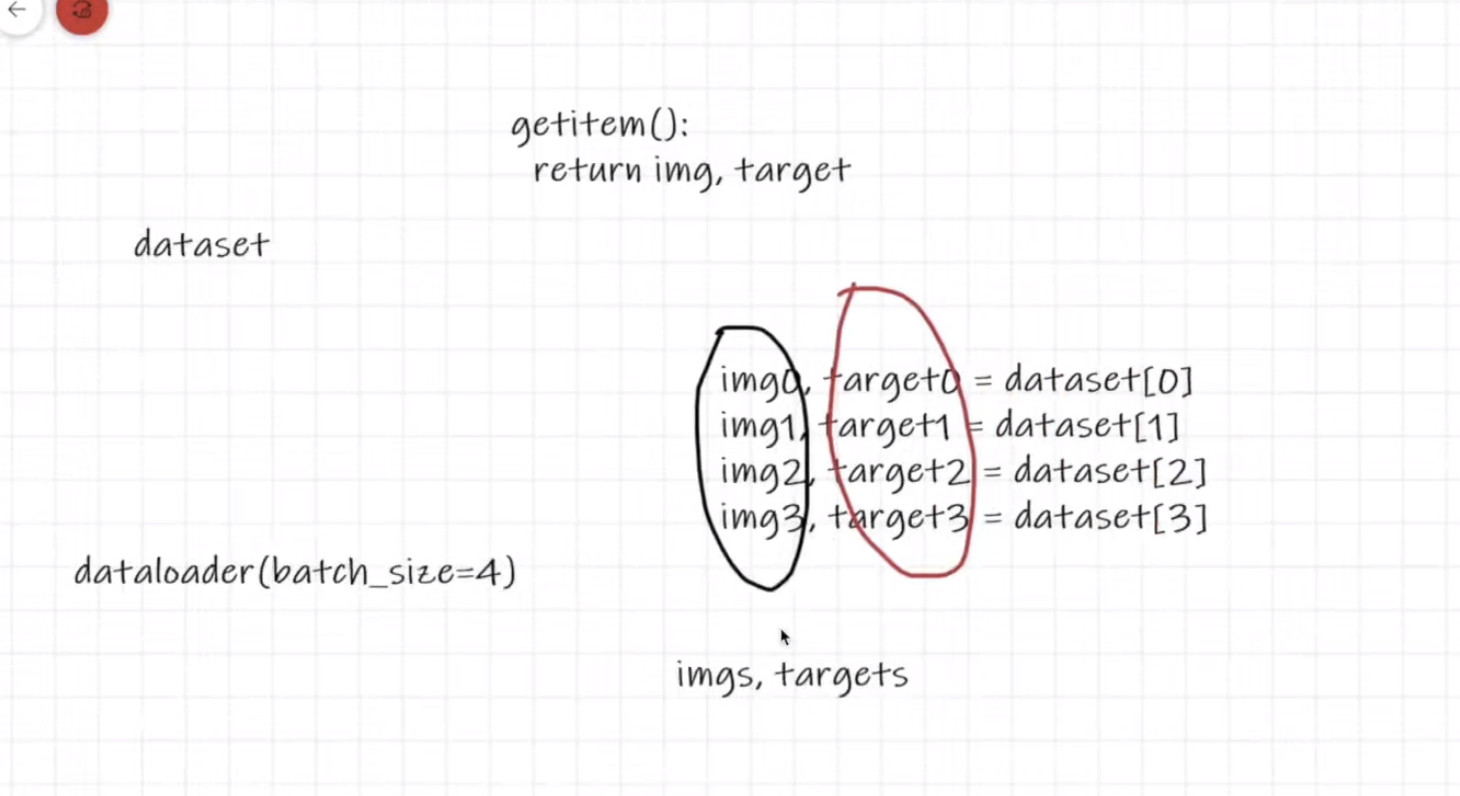
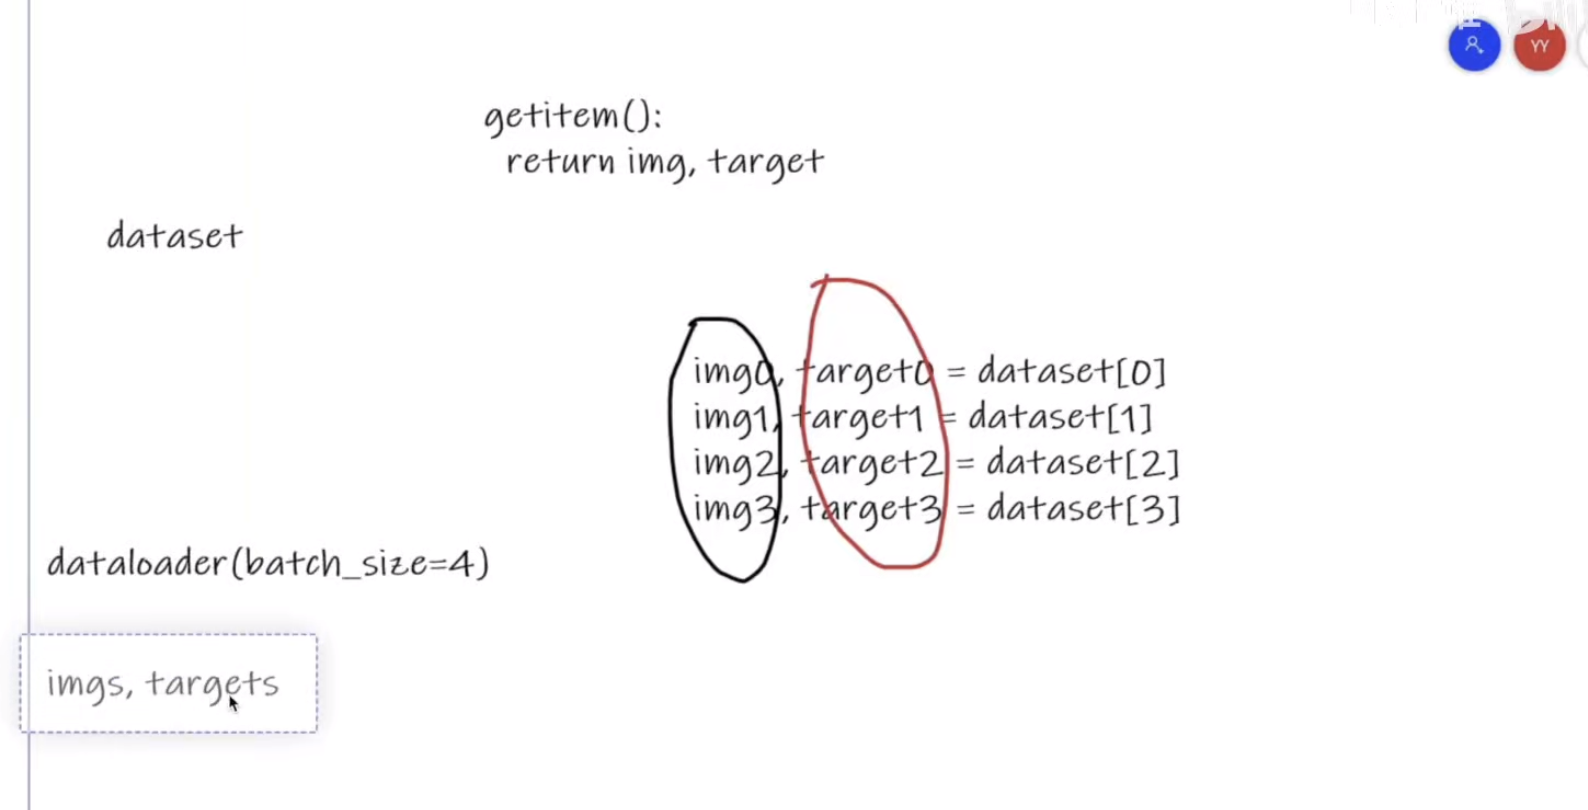
如下,遍历test_loader时,是每四个样本图片进行打包输出的。
torch.Size(3,32,32). 3是3个通道,32和32是图片尺寸3232,这个是只有1张图片。
torch.Size(4,3,32,32) 4是4张图片的意思。3是3个通道。32和32是图片尺寸为32 32的含义。
tensor(2,3,6,8)是这四张图片,每张图片的target值。
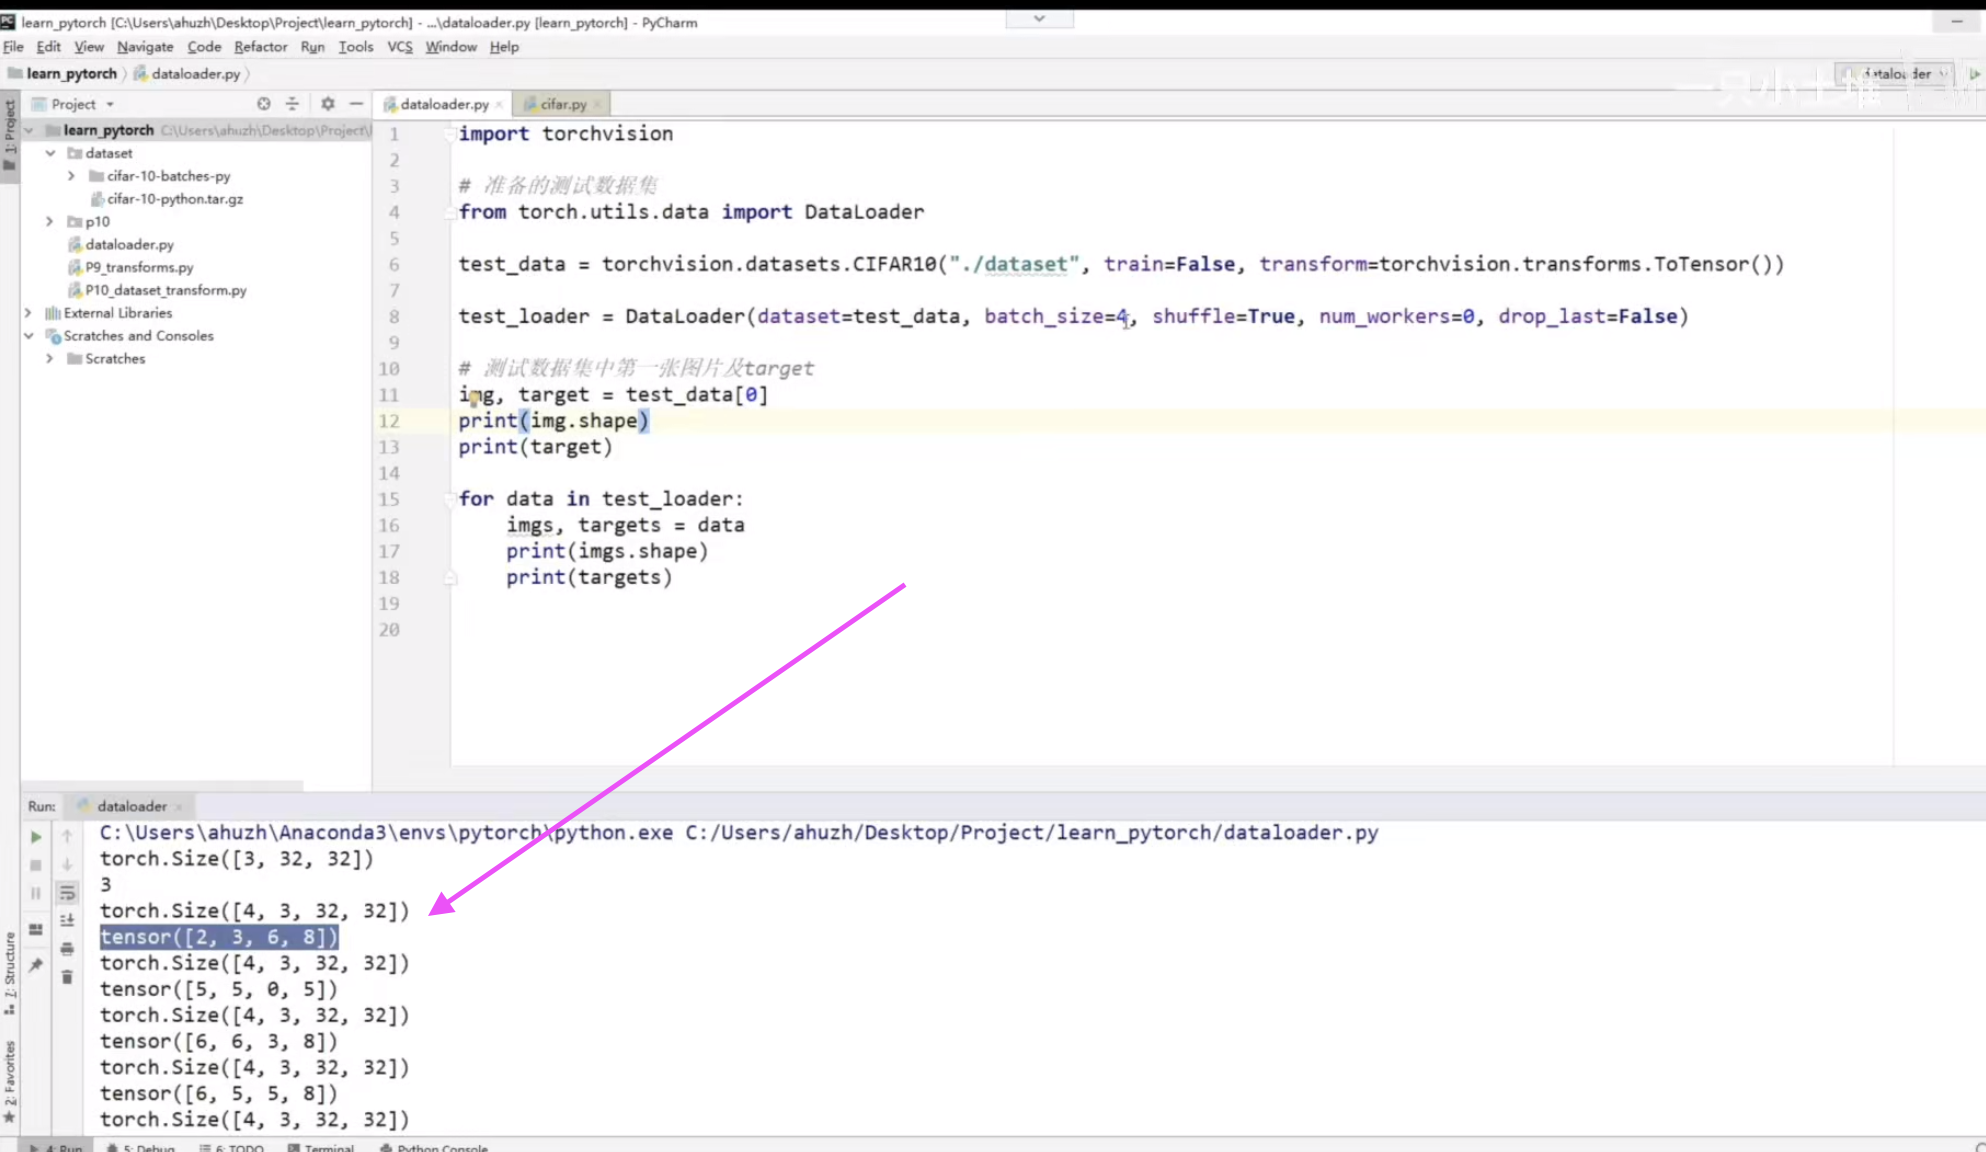
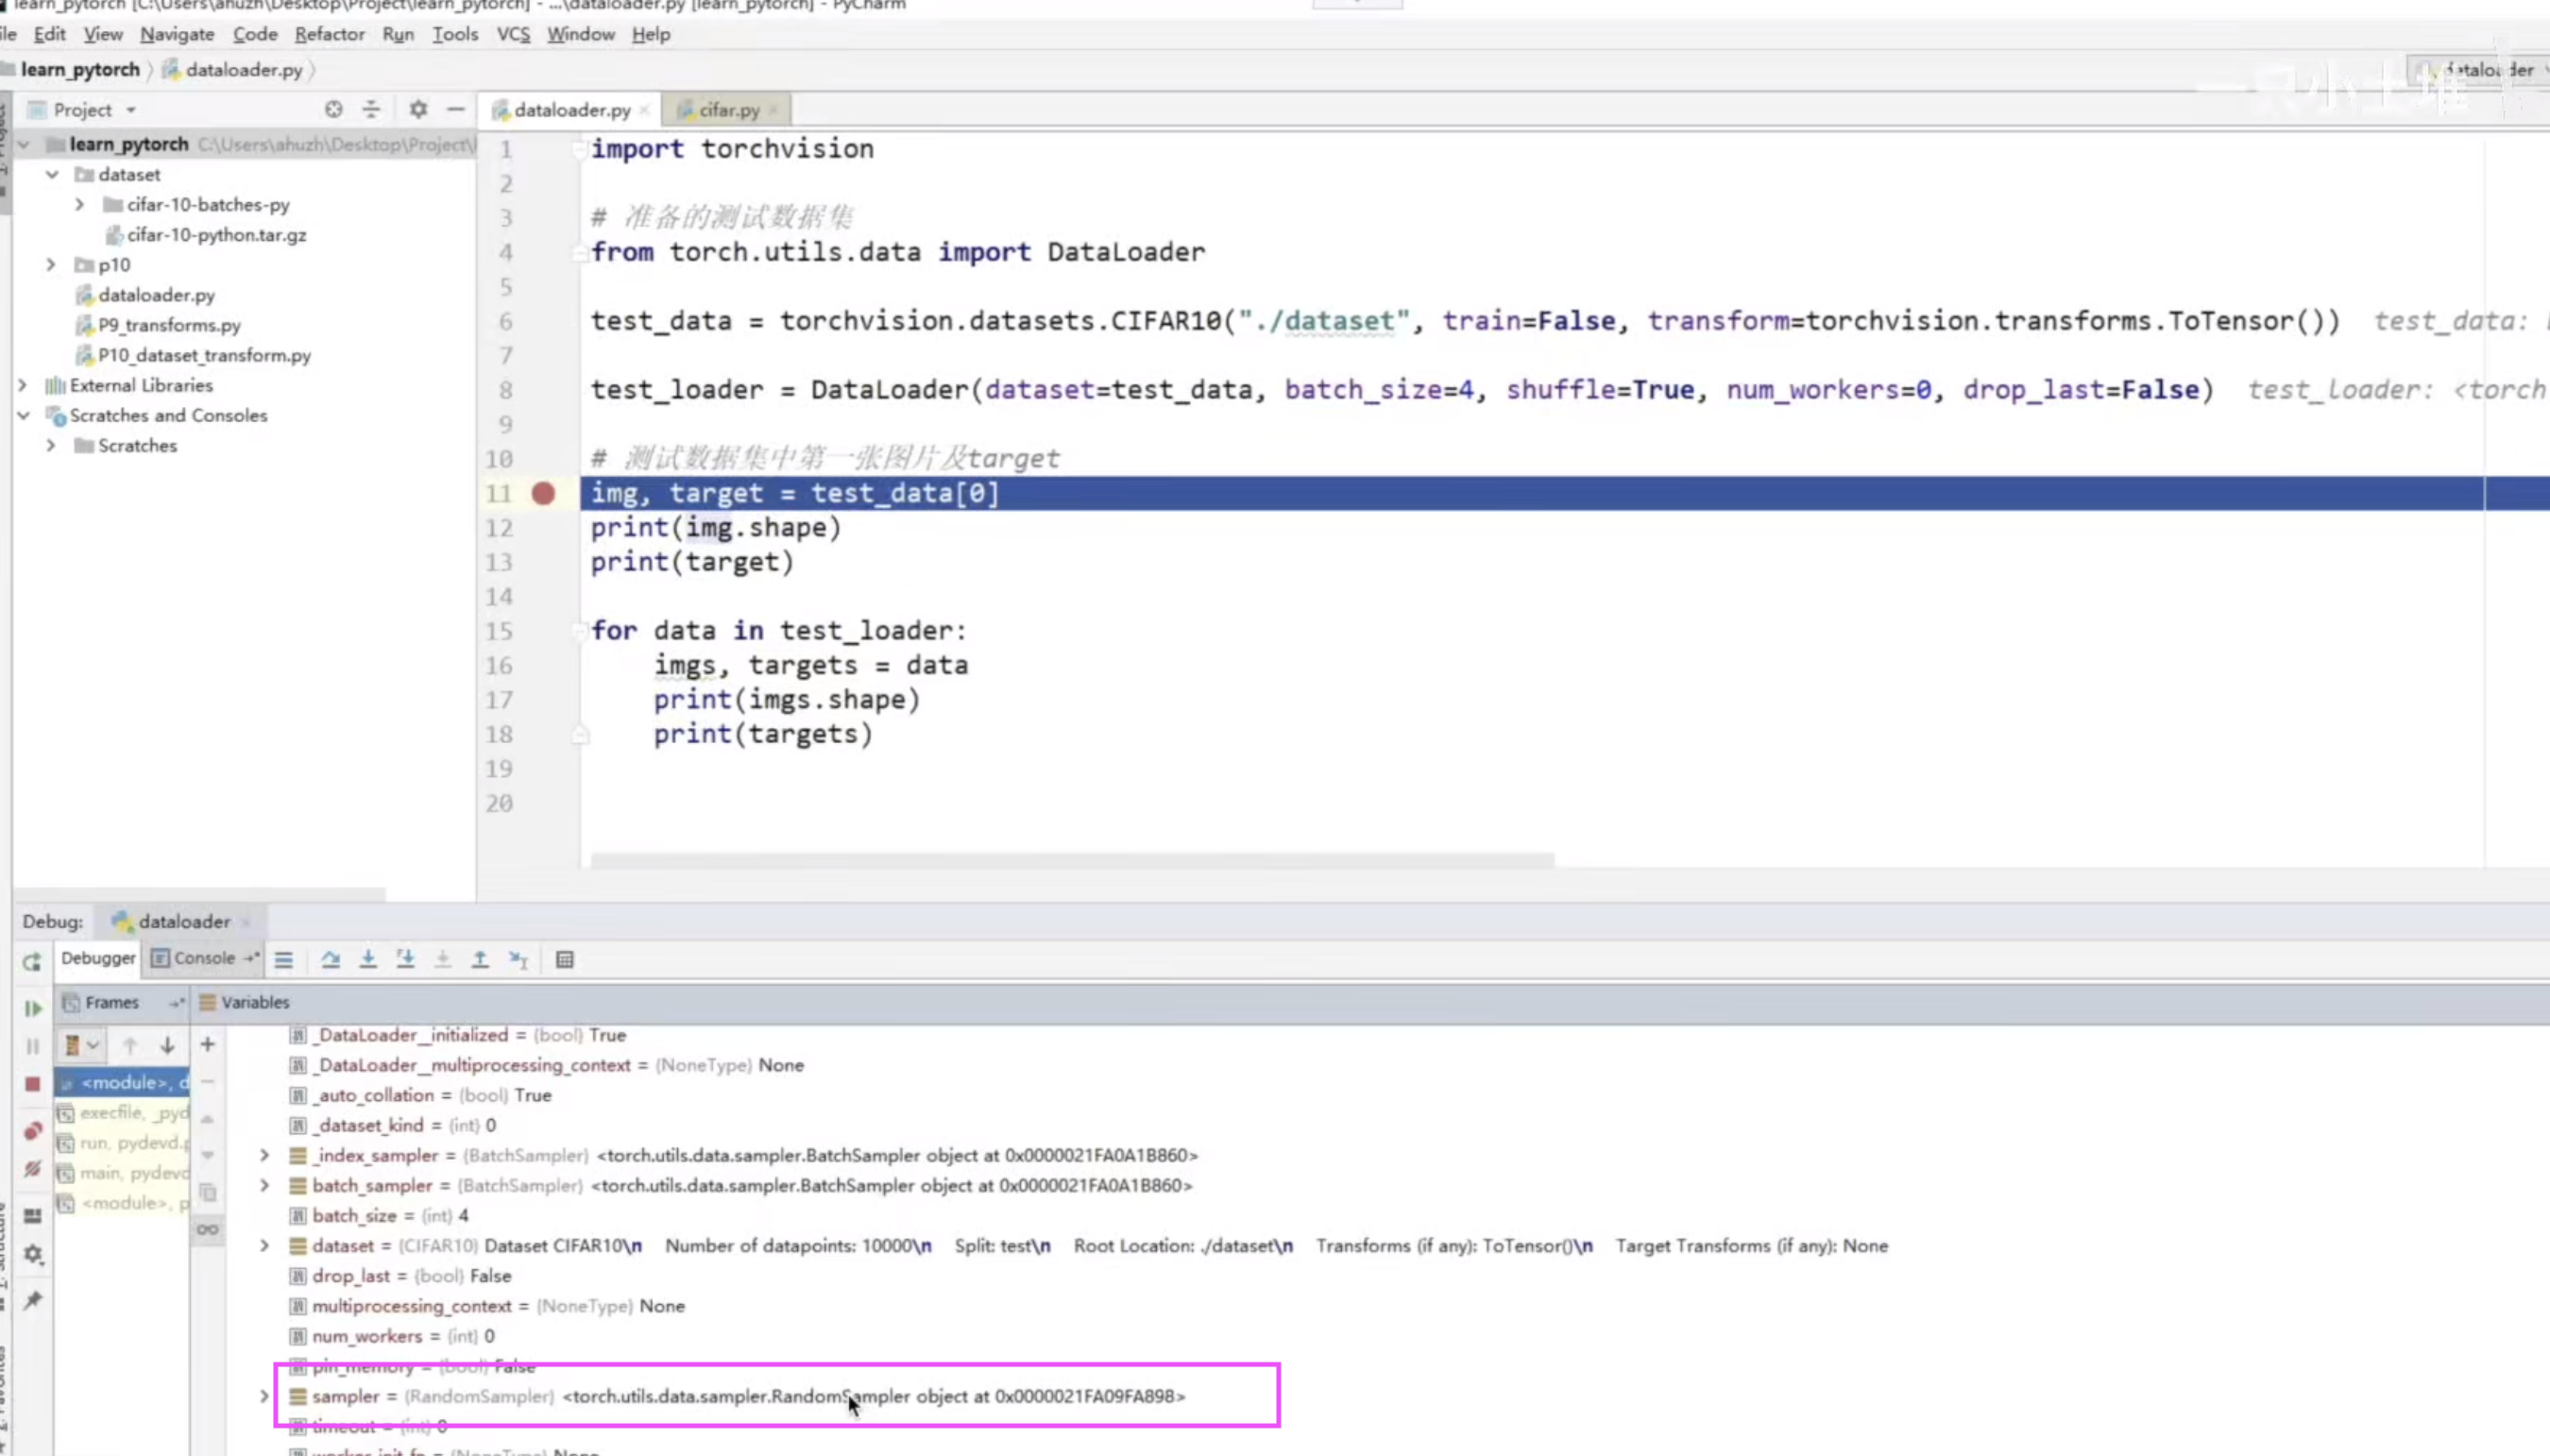
如下,我们可以看到test_loader中有采样器sample,randomsampler代表随机采样,也就是每次都是随机采样4个样本
执行如下代码,然后在终端输入 tensorboard --logdir='src/dataloader'
python
import torchvision

# 准备的测试数据集
from torch.utils.data import DataLoader
from torch.utils.tensorboard import SummaryWriter

test_data = torchvision.datasets.CIFAR10("./dataset", train=False, transform=torchvision.transforms.ToTensor())

test_loader = DataLoader(dataset=test_data, batch_size=64, shuffle=True, num_workers=0, drop_last=True)

# 测试数据集中第一张图片及target
img, target = test_data[0]
print(img.shape)
print(target)

writer = SummaryWriter("dataloader")
for epoch in range(2):
    step = 0
    for data in test_loader:
        imgs, targets = data
        # print(imgs.shape)
        # print(targets)
        writer.add_images("Epoch: {}".format(epoch), imgs, step)
        step = step + 1

writer.close()
我们可以在tensorboard查看结果,发现图片被每8*8=64张作为一批放置在各个step中。
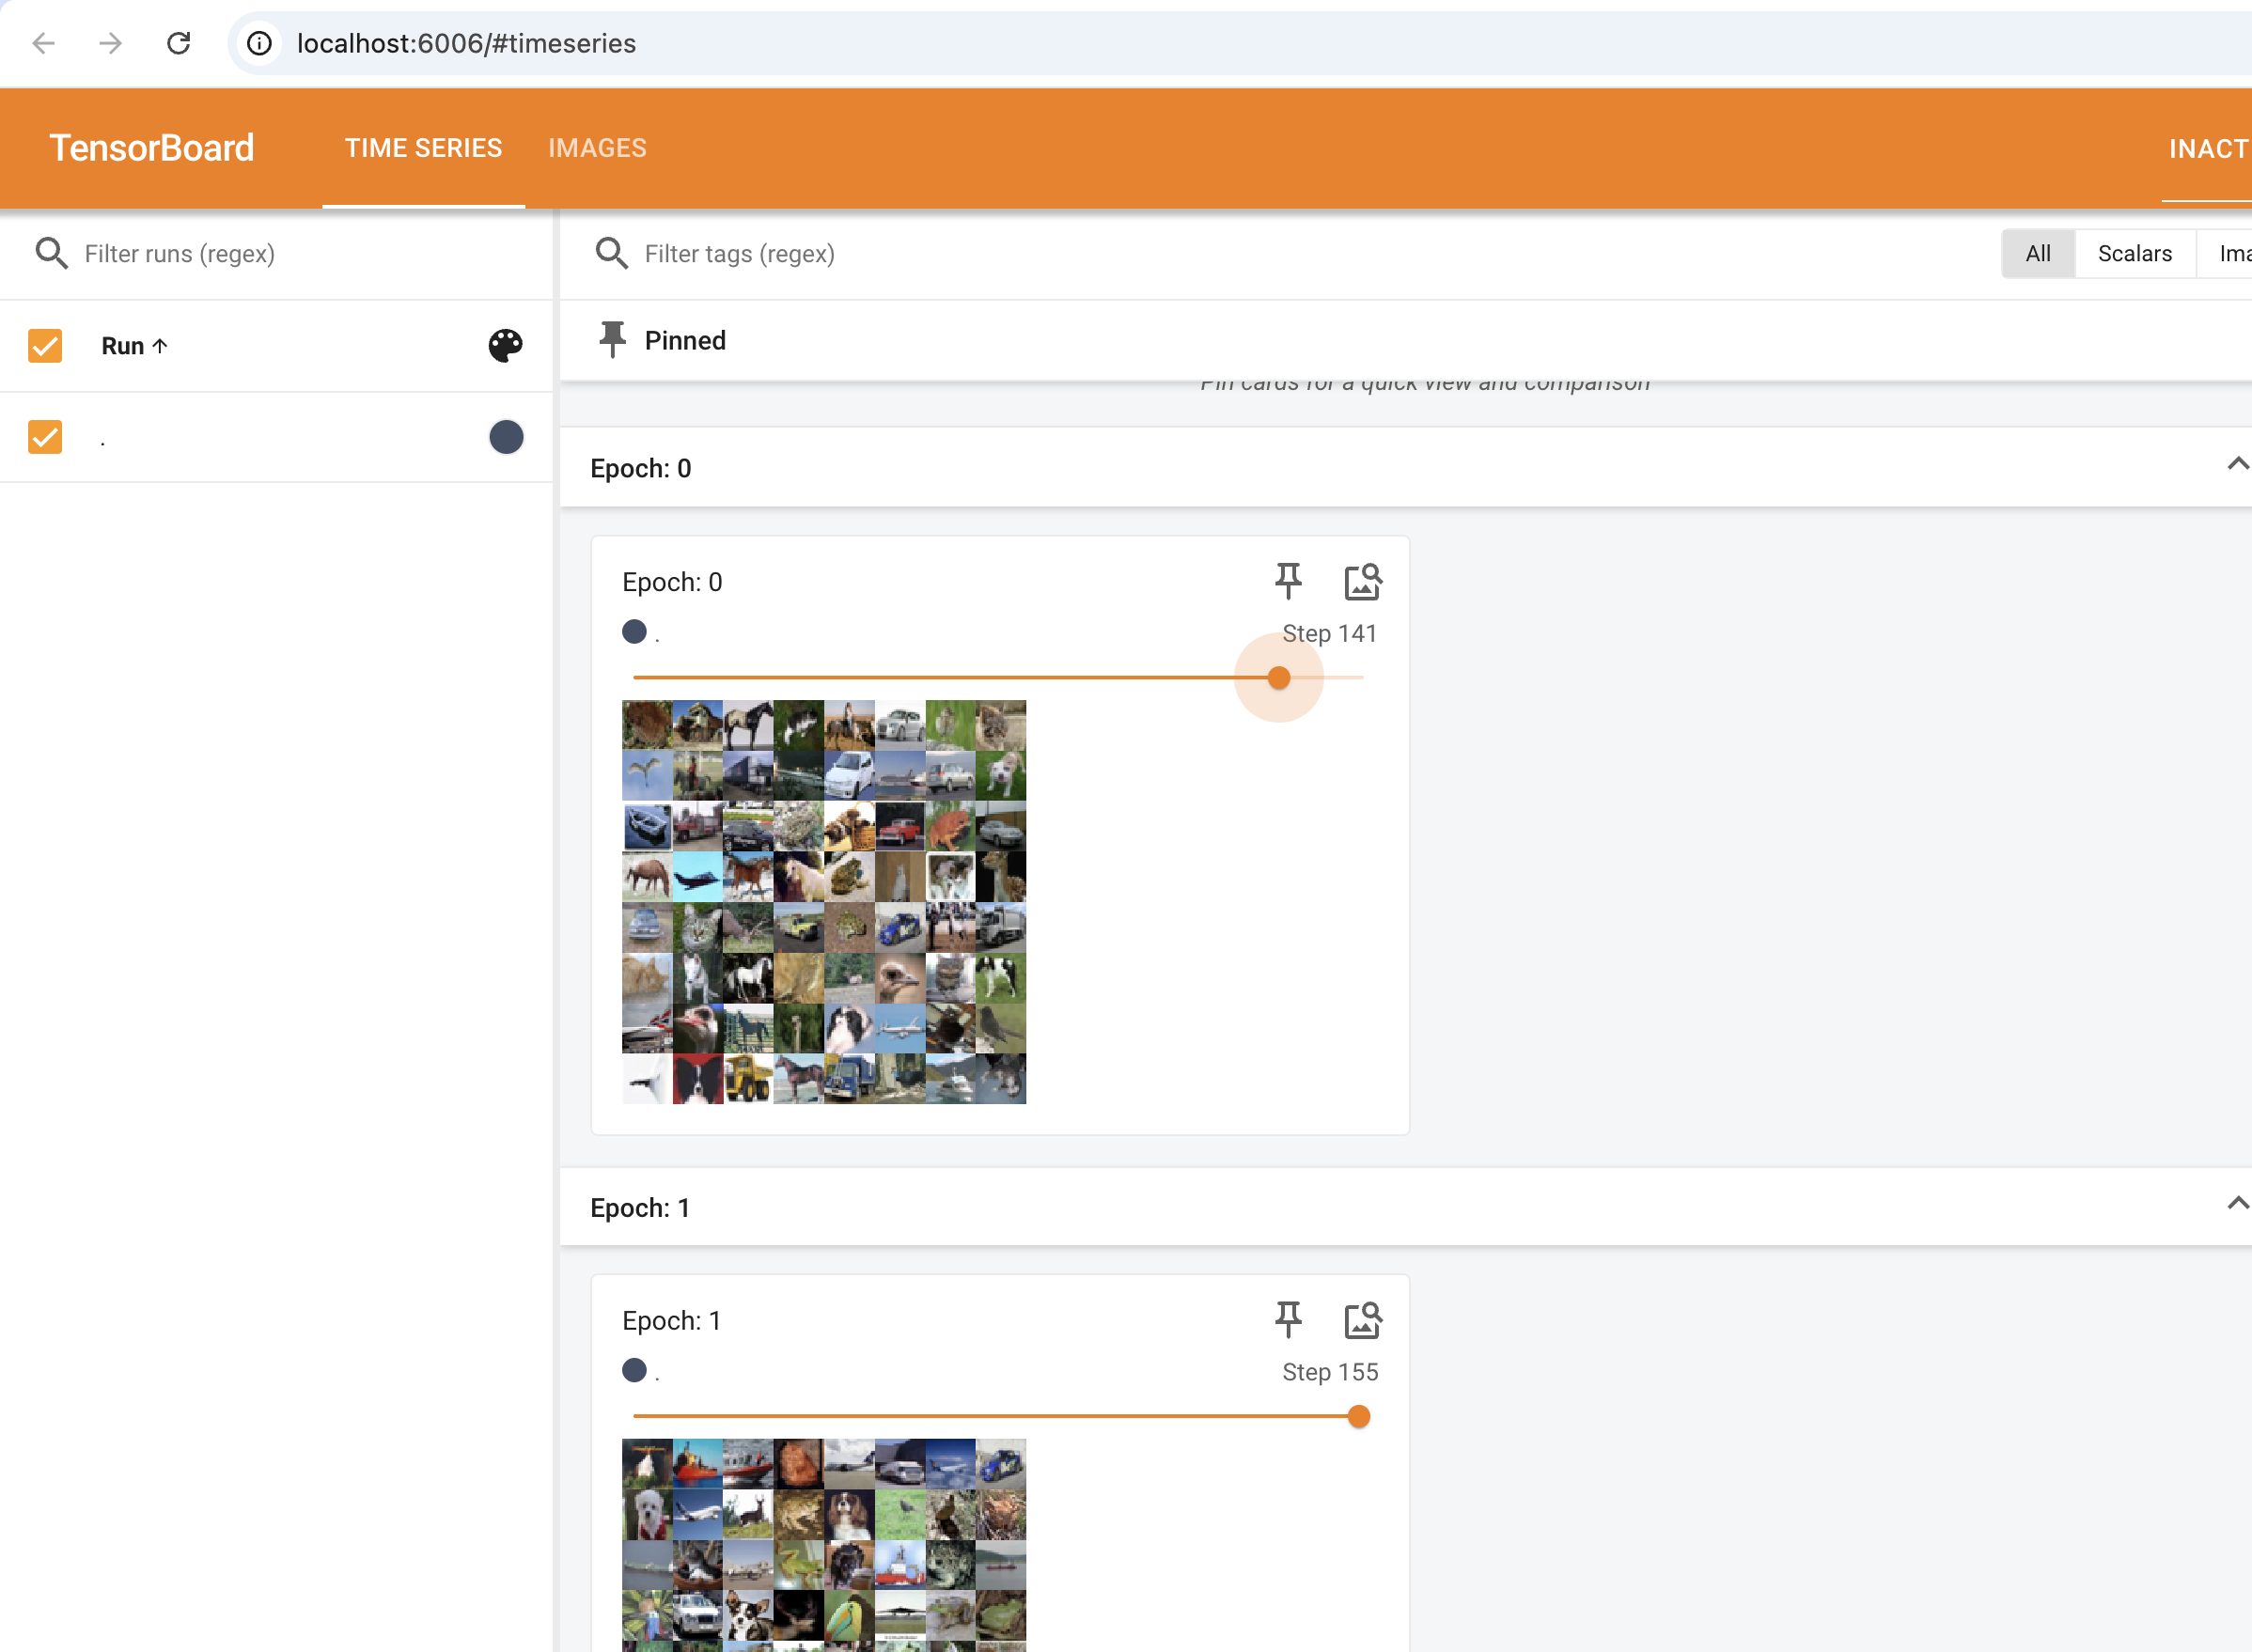
drop_last = True
python
import torchvision

# 准备的测试数据集
from torch.utils.data import DataLoader
from torch.utils.tensorboard import SummaryWriter

test_data = torchvision.datasets.CIFAR10("./dataset", train=False, transform=torchvision.transforms.ToTensor())

test_loader = DataLoader(dataset=test_data, batch_size=64, shuffle=True, num_workers=0, drop_last=False)

# 测试数据集中第一张图片及target
img, target = test_data[0]
print(img.shape)
print(target)

writer = SummaryWriter("dataloader")
for epoch in range(2):
    step = 0
    for data in test_loader:
        imgs, targets = data
        # print(imgs.shape)
        # print(targets)
        writer.add_images("Epoch: {}".format(epoch), imgs, step)
        step = step + 1

writer.close()
执行如下代码,然后在终端输入 tensorboard --logdir='src/dataloader'
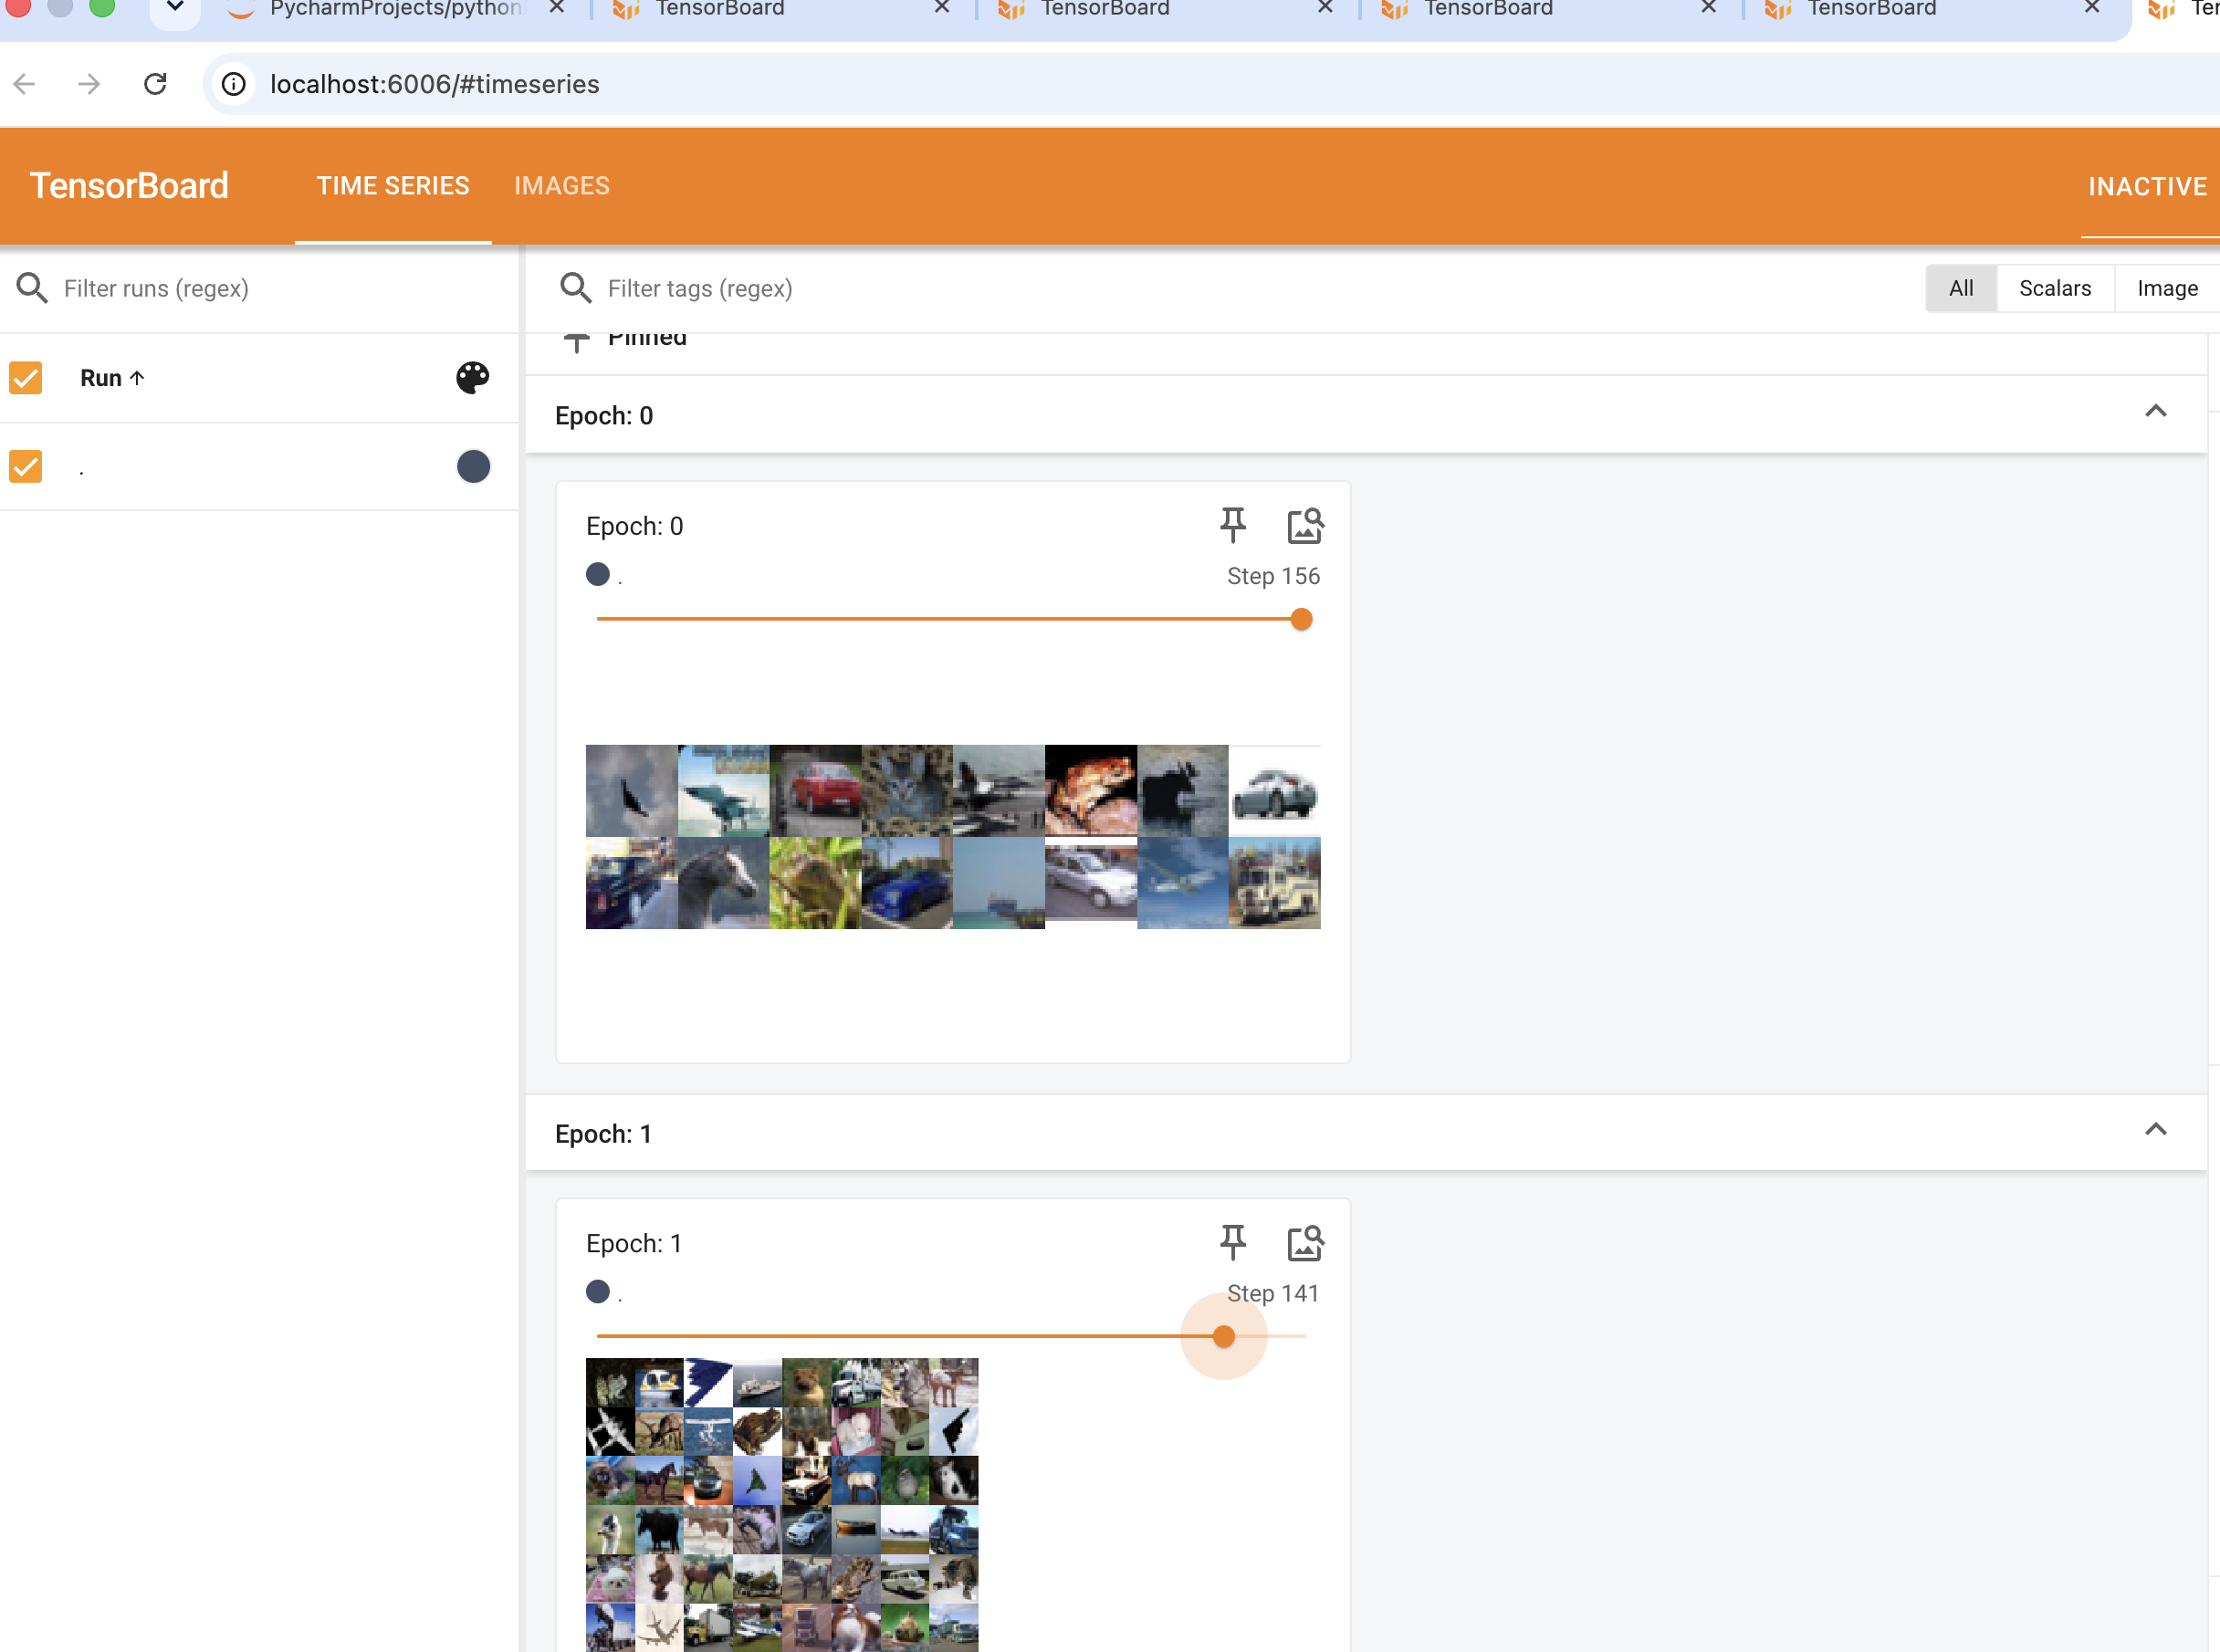
可以看到最后一个step下,不是8*8=64张图片了。
drop_last=False:保留最后不完整的batch
shuffle
shuffle参数作用:
功能:控制不同epoch间数据顺序是否变化
取值:
True:每轮epoch重新打乱数据顺序(推荐)
False:保持相同顺序
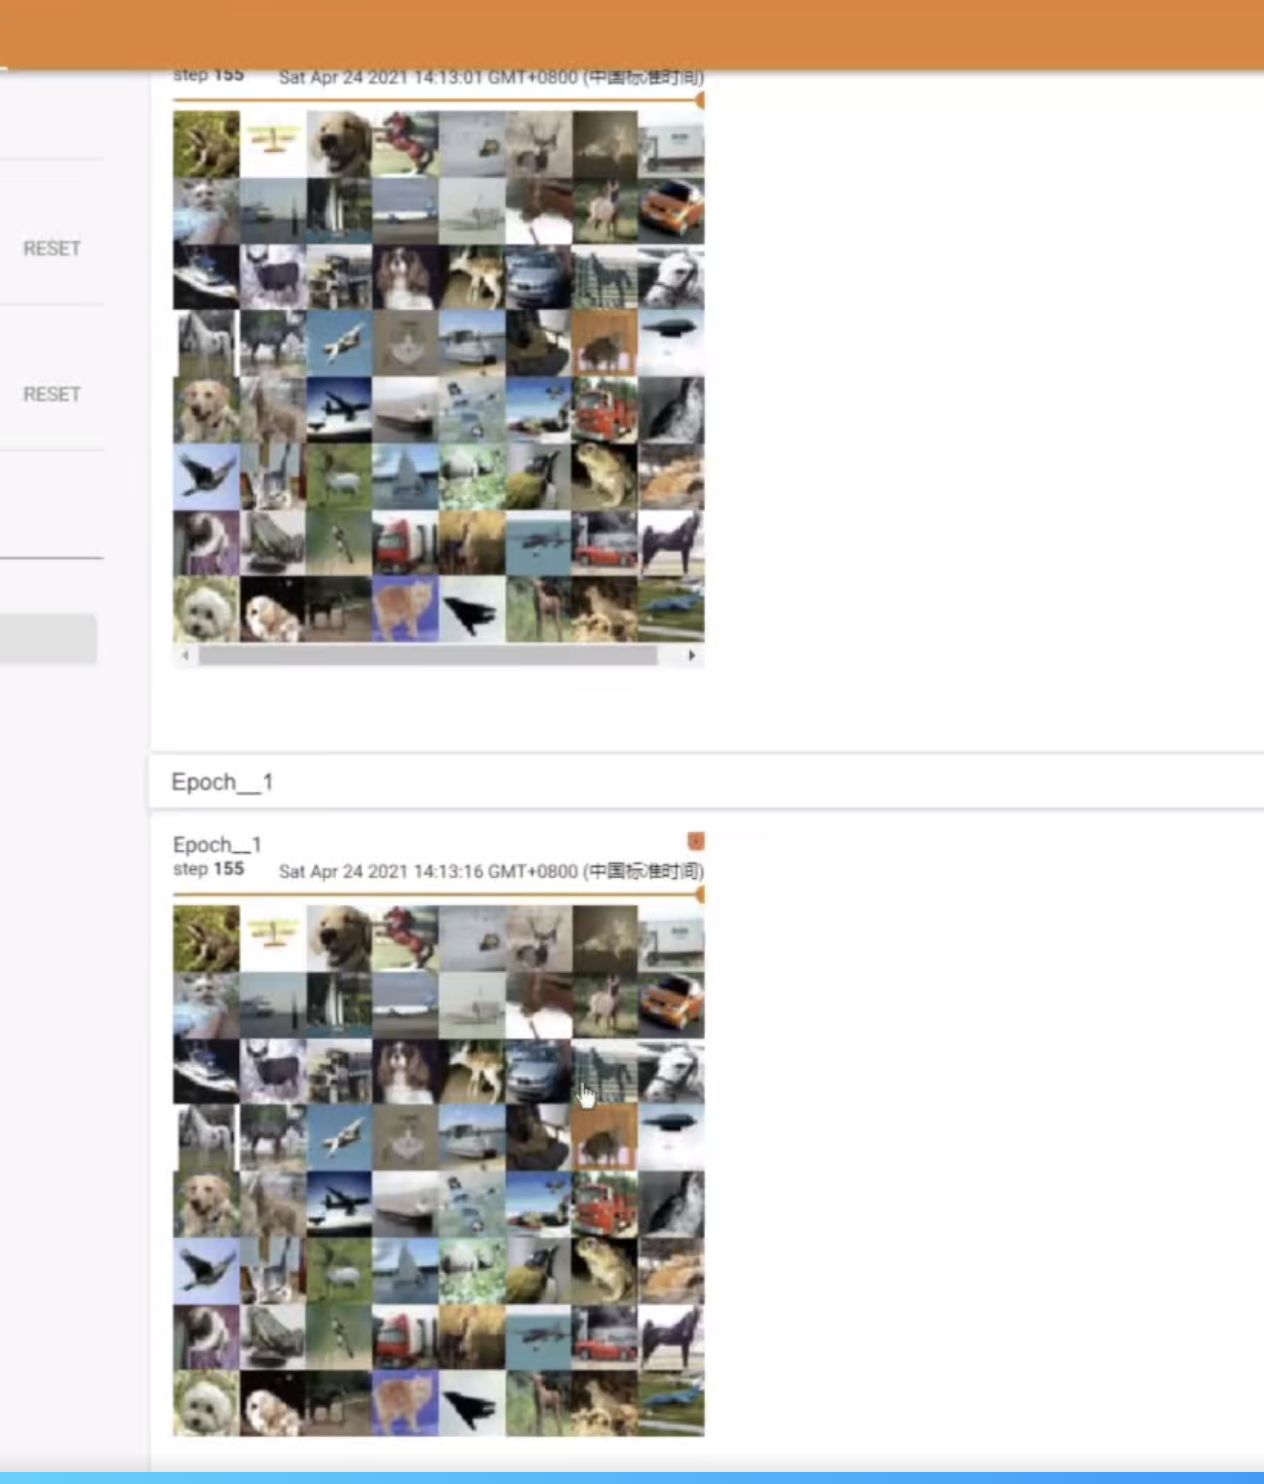
执行如下代码,然后在终端输入 tensorboard --logdir='src/dataloader'
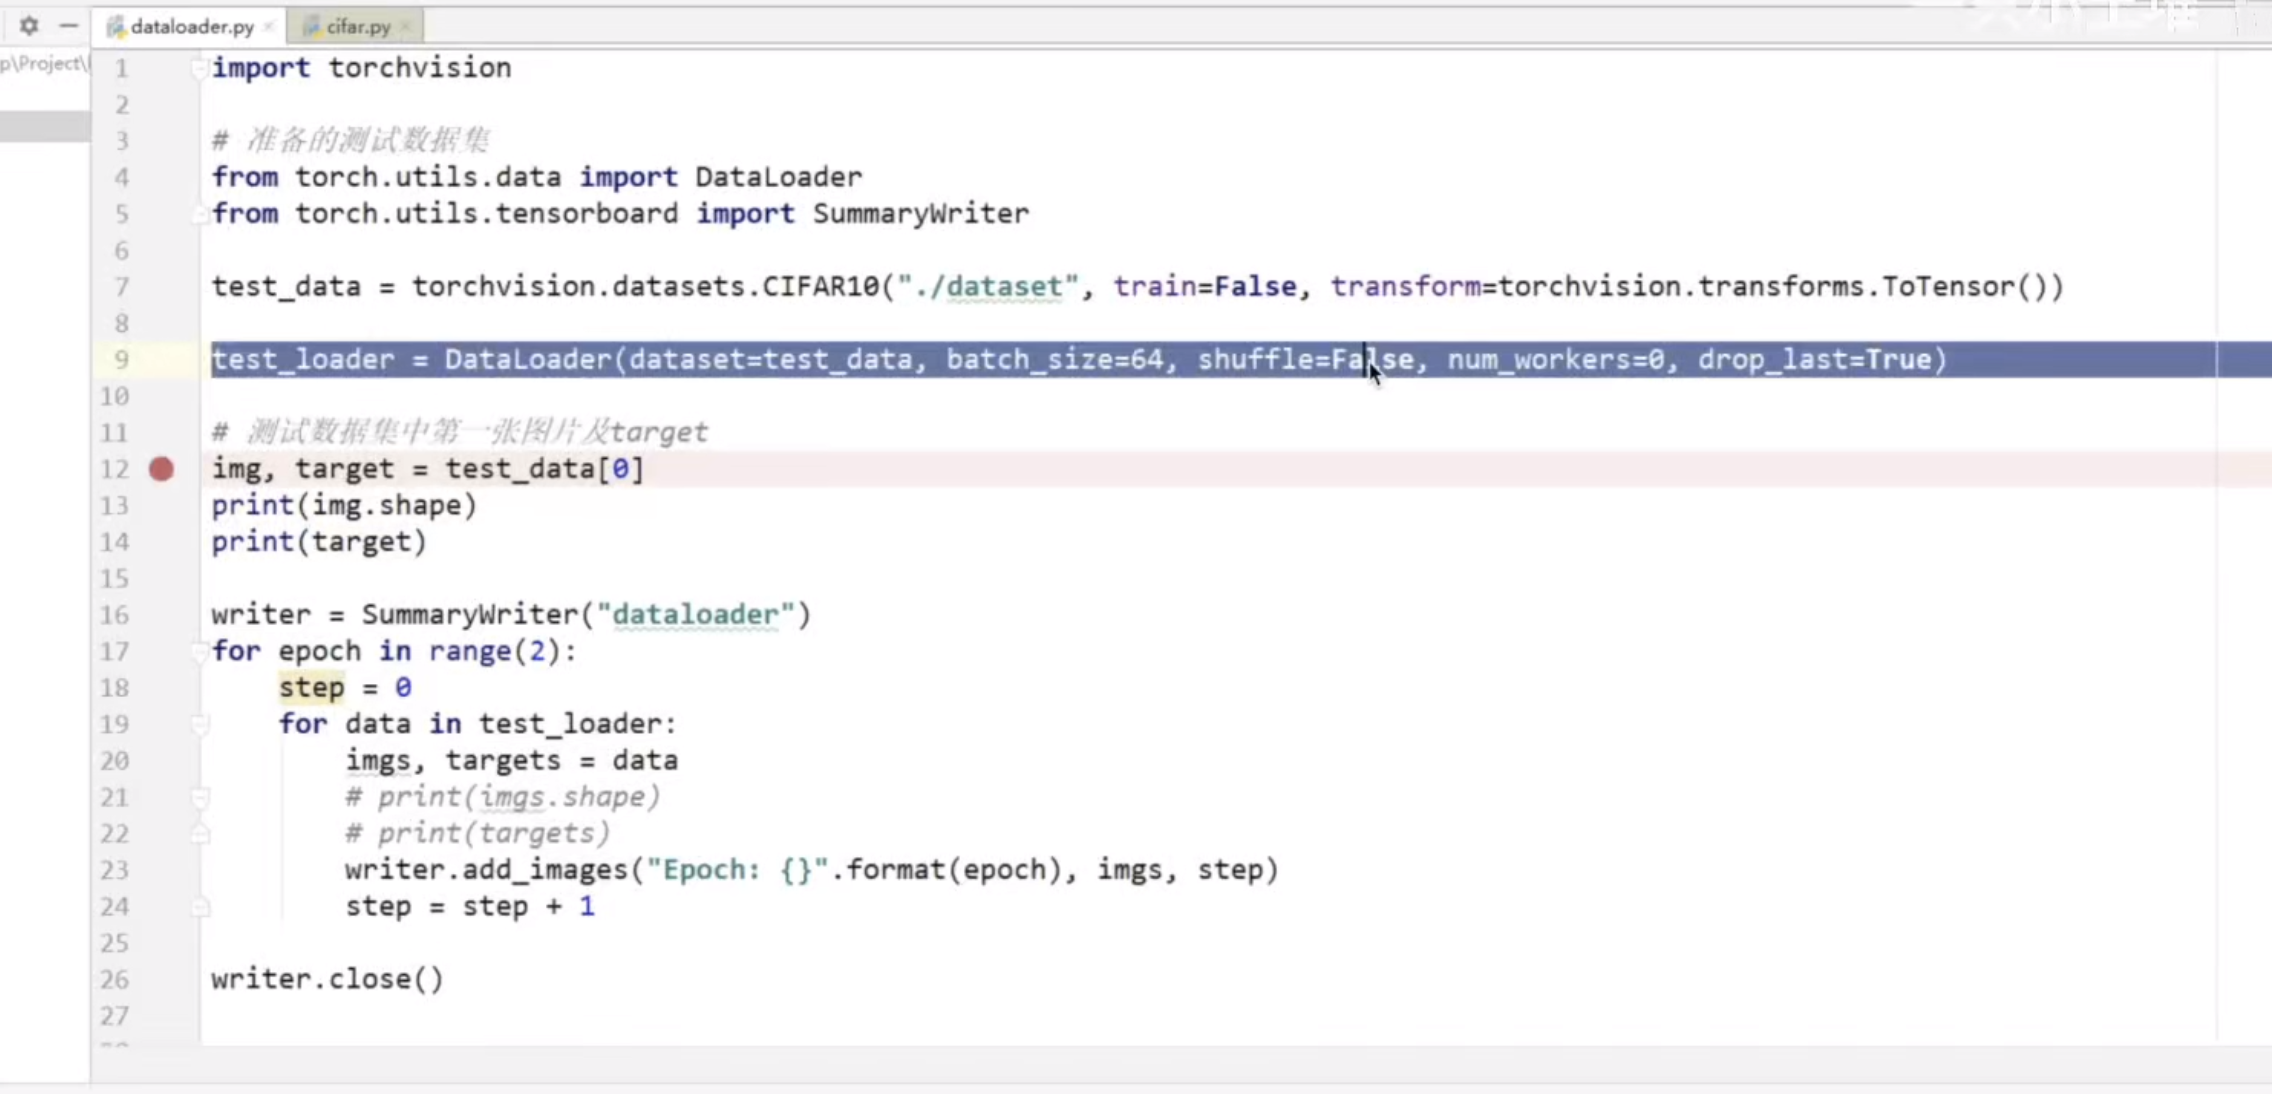
我们发现两轮的图片都是一致的。
实际应用建议
常规设置:
shuffle=True:避免模型学习到数据顺序特征
drop_last=True:保证每批数据量一致,便于计算
特殊情况:
小数据集:可设drop_last=False充分利用所有数据
测试阶段:通常设shuffle=False保证结果可复现
总结