上周接了个播客的活:一期节目是分三段录的------开场、访谈、结尾各自独立文件,甲方要一条"连续、听着像一次录完"的完整音频。听起来是最没技术含量的需求:三个MP3首尾相接而已。
结果第一版交出去就被打回来了,甲方原话是:"接缝那儿有'啪'的一声,而且访谈那段声音明显比开场大。"
这篇文章就是把这次翻车复盘清楚。拼接这件事真正的门槛不在"怎么接上",而在接上之后那条缝要不要裂、呼吸编码器会不会在缝里塞东西、以及几段素材响度能不能对齐。
先说结论:拼接只有两条技术路线
|-------------------------------------|----------------------|---------------------|--------------------------|
| 路线 | 做法 | 优点 | 代价 |
| 无损拼接(Remux / Stream copy) | 不解码,直接把压缩后的音频帧按顺序堆起来 | 秒级完成,零音质损失 | 要求所有片段的参数完全一致,否则必出问题 |
| 重编码拼接(Decode → Concat → Encode) | 全部解成 PCM 拼接,最后一次性压缩 | 参数可以不一致,能顺手做响度对齐和淡接 | 经过一次有损压缩(若输出 MP3/AAC) |
工程上的经验:先用PCM(WAV)在中间层拼接,最后一步再压成 MP3。这条规则能解决下面 90% 的怪现象,原因在第 2 节讲。
接缝那一声"啪",到底是怎么来的
2.1波形不连续 = 一次宽频冲激
音频的本质是采样点序列。假设前一段的最后一个采样点是 +0.32,后一段的第一个采样点是 -0.51,扬声器/耳机的振膜会在这一瞬间被"踢"一下------从正位移瞬间跳到负位移,听感就是"啪"或"哒"。
这在信号处理上叫不连续点(discontinuity),在频谱上表现为一条覆盖全频段的竖直能量线,所以非常刺耳,哪怕只有一次也藏不住。
2.2 MP3比WAV更容易出问题:编码器延迟(encoder delay)
这是很多人不知道的一层。MP3基于帧结构,编码器在开始编码前会插入一段前导静音(encoder delay,典型值 576 个采样点) ,结尾也会补齐 padding。也就是说,你看到的 MP3 时长里,开头和结尾都藏了一小段不属于原始素材的东西。
直接用 -c copy 把两个 MP3 拼起来,这段隐含的 delay/padding 就夹在中间------表现为接缝处十几毫秒的小空档,或者反过来一小段重叠造成的相位冲突。
所以:追求无缝,就把素材先转成 PCM WAV,拼完再编码一次。 这是规避 encoder delay 最省事的办法。
2.3 采样率不一致:会让后半段变成"花栗鼠"
还有一个更隐蔽的坑:44.1kHz 和 48kHz 的片段硬拼。
如果强行 -c copy 把两种采样率的码流堆在一起,播放器只会按第一段的采样率去解读后面的数据,结果就是:
表现为"前半段正常,后半段变成了花栗鼠"。所以拼之前必须确认:采样率、声道数、位深三者一致。
三个必须在拼接前解决的坑
坑 1:参数没对齐
拼接前的标准检查动作:
片段一多就别手敲了,用脚本扫一遍:
只要出现两种以上分组,先统一到同一规格(推荐 48kHz / 双声道 / 16bit PCM,也就是视频和主流平台的标准件):
坑 2:响度不一致
分几批录制的素材,最典型的问题就是每一段的录音电平不一样------这正是甲方吐槽"访谈段比开场大"的原因。
在拼接之前把每段单独拉到同一响度,比拼完之后再整轨压缩效果好得多(整轨标准化改不了段间的相对差):
播客/口播常用 -16 LUFS (部分平台推荐 -14),LRA 控制动态范围,旁白类可以压到 7~9 让响度更"齐"。
坑 3:接缝要不要淡接
取决于素材性质:
- 口播 / 课程 / 播客:相邻内容本来就有停顿,建议给每段加 10~30ms 的极短淡入淡出,消除不连续点;
- 音乐 / 连续现场录音:坚决不能淡接,否则会听出一个明显的"呼吸"凹陷------这种情况要在**零交叉点(zero crossing)**附近下刀,靠"波形经过零点时切断"来保证衔接连续。
给片段加极短淡变(20ms,人耳察觉不到,但能压住咔哒声):
两段之间要真正交叉淡化(crossfade),用 acrossfade:
两条实操命令:无损拼接vs重编码拼接
4.1 无损拼接(参数完全一致时首选)
写一个文件清单 list.txt:
执行:
-c copy:不解码不重压,秒出结果,零损失;
- 适用前提是前面检查过的三项参数一致;
- MP3场景下如果听见咔哒声,就说明踩了2.2的 encoder delay,改走4.2。
4.2 重编码拼接(有质量问题时的正解)
concat=n=3:v=0:a=1:三路输入,无视频流,一路音频输出;
- 拼完统一做一次 loudnorm 收口(前提:每段已经按坑2单独拉平过,这一步只是保险);
- 最后
-q:a 2(VBR,约 190kbps)输出 MP3。记住只在最后一刻压缩一次。
三个容易被忽略的细节
5.1 ID3 标签重复与 VBR 时间戳漂移
用 concat + -c copy 拼MP3时,每段文件自带的ID3标签(封面、标题、艺人)会被原样带进中间位置。后果有两个:
- 元数据重复:部分播放器读到中间的控制帧会误判,出现时长显示为第一段长度的情况;
- VBR 时间戳漂移:可变码率MP3依赖Xing/VBRI头声明时长,拼完之后这个头信息只反映第一段,累计误差可能让总时长少算或多算几百毫秒。
处理办法是先清干净再拼:
拼接中任何一步出现"时长不对",优先怀疑这一条。
5.2 反过来做是最常见的错误
很多人拿到素材第一反应是"先统一压成 MP3 再拼"------这是踩两次有损的典型:原始(可能已经是AAC/MP3)→ 第一次重编码 → 拼接 → 第二次重编码。每多一次有损编码,高频就再薄一层。
正确顺序永远是:
中间爱处理几次都行,只要不离开 PCM,就没有任何累积损失。
5.3 长音频别在剪辑软件里"导出一次"了事
有些同学习惯把三段素材拖进剪辑软件的时间线,对齐之后直接导出MP3。这本质上等价于"重编码拼接",而且你失去了对每一段单独做loudnorm的机会------段间响度差会被原封不动留在成品里。除非你本来就要在DAW里做别的处理,否则拼接这种机械活,命令行更可控、也更快。
验证:别只用耳朵验收
三条判据:时长对得上(说明没有丢帧/重复) 、响度落在目标值 ±1 LU 内 、真峰值不越 0dBTP。这三条过了,交付基本不会返工。
那次活最后是怎么交付的
复盘一下我现在的标准流程:拿到多段素材,先扫参数 → 统一到 48kHz/立体声/PCM → 单段 loudnorm 拉齐 → 检查每条接缝 → 拼完再验证响度和时长。中间层一律是WAV,MP3只在最后导出那一步出现。
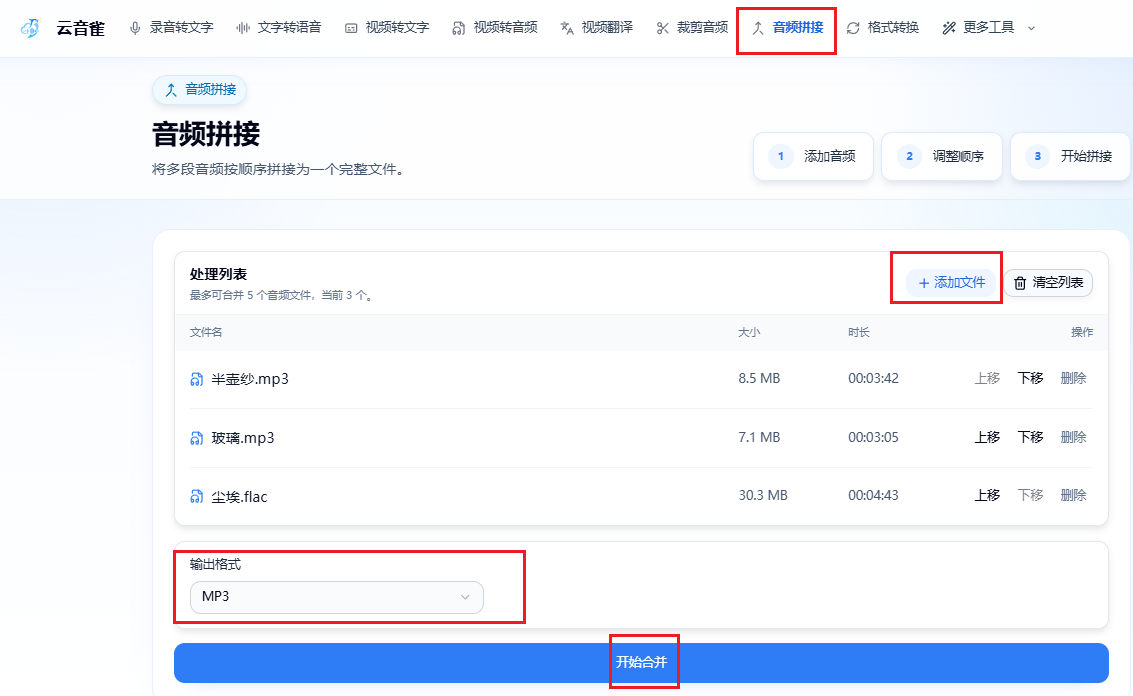
顺带说一句我偷懒时走的路径:如果只是把几段不太讲究的素材接起来(比如课程的分段录音),我也会直接用云音雀的「音频拼接」------它的三步就是 添加音频 → 调整顺序 → 开始拼接 ,支持一次多选、至少2个、最多5个文件,顺序可以拖动调整,还能选输出格式,提交后进转换记录等结果下载。上限5个是明确的规则,超过就要分批或者退回到 ffmpeg 的流程里。
两种路径的取舍很清楚:在线方案省的是环境和命令行成本,代价是文件数量有上限、中间处理不可控;ffmpeg 胜在可以插任意处理环节。 我自己的习惯是------干净素材、数量少、急交付走在线;带接缝问题、要修、要精修的一律本地。
不同场景怎么拼(速查表)
|------------------|--------------------------------------|-----------------------|
| 场景 | 推荐做法 | 说明 |
| 多段口播/课程录音,只想连起来 | 先各自拉齐响度 → WAV 中间层 → concat → 末步压 MP3 | 接缝加 20ms 淡变 |
| 音乐/连续现场录音 | 零交叉点下刀,不做淡接 | 淡接会听出"呼吸" |
| 一首接一首的节目单(要交叉淡化) | acrossfade,1~2 秒 | 先 sort 好顺序再拼 |
| 参数不一致的老文件 | 统一到 48kHz/立体声/PCM | 千万别 -c copy 硬拼(会变调) |
| 临时救急、文件不多 | 在线拼接工具 | 注意文件数量上限,成品记得及时下载 |
| 批量几十段 | Python 脚本 + concat filter | 参见第三节的检查脚本 |
最后:拼接不是"接上就完事"
拆开看,"把两个音频接起来"这件事里有三个独立问题:采样层是否连续(有无咔哒)、响度是否一致(有无台阶)、容器处理是否干净(有无delay夹在中间)。三个都解决了,听众根本不会意识到这条片子是分几次录的。
反过来说,只要有一个没解决,听众说不出哪里怪,但就是"听着不舒服"------这恰恰是最难返工的一类问题。
工具会替你完成搬运,但先检查参数、先在PCM层作业、只在最后压缩一次这三件事,得你自己把关。
如果你拼接时遇到过更刁钻的情况(比如VBR MP3的时间戳漂移、多轨采样率混拼),欢迎在评论区补充,我继续往速查表里加。