目录
- [0. 这一篇继续回答什么?](#0. 这一篇继续回答什么? "#0-%E8%BF%99%E4%B8%80%E7%AF%87%E7%BB%A7%E7%BB%AD%E5%9B%9E%E7%AD%94%E4%BB%80%E4%B9%88")
- [1. HotSpot 如何实现 AtomicInteger?](#1. HotSpot 如何实现 AtomicInteger? "#1-hotspot-%E5%A6%82%E4%BD%95%E5%AE%9E%E7%8E%B0-atomicinteger")
- [1.1 分层](#1.1 分层 "#11-%E5%88%86%E5%B1%82")
- [1.2 一次 AtomicInteger 的完整实现路径](#1.2 一次 AtomicInteger 的完整实现路径 "#12-%E4%B8%80%E6%AC%A1-atomicinteger-%E7%9A%84%E5%AE%8C%E6%95%B4%E5%AE%9E%E7%8E%B0%E8%B7%AF%E5%BE%84")
- [1.3 Atomicity](#1.3 Atomicity "#13-atomicity")
- [1.4 Visibility 和 Ordering](#1.4 Visibility 和 Ordering "#14-visibility-%E5%92%8C-ordering")
- [2. Go Runtime 如何实现 sync/atomic?](#2. Go Runtime 如何实现 sync/atomic? "#2-go-runtime-%E5%A6%82%E4%BD%95%E5%AE%9E%E7%8E%B0-syncatomic")
- [2.1 分层](#2.1 分层 "#21-%E5%88%86%E5%B1%82")
- [2.2 一次 atomic.Int64 的完整实现路径](#2.2 一次 atomic.Int64 的完整实现路径 "#22-%E4%B8%80%E6%AC%A1-atomicint64-%E7%9A%84%E5%AE%8C%E6%95%B4%E5%AE%9E%E7%8E%B0%E8%B7%AF%E5%BE%84")
- [2.3 Atomicity](#2.3 Atomicity "#23-atomicity")
- [2.4 Visibility 和 Ordering](#2.4 Visibility 和 Ordering "#24-visibility-%E5%92%8C-ordering")
- [3. CPython 如何实现内部 Atomic?](#3. CPython 如何实现内部 Atomic? "#3-cpython-%E5%A6%82%E4%BD%95%E5%AE%9E%E7%8E%B0%E5%86%85%E9%83%A8-atomic")
- [3.1 分层](#3.1 分层 "#31-%E5%88%86%E5%B1%82")
- [3.2 一次 CPython Atomic 的完整实现路径](#3.2 一次 CPython Atomic 的完整实现路径 "#32-%E4%B8%80%E6%AC%A1-cpython-atomic-%E7%9A%84%E5%AE%8C%E6%95%B4%E5%AE%9E%E7%8E%B0%E8%B7%AF%E5%BE%84")
- [3.3 Atomicity](#3.3 Atomicity "#33-atomicity")
- [3.4 Visibility 和 Ordering](#3.4 Visibility 和 Ordering "#34-visibility-%E5%92%8C-ordering")
- [4. 三种实现的共同套路](#4. 三种实现的共同套路 "#4-%E4%B8%89%E7%A7%8D%E5%AE%9E%E7%8E%B0%E7%9A%84%E5%85%B1%E5%90%8C%E5%A5%97%E8%B7%AF")
- [4.1 一次更新怎么做到不可分割?](#4.1 一次更新怎么做到不可分割? "#41-%E4%B8%80%E6%AC%A1%E6%9B%B4%E6%96%B0%E6%80%8E%E4%B9%88%E5%81%9A%E5%88%B0%E4%B8%8D%E5%8F%AF%E5%88%86%E5%89%B2")
- [4.2 同时更新冲突了怎么办?](#4.2 同时更新冲突了怎么办? "#42-%E5%90%8C%E6%97%B6%E6%9B%B4%E6%96%B0%E5%86%B2%E7%AA%81%E4%BA%86%E6%80%8E%E4%B9%88%E5%8A%9E")
- [4.3 为什么还能保证 Visibility 和 Ordering?](#4.3 为什么还能保证 Visibility 和 Ordering? "#43-%E4%B8%BA%E4%BB%80%E4%B9%88%E8%BF%98%E8%83%BD%E4%BF%9D%E8%AF%81-visibility-%E5%92%8C-ordering")
- [5. Atomic 和 Mutex 有什么区别?](#5. Atomic 和 Mutex 有什么区别? "#5-atomic-%E5%92%8C-mutex-%E6%9C%89%E4%BB%80%E4%B9%88%E5%8C%BA%E5%88%AB")
- [5.1 一次状态更新,两种做法](#5.1 一次状态更新,两种做法 "#51-%E4%B8%80%E6%AC%A1%E7%8A%B6%E6%80%81%E6%9B%B4%E6%96%B0%E4%B8%A4%E7%A7%8D%E5%81%9A%E6%B3%95")
- [5.2 多个 Atomic 为什么不能代替一把 Mutex?](#5.2 多个 Atomic 为什么不能代替一把 Mutex? "#52-%E5%A4%9A%E4%B8%AA-atomic-%E4%B8%BA%E4%BB%80%E4%B9%88%E4%B8%8D%E8%83%BD%E4%BB%A3%E6%9B%BF%E4%B8%80%E6%8A%8A-mutex")
- [5.3 怎么选?](#5.3 怎么选? "#53-%E6%80%8E%E4%B9%88%E9%80%89")
- [6. 下一篇:volatile](#6. 下一篇:volatile "#6-%E4%B8%8B%E4%B8%80%E7%AF%87volatile")
0. 这一篇继续回答什么?
上一篇从语言内存模型的规则出发,看 Atomic 如何提供 Atomicity、Visibility 和 Ordering。
这一篇继续往下看:Java、Go 和 CPython 分别如何在 Runtime 和 CPU 层实现这些保证。
1. HotSpot 如何实现 AtomicInteger?
1.1 分层
先把 Java 的实现层次固定下来:
text
JDK API
实例:AtomicInteger
作用:提供 Atomic 操作
        │
        ▼
JDK Internal
实例:Unsafe
作用:提供底层 Atomic Primitive
        │
        ▼
JVM Implementation(HotSpot)
实例:Intrinsic / C1 / C2
作用:把 Atomic Primitive 降低到机器指令
        │
        ▼
x86-64 Hardware
实例:Atomic Instruction / Cache Coherence / Fence
作用:提供 Atomicity、Visibility 与 Ordering 的硬件基础
1.2 一次 AtomicInteger 的完整实现路径
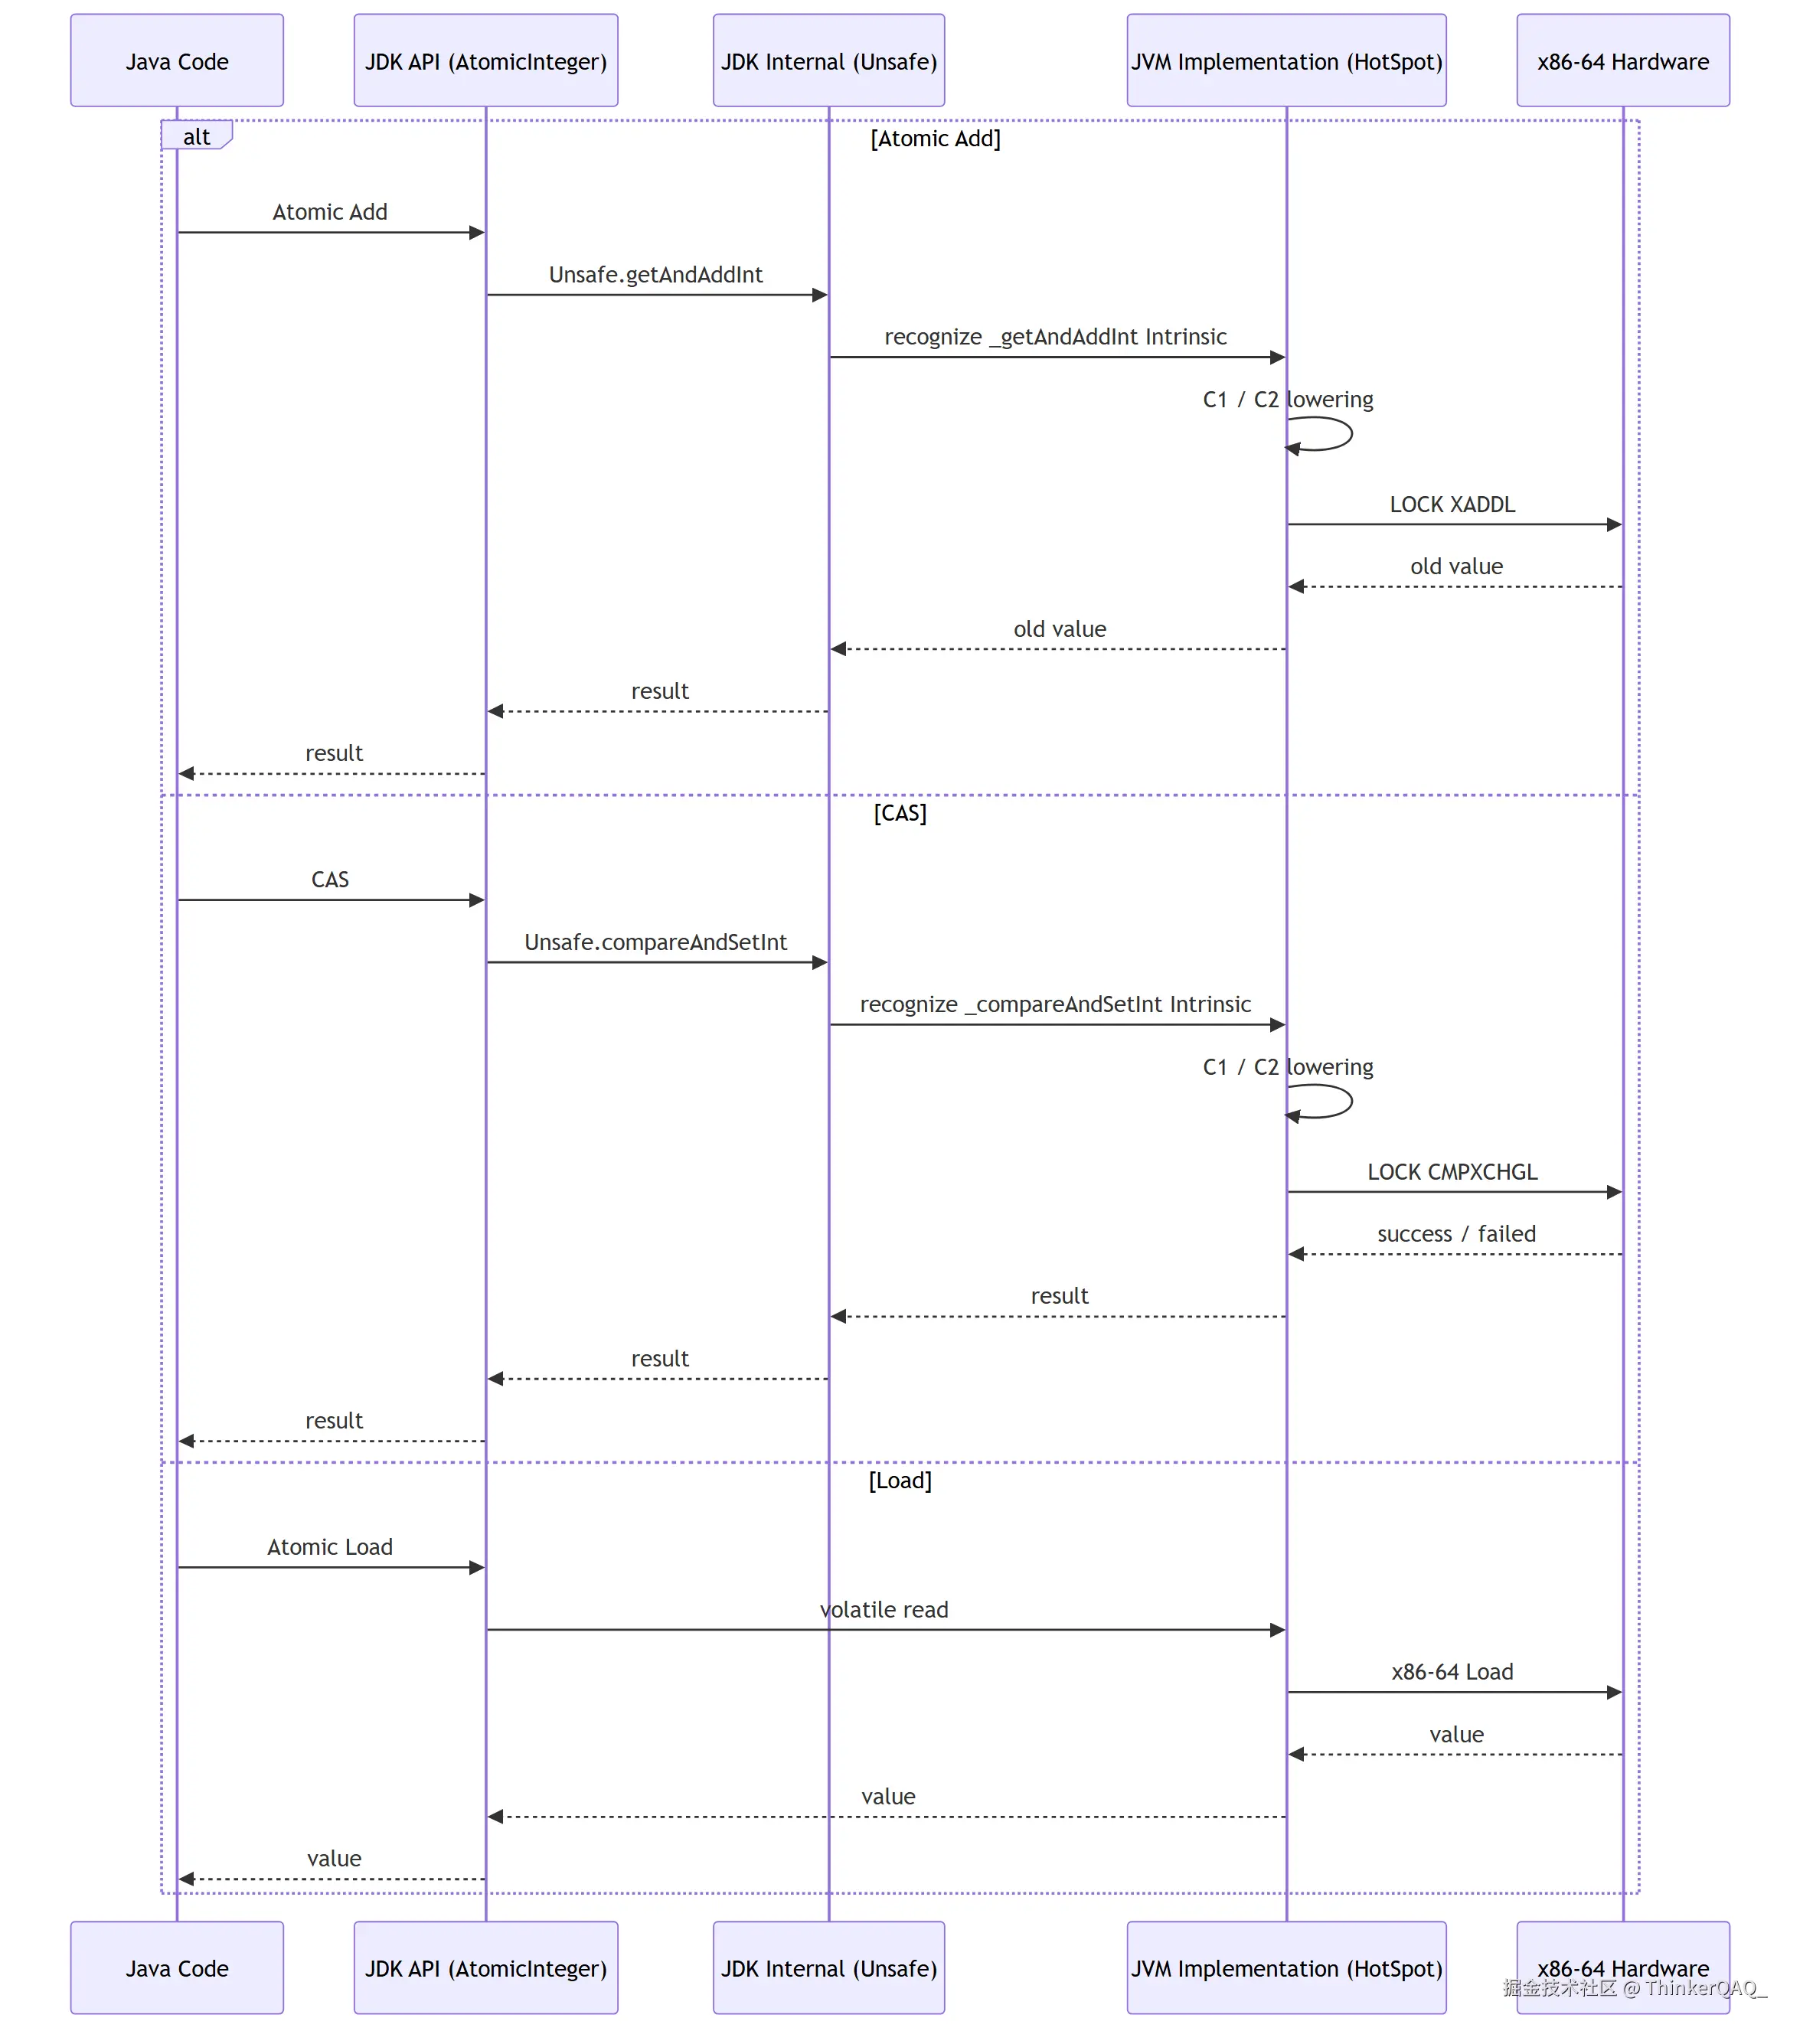
上面的时序图只保留跨层主流程。HotSpot 内部的核心路径可以进一步展开为:
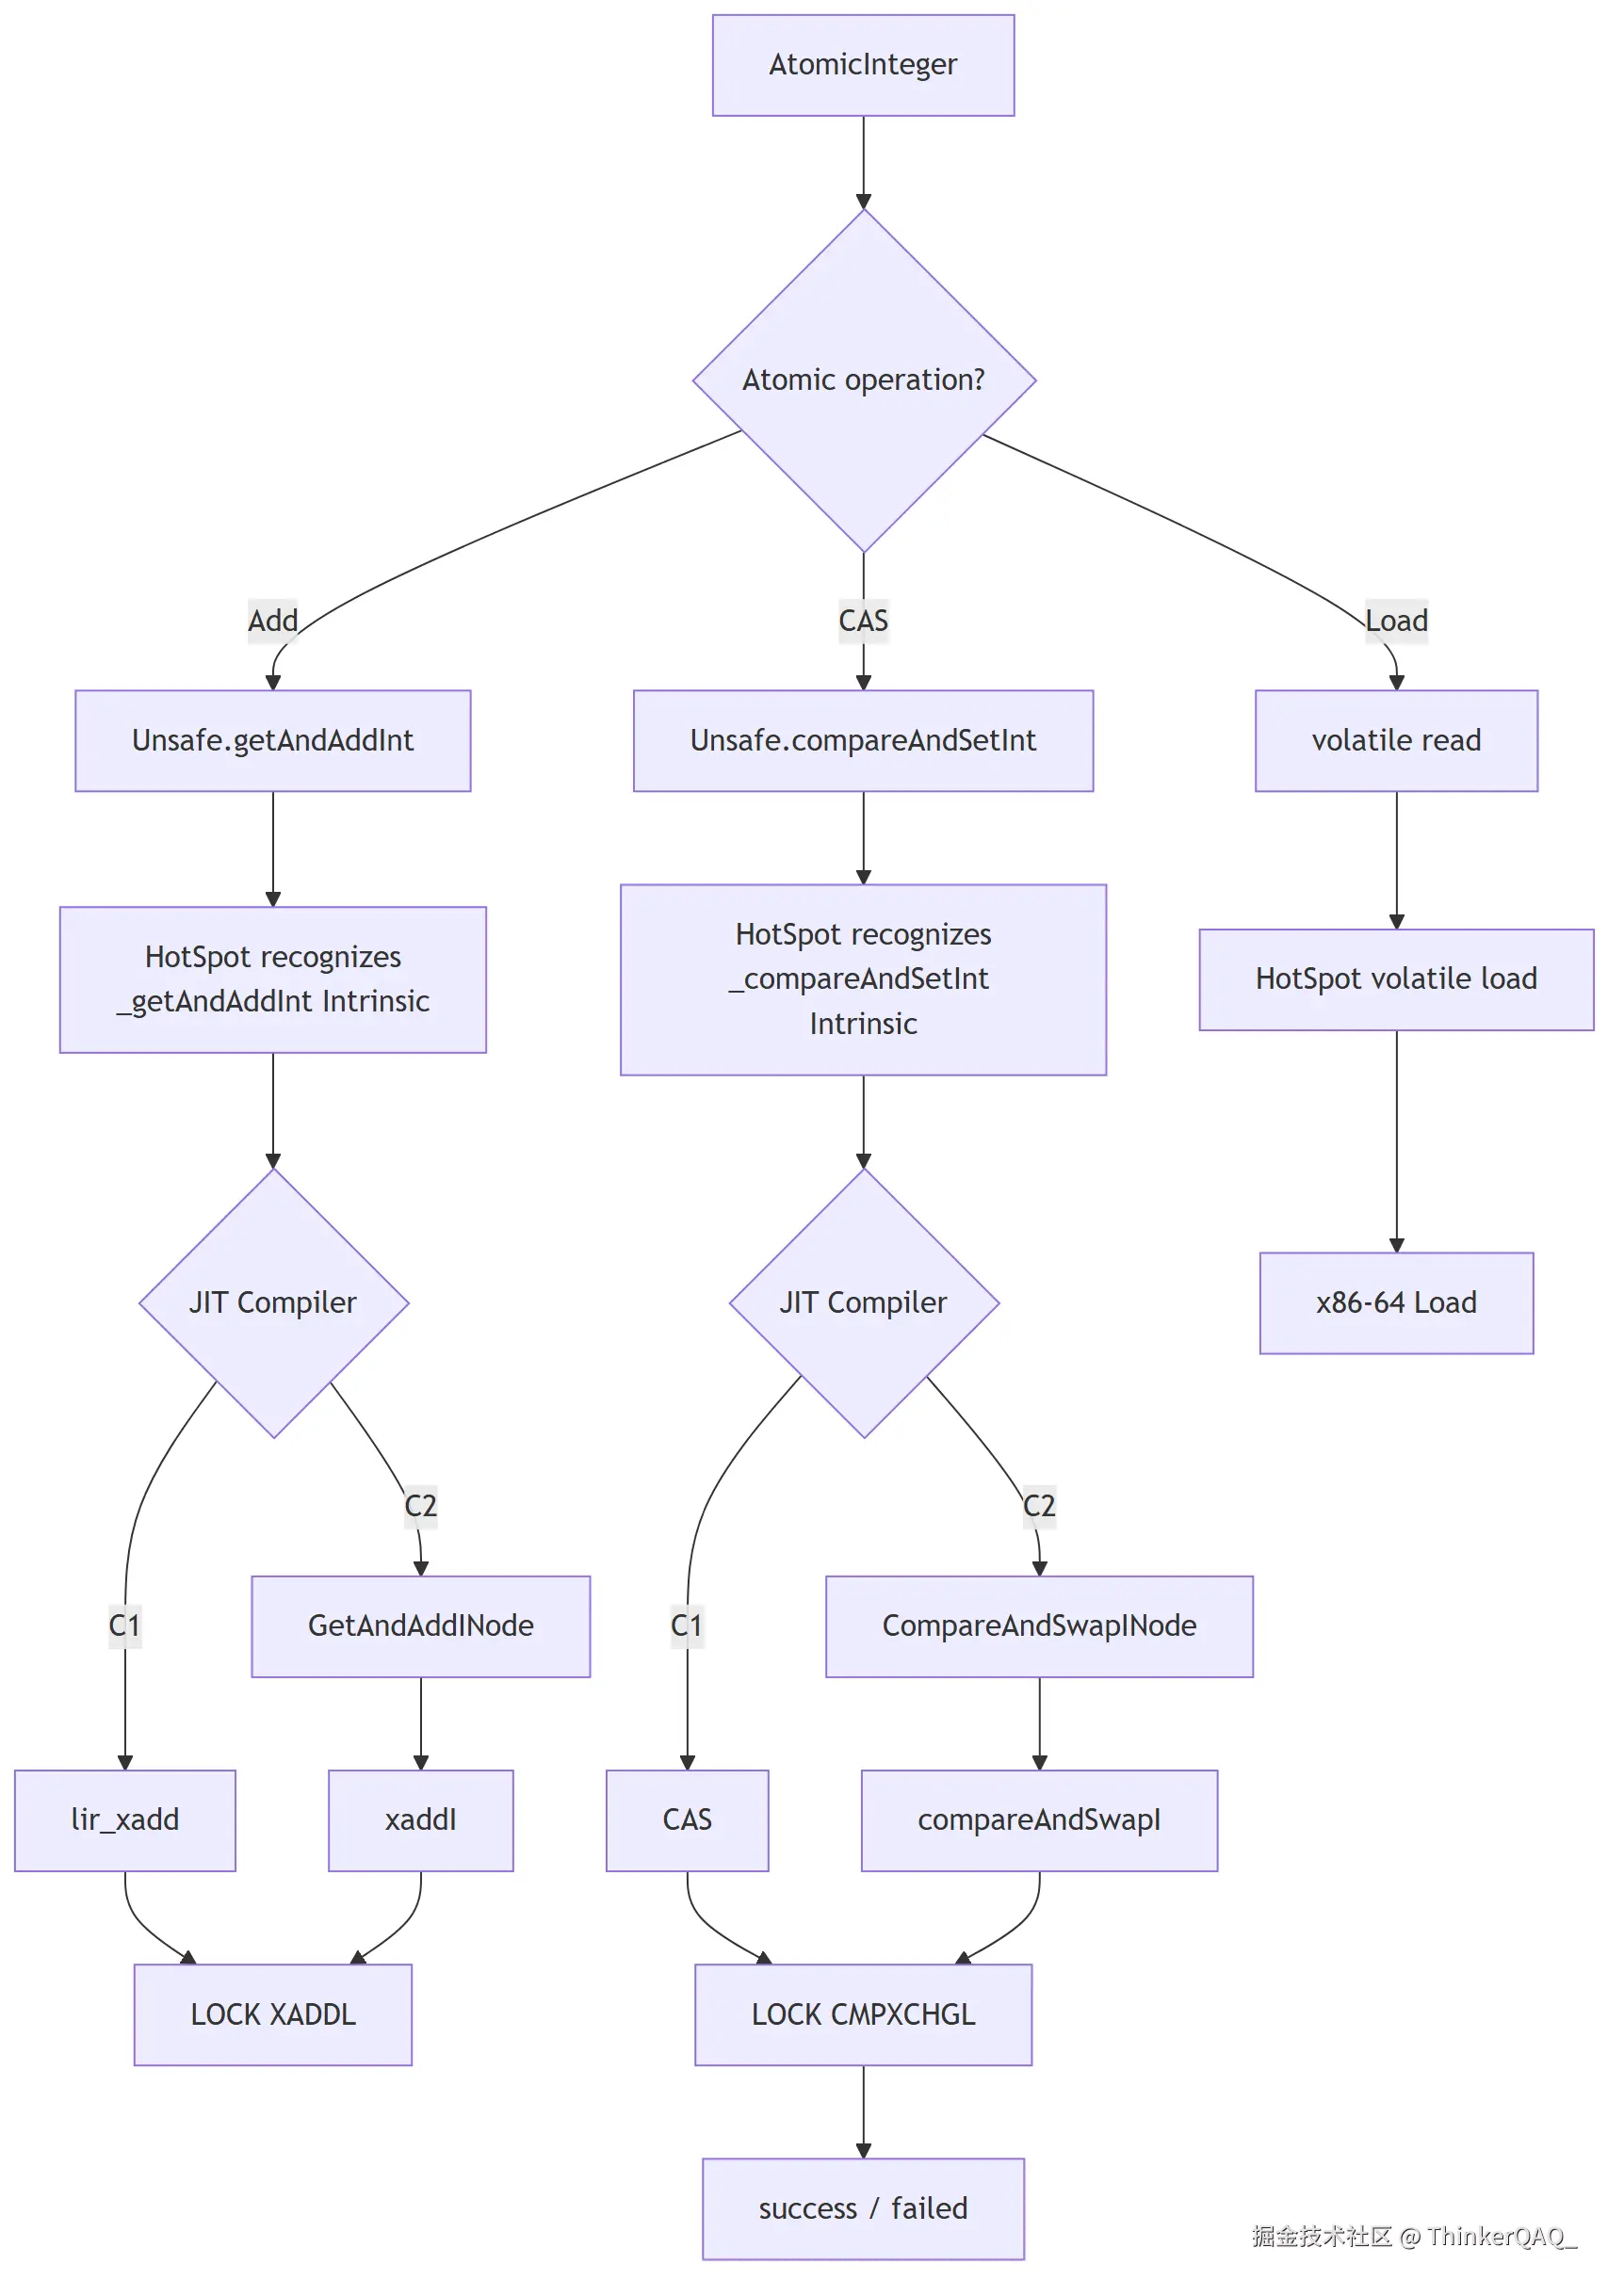
1.3 Atomicity
Atomicity 对应上面流程图里的两种原子更新:
text
Atomic Add:LOCK XADDL
CAS:       LOCK CMPXCHGL
它们都把一次共享状态修改作为不可分割的 Atomic RMW 完成。
1.4 Visibility 和 Ordering
Visibility 和 Ordering 对应上面流程图里的 Atomic 写入与读取边界:
text
写侧:Atomic Add / CAS
读侧:Atomic Load
上层的 JMM / VarHandle Memory Effects 规定这些操作的内存语义,HotSpot 在编译时保留相应的顺序约束,再由 CPU 的 Cache Coherence 和内存顺序落实。
所以 Java 与第一篇的硬件模型对应为:
text
Atomicity
  → Atomic Instruction
  → HotSpot / x86-64: LOCK XADD / LOCK CMPXCHG

Visibility
  → Cache Coherence
  → 典型 x86-64 CPU:MESI-family(如 MESIF / MOESI)

Ordering
  → Compiler Ordering + Hardware Memory Ordering
  → HotSpot + x86-64 ordering rules
实现可以继续查看 OpenJDK 的 AtomicInteger.java、Unsafe.java、vmIntrinsics.hpp、c1_GraphBuilder.cpp 和 c2compiler.cpp。
2. Go Runtime 如何实现 sync/atomic?
2.1 分层
text
Go API
实例:sync/atomic / atomic.Int64
作用:声明 Atomic 操作
        │
        ▼
Go Implementation(sync/atomic)
实例:AddInt64 / CompareAndSwapInt64 / LoadInt64
作用:实现 Atomic API 语义
        │
        ▼
Go Runtime
实例:internal/runtime/atomic
作用:实现底层 Atomic Primitive
        │
        ▼
x86-64 Hardware
实例:Atomic Instruction / Cache Coherence / Fence
作用:提供 Atomicity、Visibility 与 Ordering 的硬件基础
2.2 一次 atomic.Int64 的完整实现路径
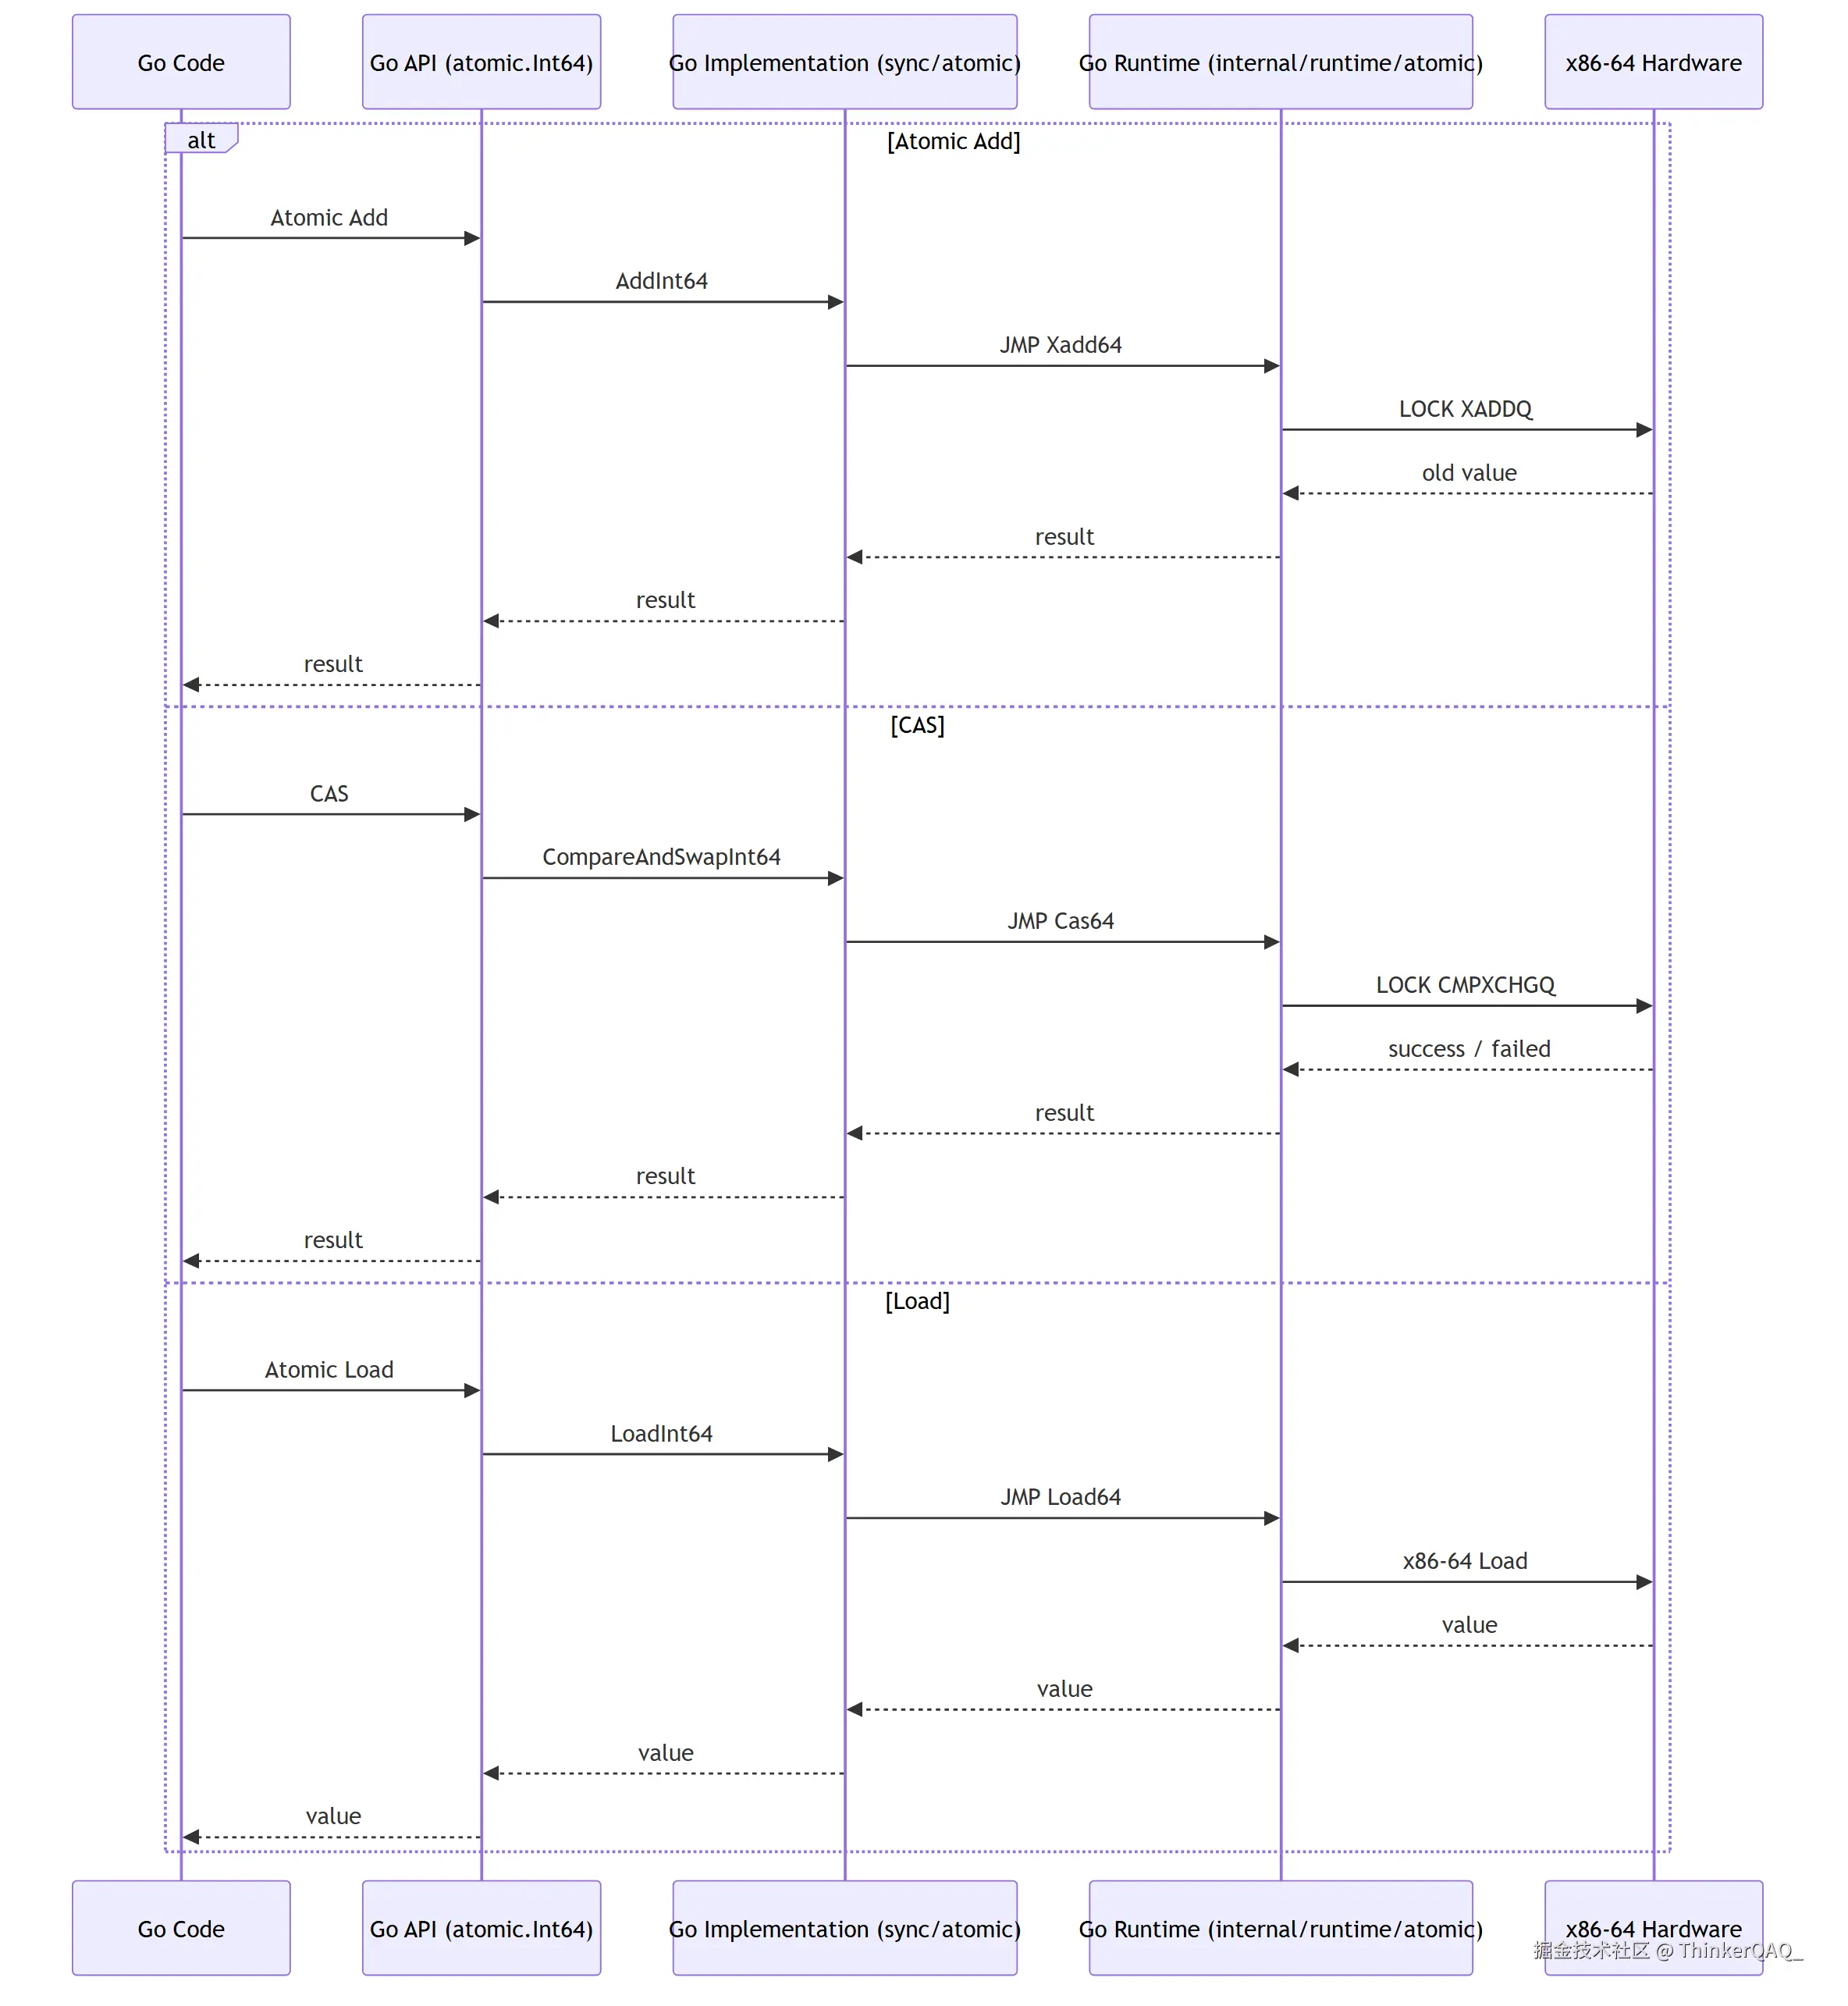
上面的时序图只保留跨层主流程。Go 内部的核心路径可以进一步展开为:
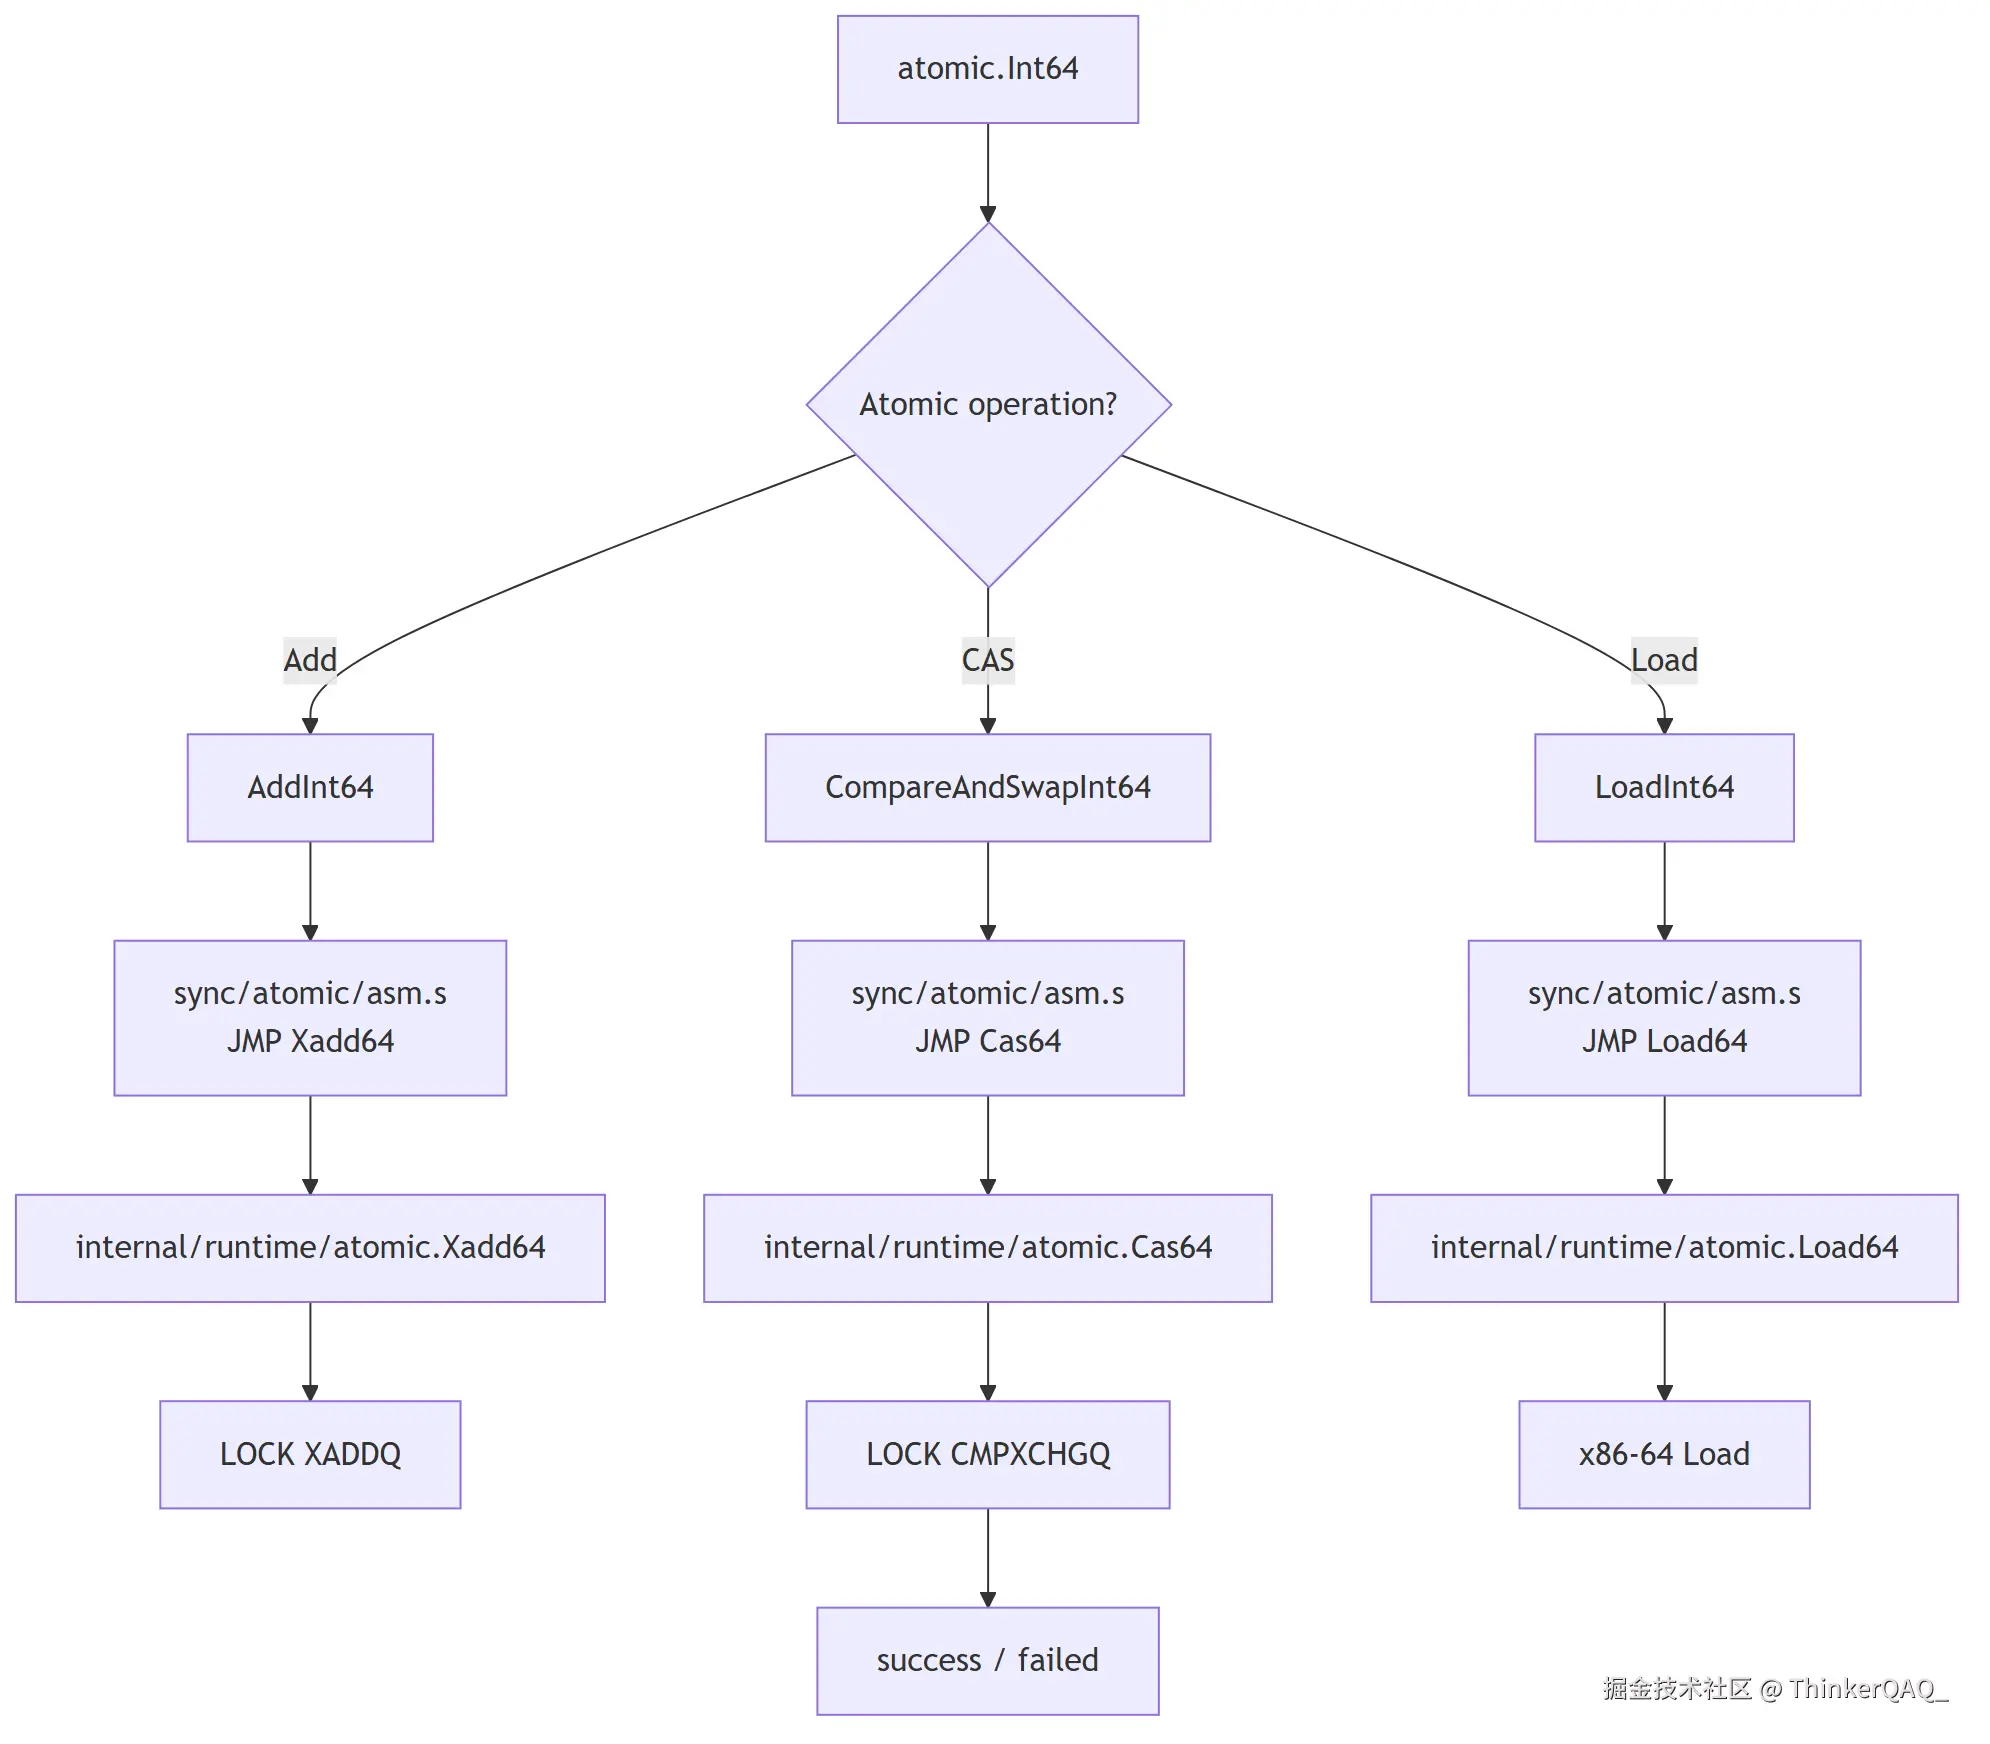
2.3 Atomicity
Atomicity 对应上面流程图里的两种原子更新:
text
Atomic Add:LOCK XADDQ
CAS:       LOCK CMPXCHGQ
它们都把一次共享状态修改作为不可分割的 Atomic RMW 完成。
2.4 Visibility 和 Ordering
Visibility 和 Ordering 对应上面流程图里的 Atomic 写入与读取边界:
text
写侧:Atomic Add / CAS
读侧:Atomic Load
Go Memory Model 规定 Atomic 操作的同步与顺序语义,编译器和 Runtime 将这些语义保留到目标架构,再由 CPU 的 Cache Coherence 和内存顺序落实。
所以 Go 与第一篇的硬件模型对应为:
text
Atomicity
  → Atomic Instruction
  → Go / x86-64: LOCK XADDQ / LOCK CMPXCHGQ

Visibility
  → Cache Coherence
  → 典型 x86-64 CPU:MESI-family(如 MESIF / MOESI)

Ordering
  → Compiler / Runtime Ordering + Hardware Memory Ordering
  → Go Atomic semantics + x86-64 ordering rules
实现可以继续查看 sync/atomic/type.go、sync/atomic/asm.s 和 internal/runtime/atomic/atomic_amd64.s。
3. CPython 如何实现内部 Atomic?
Python 标准库没有与 AtomicInteger、atomic.Int64 对称的通用整数 Atomic API,所以这一节从 CPython Runtime 内部开始。
3.1 分层
text
CPython Runtime
实例:Runtime 内部共享状态
作用:调用内部 Atomic 操作
        │
        ▼
CPython Implementation
实例:_Py_atomic_*
作用:实现 Runtime Atomic 语义
        │
        ▼
C Compiler
实例:GCC / Clang __atomic_*
作用:把 Atomic 与 Memory Order 映射到目标架构
        │
        ▼
x86-64 Hardware
实例:Atomic Instruction / Cache Coherence / Fence
作用:提供 Atomicity、Visibility 与 Ordering 的硬件基础
3.2 一次 CPython Atomic 的完整实现路径
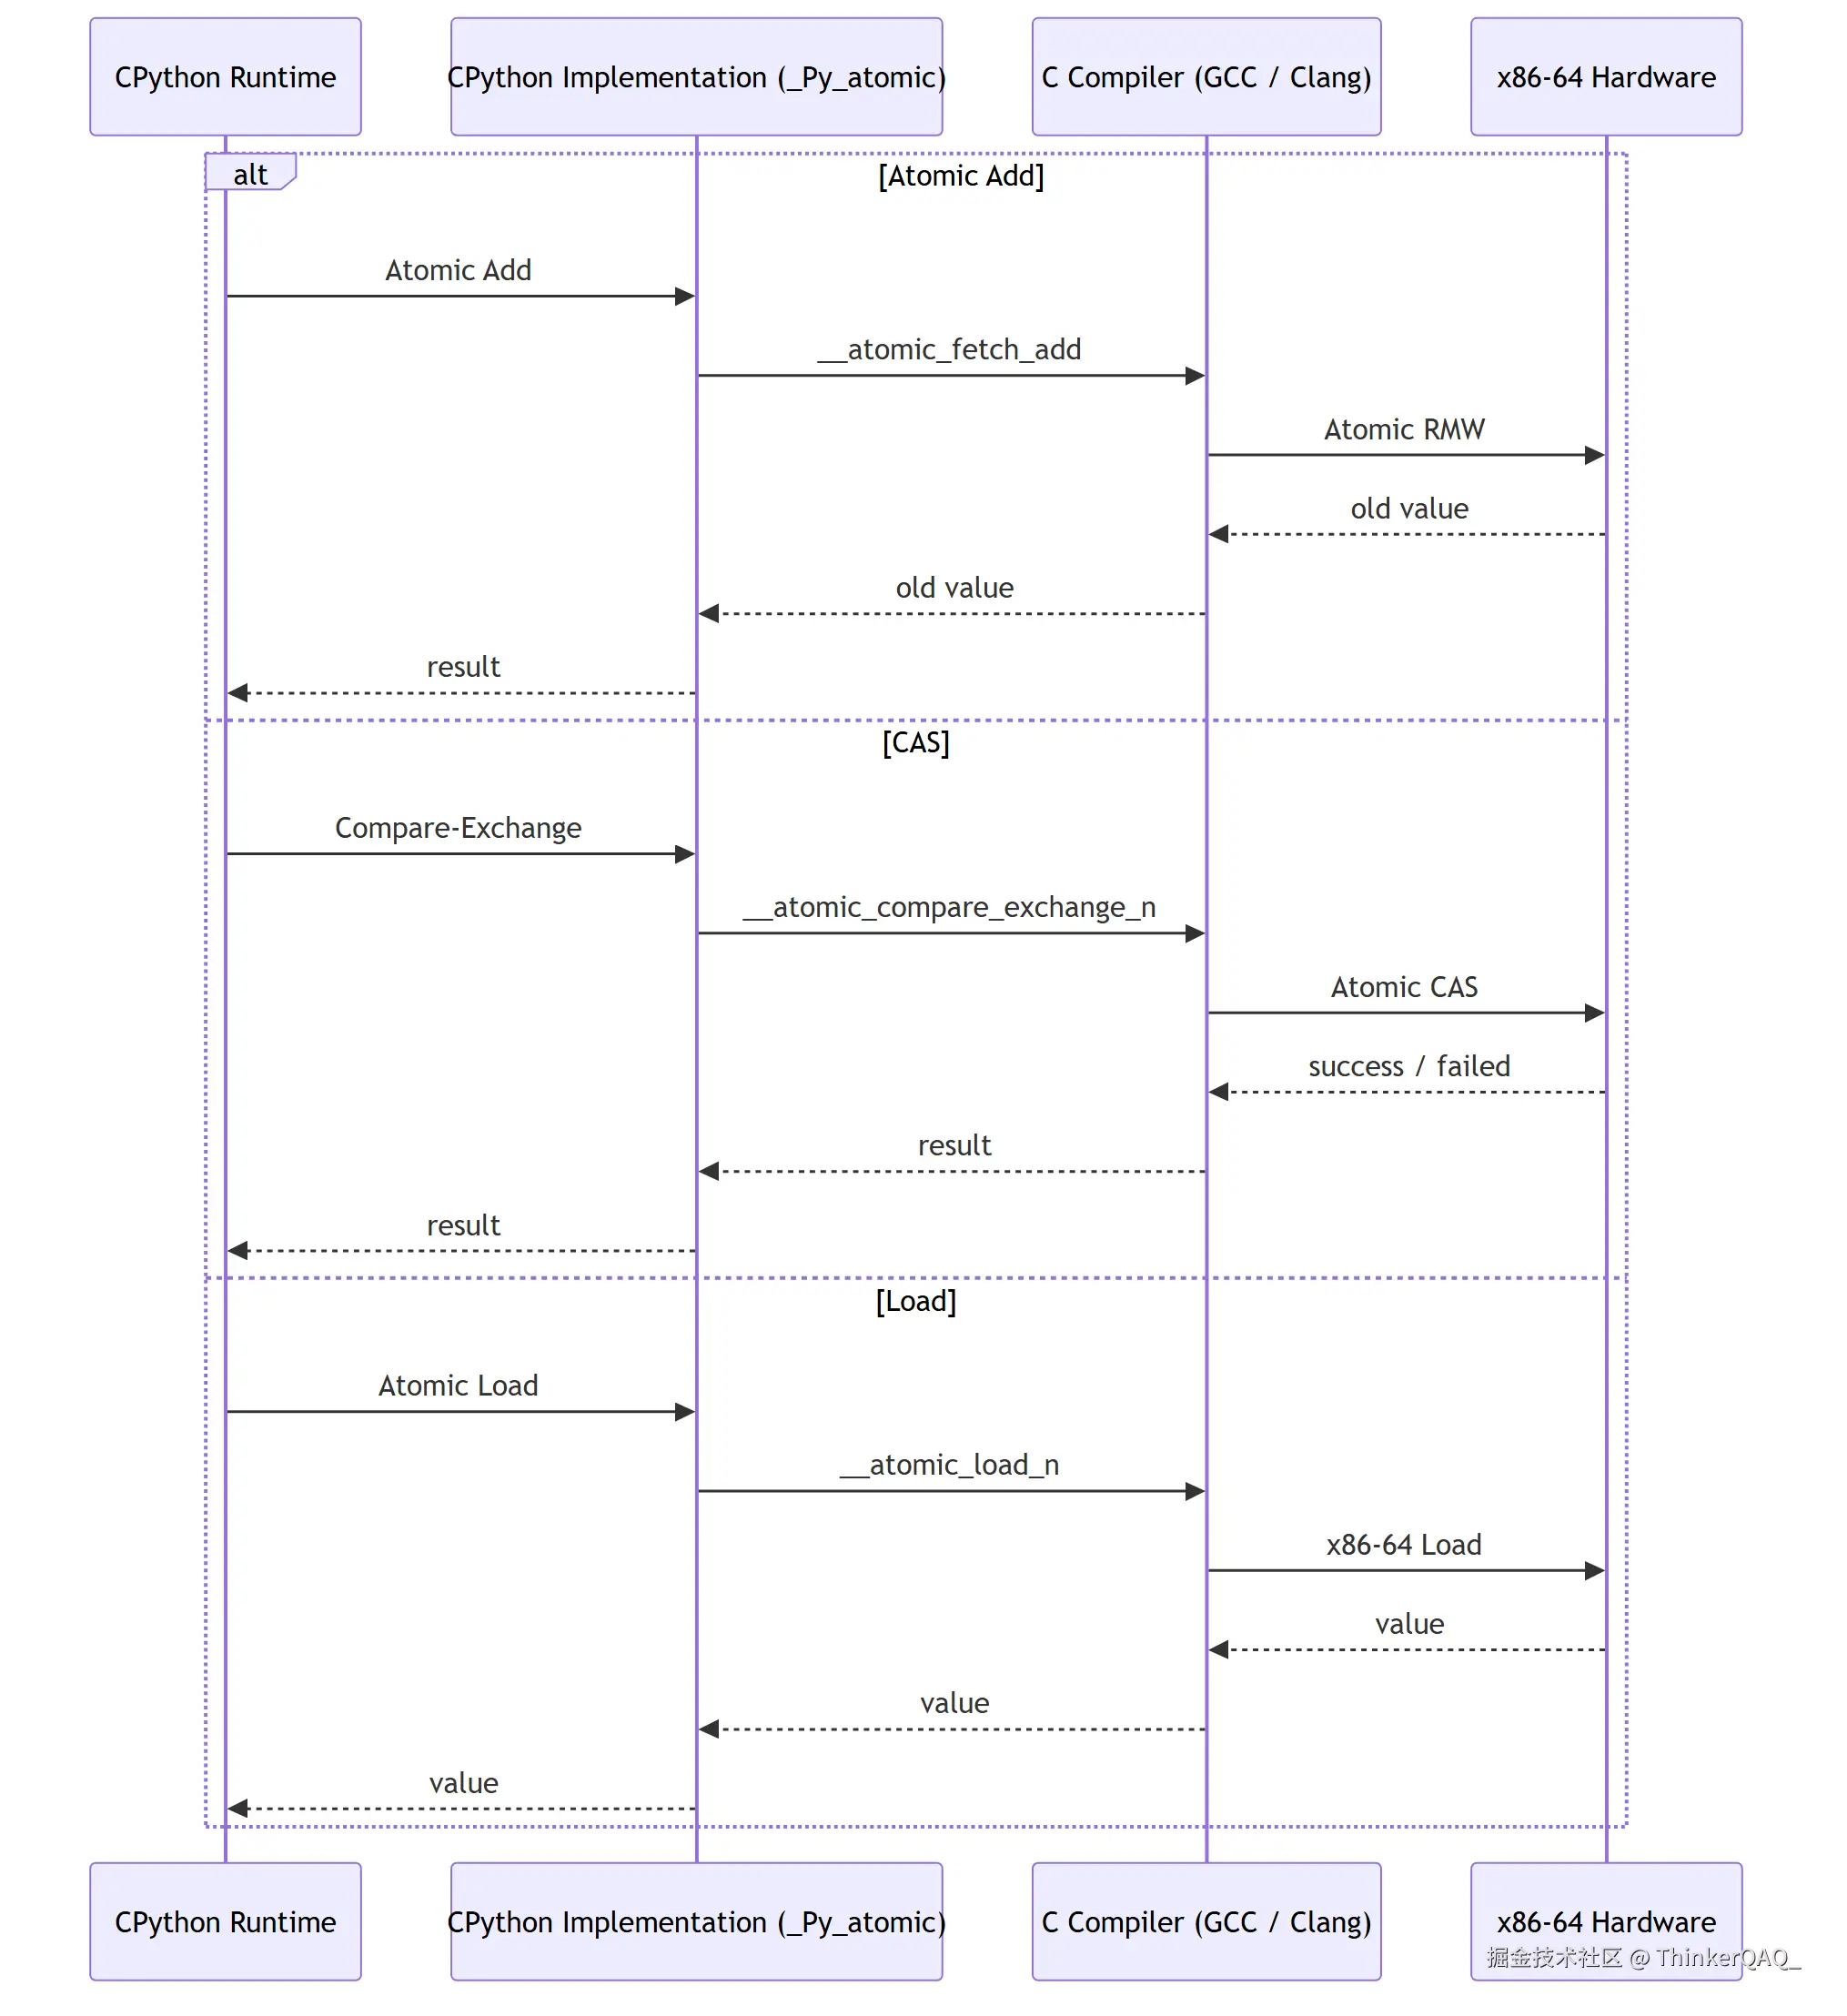
上面的时序图只保留跨层主流程。CPython 内部的核心路径可以进一步展开为:
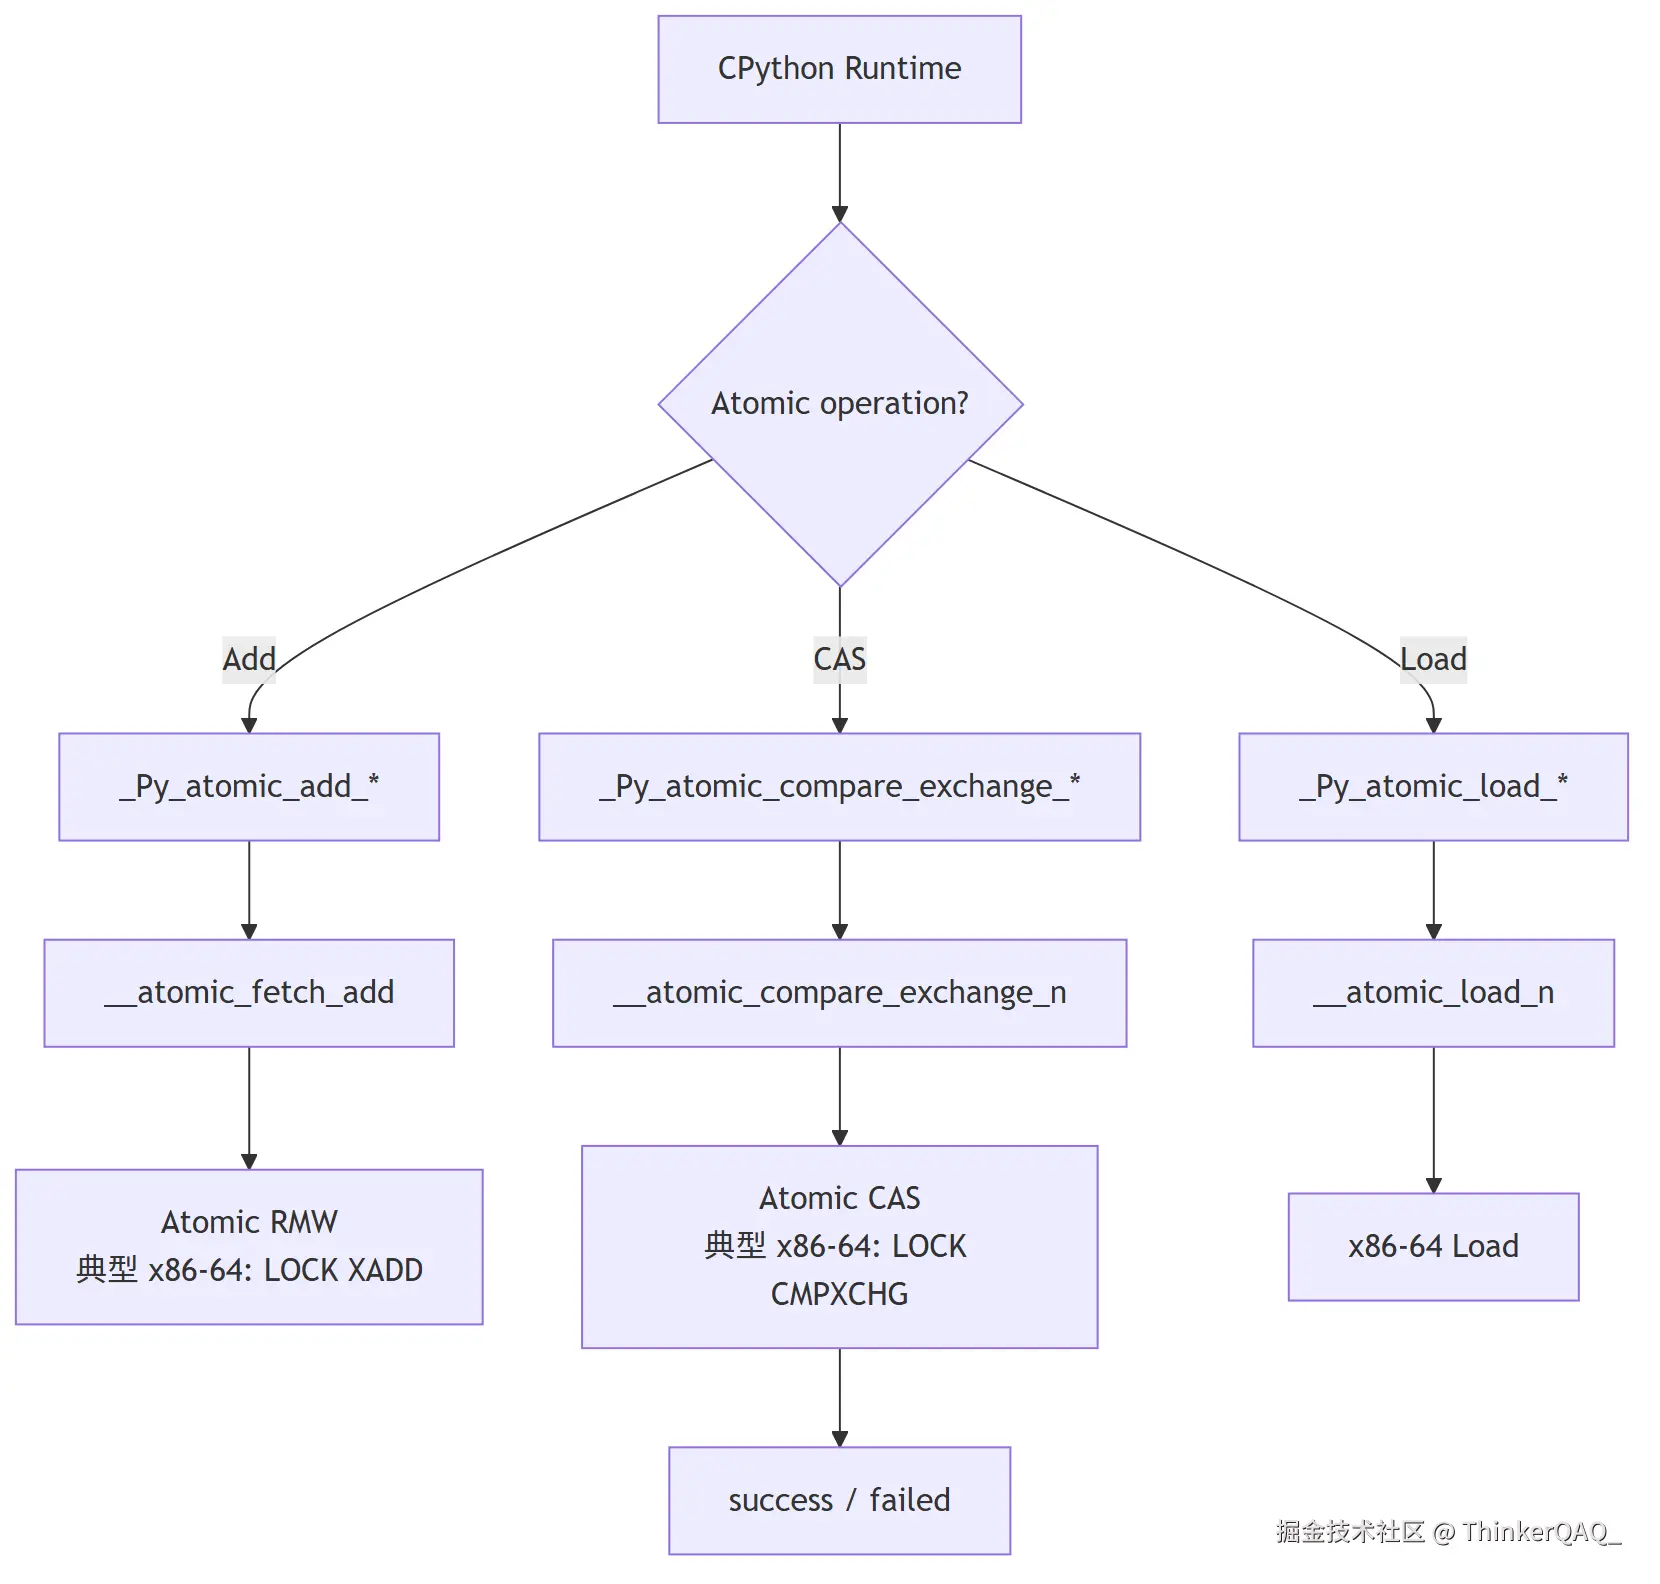
3.3 Atomicity
Atomicity 对应上面流程图里的两种原子更新:
text
Atomic Add:_Py_atomic_add_* → __atomic_fetch_add → Atomic RMW
CAS:       _Py_atomic_compare_exchange_* → __atomic_compare_exchange_n → Atomic CAS
在 x86-64 上,编译器通常会把这两类操作分别落实为 LOCK XADD 和 LOCK CMPXCHG 一类的原子指令。
3.4 Visibility 和 Ordering
Visibility 和 Ordering 对应上面流程图里的 Atomic 写入与读取边界:
text
写侧:Atomic Add / CAS
读侧:Atomic Load
_Py_atomic_* 将 Memory Order 传递给 GCC / Clang 的 __atomic_* builtins,再由编译器映射到目标架构的顺序约束与 Atomic 操作。
所以 CPython 与第一篇的硬件模型对应为:
text
Atomicity
  → Atomic Instruction
  → x86-64: LOCK XADD / LOCK CMPXCHG

Visibility
  → Cache Coherence
  → 典型 x86-64 CPU:MESI-family(如 MESIF / MOESI)

Ordering
  → Compiler Atomic Memory Order + Hardware Memory Ordering
  → __atomic_* order + x86-64 ordering rules
这里描述的是 CPython Runtime 的实现,不把它提升成 Python 应用层的 Memory Model。
实现可以继续查看 pyatomic.h 和 pyatomic_gcc.h。
4. 三种实现的共同套路
看完 Java、Go 和 CPython,把具体 API 拿掉,Atomic 做的事情其实很固定。
4.1 一次更新怎么做到不可分割?
普通的 read-modify-write 是三步:
text
Load
  ↓
Modify
  ↓
Store
问题是其他执行单元可以插进来:
text
CPU A                       CPU B

Load 0                      Load 0
Add 1                       Add 1
Store 1                     Store 1
Atomic 做的事情就是把这三步收成一次操作:
text
Atomic RMW
   │
   ├── Add
   ├── Swap
   └── CAS
继续往下,最终由 CPU 的原子指令完成。
4.2 同时更新冲突了怎么办?
如果是 Atomic Add,两次更新都要完成:
text
counter = 0

CPU A                       CPU B

Atomic Add
0 → 1

                            Atomic Add
                            1 → 2
先后顺序可以不同,但不会丢掉其中一次更新。
如果是 CAS,情况不同:
text
CPU A                       CPU B

CAS 0 → 1                  CAS 0 → 1
    │                           │
    ▼                           ▼
  success                     failed
CAS 失败以后,上层代码决定怎么办:
text
CAS
 │
 ├── success ──> done
 │
 └── failed
       │
       ├── return false
       │
       └── reload → retry
所以 Atomic 没有 Mutex 那条固定的 Spin → Park → Wakeup 路径。Add 直接完成一次原子更新;CAS 失败则返回失败,是否重试由上层决定。
4.3 为什么还能保证 Visibility 和 Ordering?
Atomicity 只保证"这一笔更新不能被拆开"。
Atomic 前后的普通读写还要满足上层规定的内存顺序:
text
前面的普通写入
      │
      ▼
Atomic Update
      │
      ▼
Atomic Read
      │
      ▼
后面的普通读取
这条关系继续往下由三层保证:
text
Language / Runtime Memory Semantics
        ↓
Compiler Ordering
        ↓
Hardware Memory Ordering + Cache Coherence
所以三种实现虽然 API 不同,最终都在解决同三件事:
text
一次更新不可分割
        +
冲突时怎么处理
        +
前后的内存访问不能乱
5. Atomic 和 Mutex 有什么区别?
最简单的区别只有一句:
Atomic 处理一次共享状态操作;Mutex 保护一段代码。
5.1 一次状态更新,两种做法
比如只想把一个计数器加一。
Mutex:
text
Lock
  ↓
counter++
  ↓
Unlock
Atomic:
text
Atomic Add(counter, 1)Mutex 的思路是:
text
先让一个执行单元进入
        ↓
再执行这段代码
        ↓
最后退出
Atomic 的思路是:
text
这一次更新本身
直接不可分割
如果问题真的只有一次 Add、CAS、Swap 或 Load / Store,Atomic 不需要再包一层临界区。
5.2 多个 Atomic 为什么不能代替一把 Mutex?
假设一次操作要同时改两个状态:
text
balance -= 100
count++
把两个变量分别做成 Atomic:
text
Atomic balance -= 100
        ↓
        ← 其他线程可能在这里读到中间状态
        ↓
Atomic count++
只能保证两次更新各自不可分割,不能保证它们合起来也是一个整体。
Mutex 可以直接把两步包起来:
text
Lock
  ↓
balance -= 100
count++
  ↓
Unlock
在这段临界区结束以前,其他竞争者不能进入同一段受保护代码。
所以问题一旦从"改一个状态"变成"这几步必须一起完成",Mutex 就更容易表达。
5.3 怎么选?
直接看你要保护什么:
text
一次状态操作
Add / CAS / Swap / Load / Store
        ↓
      Atomic
text
一段逻辑
读取 → 判断 → 修改多个状态
        ↓
      Mutex
两者也不是完全独立的。
Mutex 自己在实现"谁先拿到锁"时,底层通常就会使用 Atomic / CAS:
text
Atomic / CAS
    ↓
竞争锁状态
    ↓
Mutex
    ↓
保护临界区
所以可以把关系理解成:
text
Atomic:解决一次共享状态更新
Mutex:在 Atomic 等底层能力之上,再提供一整段临界区
6. 下一篇:volatile
Atomic 解决的是 counter++ 这类 RMW 的原子更新。
如果不需要 RMW,只需要让一个线程的写入对另一个线程可见,并建立正确顺序,就进入了 volatile 的问题。
下一篇继续从语言规则开始讨论 Visibility 和 Ordering。
本文首发于 ThinkerQAQ 的个人博客,由作者本人同步发布。原文可能持续修订,最新版本请以个人博客为准。