从0到1吃透Function Calling:Spring AI完整实战
本文是一次完整的 Function Calling 学习与实战记录:从"模型到底怎么用你的 Java 方法"的地基纠偏,到按阿里巴巴编码规范四层落地一个真实查库工具,再到实测对比与一个流式排障案例的完整复盘------配 7 张手绘概念图和全部真实代码。 技术栈:Spring Boot 3.4 + Spring AI 1.0.0 GA + 阿里百炼 DashScope(OpenAI 兼容模式)+ MySQL(业务库)/ PostgreSQL + pgvector(RAG 主库)。 完整代码见仓库。上一篇 Prompt Engineering 已发;Agent、MCP 留到后续篇章,本文只专注"让大模型用上你的 Java 方法"这一件事。
〇、先看全景:Function Calling 在体系里的位置
上一篇 Prompt Engineering 立过一个认知:大模型是接龙机器,只会逐 token 输出文字,改 Prompt 改的是题面不是脑子。这带来一个天然残缺------模型只有嘴,没有手。它的知识冻结在训练时刻,查不了实时数据库,调不了内部系统,算不了今天的库存。
Function Calling(函数调用,也叫 Tool Calling 工具调用)就是补上这只手的机制:让模型能"使用"程序里的方法------查数据库、调 API、算数据。但它和直觉的第一层理解就有偏差:这只手不是模型的,从头到尾都是工程的。
本文的实战载体延续上一篇的"设备运维问答助手"(Spring AI + pgvector):知识库里是 AGV 故障知识,这一站给它接上一个真实 MySQL 里的业务基础数据(base_entity 表,约 300 条记录,含 44 台 AGV、工作站、容器、库位),让模型能查实时基础资料。
一、地基:先破三个错觉
学 Function Calling 最忌讳直接抄 @Tool 注解的用法。动手之前必须先回答三个问题:模型真的执行了方法吗?一次调用就结束了吗?模型看得到代码吗? 这三个答案决定了后面所有工程决策为什么长那样。
1.1 错觉一:"模型调用了你的 Java 方法"
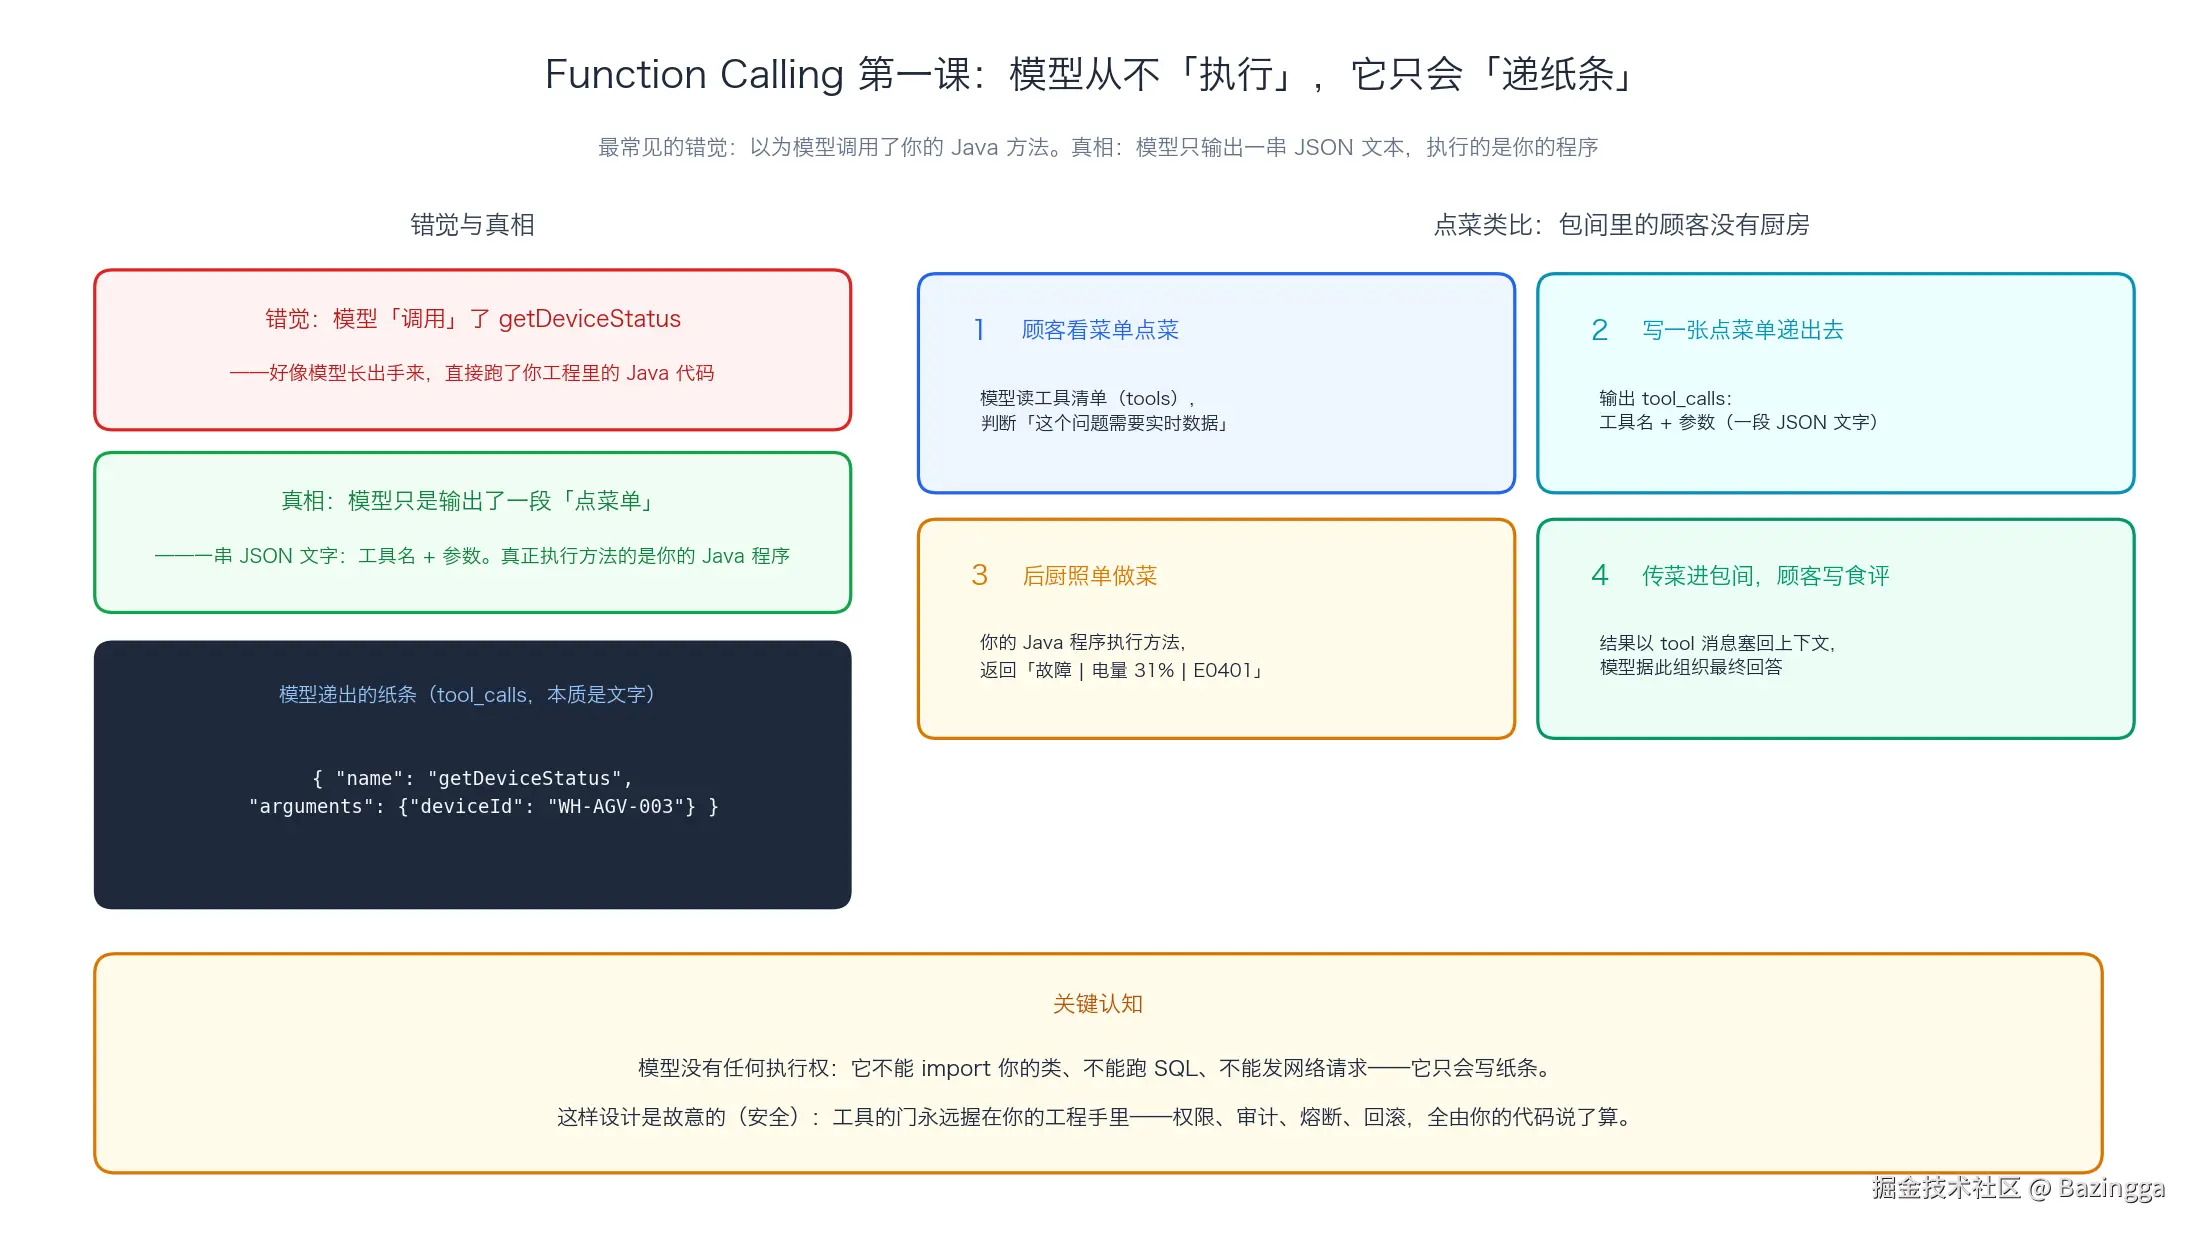
最常见的第一反应就是这句话------好像模型长出手来,伸进你的工程里跑了代码。真相是:模型从头到尾只干了一件它会干的事------输出文字。只不过这次输出的文字,恰好长成了一个 JSON 格式的"点菜单":
json
{ "name": "getDeviceStatus", "arguments": {"deviceId": "WH-AGV-003"} }真正拿起这张纸条、找到对应方法、执行、拿到返回值的,是 Java 程序。用餐厅类比记住它:模型是包间里的顾客,只有嘴没有厨房------看菜单(工具清单)、写点菜单递出去(tool_calls);后厨(代码)照单做菜;菜端回包间(结果回传),顾客尝完写食评(组织最终回答)。
为什么故意设计成这样?安全。Spring AI 官方文档的定论:模型永远不直接触碰工具背后的 API------权限校验、审计日志、熔断限流、危险操作拦截,这些门全握在工程手里。要是模型真能直接执行代码,上一篇讲的注入攻击就不是"概率游戏",而是"远程代码执行"了。
1.2 错觉二:一次调用就结束------其实是四步一个循环
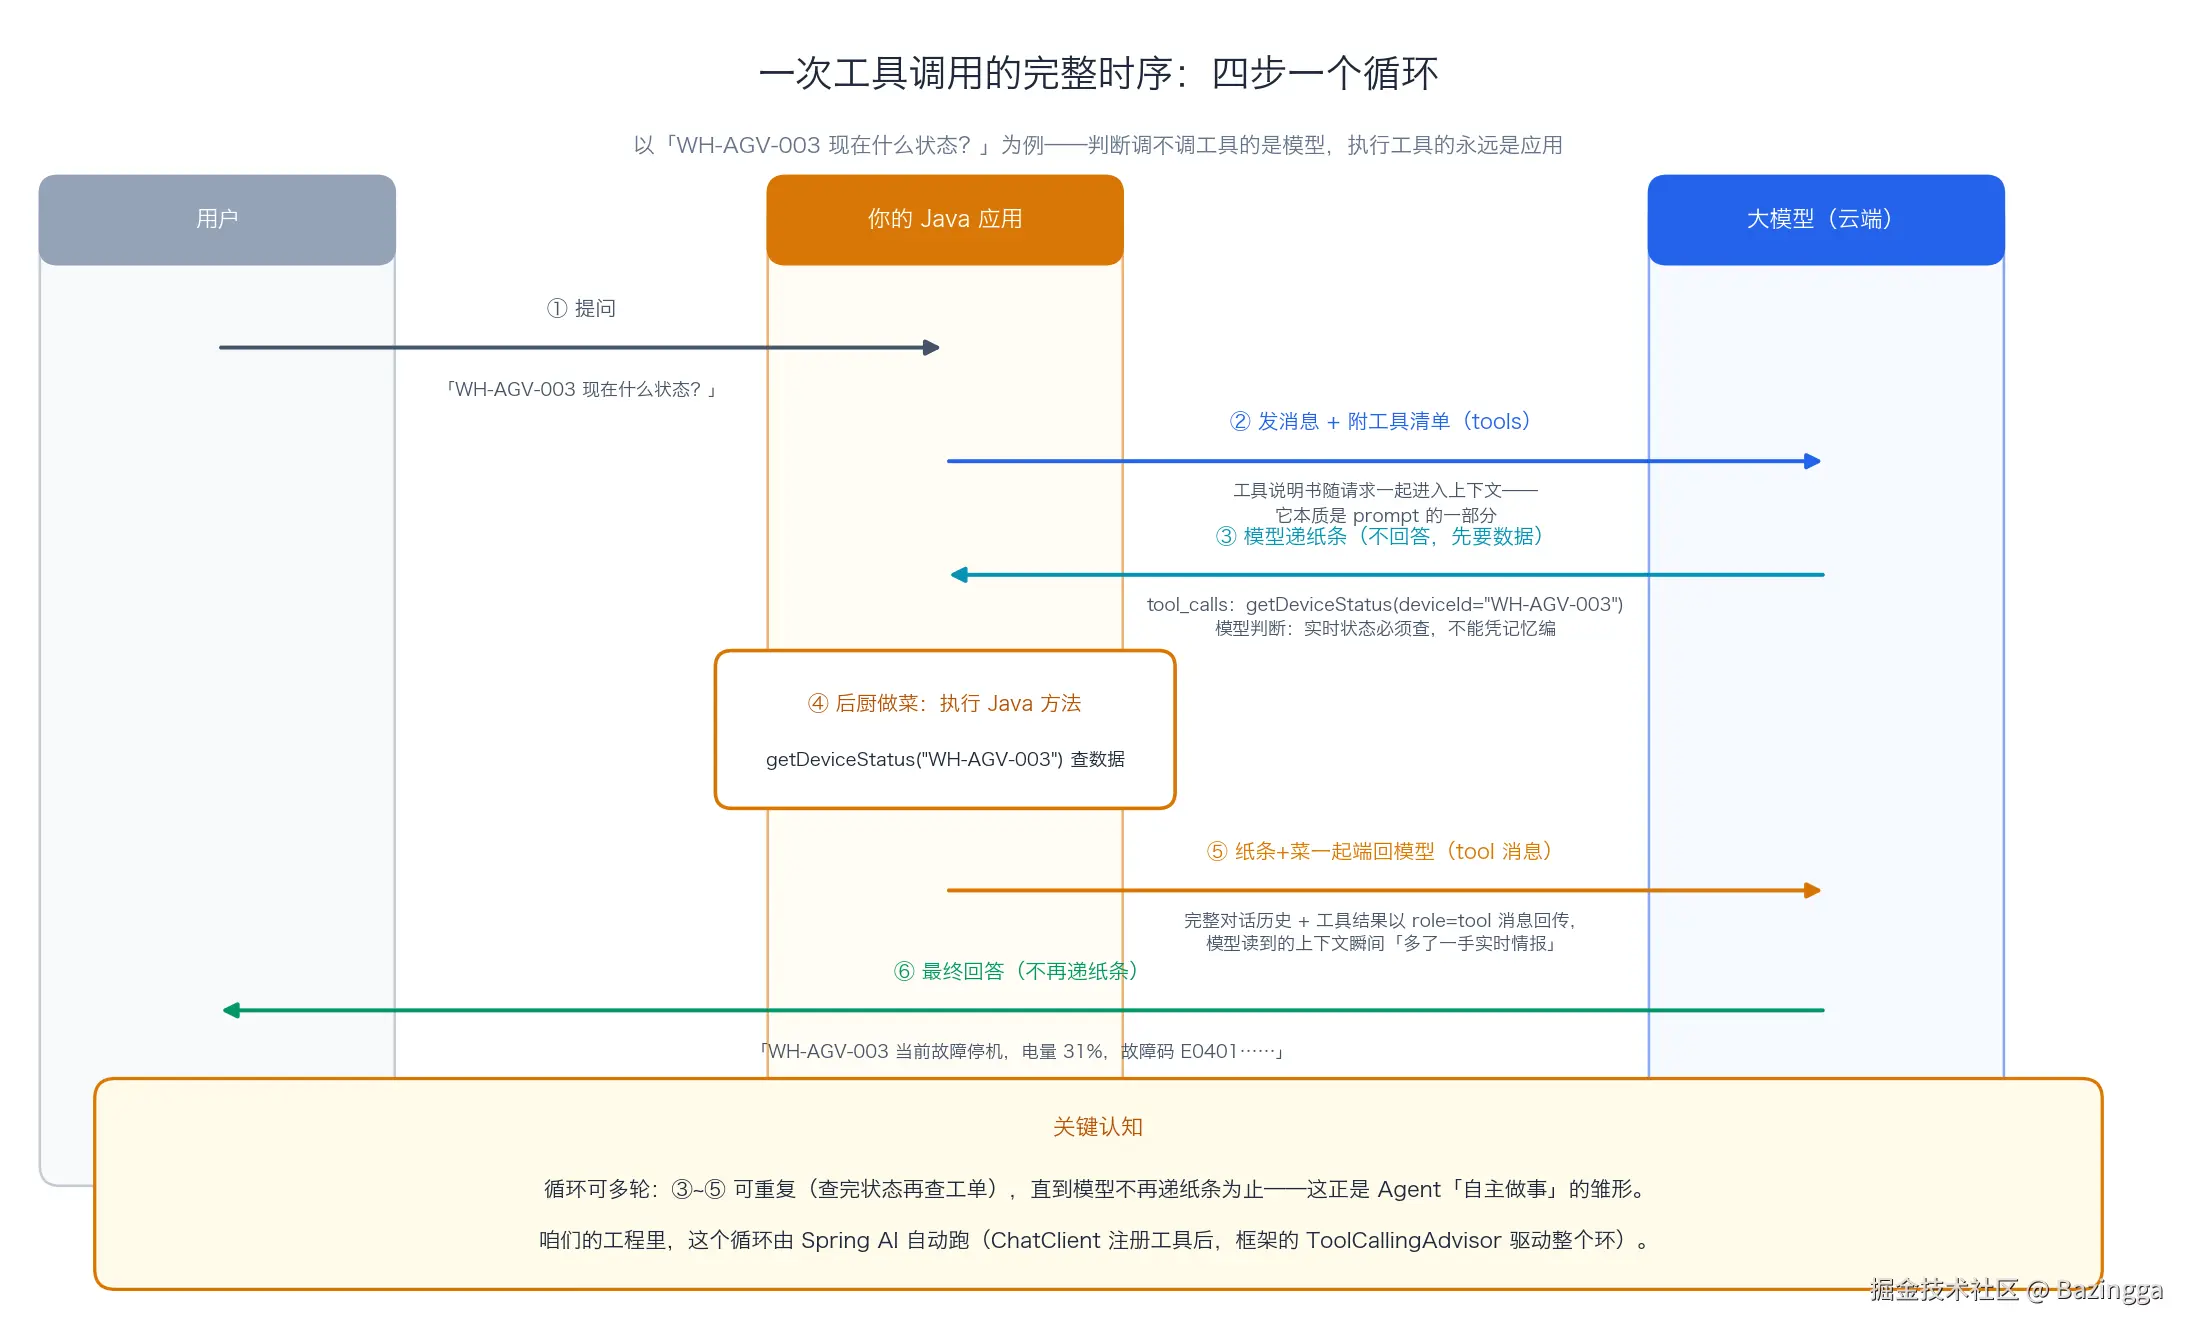
这张时序图是 FC 的全部机制(与 DashScope 官方文档的"工作原理五步"一一对应):
- 发消息附菜单 :应用把用户消息和工具清单(
tools参数)一起发给模型------注意,工具说明书是随请求进入上下文的,它本质就是 prompt 的一部分; - 模型递纸条 :模型判断"实时状态必须查,不能凭记忆编",返回的不是答案,是
tool_calls(工具名+参数);不需要工具时直接回自然语言; - 后厨做菜:应用执行 Java 方法;
- 端菜回包间 :完整对话历史 + 工具结果,以
role=tool的消息回传(上一篇埋过的第四种角色 tool),模型据此写出最终回答。
两个要点:循环可多轮 ------查完设备状态,模型可能接着要工单、要维修记录,直到它不再递纸条为止,这个"循环直到完成"的形态就是 Agent"自主做事"的雏形;循环是框架自动跑的 ------ChatClient 注册工具后,业务代码只有一行 .call(),Spring AI 的 ToolCallingAdvisor 在背后驱动整个环。
1.3 错觉三:模型看得到代码------它只看得到一份 JSON 说明书
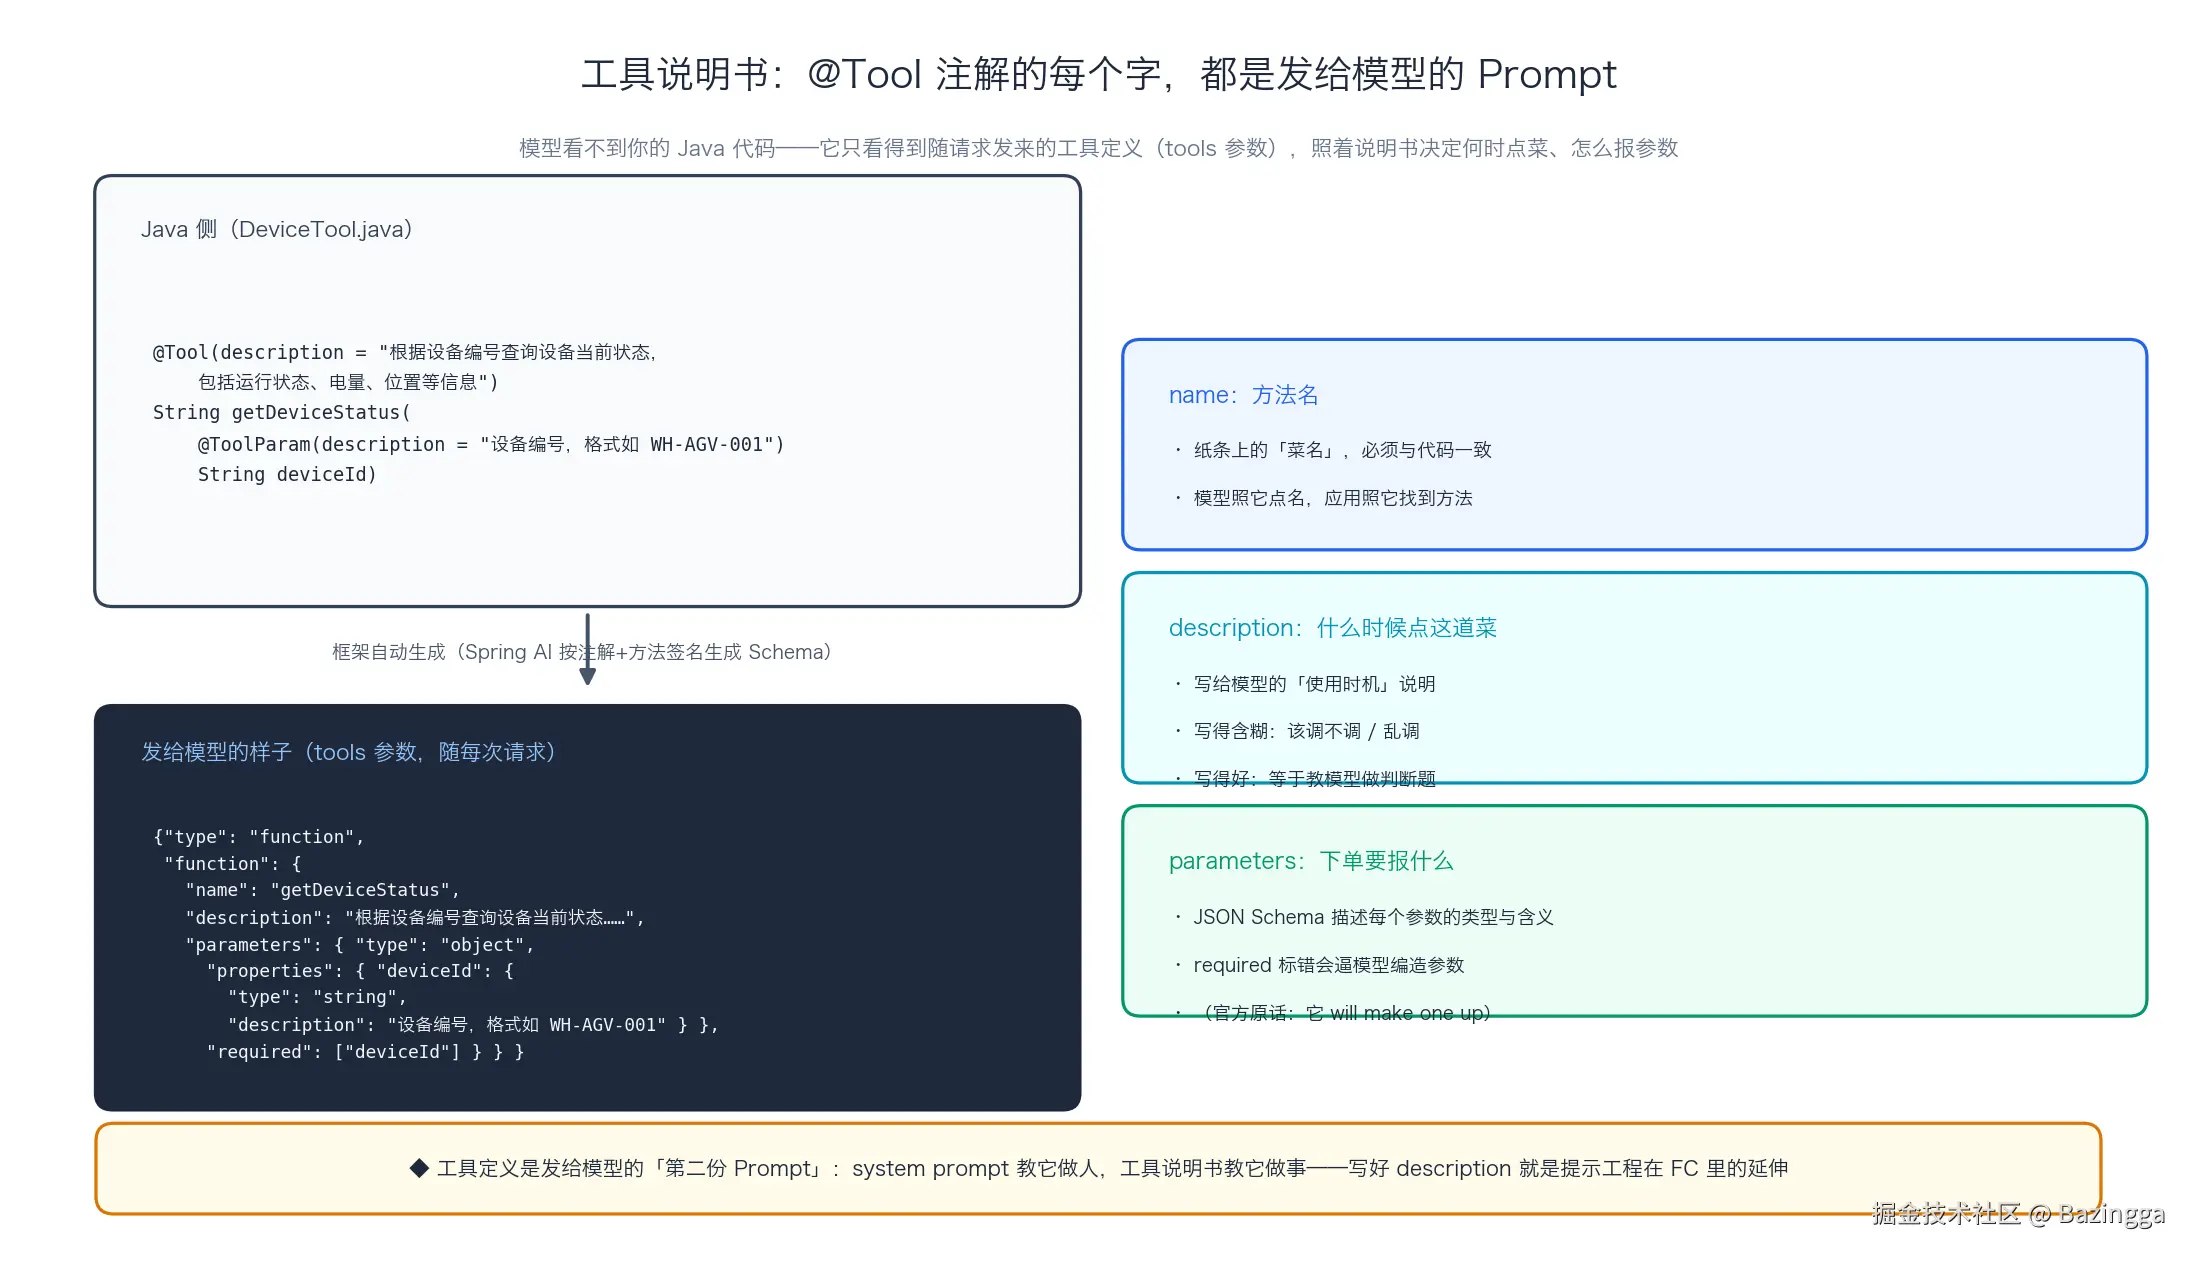
模型看不到任何 Java 代码,它在每次请求里读到的只是 tools 参数里这份 JSON 说明书,靠三样东西做决策:
- name:纸条上的菜名,必须与代码一致------模型照它点名,应用照它找方法;
- description :告诉模型什么时候点这道菜。写得含糊,该调不调或乱调;写得好,等于教模型做判断题;
- parameters (JSON Schema):下单要报什么参数。这里有个官方文档明示的陷阱:required 标错了会逼模型编造参数 ------把一个模型不可能知道的参数标成必填,它不会报错,它会编一个值交差(官方原话:it will make one up)。
所以工具定义是发给模型的第二份 Prompt :system prompt 教它做人,工具说明书教它做事。上一篇"稳定前缀吃缓存"的纪律在这里也适用:工具定义每次请求都发,顺序和结构必须逐字节一致,否则上下文缓存全断。
二、从演示级到生产级:一个工具的四层落地
概念清楚了,动手时最先撞上的问题是写法分级 :网上教程的 @Tool 示例几乎都停在演示级,而生产代码需要的是另一副骨架。这一章把两级写法的差距摆开------演示级不是错误答案,但它只在"跑通概念"这一步是正确答案。
2.1 演示级写法:能跑通,但上不了生产
演示级写法长什么样:DriverManager 裸连 MySQL、SQL 直接写在工具方法里、查完拼字符串返回。用 curl 测四组场景(指名查询、清单查询、无关问题、不存在编码)全部正常------FC 链路本身是通的。
但把它放到生产标准下审视,四个问题立刻现形:
| 演示级写法 | 为什么上不了生产 |
|---|---|
DriverManager 裸连 |
无连接池,每次查询建断连接,高并发下拖垮数据库 |
| SQL 写在工具类里 | 工具类应该只做 FC 适配,SQL 属于 DAO 层 |
| 没有分层 | 业务逻辑、数据访问、异常处理全糊在一个方法里,无法维护 |
| 查询无上限 | 模型要是问"列出全部",几百条数据直接塞爆上下文窗口 |
这个对比说明了 FC 工程化的一个本质:"能跑"和"能上线"之间隔着一整个分层体系------工具类只是模型世界和工程世界之间的翻译官,翻译官背后的每一层(校验、分层、连接管理、异常兜底)一个都不能少。
2.2 生产级重写:按阿里规约四层架构
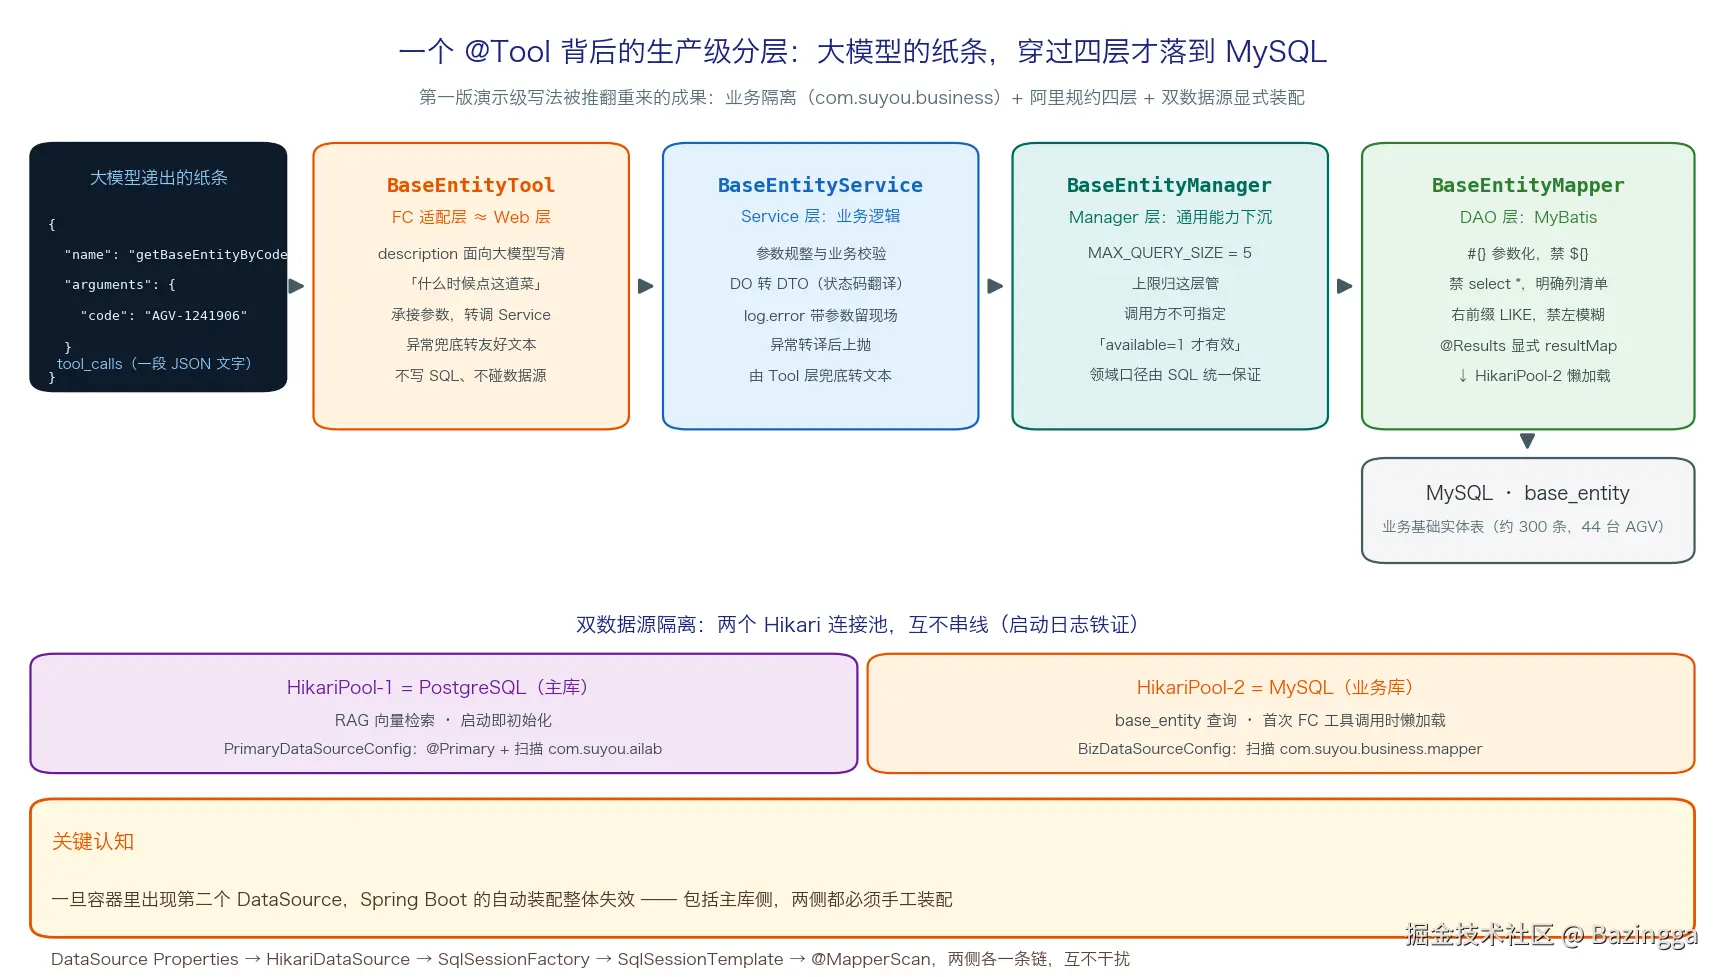
重写后的结构:业务代码隔离在独立的 com.suyou.business 包里(业务隔离),一个 FC 调用的完整路径是------大模型递纸条 → BaseEntityTool(FC 适配层,角色相当于 Web 层)→ BaseEntityService(业务逻辑)→ BaseEntityManager(通用能力下沉)→ BaseEntityMapper(DAO)→ MySQL。
FC 适配层只做三件事:description 面向模型写清楚"什么时候点这道菜"、承接参数转调 Service、把异常兜底转成给模型的友好文本------工具直接抛异常会中断对话链路,而返回"查询失败"文本能让模型如实转告用户:
java
@Component
public class BaseEntityTool {

    @Resource
    private BaseEntityService baseEntityService;

    @Tool(description = "按编码精确查询业务基础实体(base_entity 表):设备、工作站、容器、库位等基础资料。"
            + "当用户给出明确编码(如 AGV-1241906)要求查询实体详情时使用")
    public String getBaseEntityByCode(
            @ToolParam(description = "实体编码,例如 AGV-1241906") String code) {
        if (code == null || code.isBlank()) {
            return "实体编码不能为空,请提供形如 AGV-1241906 的编码。";
        }
        try {
            BaseEntityDTO entry = baseEntityService.queryByCode(code.trim());
            if (entry == null) {
                return "未找到编码为 " + code.trim() + " 的正常状态实体。可能编码有误,或该实体已废弃/删除。";
            }
            return formatEntry(entry);
        } catch (Exception e) {
            return "查询失败:" + e.getMessage();
        }
    }

    @Tool(description = "按类型搜索业务基础实体(base_entity 表)列表,最多返回 5 条。"
            + "当用户问「有哪些某类设备/站点/容器」这类没有明确编码的清单类问题时使用")
    public String searchBaseEntity(
            @ToolParam(description = "实体类型,大写,如 AGV、STATION、CONTAINER、SLOT、ACTOR、SHUTTLE") String type,
            @ToolParam(description = "名称或编码关键词(可选,前缀匹配,用于进一步过滤)", required = false) String keyword) {
        // ......参数转调 Service,空结果返回提示文本,异常兜底转友好文本
    }
}
注意 searchBaseEntity 的 description 里写死了"最多返回 5 条"------这个 5 不是随便定的,归 Manager 层管:
java
@Component
public class BaseEntityManager {

    /** 单次列表查询上限:内部运维查询场景足够,保护数据库与模型上下文 */
    private static final int MAX_QUERY_SIZE = 5;

    @Resource
    private BaseEntityMapper baseEntityMapper;

    public List<BaseEntityDO> listEntryByType(String type, String keyword) {
        return baseEntityMapper.selectByType(type, keyword, MAX_QUERY_SIZE);
    }
}
上限归 Manager 管、调用方不可指定------防止各自传参造成口径漂移,也防止大结果集拖垮数据库和模型上下文窗口。这是阿里工程规约里 Manager 层"沉淀可复用通用规则"的标准用法。
DAO 层 的 Mapper 是 MySQL 规约的落地标本------明确列清单禁 select *、#{} 预编译参数化禁 ${}、右前缀 LIKE 禁左模糊、显式 resultMap:
java
@Mapper
public interface BaseEntityMapper {

    @Select("""
            SELECT id, gmt_create, gmt_modified, type, category, code, name, location, note, available
            FROM base_entity
            WHERE code = #{code} AND available = 1
            LIMIT 1
            """)
    @Results(id = "baseEntityResultMap", value = { /* ......列与属性显式映射 */ })
    BaseEntityDO selectByCode(@Param("code") String code);

    @Select("""
            <script>
            SELECT id, gmt_create, gmt_modified, type, category, code, name, location, note, available
            FROM base_entity
            WHERE type = #{type} AND available = 1
            <if test="keyword != null and keyword != ''">
                AND (name LIKE CONCAT(#{keyword}, '%') OR code LIKE CONCAT(#{keyword}, '%'))
            </if>
            ORDER BY id
            LIMIT #{limit}
            </script>
            """)
    @ResultMap("baseEntityResultMap")
    List<BaseEntityDO> selectByType(@Param("type") String type,
                                    @Param("keyword") String keyword,
                                    @Param("limit") int limit);
}
LIMIT #{limit} 的值由 Manager 层传入,上层想多要也没有入口。Service 层 负责参数规整(大小写归一)、DO 转 DTO(把 available 状态码翻译成"正常/废弃/软删除"标签,对模型屏蔽存储细节)、以及异常处理------数据访问异常在本层 log.error 记录(带参数保留案发现场),再转译为运行时异常上抛,由 Tool 层兜底转成给模型的文本:
java
public BaseEntityDTO queryByCode(String code) {
    try {
        BaseEntityDO entryDO = baseEntityManager.getEntryByCode(code);
        return entryDO == null ? null : toDTO(entryDO);
    } catch (Exception e) {
        log.error("查询业务基础实体失败, code={}", code, e);
        throw new IllegalStateException("业务基础实体查询失败", e);
    }
}四层各归其位后有个额外收益:换掉数据源、改掉表结构,Tool 层的 description 一行都不用动------菜单稳定,模型行为的确定性就有了工程保障。
2.3 双数据源:这一站最硬的坑
新麻烦随之而来:工程的主库是 PostgreSQL(RAG 向量检索用),现在引入第二个数据源 MySQL------一旦容器里出现第二个 DataSource,Spring Boot 的数据源与 MyBatis 自动装配整体失效,包括主库侧。两侧都必须手工装配完整的链路:DataSourceProperties → HikariDataSource → SqlSessionFactory → SqlSessionTemplate → @MapperScan。
java
@Configuration
@MapperScan(basePackages = "com.suyou.business.mapper", sqlSessionFactoryRef = "bizSqlSessionFactory")
public class BizDataSourceConfig {

    @Bean
    @ConfigurationProperties("biz.datasource")
    public DataSourceProperties bizDataSourceProperties() {
        return new DataSourceProperties();
    }

    @Bean
    @ConfigurationProperties("biz.datasource.hikari")
    public HikariDataSource bizDataSource() {
        return bizDataSourceProperties()
                .initializeDataSourceBuilder()
                .type(HikariDataSource.class)
                .build();
    }

    @Bean
    public SqlSessionFactory bizSqlSessionFactory(@Qualifier("bizDataSource") DataSource dataSource) throws Exception {
        MybatisSqlSessionFactoryBean factoryBean = new MybatisSqlSessionFactoryBean();
        factoryBean.setDataSource(dataSource);
        MybatisConfiguration configuration = new MybatisConfiguration();
        configuration.setMapUnderscoreToCamelCase(true);
        factoryBean.setConfiguration(configuration);
        return factoryBean.getObject();
    }
    // ......SqlSessionTemplate 同理
}
主库侧(PG)同构写一份 PrimaryDataSourceConfig,加 @Primary 并扫描 com.suyou.ailab,把原来自动装配干的事显式接管回来。连接配置走 yml(凭据脱敏):
yaml
biz:
  datasource:
    url: jdbc:mysql://<你的MySQL主机>:3306/<库名>?useSSL=true&serverTimezone=Asia/Shanghai&connectTimeout=5000&socketTimeout=15000
    username: <用户名>
    password: <密码>
    hikari:
      maximum-pool-size: 5      # 小体量运维查询场景
      minimum-idle: 2
      connection-timeout: 5000
max-lifetime: 1800000 # 30 分钟,须小于数据库侧 wait_timeout启动后日志给了双池隔离的铁证:HikariPool-1 = PostgreSQL (启动即初始化,RAG 文档向量化用它)、HikariPool-2 = MySQL(首次 FC 工具调用时才懒加载)------两个池各自独立、互不串线。RAG 链路回归测试照常通过,证明主库被显式接管后毫发无损。
三、实测:模型怎么"知道"该调哪个工具
工具注册完成后,一个值得先想清楚再动手测的问题:工程里没有任何一行代码显式调用 BaseEntityTool,它到底在哪个阶段被调用?模型又怎么知道该调它?
3.1 @Tool 的生命周期:五个阶段
把机制拆开,@Tool 注解本身只活到应用启动那一刻:
| 阶段 | 发生时机 | 执行者 | 发生了什么 |
|---|---|---|---|
| 0. 注册 | 应用启动,一次性 | 工程 | 框架反射读取 @Tool 注解 → 生成 JSON 菜单,挂进 ChatClient。注解的使命到此结束 |
| 1. 携带 | 每次发消息 | 工程 | 菜单和问题一起 塞进请求体(tools 字段)发给模型 |
| 2. 决策 | 云端 | 大模型 | 读了"问题 + 菜单"做语义匹配,输出点菜单 JSON------"知道调哪个"发生在这一步 |
| 3. 执行 | 工程 | Spring AI | 框架拿名字字符串去注册表查,反射调用 Java 方法 |
| 4. 回喂 | 云端 | 大模型 | 结果以 role=tool 消息追加进对话,模型再次推理出最终回答 |
关键纠偏:模型"选菜"的原理和它回答普通问题是同一个动作 ------读了上下文之后,输出概率最高的一串字,而这串字恰好是合法的点菜单 JSON(训练时见过海量"菜单+问题→点菜"样本)。菜单和 Java 方法是两样东西,靠方法名字符串这个唯一的契约连接------改了方法名而模型还按旧名点菜,框架就会报"找不到工具"。
3.2 五组实测:模型的自主判断比想象中细
应用启动、debug 日志打开(logging.level.org.springframework.ai: debug),五组场景一次跑完:
| 场景 | 提问 | 模型行为 | 判定 |
|---|---|---|---|
| T1 指名查询 | "查一下 AGV-1241906 的信息" | 调 getBaseEntityByCode(code="AGV-1241906"),按真实数据回答 |
✅ |
| T2 清单查询 | "库里有哪些工作站?" | 调 searchBaseEntity(type="STATION"),列 5 条 |
✅ |
| T3 无关问题 | "今天天气怎么样" | 不调任何工具,直接拒答并引导回运维话题 | ✅ |
| T4 不存在编码 | "查 AGV-99999999" | 工具返回"未找到",模型如实转告"可能编码有误或已废弃" | ✅ |
| T5 知识型提问 | "系统里的输送线设备有哪些?" | 最值得细看的一组 :先调 searchBaseEntity(type="CONVEYOR", keyword="CONVEYOR") 前缀匹配不到(输送线的 CONVEYOR 在子类型字段里,编码是 SC- 开头),模型自主降级去掉关键词重查,拿到结果后还解释了这个数据特性 |
✅✅ |
T5 的价值在于:没有任何一行代码教它"第一次查不到就换姿势重查" ------这是模型读了菜单 description 之后自己做的判断。日志里因果链肉眼可见:Executing tool call: getBaseEntityByCode 一行出现,紧接着就是 HikariPool-2 Starting------模型递纸条、后厨开火,两个世界的接口严丝合缝。
3.3 延伸对比:FC 查库和 RAG 查库是两种物种
这个工程里 RAG 链路的 /rag/search 接口会查库吗?必查 ------但它和 FC 查库完全不同:RAG 是先把问题文本发给 DashScope 做 embedding(这一步不查库),再拿向量去 PG 里做 ORDER BY embedding <=> query_vector 的数学题(这一步必查)。数据库只做数学题,不做阅读理解 ------语义理解被前置到了 embedding 环节。而 FC 是精确条件的相等查询。一句话分清三种出场方式:/rag/search 必查库、/api/chat 模型决定要不要调工具、工具被调了才查业务库。
四、主动权:FC 一定要用户发起吗
概念全部落地后,一个很自然的问题浮现出来:大模型可以主动 FC 吗?还是这个主动操作一定要由用户发起?
4.1 拆成三层看
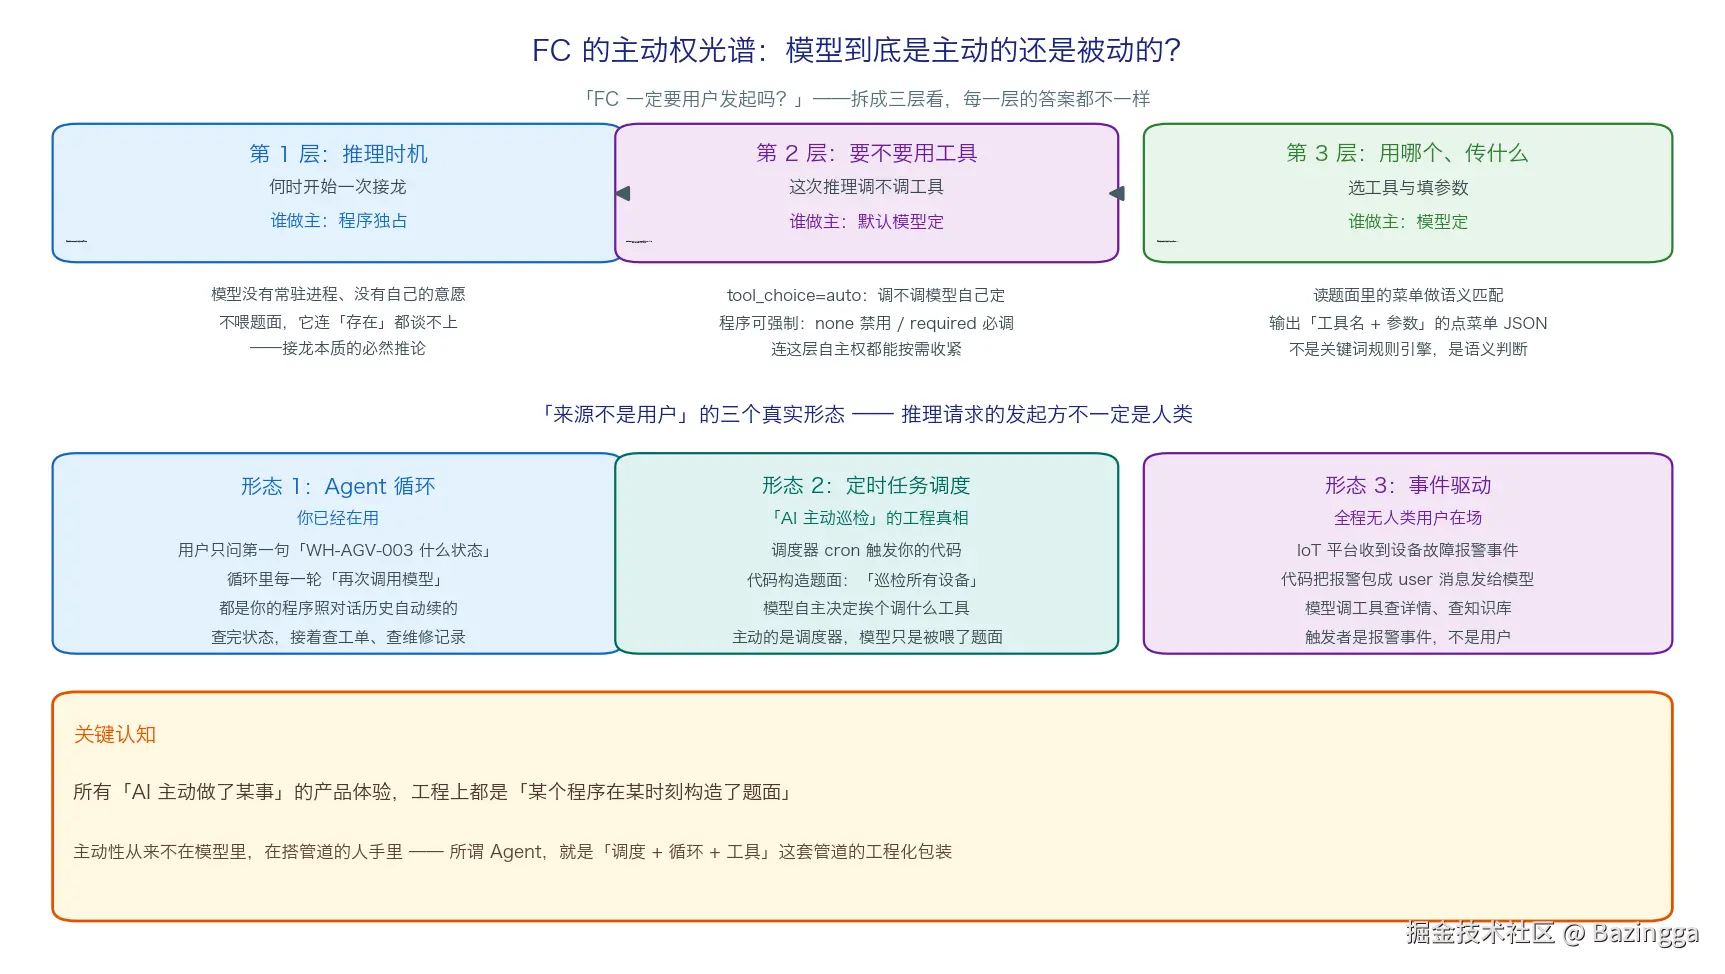
答案分三层,每一层的"谁做主"都不一样:
| 层次 | 谁做主 | 说明 |
|---|---|---|
| 推理时机(何时开始一次接龙) | 程序独占 | 模型没有常驻进程、没有自己的意愿------不喂题面,它连"存在"都谈不上 |
| 要不要用工具(这次推理调不调) | 默认模型定 | tool_choice=auto(默认)模型自主判断;程序可用 none 禁用 / required 强制 |
| 用哪个、传什么参数 | 模型定 | 读题面里的菜单做语义匹配 |
所以准确的说法不是"FC 一定要用户发起",而是:FC 一定发生在一次推理请求里,而推理请求的来源可以是任何东西。
4.2 来源不是用户的三个真实形态
- Agent 循环:用户只问第一句"WH-AGV-003 什么状态",循环里每一轮"再次调用模型"都是程序照对话历史自动续的;
- 定时任务 :产品里看到的"AI 每天主动巡检",工程实质是
cron 调度器 → 代码构造题面("巡检所有设备")→ 模型自主决定调什么工具------主动的是调度器; - 事件驱动:IoT 平台收到设备故障报警 → 代码把报警包成 user 消息发给模型 → 模型调工具查详情------触发者是报警事件,全程无人类用户在场。
结论一句话:所有"AI 主动做了某事"的产品体验,工程上都是"某个程序在某时刻构造了题面"------主动性从来不在模型里,在搭管道的人手里。这也是理解 Agent 的地基:所谓 Agent,就是"调度 + 循环 + 工具"这套管道的工程化包装。
五、流式深水区:一个把协议本质炸出来的案例
到这里同步链路全部跑通,但聊天产品的标配是流式输出------而流式 + FC 的组合里藏着一个教科书级的坑。这个案例值得完整复盘,因为它同时拆出了流式协议的本质和一套排障方法论。
5.1 现象:同步全绿,流式一开就炸
场景还原:同步接口(curl 走 /api/chat)的测试矩阵四组全绿;聊天页面(chat.html,走流式接口 /api/chat/stream)第一题就报错:
css
IllegalArgumentException: toolInput cannot be null or empty
    at org.springframework.ai.model.tool.DefaultToolCallingManager.executeToolCalls(...)
    at org.springframework.ai.openai.OpenAiChatModel.internalStream(...)
栈里 internalStream + Reactor Flux 操作符------流式路径。排障第一步是复现矩阵,把变量隔离干净:
| 流式 stream | 同步 call | |
|---|---|---|
| 有 FC 工具 | ❌ 500 报错 | ✅ 正常 |
| 无工具问题 | ✅ 正常 | ✅ 正常 |
只有"流式 + FC "这个组合炸。这也解释了同步测试为什么全绿------同步接口测不出流式 bug,这个案例暴露的测试方法论盲区是:测试矩阵必须覆盖"接口形态 × 有无工具"的每个组合。
5.2 三层证据链:模型无辜,锅在框架
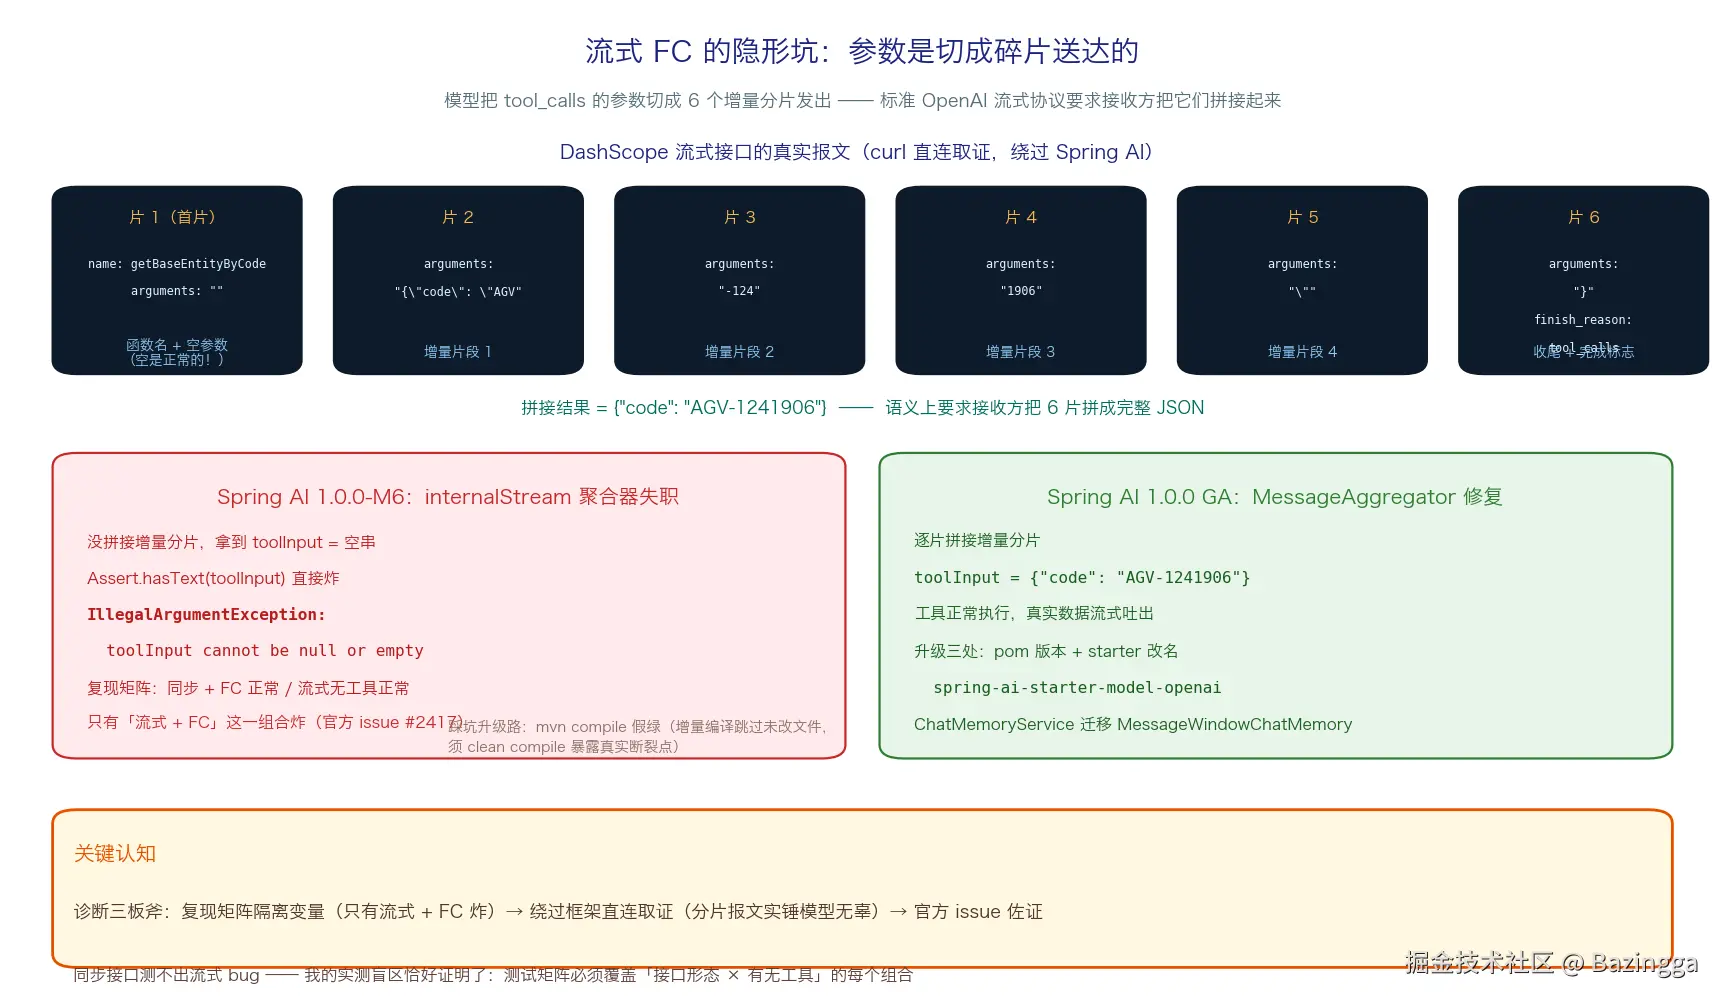
第一层:复现矩阵 (如上)。第二层:绕过框架直连取证 ------curl 直调 DashScope 的流式接口,亲眼看模型返回的 tool_calls 原始报文:
css
片1: {"name": "getBaseEntityByCode", "arguments": ""}   ← 首片:函数名 + 空参数
片2: {"arguments": "{\"code\": \"AGV"}                  ← 增量片段
片3: {"arguments": "-124"}
片4: {"arguments": "1906"}
片5: {"arguments": "\""}
片6: {"arguments": "}"}                                  ← 拼起来正是 {"code": "AGV-1241906"}
"finish_reason": "tool_calls"这是标准的 OpenAI 流式 FC 增量协议 ------模型把参数切成 6 片送达,语义上要求接收方拼接。首片 arguments 为空是完全正常的!而 Spring AI 1.0.0-M6 的流式聚合器没把分片拼上,拿空串去执行工具,Assert.hasText 一炸。模型端完全无辜,锅在框架的聚合器 。第三层:官方 issue 佐证 ------Spring AI 仓库的 #2417,"call 正常 / stream 报错",与现象逐字吻合,M6 时间窗,GA 修复。
5.3 修复:升级 Spring AI 1.0.0-M6 → 1.0.0 GA
走正道修:升级到 GA 正式版(M6 本来就是预发布里程碑版,生产不可能用)。三处改动:
xml
<!-- pom.xml:M6 → GA,GA 起 starter 改名 -->
<spring-ai.version>1.0.0</spring-ai.version>

<dependency>
    <groupId>org.springframework.ai</groupId>
    <artifactId>spring-ai-starter-model-openai</artifactId>  <!-- 原 spring-ai-openai-spring-boot-starter -->
</dependency>
java
// ChatMemoryService.java:M6 的 InMemoryChatMemory 在 GA 被移除,迁移到新 API
private final ChatMemory chatMemory = MessageWindowChatMemory.builder()
        .chatMemoryRepository(new InMemoryChatMemoryRepository())
        .maxMessages(MAX_MESSAGES)   // 滑动窗口 20 条
.build();升级路上还有一个值得单独记一笔的陷阱:mvn compile 显示通过是假绿 ------Maven 增量编译跳过没改动的文件,target 里躺着的是 IDE 编译器留下的带错 class,启动时才炸 InMemoryChatMemory cannot be resolved。mvn clean compile 全量编译才暴露真实断裂点。升级依赖后必须 clean compile,编译器的"绿"不能全信。
修复后四组验证全绿:原必炸的"流式 + FC"现在真实数据流式吐出------工具调用 → MySQL 查询 → 结果回喂 → 逐字输出,全链路走通;流式无工具、同步+FC、RAG 链路全部回归正常。
六、生产环境:BaseEntityTool 之上还长着什么
学到这很自然会问:真实生产环境也是这样写 @Tool 吗? 以下基于三篇 2026 年生产实践材料(NiteAgent 的生产级工具调用架构指南、Truto 的 B2B SaaS 集成指南、OrtemTech 的 MCP 企业采纳报告)。
6.1 核心机制:生产和本文完全一样
NiteAgent 那篇开篇第一句就是定性的:"每个生产级 tool calling 系统都遵循同一个基础架构:LLM 从不执行函数,只产出结构化 JSON,由应用层解析、执行、回喂 "。它给的决策框架表第一行------"<20 个工具、简单 API:全部工具放进上下文"------正是本文工程的现状(3 个工具、直连自家数据库)。这个规模下,BaseEntityTool 的写法就是标准答案,不存在"生产都另有做法"。
6.2 但规模一大,会连续撞四堵墙(以下是调研材料观点)
墙一:工具数量 。给模型的工具超过约 50 个,选择准确率从 84-95% 跌到 41-83%,约 740 个时接近零------不是线性下降是断崖。生产的演进路线:<20 全量进上下文 → 20100 用 embedding 检索先筛出最相关的 1020 个(语义路由准确率可达 86.4%)→ 100~500 分层路由(LLM → 子 Agent → 各自小工具集)→ 500+ 图调度。
墙二:工具定义的维护方式 。几百个 API 用硬编码 @Tool 维护是灾难。生产做法是把 API 规格存成配置数据、系统动态读配置生成 tool schema------模型用不好某个工具,产品经理在界面上改一段 description 立即生效,不用发版。眼熟吗?这和上一篇 Prompt 的 L0 硬编码 → L1 配置化 → L2 平台化是同一条演进路线。
墙三:第三方系统的脏活 。生产 agent 打交道的往往不是自家 MySQL,而是 Salesforce/Jira/钉钉------多租户 OAuth token 过期、限流 429、分页格式不一致。这些管道问题必须在代理网关层解决,绝不能把 401 喂给模型(它要么幻觉修法、要么死循环重试)。
墙四:可靠性工程 。生产硬化三件套:执行前校验门 (参数过 schema 校验,不合格把错误喂回模型自我修正)、熔断器 (某工具失败率超阈值就停调转降级)、幂等键(状态变更类工具防重试双写),外加成功率/p95 延迟/错误分布/调用次数/重试频率五信号遥测。
6.3 MCP:工具接入的行业标准
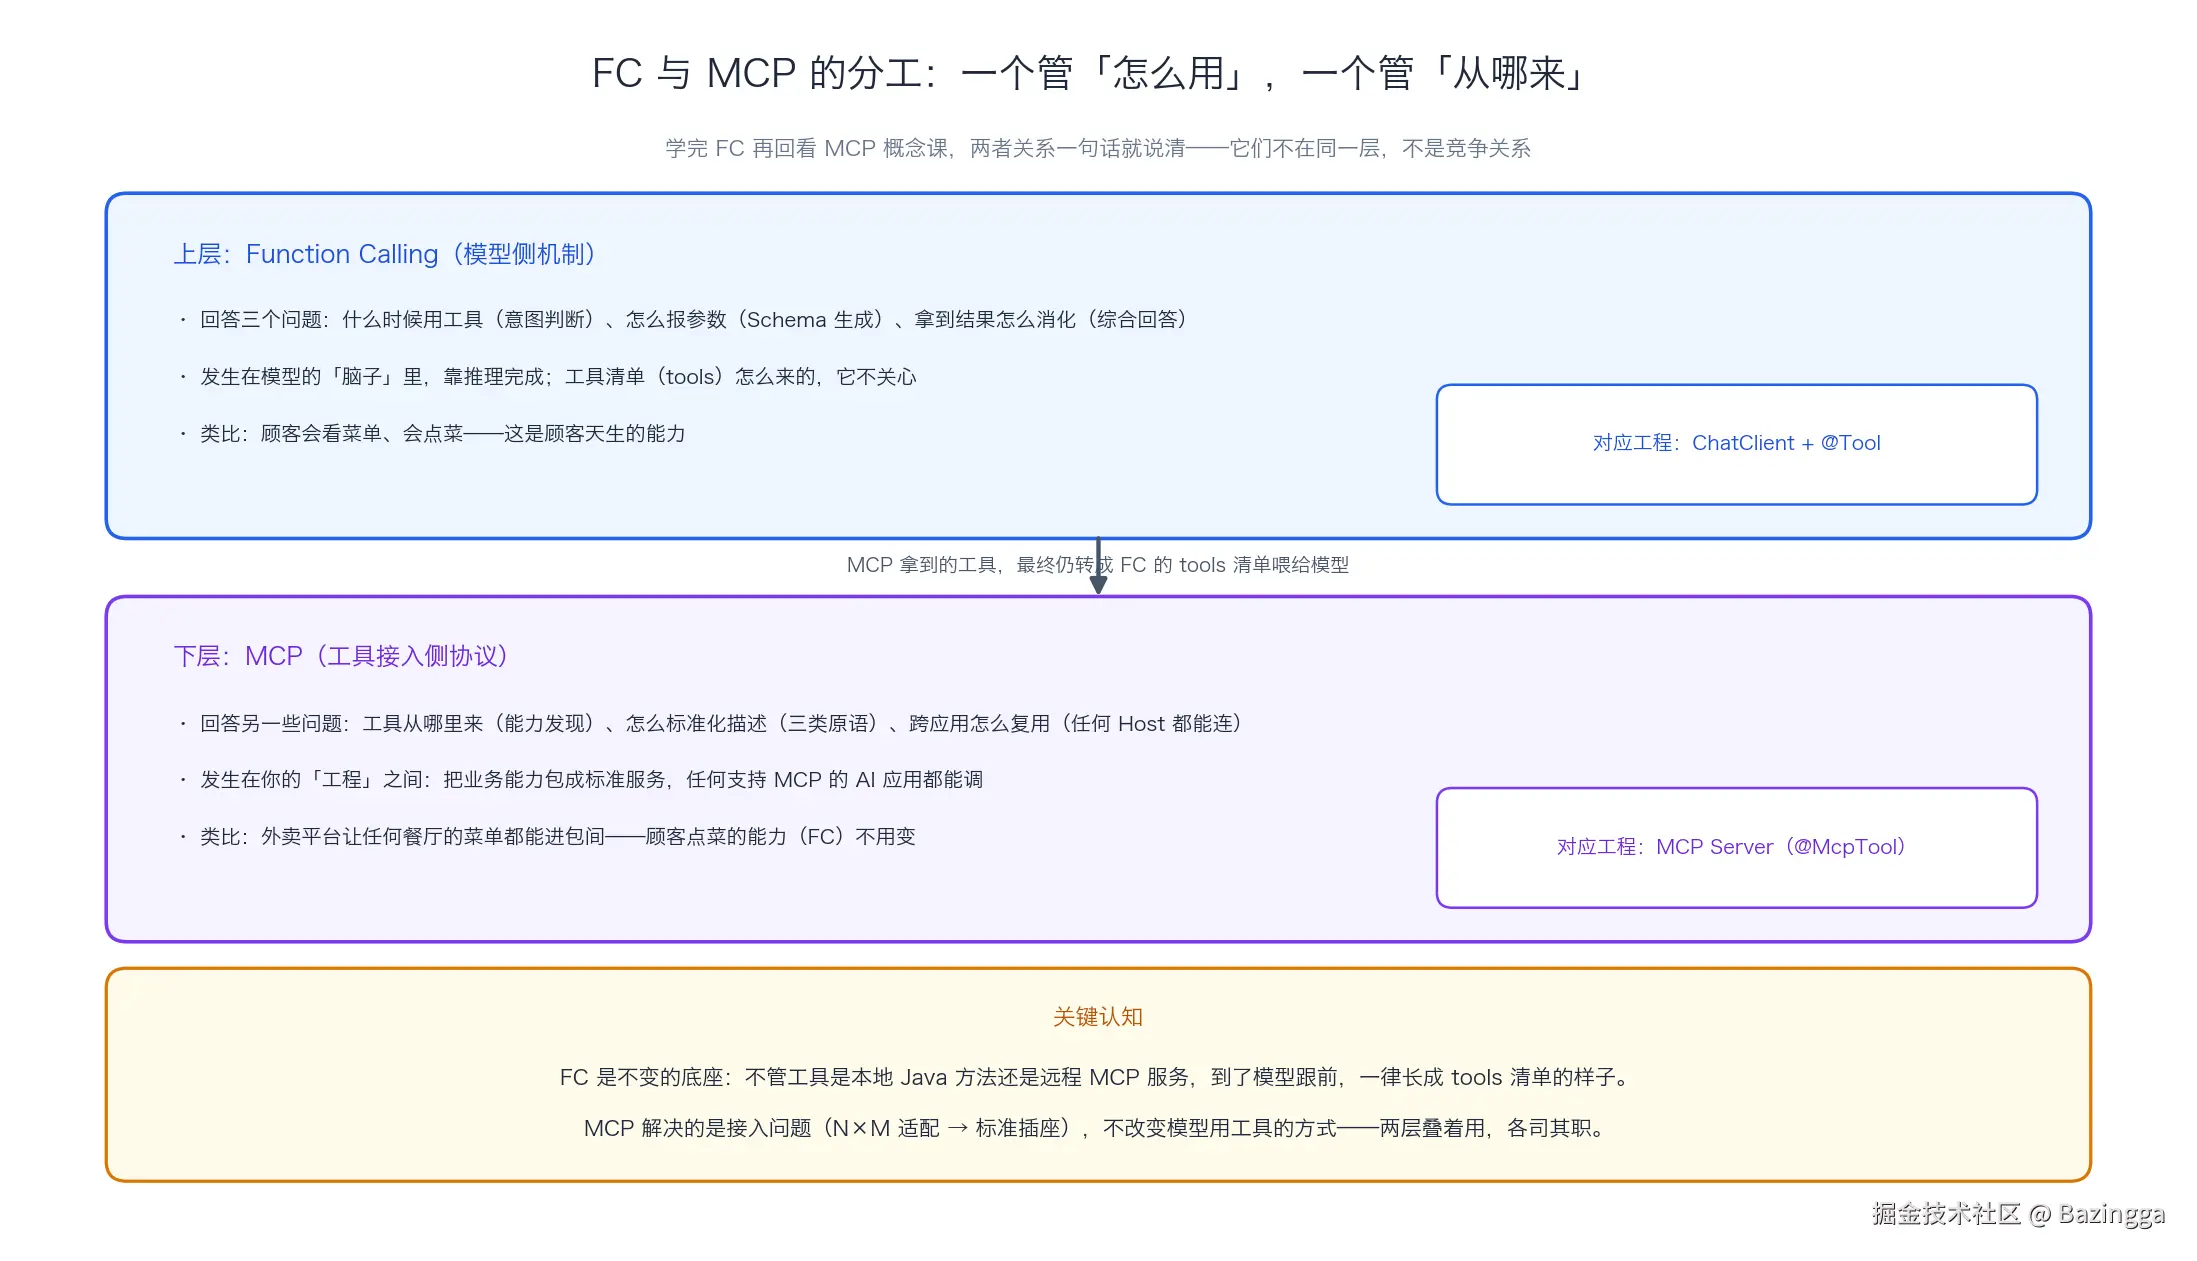
调研里最大的数字都和 MCP(Model Context Protocol)有关:截至 2026 年 3 月,MCP SDK 月下载量 9700 万(18 个月涨 970 倍),78% 的企业 AI 团队已在生产环境跑 MCP agent,生态里已有 12000+ 现成 MCP Server(PostgreSQL、GitHub、Salesforce......)。它解决的是集成矩阵问题------10 个 AI 应用 × 10 个系统 = 100 套定制集成,MCP 把它收敛为每个系统建 1 个 Server、任何 AI 都能连。
关键认知(上图):MCP 没有取代 FC------MCP Server 的工具最终还是会转成 FC 的 tools 清单进模型上下文。FC 管"模型怎么用工具"(不变底座),MCP 管"工具从哪来"(接入标准化),两层叠着用、各司其职。
6.4 收束成一张对照表
| 本文工程 | 生产环境 | |
|---|---|---|
| 核心循环 | @Tool → 菜单 → 模型点菜 → 反射执行 | 一模一样 |
| 工具定义 | Java 注解硬编码 | 小规模同样注解;大规模配置化声明生成 |
| 工具数量 | 3 个全量进上下文 | >20 检索式筛选,>100 分层路由 |
| 执行层 | 直连自家 MySQL | 自家走内网;第三方走代理网关 |
| 工具来源 | 写死在本工程 | 自建 MCP Server + 复用现成 Server |
| 可靠性 | 异常兜底转文本 | 校验门 + 熔断 + 幂等 + 遥测 |
一句话:生产环境的"Hello World"就是 BaseEntityTool------没有任何团队跳过这一步;生产的全部篇幅,花在它之后的三件事上:工具太多怎么选、第三方太脏怎么接、跑挂了怎么办。
七、总结
回收第一章的三个错觉,本篇的收获可以压成一张清单:
认知地基
- 模型从不"执行",它只会"递纸条"------执行权留在工程手里是刻意的设计(安全);
- 四步一个循环(发消息附菜单 → 递纸条 → 后厨做菜 → 端菜回包间),循环可多轮,这正是 Agent 的雏形;
- 工具定义是第二份 Prompt:name/description/parameters 三要素,description 写准了选择才准,required 标错了模型会编参数。
工程落地
- FC 工具类只是适配层(≈Web 层):description、参数承接、异常兜底转文本------业务逻辑全部下沉 Service/Manager/DAO,业务代码独立成包隔离;
- 查询上限归 Manager 层管(
MAX_QUERY_SIZE=5),调用方不可指定------保护数据库也保护模型上下文; - 双数据源的代价:第二个 DataSource 出现后自动装配整体失效,两侧都要手工装配完整链路,HikariPool 日志是隔离的最好证据。
测试与排障
- "模型怎么知道调哪个":@Tool 在启动时被反射读成菜单,菜单随每次请求发给模型,模型语义匹配点菜,框架按名字反射执行------方法名字符串是唯一契约;
- 主动性光谱:发起推理程序独占 → 用不用工具默认模型定 → 用哪个模型定;Agent 循环、定时任务、事件驱动是三种非用户发起形态;
- 测试矩阵必须覆盖"接口形态 × 有无工具"的每个组合------同步测试全绿测不出流式 bug,就是教训本身;
- 排障三板斧:复现矩阵隔离变量 → 绕过框架直连取证 → 官方 issue 佐证;升级依赖后
mvn clean compile才是真裁决。
改动文件清单:BaseEntityTool/BaseEntityService/BaseEntityManager/BaseEntityMapper/BaseEntityDO/BaseEntityDTO(business 包全新四层)、BizDataSourceConfig/PrimaryDataSourceConfig(双数据源显式装配)、ChatController(注册工具)、ChatMemoryService(GA 迁移)、pom.xml/application.yml(Spring AI 1.0.0-M6 → 1.0.0 GA + MySQL 连接配置)。检索链路一行未动------FC 的全部改动发生在"模型与工程世界的接口"上,这正是它的特点:不动模型的脑子,给它递一份写得好的菜单。