本文系「TVP • WorkBuddy 有方」专栏约稿。 作为一档聚焦 WorkBuddy 真实使用场景的最佳实践专栏,我们始终坚持一个原则:不讲概念讲落地,一篇文章解锁一个领域的 WorkBuddy 打开方式。我们邀请各行各业、各个领域的 TVP 专家老师,以第一视角分享自己在实际工作中如何使用 WorkBuddy 的真场景、真方法、真效果。
本期,我们特邀腾讯云 TVP、CDA 数据科学研究院院长 常国珍。这位北大博士深耕金融与电信行业数据治理十余年,同时也是数据分析与 AI 应用的培训讲师。长期和公式、算法打交道的他,最了解"教材是 PDF、公式是图片、一更新就全部重来"的痛苦。这一次,他从最让讲师头疼的"公式一复制就变乱码"出发,他用 WorkBuddy 搭配 Obsidian,跑通了一套把 PDF 教材变成"可出题知识库"的完整工作流。
作者简介
常国珍,北京大学会计学博士,现任CDA 数据科学研究院院长,曾任 ThoughtWorks 首席金融数据科学家。在金融和电信行业摸爬滚打了十余年,一直从事数据科学、数据治理工作。在加入 ThoughtWorks 之前,曾在毕马威咨询大数据部担任总监,也在某金融机构数据部担任过高级经理。入行伊始从事数据应用工作,主要提供人工智能在客户运营、风险防控和监管合规方面的解决方案。之后提出并践行以数据模型为核心的数据治理理念,强调面向业务应用的数据资产积累是数据工作的核心。现专注于金融行业的数据战略规划、数据资产管理、数字化人才培养,帮助企业建立数据管理体系,培养企业数字化文化,设计数据分析人员成长路径,为金融机构数字化转型提供支撑服务。
引言:每次教材更新,我都在重复造轮子
作为一名长期和数据、算法、数学公式打交道的培训讲师,我最怕的不是备课,而是"重复造轮子"。
教材是 PDF,公式是图片,想改成 Markdown 进知识库就丢格式;想根据教材出几道测试题,又得手敲 LaTeX。直到我把 WorkBuddy 和 Obsidian 组合起来,这件事才真正跑通。
这篇文章不讲概念,只讲我在真实教学场景中的落地方法:如何用四步把 PDF 教材变成带公式的可出题知识库,并分享我最常用的 Prompt 模板、几个"早知道就好了"的隐藏玩法,以及新手最容易踩的坑。
一、先摆明场景:为什么数学公式是"知识库杀手"
我的课程覆盖统计学基础、机器学习、AI 大模型实战,几乎每一页都少不了 R²、Σ、β、P-value、积分、矩阵这些符号。
过去我的工作流是这样的:
PDF 教材 → 复制粘贴到 Word → 公式变图片或乱码 → 手工转 LaTeX → 最后才能进题库
教材只要一更新,全流程就得重来一遍。
更头疼的是出题,出一道带公式的选择题,光是选项排版和解析里的数学符号,就要折腾十几分钟。
我需要的是一个"读 PDF、写 Markdown、管公式、出题"的闭环,而不是在四五款软件之间反复横跳。
二、我的工具组合:WorkBuddy+Obsidian+Pkmer-Math
这套方案的核心是把"AI 能力"和"本地知识库"打通,各司其职:
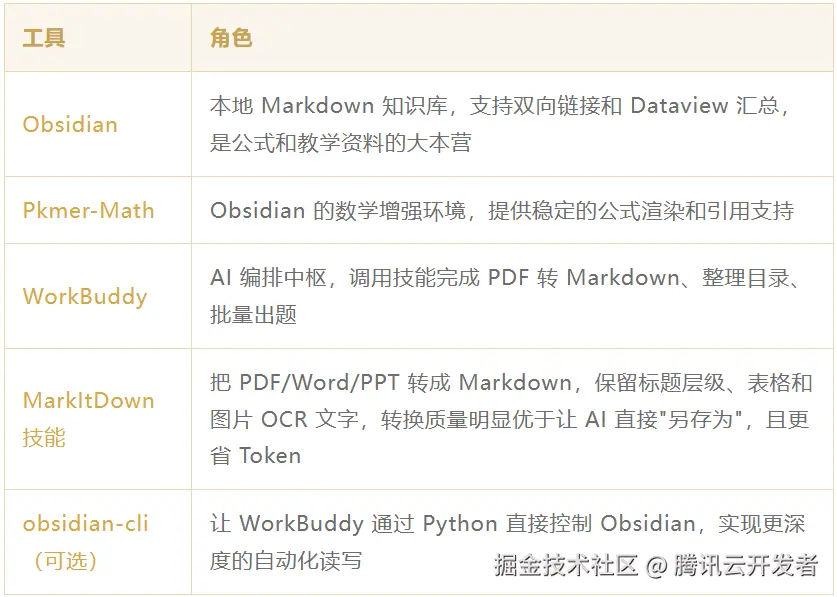
为什么非得把 Obsidian 和 WorkBuddy 绑在一起?
因为 Obsidian 负责"存"和"看"------公式渲染稳定、目录清晰、双向链接方便复习;WorkBuddy 负责"做"------读 PDF、写 Markdown、批量出题。两者各司其职,才能把一个教材更新动作,从几小时压缩到几分钟。
三、四步实战:从 PDF 教材到可出题知识库
步骤 1:安装必备软件与插件
- 先在电脑上安装 Obsidian 和 WorkBuddy;
- 然后在 WorkBuddy 中启用 MarkItDown 和 obsidian-cli 两个插件;
- 接着从 GitHub 拉取 Pkmer-Math 仓库到本地,例如
D:\Obsidian_warehouse\Math/。
这一步相当于搭好"厨房",后续所有加工都在里面完成。
步骤 2:创建 MD 知识库工作环境
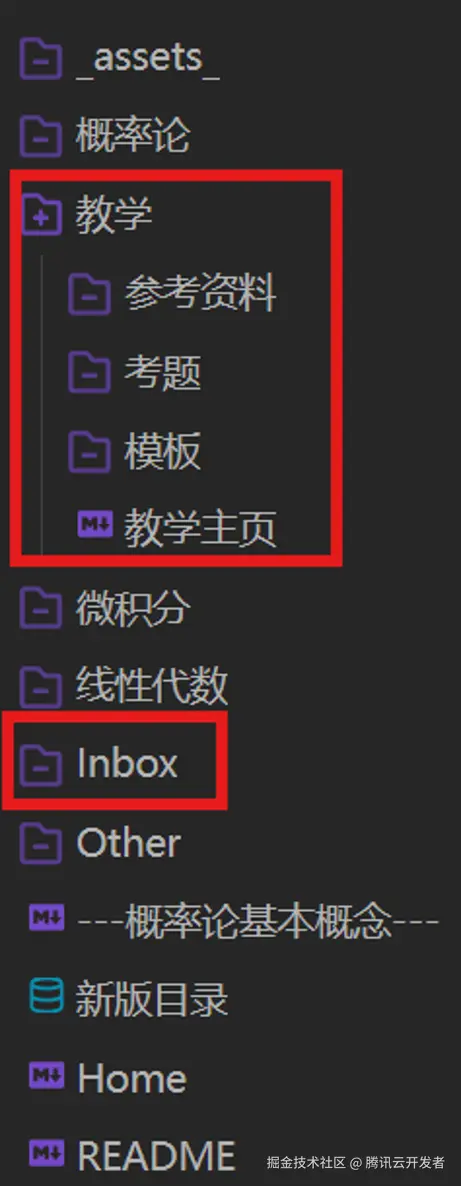
在 Pkmer-Math 目录下新建 Inbox/ 作为"待整理区",用来放刚转换或新增的 Markdown 文件;再建立教学/ 目录,下设参考资料/、考题/、模板/三个子目录,并在根目录放教学主页.md。
javascript
Pkmer-Math/
├── Inbox/            ← 待整理暂存区
├── 教学/
│   ├── 参考资料/
│   ├── 考题/
│   └── 模板/
└── 教学主页.md       ← Dataview 仪表盘,一眼纵览全局
我习惯让 WorkBuddy 在教学主页.md 里用 Dataview 做一个仪表盘,自动汇总所有参考资料和考题,打开 Obsidian 一眼就能看到全局。
步骤 3:把自己的 PDF 文档转换为 MD 文件
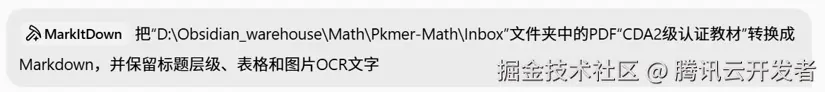
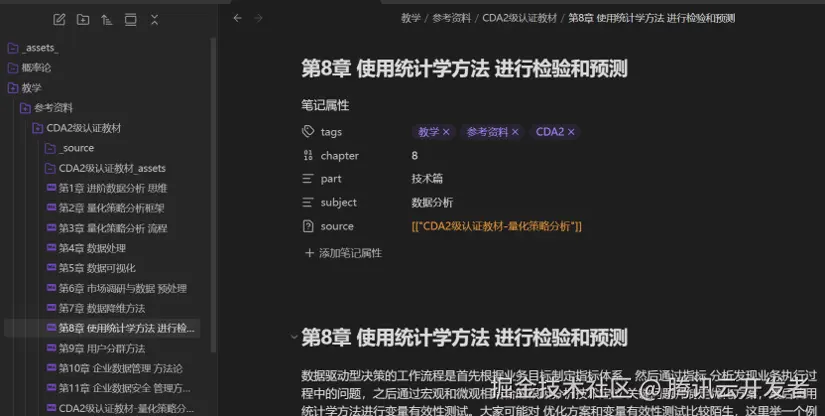
把 PDF 教材丢进Inbox/,然后在 WorkBuddy 里输入一句提示词。比如我把 《CDA2 级认证教材》 转 Markdown 时用的提示词是:
把 D:\Obsidian_warehouse\Math\Pkmer-Math\Inbox 文件夹中的 PDF《CDA2 级认证教材》转换成 Markdown,并保留标题层级、表格和图片 OCR 文字。
这里有两个注意点:
- 第一,建议手动选择 MarkItDown 技能,这样做更省 Token;
- 第二,要判断 PDF 是纯文本还是扫描图片,如果是后者,OCR 识别会非常耗时,建议先用 OCR 工具预处理。
步骤 4:使用 MD 知识库出题
单题测试通过后,就可以让 WorkBuddy 批量出题。我常用的提示词是:
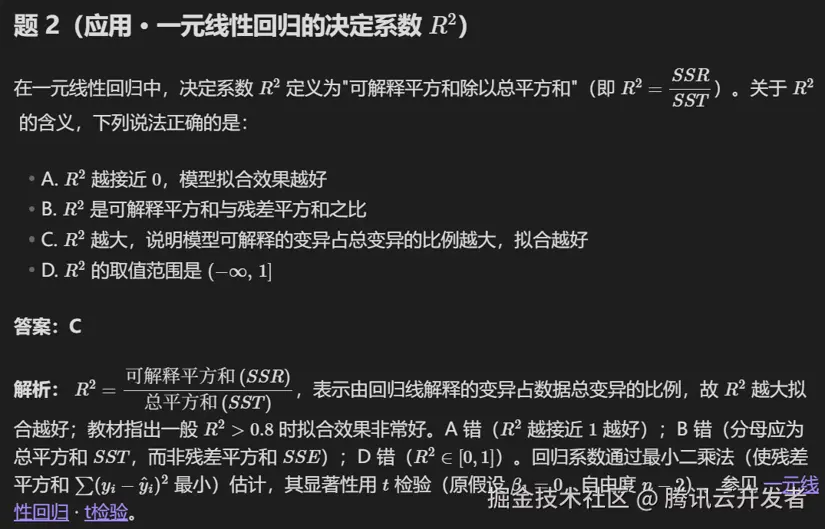
根据 CDA2 级教材中第 8 章的内容,根据布鲁姆认知 6 层次理论,出 6 道选择题,每个层次出 1 道题。文件名加上日期和时间。
WorkBuddy 会基于知识库生成带 LaTeX 公式的题目、选项、答案和解析,并自动保存到教学/考题/ 目录。
更妙的是,解析里可以出现"参见\[一元线性回归]"这样的双向链接,学员复习时点一下就能跳回知识点。
当然,AI 生成的题目我不会直接投入使用。我会先检查公式符号是否正确、选项是否存在明显逻辑漏洞、解析是否与教材一致。通常第一次跑出来的 6 道题里,会有 1-2 处需要微调,改完后即可归档,整体效率比手写出题高出不少。
四、我最常用的Prompt模板
把提示词模板化,是我使用 WorkBuddy 后效率提升最快的一点。以下四个模板可以直接复用:
- 模板 1:初始化知识库
我是数据分析/AI 培训老师,需要构建一个涉及大量数学公式的 Markdown 知识库。
请检查 Obsidian 是否已与 WorkBuddy 建立连接;使用 Pkmer-Math 管理各类公式;
建立 Inbox/ 目录存放新增 Markdown;根据 Inbox 中新增文档自动更新知识库;并能基于知识库编写参考资料、按布鲁姆认知层次出考试题目。
- 模板 2:PDF 转 Markdown
请使用 MarkItDown 技能,把 Inbox/ 中的 PDF《XXX》转换成 Markdown,保留标题层级、表格结构,并对图片中的文字进行 OCR。
- 模板 3:整理新增材料
转换整理 Inbox/ 中的新增《XXX》材料,按知识库目录结构归档到 教学/参考资料/ ,为每篇笔记生成 YAML frontmatter(tags、chapter、part、subject、source),并更新 教学主页.md 。
- 模板 4:批量出题
根据《XXX》第 N 章内容,按布鲁姆认知 6 层次理论出 6 道选择题,每层次 1 题。题目需包含 LaTeX 公式、4 个选项、正确答案和详细解析,并在解析中回链到知识库对应条目。文件名加上日期和时间。
五、那些"早知道就好了"的隐藏玩法
1、显式指定技能更稳: 写提示词时直接说"请使用 MarkItDown 技能",比让WorkBuddy 自己识别更可控,当前版本建议养成这个习惯。
2、让 AI 自动写 YAML frontmatter: 转换后让 WorkBuddy 给每篇笔记加上 tags、chapter、part、subject、source 等属性,后续用 Dataview 筛选和汇总一目了然。
3、用双链\[ ]回链知识库: 在生成的题目解析里加入"参见\[一元线性回归]",学员点击即可跳转,复习路径非常顺畅。
4、Inbox 是暂存箱不是仓库: 养成每天或每次课后让 WorkBuddy 整理 Inbox 的习惯,否则材料堆积会导致知识库失序。
5、先做单题测试,再批量生成: 新章节第一次出题时,先出 1-2 道检查格式、知识点和符号是否正确,确认无误再批量。
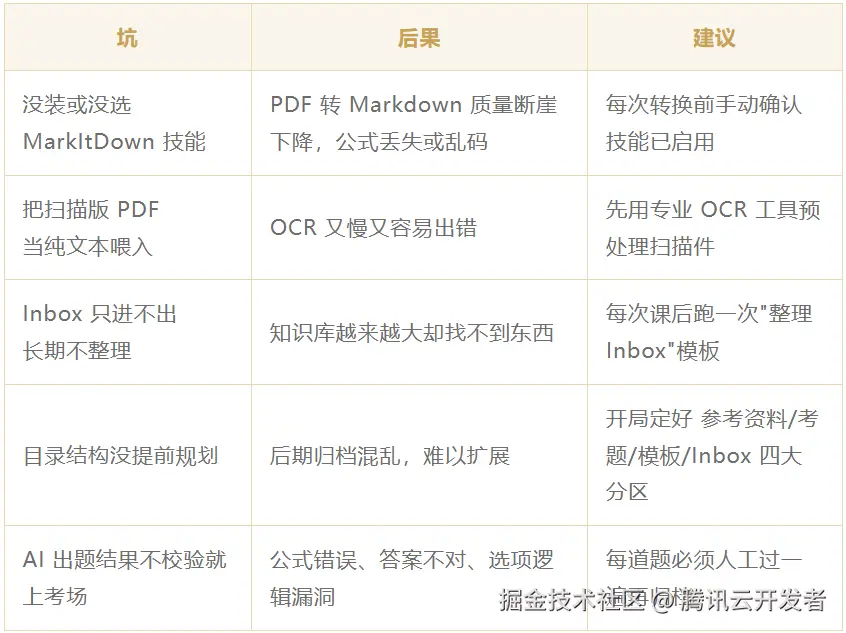
六、新手最容易踩的坑
七、写在最后
把 WorkBuddy 和 Obsidian 搭起来之后,我的备课流程从"手动搬运"变成了"扔进 Inbox,喊一句提示词"。公式不会丢,题目能批量出,学员看到解析里的蓝色双向链接也更容易复习。
就我自己的课程而言,原本整理一章 PDF 教材并配套出题,至少需要三四个小时;现在用这套流程,半小时内可以完成转格式、归档、生成初稿题目和人工校验。省下来的时间,我用来设计案例、优化讲义。
如果你也是一名需要处理大量公式、图表和结构化内容的讲师、教研或知识工作者,这套组合值得尝试。它不会让你一劳永逸,但确实能把最机械、最重复的部分交给 AI,让你把精力留在真正重要的教学设计本身。