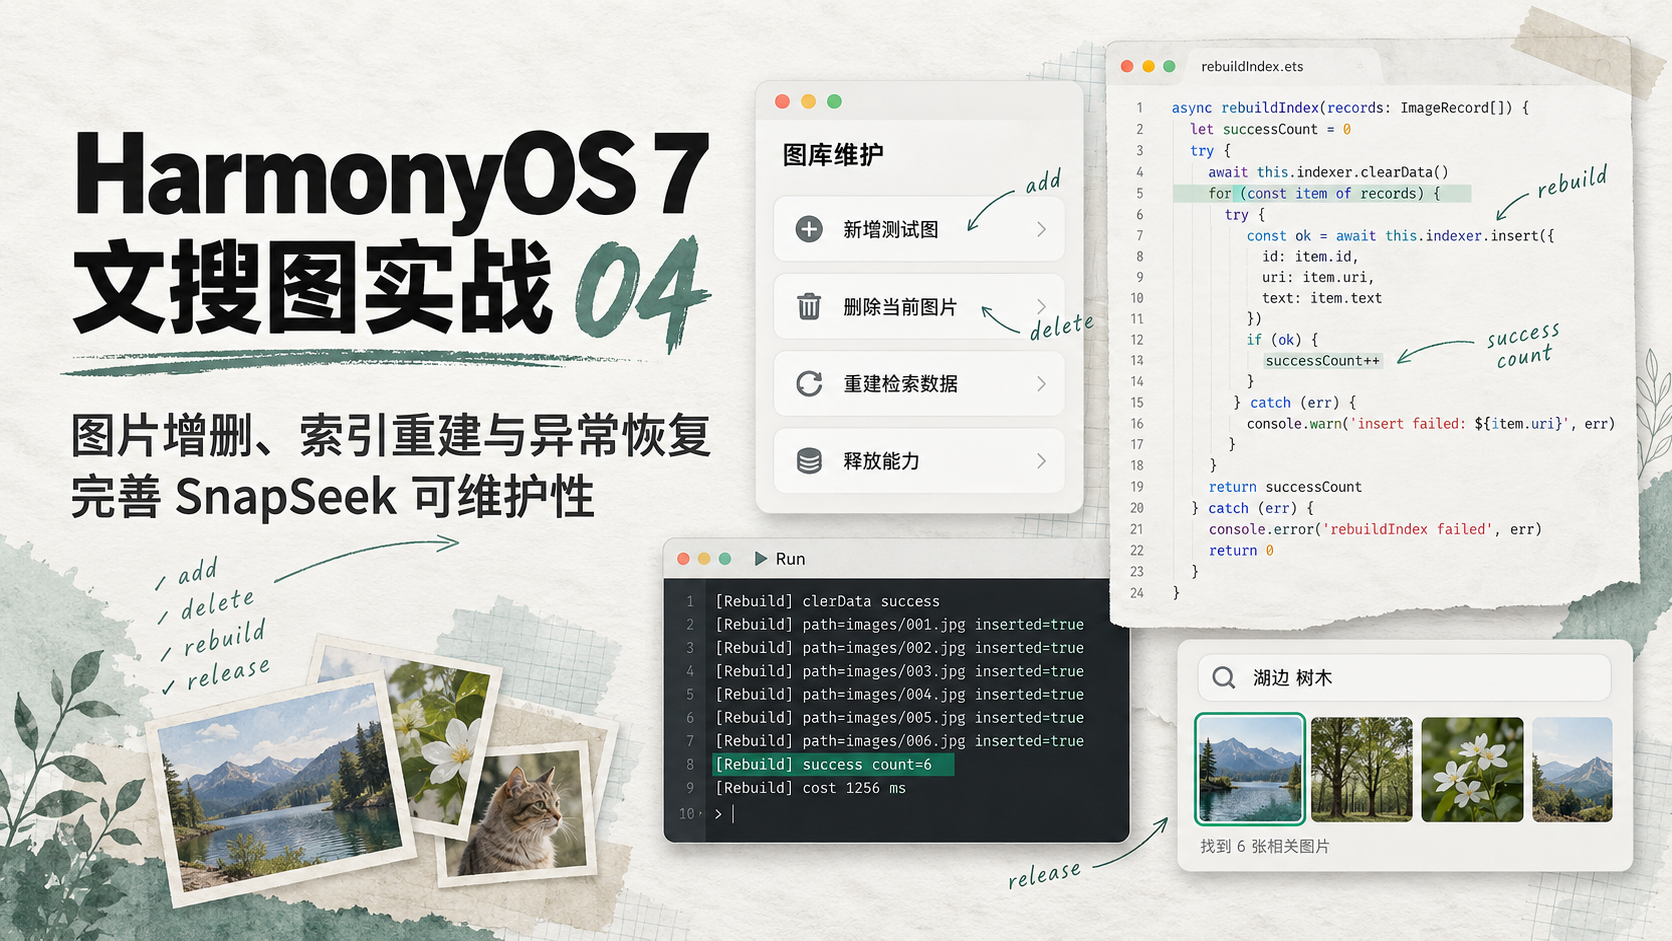
前三篇里,我已经把 SnapSeek 的主链路一步一步搭了起来:第一篇先把文搜图跑通,第二篇补上 Scope,让搜索开始有图库边界,第三篇再围绕 similarity 和 Query 去理解结果为什么这样排。做到这里,SnapSeek 已经不只是"能演示"的小 Demo 了。但越接近真实使用场景,另一个问题就越绕不过去:图片不会永远不变。 它会新增、会删除、会切换分类、会遇到检索数据失效,甚至会在能力更新后需要重建索引。这一篇,我就不再重点讲"怎么搜",而是开始讲 怎么维护 ------把 SnapSeek 从"会搜"推进到"出了变化也能稳住"。
前三篇写下来以后,我对 SnapSeek 的路线已经很清楚了。
第一篇做的是最小闭环:
页面搭起来,能力初始化,测试图片导入,输入一句话,结果出来。
第二篇开始加 Scope:
旅行、工作、宠物这些图片,不再一锅端,而是有了各自的检索边界。
第三篇继续往前走:
我开始认真观察 similarity 和 Query,试着解释"为什么这些结果会排成这样"。
到这里,文搜图最容易被看到的那部分,其实已经差不多了。
但如果我只写到这里,这个连载就会停在一个很典型的阶段:
它看起来能用,但还没碰到真正的维护问题。
而只要你把 SnapSeek 稍微往真实使用场景里想一步,这些问题立刻就会冒出来:
- 用户新增了一张图片,怎么把它放进当前 Scope 的检索数据里?
- 用户删除了一张图片,怎么让搜索结果不再继续返回它?
- 如果图片换了分类,原来的 scope 数据怎么办?
- 如果检索能力更新,原先导入的数据是不是还有效?
- 如果 clearData 之后全没了,怎么重建?
- 如果 release 没处理好,会不会后面继续搜的时候状态错乱?
这些事情不炫,但很工程。
而且说实话,越是做真实项目,越知道这种部分才最影响"能不能继续维护"。
所以第四篇,我准备把重点彻底从"搜索效果"切到"搜索数据维护"。
这也是 SnapSeek 走到这一篇之后,非常自然的一步:
从会搜,走到可维护。
一、第四篇真正要解决的,不是"搜什么",而是"图库变了以后怎么办"
前三篇里,SnapSeek 默认有一个前提:
测试图片集是相对稳定的。
第一篇里我只关心图片能不能导入。
第二篇里我关心它们属于哪个 Scope。
第三篇里我关心不同 Query 和 similarity 如何影响排序。
但无论哪一篇,其实都默认了一件事:
这些图片已经在那里了,而且暂时不怎么动。
这个前提一旦拿掉,问题一下子就不一样了。
因为真实世界里的图库从来都不是静止的。
用户会新增图片,会删掉图片,会重新整理分类,甚至你在调试阶段自己也会不断替换测试图。
于是 SnapSeek 到了第四篇,最核心的问题就不再是:
text
怎么把文字搜成图片?而变成了:
text
图片集合一旦发生变化,搜索数据怎么跟着变化?这个问题很重要,因为文搜图不是直接对"你眼前看到的文件夹"做魔法搜索。
它背后有一层属于检索能力的数据准备过程。
换句话说,图片文件存在,不代表检索数据就自动是最新的。
所以第四篇的主线会围绕 4 件事展开:
- 新增图片时,如何按 Scope 插入;
- 删除图片时,如何同步删除检索数据;
- 必要时,如何清空并重建检索数据;
- 能力更新或页面退出后,如何做异常恢复与 release。
如果说前几篇是在讲"入口",第四篇就是在讲"后勤"。
看着不如前面那几篇直接,但从工程角度说,这一步反而更像一个真正项目。
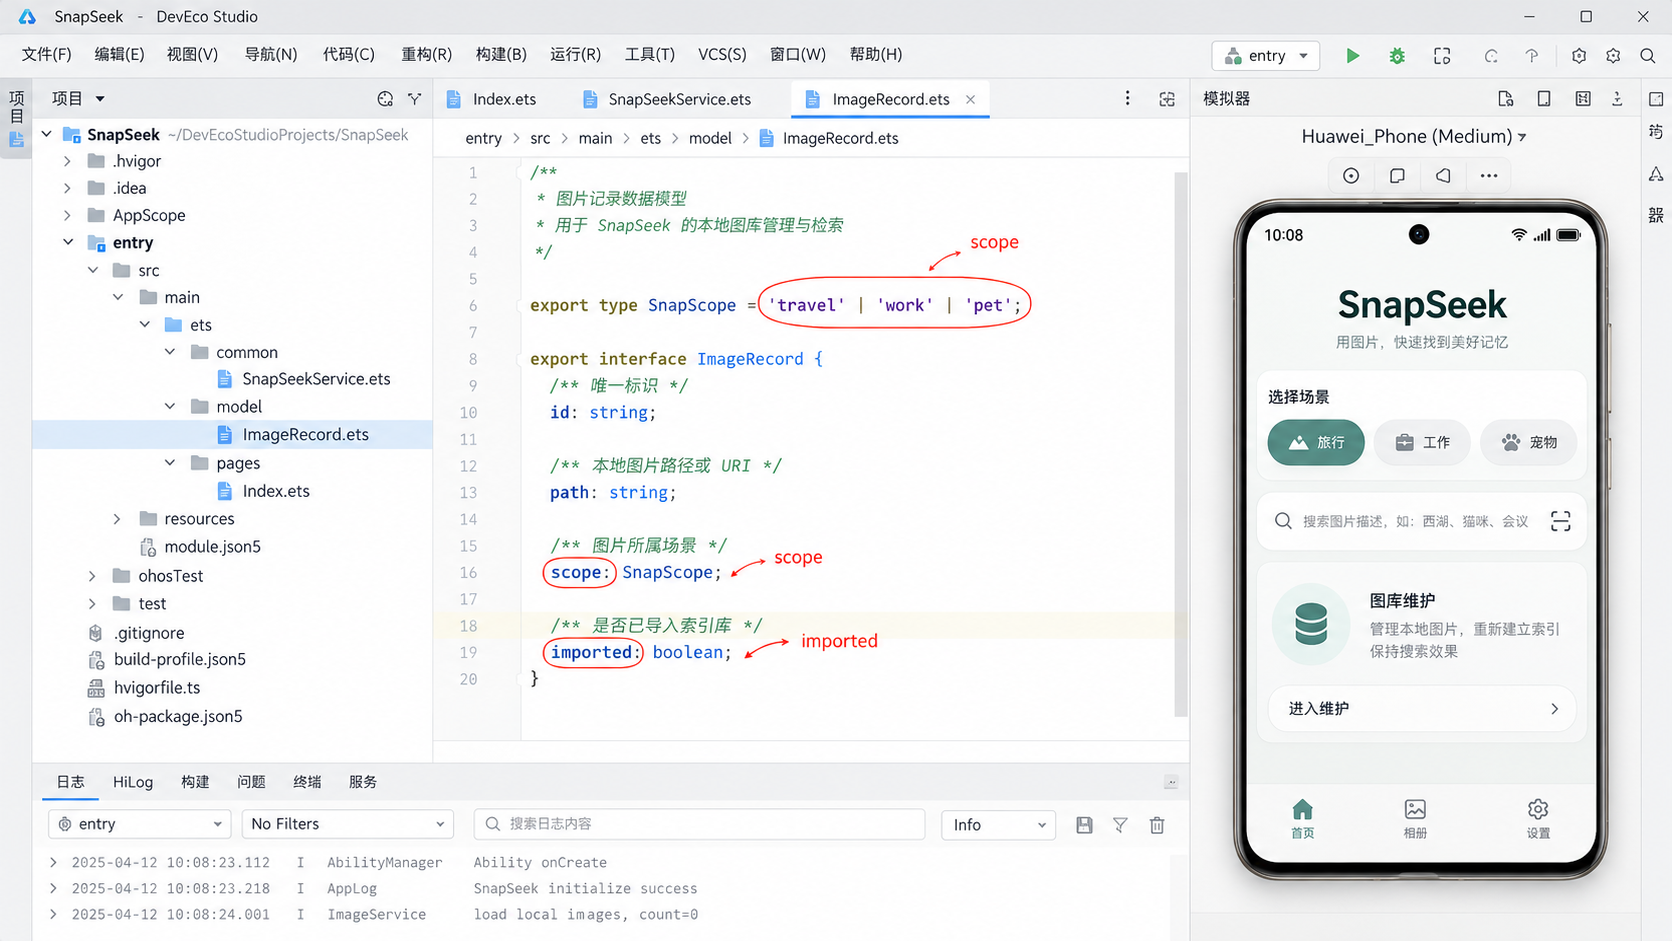
二、我先补的是图片记录模型:不是只有 path,还要知道 imported 状态
第二篇时,我已经给图片加上了 Scope。
第四篇往前走,光有 path + scope 还不够,因为现在我开始关心:
- 这张图是否已经成功插入过检索数据?
- 删除的时候是不是能准确找到它?
- 重建时还有哪些图片需要重新导入?
所以图片记录模型我又往前加了一层。
文件位置: entry/src/main/ets/model/ImageRecord.ets
用途: 记录图片基础信息和导入状态。
arkts
export type SnapScope = 'travel' | 'work' | 'pet'

export interface ImageRecord {
  id: string
  path: string
  scope: SnapScope
  imported: boolean
}
看起来只是比第二篇多了一个 imported 字段,但它的意义非常大。
因为从这一步开始,我不再只把图片看成"一个待搜索资源",而是开始把它看成:
一条需要被维护状态的图库记录。
比如一张新图刚被加入 SnapSeek 时,它可能是:
ts
{
  id: 'w3',
  path: '/data/storage/el2/base/haps/entry/files/demo/work_keyboard_01.jpg',
  scope: 'work',
  imported: false
}只有当它真正被插入文搜图检索能力之后,imported 才会变成 true。
这种状态在第四篇里非常重要。
因为接下来无论你做新增、删除、重建还是异常恢复,都不能只靠"猜图片现在大概是什么状态"。你最好有一份自己能握住的记录。
这也让我越来越确定一件事:
SnapSeek 不能把检索能力本身当成自己的图库数据库。
你自己的图片记录,和文搜图能力内部建立起来的检索数据,是两层东西。
它们有关系,但不等于一回事。
这一层想清楚了,第四篇后面的所有维护逻辑才会顺。
三、新增图片这件事,重点不在"加一张图",而在"让它真正进入当前检索范围"
很多人第一次做图库维护时,直觉都会放在 UI 上,比如"点一下新增按钮,把图放进列表里"。
这当然要做,但对文搜图来说,更关键的是下一步:
它有没有真正进入可检索的数据里?
也就是说,第四篇里"新增图片"不是把一张图显示在页面上就算完成,而是至少要经过这条链路:
text
选择或生成一张新图片
   ↓
生成 ImageRecord(带 scope)
   ↓
调用 insertImage(path, scope)
   ↓
成功后 imported = true
   ↓
更新当前列表与状态文案
我把这段逻辑收到了 Service 里,避免页面直接碰底层细节。
文件位置: entry/src/main/ets/common/SnapSeekService.ets
用途: 新增单张图片并同步更新导入状态。
arkts
import { ImageRecord } from '../model/ImageRecord'

class SnapSeekService {
  async addImage(record: ImageRecord): Promise<boolean> {
    if (!record.path) {
      return false
    }

    // const result = await textSearchImage.insertImage(record.path, record.scope)
    const result = true

    console.info(
      `[AddImage] path=${record.path}, scope=${record.scope}, result=${result}`
    )

    return result
  }
}
页面侧则会这样调用:
arkts
private async handleAddImage(record: ImageRecord) {
  const result = await this.service.addImage(record)

  if (result) {
    record.imported = true
    this.statusText = `新增图片成功,已加入 ${record.scope} 图库`
  } else {
    this.statusText = '新增图片失败,请检查图片路径和当前环境'
  }
}
这段代码虽然简单,但我特别在意一件事:
新增图片成功以后,不只是"列表多了一行",而是要能明确知道:
- 它属于哪个 Scope;
- 它是不是已经导入成功;
- 当前状态是不是可搜索。
因为第四篇开始,SnapSeek 已经在从"静态测试集"走向"可变图库"。
而可变图库最怕的,就是 UI 里看起来有图,结果搜索能力里其实还没有这张图的数据。
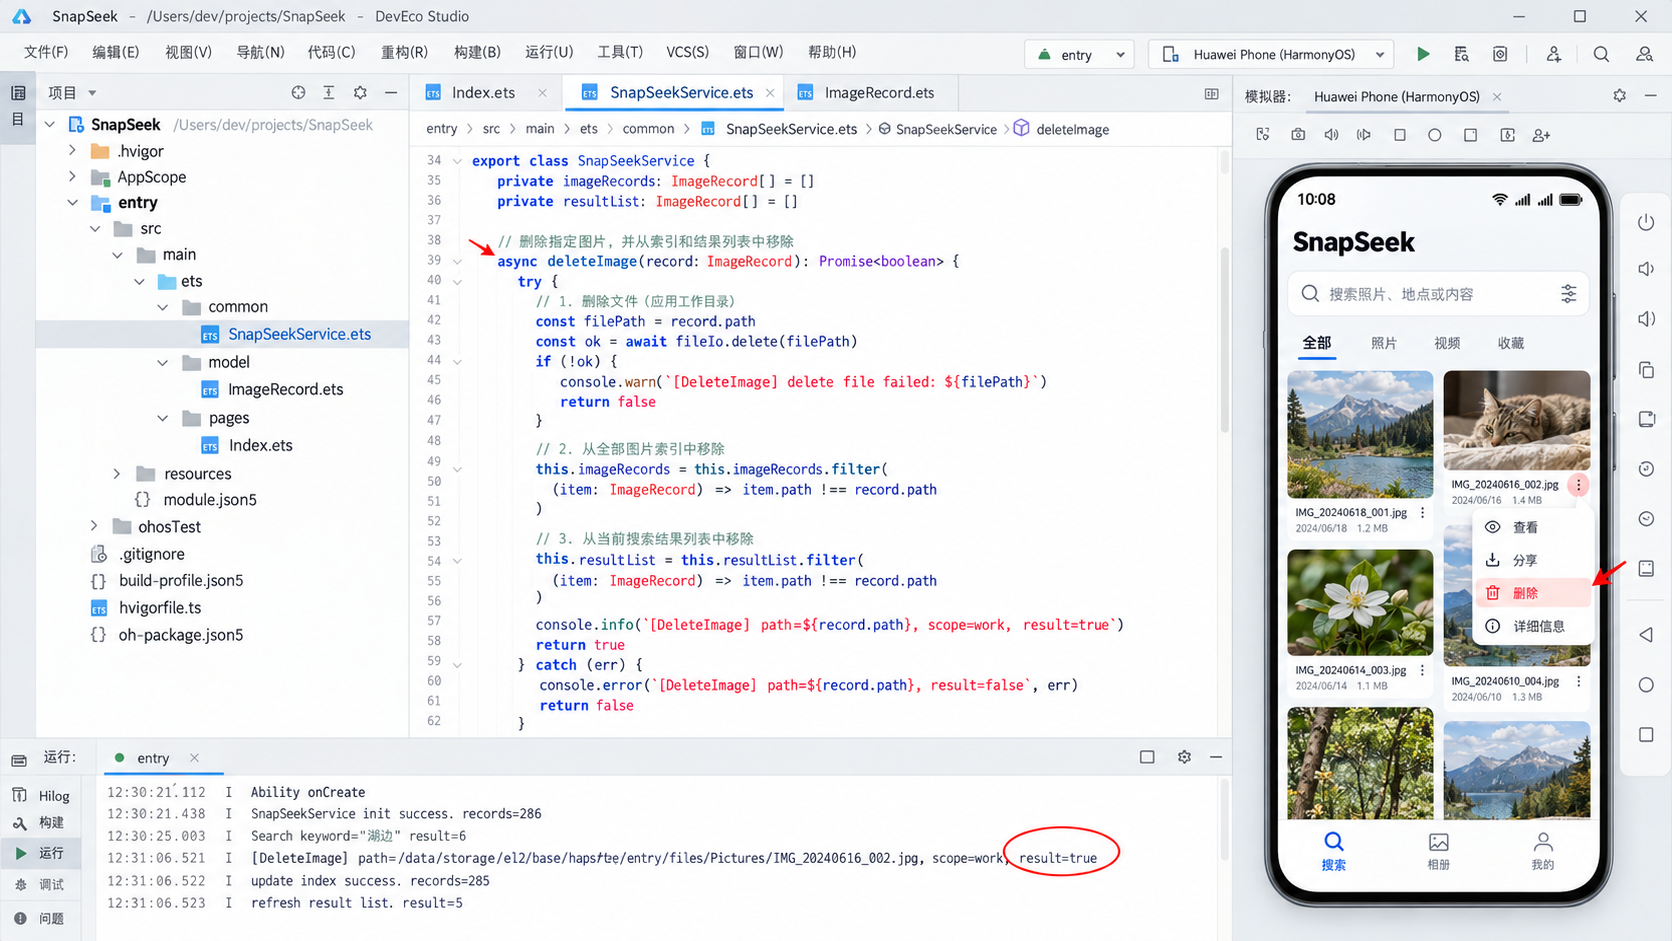
四、删除图片这一步,最怕的是"文件没了,检索结果却还在"
如果说新增图片最怕的是"页面有了,检索数据没跟上",
那删除图片最怕的正好反过来:
图片文件已经删了,但搜索结果里还会继续返回它。
这种体验非常别扭。
因为从用户角度看,这张图明明已经不该存在了;
但从检索能力角度看,如果你没显式把它从索引里删掉,它并不会自动消失。
这也是第四篇我特别想单独讲的一步:
删除图片,不是只删本地文件或本地记录,而是至少要同步处理两层:
- 业务侧图片记录;
- 文搜图能力里的检索数据。
我在 Service 里补上了删除逻辑:
文件位置: entry/src/main/ets/common/SnapSeekService.ets
用途: 删除指定图片对应的检索数据。
arkts
import { ImageRecord } from '../model/ImageRecord'

class SnapSeekService {
  async deleteImage(record: ImageRecord): Promise<boolean> {
    if (!record.path) {
      return false
    }

    // const result = await textSearchImage.deleteImage(record.path, record.scope)
    const result = true

    console.info(
      `[DeleteImage] path=${record.path}, scope=${record.scope}, result=${result}`
    )

    return result
  }
}
页面侧的处理思路则会更完整一些:
arkts
private async handleDeleteImage(record: ImageRecord) {
  const result = await this.service.deleteImage(record)

  if (result) {
    this.imageRecords = this.imageRecords.filter(item => item.id !== record.id)
    this.resultList = this.resultList.filter(item => item.path !== record.path)
    this.statusText = `已从 ${record.scope} 图库删除这张图片`
  } else {
    this.statusText = '删除失败,请稍后重试'
  }
}
这段代码里我特别保留了两件事:
- 删除图片记录;
- 同时把当前结果列表里对应 path 的结果也移掉。
因为第四篇讲的是"维护",而维护最忌讳的就是一层更新了,另一层没跟上。
你不能等用户下一次重新搜索才发现"哦,这张图终于不见了"。
如果当前页已经能明确知道删的是哪一张,就应该尽量把页面状态也立刻收口。
做到这里以后,SnapSeek 才开始慢慢具备"图库是活的"这种感觉。
五、我为什么不把 clearData 当成"清空某个分类"的快捷按钮
第四篇开始接触到 clearData() 时,我脑子里第一个反应其实也很直接:
既然它叫 clearData,那是不是可以拿来做"清空当前图库"?
后来一想,不对,这个理解太危险了。
因为从能力语义上讲,clearData() 更像是:
把当前文搜图检索数据整体清掉。
它不是专门为"清空 travel 分类"或"清空 pet 分类"设计的那种业务按钮。
如果把它直接塞进页面,做成一个高频操作入口,很容易让人误解这只是个普通分类清理功能。
所以第四篇里,我对 clearData() 的定位非常明确:
- 它不是日常用户高频操作;
- 它更像维护动作或恢复动作;
- 它通常和"重建检索数据"配套出现。
也正因为这样,我宁愿在 UI 上把它表达成一种低强调度的维护入口,比如:
- 重建检索数据
- 重新建立图库索引
- 维护模式清理后重建
而不是简单粗暴地做一个"清空当前图库"的红色大按钮。
从文章逻辑上说,这一步也特别重要。
因为第四篇不是单纯列 API,而是要讲清楚每个动作在工程里是什么角色。
如果新增、删除和重建之间的边界讲不清,后面一旦图片多起来,你自己维护都会乱。
六、真正麻烦的其实不是 clearData,而是 clear 之后怎么 rebuild
clearData() 这件事,最麻烦的从来不是"调用一下这个方法",而是它后面紧跟着的那个问题:
清掉之后,怎么把该有的数据重新建回来?
这也是我觉得第四篇最有工程味的一段。
因为它第一次明显要求你不能只会"调用能力",还得会"恢复状态"。
我最后给自己的重建思路是这样的:
text
确认需要重建
   ↓
调用 clearData
   ↓
遍历自己保存的 imageRecords
   ↓
只对有效记录重新 insertImage
   ↓
成功则 imported = true
   ↓
失败则 imported = false,并记录日志
   ↓
最后汇总重建结果
我把它收成了一个专门的方法:
文件位置: entry/src/main/ets/common/SnapSeekService.ets
用途: 清空并重建检索数据。
arkts
import { ImageRecord } from '../model/ImageRecord'

class SnapSeekService {
  async rebuildIndex(records: ImageRecord[]): Promise<number> {
    // const cleared = await textSearchImage.clearData()
    const cleared = true

    if (!cleared) {
      console.error('[Rebuild] clearData failed')
      return 0
    }

    let successCount = 0

    for (const item of records) {
      // const inserted = await textSearchImage.insertImage(item.path, item.scope)
      const inserted = true
      item.imported = inserted

      if (inserted) {
        successCount++
      }

      console.info(
        `[Rebuild] path=${item.path}, scope=${item.scope}, inserted=${inserted}`
      )
    }

    console.info(`[Rebuild] success count=${successCount}`)
    return successCount
  }
}
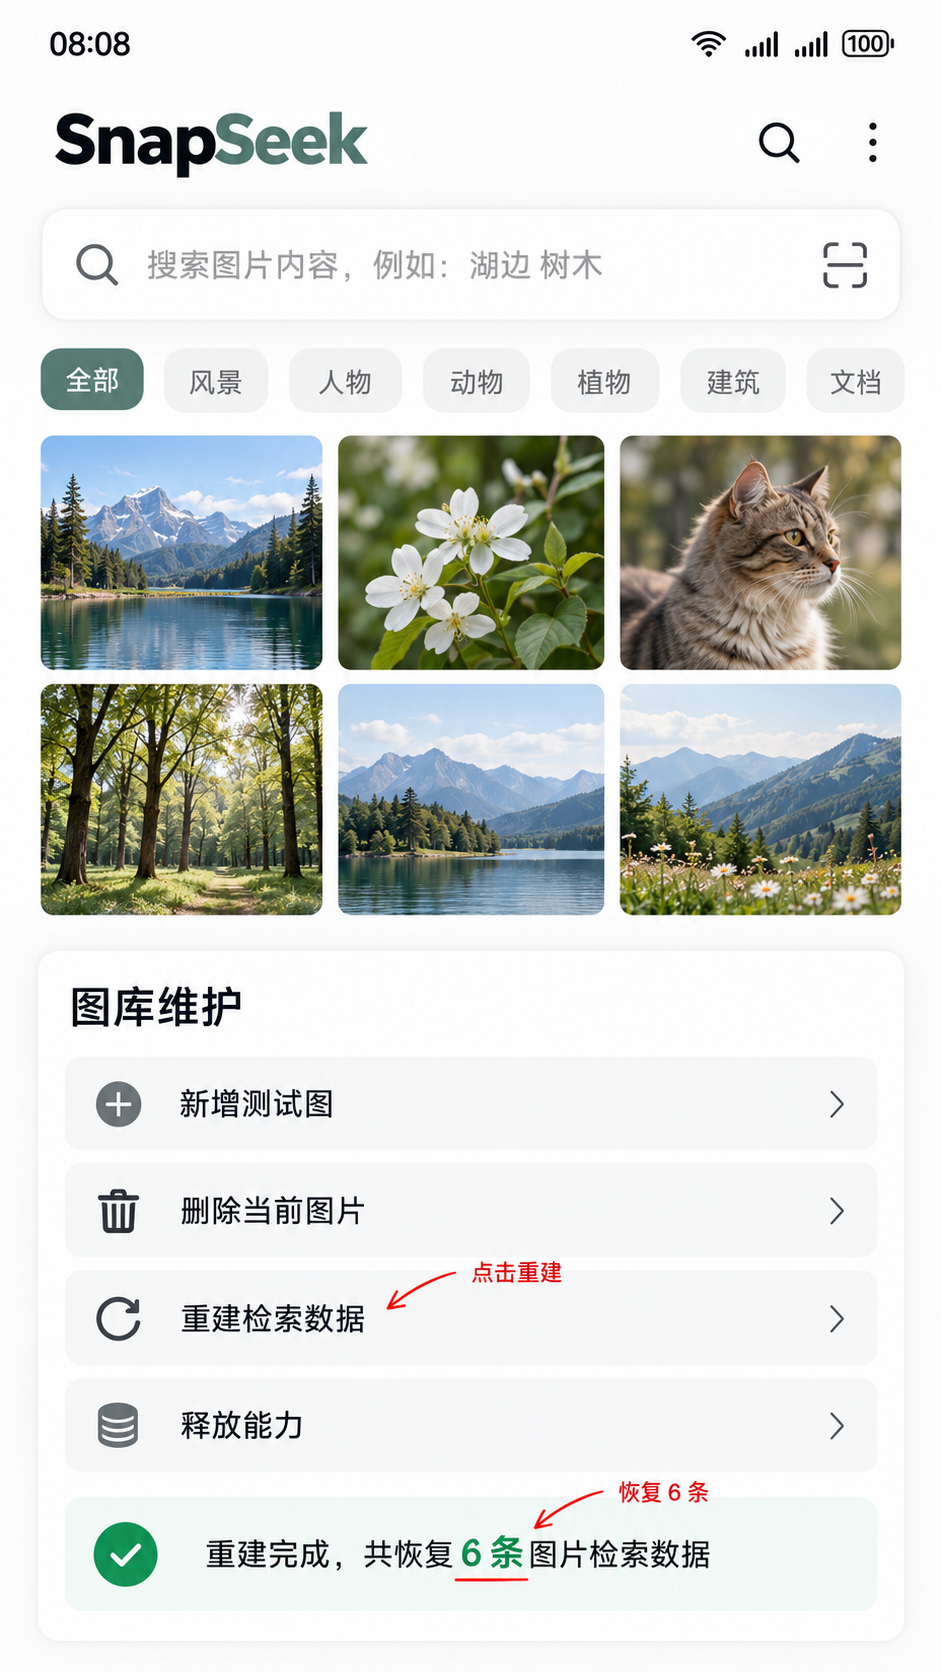
页面侧我会把这件事表达得更接近维护动作,而不是普通按钮操作:
arkts
private async handleRebuild() {
  this.loading = true
  this.statusText = '正在重建检索数据,请稍候...'

  try {
    const successCount = await this.service.rebuildIndex(this.imageRecords)
    this.statusText = `重建完成,共恢复 ${successCount} 条图片检索数据`
  } finally {
    this.loading = false
  }
}
这套结构让我很安心。
因为一旦 SnapSeek 后面真的遇到能力更新、数据错乱或测试环境切换,我至少知道:
- 重建入口在哪;
- 重建顺序是什么;
- 重建成功或失败怎么记录;
- 页面怎么给出反馈。
这就是第四篇比前三篇更像工程实战的地方。
前三篇更多是在搭"能用的功能",第四篇开始搭"可恢复的能力"。
七、异常恢复不该只弹 Toast,最好能留一条完整排查链路
只要开始碰到新增、删除和重建,异常恢复就再也不是一个边角问题了。
因为第四篇里,失败的场景已经明显变多了:
- 图片路径无效;
- 删除时 path 找不到;
- clearData 失败;
- rebuild 过程中有些图插入成功,有些图插入失败;
- 页面看起来恢复了,但其实 imported 状态没更新干净。
如果这时候还只是简单地弹一个 Toast,比如"操作失败",那对调试帮助非常有限。
所以第四篇我特别强调一件事:
异常恢复最好不是一句 Toast,而是一条能回头排查的链路。
这条链路至少应该回答:
- 当前操作是什么?
- 目标图片或 Scope 是什么?
- 成功还是失败?
- 如果失败,失败发生在哪一步?
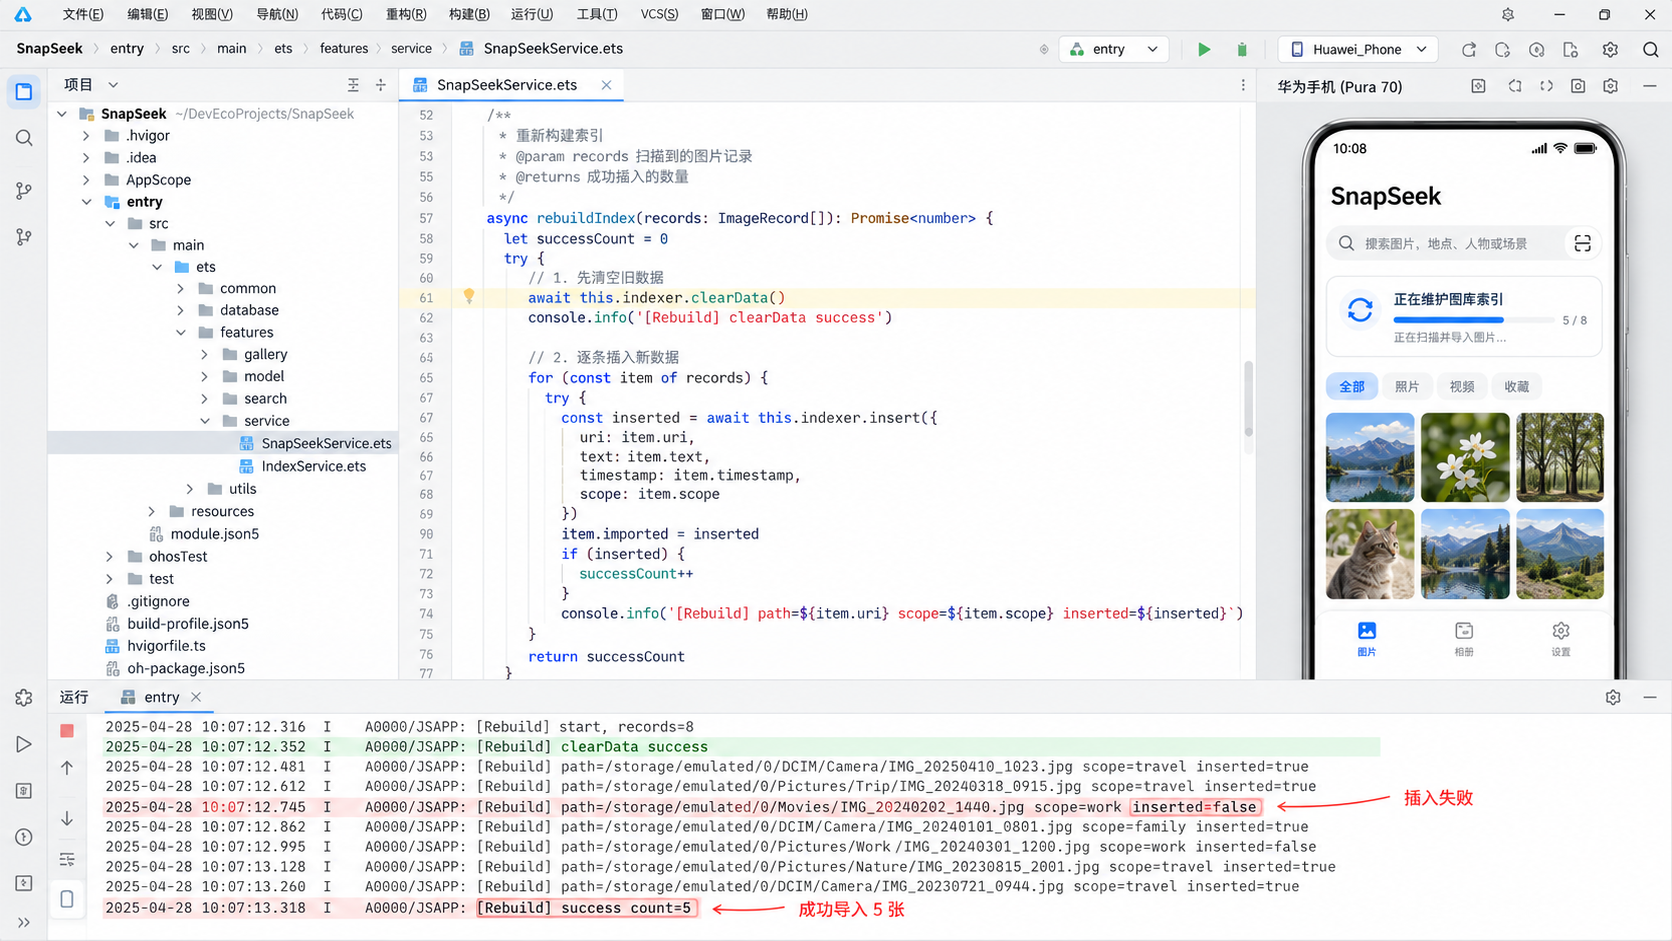
也正因为这样,我这篇里所有新增、删除、重建示例,都会尽量把日志写全一些。
比如重建失败时,日志最好至少是这种粒度:
text
[Rebuild] clearData success
[Rebuild] path=/.../travel_sea_01.jpg scope=travel inserted=true
[Rebuild] path=/.../work_desk_01.jpg scope=work inserted=false
[Rebuild] success count=5
这样你后面再回来看,才知道不是"重建整体失败",而是"某张 work 图片插入失败"。
这和第三篇研究 similarity 的思路其实是一致的:
别只看最终 UI,真正有用的判断往往藏在更细的日志里。
八、release 在第四篇里终于不能再只"预留一下"了
第一篇写 release 时,我其实只是先给结构留了个入口。
因为当时功能还很轻,页面生命周期也不复杂,我不想一开始就把这部分讲得很重。
但第四篇写到这里,release 已经不能再只是"先放着以后再说"了。
原因很简单:
现在 SnapSeek 不只是搜索一次就结束,它已经开始支持:
- 新增图片;
- 删除图片;
- 重建索引;
- 多轮搜索;
- 异常恢复。
这个阶段如果能力使用完以后没有合理释放,后面状态就很容易越积越乱。
所以我的做法是:在页面退出或不再需要当前能力时,显式做一次 release,同时把内部状态也收回来。
文件位置: entry/src/main/ets/common/SnapSeekService.ets
用途: 释放当前检索能力状态。
arkts
class SnapSeekService {
  private initialized: boolean = false

  async release(): Promise<boolean> {
    if (!this.initialized) {
      return true
    }

    // const result = await textSearchImage.release()
    const result = true

    if (result) {
      this.initialized = false
    }

    console.info(`[Release] result=${result}`)
    return result
  }
}
页面侧可以在适合的生命周期或退出操作里调用:
arkts
private async handleRelease() {
  const result = await this.service.release()
  this.statusText = result ? '检索能力已释放' : '释放失败,请稍后重试'
}
这里最重要的一点,不是 release 本身有多复杂,而是你终于开始把 SnapSeek 看成一个有完整生命周期的能力入口,而不只是若干次搜索按钮点击。
这一步做完以后,我会明显觉得第四篇比前三篇完整得多。
因为到这里,SnapSeek 已经有了:
- 数据模型;
- Scope 边界;
- Query 与 similarity 理解;
- 增删维护;
- rebuild 恢复;
- release 收口。
它开始像一个小型但完整的子系统了。
九、我还顺手做了一点"维护模式"的 UI 收口,避免功能越加越乱
第四篇如果只从能力调用角度看,其实已经差不多了。
但我还有个特别明显的感觉:一旦新增、删除、重建、释放这些动作都放进页面,UI 很容易开始变得吵。
因为前几篇的主界面本来比较单纯:
- Scope
- 搜索框
- 搜索结果
现在突然多了:
- 新增图片
- 删除图片
- 重建索引
- 释放能力
这些如果都直接铺在主搜索页面上,读者和用户都会开始分不清什么是"日常搜索动作",什么是"维护动作"。
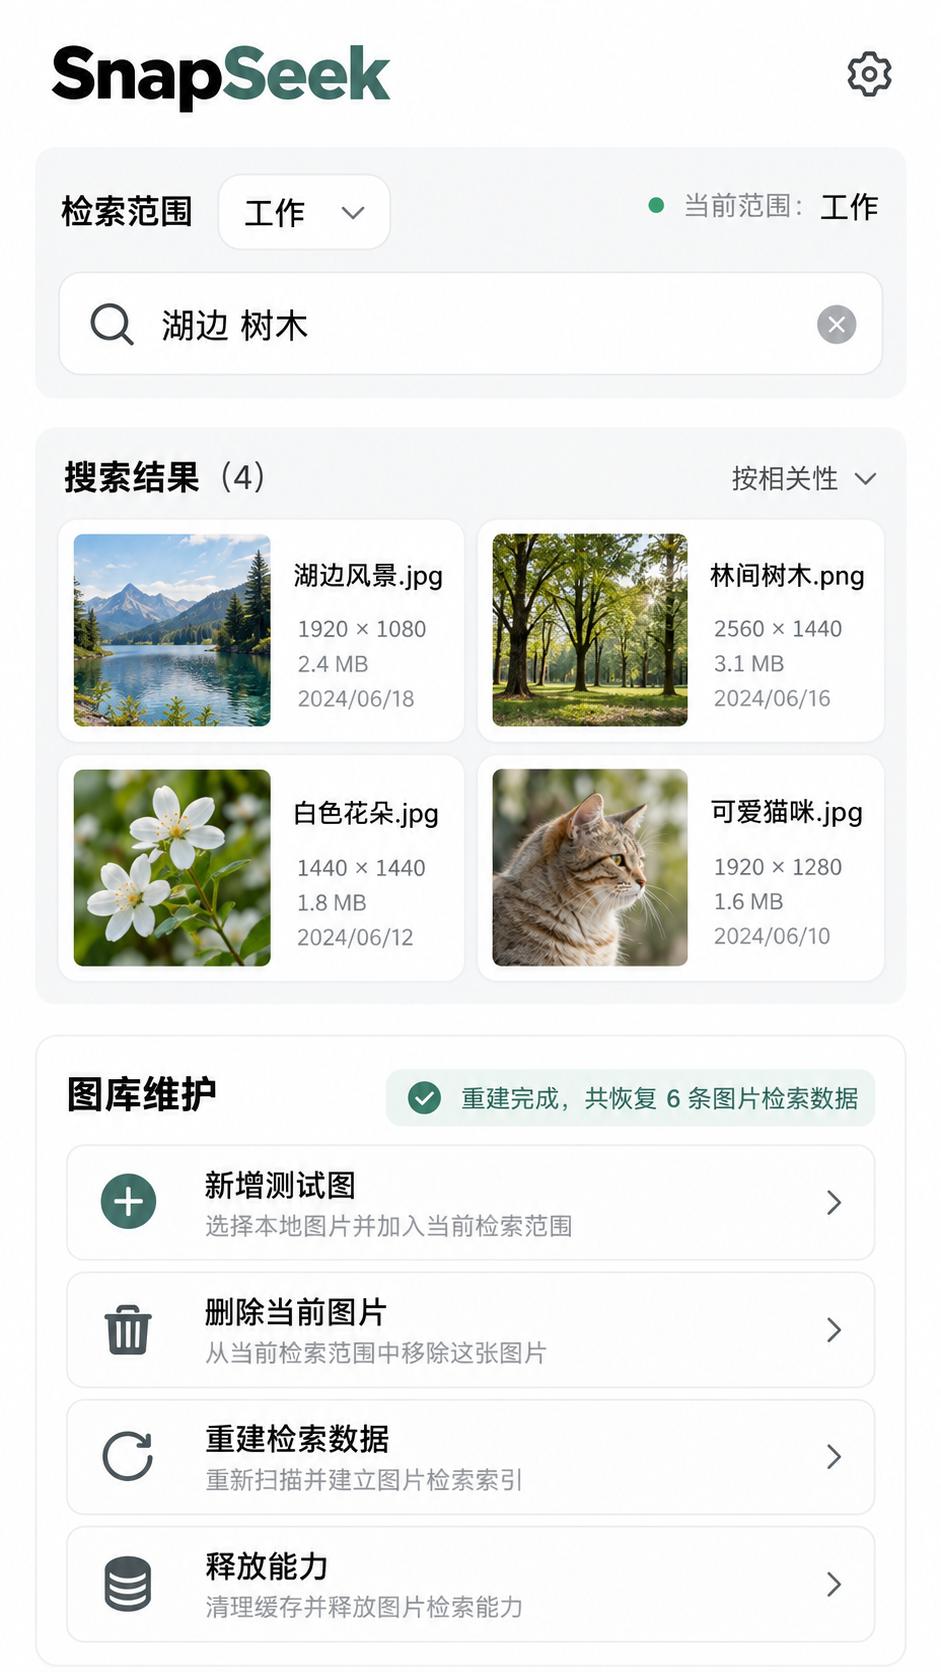
所以第四篇我更倾向于做一个轻量的"维护模式"或"维护区域",把这些功能收在一起。
比如在页面下方加一块较低强调度的卡片区域,标题叫:
text
图库维护里面再放:
- 新增测试图
- 删除当前图片
- 重建检索数据
- 释放能力
这样一来,主搜索区还是主搜索区;
维护动作则明确待在"维护区",不会互相抢焦点。
这件事看着像 UI 整理,其实和工程思路高度一致。
因为第四篇的核心本来就是:
新增、删除、重建、释放,不是普通搜索动作,它们属于维护逻辑。
一旦你在 UI 上也把这层边界表达清楚,整套 Demo 的结构感会强很多。
十、我会怎么验收第四篇:不是看按钮多了几个,而是看状态能不能闭环
第四篇做完以后,我不会用"页面功能更多了"来判断它是不是完成。
因为这篇最重要的从来不是"动作数量",而是状态有没有闭环。
我会重点看下面这些验收点。
1)新增图片后,能不能真正参与搜索
不只是列表里多一张图,而是要确认:
- 记录生成了;
- imported 变成 true;
- 当前 Scope 下重新搜索时,这张图能出现在结果里。
2)删除图片后,结果里是否彻底消失
不只是本地记录删了,还要确保:
- 检索数据删了;
- 当前结果区同步更新了;
- 再次搜索时不再继续返回这张图。
3)重建索引后,状态是否恢复一致
重建完成后,至少要能明确知道:
- 总共恢复了多少条;
- 哪些记录 imported=true;
- 哪些记录失败了;
- 页面状态文案有没有写清楚。
4)clearData 没有被误用成普通分类清空
我会特别检查这一点。
如果第四篇把 clearData 当成高频"清空当前图库"按钮来用,我会觉得这篇方向跑偏了。
5)release 是否真正把能力状态收住
释放后再次进入或重新初始化时,状态要能重新走通,而不是残留一堆旧状态。
6)维护动作和搜索动作有没有边界
UI 上我会看这些功能是不是被适当地收在维护区,而不是全部堆在主搜索流里。
如果这些点都能过,我才会觉得第四篇真正成立了。
它不是单纯多了几段 API 调用,而是开始让 SnapSeek 具备"图库变化以后也能继续稳住"的能力。
十一、第四篇做完以后,第五篇就该进入"工程收口"了
做到第四篇,SnapSeek 其实已经越来越不像一个随手做的小 Demo 了。
它现在已经逐步拥有了:
- 基础搜索链路;
- Scope 分类边界;
- similarity 与 Query 观察;
- 图片增删维护;
- 索引重建与异常恢复;
- release 生命周期收口。
也就是说,真正该有的"会搜 + 会维护"这两层,基本都已经出来了。
所以第五篇我不会再继续单独追一个小功能点了。
更自然的方向,是把整个 Demo 往工程收口上推一步,比如:
- 页面状态如何再整理;
- Service、Model、页面职责怎么进一步划清;
- 调试日志如何保留,哪些该收敛;
- 哪些体验还可以优化,但不必继续把 Demo 做得过重。
如果说前四篇是在搭一套房子的骨架、分隔和维护系统,
第五篇大概就是做最后一次整体收口:
让 SnapSeek 作为一个系列 Demo,看起来不只是"写了五篇",而是真的有一条清楚的演进路线。
十二、本文小记
如果让我给第四篇下一句最直接的总结,我会说:
前三篇把 SnapSeek 做成了"会搜"的东西,第四篇开始把它做成"搜图这件事出了变化也能处理"的东西。
这是一个很重要的转折。
因为只有开始认真处理新增、删除、重建和 release,文搜图这个能力才真正开始像工程里的一个模块,而不是单次演示效果。
这一篇最让我有感觉的,不是某个单独 API,而是那条越来越清楚的维护链路:
text
图片记录
   ↓
新增 / 删除
   ↓
检索数据维护
   ↓
重建与恢复
   ↓
release 收口
到这里,SnapSeek 已经不太像"试试能不能搜"的 Demo 了。
它越来越像一个真正可维护的小工具。
而这也正是我想把第四篇写出来的原因:
技术文章如果只写"能力有多酷",很容易停在表面;
只有写到"能力变动以后怎么维护",工程感才会真正出来。
下一篇,就把整个系列做一次完整收口。