用 OpenViking 把记忆放到 Agent 外面:Agent 接力不丢失上下文,让每个 Agent 做它最擅长的事
晚上十一点,你让 Codex 重构一个支付模块。它已经读完了二十几个文件,跟你确认过三次边界:旧接口先别删,金额统一用分,测试必须跑本地 mock。改到第四个文件,屏幕上跳出一行字:额度已用完。
你打开 Claude Code,准备接着干。然后你意识到,接下来二十分钟要花在"复述"上:这个项目是干嘛的,我们刚才定了哪几条规矩,改到哪个文件了,哪条路已经试过走不通。
这二十分钟不是模型的问题,只是模型什么都不知道。
Agent 可以换,记忆不该跟着 Agent 走。 这篇文章讲 OpenViking 怎么做到这一点,以及你今天就能照着配的具体步骤。
01为什么换 Agent 会让人那么头大?
今天大多数 Agent 都有某种记忆:Claude Code 有 CLAUDE.md 和自带的 memory 目录,Codex 有 AGENTS.md,豆包、ChatGPT 也各有各的"记住你"。问题在于,这些记忆都锁在各自的家里。
- Codex 记住的"金额统一用分",Claude Code 读不到;
- Claude Code 帮你总结的项目约定,豆包工作写方案时用不上;
- 你在三个工具里各说一遍同样的偏好,三份记忆还会慢慢变得不一致。
所以"多 Agent 协作"其实是"多 Agent 轮流失忆",你成了唯一的上下文载体,每次切换都要手动搬运。
解锁跨 Agent Context 和经验,这就是 OpenViking 的价值
OpenViking 让你把记忆从 Agent 里拿出来,统一管理在一个独立的上下文数据库。每个 Agent 装一个很薄的插件后,自动存、自动取,还能用上所有 Agent 沉淀下来的经验。
02OpenViking 是怎么做到记忆放在 Agent 外面?
接入 OpenViking 后,你的 Claude Code、Codex、TraeCode CLI、DeepSeek Harness 等 Agent 都指向同一个 OpenViking 库。之后,你使用的所有 Agent 在运行时都会自动召回、更新一个统一的记忆系统。
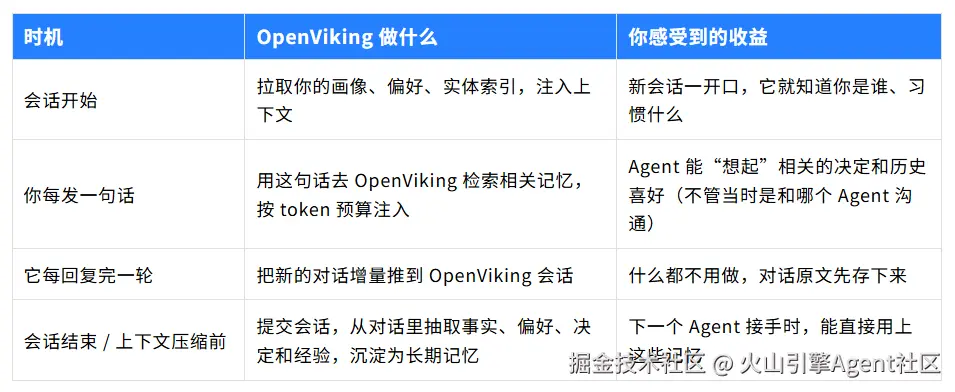
装了插件的 Agent,整个过程不需要模型主动调用任何工具。 存和取都挂在 Agent 自己的生命周期 hook 上。
03常见使用场景
场景一:Agent 额度用完,下个 Agent 无缝接手
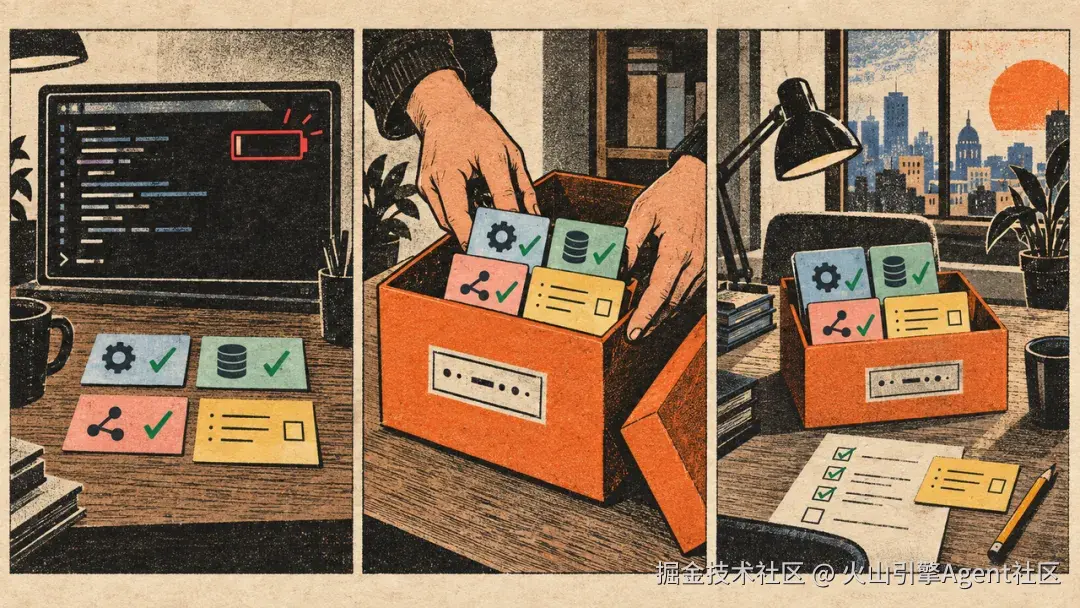
回到开头那个晚上。装了 OpenViking 之后,同样的事情会怎么发展?
22:10,你在 Codex 里开工
你说了三条规矩:旧接口先别删、金额统一用分、测试跑本地 mock。Codex 每回复完一轮就把这一轮追加到 OpenViking 会话里。
23:02,Codex 提示额度用完
你在 Codex 里正常退出,OpenViking 已经开始抽取记忆。
- "金额统一用分"成了项目约定
- "
refund_v1接口暂不删除"成了一条决定 - "已完成 order / invoice / ledger 三个文件,settlement 进行到一半"成了一条事件
23:04,你在同一个目录打开 Claude Code
"继续刚刚 Codex 在做的代码重构"
Agent 会自动用这句话去检索 OpenViking,Codex 刚留下的那几条记忆会被召回,并注入给到 Agent。
新Agent 回复:"上次改到 settlement,金额单位按分处理,refund_v1 保留。我先看 settlement 剩下的部分。"
💡你切换了 Agent,却没有复述任何东西,也不是把 Codex 的整个上下文窗口复制了。
OpenViking 保留原始会话与来源,同时抽取适合长期复用的事实、偏好、实体、事件和经验,让新 Agent 根据当前任务按需召回。需要核对细节时,还可以沿 viking:// URI 读取原文,而不是相信一段脱离来源的摘要。
场景二:让每个 Agent 做它最擅长的事
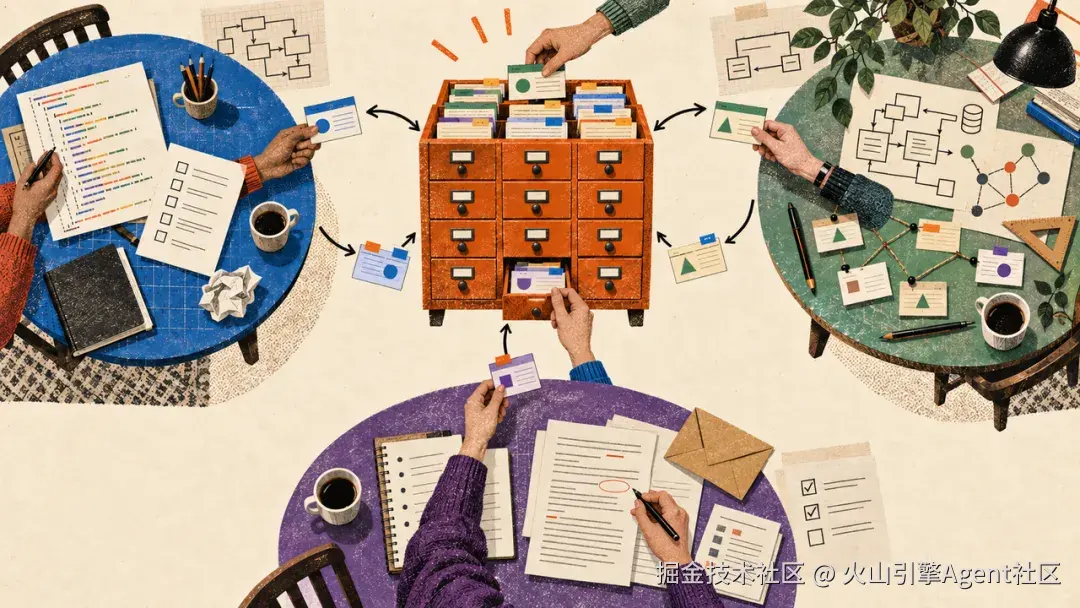
跨 Agent 记忆的价值不只是在额度耗尽时"救场"。更有意思的是主动切换,你本来就同时在用好几个 Agent,因为它们擅长的东西不一样。
一个真实的分工可能是这样:
- 豆包工作: 贴近办公场景的活,比如读飞书文档和群消息、写 PRD、整理周报、把结果同步给团队;
- TRAECode / Codex: 长时间自主跑的工程任务,比如按设计稿实现一个原型、批量改一片代码;
- TRAECode / Claude Code: 需要反复推敲的活,比如代码评审、写技术文档、梳理复杂的排障过程。
以往,这种分工的代价非常大。每换一个 Agent,就要把前一个 Agent 的产出和结论重新喂一遍。
有了 OpenViking 的共享记忆,多 Agent 工作流程变成真正的接力
- 先利用豆包工作: 读完客户群里的反馈和相关飞书文档,整理出需求要点。确认后,让豆包工作把结论写入 OpenViking。
- Codex / TRAECode 在项目仓库里开工,一开始就召回了豆包工作保存下来的需求要点,照着实现原型。实现过程中的取舍自动沉淀到 OpenViking 内。
- Claude Code / TRAECode 做评审和文档。它知道需求来自哪次客户反馈,也知道 Codex 做了哪些取舍,评审意见不会绕回已经定下来的事。评审反馈和改动同样沉淀到 OpenViking 内。
- 回到豆包工作写上线说明,前面三步的结论它都拿得到。
每个 Agent 读的是同一份记忆,写回的也是同一份记忆。 你负责判断和拍板,不再负责搬运。
04如何把跨 Agent 接力跑起来?(3 步接入验证)
第一步:准备一个 OpenViking 服务
- 【建议】开通火山引擎的 OpenViking 云服务:console.volcengine.com/vikingdb/op...
- 本地部署:细节请查阅:docs.openviking.ai/zh/getting-...
第二步:给每个 Agent 装插件
按下面的指引,给你的 Agent 安装插件并验证连接:
- 火山引擎的 OpenViking 云服务:docs.volcengine.com/docs/vector...
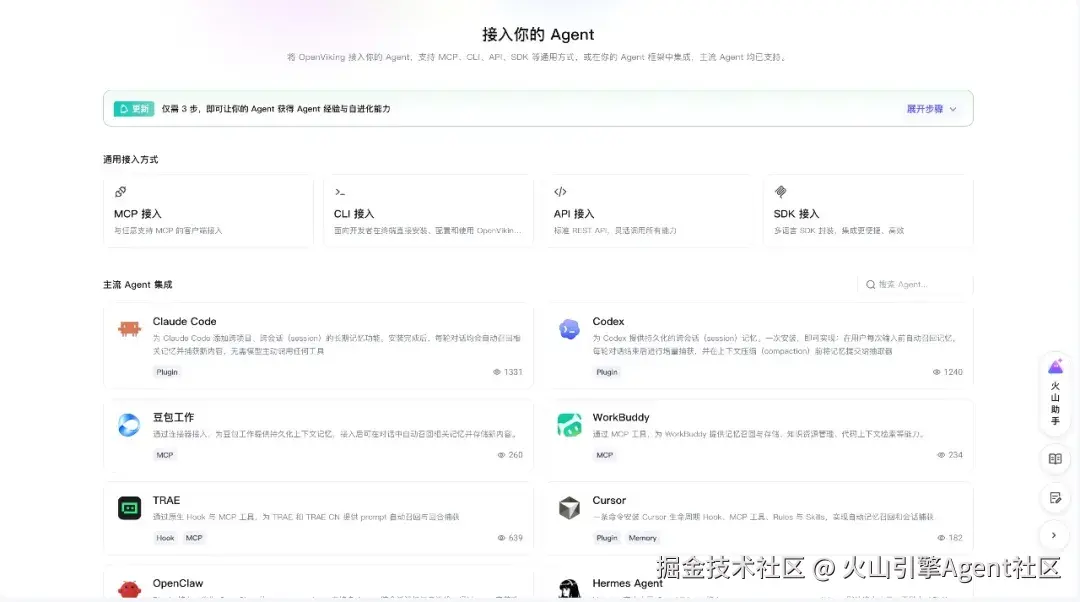
第三步:体验 OpenViking 能力
Codex 中断,Claude Code 接手,TRAECode 完成
- 在 Codex 里依次发送:
markdown
我们来做一次代码开发的记忆测试。先定三条规矩:
1. 金额字段统一用"分"(整数)存储;
2. 旧接口 refund_v1 先不要删;
3. 测试只跑本地 mock,不连真实支付网关。
请复述一遍确认。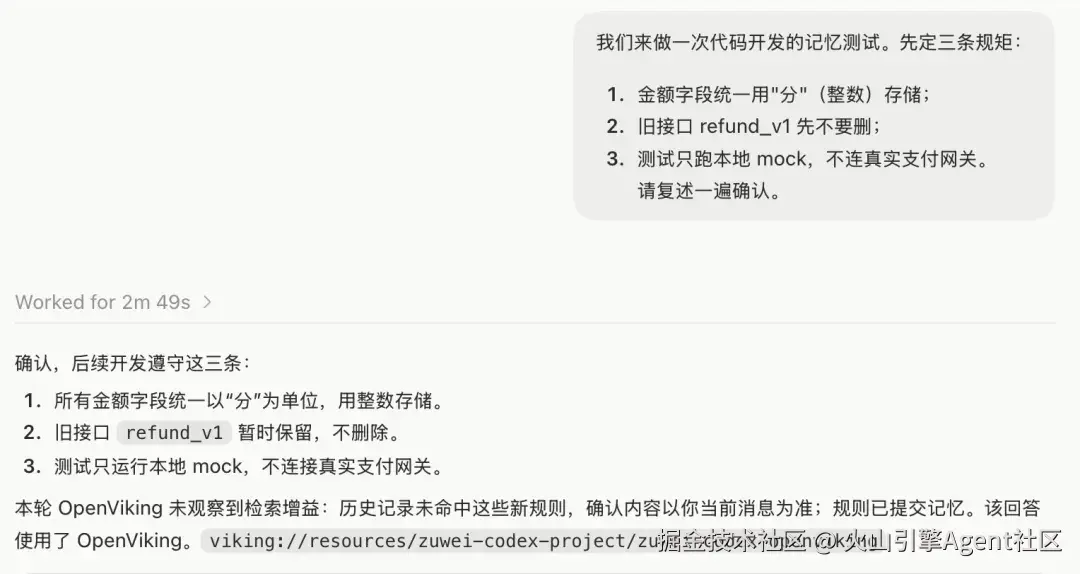
-
正常退出,模拟额度用完。等待片刻,让 OpenViking 完成记忆抽取。
-
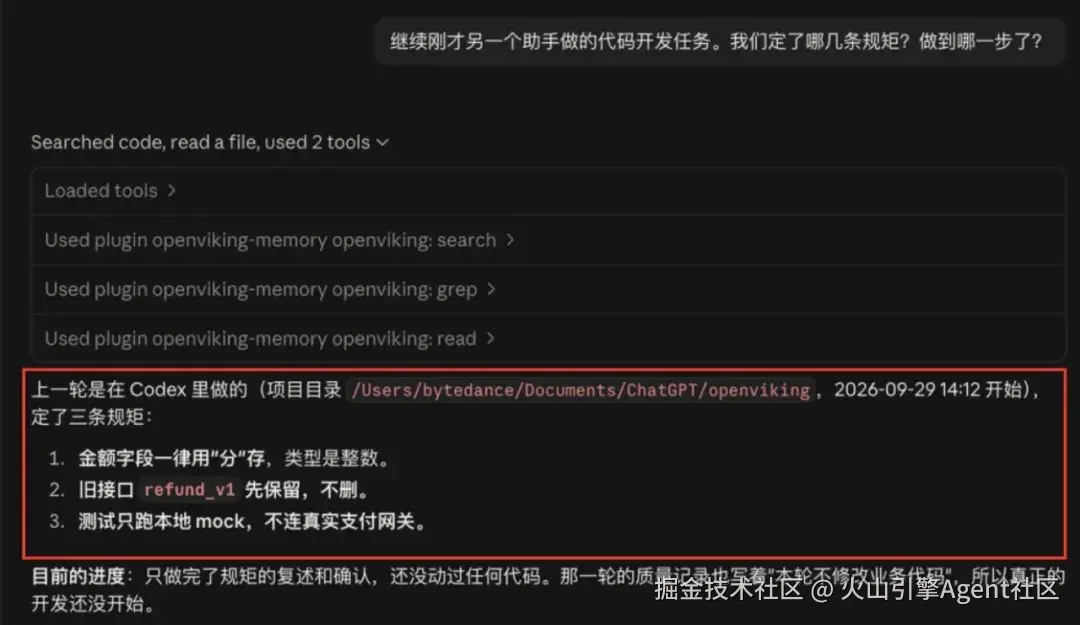
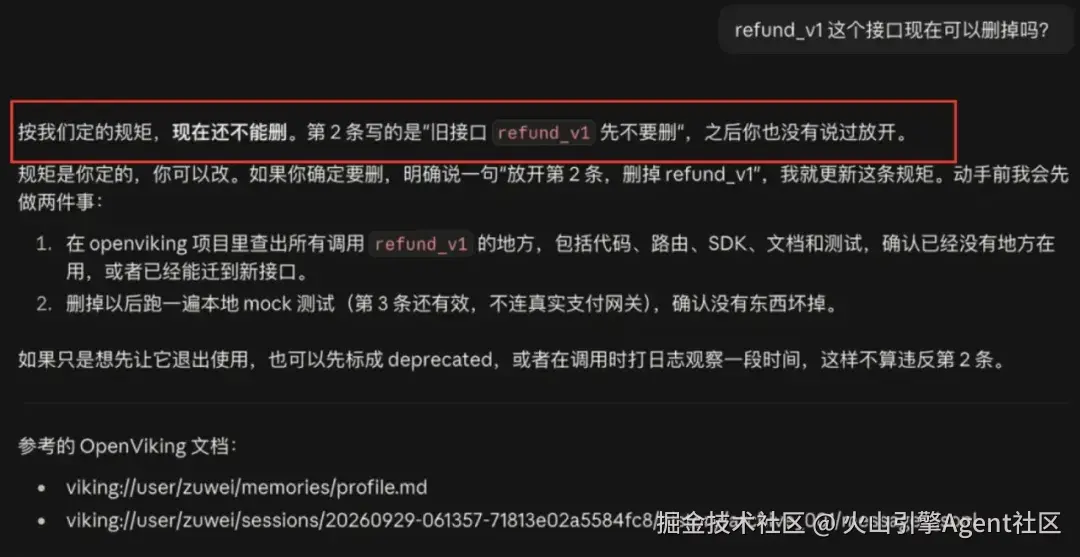
在同一个目录打开 Claude Code,依次发送:
makefile
Q1: 继续刚才另一个助手做的代码开发任务。我们定了哪几条规矩?
Q2: refund_v1 这个接口现在可以删掉吗?
✅️ Q1 预期结果: 能说出三条规矩
✅️ Q2 预期结果: 回答"不能删,要保留"
- 开启 TRAECode CLI,发送下面内容。
提问
arduino
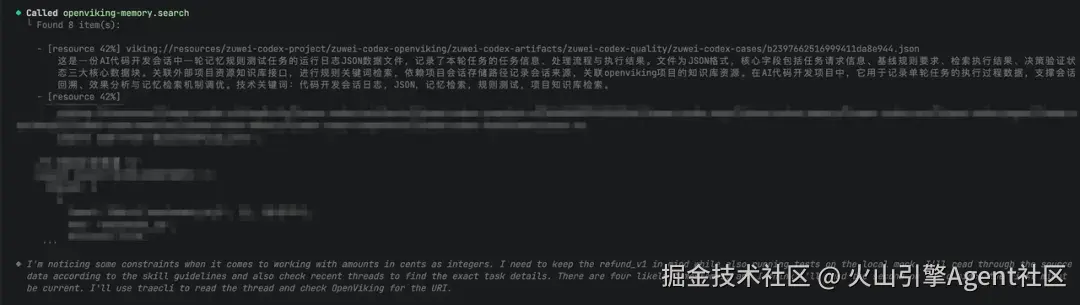
继续刚才另一个助手做的代码开发任务。
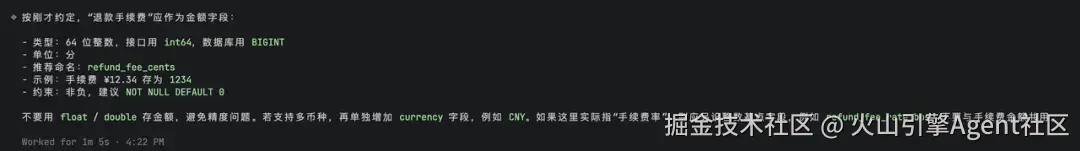
我想在需求内新加一个"退款手续费"字段,应该用什么类型和单位存?
✅️ 预期结果: 回答"整数,单位是分"

调用 OpenViking 获取了 Codex 保存的记忆
Agent 答复
再回到那个晚上十一点,额度用完的提示不再意味着"从头讲一遍"。过去,你是几个 Agent 之间唯一的记忆。现在这件事交给 OpenViking,你只需要决定下一件事交给谁,OpenViking 让你的 Agent 无缝接力。
🚀 上手试用,前 50 文档免费:volcengine.com/product/openviking-service
🌟 开源 OpenViking:github.com/volcengine/... Star!
💬 加入飞书交流群!