流式调用
invoke和stream有什么区别?
invoke():同步调用,在模型输出完成后一次性获取响应,对于输出文本很长的场景,用户体验不好
stream():流式调用,实时返回响应片段。调用后,返回一个迭代器(iterator),可以通过循环来实时处理每一个新生成的chunk内容块
注意:流式输出依赖于模型供应商对于流式输出的支持
bash
from langchain.chat_models import init_chat_model
from dotenv import load_dotenv
import os

from langchain_core.messages import HumanMessage

load_dotenv(override=True)
CLOSEAI_API_KEY = os.getenv("CLOSEAI_API_KEY")
CLOSEAI_API_BASE = os.getenv("CLOSEAI_API_BASE")

model = init_chat_model(
    model = "gpt-6-luna",
    api_key = CLOSEAI_API_KEY,
    base_url = CLOSEAI_API_BASE,
)

response2 = model.stream([HumanMessage("你是啥模型")])
for chunk in response2:
    print(chunk.content,end="")
stream()方式的优点:
- 响应速度更快 ------ 用户不必等待完整输出
- 交互体验更流畅 ------ 尤其在长文本或复杂推理场景下
- 可实时展示模型思考过程
批量调用
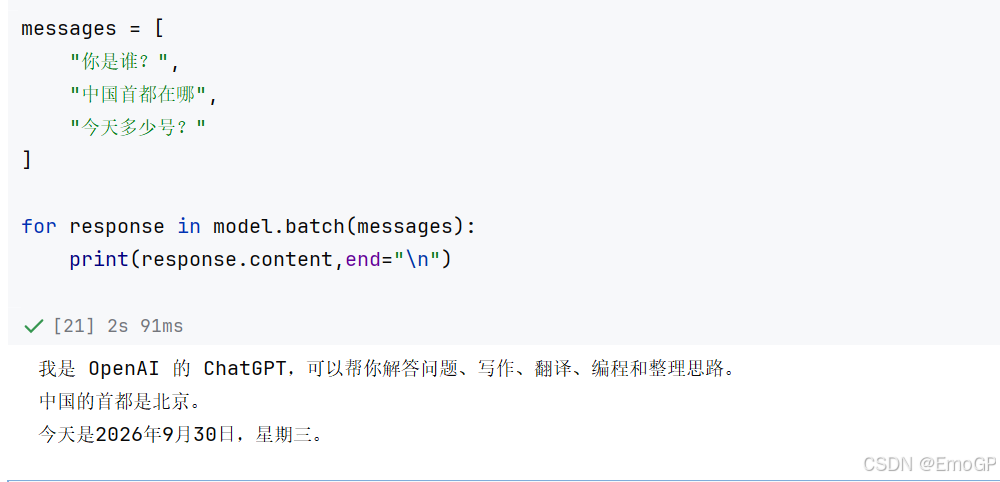
batch()方法允许你一次性发送一组请求(含多条独立请求),模型会在后台并行处理,然后返回所有结果的列表。
与逐个顺序调用相比,能大幅减少网络往返开销和等待时间,显著提升性能、降低成本
适用场景:文档摘要、批量问答、数据预处理、多样本分类等
一次性接收所有响应
batch()特点是等待所有请求处理完毕,按原始输出顺序返回结果列表
按完成顺序接收响应
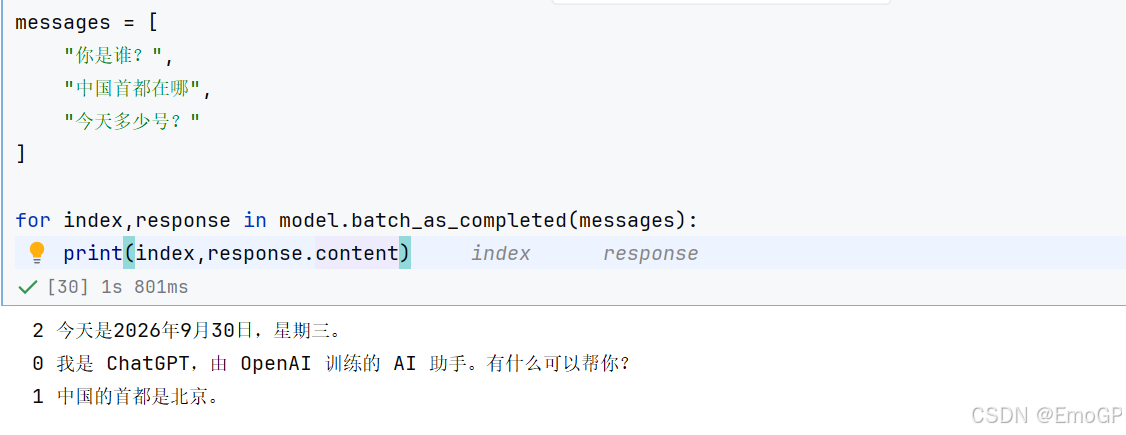
当输入列表很大或单个模型调用耗时差异显著时,batch_as_completed()允许应用在收到第一个结果后立即返回响应,而不会等待批次内所有任务完成才响应。即batch_as_completed()每个请求完成后立即yield结果,结果可能乱序。
但是,每个返回的响应都被放在一个元组中,元组的第一个元素是原始输入的Index索引,可根据索引重新排序
性能对比
使用batch():
bash
# 准备多个输入
inputs = [
"翻译成英文:春天来了",
"翻译成英文:夏天很热",
"翻译成英文:秋天落叶",
"翻译成英文:冬天下雪"
]
# ✅ 批量调用(高效)
import time
start = time.time()
responses = model.batch(inputs)
batch_time = time.time() - start
print("批量调用结果:")
for i, response in enumerate(responses):
    print(f"{i+1}. {response.content}")
print(f"耗时: {batch_time:.2f}秒\n")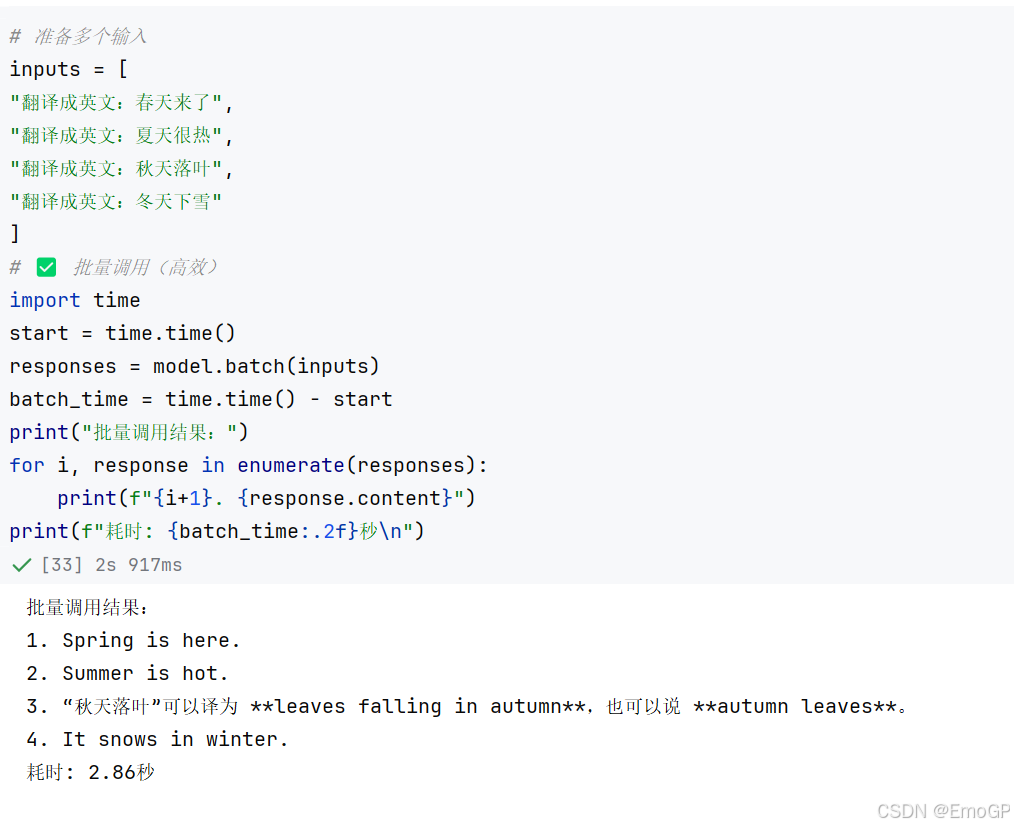
使用循环调用invoke():
bash
# ❌ 循环调用(低效,仅用于对比)
inputs = [
"翻译成英文:春天来了",
"翻译成英文:夏天很热",
"翻译成英文:秋天落叶",
"翻译成英文:冬天下雪"
]
start = time.time()
loop_responses = []
for inp in inputs:
    response = model.invoke(inp)
    loop_responses.append(response)
loop_time = time.time() - start
for i, response in enumerate(responses):
    print(f"{i+1}. {response.content}")
print(f"循环调用耗时: {loop_time:.2f}秒")
print(f"批量调用节省: {((loop_time - batch_time) / loop_time * 100):.1f}%")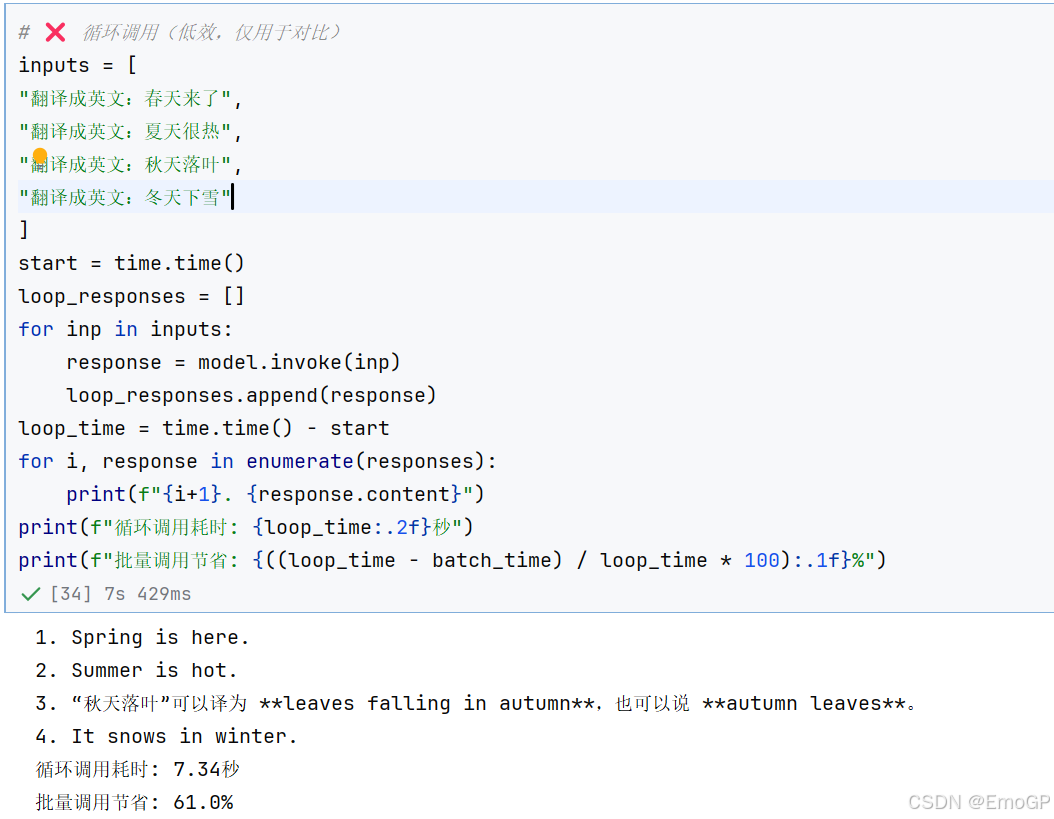
异步调用
同步 vs 异步
同步(sync):
概念:发起一个任务之后,需要等待该任务完成后,才能继续执行后续任务
表现:当前执行流会被阻塞
异步(async):
概念:发起一个任务之后,不必等待该任务完成,就可以继续执行其他任务
备注:虽然不必等待任务完成,但任务完成后,仍然可以通过特定方式获取结果。
表现:当前执行流不会被阻塞
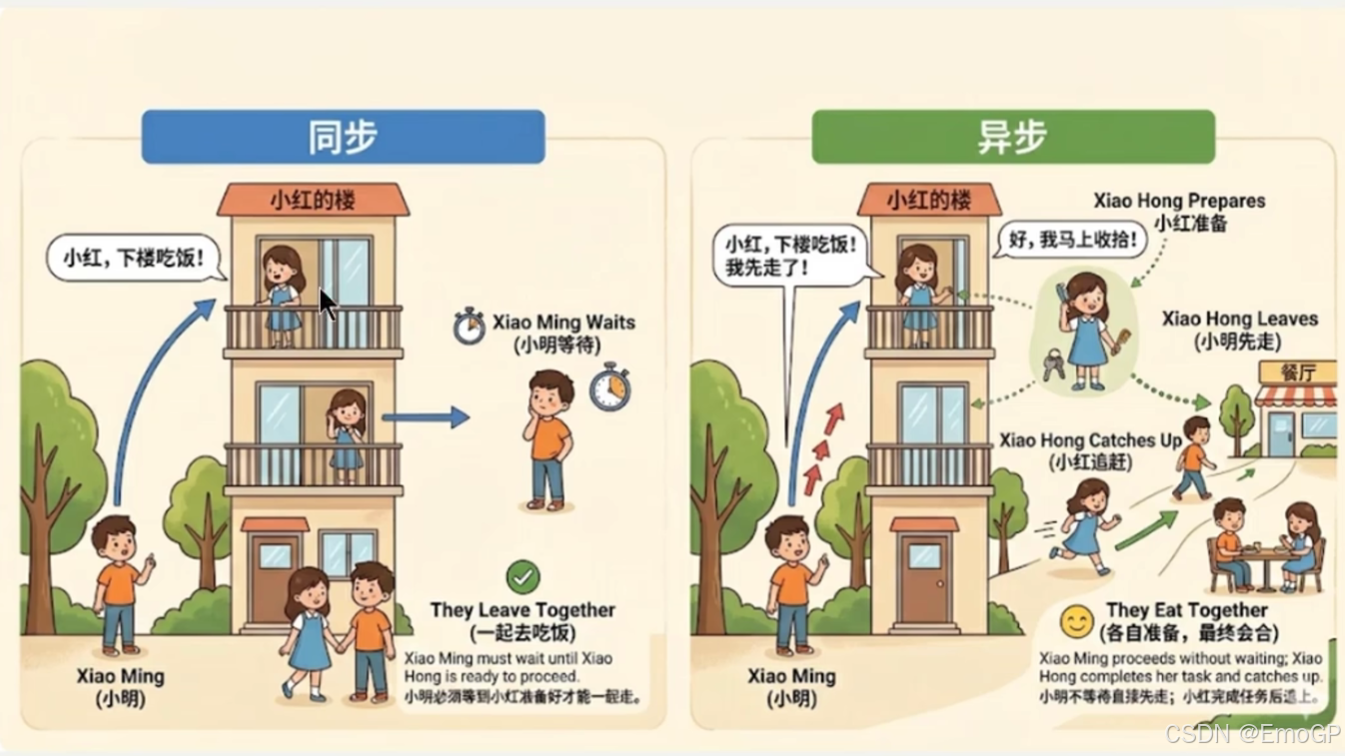
在LangChain框架中,异步方法(ainvoke、astream、abatch)与它们的同步版本(invoke、stream、batch)相比,具备如下特点:
避免阻塞主线程:同步调用会阻塞程序执行,而异步方法让应用程序在等待API响应时保持响应性
优化资源利用:异步操作可以更高效地利用系统资源,减少空闲等待时间
bash
from langchain.chat_models import init_chat_model
from dotenv import load_dotenv
import os
import asyncio
import time

load_dotenv(override=True)
CLOSEAI_API_KEY = os.getenv("CLOSEAI_API_KEY")
CLOSEAI_BASE_URL = os.getenv("CLOSEAI_API_BASE")

model = init_chat_model(
    model="openai:gpt-5.4-mini",
    api_key=CLOSEAI_API_KEY,
    base_url=CLOSEAI_BASE_URL,
)

async def demo_async_invoke():
    print("=== 演示:ainvoke 的异步(非阻塞)效果 ===")
    start_time = time.perf_counter()
    print("程序开始...")

    print(">>> 发起异步模型调用 (ainvoke)...")
    async_task = asyncio.create_task(model.ainvoke("用一句话解释人工智能。"))

    print(">>> 模型请求已在后台发送,继续执行本地逻辑...")
    for i in range(3):
        await asyncio.sleep(1)
        print(f">>> 正在执行第{i + 1}个任务... (已耗时 {time.perf_counter() - start_time:.2f}s)")

    print(">>> 本地任务完成,检查模型状态...")
    response = await async_task
    end_time = time.perf_counter()
    print(f">>> 模型返回: {response.content}")
    print(f"=== 总运行耗时: {end_time - start_time:.2f}s ===")

async def main():
    await demo_async_invoke()

# Notebook 里直接这样调用
await main()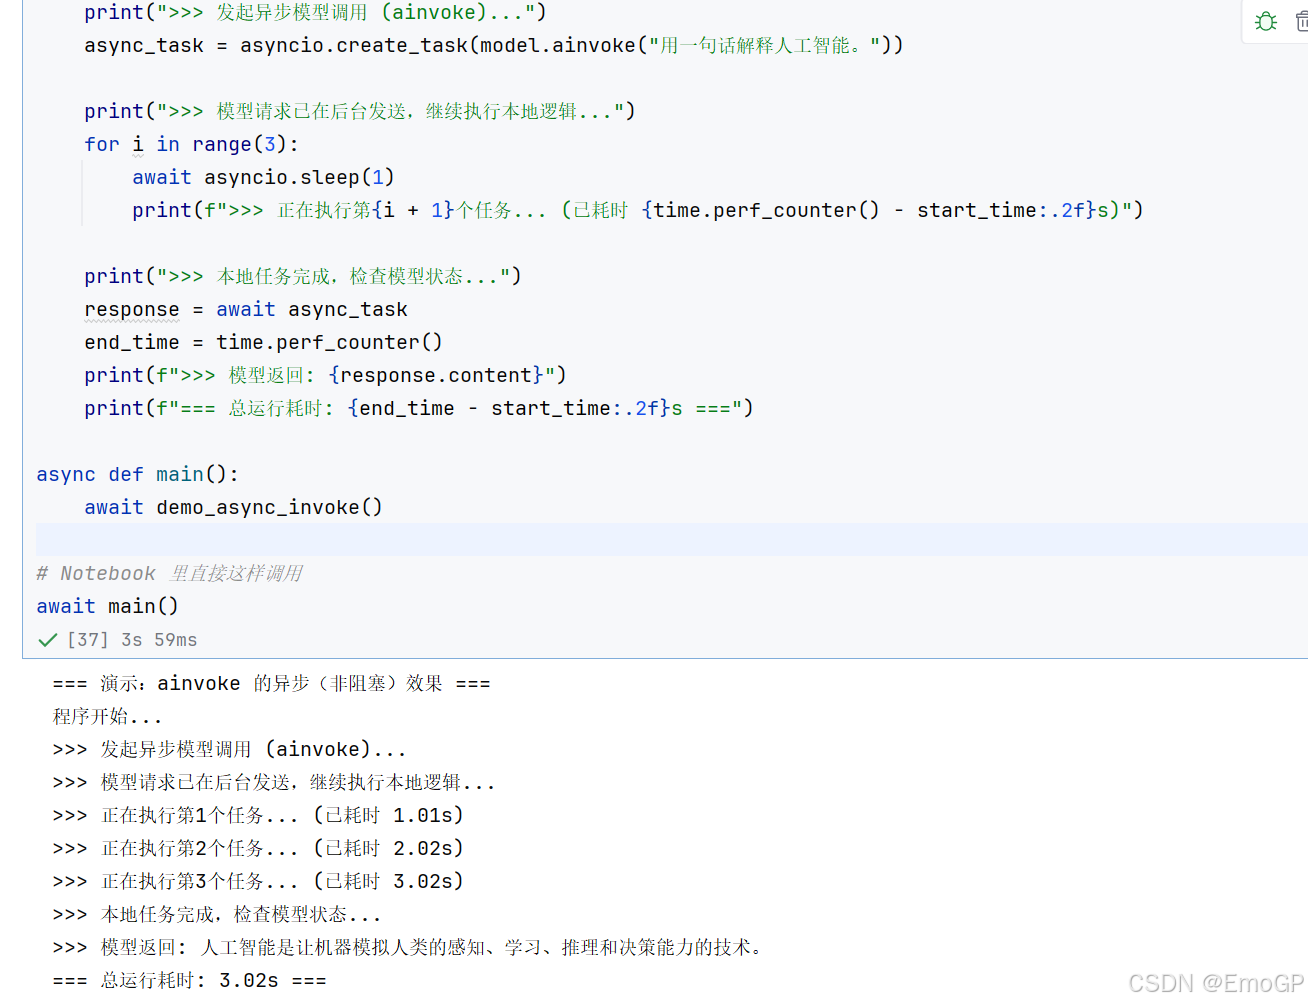
astream
bash
import asyncio
import os
from langchain.chat_models import init_chat_model
from dotenv import load_dotenv
import time
# 从.env文件中加载环境变量
load_dotenv(override=True)
CLOSEAI_API_KEY = os.getenv("CLOSEAI_API_KEY")
CLOSEAI_BASE_URL = os.getenv("CLOSEAI_API_BASE")
model = init_chat_model(
    model="openai:gpt-5.4-mini",
    api_key=CLOSEAI_API_KEY,
    base_url=CLOSEAI_BASE_URL
)
async def demo_async_stream():
    """演示异步调用的非阻塞特性"""
    print("=== 演示:astream 的异步(非阻塞)效果 ===")
    start_time = time.perf_counter() # 记录开始时间
    print("程序开始...")
    # 1. 发起异步流式请求
    # 注意:此时请求已发出,返回的是一个异步生成器
    print(">>> 发起异步流式调用 (astream)...")
    stream_resp = model.astream("请用一句话解释机器学习的基本概念。")
    # 2. 在等待流式响应的同时,执行其他任务
    print(">>> 流式请求已发送,程序无需等待,继续执行其他异步任务...")
    for i in range(3):
    # 使用 asyncio.sleep 而非 time.sleep
    # 这允许事件循环在等待时去处理上面的 stream_resp 网络 IO
        await asyncio.sleep(1)
# print(f">>> 正在执行并发任务 {i + 1}... ")
        print(f">>> 正在执行第{i + 1}个任务... (已耗时 {time.perf_counter() -
start_time:.2f}s)")
# 3. 现在开始处理流式结果
    print(">>> 模拟任务已完成,开始读取缓冲区中的流式结果...")
    end_time = time.perf_counter()
    print(">>> 流式输出: ", end="", flush=True)
    async for chunk in stream_resp:
        # LangChain 的消息块通常通过 .content 获取内容
        content = chunk.content if hasattr(chunk, 'content') else str(chunk)
        print(content, end="", flush=True)
    print("\n>>> 流式输出结束\n")
    print(f"=== 总运行耗时: {end_time - start_time:.2f}s ===")
async def main():
    """主函数"""
    await demo_async_stream()
if __name__ == "__main__":
    asyncio.run(main())
abatch:
bash
import asyncio
import os
from langchain.chat_models import init_chat_model
from dotenv import load_dotenv
import time
# 从.env文件中加载环境变量
load_dotenv(override=True)
CLOSEAI_API_KEY = os.getenv("CLOSEAI_API_KEY")
CLOSEAI_BASE_URL = os.getenv("CLOSEAI_API_BASE")
model = init_chat_model(
    model="openai:gpt-5.4-mini",
    api_key=CLOSEAI_API_KEY,
    base_url=CLOSEAI_BASE_URL
)
async def demo_async_batch():
    """演示异步批量的非阻塞特性"""
    print("=== 演示:abatch 的异步(非阻塞)效果 ===")
    start_time = time.perf_counter() # 记录开始时间
    print("程序开始...")
    # 准备批量输入
    questions = ["用一句话说明深度学习与传统机器学习的区别", "中国首都在哪里?"]
    # 1. 发起异步批量请求
    # 关键修改:使用 create_task 让协程立即在后台执行
    print(">>> 发起异步批量调用 (abatch)...")
    batch_task = asyncio.create_task(model.abatch(questions))
    # 2. 在等待批量处理的同时,执行其他任务
    print(">>> 批量任务已在后台运行,主程序继续执行...")
    for i in range(3):
        # 关键修改:使用 asyncio.sleep 允许后台任务获取 CPU 时间片进行网络请求
        await asyncio.sleep(1)
        print(f">>> 正在执行第{i + 1}个任务... (已耗时 {time.perf_counter() -
                                                    start_time:.2f}s)")
    # 3. 等待批量处理结果
    print(">>> 其他任务已完成,现在获取后台批量任务的结果...")
    # 此时 batch_task 可能已经完成,或者我们在这里等待它完成
    responses = await batch_task
    end_time = time.perf_counter()
    for response in responses:
        content = response.content if hasattr(response, 'content') else str(response)
    print(f">>> 响应内容: {content}")
    print(f"=== 总运行耗时: {end_time - start_time:.2f}s ===")


async def main():
    """主函数"""
    await demo_async_batch()
if __name__ == "__main__":
    asyncio.run(main())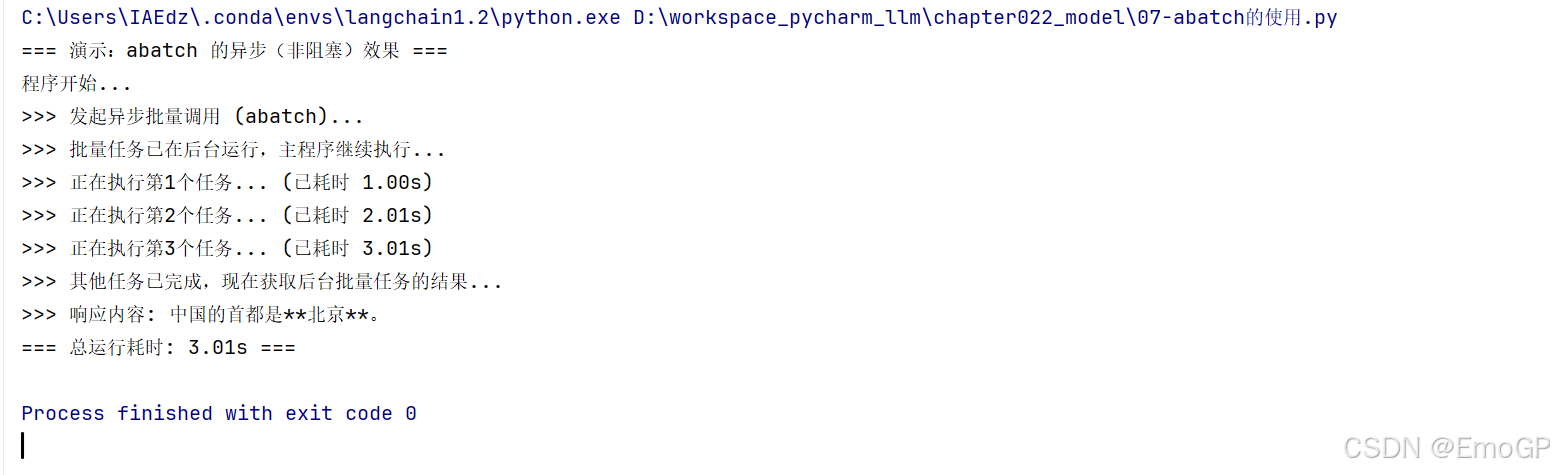
如何处理API调用失败
使用try-except块捕获异常: