💡 一句话总结:腾讯把 WeVisDoc 的 backbone 锁死在 Qwen3-VL 2B/4B 上,只靠两阶段数据工程------先铺覆盖、再按残差补短板------把端到端文档解析推到 OmniDocBench 95.38 分的第一梯队,而且增益几乎全部落在拍照、影印这类真实退化页面上。对做数据管线的同学来说,这篇真正的干货是那套「按 token 预算配数据」的账本算法。
做文档解析的都知道现在有多卷:dots.ocr、DeepSeek-OCR、GLM-OCR、PaddleOCR-VL......端到端解析模型几乎月月出新,OmniDocBench 的分数也开始了 90+ 通货膨胀。你的感受大概和我一样:再看下去,分数已经分辨不出好坏模型了。
那下一步卷什么?腾讯 WeVisDoc 团队给的答案特别朴素:别动模型,去算数据的账 。这篇论文从头到尾没提任何新架构------backbone 就是现成的 Qwen3-VL,2B 和 4B 两个尺寸全程锁死,输出格式、训练目标也全部固定。它只回答一个问题:训练语料要怎么建、怎么分配,才能让解析器在干净页面和脏页面上都可靠?
想自己上手?资源在这:
- 📄 论文 · arXiv 2609.20423
- 💻 代码 · GitHub · Tencent/WeVisDoc
- 🧩 模型 · HuggingFace · WeVisDoc-4B / WeVisDoc-2B
- 🏠 项目主页 · tencent.github.io/WeVisDoc
🧊 先问一个扎心的问题:你缺的是数据,还是训练?
这是全文最值钱的洞察。做数据管线的团队经常把两件事混在一起说「加数据」:
- 扩覆盖:收集、检索、合成新数据------让模型见过以前没见过的版式;
- 加暴露:对已有数据重加权、重采样------让模型多练已经见过的弱项。
这两者是完全不同的干预。更麻烦的是,残差错误高不等于覆盖有缺口:误差可能来自标注本身不可靠、图片糊到内容不可读、解码失败停不下来,或者干脆是模型容量到顶了。这些情况下你再补一万张相似的图,预算也是白烧。
还有一个特别容易踩的坑:按「条数」配数据。一条整页论文的标注可能上万 token,一条孤立公式只有几十 token。按记录数一比一配比,等于让「一条公式」和「一篇论文」在训练里说了同样多的话------这显然不对。WeVisDoc 的解法是把所有预算统一换算成 loss-bearing target tokens(真正计入损失的目标 token 数),再用长度修正公式反推每条记录的采样概率。这个口径转换几乎可以直接抄到任何自回归 parser 的数据配比里。
🛠️ 两阶段打法:先铺地板,再补短板
Stage I 叫「广覆盖构建」,目标是把语义、结构、外观三个维度的地板铺平。数据来自四个异构来源:开源数据集、内部生产文档、定向爬取、程序化合成,统一转成整页、区域、组件三种粒度。
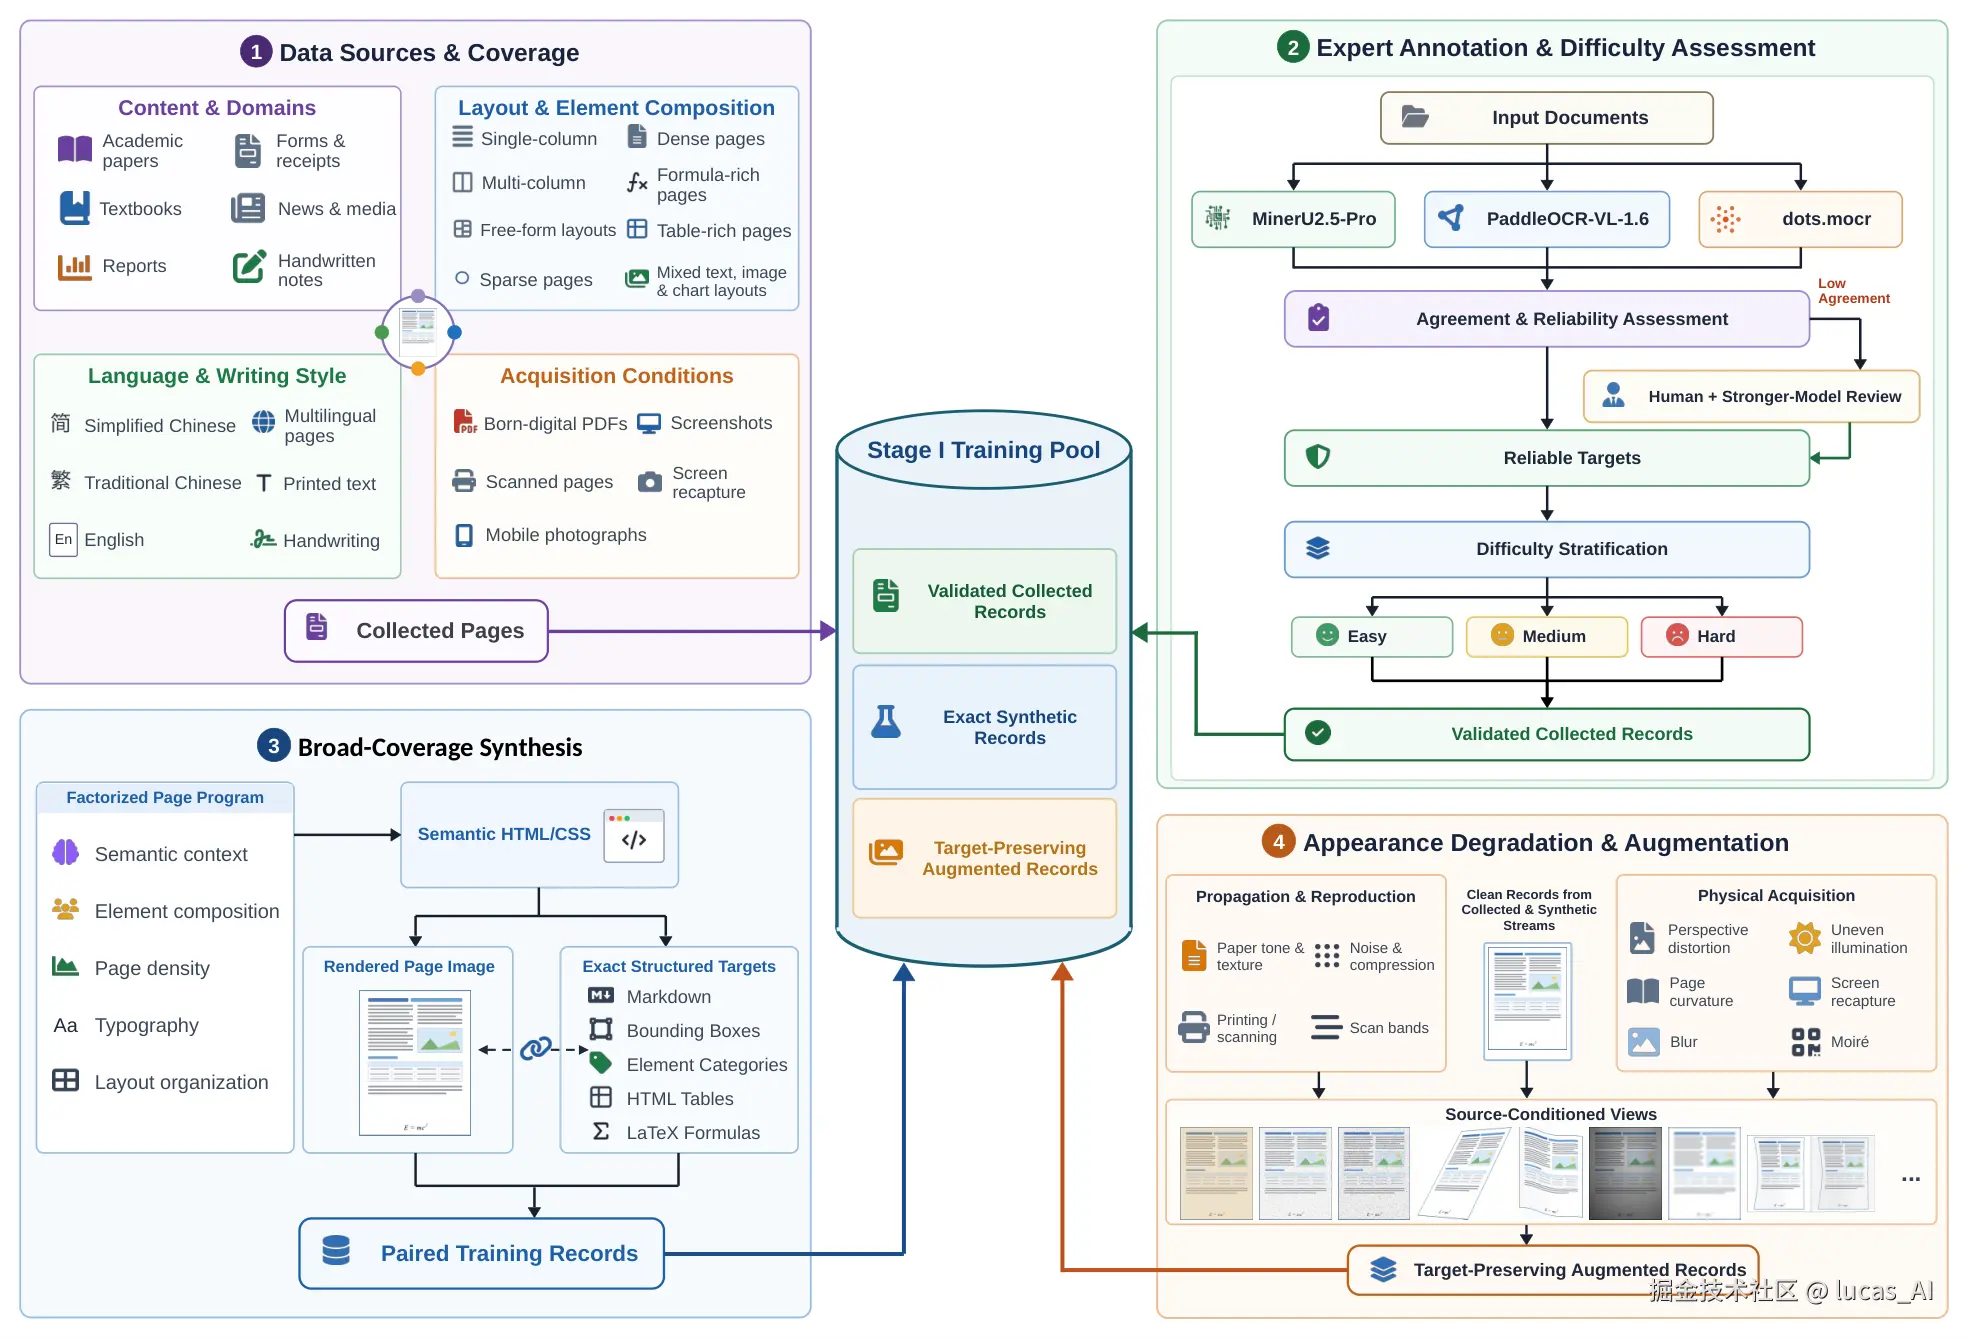
这里有两个设计值得展开。一是双编译合成:用语义 HTML 当中间表示,一份页面程序同时编译出两个东西------渲染出来的页面图像,和精确到节点 ID 的结构化标注(阅读顺序 Markdown、HTML 表格、LaTeX 公式)。监督信号来自生成源而非事后标注,所以阅读顺序这类最难标的信息是免费拿到的。
二是「一致性不等于正确性」的标注哲学:三个专家 parser(MinerU2.5-Pro、PaddleOCR-VL-1.6、dots.mocr)两两算归一化编辑距离,全对上才算高置信候选------但三个模型可能在同一个表格上犯一样的错,所以高误差样本还必须归因:是标注错、模型错,还是图本身看不清?分不清就不许进训练。
Stage I 练出第一版模型后,Stage II「能力感知精修」开始还债。流程是:在与训练完全解耦的留出探针上,按视觉-结构聚类逐簇测残差------哪个簇的模型还在犯错,就定向合成哪类数据(公式密集页、嵌套表格、报纸排版......),再把硬例过采样、Stage I 数据 replay 按固定 token 预算重新分配。
重分配那步做得相当克制:提案分布由「自然 token 份额 × 残差严重度」加权生成,然后 KL 投影回「相对自然份额有上下界」的可行域。说白了就是:弱项可以加练,但不许把训练分布扭曲到忘了正事。
📸 脏页面才是主战场:退化增强的准入条件
文档解析的真实场景是什么?是用户拿手机拍合同、扫老化影印件、翻拍屏幕------不是论文 PDF 的原生数字页。WeVisDoc 按物理采集路径组织退化算子:影印要依次经过纸张油墨、设备复制、相机拍摄三段变换;屏幕翻拍有摩尔纹和彩色条纹;还有透视、曲面、折痕、运动模糊。
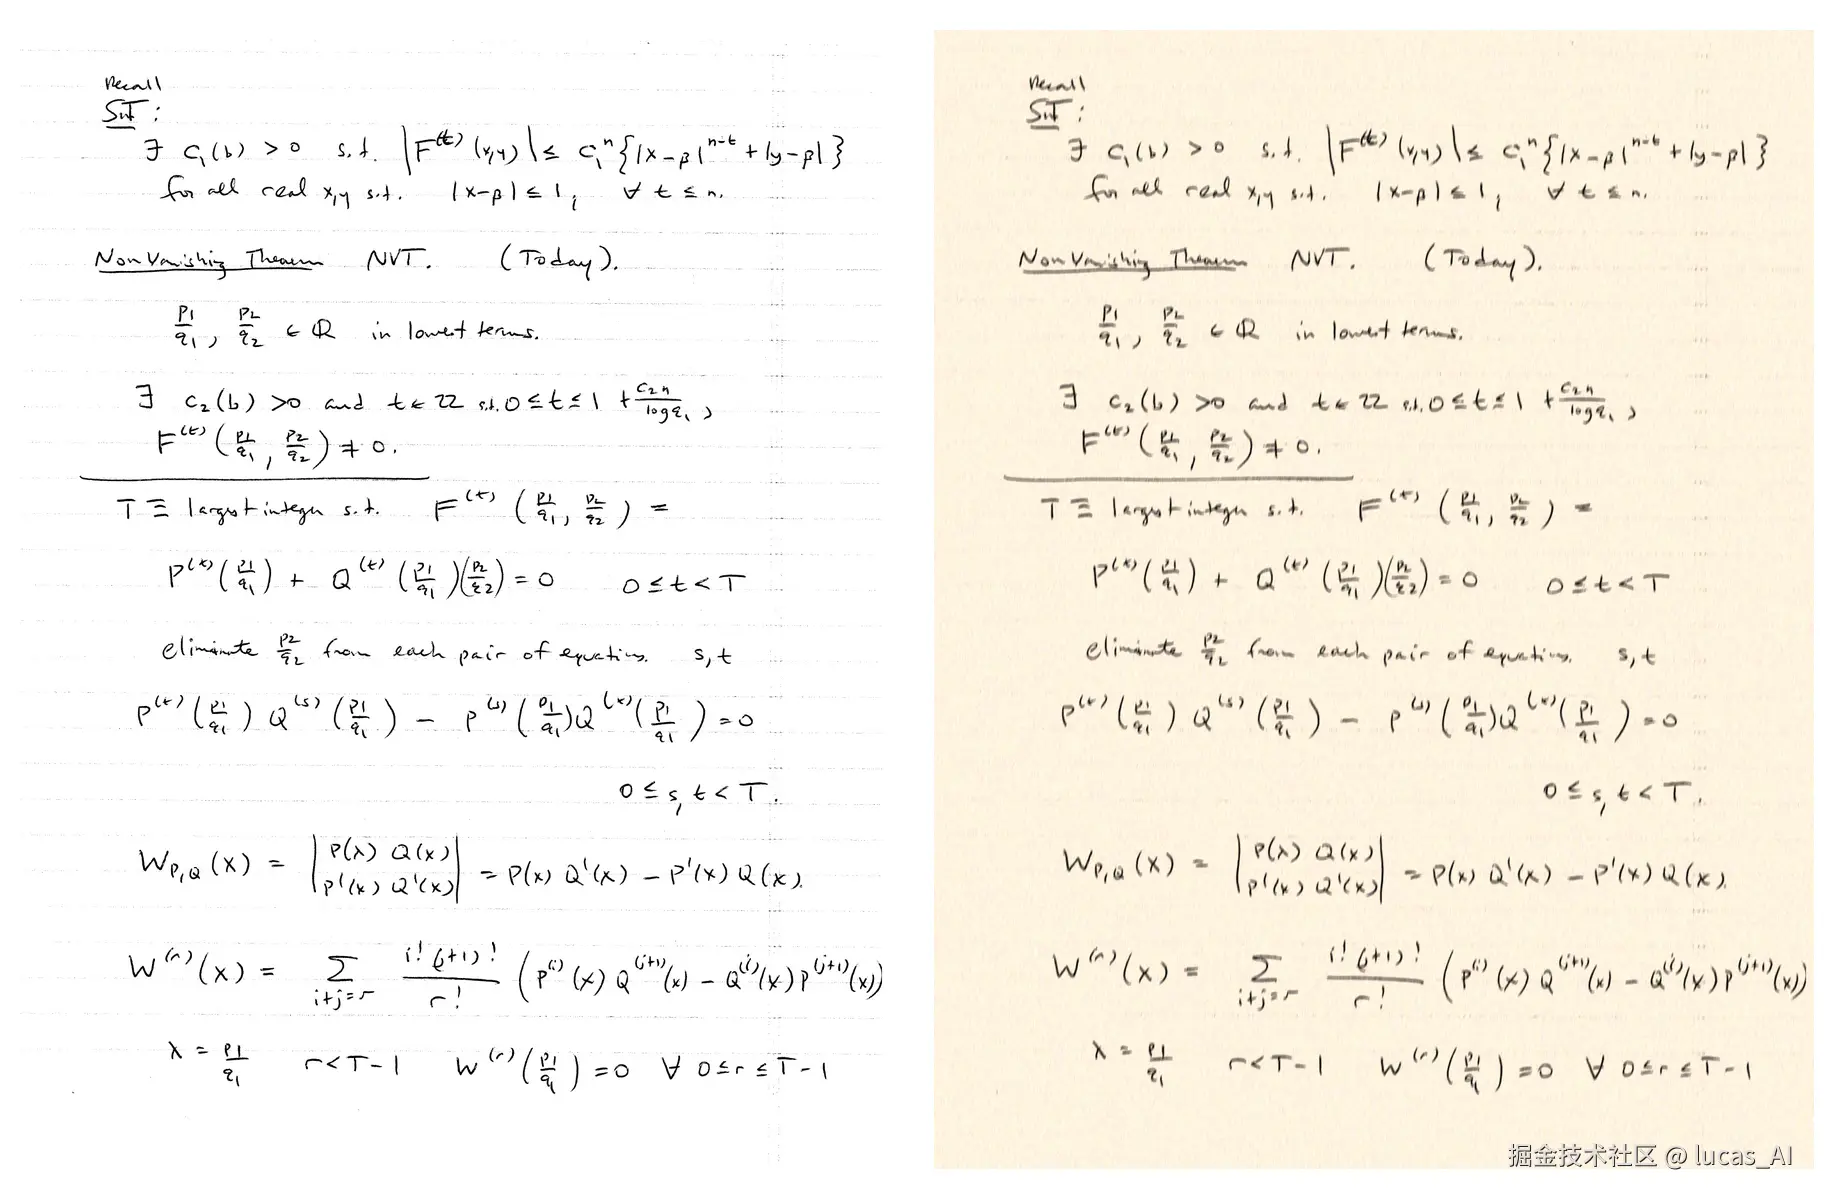
关键在准入条件:退化之后,只有所有被监督的内容仍然可见可读,原标注才继续有效;糊到标注不再成立的样本直接拒绝,或者改派「可见内容裁切」目标。这个设计防的是退化增强最常见的翻车方式------不是「不够糊」,而是「糊到监督信号变成噪声」。
📈 效果到底怎么样?数字都在这了
先看主战场 OmniDocBench v1.6(Overall 为文本、公式、表格三项的平均,越高越好):
| 类别 | 模型 | 规模 | Overall↑ | FormulaCDM↑ | TableTEDS↑ |
|---|---|---|---|---|---|
| 通用 VLM | Gemini 3 Pro | -- | 92.91 | 95.99 | 89.15 |
| 流水线 | PaddleOCR-VL-1.6 | 0.9B | 96.33 | 97.49 | 94.76 |
| 流水线 | MinerU2.5-Pro | 1.2B | 95.75 | 97.45 | 93.42 |
| 端到端 | HunyuanOCR-1.5 | 1B | 94.74 | 94.50 | 93.67 |
| 端到端 | WeVisDoc | 2B | 95.06 | 95.94 | 93.03 |
| 端到端 | WeVisDoc | 4B | 95.38 | 96.81 | 92.95 |
4B 拿下 95.38,在端到端组里排第一,领先前名 HunyuanOCR-1.5 零点六四分;2B 更有意思------一半的参数量,分数只差 0.32,数据工程实打实顶替了一部分参数规模。
更能说明问题的是阶段对比。Stage I 到 Stage II 用的是同样的 token 预算,增益却不是平均分布的:
| 规模 | 阶段 | Clean↑ | Digital Degraded↑ | Real Degraded↑ |
|---|---|---|---|---|
| 4B | Stage I 广覆盖 | 79.32 | 75.19 | 65.05 |
| 4B | Stage II 精修 | 79.81 (+0.49) | 77.74 (+2.55) | 69.08 (+4.03) |
增益沿「干净页 < 数字退化 < 真实退化」单调放大,4B 在真实退化赛道上白拿 4.03 分,干净页只动了 0.49。这说明 Stage II 的补课真的落在了分布尾部------也就是用户实际遇到的那些拍照件上。
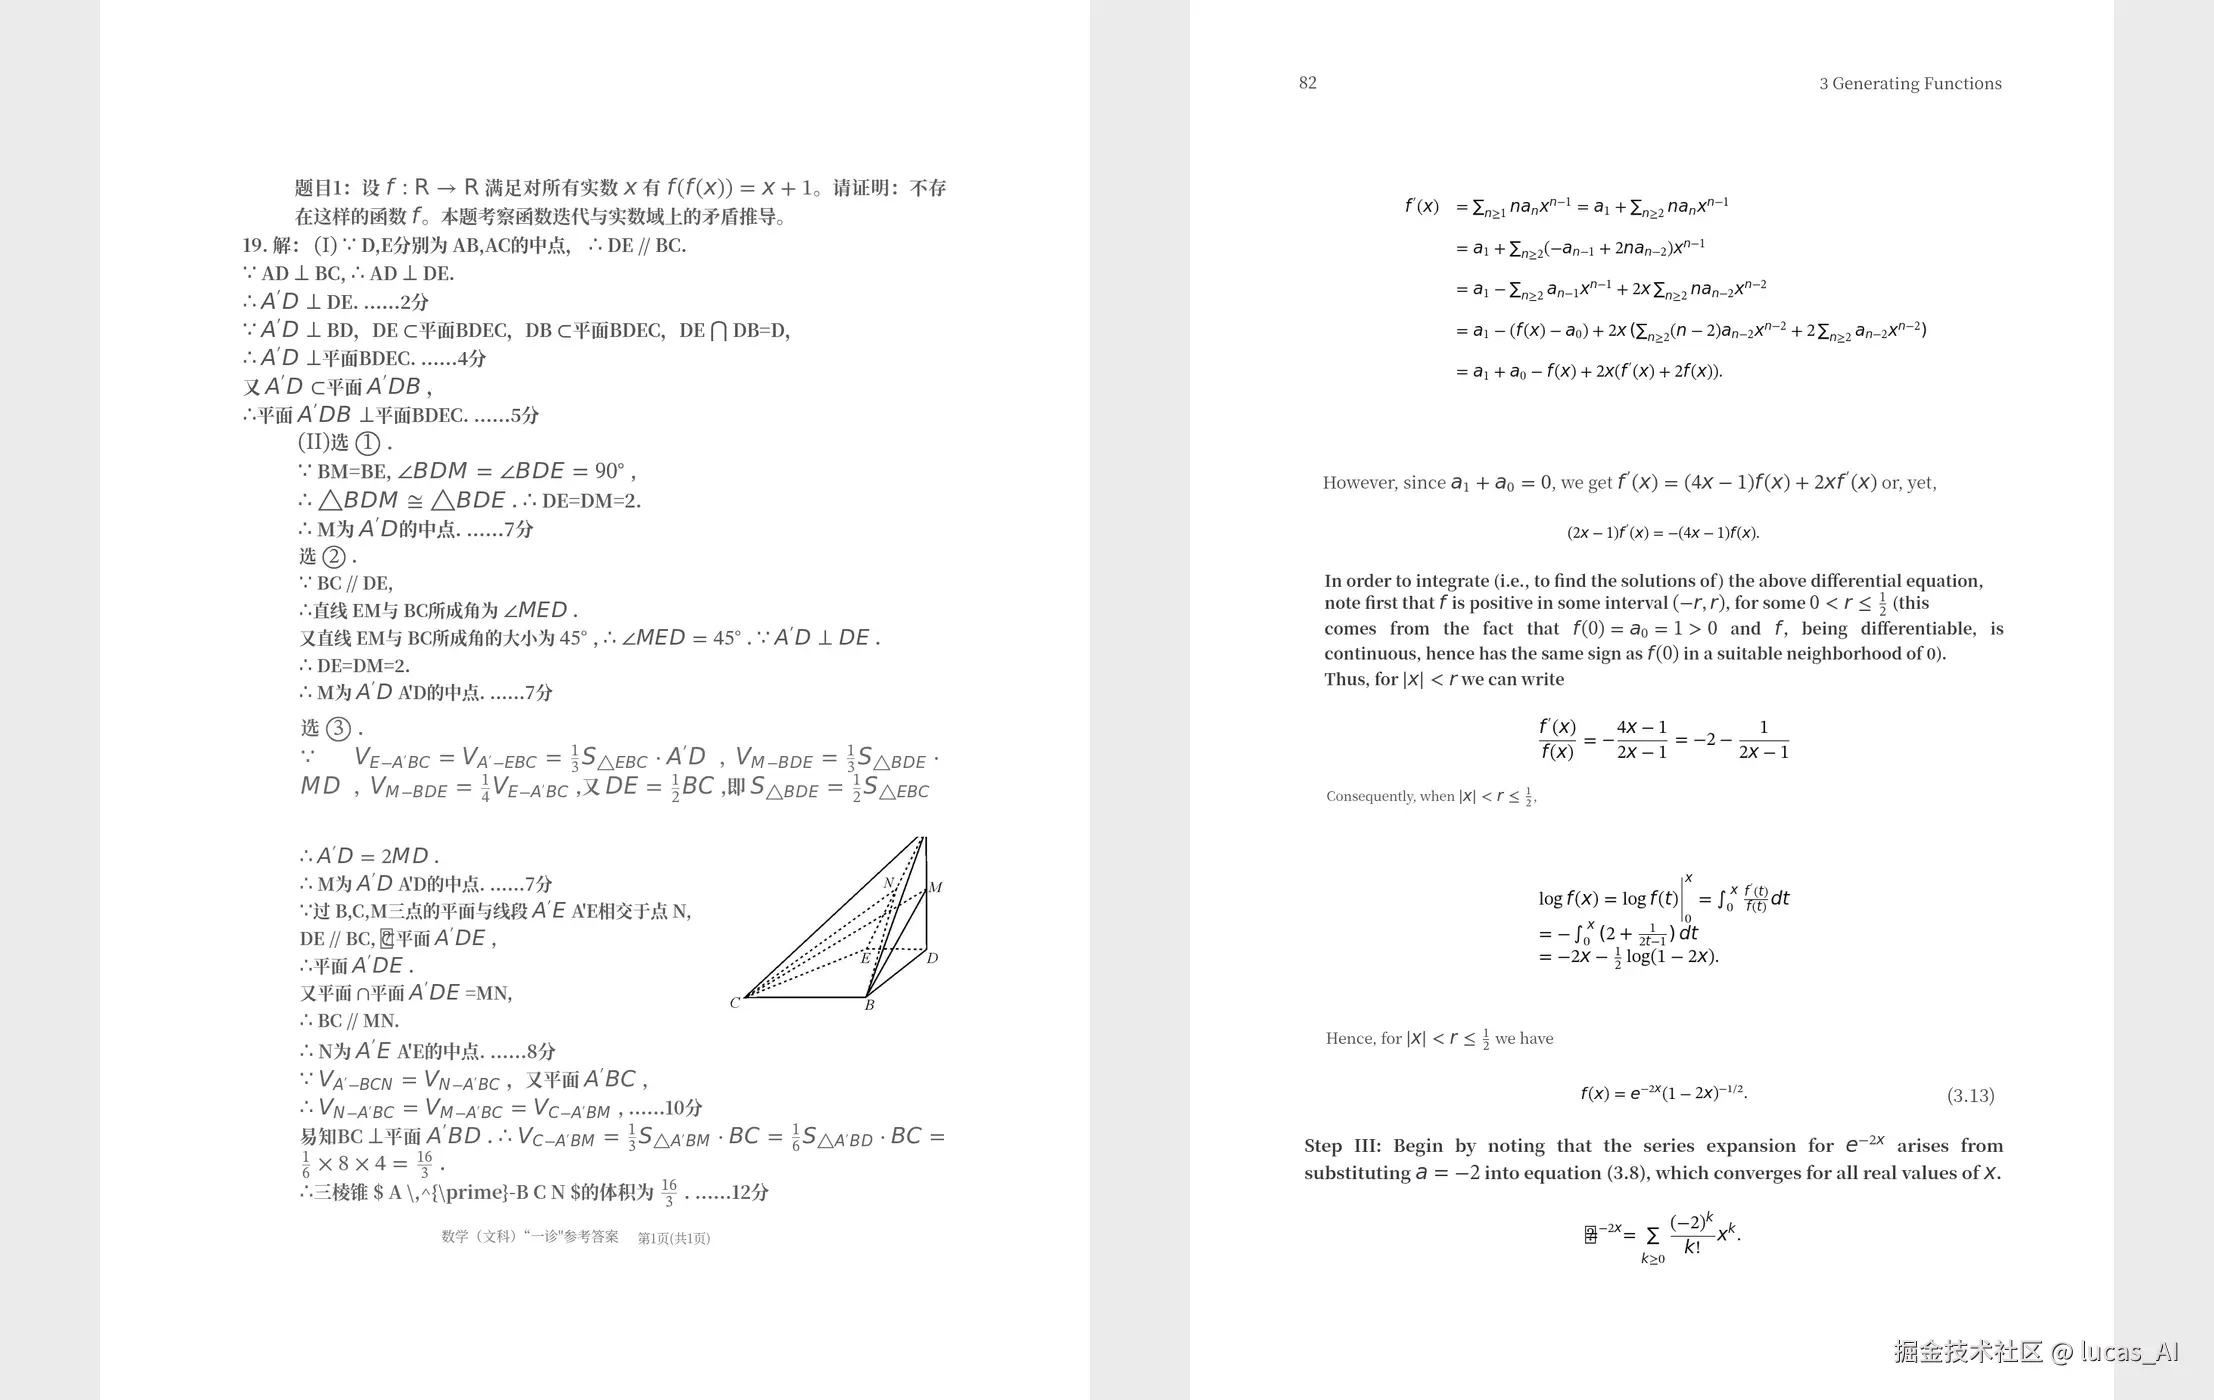
定性案例也支持同一个故事:Stage II 系统性地修掉了漏表格、按列误串阅读顺序、字段值不配对、跨文档幻觉这几类失效。但注意,作者自己也承认:真实退化案例里仍残留字符级转写错误------结构恢复变强,不等于物理采集下的识别错误消失。
🧊 泼冷水时间:这些地方要打问号
按惯例说说不能全信的部分,这篇的问号还不少:
- Stage II 是复合干预:继续训练、硬例过采样、定向新数据、replay 一起上,作者三度主动声明「无法归因到残差重分配这一个机制」。想抄「按残差调配比」这个单点的同学要清楚:支持它的证据并不存在,那 +4.03 可能大部分只是「多训一轮 + 难例多抽几次」。
- 缺一个近乎零成本的对照:把 Stage II 的预算拿去做 Stage I 数据的随机重采样,就能排除「过度工程」质疑------论文没做。
- 表格是短板:4B 的 TableTEDS 92.95,低于 PaddleOCR-VL-1.6、MinerU2.5-Pro,甚至低于自家 2B(93.03)。正文宣称领先时用了一个未解释定义的 TableTEDS_S 变体,微妙地绕开了这项。
- 领先幅度贴着标注噪声:论文自己引用的审计显示 OmniDocBench v1.5 有 2,580 处确认标注错误,而主结果的领先是 0.64 分。量级上说不清谁压得住谁。
🤔 那这篇到底能带走什么?
抛开具限,有三样东西我认为是真金白银,做数据管线的可以直接搬:
- token 口径的预算换算(长度修正那组公式):解决「长页面 vs 短公式」的配比失真,任何自回归生成任务都适用;
- 硬例归因三分类:标注错 / 解码坏 / 视觉不可读 / 模型真错,四者分开,并且「修好标注后错误消失的样本不得进硬例过采样」------这条朴素规则能防住 hard example mining 最大的坑:越抽越脏;
- 收缩估计处理小簇残差:小簇的原始误差方差巨大,直接拿来做采样决策会让预算被几个偶然簇吃掉;向池化均值收缩后再比较,稳得多。
至于模型本身,2B/4B 权重已经在 HuggingFace 上开放,文档解析有刚需的团队值得拉下来在自己语料上试一把------尤其如果你的输入天然偏脏:手机拍照、老扫描件、翻拍屏摄,这正是它相对优势最大的区间。
往大里说,这篇论文讲的其实是一个特别古老的道理:当所有人都往模型上堆创新的时候,把数据的账算清楚,可能就是最便宜的那次涨分。90+ 时代拼的是数据工程质量,这句听起来像正确的废话------但 WeVisDoc 至少把这本账的算法,明明白白写出来了。