论文:
发布于 EMNLP 2024
代码:GitHub - ZBWpro/STS-Regression · GitHub
- 现有问题
(1)以 SimCSE 为代表的对比学习,通过将相似句子拉近、不相似句子推远来训练模型。它简单有效,但存在两个根本问题:
-
对比学习本质上只区分"相似"和"不相似"。如果标注数据包含"高度相关、中度相关、有点相关、不相关"等多档信息,它只能利用最相似和最不相似的两端,中间档位被白白浪费。
-
为了防止模型坍塌,SimCSE 需要极大的 batch size(如 512),导致显存消耗惊人。
(2)Sentence-BERT 的局限
Sentence-BERT 采用双塔结构,效率高,但它同样从分类视角 处理 STS 任务。假设一个任务有 5 个相似度类别(标为 1 到 5),一个真实标签为 2 的样本,预测成 3 还是 4,分类损失是一样的。然而,从语义上看,预测成 3 显然比 4 更接近 2。分类视角忽略了类别之间的渐进关系,导致性能次优。
- 网络架构
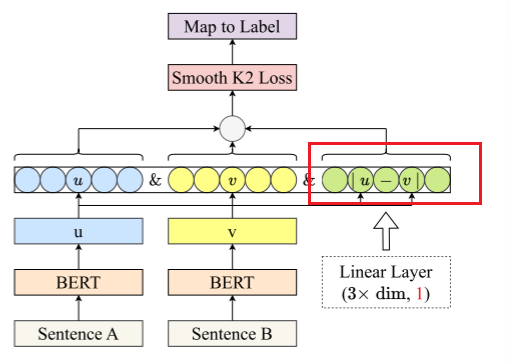
本文将将原始的离散类别标签,按照语义相似度顺序映射成一串等距的数值。例如,对于"矛盾、中立、蕴含"三类,分别映射为 0、1、2,从最不相似到最相似。然后,模型不再使用分类损失,而是使用回归损失来拟合这些数值。
采用经典的 Siamese 双塔结构 ,两个 BERT 共享参数,分别编码句子 A 和 B,得到向量 u 和 v。不仅拼接了两个句向量,还拼接了它们的逐元素绝对差 |u-v|。
论文做了消融实验,拼接(u,v,|u-v|)之后,Spearman涨到76
3.损失函数
真实的标签是离散的,而预测值是连续的,只要预测值与真实值的差距骄傲与类别间距的一半,就可以正确分类。为此引入了零梯度缓冲区,当预测误差小于某个阈值是,损失为0.
(1)Translated ReLU
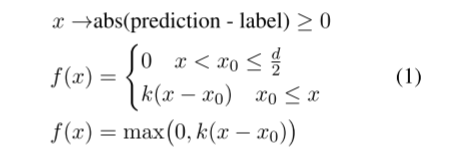
对于噪声较大的数据,可以使用Translated ReLU
(2)Smooth K2 Loss
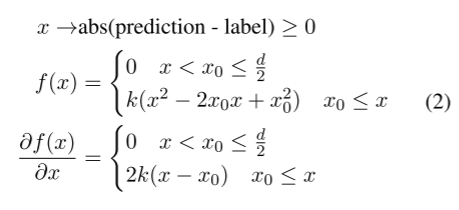
对于高质量、可信数据,可以使用Smooth K2 Loss