目录
[为什么需要 RAG?](#为什么需要 RAG?)
[RAG 工作原理](#RAG 工作原理)
[Embedding 是什么?](#Embedding 是什么?)
什么是RAG?
RAG(Retrieval-Augmented Generation, 检索增强生成):就是把信息检索 和大语言模型绑定在一起使用。系统先在知识库里面检索出和当前问题相关的片段,将片段和原始问题一起送给大模型(LLM),让模型基于检索到的内容给出回答。
为什么需要 RAG?
**知识时效性:**预训练模型的知识会停在训练数据截止时间点。训练后的知识模型是不知道的,除非联网,外部知识注入来补。RAG 的做法是动态检索外部知识源,把最新的相关内容直接送给 LLM,让它不用只依赖参数里的旧知识。
**私有数据访问:**企业内部知识是不公开的,无法让 LLM 随便访问。RAG 在用户提问时只提取和问题相关的片段给 LLM,不需要暴露全部数据,模型也能基于企业自己的知识回答。
**幻觉问题:**即 LLM 编造事实,RAG 通过提供明确参考文本,让模型尽量基于证据回答,确实能降低幻觉概率。
常见场景
RAG 适合答案依赖外部资料,并且资料会变化或很大的场景。
如: 客服机器人,研发运维 Copilot,医疗助手,法律咨询,教育辅导,企业内部助手
RAG 工作原理
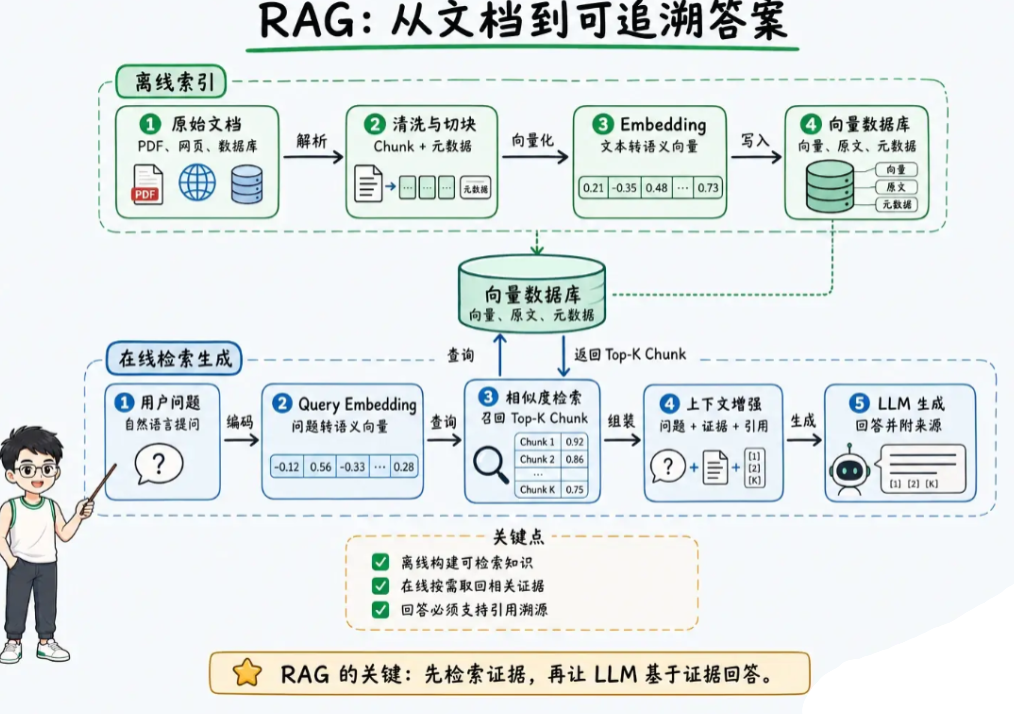
RAG 的工程链路,常两个阶段:离线索引和在线检索生成,索引阶段把原始文档处理成可检索的数据结构;在线阶段在用户提问时完成查询理解,检索召回,上下文构建和答案生成。
如:
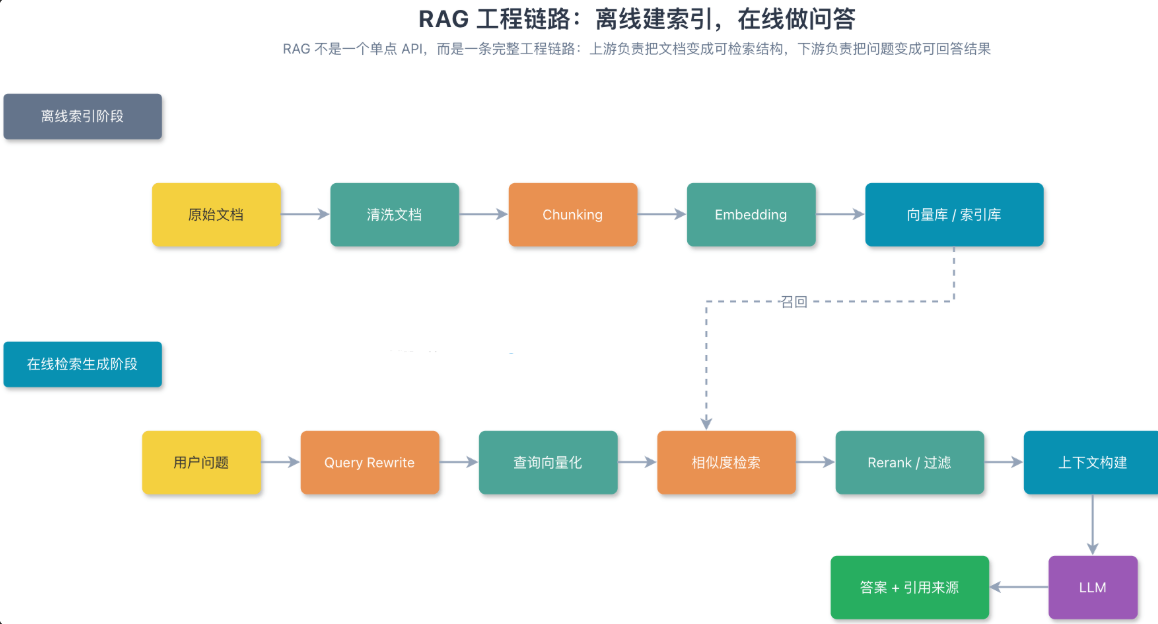
索引阶段主要做这些事:
- 输入文档:文本文件、PDF、网页、数据库记录都可以,只要有内容。
- 清理文档:去掉 HTML 标签、特殊字符等噪声。
- 增强文档:补充元数据,比如时间戳、分类标签,为后续检索提供过滤维度。
- 文档拆分(Chunking):用文本分割器把文档切成较小片段。
- 向量化表示(Embedding Generation):通过嵌入模型将文本片段映射为语义向量,也就是高维稠密向量。
- 存储到向量存储或索引系统:把嵌入向量、原始内容和对应元数据存入向量存储或向量索引系统。
检索是在线进行的。用户提问之后,系统通常会走下面这些步骤:
- 接收请求:拿到用户的自然语言查询。有些系统会先做查询改写或扩充,让后续检索更容易命中。
- 查询向量化:用嵌入模型把查询也转成向量,这样才能和文档向量在同一个空间里比较。
- 信息检索(R):在向量库里做相似性搜索,把和查询向量最相关的文档片段捞出来。
- 上下文增强(A):把检索片段、原始问题、系统指令和引用要求组织成 Prompt,交给 LLM。
- 输出生成(G):LLM 输出自然语言回复,同时附上参考资料链接。
- 结果反馈(可选):用户不满意时可以反馈,系统再调整 Prompt 或检索策略。有些实现也支持多轮对话来逐步完善回答。
Embedding 是什么?
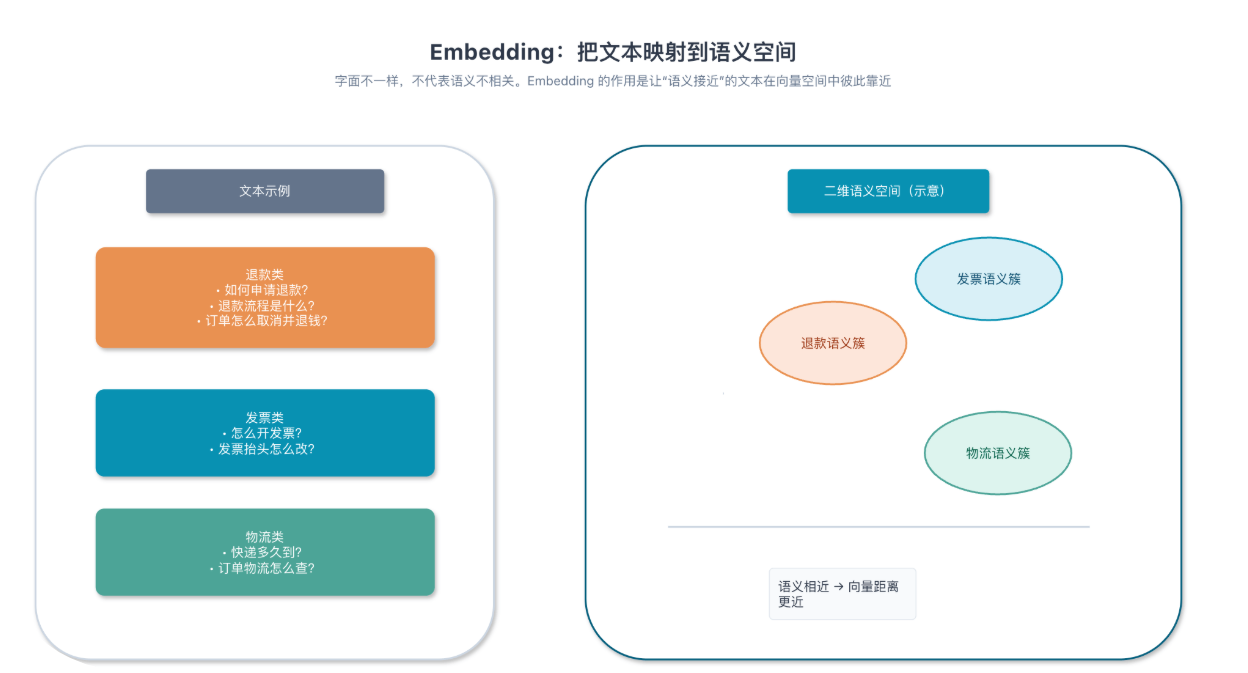
Embedding 就是把文本变成一串数字。更准确地说,它会把文本映射到一个高维稠密向量空间里,让语义接近的文本在向量空间中距离更近。
RAG有哪些演进阶段?
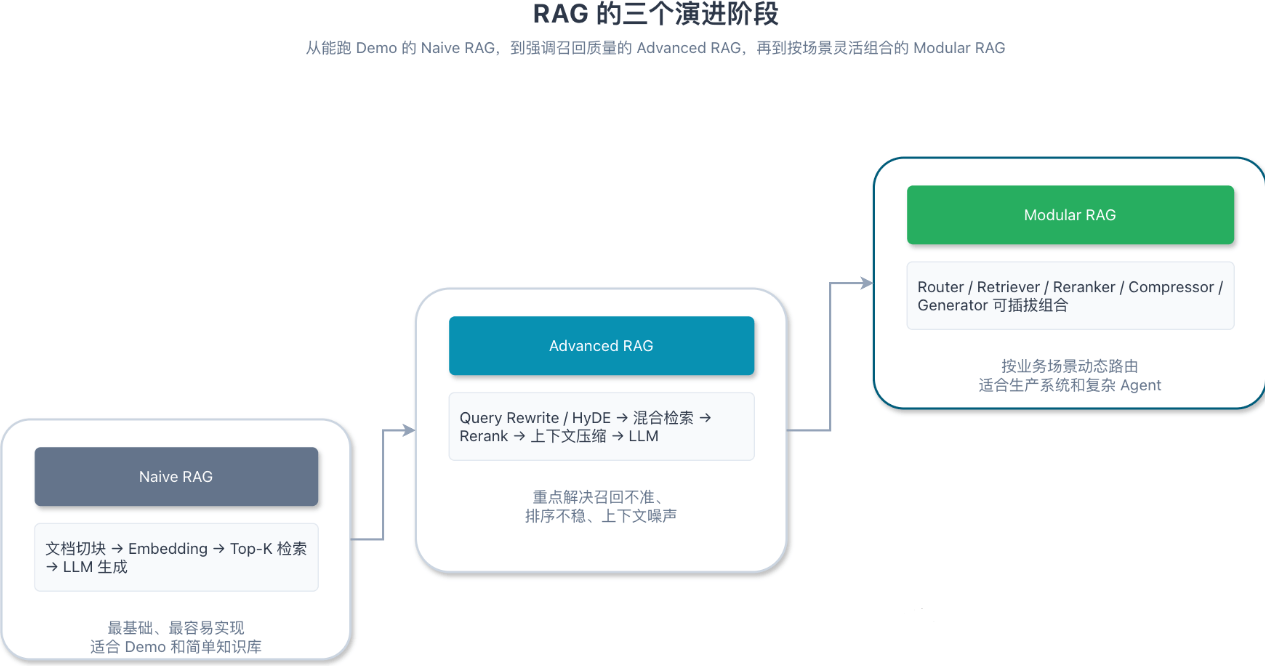
RAG 这两年一直在迭代,大致可以分成三个阶段。
| 阶段 | 典型链路 | 特点 |
|---|---|---|
| Naive RAG | 文档切块 → Embedding → Top-K 检索 → LLM 生成 | 最基础、最容易实现,适合 Demo 和简单知识库 |
| Advanced RAG | Query Rewrite / HyDE → 混合检索 → Rerank → 上下文压缩 → LLM 生成 | 重点解决召回不准、上下文噪声和排序不稳 |
| Modular RAG | 检索器、重排器、压缩器、路由器、生成器等模块可插拔组合 | 按业务场景动态路由,适合生产系统和复杂 Agent |
RAG的优缺
核心优势
RAG 最大的好处是知识更新成本低。,RAG 通常只需要更新知识库和索引。新闻、法规、产品文档这类经常变化的数据,用 RAG 维护起来会轻很多。
它也能减少幻觉,并且方便追溯来源。 RAG 让模型从"凭记忆回答"变成"基于检索证据回答"。每个回答都可以挂到具体文档片段上,这在金融合规、医疗辅助、法律检索这些对准确性要求高的场景里很重要。
数据隔离也更容易做。 你可以在检索层实现多租户隔离和访问控制(ACL),确保用户只能看到自己权限范围内的数据。
换领域的成本也低。 不需要针对每个领域重新训练模型,把领域知识库建好、索引跑通,就能先用起来。
局限
**检索质量决定上限。**如果 Embedding 表达不准,或者分块策略把关键信息切丢了,召回内容和问题本身无关,下游 LLM 再强也救不回来。
上下文也不是越长越好。 塞太多无关片段进去,模型注意力会被稀释,逻辑推理会被干扰,Token 开销也会跟着上升。
延迟是另一个硬问题。 完整链路要经过查询改写、向量化、相似度检索、重排序、上下文构建、LLM 生成,每一步都会增加耗时。对响应时间敏感的场景,不能只看答案质量,也要认真算延迟账。
工程复杂度也不低。 你要维护向量数据库,处理文档增量索引,持续优化检索策略,还要做权限过滤、引用溯源和评测闭环。相比直接调用 LLM API,RAG 的运维负担明显更重。
Token 成本同样要算清楚。 RAG 省了训练成本,但每次请求都要带上下文,输入 Token 往往比普通对话高不少。文档片段塞得越多,账单和延迟都会一起涨。