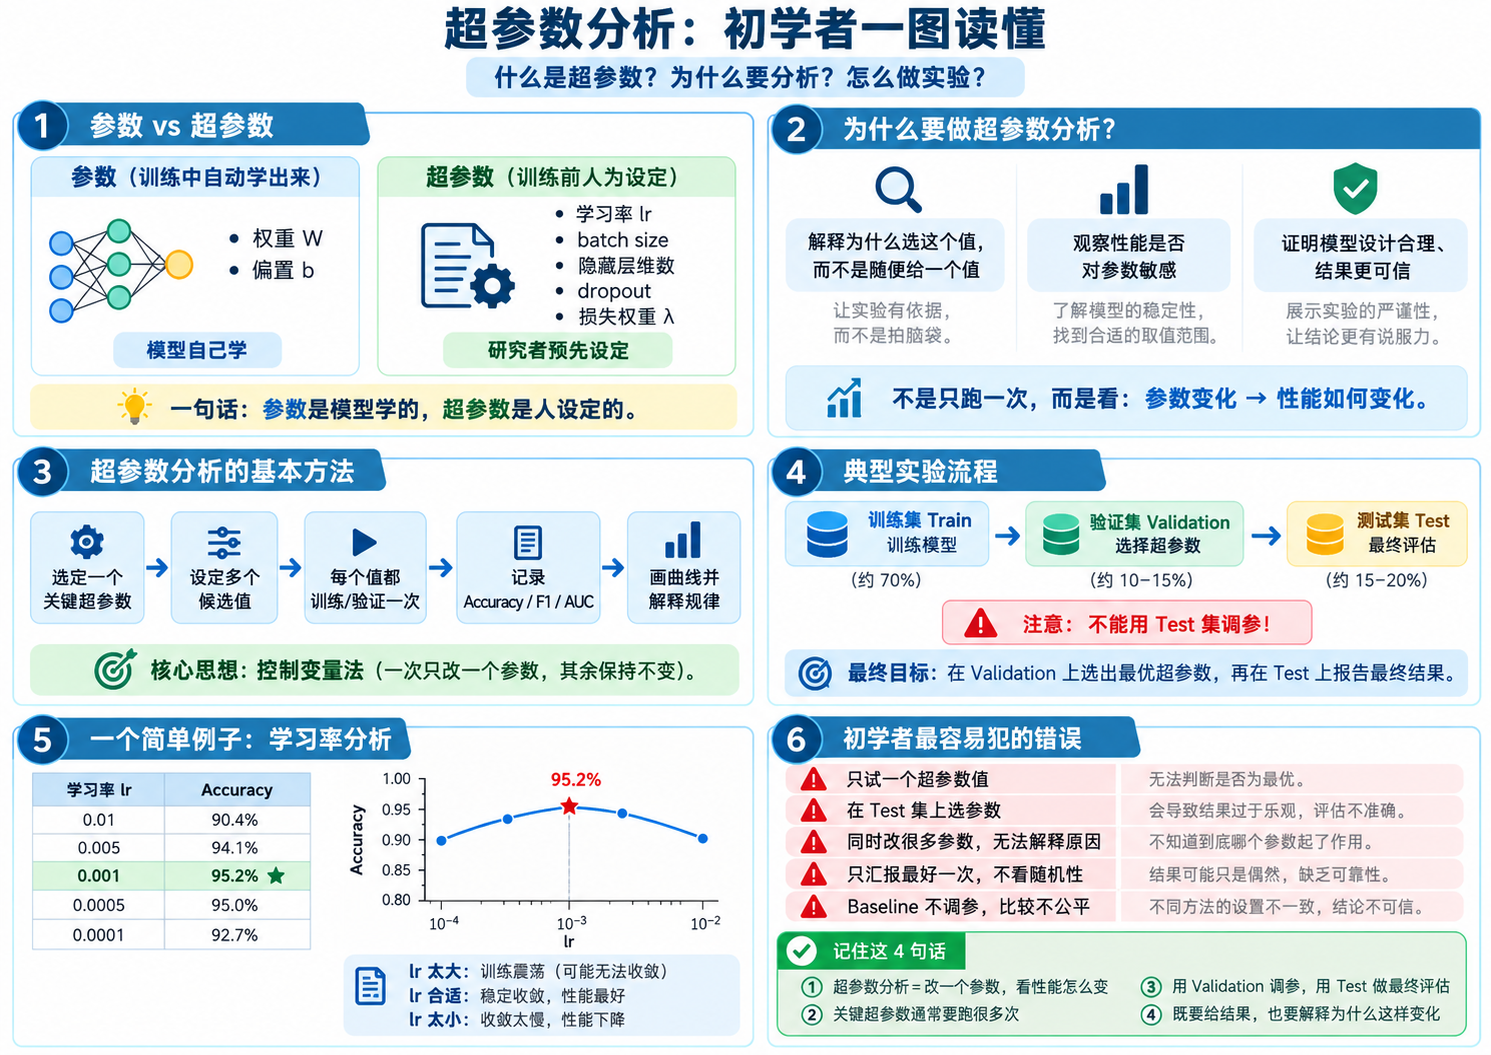
超参分析,不是"把所有超参数都调到最好",而是研究:当某个关键超参数发生变化时,模型性能如何变化,以及为什么最终选这个值。
你现在"给一个超参值 → 跑模型 → 和别的模型比较",只能说明这个参数配置下你的模型表现如何 ,但审稿人很容易问:
为什么学习率取 0.001?为什么 dropout=0.3?为什么隐藏维度是 128?换一个值是不是结果就崩了?
这就是论文里做**超参数分析(Hyperparameter Analysis / Sensitivity Analysis)**的原因。
一、先彻底搞清:什么叫"参数",什么叫"超参数"
假设一个最简单的神经网络:
x→Linear(20,128)→ReLU→Linear(128,5) x\rightarrow \text{Linear}(20,128)\rightarrow \text{ReLU}\rightarrow \text{Linear}(128,5) x→Linear(20,128)→ReLU→Linear(128,5)
训练时:
python
learning_rate = 0.001
batch_size = 64
hidden_dim = 128
dropout = 0.3
epochs = 100
这里有两类东西。
模型训练过程中自动学出来的:
W, b W,\ b W, b
也就是神经网络中的权重和偏置。
它们叫:
模型参数
而你训练之前人为规定的:
text
学习率 learning rate
batch size
隐藏层维数
网络层数
dropout
损失函数中的 λ
卷积核大小
Transformer head 数
叫:
超参数
因此:
参数是模型自己学的,超参数是研究者预先设定的。
二、为什么论文必须解释超参数?
例如你的模型准确率达到:
Accuracy=95.2% Accuracy=95.2\% Accuracy=95.2%
你写:
text
learning rate = 0.001审稿人马上可能产生一个疑问:
你是不是碰巧挑中了一个特别好的数字?
如果实际上:
| Learning Rate | Accuracy |
|---😐---😐
| 0.1 | 62.3% |
| 0.01 | 90.4% |
| 0.005 | 94.1% |
| 0.001 | 95.2% |
| 0.0005 | 95.0% |
| 0.0001 | 92.7% |
这时候你就可以很有底气地说:
随着学习率降低,模型性能先提高后下降。在 10−310^{-3}10−3 附近模型性能达到较优水平,因此本文将学习率设置为 10−310^{-3}10−3。
这就是最简单的:
超参数敏感性分析
所以你已经猜对了:
三、做超参分析,确实通常要跑很多次模型
比如你研究学习率:
η∈{10−1,10−2,10−3,10−4,10−5} \eta\in\{10^{-1},10^{-2},10^{-3},10^{-4},10^{-5}\} η∈{10−1,10−2,10−3,10−4,10−5}
那么至少:
5 个学习率⇒5 次训练 5\ \text{个学习率} \Rightarrow 5\ \text{次训练} 5 个学习率⇒5 次训练
如果每个值为了避免随机性,再跑 3 次:
5×3=15 5\times3=15 5×3=15
次。
这在 SCI 论文里非常正常。
但注意一个非常重要的问题:
"超参分析"不等于把所有参数进行排列组合。
这是初学者最容易掉进去的坑。
四、我们从一个小白能完全理解的案例开始
假设你的任务是故障诊断:
text
输入:
传感器时间序列
输出:
正常
轴承故障
齿轮故障
建立一个神经网络:
X→CNN→Feature→Classifier→y X\rightarrow \text{CNN}\rightarrow \text{Feature}\rightarrow \text{Classifier}\rightarrow y X→CNN→Feature→Classifier→y
最终 Accuracy:
95% 95\% 95%
你的模型里有:
text
learning rate = 0.001
batch size = 64
CNN kernel size = 5
hidden dimension = 128
dropout = 0.3
λ = 0.1
很多新手会觉得:
那我是不是这 6 个参数都要疯狂测试?
不一定。
论文一般选择:
2~4 个最重要的超参数
重点分析。
比如你的论文真正创新的是一种新的损失函数:
L=Lcls+λLcon L=L_{cls}+\lambda L_{con} L=Lcls+λLcon
那么最应该分析的是:
λ \lambda λ
而不是花半篇论文研究 batch size。
五、案例 1:第一次超参分析------只研究一个参数
我们从最简单的 KNN 开始。
KNN 有一个非常重要的超参数:
K K K
意思是:
判断一个样本属于哪一类时,看附近几个邻居。
假设:
text
K = 1
K = 3
K = 5
K = 7
K = 9
K = 11
分别训练/测试。
得到:
| K | Accuracy |
|---|---|
| 1 | 87.2 |
| 3 | 90.5 |
| 5 | 92.1 |
| 7 | 93.0 |
| 9 | 92.8 |
| 11 | 91.6 |
| 你画一张图: |
text
Accuracy
94 |             ●
93 |          ●     ●
92 |       ●
91 |                   ●
90 |    ●
89 |
88 | ●
   ------------------------
    1  3  5  7  9  11
           K
你已经完成了一次标准的超参分析。
你研究的是:
f(K)=Accuracy f(K)=Accuracy f(K)=Accuracy
也就是:
当 K 改变时,性能发生什么变化?
这叫:
Sensitivity Analysis
参数敏感性分析。
六、这和"调参"还不是完全一回事
这里你需要区分三个概念。
超参数设置
直接说:
text
K=7
lr=0.001
batch size=64
没有进一步解释。
超参数优化
目标是:
θh∗=argmaxθhPerformance(θh) \theta_h^*=\arg\max_{\theta_h} Performance(\theta_h) θh∗=argθhmaxPerformance(θh)
也就是说:
到底哪个参数组合最好?
例如:
text
lr ∈ {0.01, 0.001, 0.0001}
batch ∈ {32, 64, 128}
dropout ∈ {0.1, 0.3, 0.5}
寻找最佳组合。
超参数分析
关注的是:
性能如何随着参数变化?模型对这个参数敏不敏感?
比如:
λ=0, 0.01, 0.05, 0.1, 0.5, 1 \lambda = 0,\ 0.01,\ 0.05,\ 0.1,\ 0.5,\ 1 λ=0, 0.01, 0.05, 0.1, 0.5, 1
然后观察:
F1(λ) F1(\lambda) F1(λ)
所以:
超参数优化 ≠ 超参数分析
但是现实论文中两者经常结合起来做。
七、案例 2:学习率------这是你以后做深度学习最常见的分析
现在建立一个 CNN。
设置:
lr∈{10−1,10−2,10−3,10−4,10−5} lr\in\{10^{-1},10^{-2},10^{-3},10^{-4},10^{-5}\} lr∈{10−1,10−2,10−3,10−4,10−5}
为什么通常按 10 倍变化?
因为学习率往往不是:
text
0.001
0.002
0.003
0.004
这样研究。
而是研究数量级:
10−1→10−2→10−3→10−4 10^{-1}\rightarrow10^{-2}\rightarrow10^{-3}\rightarrow10^{-4} 10−1→10−2→10−3→10−4
因为学习率对训练动态影响很大。
假设结果:
| Learning Rate | Accuracy | F1 |
|---|---|---|
| 10−110^{-1}10−1 | 70.2 | 68.4 |
| 10−210^{-2}10−2 | 91.3 | 90.5 |
| 10−310^{-3}10−3 | 95.2 | 94.8 |
| 10−410^{-4}10−4 | 94.6 | 94.0 |
| 10−510^{-5}10−5 | 89.3 | 88.6 |
| 你就可以理解发生了什么: |
\text{过大} \Rightarrow \text{参数更新跨度过大} \Rightarrow \text{训练震荡}
lr\ \text{适中} \Rightarrow \text{稳定收敛}
lr\ \text{过小} \Rightarrow \text{收敛速度太慢}
所以表现往往是:
低 → 高 → 下降
这才是超参分析最重要的地方:
不是仅仅找:
lr=0.001 lr=0.001 lr=0.001
而是解释:
为什么 0.001 比较合理
八、真正论文实验时应该怎么做?
假设论文里有四个比较重要的超参数:
lr,batch,dropout,λ lr,\quad batch,\quad dropout,\quad \lambda lr,batch,dropout,λ
一个非常适合初学者的做法叫:
控制变量法
也叫 One-Factor-at-a-Time。
假设默认配置:
text
lr = 0.001
batch = 64
dropout = 0.3
λ = 0.1
第一组,只改变 lr:
text
lr =
0.01
0.005
0.001
0.0005
0.0001
其他全部保持:
text
batch = 64
dropout = 0.3
λ = 0.1
第二组,只改变 dropout:
text
dropout =
0
0.1
0.3
0.5
0.7
其他保持不变。
第三组,只改变 λ\lambdaλ:
text
λ =
0
0.01
0.05
0.1
0.5
1.0
这样你才能说:
性能变化主要是这个超参数引起的。
九、为什么一定要"其他参数保持不变"?
假设:
实验 A:
text
lr = 0.001
dropout = 0.1
batch = 32
Accuracy:
95% 95\% 95%
实验 B:
text
lr = 0.01
dropout = 0.5
batch = 128
Accuracy:
90% 90\% 90%
你能不能得出:
lr=0.001 比 lr=0.01 好?
不能。
因为你同时改变了三个变量:
lr, dropout, batch lr,\ dropout,\ batch lr, dropout, batch
你根本不知道是谁造成了性能变化。
所以超参敏感性分析背后的实验思想其实非常简单:
控制变量法
十、案例 3:理解你自己的"创新超参数"
这个案例对你以后写 SCI 特别重要。
假设你提出了一种新的跨工况故障诊断模型:
L=Lcls+λLinvariant L=L_{cls}+\lambda L_{invariant} L=Lcls+λLinvariant
这里:
Lcls L_{cls} Lcls
负责分类。
而:
Linvariant L_{invariant} Linvariant
负责学习跨工况不变特征。
λ \lambda λ
决定:
到底有多重视"不变特征"。
那么:
λ=0 \lambda=0 λ=0
意味着:
L=Lcls L=L_{cls} L=Lcls
你的创新模块相当于没发挥作用。
如果:
λ=100 \lambda=100 λ=100
又可能导致模型只顾学习工况不变性,反而损伤分类能力。
因此你测试:
λ={0, 0.01, 0.05, 0.1, 0.5, 1, 5} \lambda=\{0,\ 0.01,\ 0.05,\ 0.1,\ 0.5,\ 1,\ 5\} λ={0, 0.01, 0.05, 0.1, 0.5, 1, 5}
假设结果:
| λ\lambdaλ | F1 |
|---😐---😐
| 0 | 90.3 |
| 0.01 | 92.0 |
| 0.05 | 94.1 |
| 0.1 | 95.0 |
| 0.5 | 94.6 |
| 1 | 92.8 |
| 5 | 86.1 |
这张图的意义就比"学习率分析"更大。
因为它证明:
λ=0⇒创新约束不存在 \lambda=0 \Rightarrow \text{创新约束不存在} λ=0⇒创新约束不存在
模型较弱。
增加:
Linvariant L_{invariant} Linvariant
以后:
F1↑ F1\uparrow F1↑
但权重太大:
λ≫1 \lambda \gg 1 λ≫1
又导致:
F1↓ F1\downarrow F1↓
于是形成非常漂亮的机理解释:
分类判别能力 ↔ 工况不变性
需要达到一个平衡。
这就是高质量论文里的超参分析。
十一、所以论文里哪些超参数值得重点分析?
假设你的网络里有 20 个超参数。
千万不要想着 20 个全部画图。
一般最值得分析的是:
与你论文创新直接相关的超参数
例如你提出:
L=Lcls+λ1Lcon+λ2Ldomain L=L_{cls}+\lambda_1 L_{con}+\lambda_2 L_{domain} L=Lcls+λ1Lcon+λ2Ldomain
那么:
λ1,λ2 \lambda_1,\lambda_2 λ1,λ2
非常值得分析。
如果你提出多尺度网络:
kernel={3,5,7} kernel=\{3,5,7\} kernel={3,5,7}
那么:
kernel size kernel\ size kernel size
值得分析。
如果提出 Transformer:
Nlayer N_{layer} Nlayer
可能值得分析。
而下面这种普通参数:
text
Adam β1=0.9
Adam β2=0.999
很多情况下没必要专门占一张图。
十二、现在来到一个你非常关心的问题:到底需要跑多少次?
假设分析三个超参数。
学习率:5 个值。
dropout:5 个值。
λ\lambdaλ:6 个值。
控制变量法:
5+5+6=16 5+5+6=16 5+5+6=16
组实验。
如果每组跑 3 次不同随机种子:
16×3=48 次 16\times3=\boxed{48\ \text{次}} 16×3=48 次
所以:
是的,一篇认真做的深度学习论文,跑几十次甚至几百次实验很正常。
甚至这还只是超参数实验。
因为你还会有:
text
主实验
Baseline
消融实验
参数分析
鲁棒性实验
噪声实验
跨工况实验
泛化实验
所以真正的 SCI 实验量,远远不是:
我的模型跑一次,baseline 跑一次。
十三、为什么最好每个参数跑 3 次,而不是只跑一次?
神经网络有随机性:
text
参数随机初始化
mini-batch 随机采样
dropout
数据划分
GPU计算
所以:
第一次:
95.1 95.1 95.1
第二次:
94.3 94.3 94.3
第三次:
95.5 95.5 95.5
可能都很正常。
因此 SCI 论文经常报告:
Mean±Std Mean\pm Std Mean±Std
例如:
95.0±0.6 \boxed{95.0\pm0.6} 95.0±0.6
而不是只报告:
95.5 95.5 95.5
假设 5 个随机种子:
text
42
123
2024
3407
8888
得到:
text
95.1
94.7
95.3
94.9
95.0
最后:
94.99±0.23 94.99\pm0.23 94.99±0.23
结果就更可信。
十四、但这里藏着一个非常重要的"科研大坑"
你可能现在是:
text
Train
↓
Test
↓
发现lr=0.001最好
↓
用lr=0.001
↓
报告Test结果
这是不规范的。
因为:
Test 不能拿来调超参数
正规的逻辑应该是:
Dataset→Train+Validation+Test Dataset\rightarrow Train+Validation+Test Dataset→Train+Validation+Test
例如:
70%+15%+15% 70\%+15\%+15\% 70%+15%+15%
Train:
训练模型
Validation:
选择超参数
Test:
最终一次评估
也就是:
text
Train
    ↓
训练不同超参数模型
    ↓
Validation
    ↓
选择 λ=0.1
    ↓
确定模型
    ↓
Test
    ↓
最终结果
Test 应尽可能保持"没见过"。
十五、我们实际写一个最简单的实验
你甚至不用深度学习。
使用 sklearn:
python
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.neighbors import KNeighborsClassifier
from sklearn.metrics import accuracy_score
X, y = load_iris(return_X_y=True)
X_train, X_val, y_train, y_val = train_test_split(
    X,
    y,
    test_size=0.3,
    random_state=42,
    stratify=y
)
k_values = [1, 3, 5, 7, 9, 11]
for k in k_values:
    model = KNeighborsClassifier(
        n_neighbors=k
    )
    model.fit(
        X_train,
        y_train
    )
    pred = model.predict(X_val)
    acc = accuracy_score(
        y_val,
        pred
    )
    print(k, acc)
你跑完以后可能得到:
text
K=1     Accuracy=0.933
K=3     Accuracy=0.956
K=5     Accuracy=0.978
K=7     Accuracy=0.978
K=9     Accuracy=0.956
K=11    Accuracy=0.933
到这里,你已经真正完成了:
一次超参数实验
十六、然后把它画出来
python
import matplotlib.pyplot as plt
k_values = [1,3,5,7,9,11]
accuracy = [
    0.933,
    0.956,
    0.978,
    0.978,
    0.956,
    0.933
]
plt.plot(
    k_values,
    accuracy,
    marker='o'
)
plt.xlabel("Number of Neighbors K")
plt.ylabel("Accuracy")
plt.show()
你看到:
text
Performance
   ↑
   │       ●──●
   │     ●      ●
   │   ●          ●
   │
   └────────────────→ K
      1 3 5 7 9 11
这张图,就是很多 SCI 论文中所谓的:
Hyperparameter sensitivity analysis
别被这个名字吓住。
本质就是:
改变一个参数 → 跑模型 → 记录指标 → 画图 → 解释规律
十七、案例 4:深度学习版本
假设你现在做一个 CNN 故障诊断模型。
python
learning_rates = [
    1e-2,
    5e-3,
    1e-3,
    5e-4,
    1e-4
]
results = []
for lr in learning_rates:
    model = MyCNN()
    optimizer = Adam(
        model.parameters(),
        lr=lr
    )
    train(model, optimizer)
    f1 = evaluate(model)
    results.append(f1)
本质还是一样:
lr→Train→Validation→F1 lr\rightarrow Train\rightarrow Validation\rightarrow F1 lr→Train→Validation→F1
区别只是深度学习训练更慢而已。
十八、案例 5:两个参数怎么办?
假设你的模型:
L=Lcls+λ1Lcon+λ2Ldomain L=L_{cls}+\lambda_1 L_{con}+\lambda_2 L_{domain} L=Lcls+λ1Lcon+λ2Ldomain
你想同时研究:
λ1,λ2 \lambda_1,\lambda_2 λ1,λ2
设:
λ1∈{0.01,0.1,1} \lambda_1\in\{0.01,0.1,1\} λ1∈{0.01,0.1,1}
λ2∈{0.01,0.1,1} \lambda_2\in\{0.01,0.1,1\} λ2∈{0.01,0.1,1}
那么组合数:
3×3=9 3\times3=9 3×3=9
结果可能是:
| λ1\λ2\lambda_1\backslash\lambda_2λ1\λ2 | 0.01 | 0.1 | 1 |
|---|---|---|---|
| 0.01 | 91.2 | 92.8 | 90.5 |
| 0.1 | 93.1 | 95.2 | 92.4 |
| 1 | 90.6 | 91.3 | 87.9 |
| 这就可以做: |
二维超参数分析
论文里通常画成 heatmap。
一眼看出:
(λ1,λ2)=(0.1,0.1) (\lambda_1,\lambda_2)=(0.1,0.1) (λ1,λ2)=(0.1,0.1)
附近最好。
十九、这时候你终于碰到"参数爆炸"问题了
假设有:
lr:5 个值 lr:5\ \text{个值} lr:5 个值
batch:4 个值 batch:4\ \text{个值} batch:4 个值
dropout:5 个值 dropout:5\ \text{个值} dropout:5 个值
hidden:4 个值 hidden:4\ \text{个值} hidden:4 个值
λ1:6 个值 \lambda_1:6\ \text{个值} λ1:6 个值
λ2:6 个值 \lambda_2:6\ \text{个值} λ2:6 个值
全部排列组合:
5×4×5×4×6×6 5\times4\times5\times4\times6\times6 5×4×5×4×6×6
等于:
14,400 组 \boxed{14,400\ \text{组}} 14,400 组
每个还跑 3 次:
43,200 次 43,200\ \text{次} 43,200 次
你电脑可能先写出遗书。
所以论文实验绝对不是:
所有超参数穷举
二十、于是就出现了四种常见调参方法
最简单的是:
Grid Search
比如:
text
lr = [0.01, 0.001, 0.0001]
dropout = [0.1, 0.3, 0.5]
全部组合:
3×3=9 3\times3=9 3×3=9
次。
适合:
参数少、范围已经比较明确。
另一个常见方法:
Random Search
不是所有组合都试。
例如:
lr∈10−5,10−2 lr\in10\^{-5},10\^{-2} lr∈10−5,10−2
dropout∈0,0.7 dropout\in0,0.7 dropout∈0,0.7
随机抽:
30 30 30
组。
往往比死板 Grid Search 更高效。
更高级的是:
Bayesian Optimization
例如 Optuna。
模型会根据:
前面哪些参数表现好?
决定:
下一次优先试哪里?
你以后会经常看到:
python
Optuna
Ray Tune
Hyperopt
但注意:
自动调参软件负责寻找最优参数,不等于论文里的超参分析。
你还是需要展示:
parameter→performance parameter\rightarrow performance parameter→performance
的规律。
二十一、给你一个非常实用的 SCI 实验工作流
以后你建立一个新模型:
M(θ,λ) M(\theta,\lambda) M(θ,λ)
可以按照这套流程走:
text
确定合理范围
    ↓
粗搜索
    ↓
缩小范围
    ↓
精细搜索
    ↓
关键超参数敏感性分析
    ↓
确定最终参数
    ↓
Baseline 正式比较
    ↓
多随机种子验证
这其实比"上来就和 baseline 比"科学得多。
二十二、举一个完整的连续实例
假设你的跨工况故障诊断模型叫:
InvariantNet \text{InvariantNet} InvariantNet
核心损失:
L=Lcls+λLinv L=L_{cls}+\lambda L_{inv} L=Lcls+λLinv
你一开始根本不知道:
λ \lambda λ
应该是多少。
那么第一轮粗搜索:
λ={0, 0.001, 0.01, 0.1, 1, 10} \lambda=\{0,\ 0.001,\ 0.01,\ 0.1,\ 1,\ 10\} λ={0, 0.001, 0.01, 0.1, 1, 10}
得到:
text
0       → 89.3
0.001   → 89.8
0.01    → 92.1
0.1     → 95.0
1       → 92.7
10      → 80.2
你发现:
0.01∼1 0.01\sim1 0.01∼1
比较好。
第二轮精细搜索:
λ={0.02,0.05,0.1,0.2,0.5} \lambda=\{0.02,0.05,0.1,0.2,0.5\} λ={0.02,0.05,0.1,0.2,0.5}
得到:
text
0.02 → 93.5
0.05 → 94.6
0.10 → 95.0
0.20 → 94.9
0.50 → 94.1
于是选择:
λ=0.1 \boxed{\lambda=0.1} λ=0.1
然后最终固定:
text
λ = 0.1再去跑:
text
CNN
LSTM
ResNet
Transformer
DANN
CORAL
你的 InvariantNet
这才是比较规范的流程。
二十三、一个特别重要的问题:Baseline 也需要调参吗?
答案是:
需要
否则不公平。
例如:
你的模型:
lr=0.001 lr=0.001 lr=0.001
是你认真调出来的。
而 baseline:
text
ResNet
lr=0.1
随便给一个值。
结果:
text
Ours       96%
ResNet     82%
这个比较没有多少说服力。
比较正规的做法是:
Baseline 使用原论文推荐参数,或者在统一验证集上进行合理调参。
所以论文可以写:
All competing methods were tuned on the validation set according to their recommended settings or the search spaces reported in the original papers.
二十四、超参分析和消融实验有什么区别?
这个问题你以后一定会遇到。
假设:
L=Lcls+λLinv L=L_{cls}+\lambda L_{inv} L=Lcls+λLinv
消融实验
研究:
有没有 LinvL_{inv}Linv 有什么区别?
即:
λ=0vs.λ>0 \lambda=0 \quad \text{vs.} \quad \lambda>0 λ=0vs.λ>0
本质是:
这个模块有没有用?
超参数分析
研究:
λ=0.01, 0.05, 0.1, 0.5, 1 \lambda=0.01,\ 0.05,\ 0.1,\ 0.5,\ 1 λ=0.01, 0.05, 0.1, 0.5, 1
本质是:
这个模块多大强度最合理?
所以:
Ablation:有没有它?
Hyperparameter:它应该多大?
这是非常重要的区别。
二十五、一个非常典型的论文实验结构
以后你的论文实验章节完全可以这样理解:
text
4 Experiments
4.1 Datasets
4.2 Experimental Settings
4.3 Comparison with State-of-the-Art Methods
4.4 Ablation Study
4.5 Hyperparameter Sensitivity Analysis
4.6 Robustness Analysis
4.7 Visualization
其中:
4.2 Experimental Settings
告诉别人:
lr=0.001 lr=0.001 lr=0.001
batch=64 batch=64 batch=64
epoch=100 epoch=100 epoch=100
4.4 Ablation Study
回答:
我的创新模块到底有没有用?
4.5 Hyperparameter Analysis
回答:
为什么 λ=0.1\lambda=0.1λ=0.1?
二十六、论文中的超参数分析应该怎么写?
例如你的实验结果显示:
λ=0.1 \lambda=0.1 λ=0.1
最好。
不能只写:
As shown in Fig. 8, λ=0.1\lambda=0.1λ=0.1 achieves the best performance.
这太浅。
更好的逻辑应该是:
λ\lambdaλ 很小
↓
LinvL_{inv}Linv 作用弱
↓
跨工况特征约束不足
↓
性能较低。
随着:
λ↑ \lambda\uparrow λ↑
不变特征约束增强:
Performance↑ Performance\uparrow Performance↑
但是:
λ\lambdaλ 过大
↓
模型过度追求域不变性
↓
削弱类别判别结构
↓
Performance↓ Performance\downarrow Performance↓
最终说明:
λ=0.1 \lambda=0.1 λ=0.1
在
Domain Invariance↔Class Discrimination \text{Domain Invariance} \leftrightarrow \text{Class Discrimination} Domain Invariance↔Class Discrimination
之间取得较好的平衡。
这样的分析才像 SCI 论文,而不是"看图说数字"。
二十七、初学者做超参分析最容易犯的 7 个错误
| 错误 | 问题 |
|---|---|
| 只跑一个超参数值 | 不知道参数敏感性 |
| 在 Test Set 上选参数 | 数据泄漏 |
| 每次同时改变很多参数 | 无法解释因果 |
| 只报告最好一次 | 可能存在随机性 |
| 所有超参数都暴力搜索 | 计算量爆炸 |
| 只画图不解释规律 | 缺少科研价值 |
| Baseline 不调参 | 比较不公平 |
| 其中最重要的三个,你可以牢牢记住: |
- Validation 调参
- Test 最终评估
- 关键实验多随机种子
二十八、你以后看到论文中的这张图就应该知道它在干什么了
例如论文:
text
(a) Effect of λ
(b) Effect of hidden dimension
(c) Effect of number of layers
(d) Effect of temperature τ
横轴:
Hyperparameter \text{Hyperparameter} Hyperparameter
纵轴:
Accuracy / F1 / AUC \text{Accuracy / F1 / AUC} Accuracy / F1 / AUC
本质都是:
y=f(hyperparameter) y=f(\text{hyperparameter}) y=f(hyperparameter)
研究模型对参数的敏感程度。
如果曲线是:
text
         ●
      ●     ●
   ●           ●
 ●
通常说明:
存在最佳区间
如果:
text
●──●──●──●──●说明:
模型对该参数较鲁棒
而这其实是一个很好的性质。
二十九、给你一个"论文小白→会做科研"的实践作业
我建议你不要只看,直接动手。
第 1 关:KNN
用 Iris 数据集跑:
K=1,3,5,7,9,11,15 K=1,3,5,7,9,11,15 K=1,3,5,7,9,11,15
画:
K-Accuracy K\text{-}Accuracy K-Accuracy
曲线。
第 2 关:SVM
测试:
C=0.01,0.1,1,10,100 C=0.01,0.1,1,10,100 C=0.01,0.1,1,10,100
研究:
C-Accuracy C\text{-}Accuracy C-Accuracy
第 3 关:简单神经网络
测试:
lr=10−2,10−3,10−4,10−5 lr=10^{-2},10^{-3},10^{-4},10^{-5} lr=10−2,10−3,10−4,10−5
画:
lr-F1 lr\text{-}F1 lr-F1
第 4 关:Dropout
测试:
p=0, 0.1, 0.3, 0.5, 0.7 p=0,\ 0.1,\ 0.3,\ 0.5,\ 0.7 p=0, 0.1, 0.3, 0.5, 0.7
理解:
p 太小⇒可能过拟合 p\ \text{太小} \Rightarrow \text{可能过拟合} p 太小⇒可能过拟合
p 太大⇒可能欠拟合 p\ \text{太大} \Rightarrow \text{可能欠拟合} p 太大⇒可能欠拟合
第 5 关:论文创新超参数
人为构造:
L=Lcls+λLaux L=L_{cls}+\lambda L_{aux} L=Lcls+λLaux
分析:
λ=0, 0.01, 0.05, 0.1, 0.5, 1 \lambda=0,\ 0.01,\ 0.05,\ 0.1,\ 0.5,\ 1 λ=0, 0.01, 0.05, 0.1, 0.5, 1
到这里,你基本就真正掌握论文中的超参分析了。
三十、最后给你建立一张完整的"大脑地图"
以后看到超参数,不要想到:
"老师让我多跑几次模型。"
而应该形成下面这个思维:
提出模型
↓
模型存在超参数:
θh \theta_h θh
↓
确定合理搜索空间:
Θh \Theta_h Θh
↓
Train:
θ=argminθL(Xtrain;θ,θh) \theta=\arg\min_\theta L(X_{train};\theta,\theta_h) θ=argθminL(Xtrain;θ,θh)
↓
Validation:
θh∗=argmaxθhMetricval \theta_h^*=\arg\max_{\theta_h} Metric_{val} θh∗=argθhmaxMetricval
↓
做敏感性分析:
Metric=f(θh) Metric=f(\theta_h) Metric=f(θh)
↓
解释:
为什么性能会这样变化?
↓
确定最终参数:
θh∗ \theta_h^* θh∗
↓
最后在 Test 上评估:
Metrictest Metric_{test} Metrictest
↓
和 Baseline 公平比较。
所以你原来理解的:
给一个超参 → 跑一次 → 和别人比较
可以升级成真正的科研实验逻辑:
确定搜索空间 → 验证集调参 → 敏感性分析 → 解释变化机理 → 确定参数 → 多随机种子 → 测试集最终比较
这就是你以后写机器学习、深度学习 SCI 论文时,超参数实验最核心的一套方法论 。
尤其你以后自己设计类似
L=Lcls+λ1Ldomain+λ2Lcon L=L_{cls}+\lambda_1 L_{domain}+\lambda_2 L_{con} L=Lcls+λ1Ldomain+λ2Lcon
这种新模型时,λ1,λ2\lambda_1,\lambda_2λ1,λ2 的超参分析往往不是"附属实验",而是帮助你证明模型设计是否合理的重要证据。
补充说明 :本版本保留了所有数学表达式(如 argmax\arg\maxargmax、λ∈{...}\lambda\in\{...\}λ∈{...}、Mean±StdMean\pm StdMean±Std 等)为标准 LaTeX 数学语法,可在支持 KaTeX/MathJax 的 Markdown 渲染器(Typora、Obsidian、VS Code、Jupyter 等)中正确显示;纯中文或纯流程性的 \boxed 内容改为了引用块或代码块箭头图,保证在任何 Markdown 环境下都不会渲染失败。