1. 论文信息
作者:Bowen Zhang, Chunping Li
会议:EMNLP 2024 Main Conference
论文主要研究 Semantic Textual Similarity(STS,语义文本相似度),核心思路是将传统的相似度分类任务转化为回归任务,直接预测两个文本之间的连续相似度。
2. 研究背景
传统的文本相似度任务可以将相似度划分为多个等级,例如:
0:不相似
1:低相似
2:中等相似
3:高度相似
如果使用分类方法,模型最终需要预测:
0 / 1 / 2 / 3但这些标签本身具有明显的顺序关系。
例如真实值为 2:
预测 3 → 与真实值比较接近
预测 0 → 与真实值差距较大
普通分类损失并不能很好地体现这种"距离关系"。
因此论文提出:与其将相似度看成离散类别,不如直接预测一个连续的相似度分数。
例如:
QA1:如何申请国家助学金?
QA2:国家助学金怎么申请?
        ↓
Similarity Regression
        ↓
	  0.92
3. 论文方法
论文采用两个文本分别经过共享的编码器得到表示:
Text A ──→ Encoder ──→ u
                         │
                         ├──→ Similarity Head
                         │
Text B ──→ Encoder ──→ v
然后利用:
作为输入,通过回归层直接得到相似度分数。
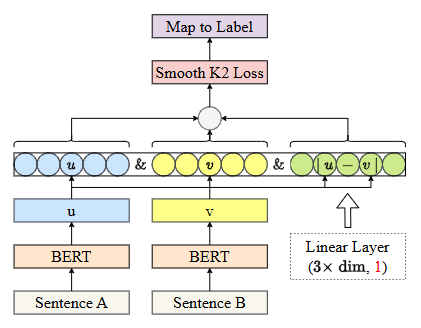
对于 K 类任务,最终输出层的参数规模可以从:3×hidden_dimension×K → 3×hidden_dimension×1
两个损失函数:
Translated ReLU
给预测误差设置一个容忍范围。
当预测值已经足够接近真实值时:不再继续产生梯度。
只有误差超过一定范围后才继续优化。
Smooth K2 Loss
同样保留一个误差容忍区间,但超过阈值后采用二次形式进行惩罚:误差越大,惩罚越强。
4. 实验结果
论文在 STS-12~STS-16、STS-B、SICK-R 等 7 个 STS 数据集上进行实验。
在作者的实验设置下:
- BERT-base + Smooth K2 Loss:平均 76.03 Spearman
- RoBERTa-base + Smooth K2 Loss:平均 76.04 Spearman
整体结果表明,将 STS 建模为回归任务,并设计针对性的回归损失,可以取得较好的语义相似度效果。
论文同时比较了训练资源消耗,在其设置下,回归方案相比 SimCSE 使用了更低的训练显存。
5. 对我们当前 LAUR 项目的启发
目前的 LAUR 主要是:
文本
 ↓
BERT + LAUR
 ↓
分类 Head
 ↓
类别标签
而新任务可能涉及:
QA1 + QA2
    ↓
相似度学习
    ↓
连续相似度
    ↓
后续进行 QA 分组
因此,这篇论文给我的主要启发是:考虑将 LAUR 原有的分类任务进一步扩展为相似度回归任务。
也就是:
原 LAUR:
文本 → LAUR → 分类

可能的后续方向:
QA1 + QA2
    ↓
  LAUR
    ↓
Similarity Regression
    ↓
相似度分数
这样仍然保留了 LAUR 的持续学习特点,同时改变任务目标。
6. 与任务的联系
- 都涉及文本/问答之间的语义相似度
- 都可以采用连续相似度而不是简单分类标签
- 回归结果可以进一步用于后续的相似 QA 分组
因此,这篇论文更适合作为:LAUR 从分类任务向相似度回归任务扩展
7. 总结
这篇论文最核心的思想:将具有连续语义关系的文本相似度从分类问题转化为回归问题,并通过 Translated ReLU 和 Smooth K2 Loss 改善回归训练。
现有 LAUR
   ↓
持续学习
   ↓
分类任务
   ↓
────────────
   ↓
相似度回归
   ↓
QA 两两相似度
   ↓
进一步进行分组