【简介】虽然知道MLX-Serve很好,但是要敲命令,对电脑不熟悉的就头大了,想想还是LM Studio简单方便,那还有没有在LM Studio下可以用的占满128G内存的大模型呢?
 ChatGPT 的推荐
虽然ChatGPT介绍大模型的时候有点不靠谱(介绍了一个LM Studio下不能用的107G大模型),但是人无完人不是。
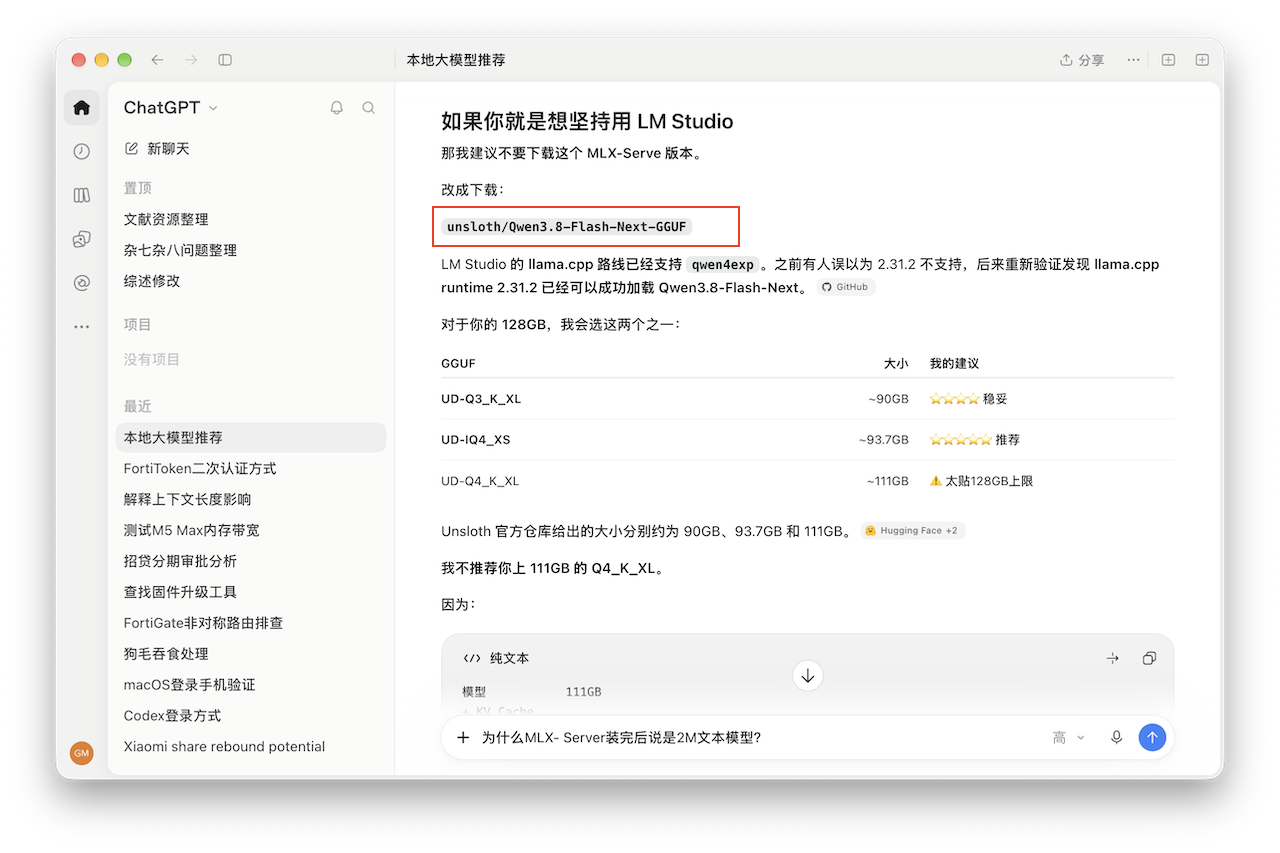
① ChatGPT 给我推荐了 unsloth/Qwen3.8-Flash-Next-GGUF 这个模型。
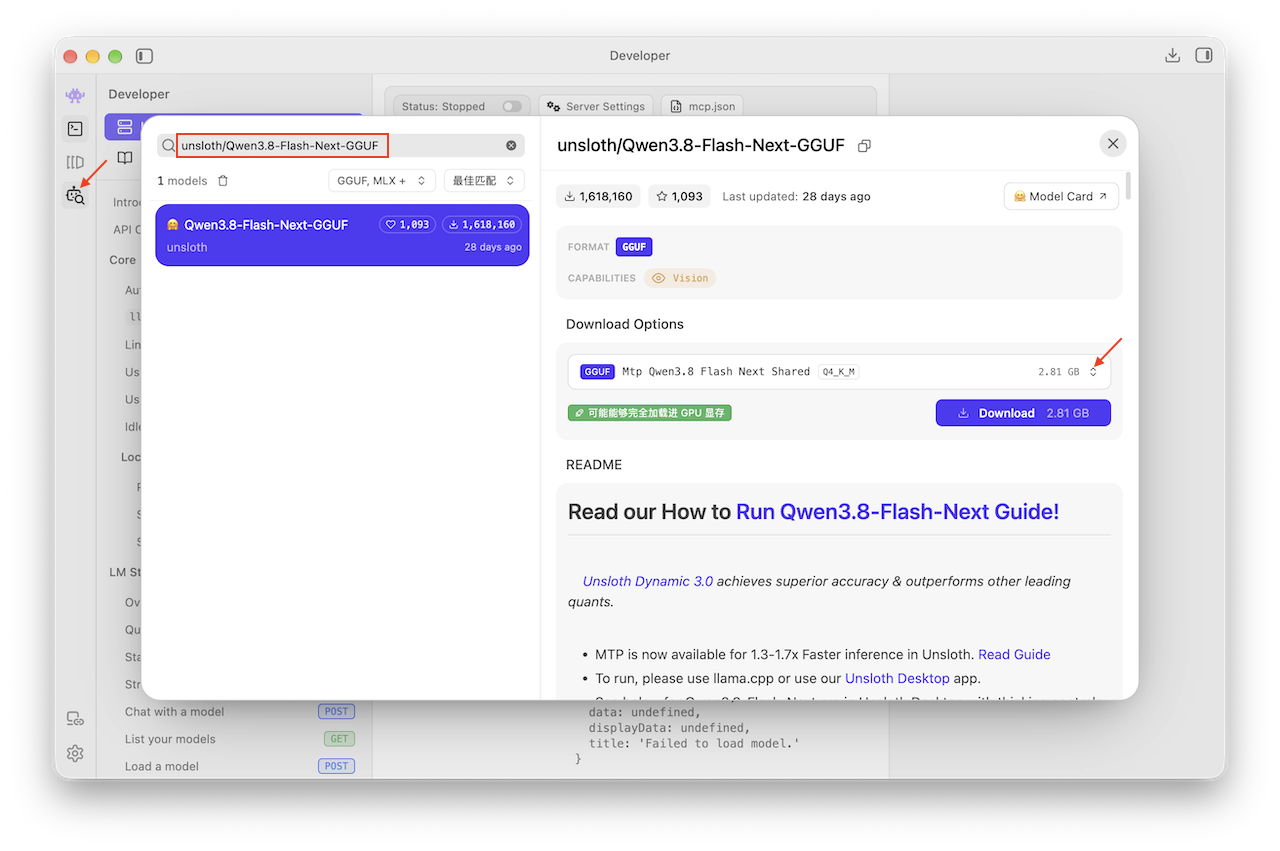
② 回到LM Studio,一搜索,还真有这个模型。点击下载选项里模型右边菜单按钮。
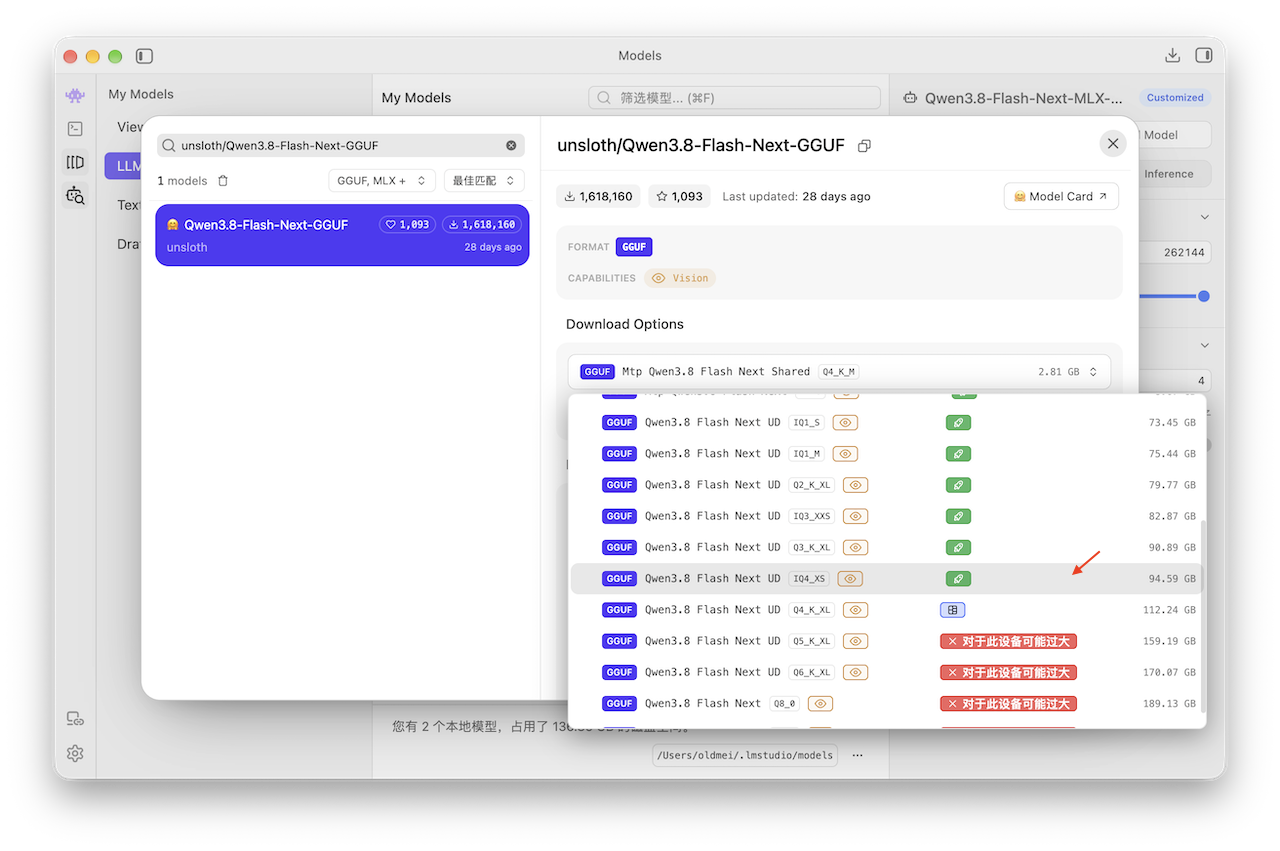
③ 这回学精了,不选择超过100G的大模型,这里选择94.59GB的,试试能不能正常用。
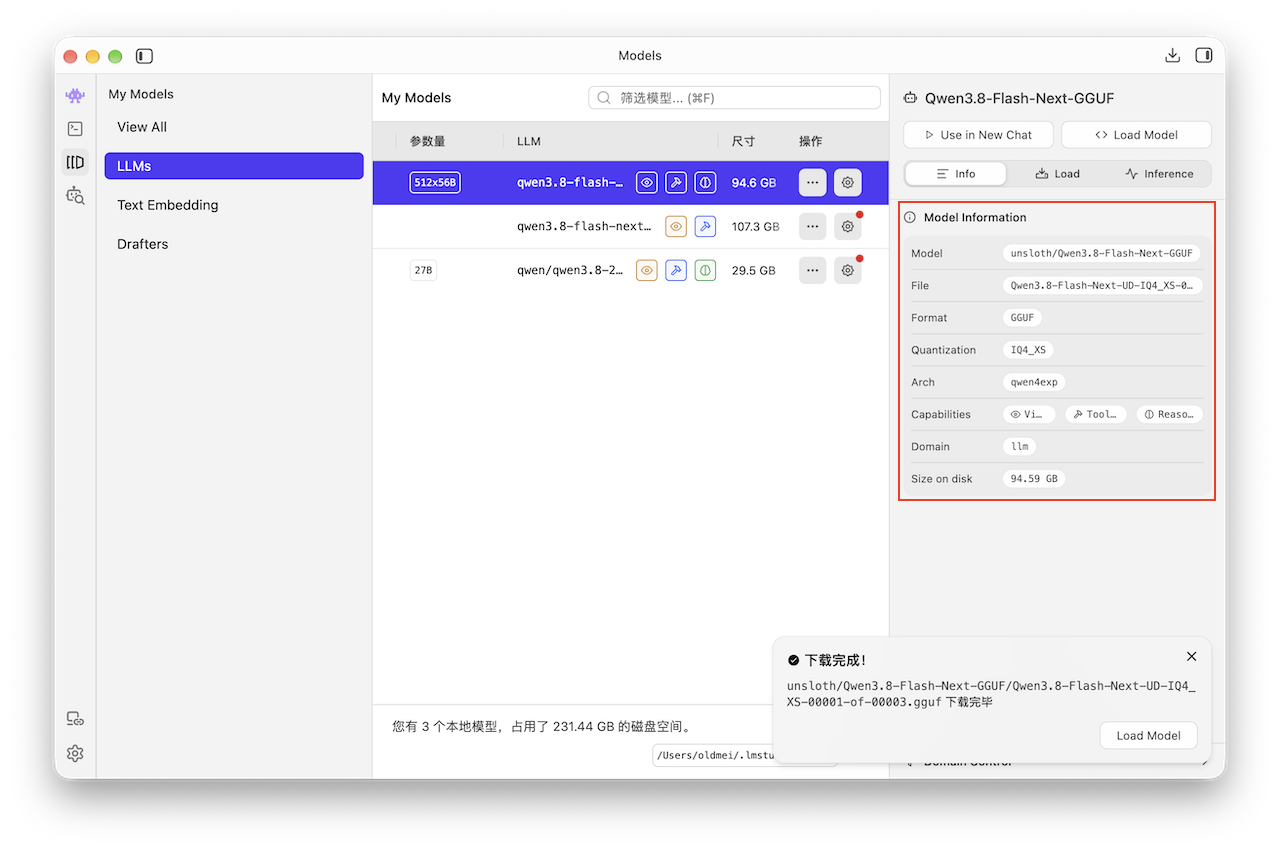
④ 好不容易下载完成,得亏买的是2T硬盘的,不然多下几个模型都不够存放了。还是老规则,重新Mac后启动LM Studio装载新下载的模型。启动后系统约占10G内存。
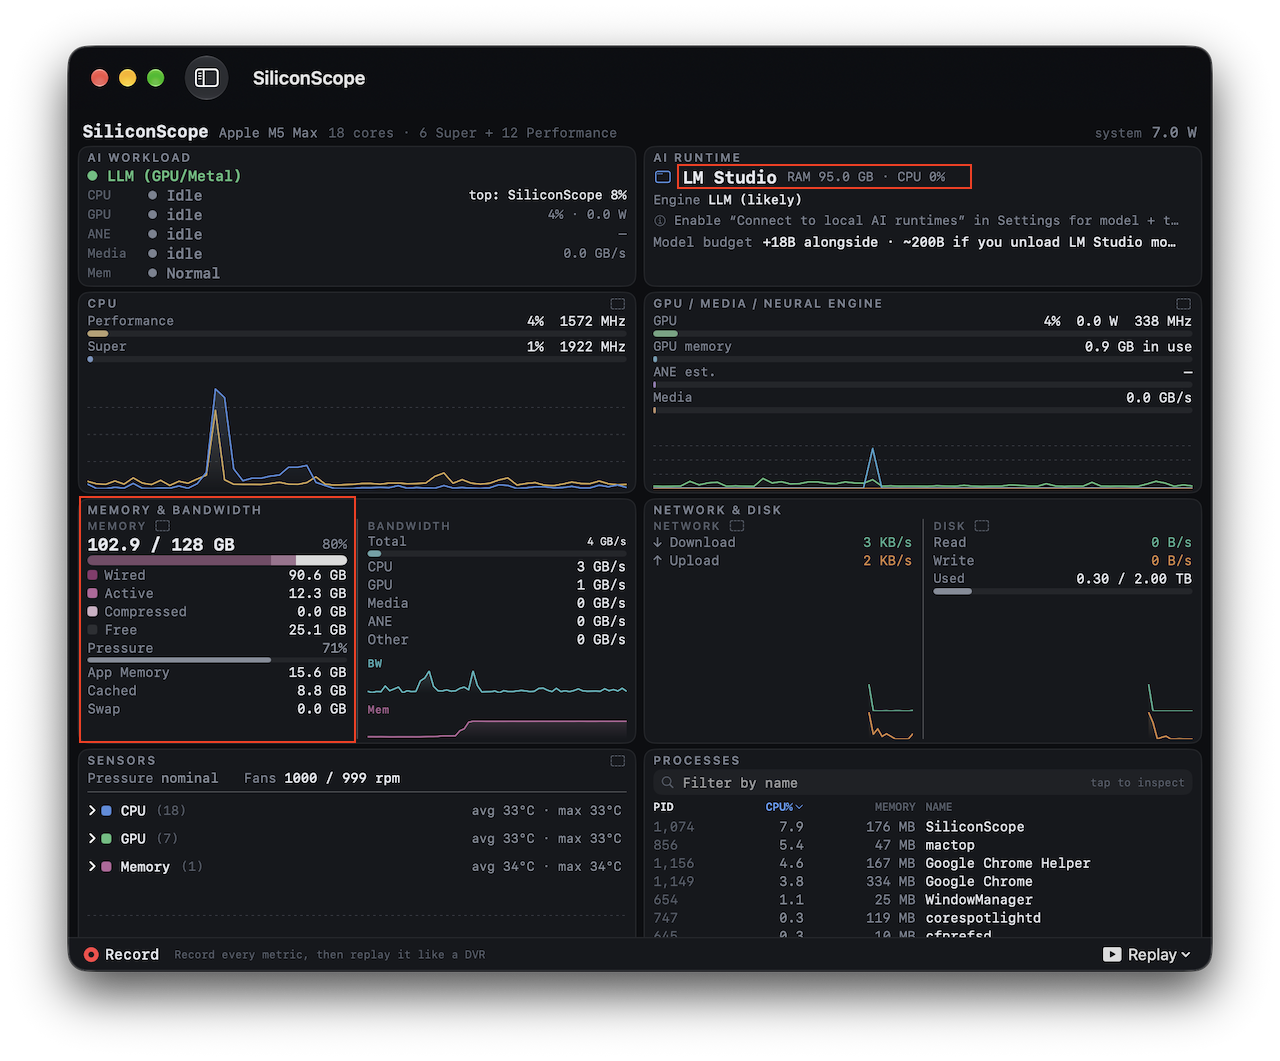
⑤ 这次查看内存,AI RUNTIME 显示 LM Studio 占了95GB内存。离我们的预想进了一步,下面试试这个模型好不好用。
 模型测试
由于对这个模型不了解,我们先简单测试一下。
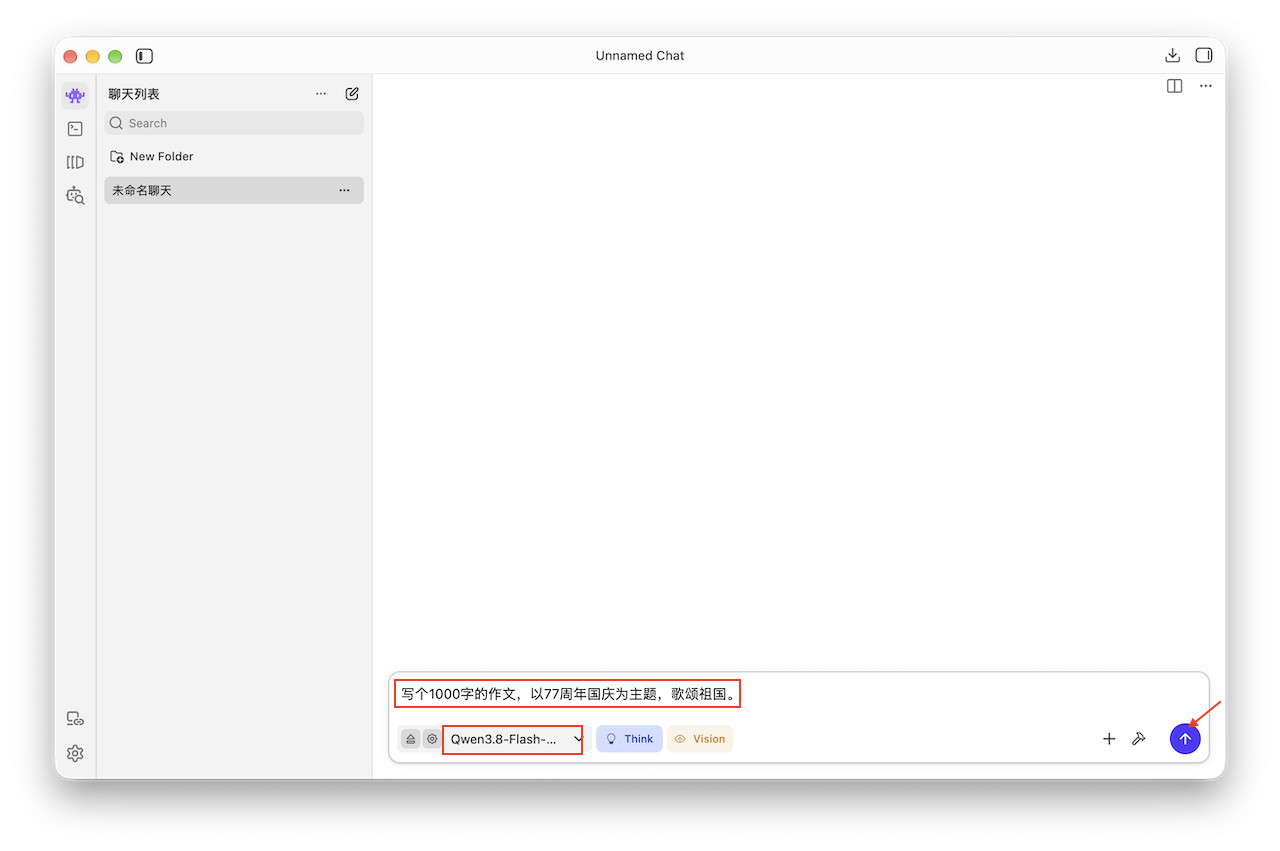
① 在LM Studio聊天窗口,模型选择Qwen3.8-Flash-Next-GGUF,让写一个1000字的作文。上次用Qwen3.8-27B 8bit这个模型的时候,同样问题就卡住死循环了。当然也不排除是我设置错了。
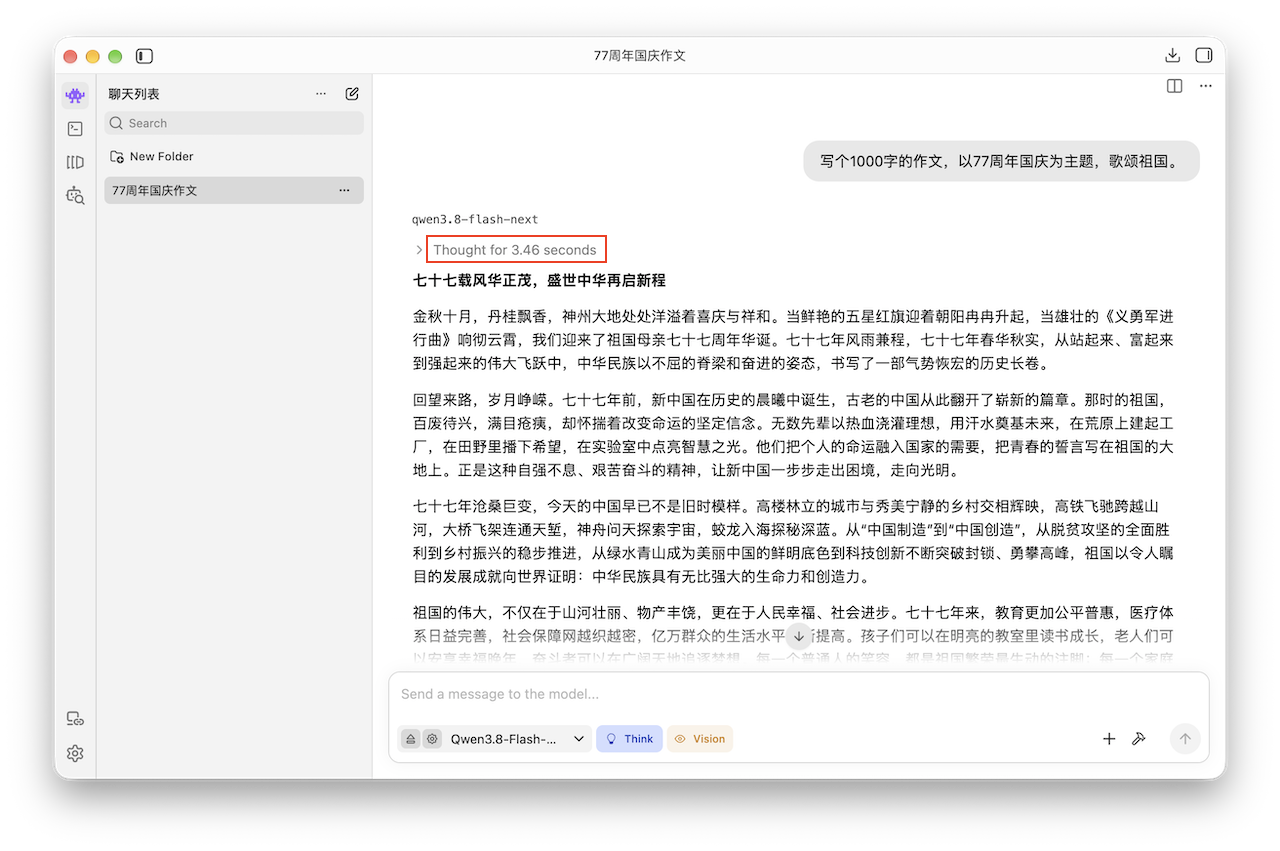
② 本地AI思考了3.46秒,就给出了1000字的作文。
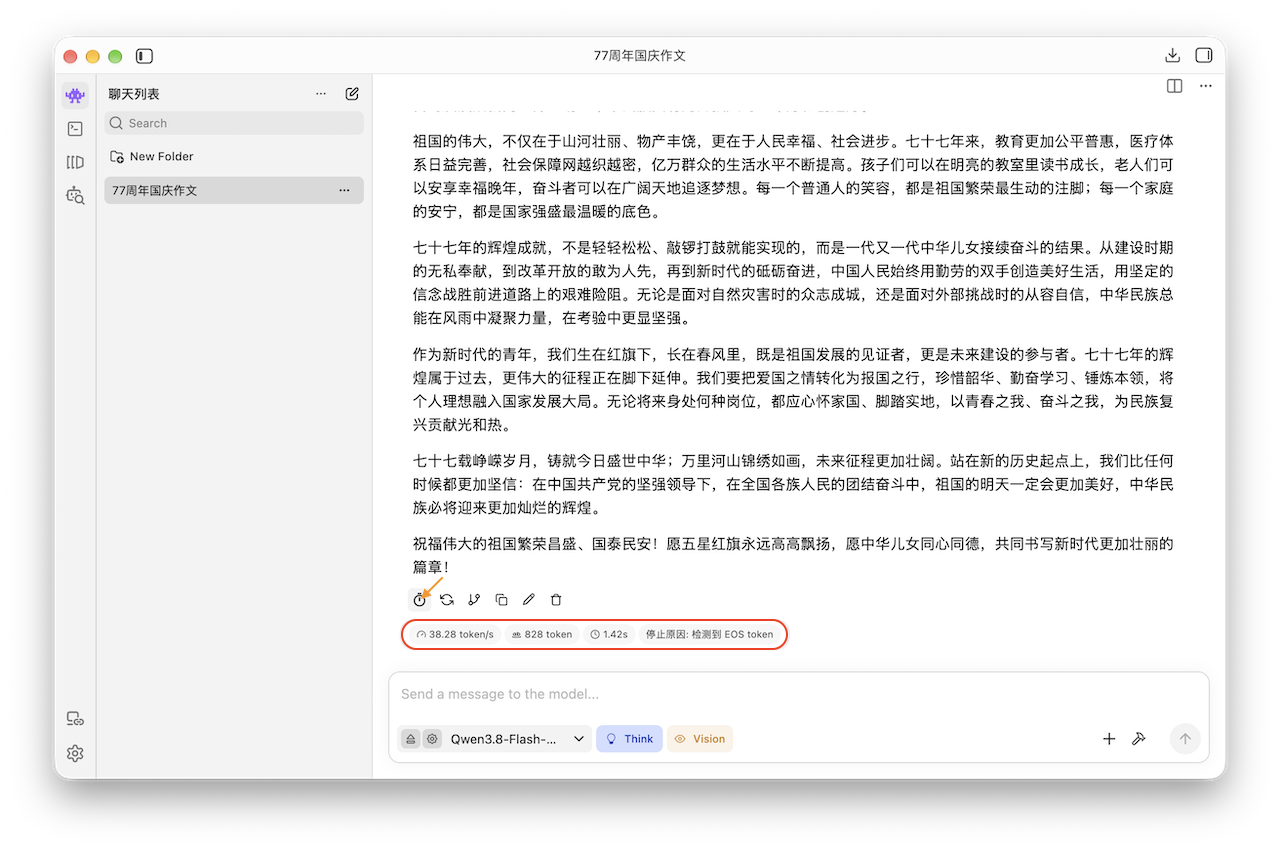
③ 鼠标移到未尾第一个秒表图标上,会弹出一些显示信息。
38.28 token/s 是生成速度(吞吐率):模型每秒输入出约38.28个token,token是模型处理文本的最小单位,中文里大致1~2个字算一个token,这个值越高,回答"吐字"越快。
828 token 是本次输出的总长度:这篇作文一共生成了约828个token,注意是token数,不是汉字字数。
1.42s 是耗时:本次生成过程所花时间。
停止原因:检查到EOS token 里的EOS=End Of Sequence(序列结束符),是词表里一个特殊的控制标记,相当于告诉模型"话说完了,可以停笔"。
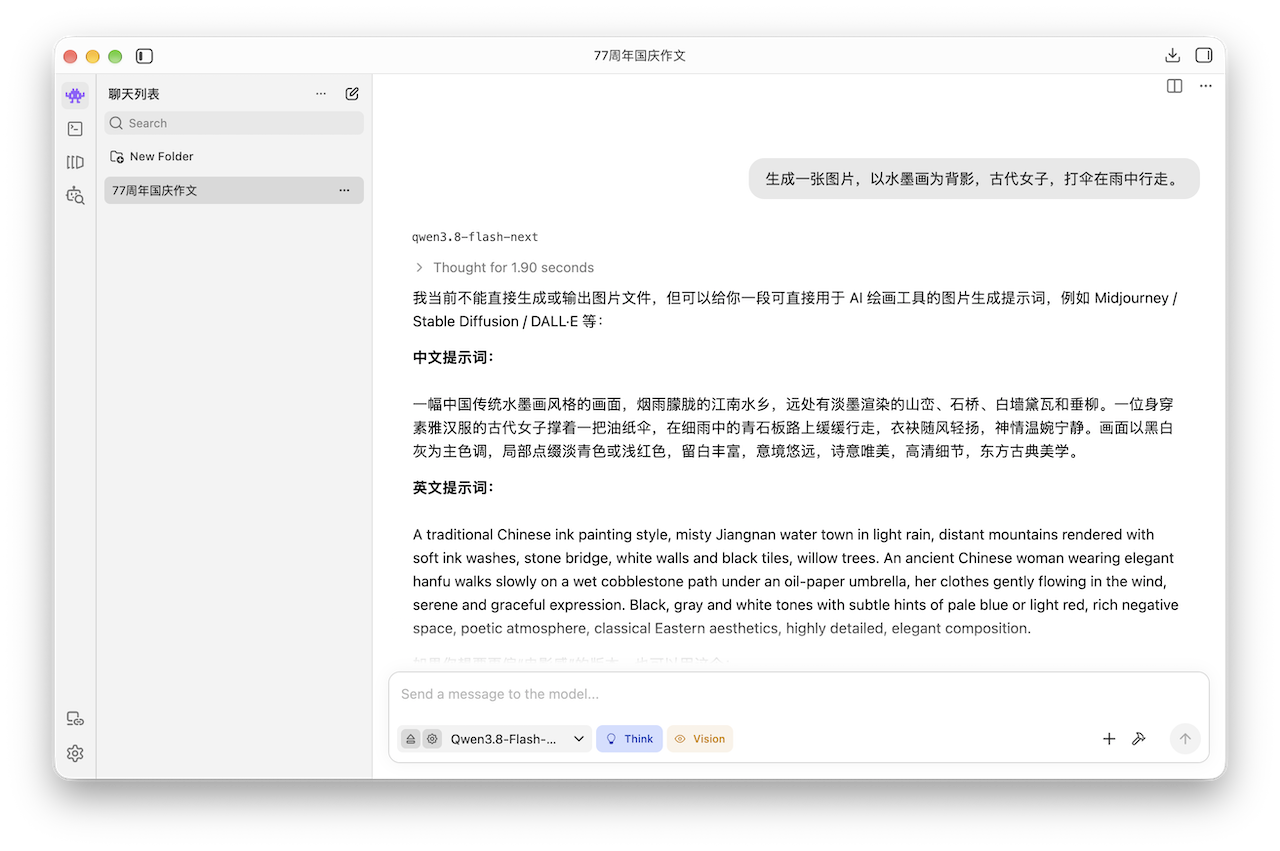
③ 让本地AI生成一张图片,可惜不支持图片生成,但是可以生成中、英文提示词。
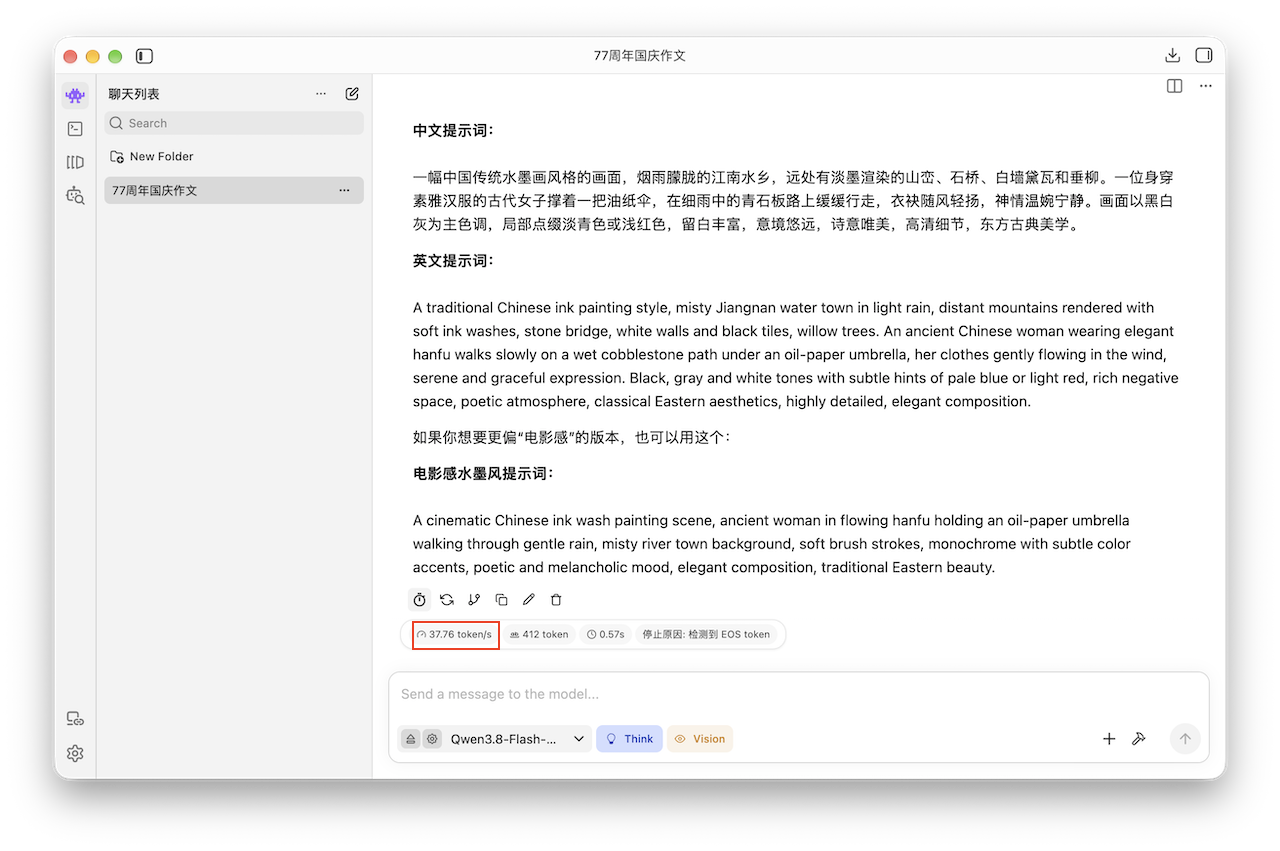
④ 文字的生成速度和第一个相差不大,37 token/s。
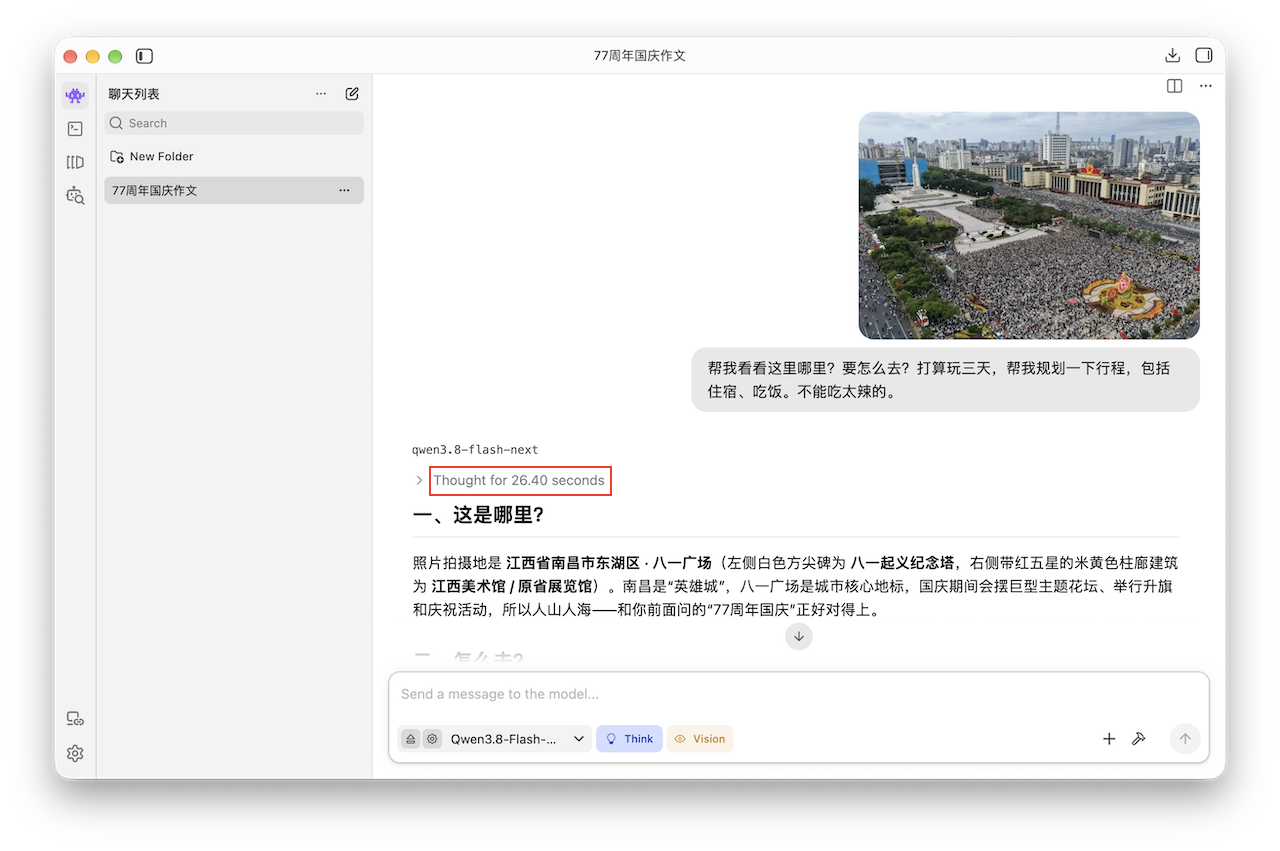
⑤ 上点强度,这里上传了一张照让,让本地AI识别照片是哪里,并安排吃、住行程,这次反应时间是26.40秒。
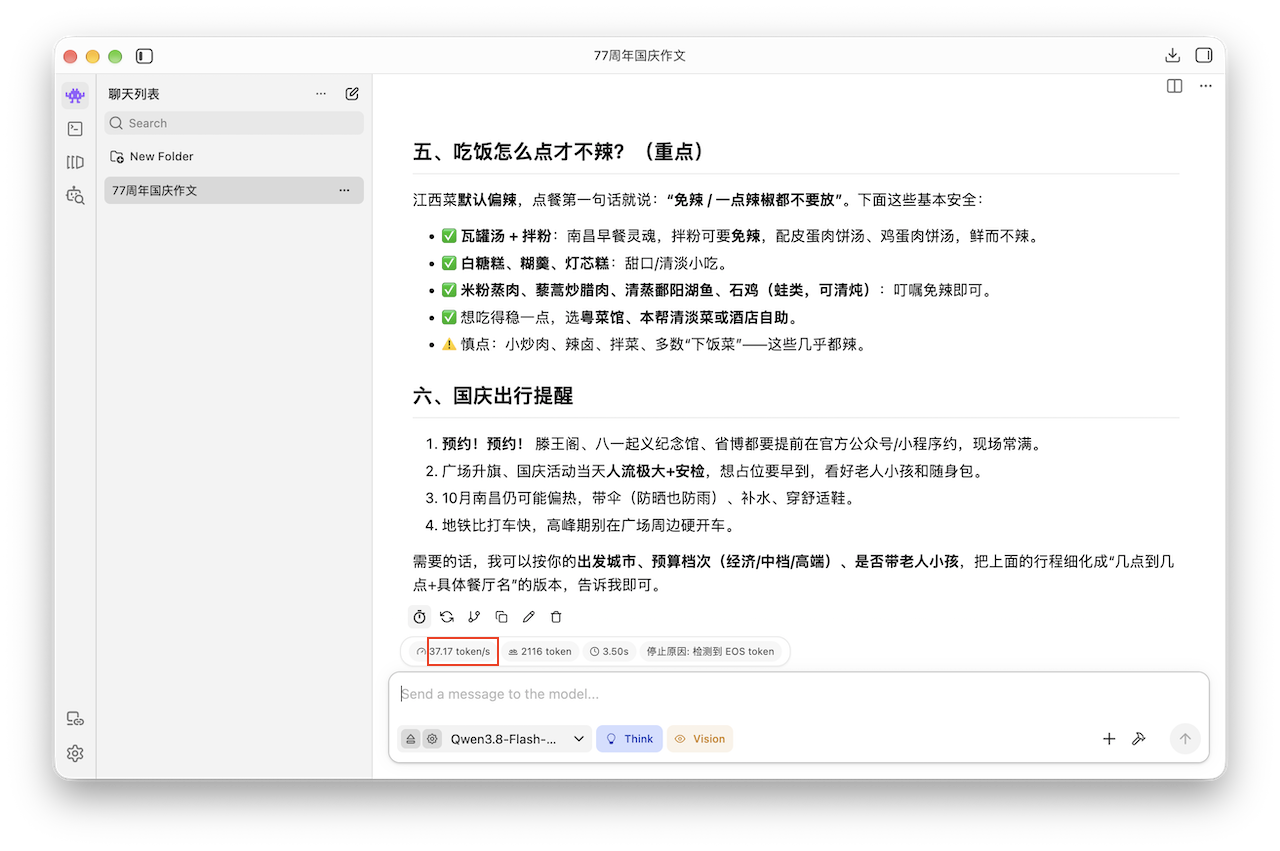
⑥ 本地AI成功的识别出了照片上的地址,并安排了一系列的行程,感觉和互联网上的AI给出的答案大差不差。文字生成速度仍然是 37 token/s。
⑦ 为了验证没有从互联网上查找答案,我这里关掉Mac的无线,网线没插,Mac是无网状态。
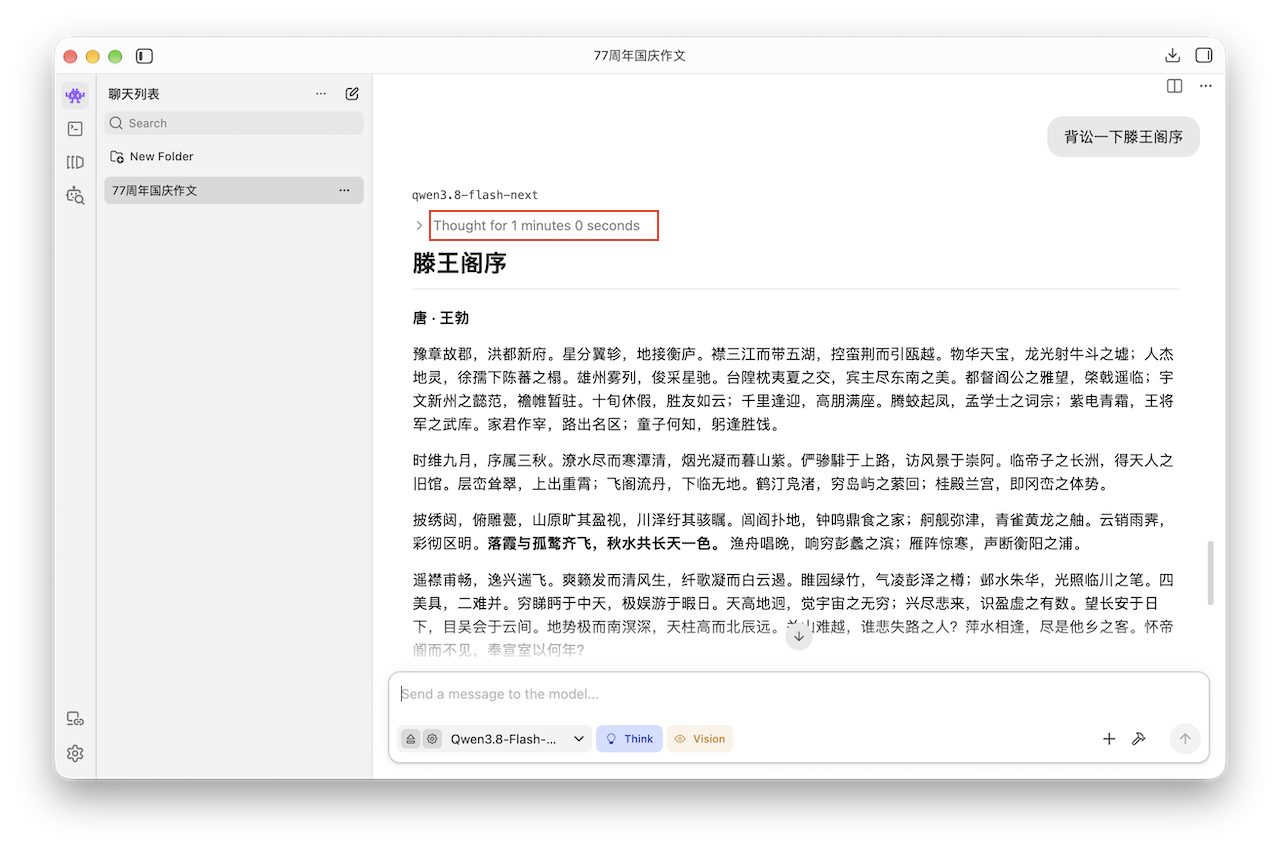
⑧ 让本地AI背讼腾王阁序,这次思考了一分钟,仍然给出了答案。
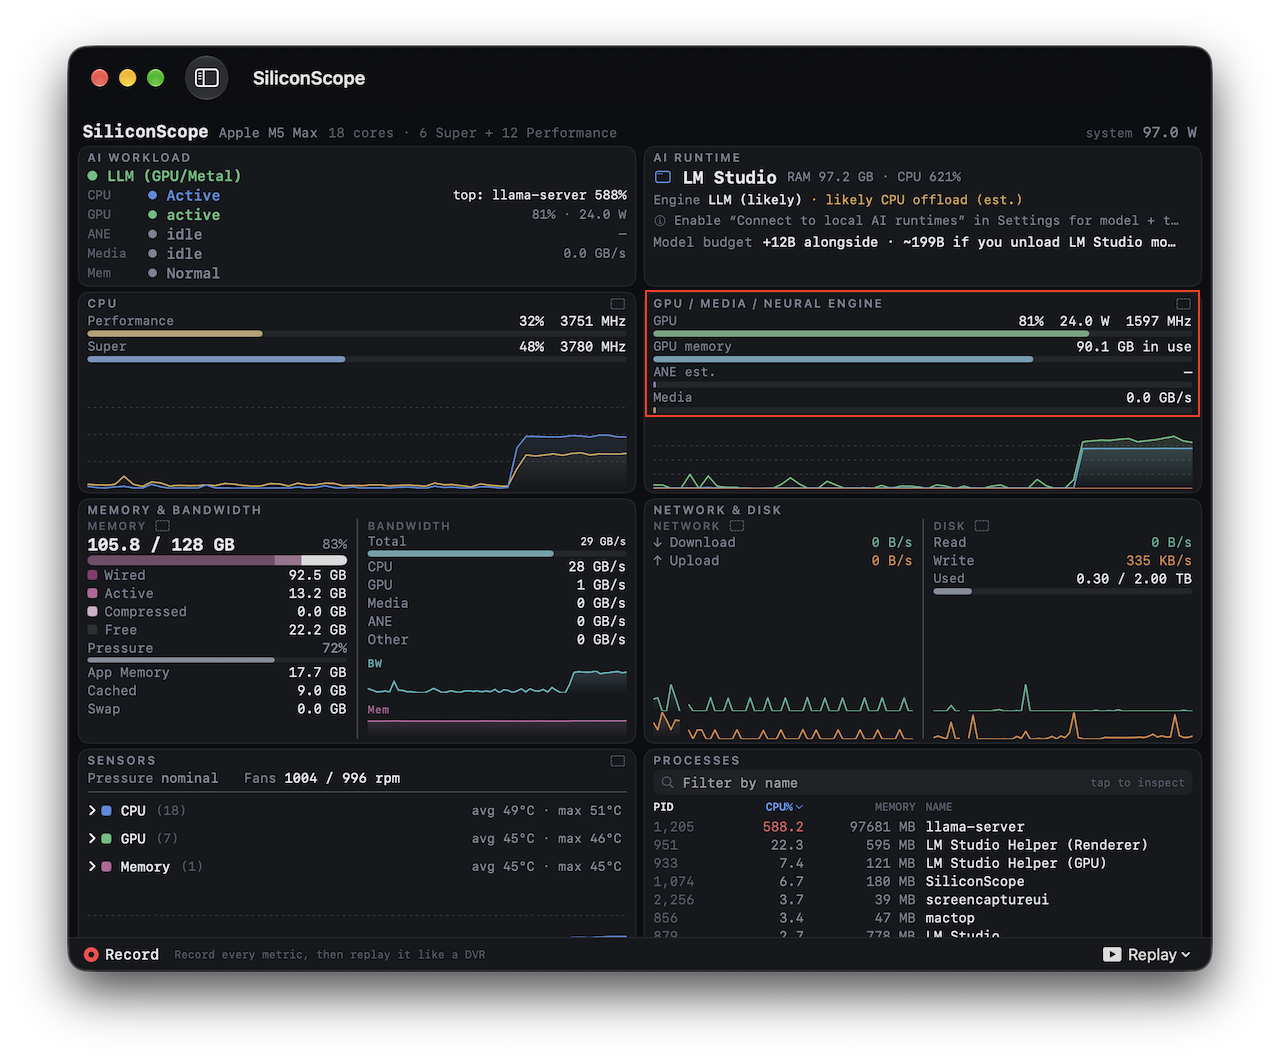
⑨ 查看系统状态,CPU和GPU都在狂运行,特别是GPU。
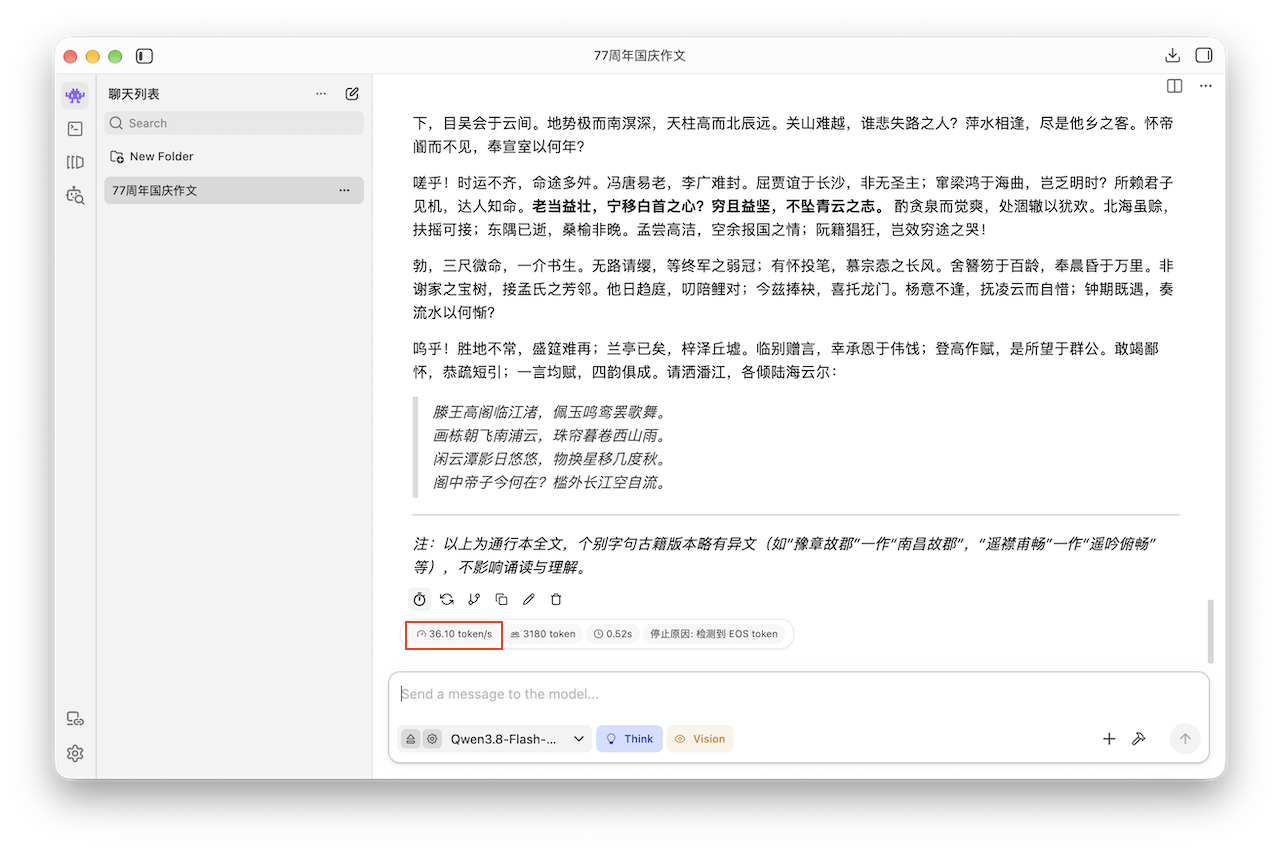
⑩ 最后查看生成速度,36 token/s,也就是说这个模型生成速度始终在36~38 token/s之间。很奇怪,都没网了,它是怎么算出这个腾王阁序来的?
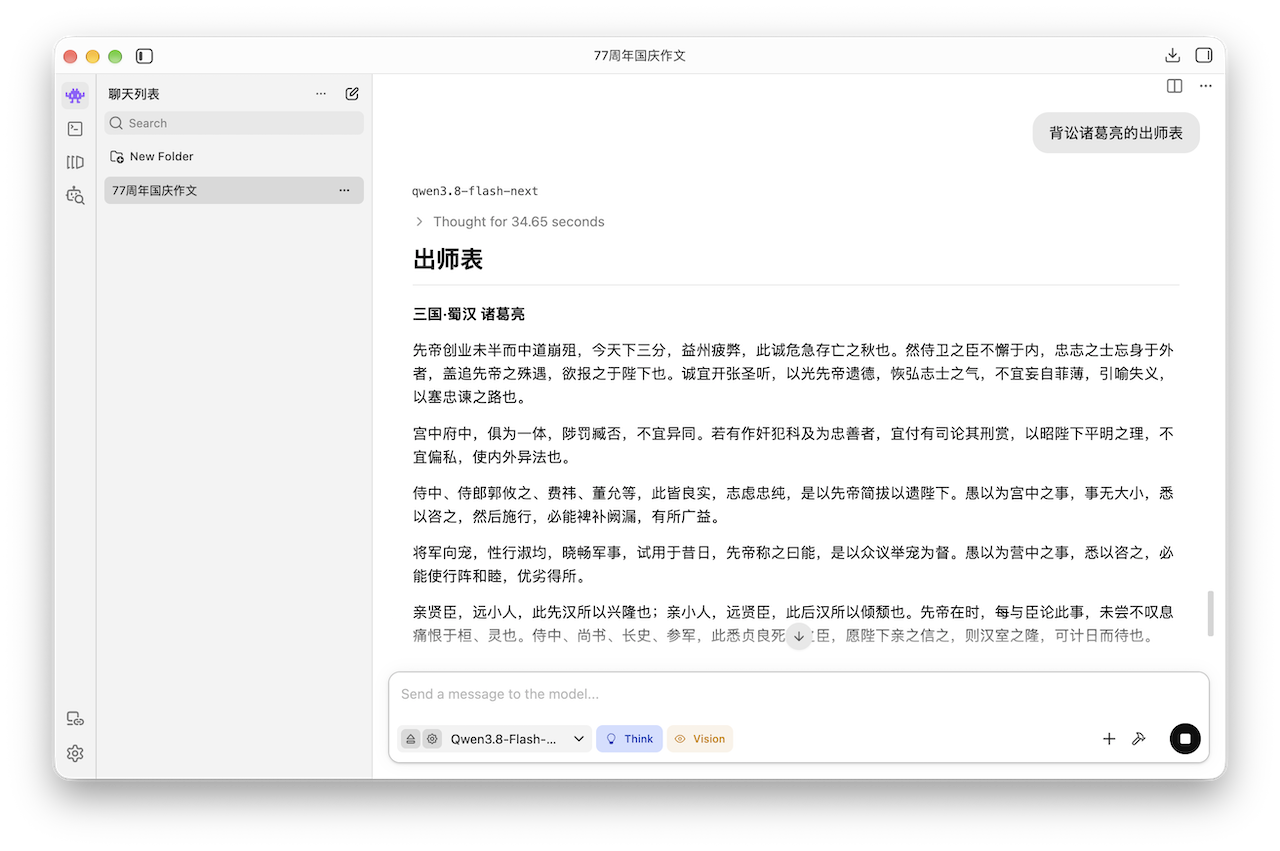
⑪ 最后还是不死心,在没联网的情况下让它背个出师表,嘿,人家还真背出来了,有谁能解释解释这是啥原理吗?
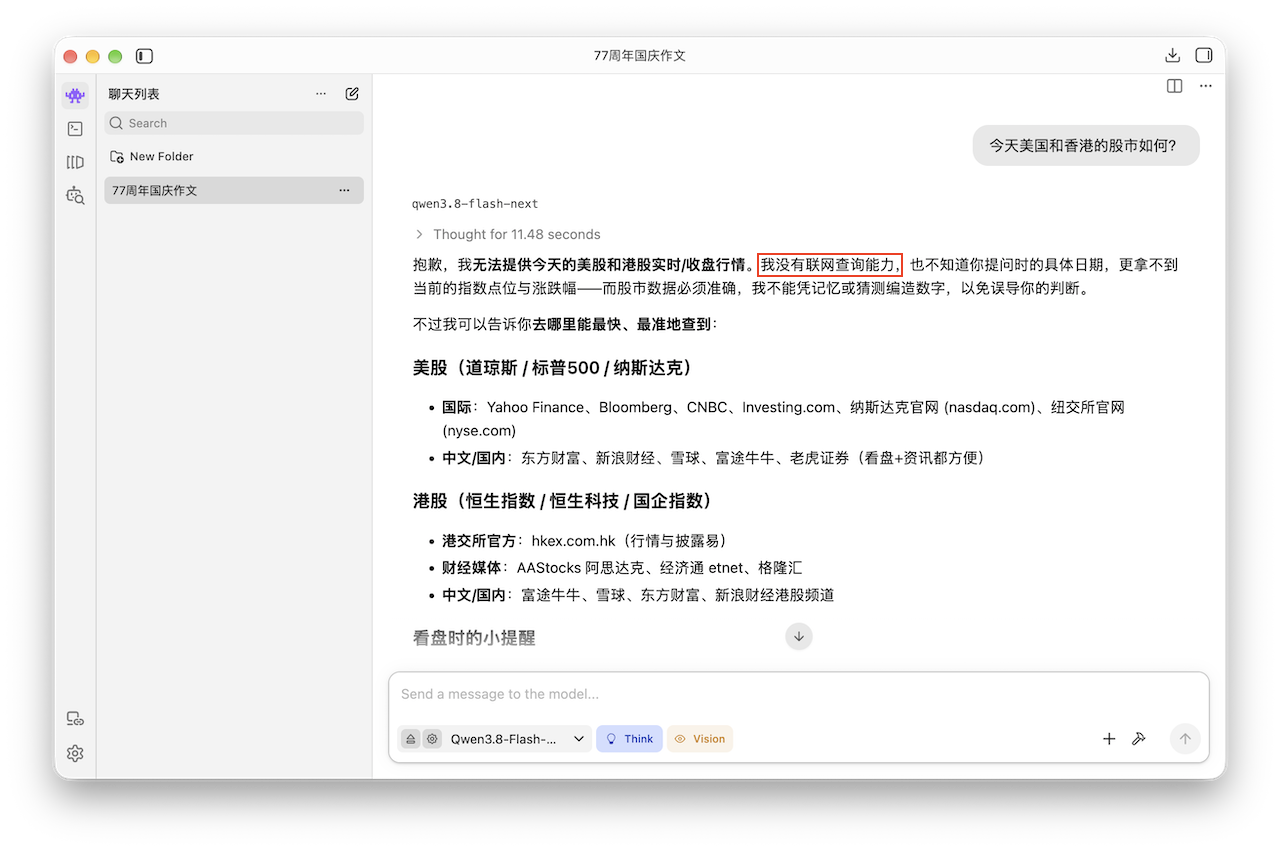
⑫ 我把网连上,让它查一下股票行情,结果人家告诉我它没联网查询能力,看来本地运行是真的。
