作者:来自 Elastic Panagiotis Bailis
Elasticsearch 现在会针对每个查询决定是在向量搜索之前还是之后执行 kNN 过滤。在一个包含 1000 万个向量的数据集上,在 120 组基准测试中,有 104 组采用后置过滤的速度更快,同时仍能返回 k 个结果。
现在,Elasticsearch 会针对每个查询决定是在向量搜索之前还是之后应用 kNN 过滤。在包含 100 万个向量的 segment 上,在搜索之后检查一个宽泛的 match_phrase 过滤条件耗时不到 1 毫秒,而在搜索之前检查则需要 33.4 毫秒。在包含 1000 万个向量的数据集上,在 120 组基准测试中,后置过滤有 104 组速度更快,同时 recall 与前置过滤相差不超过 0.01。
你可以通过这个面向 Search AI 的自主学习实践课程亲自体验向量搜索。你现在可以开始免费云试用,也可以在你的本地机器上试用 Elastic。
Elasticsearch 现在会针对每个查询决定是在向量搜索之前还是之后应用 kNN 过滤。knn 子句中的过滤条件,例如租户 ID 或语言,会作为前置过滤运行,因此会在搜索开始之前,对每个 segment 中的每个文档进行评估。当过滤条件 匹配数据 集中的足够多文档时,Elasticsearch 会先执行向量搜索,然后只针对返回的候选项检查过滤条件。候选池的大小会通过统计方式确定,以确保至少有 k 个结果通过过滤。如果结果数量不足,Elasticsearch 会重试一次,然后回退到前置过滤搜索。你的查询保持不变,并且仍然可以获得 k 个结果。预计这项功能将在 Elasticsearch 9.6 中默认启用。
kNN 过滤在 Elasticsearch 中如何工作
简单回顾一下,Elasticsearch 针对 dense_vector 字段提供了两种近似最近邻结构。HNSW 是一种邻近图:搜索会从一个邻居移动到另一个邻居,同时将目前找到的距离最近的 num_candidates 个向量保留为搜索波束。IVF ,即 bbq_disk 索引类型,会围绕质心对向量进行聚类,每个质心都有一个包含其向量的倒排列表,并扫描距离查询最近的倒排列表;它扫描的 segment 比例,即 访问比例 ,由 num_candidates 和 k 推导得出。HNSW 图和 DiskBBQ 这两篇文章对二者都有深入介绍。
接下来所有内容的关键在于,这两种结构都不是一个覆盖整个索引的单一结构。每个 Lucene segment 都拥有自己的 HNSW 图或自己的一组 IVF 倒排列表,因此 kNN 查询会分别搜索每个 segment 并合并结果,首先在每个 shard 内合并,然后再由协调节点进行合并。因此,搜索在开始探索之前需要准备的任何内容,都需要针对每个 segment 分别准备一次。
现在,让我们在 kNN 查询中添加一个 filter:
bash
`
1. POST my-index/_search
2. {
3. "knn": {
4. "field": "embedding",
5. "query_vector": [0.12, -0.03, ...],
6. "k": 10,
7. "num_candidates": 100,
8. "filter": {
9. "term": { "language": "en" }
10. }
11. }
12. }
`AI写代码因为过滤条件位于 knn 子句内部,所以它属于前置过滤:这 10 个结果是在所有匹配 language: en 的文档中距离最近的 10 个文档。为了实现这一点,搜索必须知道它遇到的每个文档是否通过过滤条件。在每个 segment 中,这一过程分为两个步骤。
步骤 1:将过滤条件物化为 bitset
这两种结构都不会按照 doc ID 顺序访问文档。HNSW 遍历会跳转到图中的邻居,而 IVF 会一次扫描一个质心对应的倒排列表,这意味着文档 ID 会按照向量邻近关系所决定的任意顺序到达。搜索需要随时回答 "doc 84,219 是否匹配?" 这样的问题,而过滤条件的常规 DocIdSetIterator(只能向前移动)无法做到这一点。
在搜索开始之前,会在整个 segment 上完整执行过滤条件,并将匹配结果记录到 bitset 中。对于 HNSW,这一过程发生在 Lucene 的 AcceptDocs 中:
ini
`

1.  // org.apache.lucene.search.AcceptDocs
2.  private void createBitSetAcceptDocsIfNecessary() throws IOException {
3.    if (acceptBitSet == null) {
4.      acceptBitSet = Objects.requireNonNull(createBitSet(iterator(), liveDocs, maxDoc));
5.      cardinality = acceptBitSet.cardinality();
6.    }
7.  }

`AI写代码
createBitSet 会将过滤条件的迭代器一直遍历到末尾,并根据匹配的文档数量,填充一个大小为 segment 的 maxDoc 的 FixedBitSet,或者填充一个稀疏 bitset。IVF 会执行等价的操作,在扫描第一个倒排列表之前,通过 Elasticsearch 自己的 ESAcceptDocs 完成这一过程。无论哪种方式,其成本都取决于 segment 的大小以及计算过滤条件的开销,而不是取决于搜索随后会访问 segment 的多少内容。
步骤 2:跳过未通过过滤条件的文档
未通过过滤条件的文档不会计入结果。搜索必须访问 segment 中更多的内容,以收集足够多的通过过滤条件的文档:HNSW 会进一步遍历图,而 IVF 会额外扫描几个倒排列表。两者都会对这一过程进行限制。例如,HNSW 会在访问的向量数量达到过滤条件匹配的文档数量后停止遍历图,并直接对匹配的文档进行评分。对于匹配数据集大部分内容的过滤条件而言,额外工作量很小,下一节中的 profile 就展示了这一点。
结论是:过滤条件导致的额外搜索工作是有界的,而且很少是过滤查询耗时的主要来源。步骤 1 中的物化过程则没有这样的界限。这就是为什么真正值得关注的情况不是限制性很强的过滤条件,而是宽泛的过滤条件,例如匹配数据集 90% 的内容。它几乎不会剪枝,也不会增加多少搜索工作,但仍然需要在每个 segment 中完整地执行物化,付出全部成本。
为什么经过过滤的 kNN 搜索可能比未经过滤的搜索更慢
搜索 profile 会直接展示这一成本,不过它可能并不在你第一时间想到的位置。
Lucene 的 kNN 查询几乎所有工作都在 rewrite 中完成。对于 HNSW,AbstractKnnVectorQuery#rewrite 会物化过滤条件、搜索每个 segment、合并各个 segment 的结果,并返回一个包含最终文档 ID 和分数的 DocAndScoreQuery。IVF 执行相同的操作,并返回 Elasticsearch 的 KnnScoreDocQuery。等到查询以通常意义上的方式执行时,搜索已经结束,剩下的只是返回一个预先计算好的命中列表。
顶层 knn 子句会在 DFS 阶段运行,因此它的 profile 会出现在 profile.shards[].dfs.knn[] 下。下面是一个未经过滤的搜索,使用 k: 10 和 num_candidates: 100,针对包含 100 万个向量的单个 HNSW segment 执行,其中每项明细都经过精简,只保留非零项:
bash
`
1. {
2. "dfs": {
3. "knn": [
4. {
5. "vector_operations_count": 2378,
6. "query": [
7. {
8. "type": "DocAndScoreQuery",
9. "description": "DocAndScoreQuery[177025,...][0.7580181,...],0.7580181",
10. "time_in_nanos": 5708,
11. "breakdown": {
12. "create_weight": 1250,
13. "build_scorer": 2583,
14. "next_doc": 1041,
15. "score": 834,
16. ...
17. }
18. }
19. ],
20. "rewrite_time": 5158917,
21. "collector": [...]
22. }
23. ]
24. }
25. }
`AI写代码rewrite_time 为 5.2 毫秒,这就是 kNN 搜索的耗时。DocAndScoreQuery 项耗时不到 6 微秒:它只负责返回这 10 个命中结果。
现在添加一个匹配 90% 文档的 match_phrase 过滤条件。在实际应用中,一个几乎匹配整个数据集的短语并不是常见的过滤条件,但它可以清晰地隔离出其中的影响:它几乎不会缩小搜索范围,却需要较高的计算成本。大多数实际中匹配范围如此广泛的过滤条件,其成本都介于这个过滤条件和我们下面进行比较的 term 过滤条件之间。
swift
`
1. {
2. "dfs": {
3. "knn": [
4. {
5. "vector_operations_count": 2682,
6. "query": [
7. {
8. "type": "CachingEnableFilterQuery",
9. "description": "(ConstantScore(body:\"red fox\"))^0.0",
10. "time_in_nanos": 33595666,
11. "breakdown": {
12. "create_weight": 9125,
13. "build_scorer": 174083,
14. "next_doc": 15708,
15. "into_bit_set": 33396750,
16. "into_bit_set_count": 1,
17. ...
18. },
19. "children": [
20. {
21. "type": "PhraseQuery",
22. "description": "body:\"red fox\"",
23. "time_in_nanos": 33589916,
24. "breakdown": {...}
25. }
26. ]
27. },
28. {
29. "type": "DocAndScoreQuery",
30. "description": "DocAndScoreQuery[163399,...][0.7200494,...],0.7580181",
31. "time_in_nanos": 4092,
32. "breakdown": {...}
33. }
34. ],
35. "rewrite_time": 40076834,
36. "collector": [...]
37. }
38. ]
39. }
40. }
`AI写代码发生了三件事:
-
过滤条件有了自己的条目 ,与
DocAndScoreQuery并列,而不是位于其中,因为它会在 kNN 查询的 rewrite 阶段运行。CachingEnableFilterQuery是 Elasticsearch 放在 kNN 过滤条件外面的包装器,用于确保查询缓存始终认为这些过滤条件值得缓存;你编写的查询就是它的子查询。在bbq_disk字段上,条目名称有所不同,但过滤条件的显示方式相同。 -
into_bit_set就是步骤 1 中的物化过程 :通过一次调用在整个 segment 上运行短语查询,并将每个匹配项记录到 bitset 中。这耗时 33.4 毫秒。这段时间包含在rewrite_time中,而不是在其基础上额外增加;rewrite_time从 5.2 毫秒增加到 40.1 毫秒,其中过滤条件占据了差值中的 33.6 毫秒。(匹配少于约 1/128 文档的过滤条件会改为逐个文档收集到稀疏 bitset 中,因此其成本会显示在next_doc下。) -
vector_operations_count几乎没有变化。它增加了 13%,这大致符合预期,因为每 10 个被访问的文档中有 1 个未通过过滤条件。
这个查询超过 80% 的耗时都花在了计算过滤条件上。阅读这类 profile 时需要注意一点:profile 会绕过查询缓存,因此即使未进行 profile 的请求可以从缓存中找到某个过滤条件,profile 也始终显示该过滤条件未缓存时的成本。
kNN 过滤成本:物化与额外搜索工作
这两个 profile 之间的差异由两项成本构成,值得将它们分开,因为它们的增长方式不同。
过滤条件物化是每个 segment 都必须付出的成本,与 segment 大小成正比,并且发生在任何向量处理之前。它的成本完全取决于查询类型:
| 过滤条件 | 物化成本 |
|---|---|
term on a keyword |
低 ------ 读取一个倒排列表,以批量方式执行 intoBitSet |
range on a numeric or date field |
通常较低 ------ 遍历 points(BKD)索引;只有单独使用 doc values 的字段(index: false)才需要检查每个文档 |
match_phrase |
对每个包含这些词项的文档进行位置解码和交集运算;成本最高 |
bool of several clauses |
每个子句的成本,加上合取/析取操作的额外处理 |
| Cached filter | 命中缓存时几乎没有成本,缓存未命中时则需要付出完整成本 |
在上面这个包含 100 万个文档的 segment 中,一个匹配相同 90% 文档的 term 过滤条件,在 into_bit_set 中的耗时约为 0.3 毫秒,大约比短语过滤条件低 100 倍。而且成本会随着 segment 增大而增长:在下面的基准测试中,一个匹配 1000 万个文档中 90% 的 match_phrase 过滤条件,会使 HNSW 查询耗时从 2.3 毫秒增加到 395 毫秒。
额外搜索工作会在此基础上增加一些成本,但正如我们看到的,它是有界的,而且对于宽泛的过滤条件来说很小:上面的 13%。物化成本占据主导地位,因此,一个使用宽泛且计算成本高的过滤条件的 kNN 搜索,大部分时间可能都花在与向量比较无关的工作上。它最终得到的答案也与未经过滤的结果高度重叠:如果一个过滤条件匹配整个数据集的 90%,并且与查询无关,那么整体上距离最近的 10 个邻居中,大约已经有 9 个通过了过滤条件,而未通过的那些会被排名仅稍微靠后的文档替代。
这就是本文其余部分所要讨论的不对称性。过滤条件的成本取决于需要对多少个文档进行评估,而将过滤条件从向量搜索之前移到之后,会让这个数量发生数量级的变化:
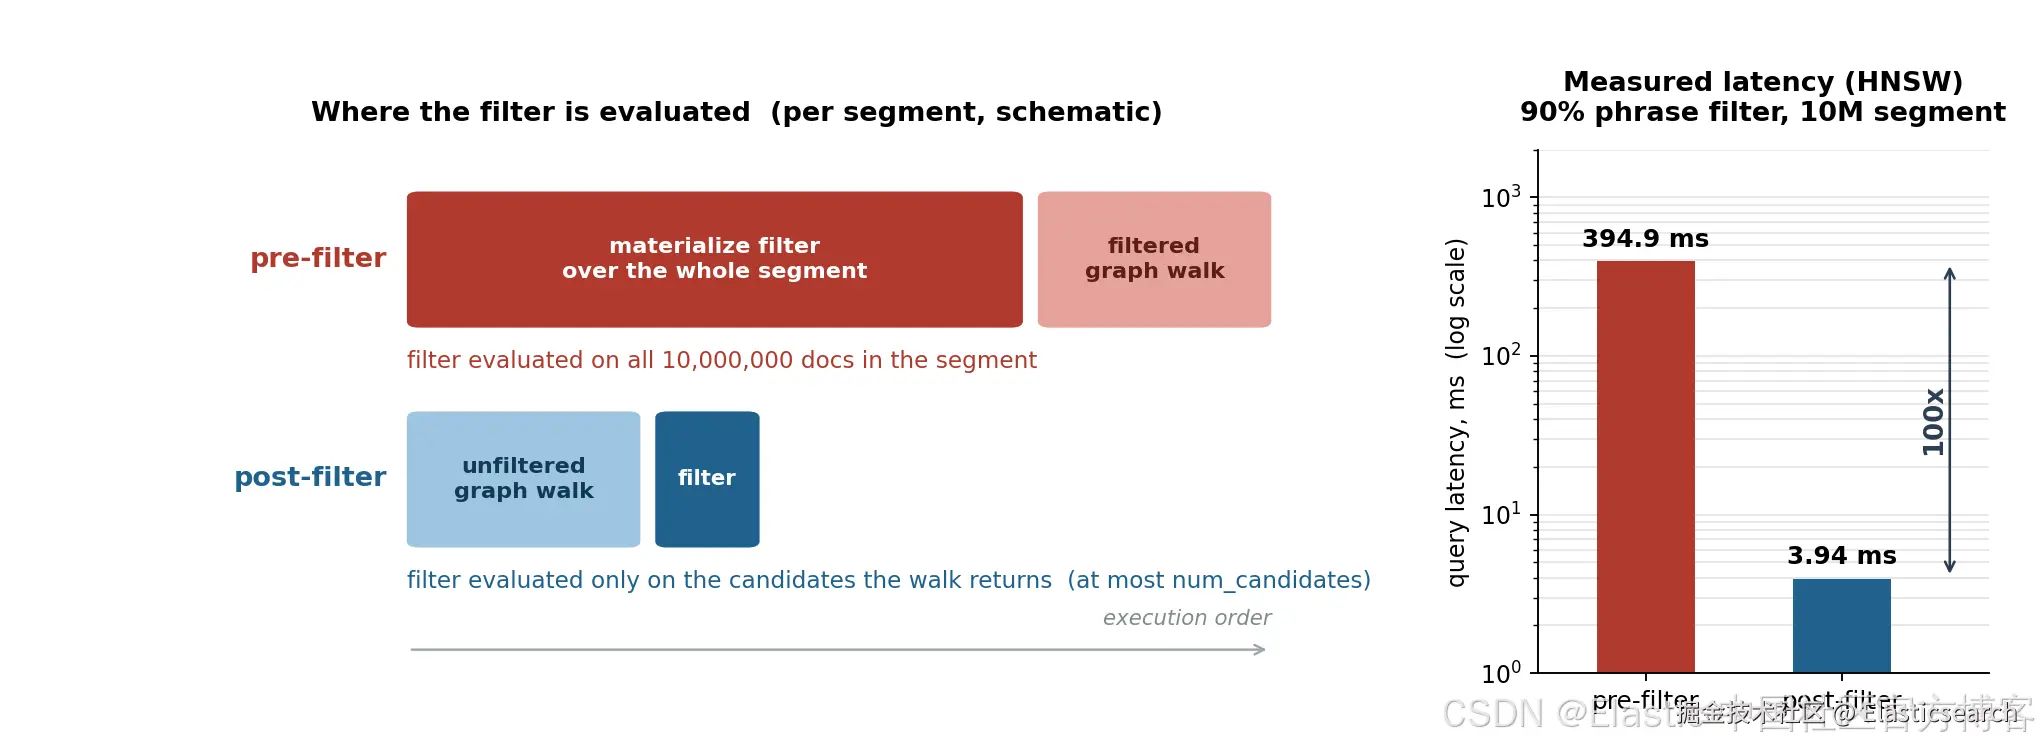 前置过滤会在向量搜索之前,对 segment 中的每个文档执行过滤条件评估;后置过滤则只对向量搜索返回的候选文档执行过滤条件评估。
kNN 搜索中的前置过滤与后置过滤
如果我们直接使用后置过滤呢?这个观察并不新鲜,而且 Elasticsearch 一直都允许你利用这一点。将过滤条件移到 knn 子句_外部_,它就会变成后置过滤 :kNN 搜索不受限制地运行,然后将过滤条件应用于它返回的 k 个结果。
bash
`
1. POST my-index/_search
2. {
3. "query": {
4. "bool": {
5. "filter": { "term": { "language": "en" } },
6. "must": {
7. "knn": {
8. "field": "embedding",
9. "query_vector": [0.12, -0.03, ...],
10. "k": 10,
11. "num_candidates": 100
12. }
13. }
14. }
15. }
16. }
`AI写代码我们在如何选择 Elasticsearch 中的精确 kNN 搜索与近似 kNN 搜索中详细讨论过这种权衡,其中关键问题可以简单概括为:
在 kNN 中使用后置过滤的问题在于,过滤条件是在我们获取 top k 结果之后才应用的。这意味着最终返回的结果可能少于 k 个,因为我们需要从已经从 HNSW 图中检索到的 top k 结果中移除不符合过滤条件的元素。
请求 10 个,返回 6 个。或者 2 个。或者 0 个。向量搜索不知道过滤条件的存在,因此无法保证它返回的结果中有 10 个能够通过过滤条件。唯一可用的补救方法是手动进行过量收集:请求 k: 50,然后希望其中有 10 个能够通过过滤条件。这样你就会陷入一个尴尬的境地:
- 你必须猜测这个倍数,而正确的倍数取决于过滤条件对于_当前这个查询_的选择性;而通常情况下,你并不知道这一点。
- 猜得太低,你就会在没有任何提示的情况下返回较短的结果集。猜得太高,你就需要为不必要的搜索付出代价,而这恰恰是你原本想避免的成本。
- 无论哪种情况,
k都不再代表 API 所声明的含义,因此分页、size以及任何下游处理都必须单独进行推理。
因此,这两种方案都不太令人满意。前置过滤是正确的,但可能会出现异常缓慢的情况。后置过滤速度快,但却将统计问题转嫁给了用户,而且仍然无法提供任何保证。
下表比较了这两种方案,以及下一节将介绍的自动后置过滤。
| 前置过滤 | 手动后置过滤 | 自动后置过滤 |
|---|---|---|
| 过滤条件放在哪里 | ||
knn 子句内部 |
knn 子句外部,在 bool 查询中 |
knn 子句内部(不变) |
| 过滤条件在哪些对象上进行评估 | ||
| 每个 segment 中的每个文档 | 向量搜索返回的 k 个结果 |
向量搜索返回的候选项 |
| 返回 k 个结果 | ||
| 是 | 不保证 | 是,如果需要则回退到前置过滤 |
| 谁负责确定候选池大小 | ||
| 不需要 | 你,通过猜测 k 的倍数 |
Elasticsearch,根据过滤条件的估计选择性 |
| 最适合 | ||
| 高选择性的过滤条件 | 可以接受较短结果集的情况 | 宽泛的过滤条件(默认选择性为 0.7 或更高) |
但我们可以做得更好
关键在于,在这两种方案之间进行选择不一定非得由用户决定,而且也不必针对整个索引只做一次决定。Elasticsearch 在 rewrite 阶段会保留过滤条件的 Weight。它可以估算过滤条件的选择性,判断对于_当前查询在当前 shard 上_后置过滤是否值得采用,根据这个估算值而不是猜测来确定过量收集的规模,并在底层保留一个正确性保障机制,这样即使估算不准确,付出的代价也是延迟,而不是结果缺失。
这就是自动后置过滤为 HNSW 和 IVF(bbq_disk)带来的能力。重要的是,这一切都不会改变你编写的查询:你仍然以表达前置过滤的方式编写查询,仍然获得前置过滤的语义,而具体如何满足这一要求则交由搜索引擎决定。
依次包含四个步骤:
-
估算过滤条件的选择性。
-
使用这个估算值确定过量收集的规模。
-
如果结果数量不足,则重试一次。
-
如果仍然不足,则回退到原始查询。
估算 kNN 过滤条件的选择性
首先,我们需要得到一个数字,用来回答 "这个过滤条件允许数据集中的多少内容通过?" 一个成本低廉且效果出乎意料地好的方法,是询问过滤条件自身的 scorer,了解它预计会匹配多少文档,然后除以该字段实际建立索引的向量数量:
java
`
1. public static float computeSelectivity(Weight filterWeight, List<LeafReaderContext> leaves, int totalVectors)
2. throws IOException {
3. long filterCost = 0;
4. for (LeafReaderContext leafCtx : leaves) {
5. ScorerSupplier ss = filterWeight.scorerSupplier(leafCtx);
6. if (ss != null) {
7. filterCost += ss.cost();
8. }
9. }
10. return totalVectors > 0 ? Math.min(1f, (float) filterCost / totalVectors) : 0f;
11. }
`AI写代码有两点使这一过程成本很低。ScorerSupplier#cost() 是一个_估算值_。对于 term 查询来说,它就是倒排列表的长度,这个值可以直接从元数据中读取,因此无需物化任何内容。分母则是来自 codec 的向量数量,而不是 maxDoc,因此,对于只有部分文档包含该字段的情况,这个比例不会受到影响。
有两点使这个估算并不完美,而这两点都会在后续处理中得到解决,而不是假装它们不存在。对于合取查询,cost() 是一个上界,因此选择性可能会被高估。更根本的问题是,选择性是 shard 的一个_全局_属性,而真正重要的是过滤条件在查询向量邻域内的通过率。对于一个与向量内容无关的过滤条件,两者是一致的。对于一个与向量内容存在相关性的过滤条件,两者则可能向任意一个方向产生偏差。
假设 language: en 匹配某个 shard 中 90% 的文档。对于一个英文查询,几乎所有最近邻都是英文文档。因此,本地通过率接近 100%,而全局估算值只是比较保守。对于一个用西班牙语编写的查询,最近邻可能主要来自那 10% 的非英文文档,因此本地通过率可能远低于 90%,即使全局估算值并没有发生变化。下面的重试和回退过程就是为了处理第二种情况。
使用二项式模型确定候选池大小
给定选择性 p,未过滤搜索应该收集多少个原始候选项 m,才能获得至少 k 个通过过滤条件的结果?
最简单的答案是  。这样可以让你_平均_获得
 个通过过滤条件的结果,这意味着大约有一半的情况下结果数量仍然不足。平均值在这里并不是正确的工具:我们需要的是一个高概率保证。
因此,可以将每个候选项建模为以概率 p 独立通过过滤条件。这样, 个候选项中通过过滤条件的结果数量就是一个二项式随机变量:
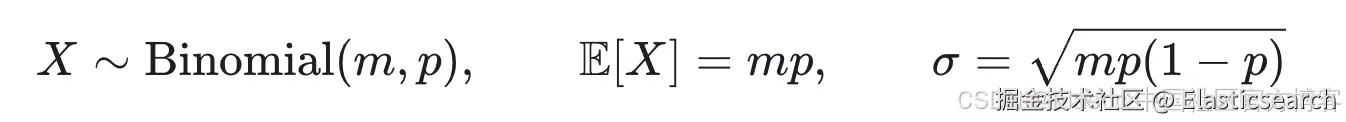
现在,我们不再要求均值等于 k,而是要求 k 位于均值的下方,距离均值为 Z 个标准差:
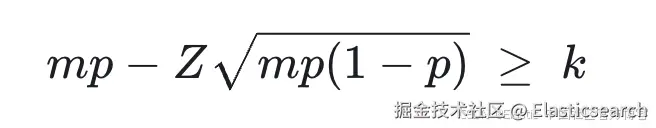
精确地对 m 求解会得到一个二次方程。将 m≈k/p 代入方差项,则可以得到一个封闭形式,其结果略微偏保守,而这正是我们希望出现的误差方向:
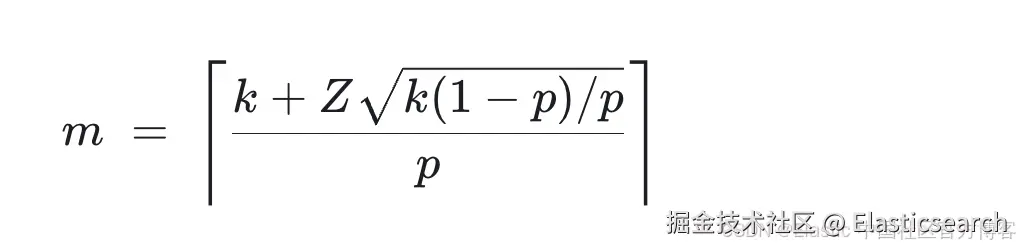
Z 是一个置信度调节参数:第一轮成功的概率约为 Φ(Z)。实现中使用 Z=2.5,也就是约 99.4%。
这里有一个值得明确说明的假设,那就是独立性。我们之所以采用这一假设,是因为在没有任何信号表明过滤条件与向量内容之间存在怎样的相关性的情况下,这是我们_唯一能够_做出的假设。下面的重试和回退过程正是为了覆盖这一假设不成立的情况。
后置过滤会收集多少额外候选项
在代码中,这个公式再加上一些保护措施就是:
c
`
1. /**
2. * Minimum round-1 oversample factor. Round 1 always asks for at least this many ×
3. * the target count, regardless of what the binomial variance formula computes. Active
4. * when selectivity is near 1, where the variance term collapses to ≈ 0.
5. */
6. float POST_FILTER_OVERSAMPLE_FLOOR = 1.2f;
7. float POST_FILTER_OVERSAMPLE_Z_SCORE = 2.5f;
8. static double zMargin(int k, float selectivity) {
9. return POST_FILTER_OVERSAMPLE_Z_SCORE * Math.sqrt(k * (1.0f - selectivity) / selectivity);
10. }
11. static int computeScaledK(int k, float selectivity) {
12. double zMargin = zMargin(k, selectivity);
13. double floor = Math.min(Math.ceil(k * POST_FILTER_OVERSAMPLE_FLOOR), NUM_CANDS_LIMIT);
14. return (int) Math.clamp(Math.ceil((k + zMargin) / selectivity), floor, NUM_CANDS_LIMIT);
15. }
`AI写代码1.2 倍的下限很重要,因为当 p→1 时,方差项会趋近于 0,而公式会恰好返回 k,从而没有为少量_确实会被过滤掉的文档_留下任何余量。NUM_CANDS_LIMIT 上限(10,000)则可以防止过滤条件过于严格时请求一个无限增长的候选池。
对于 k=10 和 Z=2.5,得到的过量收集比例为:
选择性 p |
Zσ 裕量 |
候选项 m |
过量收集 |
|---|---|---|---|
| 0.99 | 0.79 | 12(下限) | 1.2x |
| 0.95 | 1.81 | 13 | 1.3x |
| 0.90 | 2.64 | 15 | 1.5x |
| 0.80 | 3.95 | 18 | 1.8x |
| 0.70 | 5.18 | 22 | 2.2x |
| 0.55 | 7.15 | 32 | 3.2x |
注意,这些数值都相当适中,而且随着 k 增大,相对于 k 的比例会缩小,因为标准差随着 k 增长,而均值也随着 k 增长。在 k=100、p=0.55 时,过量收集比例只有 2.2 倍,而 k=10 时则为 3.2 倍。请求 15 个结果而不是 10 个,与在一个包含 1000 万个文档的 segment 上物化一个昂贵的过滤条件相比,几乎不值一提。
还有一个预算不能与 k 混为一谈,弄错这一点很容易导致搜索参数被意外重新调节。对于 HNSW,num_candidates 是 beam 宽度,是一个独立的调节参数。delegate 会保留用户设置的值,但将其下限设为扩大的 k(如果 beam 比请求的结果数量还窄,就无法返回这些结果):
arduino
`

1.  static int cappedNumCands(int numCands, int scaledK) {
2.      return Math.clamp(numCands, scaledK, NUM_CANDS_LIMIT);
3.  }

`AI写代码
这里有一个值得特别说明的结果:HNSW delegate 返回的候选项数量会多于扩大的 k。每个 segment 的图遍历都会保留完整的 beam(最多 num_candidates 个候选项),并对其中每一个候选项检查过滤条件。在 HNSW 中,扩大的 k 主要在 num_candidates 接近 k 时才真正重要;在通常使用更宽 beam 的情况下,第一轮有足够多的候选项可供选择。
对于 IVF,num_candidates 只有相对于 k 才有意义:codec 根据两者的比例计算访问比例。如果在 k 增大时保持 num_candidates 不变,就会在不知不觉中减少搜索范围,而 IVF 会对其进行缩放,以保持这个比例:
arduino
`

1.  static int numCandsPreservingRatio(int numCands, int k, int newK) {
2.      if (k <= 0) {
3.          return Math.clamp(numCands, newK, NUM_CANDS_LIMIT);
4.      }
5.      long scaled = (long) Math.ceil((double) numCands * newK / k);
6.      return Math.clamp(scaled, newK, NUM_CANDS_LIMIT);
7.  }

`AI写代码
后置过滤结果不足时进行重试
二项式模型的校准目标是约 99.4% 的成功率,而它所依赖的独立性假设可能并不成立。因此,第一轮有时会出现结果不足。重试轮次会将"通常足够"变成"足够"。
只有当结果不足看起来更像是运气不好,而不是模型错误时,才会执行重试。如果第一轮返回的通过过滤条件的结果远少于全局选择性所预测的数量,这就表明过滤条件与查询邻域存在_相关性_;而这正是二项式模型明确无法处理的情况。更多轮次无法修复一个错误的模型,因此我们会提前退出:
ini
`

1.  double expectedHits = k * (double) selectivity;
2.  double threshold = expectedHits * 0.5;
3.  boolean shouldExit = scoreDocsCount < threshold;;

`AI写代码
如果实际通过过滤条件的结果少于预测数量的一半,就意味着过滤条件对这个查询的向量邻域并不友好,此时前置过滤才是正确的工具。对于 k < 5,会跳过这项检查,因为预期结果数量太小,这个比例没有实际意义。
重试并不只是用更大的 k 再运行一次;这样会再次找到相同的候选项。它必须搜索一些_新的_区域,因此需要传递三部分状态:
ini
`

1.  int remaining = expectedBaseQueryDocMatches - scoreDocs.length;
2.  int retryK = PostFilterableKnnQuery.computeScaledK(remaining, selectivity);
3.  Query retry = postFilterQuery.createRetryQuery(searcher.getIndexReader(), excluded, seedDocsPerLeaf, retryK);
4.  TopDocs retryDocs = searcher.search(retry, retryK);

`AI写代码
排除集合。 第一轮中看到的每个文档------无论通过还是未通过过滤条件------都会通过 ExcludeDocsQuery 排除。HNSW 会将它组合到 accept-docs 中;IVF 则将其传递给倒排列表遍历,使 codec 直接跳过这些文档。
种子入口点。 对于 HNSW,如果从顶层重新开始图遍历,就会再次沿着相同的路径向下搜索。因此,重试会从第一轮中距离最近的匹配项开始播种(每个 segment 最多四个),这样它一开始就处于正确的邻域中,然后向外扩展:
ini
`int[][] seedDocsPerLeaf = nearestSeedsPerLeaf(matching, MAX_SEEDS_PER_LEAF);`AI写代码IVF 暂时忽略种子;它已经知道哪些质心距离最近,只需重新扫描这些质心,同时跳过已排除的文档。
重新调整目标数量。 remaining 是_通过过滤条件的结果_中的不足数量。它会再次使用相同的选择性传入 computeScaledK,以针对重试过程中同样会发生的结果损耗进行扩充。
恰好只重试一次。 第二次重试就等于追逐一个模型已经证明错误的分布,而下面的回退机制成本更低,并且能够严格保证正确性。
回退到前置过滤
回退轮次使自动后置过滤可以安全地默认启用。如果后置过滤没有产生完整的候选池,就丢弃它的结果,然后改为运行原始的前置过滤查询。
markdown
`

1.  if (scoreDocs.length < expectedBaseQueryDocMatches) {
2.      logger.debug(
3.          "post filtering retrieved only [{}] results, less than the desired [{}] results. Falling back to original query",
4.          scoreDocs.length,
5.          expectedBaseQueryDocMatches
6.      );
7.      return null;
8.  }

`AI写代码
从 postFilterRewrite 返回 null 会让 rewrite 进入常规路径:
ini
`

1.  Query rewritten = ((Query) innerQuery).rewrite(searcher);
2.  this.totalVectorOps += innerQuery.totalVectorOps();
3.  return rewritten;

`AI写代码
用户的查询就是回退方案。这意味着,错误的选择性估算所带来的最坏情况是_延迟_(浪费了一次候选项收集,然后再执行原本就会执行的前置过滤搜索),而绝不会导致结果集过短或结果错误。正是这一特性使得像 ScorerSupplier#cost() 这样粗略的估算也足够好;它只需要在足够多的情况下估算正确,从而弥补估算错误时所付出的成本。
简而言之,第一轮之后:
-
如果至少有
k个候选项通过过滤条件,则返回距离最近的k个。 -
如果通过过滤条件的候选项少于预期数量的一半(
0.5⋅p⋅k),则提前退出,执行前置过滤查询。 -
否则,重试一次。如果此时至少有
k个候选项通过过滤条件,则返回距离最近的k个;如果仍然不足,则回退到前置过滤查询。
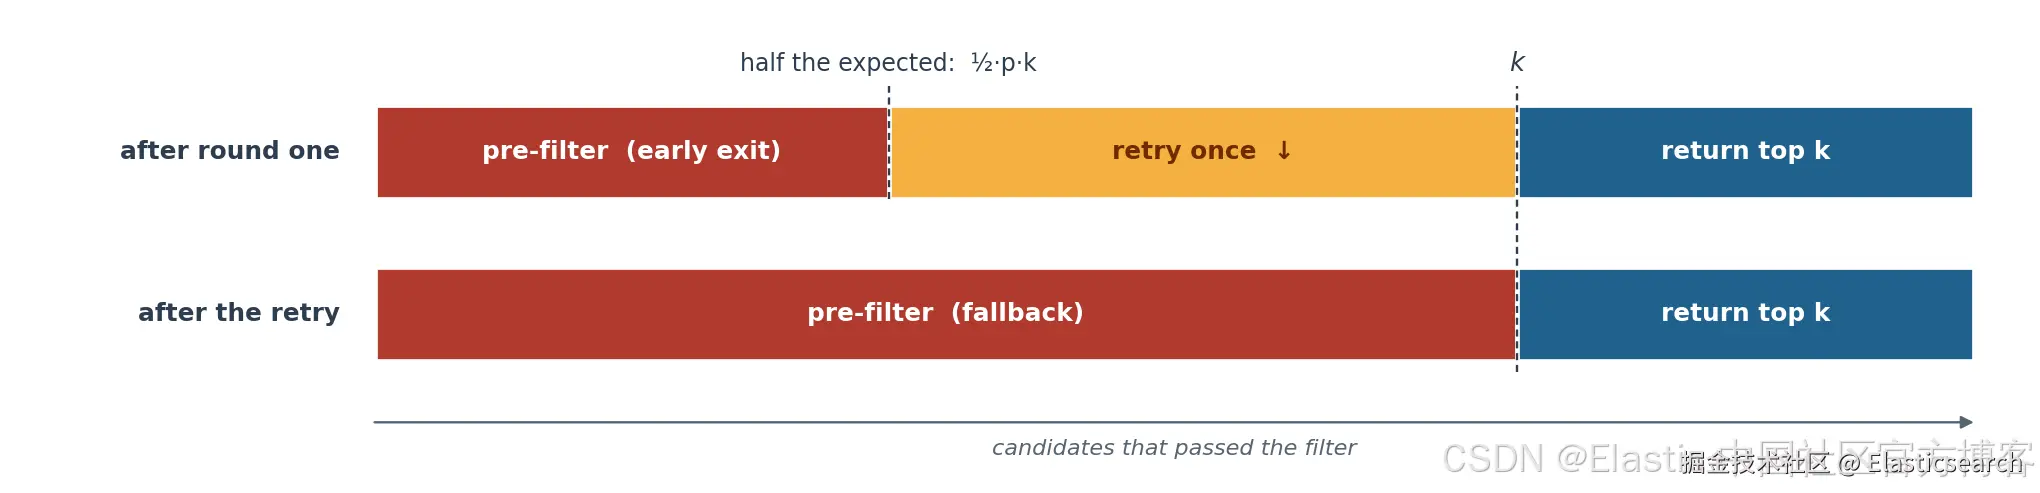 相同的两项检查,每轮一行。所有前置过滤结果都与单独执行前置过滤时完全一致。
还有一个与分数正确性有关的细节值得注意。对于量化字段,近似分数会通过一次精确的重新评分过程进行校正。通常情况下,IVF 会在自己的 rewrite 中完成这一过程,但对于后置过滤 delegate,必须在过滤之后进行,否则我们就会对那些即将被丢弃的文档进行重新评分。delegate 会跳过这一步,而 orchestrator 会在候选池最终确定后,通过 finalizeTopK 回调执行这一过程。如果没有这个钩子,后置过滤的结果会携带原始的量化分数,而回退结果则会携带精确分数,从而在同一次搜索中混用两个不同的分数域。
一个经过过滤的 kNN 查询,从头到尾
假设你在一个包含 1000 万个文档的 shard 上运行以下查询,其中 language: en 能匹配其中 900 万个文档:
json
`

1.  {
2.    "knn": {
3.      "field": "embedding",
4.      "query_vector": [...],
5.      "k": 10,
6.      "num_candidates": 100,
7.      "filter": { "term": { "language": "en" } }
8.    }
9.  }

`AI写代码
1. Rewrite。 PostFilterKnnQuery#rewrite 构建过滤条件的 Weight,并将其与 embedding 上的 FieldExistsQuery 合取,这样没有向量的文档就不会被计入,但不会执行这个过滤条件。
2. 估算。 在各个 segment 上通过 ScorerSupplier#cost() 得到约 900 万,而实际建立索引的向量数量为 1000 万:p=0.9。这高于默认的 0.7 阈值,因此启用后置过滤。(如果结果只有 0.4,我们就会在这里停止,并运行普通的前置过滤查询。)
3. 确定第一轮的规模。 m=⌈(10+2.510⋅0.1/0.9)/0.9⌉=15,因此会构建一个不带过滤条件的 delegate,请求 15 个结果,而不是 10 个。它的搜索预算遵循前面的规则:对于 HNSW,num_candidates 保持为 100,即 beam 宽度;对于 IVF,则将其缩放到 150,这样访问比例就不会发生变化。
4. 执行无过滤搜索。 delegate 在所有 segment 上运行,不使用 accept-docs bitset:不会进行过滤条件物化,也不会进行额外搜索。每个 segment 都会保留自身搜索收集到的所有候选项,因此 orchestrator 无需重新推导这些候选项。对于 HNSW,这是该 segment 的整个 beam,最多 100 个候选项;对于 IVF,则是所请求 15 个结果的一个小倍数,因为 IVF 会进行过量收集,以吸收出现在多个倒排列表中的文档。
5. 将过滤条件应用于候选项,而不是 1000 万个文档。 applyFilter 按 doc-ID 顺序遍历每个 segment 的候选项,并通过 Lucene#asSequentialAccessBits 对它们进行测试。对于暴露 TwoPhaseIterator 的过滤条件,每个候选项只需要执行一次 approximation advance,并且只有当 approximation 命中该候选项时才调用 matches()。这正是整个方案的核心:过滤条件只针对每个候选项进行一次评估,而不是针对 segment 中的每个文档进行评估。
这也意味着,过滤条件不再需要通过缓存来实现快速执行。在前置过滤中,避免每次查询都为物化付出成本的常用方法是使用过滤条件缓存,该缓存会存储过滤条件针对每个 segment 的 bitset,以便重复使用。只有当某个过滤条件被使用足够多次并进入缓存后,这种方式才会有所帮助,而且每个新 segment 都需要从冷缓存开始。后置过滤没有值得缓存的内容:applyFilter 会告诉过滤条件它只需要面对少量候选项,而 Lucene 的查询缓存也不会为一个匹配数百万个文档、但实际上只会检查其中极少一部分的过滤条件创建 bitset。这个过滤条件第一次使用时的速度与第一百次使用时一样快。
6. 检查是否达到目标。 目标是用户请求的 10 个结果。对于一个能够通过 90% 文档的过滤条件,大约每 10 个候选项中有 9 个能够通过过滤条件,因此跨各个 segment 后,通过的数量远超过 10 个。我们进行去重,并保留距离最近的 10 个。
假设只有 7 个不同的候选项通过了过滤条件,就像之前提到的西班牙语查询那样,当过滤条件与查询存在相关性时就可能发生这种情况。7 高于针对不友好过滤条件的阈值(10×0.9×0.5=4.5),因此会触发重试:排除之前已经看到的每个候选项,无论它是否通过过滤条件;从每个 segment 中距离最近的、最多 4 个通过过滤条件的候选项开始播种;然后请求 computeScaledK(3, 0.9) = 5 个额外结果,以弥补 3 个结果的不足。如果这样仍然无法达到 10 个结果,就运行前置过滤查询,此时后置过滤除了候选项收集之外没有产生任何额外成本。
7. Finalize。 通过 introselect 按分数选择 top k,并将结果包装在 KnnScoreDocQuery 中。
过滤条件只在向量搜索返回的候选项上进行评估,而不是在 1000 万个文档上进行评估。向量搜索不受过滤条件限制,并且返回的文档与前置过滤原本会找到的 10 个文档相同;同时还能保证,如果结果不一致,你最终会得到前置过滤查询的结果。
最多 1000 万个向量上的后置过滤与前置过滤基准测试
基准测试设置
为了测量这里的性能上限,我们进行了强制对比:每种配置都运行两次,一次使用前置过滤,一次使用后置过滤,并绕过自适应逻辑,使两种策略都无法回退到另一种策略。这比生产环境中的实际行为更加严苛;真实实现会针对每个查询进行选择并在必要时回退,但这种测试能够清晰展示每种策略在哪些情况下更有优势。
**测试网格:**5 个数据集,从 523K 到 1000 万个向量不等,每个数据集都分别使用 IVF 和 HNSW 建立索引,同时采用单 segment 和多 segment 布局,针对 5 种过滤条件和 7 种选择性,分别运行前置过滤和后置过滤:5 × 2 × 2 × 5 × 7 × 2 = 1400 次测量,也就是 700 组匹配的前置/后置过滤对比。7 种选择性分别为 0.55、0.7、0.8、0.9、0.95、0.99 和 1.0,其中 1.0 表示没有过滤条件。固定使用 num_candidates=1000、k=10、1% 的访问比例、未缓存的过滤条件,以及每个测试点 300 个查询。IVF 使用 clusterSize=384;HNSW 使用 m=16、efConstruction=200;全程使用 1-bit 量化。
过滤条件均未进行缓存。这是前置过滤的冷启动情况:如果过滤条件在多个查询之间重复使用,温热的过滤条件缓存会缩小两者之间的差距。这也是后置过滤唯一会遇到的情况,因为后置过滤从一开始就不会依赖缓存。
并非每个数据集都具有可供 range、term 和 phrase 过滤条件使用的 numeric、keyword 或 text 字段。如果缺少某个字段,我们就添加该字段,并使用随机内容填充。然后对数据集进行采样,选择与目标 D% 文档匹配的过滤值:
-
range是针对 numeric 字段的范围查询,其边界经过选择,使 D% 的文档落在该范围内。 -
term匹配一个 keyword 值,该值存在于 D% 的文档中。 -
phrase是针对 text 字段的短语查询,查询的短语出现在 D% 的文档中。对它进行评估意味着需要检查词项位置,而不仅仅是检查词项是否存在,因此它是这里物化成本最高的过滤条件。 -
range_term在bool查询中组合range和term两个过滤条件。 -
random匹配随机选择的 D% 文档。
不同数据集规模和过滤条件类型下的结果
对于过滤而言,数据集最重要的属性是其大小,因为物化过滤条件所需的时间与每个 segment 中的文档数量成正比。我们使用这 5 个数据集来展示随着数据集规模增长,两种策略之间的差异,并在下面使用最大的 cohere-msmarco-10M 数据集(1000 万个向量、1024 个维度、float32)给出详细数据。
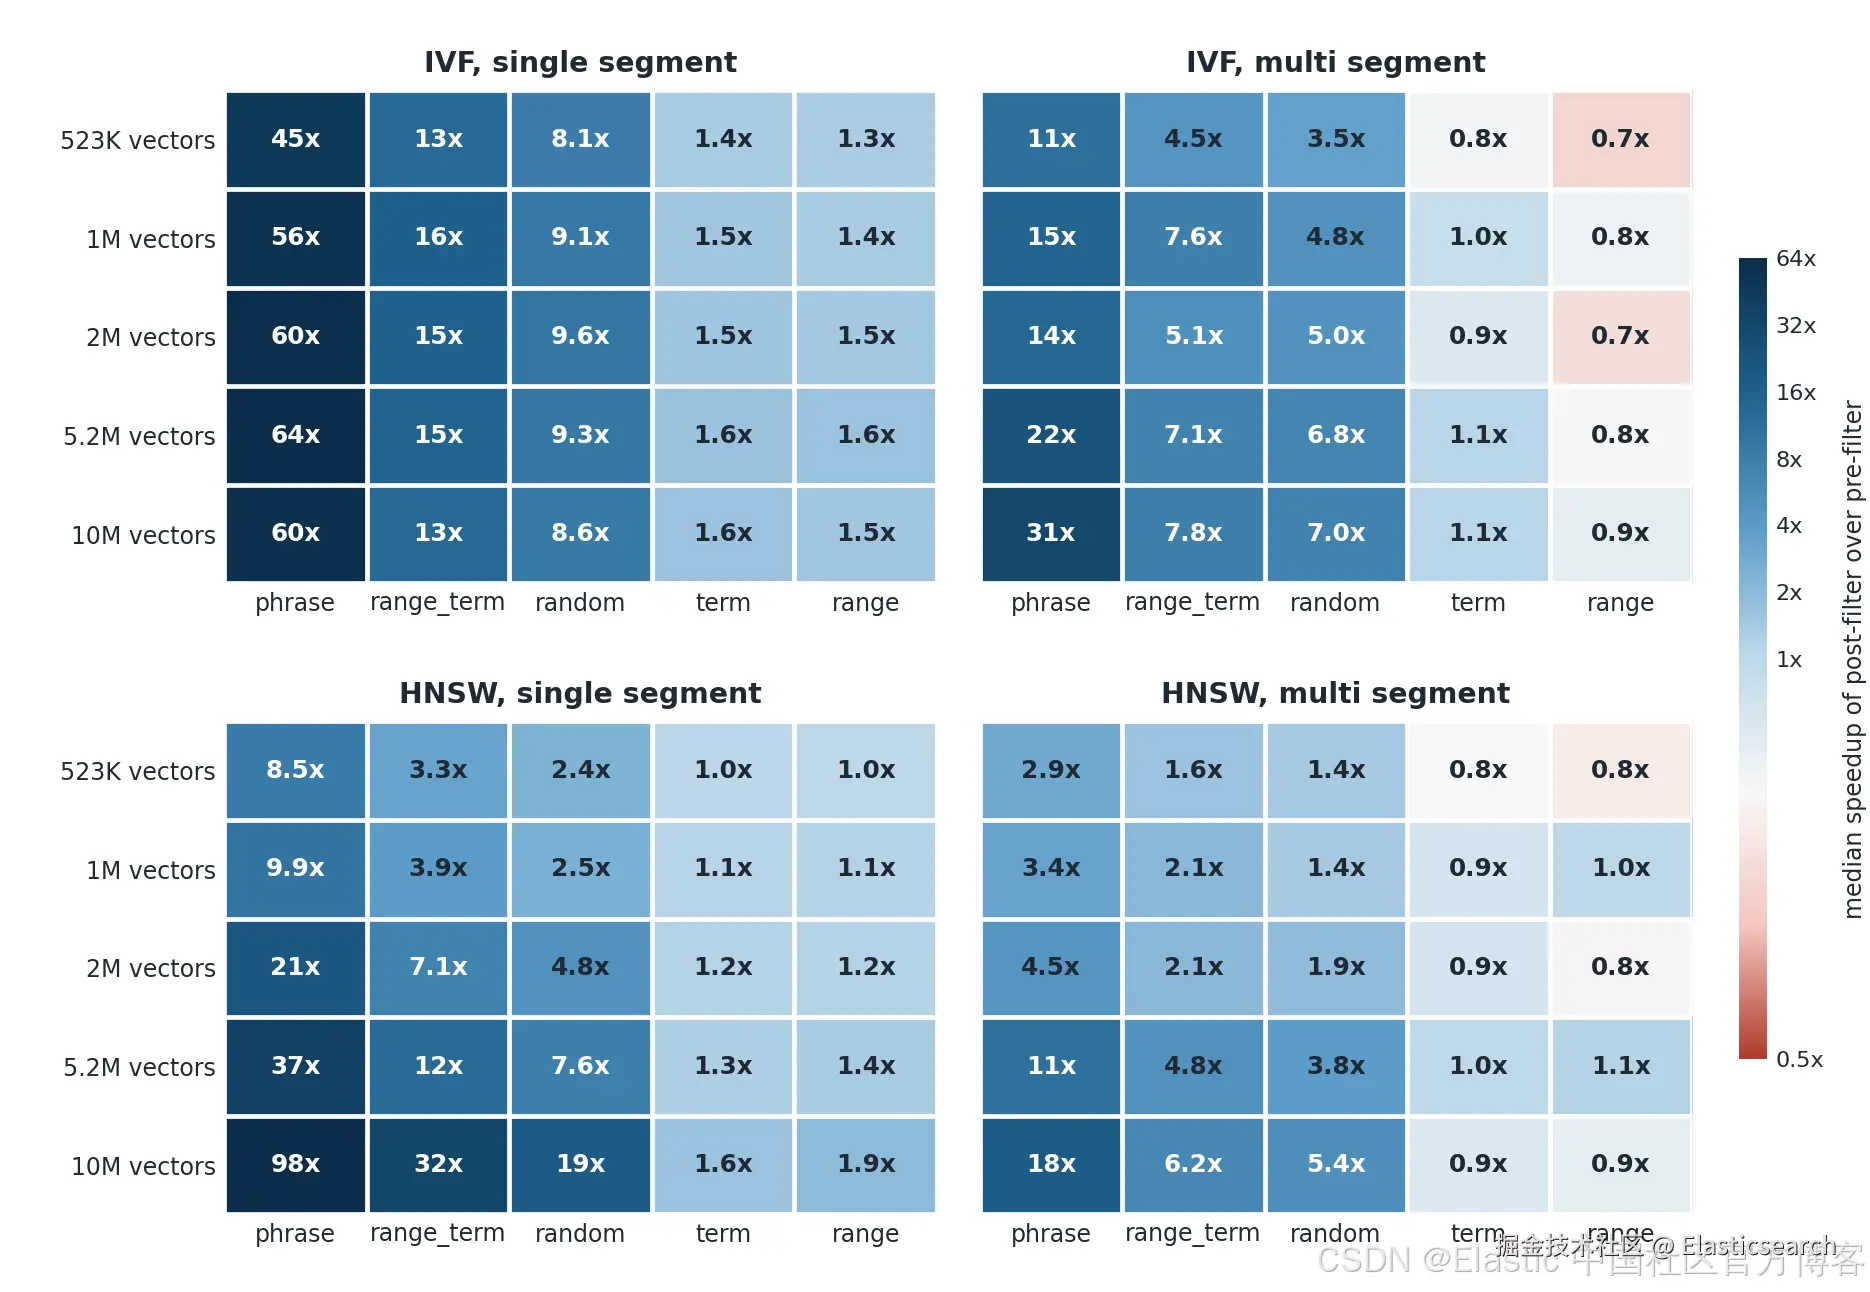 在选择性低于 1.0 的情况下,按数据集规模统计的后置过滤相对于前置过滤的中位速度提升。蓝色表示后置过滤更快,红色表示前置过滤更快。
后置过滤几乎在所有情况下都占据优势:在每一种数据集规模、两种索引类型以及两种布局中都是如此。具体领先多少取决于物化过滤条件的成本,而在大多数布局中,随着数据集规模增长,这一差距也会扩大。在低于 1.0x 的 100 个测试单元中,有 16 个属于多 segment 布局下成本较低的 term 或 range 过滤条件,最低为 0.68x。
在 cohere-msmarco-10M 数据集上,120 组过滤条件对比中有 104 组采用后置过滤时速度更快 ,其中单 segment 上的全部 60 组都是如此,另外还有 2 组基本持平(差异在 2% 以内)。剩余的 14 组是多 segment 布局下成本较低的 range 和 term 过滤条件,其中前置过滤最多只领先 1.33x(1.76 ms 对 2.34 ms)。
延迟与选择性之间的曲线直接展示了其中的机制:
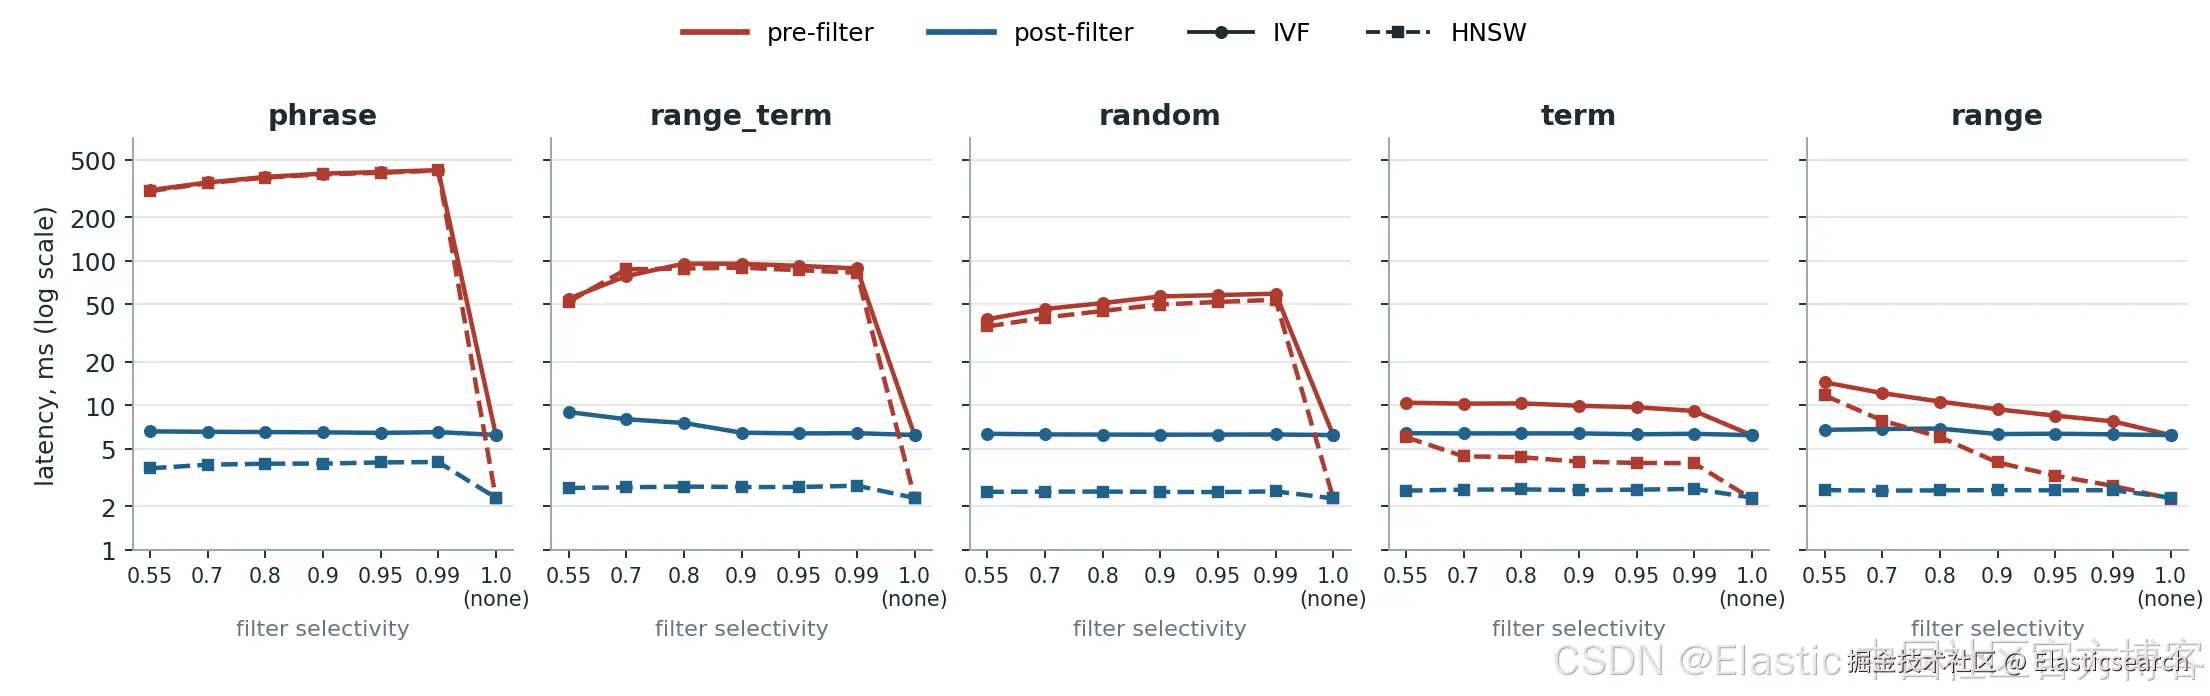 cohere-msmarco-10M 单 segment 上延迟与过滤条件选择性的关系。红色表示前置过滤,蓝色表示后置过滤;实线表示 IVF,虚线表示 HNSW。
蓝色的后置过滤曲线几乎是平的。对于后置过滤而言,延迟主要由 kNN 搜索本身决定,而 kNN 搜索不受过滤条件限制,因此无论过滤条件匹配多少文档,其成本都基本相同。在此基础上,将过滤条件应用于候选项所增加的成本很小,而且即使过滤条件的范围不断缩小,过量收集的规模也仍然很小。对于给定的过滤条件类型而言,延迟几乎不受选择性影响:在中位配置下,从整个 0.55--0.99 范围来看,延迟变化约为 10%,而前置过滤约为 50%。红色的前置过滤曲线位于其上方,差距大致相当于物化过滤条件的成本,也就是说,过滤条件越昂贵,两者之间的差距就越大;当选择性达到 1.0 时,两条曲线最终汇合,因为此时没有需要评估的过滤条件。
召回率基本与策略无关:140 组对比中的每一组,召回率差异都在 0.01 以内,因此这里的权衡实际上纯粹是延迟上的权衡。
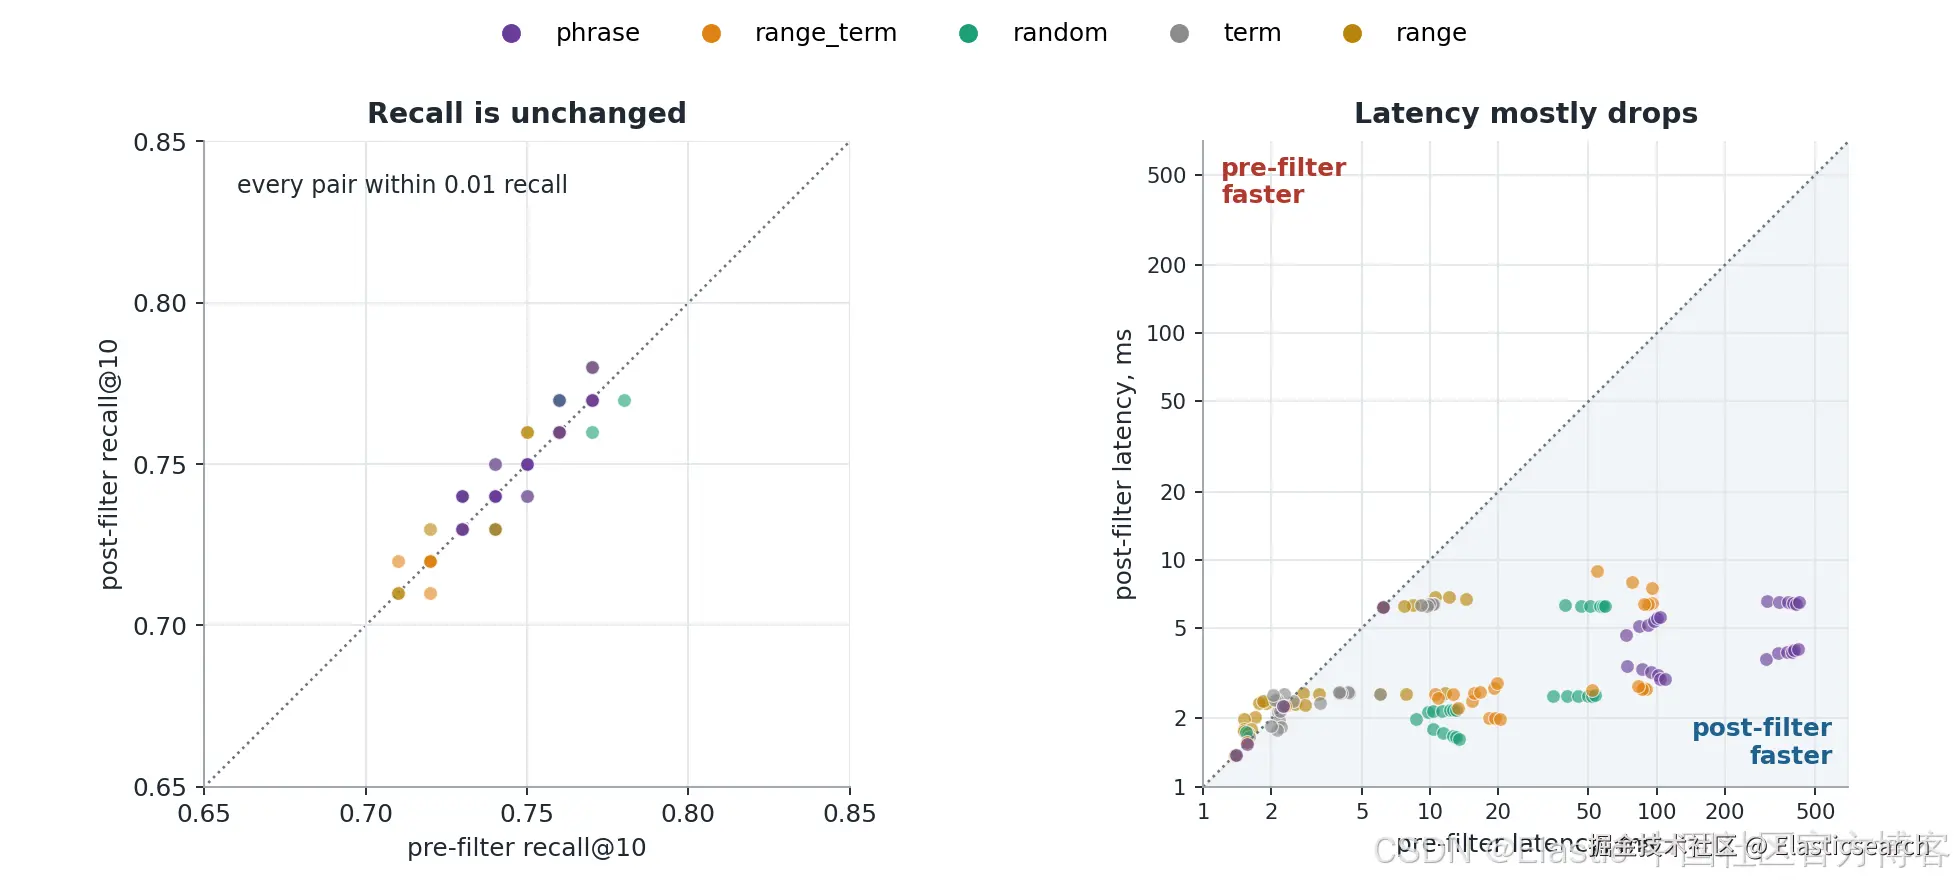 每个点代表 cohere-msmarco-10M 上 140 组前置/后置过滤对比中的一组。左图:召回率。右图:对数尺度下的延迟;位于对角线下方的点表示后置过滤速度更快。
局限性:相关过滤条件与多 segment 布局
有两个注意事项值得明确说明。
**这些过滤条件与向量基本不相关。**基于随机内容构建的过滤条件会独立地通过文档,而不受文档在向量空间中所处位置的影响,这正是二项分布模型所采用的假设。结果也体现了这一点:在任何单一配置中,5 种过滤条件之间的召回率差异最多为 0.04,并且在每种选择性下,中位召回率都在 0.74--0.75 之间。对于相关过滤条件,例如前面提到的 language 示例,重试、提前退出和回退机制会发挥作用,即使选择性估算不准确,也能确保结果正确。衡量这种加速效果有多少能够延伸到高度相关的过滤条件,是下一步很自然的基准测试方向。
**多 segment 布局会缩小后置过滤的优势。**比较热力图中的单 segment 和多 segment 面板。固定的每个 segment 成本需要支付更多次,而前置过滤则可以在每个 segment 较小的 maxDoc 上摊销其 bitset 成本。后置过滤在成本较高的过滤条件上仍然更快,只是领先幅度较小。
如何启用和调整自动后置过滤
自动后置过滤计划在 Elasticsearch 9.6 以及即将发布的 Elastic Cloud Serverless 版本中默认启用 。启用后,你无需修改查询:继续将过滤条件写在 knn 子句内部,每个 shard 都会针对每个查询自行决定是否值得尝试后置过滤。
调整后置过滤选择性阈值
这一决策由一个索引设置 index.dense_vector.post_filter_selectivity_threshold 控制,其默认值为 0.7。当查询的估计选择性大于或等于该阈值时,查询会进入后置过滤流程。因此,该阈值实际上规定了过滤条件必须有多宽泛,才会尝试使用后置过滤:
| 阈值 | 行为 |
|---|---|
1.0 |
关闭。没有任何过滤条件能够满足要求。 |
0.9 |
只有非常宽泛的过滤条件 ------ 匹配 90% 以上数据集的过滤条件 ------ 才会使用后置过滤。 |
0.7 (默认值) |
匹配 70% 以上文档的过滤条件使用后置过滤。 |
0.0 |
每个带过滤条件的 kNN 查询都会尝试使用后置过滤。 |
如果你的过滤条件通常需要较高的评估成本,可以降低该值来针对索引进行调整;也可以将其设置为 1.0,从而完全选择退出。你可以在索引设置中进行配置:
bash
`
1. PUT my-index
2. {
3. "settings": {
4. "index.dense_vector.post_filter_selectivity_threshold": 0.5
5. },
6. "mappings": {
7. "properties": {
8. "embedding": {
9. "type": "dense_vector",
10. "dims": 1024,
11. "index_options": { "type": "bbq_hnsw" }
12. }
13. }
14. }
15. }
`AI写代码范围与局限性
值得了解一下适用范围:
-
同时适用于 HNSW 和
bbq_disk**(IVF)**字段,支持float、bfloat16和byte元素类型,以及 HNSW 上的bit向量。 -
嵌套向量字段也受到支持,但有一个需要注意的地方:由于嵌套 kNN 搜索每个 parent 只保留一个命中结果,因此一个已经产生匹配结果的 parent 会在重试时作为一个_完整块_被排除;而一个 child 只是被过滤掉的 parent 仍然有资格参与重试 ------ 它下面更深层的 child 仍然可能通过过滤条件。
-
**查询语义保持不变。**你仍然编写前置过滤,并获得前置过滤语义。请求体没有任何变化;这纯粹是一个执行策略决策。
-
profile 会显示实际运行的是哪种策略 。当查询使用后置过滤时,过滤条件对应的条目中没有
into_bit_set:过滤条件会逐个候选项进行检查,这意味着它会针对向量搜索返回的每个候选项报告一次advance。在前面的短语过滤示例中,这意味着有 100 次advance调用(beam 中的每个候选项一次),总耗时远低于 1 毫秒,而不是 33.4 ms 的into_bit_set。在向量搜索自身的命中列表旁边,还会出现第二个命中列表条目,其中包含保存最终 topk的KnnScoreDocQuery。如果想查看单次决策(重试、提前退出、回退以及这些决策背后的选择性估算),请将logger.org.elasticsearch.search.vectors.PostFilterKnnQuery: DEBUG设置为DEBUG。
Elasticsearch 中过滤 kNN 搜索的下一步
我们最感兴趣的改进方向包括:
更好的选择性估算。 ScorerSupplier#cost() 不需要额外成本,但比较粗略,而且会高估 conjunction。Elasticsearch 已经在跟踪更丰富的字段统计信息;如果将这些统计信息接入,或者在 segment 的有限范围内对过滤条件进行采样,就可以让阈值不必设置得如此保守。
**提前检测相关性。**针对 hostile filter 的提前退出属于响应式机制:只有在花费一轮搜索发现过滤条件与查询邻域存在相关性之后,我们才知道这一点。如果在做出决策之前,就能估算过滤条件的_局部_通过率(例如根据图遍历的 seed 文档,或者使用缓存的每查询统计信息),就可以将其转变为低成本的前置路由决策,并安全地降低阈值。
**基于成本的路由。**基准测试表明,合适的阈值不仅取决于选择性,也同样取决于过滤条件类型:与 term 过滤条件相比,match_phrase 过滤条件的物化成本高出几个数量级,因此即使在低得多的选择性下,也值得使用后置过滤。基于过滤条件查询结构而不仅仅是选择性建立成本模型,可以让引擎针对每个查询做出这一决策,而不是依赖单个每索引阈值。
**按 segment 做出决策。**目前的路由是在 shard 级别进行的,但不同 segment 之间的选择性和 segment 大小可能有所不同。按 segment 做出决策后,同一个查询中就可以让较小的 segment 使用前置过滤,而较大的 segment 使用后置过滤。
更广泛来说,这一观点并不局限于 kNN。Elasticsearch 已经投入大量工作来提升向量比较的速度(量化、SIMD、更好的 HNSW 图以及更适合磁盘的 IVF 索引),并因此实现了向量比较不再是瓶颈的查询。当一次过滤后的 kNN 搜索大部分时间都花在物化昂贵的过滤条件上时,真正值得进行的优化并不是让距离函数更快,而是意识到:要回答一个关于十个文档的问题,并不需要在 1000 万个文档上运行过滤条件。
常见问题
kNN 搜索中的前置过滤和后置过滤有什么区别?
前置过滤会在向量搜索运行期间应用过滤条件,因此 top k 结果是匹配过滤条件的文档中距离最近的 k 个文档。后置过滤则不受限制地运行向量搜索,然后再对结果应用过滤条件,这样速度更快,但可能返回少于 k 个结果,除非搜索首先过量收集候选项。
为什么过滤后的 kNN 查询有时会比未过滤查询更慢?
前置过滤会在进行任何向量比较之前,为每个 segment 将过滤条件物化为 bitset,而其成本与 segment 大小成正比,而不是与搜索实际访问的文档数量成正比。对于 match_phrase 这样的高成本过滤条件,这项工作可能成为查询的主要成本;即使过滤条件匹配几乎所有文档、因此实际上排除了很少的文档,也必须完整承担这项成本。
原文:Elasticsearch kNN filter: Pre-filtering vs. post-filtering | Elasticsearch Labs