先交代背景,免得后面看不懂。我写了一套脚本用 Chrome 调试协议控制浏览器,专门替我干发文章这种活:开编辑器、填标题摘要、传图、点保存。攒了小半年,越来越长,现在发一篇文章是一条命令的事。
这套东西现在能跑。但我要讲的是它曾经怎么骗我的------一个下午,七次,零报错。
起点:我给一个没跑过的命令标了「已验证」
那天我在传封面。封面那一步要点系统的文件选择框,鼠标键盘够不着,得走调试协议把文件塞进 input[type=file]。
我脚本里有个现成的子命令干这事。几行代码,写的时候顺手,注释里还标着「已验证」。
那天我第一次真正跑它。它报错了。
Could not find node with given id。我回头看代码才明白问题在哪:
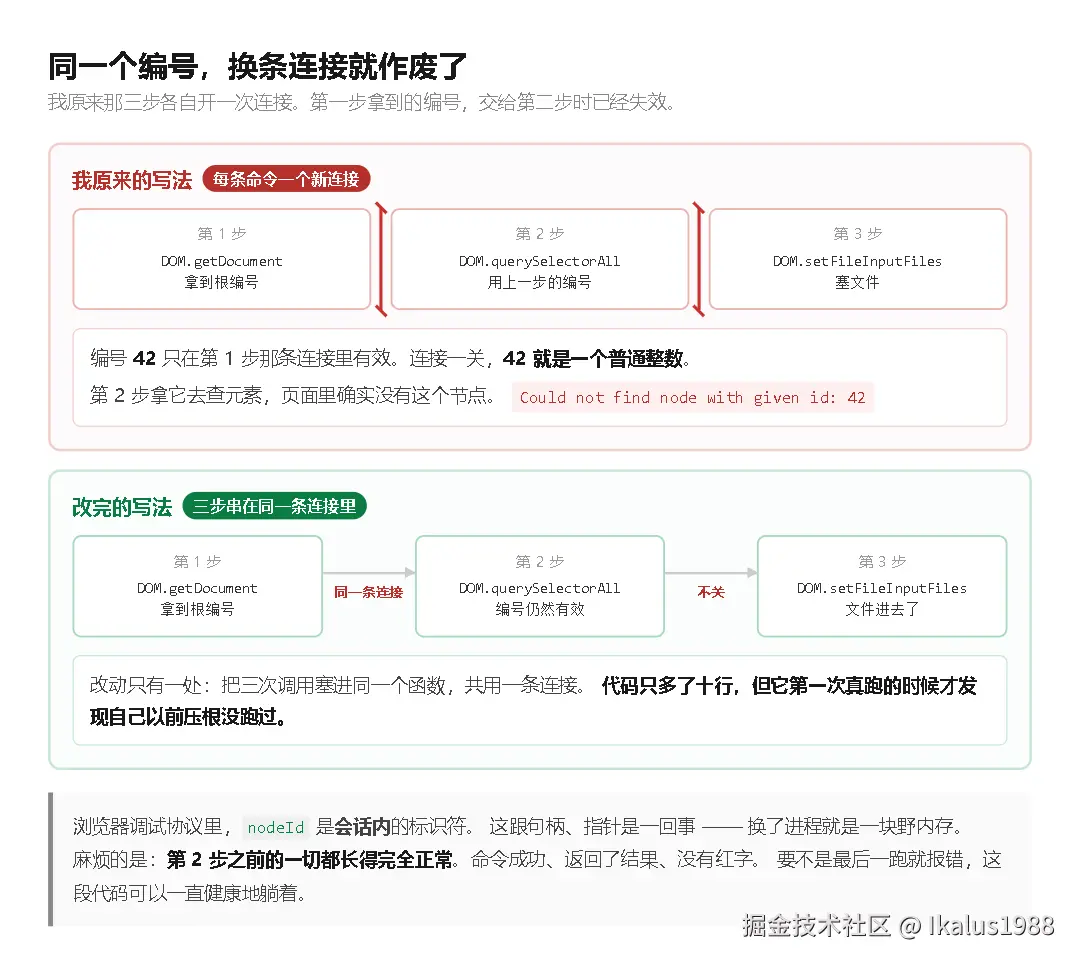
- 这个脚本底层每执行一条命令就新开一个 WebSocket 连接
- 调试协议里定位 DOM 节点的
nodeId是会话内标识符,连接一关就作废 - 我那三步------
DOM.getDocument→DOM.querySelectorAll→DOM.setFileInputFiles------各自开了一个连接 - 所以第一步取到的编号,交给第二步时已经是个死整数
修法是把三步塞进同一个函数共用一条连接。代码多了十行。
让我停了一会儿的不是这个 bug,是另一件事:那个「已验证」,是我自己在同一个下午写上去的,隔了几个小时,它第一次真跑,第一次跑就报错。
为什么没早点发现?因为「上传」这件事我早就在另一条路上验证过无数次------手动点「从图片库选择」,右上角「上传文件」,系统弹框,手动选文件。每次都成。setfile 是我为了省掉那几下点击另外加的。
那条路确实成功。所以我给它盖的章,验的是别的东西。
那天剩下的六次
按「不报错」这个共同点重新排一遍,六次里有三次是我差点做错决定的:
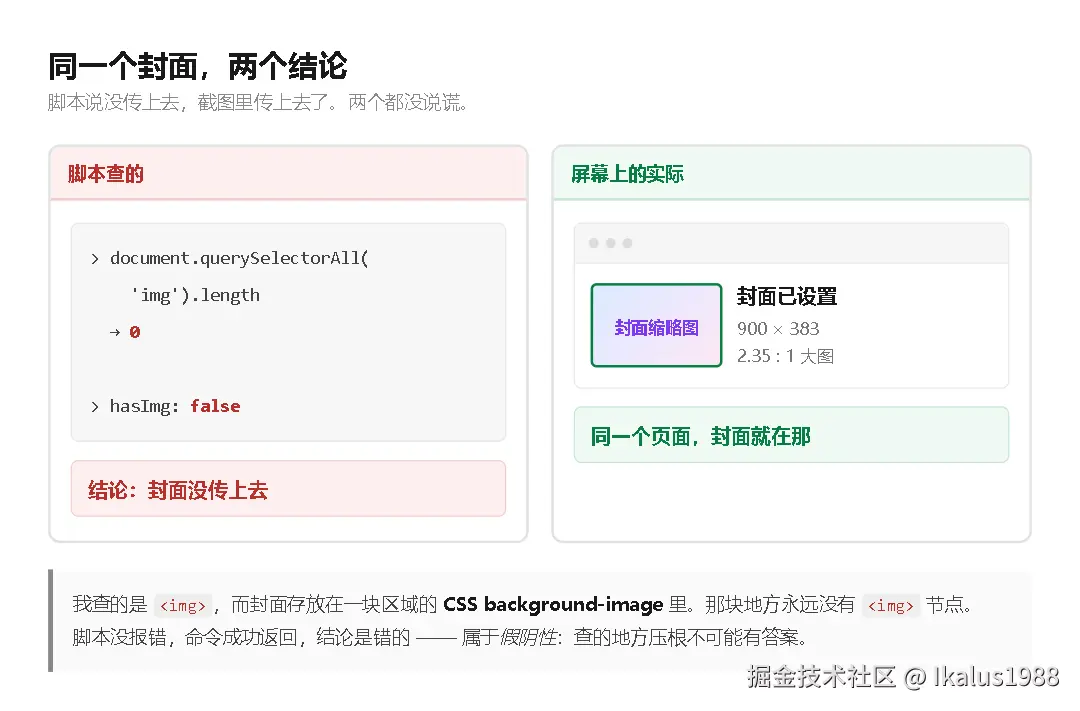
- 封面查不到图。 脚本
hasImg: false,零张<img>。我正打算改数据结构,截图一看封面好好挂着。错在我查了<img>,而封面存在一块区域的 CSSbackground-image里,那儿永远不会有<img>节点。查的地方压根不可能有答案------典型假阴性。 - 摘要两个计数器。 面板显示
52/120,我一看还剩一半富余,准备加两句。真实是118/120,只剩两个字。那个52读的是手机预览 iframe 里的一个候选副本。 - 正文粘进去,手机预览面板完整显示。 段落、配图、标题全在,看着就是成了。实际正文编辑器里是空的。那个面板是预览,它先渲染一份副本给你看。
- 封面弹窗四个按钮
getElementById一个都查不到。 它们是 class 不是 id:js_imagedialog/js_imageScan/js_aiImage全在<a class="pop-opr__button js_imagedialog">上。而且面板里根本没有「上传本地」,本地上传藏在「从图片库选择」→「上传文件」里。 - 改视口尺寸的调试命令返回空对象。
Emulation.setDeviceMetricsOverride回{},看着像成功,其实什么都不干------它绑在连接会话上,我这个脚本每条命令重开会话。 - 最贵的一个:表格在草稿里好好的,发表后变成段落。 两个
<table>在编辑器 DOM 里明明在(tableRows [6,4]),一旦从编辑器发表,公开页就变成一连串<p>,竖线全没了。根因是MediumEditor的 markdown 序列化器不认识表格------你发表那一刻,它拿富文本 DOM 反推mark_content,而掘金公开页是按mark_content渲染的。html_content里好好的<table>根本不参与显示。
由此得出一条推论:任何从编辑器走一遍的内容,表格都活不下来。 所以「API 改好 mark_content 再从编辑器发表」这条路是死的,会再坏一次。我最后把两张表改成无序列表,实测列表能活着穿过序列化器。
后面还有一次,差点更贵
当天晚上我在这台机器的上一级目录 git init 了,不是在项目目录里。
家目录里有什么我大概知道:云厂商的密钥目录、SSH 配置、各家 CLI 存 token 的文件。git init 也确实成功了,它从来不问你要不要。
真正提交之前我才想起这事。那时候还没 commit,风险是零。
我给自己写了一份忽略规则,用的是「先全挡、再放行要提交的那个目录」------后来知道,靠逐条列黑名单是挡不住的,你总会漏一条。仓库根是整个家目录这件事,白名单是唯一靠得住的答案。
然后我装了个专门扫密钥的工具。它在我自己的探针目录里翻出两个文件,里面硬编码了带签名的图片地址,那种地址谁拿到都能用。
那两个文件是我前两天写的探针,作用是把图片塞进编辑器。我写它们的时候只想着「先跑通」,没想过会被谁看到------我以为没人看的东西,和会被提交的东西,在同一个目录。
这七次的共同点
不报错。
真正会报错的东西反而不危险。class 不是 id,一查就知道;端口被占,直接连不上。这些花你五分钟。
真正贵的是那些回了一个成功、结论却是错的:
- 查错了地方,返回空数组,看起来像「确实没有」
- 命令绑在会话上,返回
{},看起来像「执行了」 - 数据在前端好好躺着,落库时被序列化器改掉,前端仍然显示正常
- 「已验证」这三个字,是我给自己盖的,底下什么都没有
一个不会自己叫的坏东西,比一个会叫的坏东西安全得多,也危险得多。
我现在用的笨办法
截图才算数。 页面上看不见的东西我不当它存在。hasImg: false 这种结论必须配一张截图一起看。
从服务端读回来才算数。 编辑器里显示「已保存」不算,重新开一个标签,看服务器到底收没收。
写完一个命令,立刻拿真数据跑一遍。 不用假数据,不用「应该可以」。
这三条都很慢,比以前慢很多。但慢的代价我能看见。
还有第四条我暂时没想明白,可能是:别让自己写的工具成为你最信任的那个。 我对它没有戒心,因为我清楚每一行。这恰恰是问题------陌生工具的毛病我会怀疑,自己写的不会。
顺带记几条给做自动化的
如果你也在写这类脚本,这几处我踩过:
- 调试协议的
nodeId是会话内的,任何依赖上一步结果的多步操作,必须同一条连接 - 判断元素存不存在,先确认「它应该以什么形式存在」再查。查
<img>找不到背景图,这是查错地方不是查错内容 - 页面上的计数器和预览面板可能是副本。要确认写入生效,读服务端或读另一个容器
- 前端编辑器里格式完好不代表落库格式完好,序列化器可能中间改了一刀
- 别切富文本/Markdown 模式。实测切一次会多出一个空壳草稿(新 draft_id、标题空),原草稿正文被清空
关于我:用一套调试协议脚本和一台常驻 Chrome 把发文章变成一条命令的人。写坏过几次,删过两个差点泄露密钥的文件,也发出去过几篇还行的东西。