这篇讲什么 :我们给一个操作手机的 AI Agent 做了一个「记忆层」------它每完成一个任务,就把这次的经验记下来,下次开工时塞进提示词里。问题是:这样真的能少走弯路吗?
答案:一半立住了,另一半还没看到正向证据------而且界线很清楚。
- ✅ 环境事实 ("新建笔记会先弹类型选择框"、"输入框没聚焦时打字静默无效"):任务步数中位数从 41 步降到 21 步,三轮复现方向一致。
- ⏳ 操作技能 ("新建一条闹钟要点哪几个按钮"):自蒸馏的两种形态真实加载过 ,步数没改善;塞进常驻块反而测得 45 步 (比无知识更差)------ 目前拿不到正向证据,不是已被判死。
一句话基调:一个平面立住了(环境事实 −49%),另一个平面还没看到正向证据(操作技能)。后者不是结论,是待验证。
再定性一句 :我们否定的是「自动蒸馏」这个供给方式 ,不是「技能」这个平面 ------ 技能平面保留,改为人工编写。
全文真机(realme RMX3115 / Android 12)。标注含义:✅ 已实测 / ⏳ 还没看到正向证据 / ⚠️ 方向一致但未达显著 / ❌ 未验证。负结果照实写。
一张表看全局
| 知识类型 | 例子 | 供给方式 | 现状 |
|---|---|---|---|
| 环境事实 | "新建笔记会先弹类型选择框"、"输入框没聚焦时打字静默无效" | 模型自动蒸馏 | ✅ 中位 41 → 21 步(p=0.0216) |
| 操作技能 | "新建闹钟的完整点击步骤" | 自动蒸馏(本版起不再产出)→ 改为人工编写 | ⏳ 真实加载过,但还没看到正向证据 |
下面分四部分展开:立住的那半、待验证的那半(含与开源框架的对照)、知识本身的上限、以及我们怎么设计的。
一、有效的一半:把"环境规律"常驻注入
怎么测的
标准做法是两臂对照(另有技能臂与混合臂,见第二节):
- A 臂:不给任何知识
- M 臂:只注入环境事实
执行纪律:两组交错跑(抵消时间漂移)、每轮之前把知识清到该臂基准线(防止上一轮残留污染下一轮)、每轮之后把被测 App 重置。5 轮/组,20 次全部成功。
指标用步数而不是成功率------把步数上限放大到撞不上之后,成功率会饱和到 100%、失去区分度;步数还能反映"知道怎么做"和"执行得干净"之间的差别。
结果
| 臂 | 中位步数 | 均值 | 对比 A 臂 | 判定 |
|---|---|---|---|---|
| A 无知识 | 41 | 43.0 | 基线 | --- |
| M 只注入事实 | 21 | 20.4 | −49% | ✅ p=0.0216 |
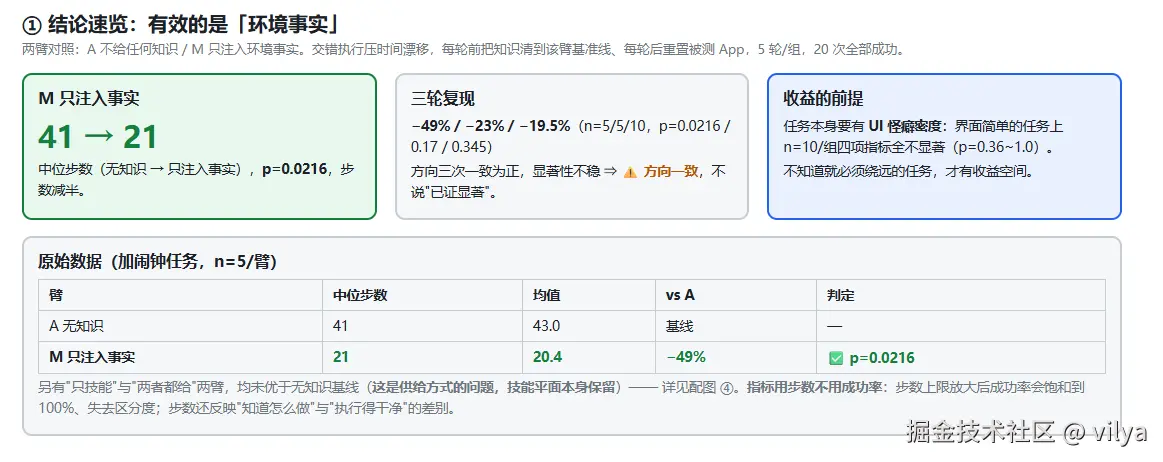
怎么读:知道这个 App 的怪癖之后,Agent 少绕了 20 步,差异在统计上显著。
复现与适用条件
换任务重跑三轮,中位步数的改善分别是 −49% / −23% / −19.5% (p=0.0216 / 0.17 / 0.345)。
怎么读:三轮方向一致为正,但后两轮没达到统计显著。我们标成 ⚠️「方向一致」而不是「已证明」------每轮只有 5 次的小样本给不出稳定显著的结论,但方向不会骗人。
收益有前提:换成界面简单的任务,n=10/组,四项指标全部不显著(p=0.36~1.0)。
怎么读:知识能省下的,是"不知道就必然绕远"的那部分路。任务本身简单时没什么可省,收益就低于噪声。
二、还没看到正向证据的一半:操作技能(一次试过、按止损口径放下的尝试)
这一节是本文的探索部分 :操作技能我们不是没想到,而是自动蒸馏这条路目前拿不到正向证据------并且它和公开研究的观测同向。
我们试了什么
让模型在每次任务成功后,除了事实之外再产出一份「操作技能」,产出两种形态,都走同一套校验(引用的控件必须在轨迹里真出现过、文本脱敏、坐标不许偏离实际点按位置):
| 形态 | 长什么样 | 怎么用 |
|---|---|---|
| 文字操作手册 | 一段引导文字:怎么确认进对界面 → 每一步做什么 → 有哪些坑 → 怎么算成功 | 模型需要时调用 load_skill 取 |
| 步骤序列 | 从执行轨迹自动提炼的点击步骤(脱敏后落盘) | 同上 |
两者都被模型真实加载过(10 次实验里 10 次调用了取技能的指令)。
结果
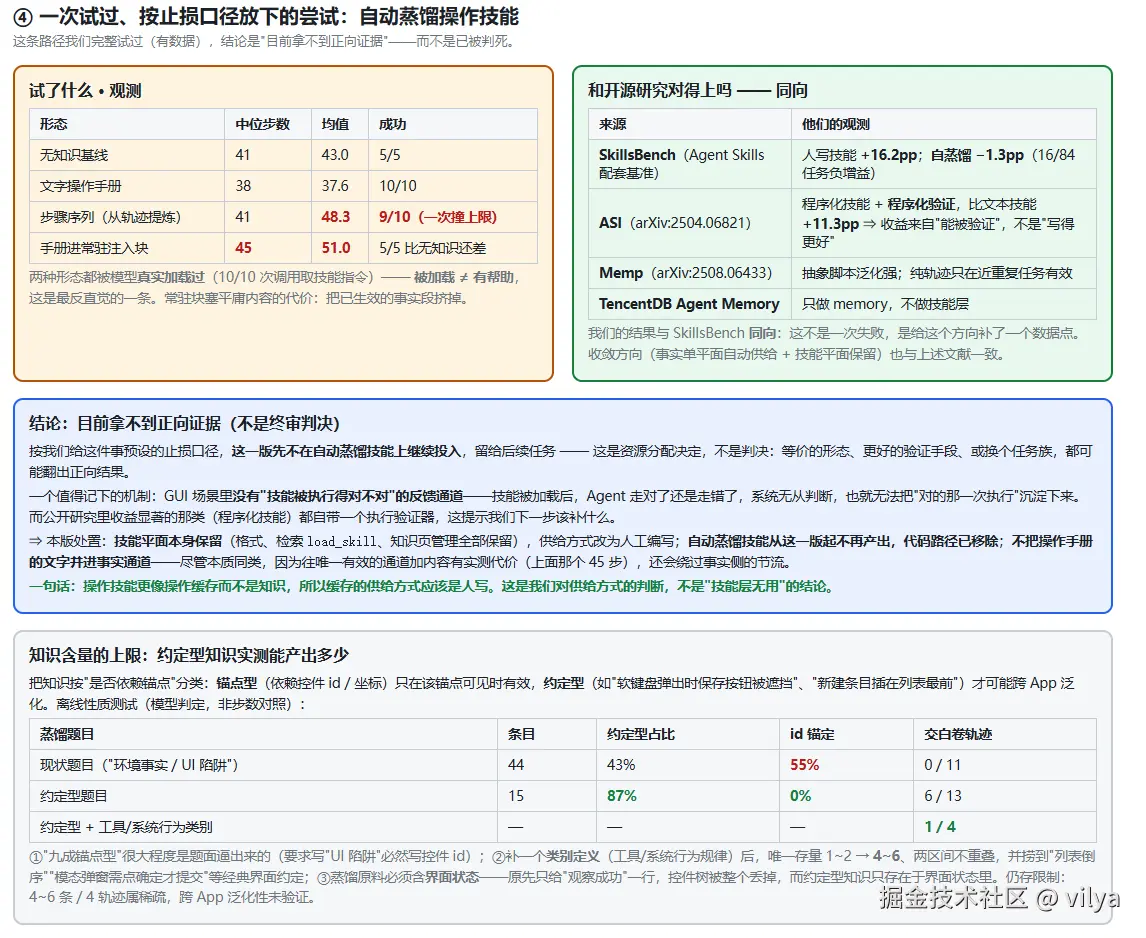
| 形态 | 中位步数 | 均值 | 成功次数 |
|---|---|---|---|
| 文字操作手册 | 38 | 37.6 | 10/10 |
| 步骤序列 | 41 | 48.3 | 9/10(一次撞步数上限) |
怎么读 :两种形态都落在"无知识"基线(41 步)附近,没有可确认的改善。被加载 ≠ 有帮助------这是这次探索最反直觉的一条:模型确实去读了技能,但读完并没有少走路。
还有一个副作用更值得记:把技能手册也放进常驻注入块(每步都重发的那段),中位步数变成 45,比无知识还差。
怎么读:常驻上下文是按步计费的"带宽"。往里塞一段平庸内容,代价是把已经生效的内容挤掉。
和开源研究对得上吗?------对得上
| 来源 | 他们的结论 | 与我们的关系 |
|---|---|---|
| SkillsBench(Agent Skills 规范配套基准) | 人写技能 +16.2pp ;自蒸馏 −1.3pp,84 个任务里 16 个负增益 | 我们的结果与它同向 |
| ASI(arXiv:2504.06821) | 程序化技能 + 程序化验证 ,比"文本技能"高 +11.3pp | 收益来自"能被验证",不是"写得更好" ⇒ 提示我们缺的可能正是验证器 |
| Memp(arXiv:2508.06433) | 抽象脚本泛化强;纯轨迹只在近重复任务上有效 | 解释了为什么技能段进常驻块反而变差 |
| TencentDB Agent Memory | 只做 memory,不做技能层 | 我们的收敛方向与之一致 |
我们的负结果和公开报告同向:SkillsBench 上自蒸馏技能 −1.3pp。所以这不是一次失败,是给这个方向补了一个数据点。
这一路的结论
目前它拿不到正向证据。 按我们给这件事预设的止损口径,这一版先不在自动蒸馏技能上继续投入,留给后续任务------但这是资源分配决定,不是终审判决:等价的形态、更好的验证手段、或者换个任务族,都可能翻出正向结果。
有一个值得记下的机制:GUI 场景里没有"技能被执行得对不对"的反馈通道------技能被加载之后,Agent 走对了还是走错了,系统无从判断,也就无法把"对的那一次执行"沉淀下来。而公开研究里收益显著的那类(程序化技能)都自带一个执行验证器。这解释了 ASI 那个 +11.3pp 的前提,也提示我们下一步该补什么。
所以这一版的处置是:
- 技能平面本身保留(格式、检索、按需加载、知识页管理都保留),供给方式改为人工编写;
- 自动蒸馏技能从这一版起不再产出,代码路径已移除(蒸馏题目不再要求产出技能、晋升链与轨迹校验链一并撤掉);
- 不把操作手册的文字并进事实通道------尽管它们本质同类。因为往唯一有效的通道里加内容有实测代价(就是上面那个 45 步),而且会绕过事实侧现有的节流。
一句话:操作技能更像操作缓存而不是知识 ,所以缓存的供给方式应该是人写。这是我们对供给方式的判断,不是"技能层无用"的结论------它留着一个口子:等有了执行验证通道,或换到有复现可能的场景,这条路可以重新拿出来跑。
三、知识本身有多少:约定型知识的实测
事实通道既然唯一有效,那它能装多少真正有迁移价值的知识?这是个必须实测的问题。
先把知识按"是否依赖界面锚点"分两类:
| 类型 | 定义 | 例子 | 生效条件 |
|---|---|---|---|
| 锚点型 | 依赖具体控件 id 或坐标 | "点某个控件切到文本输入" | 环境提供该锚点时 |
| 约定型 | 不依赖具体控件的行为规律 | "软键盘弹出时保存按钮被遮挡"、"新建条目插在列表最前" | 任何环境 |
只有约定型才可能跨 App 复用。两项离线测试(用模型做判定,不跑步数对照):
测试一 · 换提问方式。 同一批真机轨迹,只改蒸馏时给模型的题目:
| 题目 | 产出条目 | 约定型占比 | 文本锚定 | 控件 id 锚定 | 交白卷的轨迹 |
|---|---|---|---|---|---|
| 现状题目("环境事实 / UI 陷阱") | 44 | 43% | 1 | 55% | 0 / 11 |
| 约定型题目 | 15 | 87% | 1 | 0 | 6 / 13 |
怎么读 :控件 id 占比 55% → 0。之前"库存九成是控件 id 知识"这件事,很大程度是提问方式逼出来的:要求写"UI 陷阱",模型自然去写具体控件。
测试二 · 补一个漏掉的类别。 读真机产物时发现,唯一一条跨 App 的规律(截图因系统服务未启动而失败 → 改用控件树观察)来自工具与系统层,而题目全在讲界面控件。只补一条类别定义("工具/系统行为规律"),措辞一字不动:
| 题目 | 唯一存量(跨轨迹归并后) | 交白卷轨迹 |
|---|---|---|
| 约定型(只给界面形态示例) | 2 / 1(两次运行) | 3/4、3/4 |
| 约定型 + 工具/系统类别 | 4 / 6 / 4(三次运行) | 1/4、1/4、1/4 |
怎么读:三次运行全部高于对照、两个区间不重叠。同一现象的两种抽象层级最能说明问题------
- 对照:「时间选择器弹出后若处于文本输入模式,键入需先点中小时/分钟框才生效」= 界面形态,换个 App 就不成立;
- 补类别后:「文本输入工具 在目标输入框未获焦点时静默无效(不报错也不产生内容) ,必须先点击该输入框使其聚焦」= 工具层,跨 App 成立。
补类别后还捞到了此前四批都没出现的经典界面约定:「新建条目插入列表最前(倒序),而非追加在末尾」「单选项弹窗中选中条目本身不关闭弹窗,必须再点底部『确定』才提交」「系统级对话框『确定』在右下、『取消』在左下」。
两个必须承认的限制:
- 蒸馏原料原来只给了"这一步观察成功",界面状态被整个丢掉了 ------而约定型知识只存在于界面状态里。补上"动作 + 界面状态摘要"(可见文案 / 可点控件 / 焦点控件,不含 id 与坐标)后,上面那些条目才可能出现。
- 4~6 条 / 4 条轨迹仍属稀疏;真正的跨 App 条目集中在工具层,界面层条目多与本批 App 的交互模式相关,跨 App 泛化性未验证。
四、我们怎么设计的
4.1 两个知识平面 + 一层证据
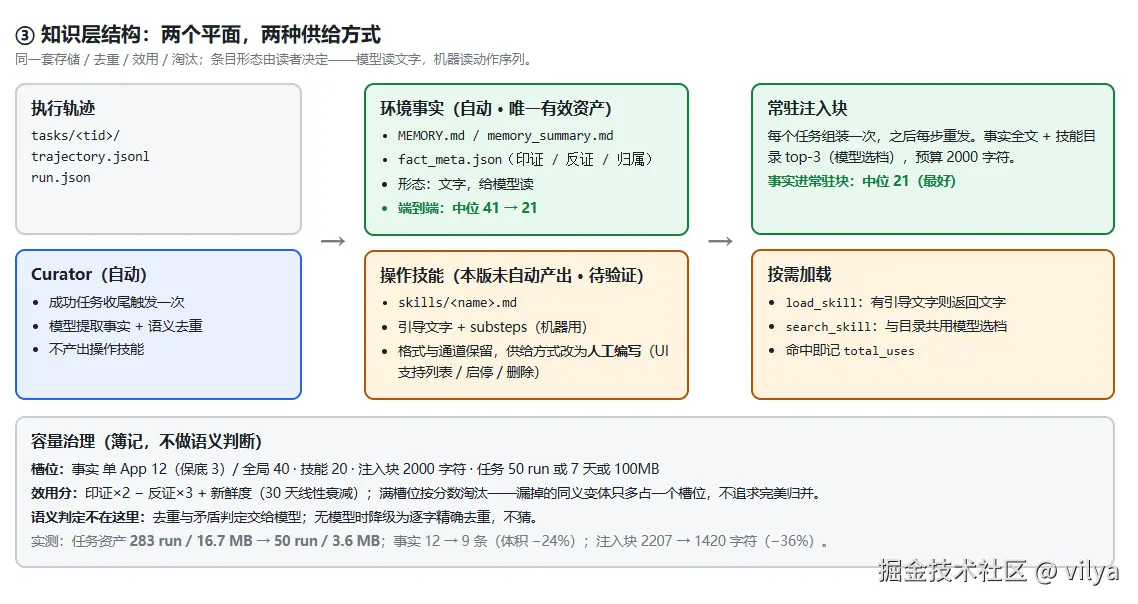
| 平面 | 路径 | 供给方式 | 消费方式 |
|---|---|---|---|
| 环境事实 | memory/MEMORY.md(分区)· memory_summary.md(注入视图)· fact_meta.json(效用索引) |
自动:每次成功任务收尾蒸馏 | 常驻注入(每步重发,预算内全量) |
| 操作技能 | skills/<name>.md |
人工编写(UI 支持列表 / 启停 / 删除) | 按需加载 :search_skill / load_skill |
| 任务证据 | tasks/<tid>/(轨迹 jsonl / run.json) |
运行时 | 蒸馏原料、可选重放 |
读给模型的内容是引导型文字;substeps 这类动作序列读给机器(做身份与校验),不进 prompt。两个平面共用一套治理:去重、效用分、容量淘汰。
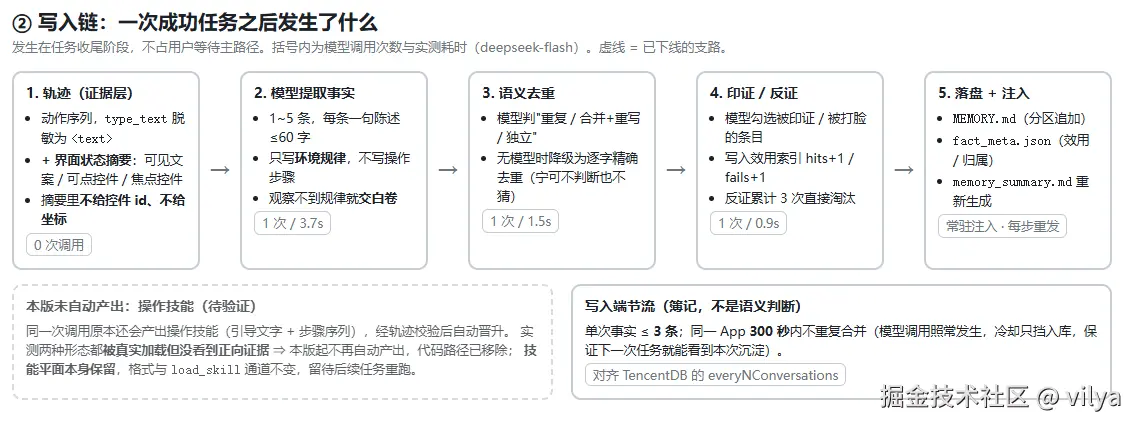
4.2 写入链:一次成功任务之后做什么
arduino
轨迹(脱敏:文本内容 → <text>)
  + 每步的界面状态摘要:可见文案 / 可点控件 / 焦点控件(不给 id、不给坐标)
  ↓ 模型提取事实(1 次调用 / 约 3.7s)
{"facts": ["环境规律 1~5 条"]}
  ↓ 语义去重:模型判"重复 / 合并 / 独立"(1 次 / 约 1.5s)
  ↓ 印证与反证:模型勾选被印证 / 被打脸的条目(1 次 / 约 0.9s)
MEMORY.md 追加 + fact_meta.json 更新 + 注入视图重新生成 → 每步重发进 prompt
三个关键设计点:
- 界面状态摘要不能省(见第三节末)。
- 允许交白卷:题目里明确写"观察不到规律就交空列表,交白卷是正确答案,凑数写出来的假规律是错误答案"。改成"必须产出 N 条"之后,模型在任何轨迹上都能硬凑出 N 条(含撞步数上限的噪声轨迹),其中约 23% 被判定无证据支撑------被配额逼出来的,不是观察到的。
- 写入端节流:单次 ≤3 条;同一 App 300 秒内不重复合并(模型调用照常发生,冷却只挡入库,保证下一次任务就能看到本次沉淀)。
4.3 语义判断全部交给模型,脚本只做簿记
这是最硬的一条约束:同义判断、矛盾判断、印证判断都不写成"自己拍的规则" 。
这不是反对检索------BM25、向量检索仍是主流且可扩展,向量检索本身也是把语义交给模型。区别在于:阈值是在真机上看着几条样本拍出来的,换一批数据就要重调,而且永远调不到位。
| 环节 | 有模型 | 无模型(降级) |
|---|---|---|
| 事实去重(新增 vs 存量) | 判"重复 / 合并+重写 / 独立" | 只做逐字精确去重 |
| 事实去重(存量之间) | 判"删哪些 / 改写成哪句" | 同上 |
| 印证 / 反证 | 勾选被印证 / 被打脸的条目 | 什么都不做 |
| 检索选档 | 模型选相关项 | 保持原序,不做相关性判断 |
降级方向是宁可不判断:两条事实被错并成一条,两边信息都丢了且不容易被发现;留重复交给容量淘汰兜底。
这条约束是被真机数据教出来的------规则路线在同一类错误上失效过多次:阈值式的去重调了三轮仍漏;用"控件名字相同"判技能同一性,结果模型每次命名有出入,同一套路裂成多个档位;"包名或控件出现即印证"的规则命中与真实依赖无关。
4.4 注入与容量
- 常驻注入块 :事实全文 + 技能目录 top-3(模型选档),总预算 2000 字符,每步重发。
- 按需加载 :
load_skill/search_skill由模型按需调用,命中即计数(否则命中率不可观测,淘汰没有输入)。 - 可观测:上报"这次到底注入了哪几条事实"------只有这个能回答"知识到底有没有被送进去"。
| 对象 | 上限 | 治理 |
|---|---|---|
| 事实 单 App / 全局 | 12(保底 3)/ 40 | 效用分排序淘汰 |
| 技能 全局 | 20 | 同上 |
| 注入块 / 记忆视图 | 2000 / 20000 字符 | 硬上限 |
| 轨迹 / 任务 | 30 条 / 50 run・7 天・100 MB | 收尾清理 |
效用分 = 印证次数×2 − 反证次数×3 + 新鲜度(30 天线性衰减) 。反证来自失败任务:按某条事实说的做却没生效,记一次 fail,累计 3 次直接淘汰------记忆会认错,所以必须有反证通道。
容量的理由是效率不是磁盘:注入块每步重发,字节按步计。实际占几个 G 根本不是问题。
实测治理效果:任务资产 283 run / 16.7 MB → 50 run / 3.6 MB;事实 12 → 9 条(体积 −24%);注入块 2207 → 1420 字符(−36%)。
五、几条设计决策及其代价
| 决策 | 依据 | 代价 / 放弃的东西 |
|---|---|---|
| 知识按"是否依赖锚点"分类,而不是按"事实 / 技能"分类 | 2×2 实验:抹掉环境里的控件 id(低带宽)后,知识从少 4.2 步 变成多 5.6 步------方向与预期相反 | 分类不能直接指导产出,得靠题目引导 |
| 事实常驻 、技能按需 | 事实进常驻块 21 步(最好),技能手册进常驻块 45 步(比无知识差) | 每步重发的预算必须设硬上限 |
| 事实条目短、常驻、写成陈述句 | 有效的事实里同样有控件 id 知识(如系统确认按钮 id),照样有效 ⇒ 起作用的是载体不是内容 | 放弃了"沉淀长操作手册"这条路 |
| 允许交白卷,不给产出配额 | 配额会让模型在任何轨迹上硬凑,其中 23% 无证据支撑 | 沉淀量下降,要靠任务质量而非模型努力 |
| 蒸馏题目加入工具/系统行为类别 | 唯一存量 1 |
尚未测"这些知识进注入后是否真的更好用" |
| 语义判断全交模型 | 规则路线反复失效(阈值调三轮仍漏等) | 无模型时知识库退化为"不判断"状态,靠容量淘汰兜底 |
| 技能平面保留,供给方式改为人工维护 | 自动蒸馏技能目前拿不到正向证据(本文第二节),与 SkillsBench 自蒸馏 −1.3pp 同向 | 这一版不再自动产出;留口子------有了执行验证通道或换场景可重跑 |
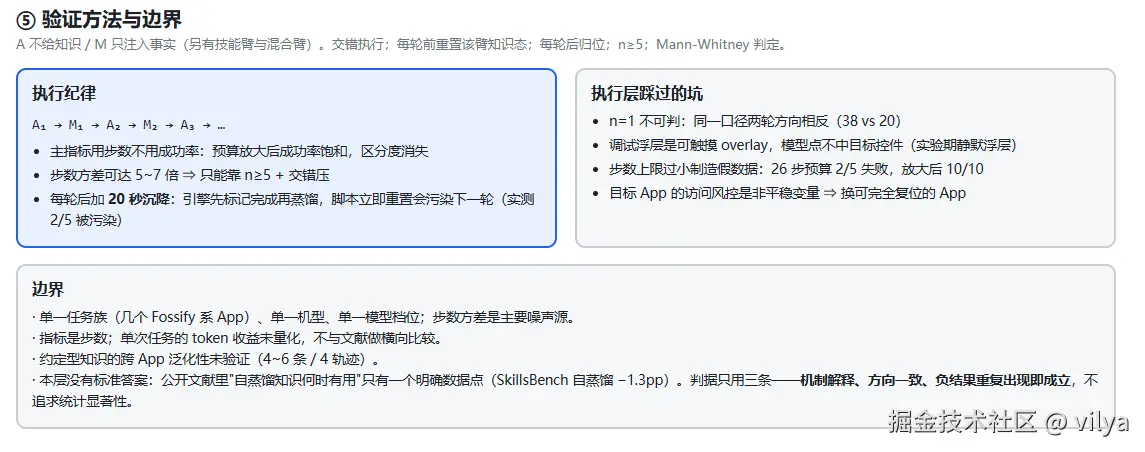
六、边界
-
结论基于单一任务族(几个 Fossify 系 App)、单一机型、单一模型档位。步数的 run 间方差可达 5~7 倍,是所有对照实验的主要噪声源。
-
收益指标是步数;单次任务的 token 收益未量化,与公开研究不同口径,不做横向比较。
-
约定型知识的跨 App 泛化性未验证(4~6 条 / 4 轨迹)。
-
反证淘汰机制目前只有单测覆盖,未在真实失败任务上验证。
-
这一层没有标准答案 。公开文献里"自蒸馏知识何时有用"只有一个明确数据点(SkillsBench 自蒸馏 −1.3pp),所以我们的判据只用三条:机制解释、方向一致、负结果重复出现即成立,不追求统计显著性。
-
两处我们主动停下来的地方(都是资源分配,不是判决):
- 操作技能的自动蒸馏 :这一版不再产出(§2)。同向证据已有(SkillsBench −1.3pp),但我们判断继续投入的边际收益低。留口子:一旦有了执行验证手段,或换到有复现可能的场景,可以重跑。
- 知识层的进一步收缩 :若把"工具/系统行为"类别搬进生产题目后,事实臂相对无知识臂仍看不到明显改善,就把知识层收缩为事实单平面(注入策略与容量治理保留),停止一切知识形态方向的投入。
七、复现工具
| 工具 | 用途 |
|---|---|
harness/experiments/xhs_probe.py |
多臂对照 runner(知识态重置 / App 归位 / 注入块字节 dump) |
harness/experiments/_inject_dump.py |
用内核自己的代码组装注入块,保证看到的就是 prompt 字节 |
harness/experiments/_convention_probe.py |
知识性质测试(换题目 / 补类别;产出性质与唯一存量统计) |
kernel/tests/ · harness/parity/ |
内核单测与双仓等价性测试 |
八、参考与致谢
- TencentDB Agent Memory(MIT):注入端预算化召回、写入端节流、"低层留证据、高层留结构"。未采纳其"存储端默认永不清理"------那是桌面与服务端的成本结构,手机端每步重发整块必须真删。
- SkillsBench / Agent Skills 规范:技能以文档 + 渐进披露提供,模型按需加载。其"人写 vs 自蒸馏"的对照数据是本文第二节的关键参照。
- ASI(arXiv:2504.06821):程序化技能 + 程序化验证的收益量化。
- Memp(ACL 2026 Findings, arXiv:2508.06433):程序性记忆双粒度。分歧点:其动作是文本指令可逐字照做,GUI 动作含坐标与控件 id 组合、每步界面都在变,逐字照做的前提不成立(未验证)。
- Agent Workflow Memory(arXiv:2409.07429):从轨迹归纳自然语言 workflow,选择性注入。
- ExpeL(arXiv:2308.10144):从轨迹抽取"洞察",评估时与成功轨迹一起召回。
- AppAgent:移动端 Agent 的知识形态是每元素文字文档,恰好等于本文"事实"的形态。