GitHub 今日推荐|lipflow:无麦克风唇读文字输入工具
一句话看懂
项目地址:github.com/amywork777/...
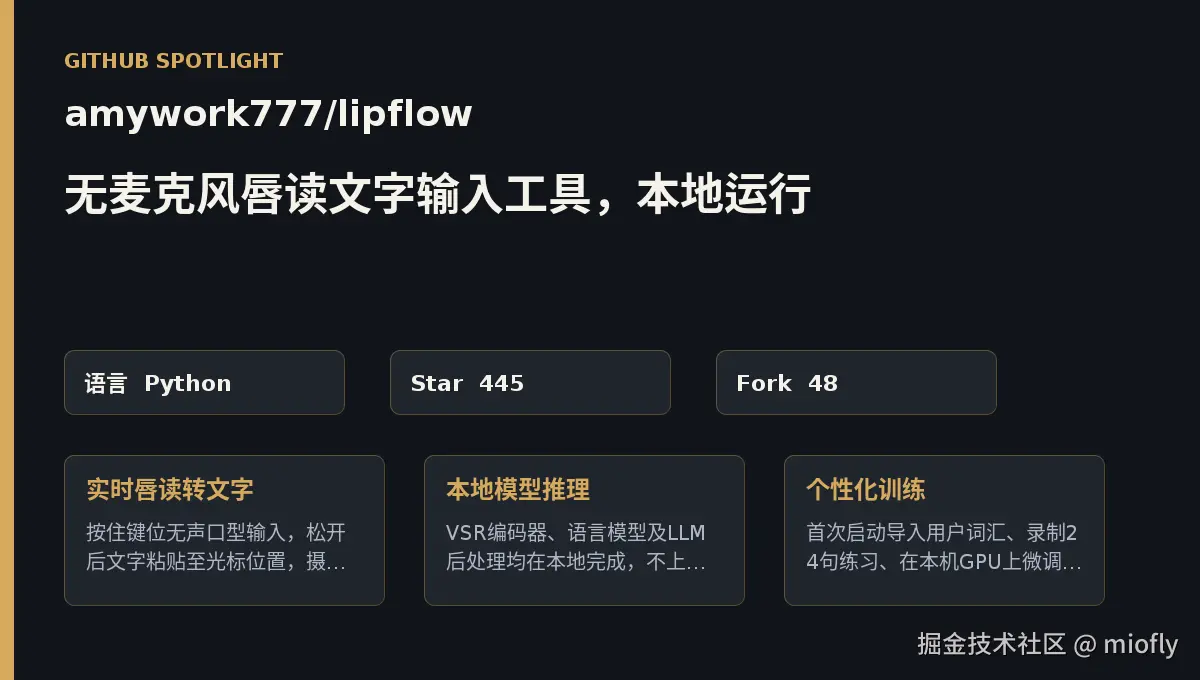
lipflow 是一款本地运行的唇读文字输入工具。按住指定键位、无声做出口型,松开后识别结果自动粘贴到光标位置。所有模型推理在本机完成,不上传视频或文本。支持首次启动时通过 24 句练习适配个人口型,可选语言模型修正同唇音错误。
它解决什么问题
传统语音输入需要发声和麦克风,噪音环境干扰识别、公共场所泄露隐私。lipflow 完全无声、不录音,仅通过摄像头读取口型转文字。适用于会议室安静记录、机场咖啡厅等噪音场所、或需要隐私保护的文字输入场景。macOS 版使用 Apple GPU 加速,M4 Pro 上 9 秒语句编码耗时 0.16 秒,松键到出字约 1-2 秒。
核心概念速览
homophenes(同唇音):指唇形相同但发音不同的音素,例如 p/b/m、f/v。唇读无法从视觉区分这些音,原始输出常出现替换(WALLET OFFICER 实为 while in office)。lipflow 通过语言模型或 LLM 后处理修正。
CTC(Connectionist Temporal Classification):一种序列对齐算法,允许输出序列比输入短。在 lipflow 中,实时预览使用 greedy CTC 每 0.45 秒更新一次,最终解码时 CTC 与 Transformer decoder 联合打分。
beam search:解码时保留多条候选路径求最优序列。lipflow 结合 CTC、语言模型和个人语言模型权重搜索,默认 beam size 10。
push-to-talk:按住说话、松开发送的交互模式。lipflow 按住右 Option(macOS)或右 Ctrl(Windows)录制,双击进入免提 60 秒模式,按 Esc 或其他键取消。
fine-tune:在预训练模型基础上用特定数据继续训练。lipflow 用户练习 24 句后在本机 GPU 上微调 VSR 模型,仅保存变化张量,同时用 Wispr Flow 历史训练个人语言模型,权重 0.2 叠加打分。
架构拆解
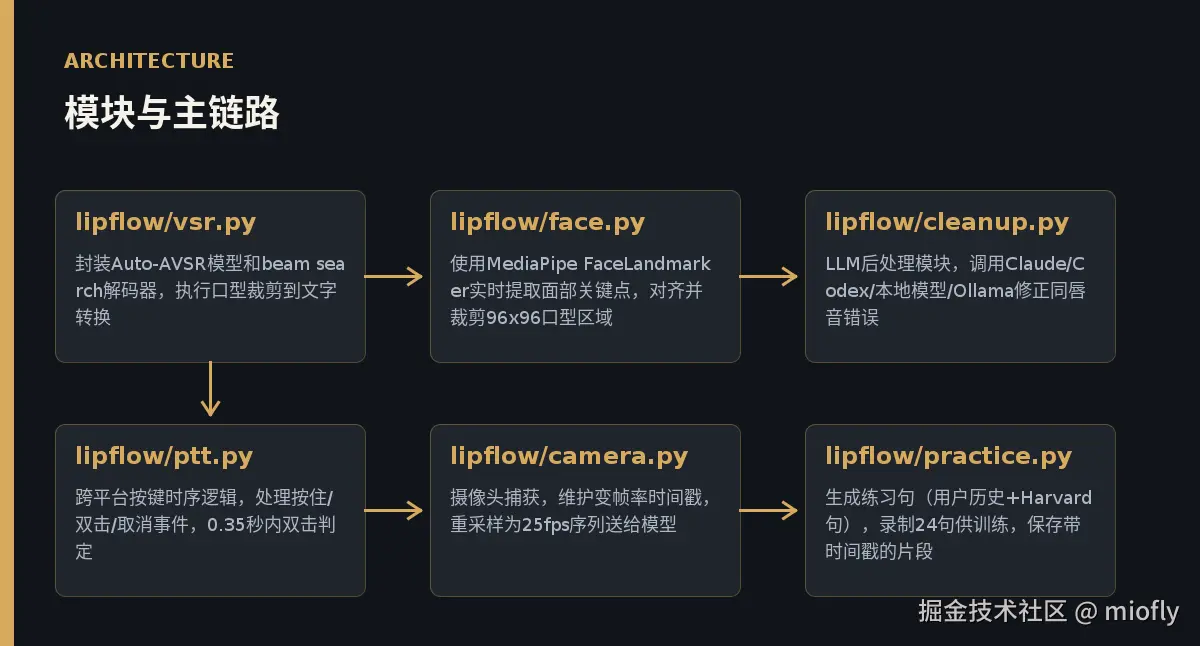
lipflow 分为前端捕获层、视觉处理层、模型推理层和输出层。
前端捕获层 :lipflow/camera.py 从摄像头获取变帧率视频流,记录每帧时间戳。lipflow/ptt.py 监听键盘事件,按下右 Option/右 Ctrl 触发录制,松开后继续录 0.4 秒获取最后一个词的后续帧。
视觉处理层 :lipflow/face.py 使用 MediaPipe FaceLandmarker 提取面部关键点(眼、鼻基、嘴锚点),对齐训练均值脸并裁剪 96x96 灰度口型区域。变帧率序列重采样为 25fps 均匀索引。
模型推理层 :lipflow/vsr.py 封装 Auto-AVSR 模型,口型数组归一化为张量后送入 3D-conv + Conformer 编码器(Apple GPU/CUDA),输出编码张量到 CPU。Transformer decoder + CTC beam search 结合解码器、CTC、语言模型和个人语言模型打分,返回 nbest 候选大写句。
输出层 :lipflow/cleanup.py 调用 Claude/Codex CLI/本地 Qwen3-0.6B(MLX)/Ollama 修正同唇音错误,拼接候选、上下文和用户词汇。lipflow/paste.py 将修正句通过 Quartz 事件(macOS)或模拟 V 键(Windows)粘贴到光标。
训练模块 :lipflow/practice.py 生成练习句(用户历史 + Harvard 句),录制 24 句保存带时间戳片段。lipflow/train_vsr.py 和 lipflow/train_lm.py 分别微调视觉编码器和语言模型,仅保存 delta 权重到 ~/Library/Application Support/Lipflow/。训练过程约 8 分钟,仅在个人模型读取 24 句效果优于基础模型时保留。
关键实现走读
推理入口
python
def read(self, rois: np.ndarray, fast: bool = False) -> tuple[str, float]:
    """Return (UPPERCASE transcript, seconds spent)."""
    t0 = time.time()
    enc = self.encode(rois)
    text = self.greedy(enc) if fast else self.beam_search(enc)
    return text, time.time() - t0
做了什么 :LipReader.read 接收口型数组,调用 encode 编码,根据 fast 参数选择 greedy CTC 或 beam search 解码,返回大写转录和耗时。
为什么这样写:fast 模式用于实时预览(每 0.45 秒),greedy CTC 速度快但准确率低。最终解码用 beam search 结合多个语言模型打分,准确率高但耗时 0.8-1.6 秒(CPU)。
没有它会怎样:无法切换解码策略,实时预览和最终输出必须用同一算法,无法平衡速度和准确率。
按键时序逻辑
python
def key_up(self, now: "float | None" = None):
    if not self.down:
        return
    now = time.time() if now is None else now
    self.down = False
    held = now - self.down_at
    if self.hands_free:
        self.hands_free = self.active = False
        self.on_stop()
    elif held < TAP_MAX:
        if now - self.last_tap < DOUBLE_TAP:
            self.hands_free = True  # second tap: keep listening until the next tap
            self.last_tap = 0.0
            self.on_start(hands_free=True)
        else:
            self.last_tap = now
            self.active = False
            self.on_cancel(silent=True)
    elif self.active:
        self.active = False
        self.on_stop()
做了什么 :PushToTalkState.key_up 处理松键事件。若在免提模式,停止录制。若按住时长小于 TAP_MAX(0.25 秒)判定为短按,距上次 tap 小于 DOUBLE_TAP(0.35 秒)则进入免提模式,否则取消录制。若按住超过 0.25 秒且录制中,停止录制触发推理。
为什么这样写:短按避免误触,双击进入免提模式支持长句输入(最长 60 秒)。按住期间同时按其他键视为快捷键,取消录制避免误粘贴。
没有它会怎样:无法区分短按、长按和双击,误触会触发推理浪费资源,无法支持免提模式。
动手上手
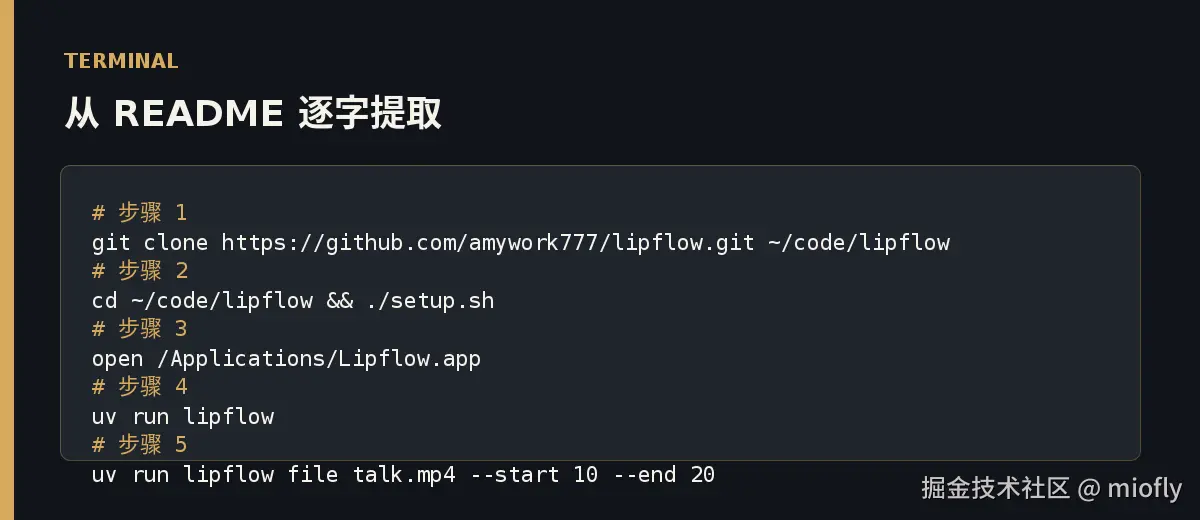
安装步骤
-
克隆仓库到本地:
bash验证:
~/code/lipflow目录存在setup.sh。 -
运行安装脚本:
bashcd ~/code/lipflow && ./setup.sh验证:脚本下载约 2GB 模型文件,终端输出 "Setup complete"。
-
启动应用(macOS):
bashopen /Applications/Lipflow.app验证:弹出摄像头、输入监控和辅助功能权限请求,授予后应用启动。
-
首次训练(可选): 应用启动后提示导入 Wispr Flow 历史或跳过,录制 24 句练习(约 3 分钟),训练 8 分钟,仅在个人模型效果更好时保留。 验证:训练完成后重启,按住右 Option 无声口型输入,松开后文字粘贴到文本编辑器。
命令行模式
bash
uv run lipflow file talk.mp4 --start 10 --end 20验证:识别视频 10-20 秒片段,输出大写转录。README 示例输出为 "BORN IN NEW YORK CITY AND RAISED MOSTLY IN CHICAGO NANCY DAVIS GRADUATED FROM SMITH COLLEGE IN NINETEEN FORTY THREE"。
应用场景
会议室无声记录:按住键无声口型输入,松开后文字粘贴到笔记应用。需授予摄像头、输入监控和辅助功能权限,光线需充足使面部清晰。
公共场所隐私输入:机场、咖啡厅等噪音环境下,不发声不录音只读唇输入文字。个人口型与训练集差异大时准确率下降,首次 Setup 训练 8 分钟适配。
Whisper 模式高准确率:Settings 开启 Whisper mode,按键期间软耳语 + 唇读联合识别。测试片段错误率从 31.9% 降至 6.9%。需麦克风权限,模型 1.8GB 额外下载,真实耳语比测试片段清晰度低。
独立分析
lipflow 当前 445 Star,主语言 Python,topics 为空,创建于 2026 年 9 月 29 日,最近 push 2026 年 10 月 3 日。活跃度较低但核心功能完整。
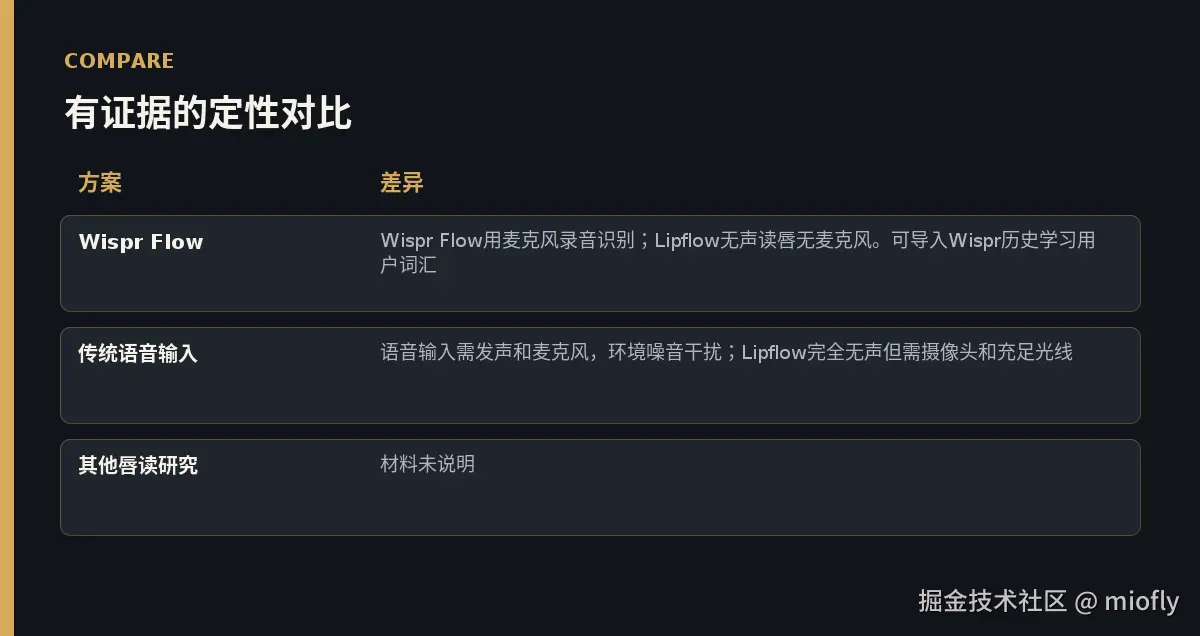
对比 Wispr Flow:Wispr Flow 用麦克风录音识别,需发声。lipflow 无声读唇无麦克风,可导入 Wispr 历史学习用户词汇。两者目标场景不同,lipflow 更适合隐私保护或噪音环境。
对比传统语音输入:语音输入需发声和麦克风,环境噪音干扰。lipflow 完全无声但需摄像头和充足光线,同唇音混淆依赖语言模型修正。
独立分析:真实无声口型比测试片段更难识别。README 明确指出 "Silently mouthed speech is harder than filmed speech (smaller lip movements)",无声口型动作幅度小,训练集多为有声视频,泛化能力受限。个人训练显著提升准确率,Setup 第 4 步说明仅在个人模型效果更好时保留,证明适配个人口型是提升准确率的关键。
基于 LRS3 数据集的 Auto-AVSR 模型 benchmark WER 19.1%,但实际使用中同唇音混淆、光线不足、口型差异都会提高错误率。开启 Whisper 模式或使用高质量 LLM(Claude)后处理能显著改善,但前者需麦克风、后者增加延迟和成本。
局限与风险
技术局限:同唇音(p/b/m、f/v 等)无法从视觉区分,必须依赖语言模型或 LLM 纠正。个人口型差异大时需重新训练 8 分钟,数据不足影响效果。
平台差异:Windows 无 NVIDIA GPU 时编码器 CPU 运行慢 1-2 秒,训练时间数倍于 Mac。Linux 粘贴需 wl-clipboard + wtype/ydotool,Wayland 输入组权限,GNOME 无活动窗口标题 API。
使用限制:免提模式最长 60 秒,超出需重新触发。学习用户纠错功能仅 macOS 实现,Windows/Linux 未支持。
法律风险:LRS3 模型权重仅限非商业研究使用。商业场景需评估许可证合规性。
隐私保护 :个人数据(视频片段、短语、训练模型)保存在本地 ~/Library/Application Support/Lipflow/,删除该目录可重置。所有推理本地完成,不上传视频或文本,但用户需授予摄像头和辅助功能权限。
结论卡片
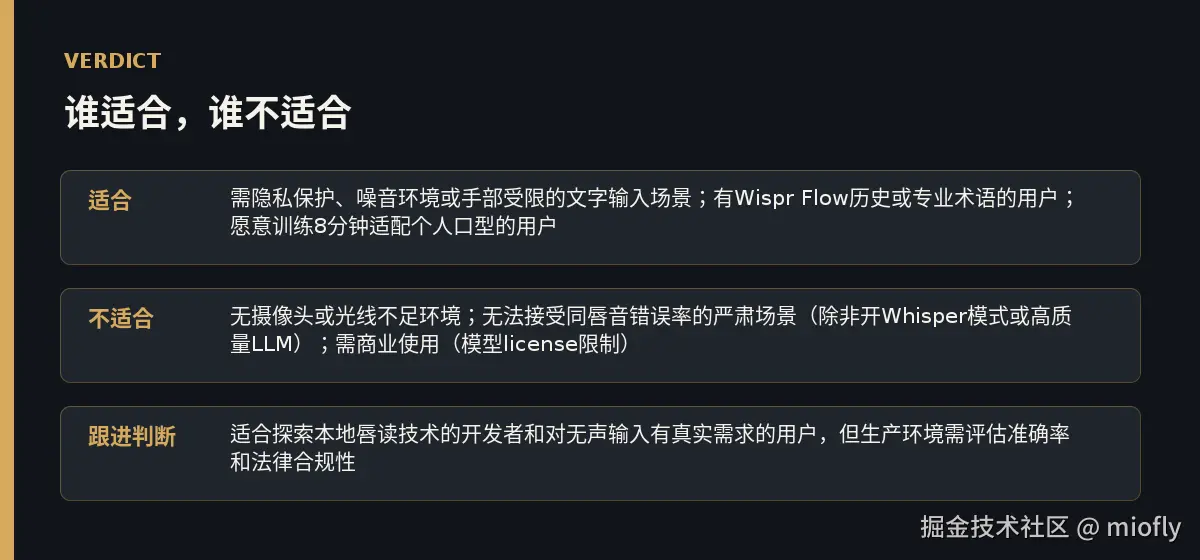
适合:需隐私保护、噪音环境或手部受限的文字输入场景。有 Wispr Flow 历史或专业术语的用户。愿意训练 8 分钟适配个人口型的用户。
不适合:无摄像头或光线不足环境。无法接受同唇音错误率的严肃场景(除非开 Whisper 模式或高质量 LLM)。需商业使用(模型 license 限制)。
跟进价值:适合探索本地唇读技术的开发者和对无声输入有真实需求的用户,但生产环境需评估准确率和法律合规性。