项目github地址github.com/Wrste/phero...
项目相关参考文献地址arxiv.org/abs/2606.30...
用 pheromone-network 管理智能体上下文
在上下文管理(context management)与智能路由决策中,智能体应用经常需要回答四个问题:
- 当前任务需要哪些历史信息?
- 哪些记忆与当前问题相关?
- 在固定 token 预算下,哪些内容应该保留、摘要或暂时移出?
- 如何让真正被验证和复用的经验在后续任务中更容易被召回?
pheromone-network 提供的是一层本地关联学习与候选召回组件 。应用把文本、工具结果或任务状态编码为向量,使用 observe 学习已经发生的关联,再使用 score 比较查询与候选内容的相关程度。应用负责保存原文、计算 token、选择最终上下文和执行任务闭环。
它可以帮助智能体减少无关上下文、复用经过验证的经验,并让长期不用的关联逐渐淡出;它不替代大语言模型、向量数据库、任务状态机或结果验证器。
一、核心思路:把上下文当作可更新的记忆集合
不要把整段会话作为一个不可分割的字符串反复塞回模型。更适合管理的记忆单元通常是一条事实、一个约束、一次工具结果、一个任务决定或一个待办状态。
每个记忆单元至少保存以下信息:
| 字段 | 用途 |
|---|---|
id |
稳定标识,便于反馈和删除 |
text |
注入模型的原文或摘要 |
vector |
与查询使用同一编码器生成的向量 |
kind |
fact、constraint、decision、tool、observation 或 task |
tokens |
注入上下文时预计占用的 token 数 |
priority |
应用层的业务优先级 |
required |
是否属于硬约束,不能仅靠相关性分数丢弃 |
usedAt / usedCount |
应用侧记录实际使用反馈 |
RecallKernel 只学习向量之间的关系并返回分数,不保存 text,也不理解 tokens、权限和业务优先级。把这些信息留在应用层,可以让上下文策略保持可解释、可测试、可替换。
二、原理与机制
1. 从高维向量折叠到联想空间
RecallKernel 接受任意正整数维度的 number[]。默认情况下,它会把输入向量确定性地折叠到 codeDim,将多个输入位置累加到同一个编码位置。默认 codeDim 为 512,但不会超过输入维度。
这样做有两个目的:保留整个输入向量的信号,同时把后续局部网络的计算规模控制在较小的编码空间。折叠不是语义压缩模型,因此语义质量仍然取决于输入向量本身;需要更强语义表达时,应接入外部 embedding。
ini
const dim = 1536;
const kernel = new RecallKernel(dim, { codeDim: 256 });

// query、candidate 和 observe 的向量都必须使用同一维度与编码方式
const query = existingEmbedding("查找最近一次部署记录");
const candidate = existingEmbedding("上周完成了生产环境部署");

kernel.observe(candidate);
const score = kernel.score(query, candidate);
2. 用固定稀疏拓扑限制局部连接
编码空间内部不是全连接网络。构建 LocalPheromoneLayer 时,系统根据单元位置、标签距离和 maxNeighbors 为每个输出单元选择有限的输入连接,并保存连接索引和掩码。
因此,每个输出只读取少量邻近输入,前向计算和局部更新都只在这些有效连接上进行。连接拓扑在构建后保持稳定,训练主要改变连接权重和信息素,不会在每次调用时重建整个网络。
markdown
输入单元与标签
        ↓
兼容候选 → 邻近连接 → connectionMask
                              ↓
                  只更新有效局部连接
3. observe 使用自联想 Hebbian 式局部学习
调用 RecallKernel.observe(vector) 时,内核先将向量折叠到编码空间,再把折叠后的向量同时作为输入和目标。这是一种自联想训练:网络尝试重建当前记忆,并根据局部信号更新权重。
一次局部训练大致包含以下步骤:
- 前向计算当前预测和局部误差。
- 根据共同激活、误差和连接预算,选择本次允许更新的稀疏连接。
- 更新被选连接的权重,并对未被选中的连接施加轻微突触衰减。
- 强化被接受连接的短期和长期信息素,同时让信息素自然蒸发。
- 根据配置返回损失、更新模式、预算和活跃突触数量。
它不是反向传播,也不需要训练数据集或 GPU;每次 observe 都是一次小范围的在线更新。
php
const report = kernel.observe(candidate);

console.log({
  loss: report.loss,
  mode: report.mode,
  activeSynapses: report.activeSynapses,
  budgetPerOutput: report.budgetPerOutput,
});
4. 短期与长期信息素共同影响前向计算
每条有效连接维护两种痕迹:
- 短期信息素:对近期共同激活反应更快,默认衰减更快。
- 长期信息素:积累经过反复使用的稳定关系,默认在前向门控中占主要权重。
前向计算会将两种信息素按配置混合,归一化为门控值,再与连接权重和连接掩码相乘:
有效权重 = 连接权重 × connectionMask × 信息素门控
输出值   = 有效连接输入的加权和 + 偏置
默认配置中 shortPheromoneWeight = 0、longPheromoneWeight = 1,所以长期信息素主导前向门控;两种信息素仍然都会被维护。需要强调的是,Demo 中展示的"使用次数加分"属于 Demo 的排序逻辑,不是内核默认的 score 公式。
5. score 在学习到的联想空间中比较
查询向量和候选向量都会经过同一个网络前向投影,得到两个编码结果。内核随后计算这两个结果的归一化余弦相似度:
erlang
query    → 折叠 → 局部网络前向 → queryCode
candidate→ 折叠 → 局部网络前向 → candidateCode
                                     ↓
                         normalized cosine(queryCode, candidateCode)
这意味着 score 会随着网络权重和信息素变化而变化。它反映的是当前内核状态下的关联程度,而不是一次固定的原始文本相似度。
6. 强化、蒸发与显式时间衰减
内核在局部训练时会执行"强化被选连接、衰减未选连接"的更新。应用还可以在业务周期结束时调用:
scss
kernel.evaporate(0.02);       // 按比例蒸发,等价于乘以 0.98
kernel.decayByFactor(0.5);    // 直接将有效信息素乘以 0.5
decayByFactor 会对有效连接的长期和短期信息素应用乘法因子,并受最小信息素限制。它不会改变应用保存的原文和向量,也不会自动判断某条记忆是否应该删除。
7. 为什么它适合上下文管理
这个机制组合形成了一条简单的反馈回路:
实际使用记忆 → observe 强化关联 → score 更容易召回
长期不使用   → 局部蒸发 / 显式衰减 → 关联逐渐淡出
因此,网络适合作为上下文窗口前的候选召回层。但"是否注入模型""是否摘要""是否违反安全规则"仍然必须由应用层决定。
三、三个核心 API 分别做什么
observe(vector):写入并强化
observe 会对输入向量执行一次局部自联想学习,更新网络权重和信息素。只有当记忆被真正采用、验证成功或确认有价值时,才应该再次调用它。
ini
kernel.observe(memoryVector);不要把"被召回"直接等同于"被使用"。如果每次检索都强化,错误结果也可能越来越容易被召回。
score(query, candidate):比较候选关联
score 将查询和候选分别投影到当前联想空间,再返回归一化相似度。它只负责比较一对向量,不负责遍历候选集合,也不负责最终 token 预算。
ini
const relationScore = kernel.score(queryVector, candidateVector);应用通常需要在这个分数之外,再结合硬约束、业务优先级、来源可信度、新鲜度和 token 成本进行排序。
decayByFactor(factor) / evaporate(rate):维护旧关系
旧的工具结果、临时观察和已被替代的约定不应该永久占据召回结果。应用可以按版本、项目周期或业务时间显式衰减:
ini
// 经过两个半衰期后,信息素乘以 0.25
const factor = 0.5 ** (elapsedHours / halfLifeHours);
kernel.decayByFactor(factor);
内核不会自动读取系统时间,也不会自动删除应用保存的文本。何时衰减、何时归档由应用决定。
四、推荐的上下文处理流程
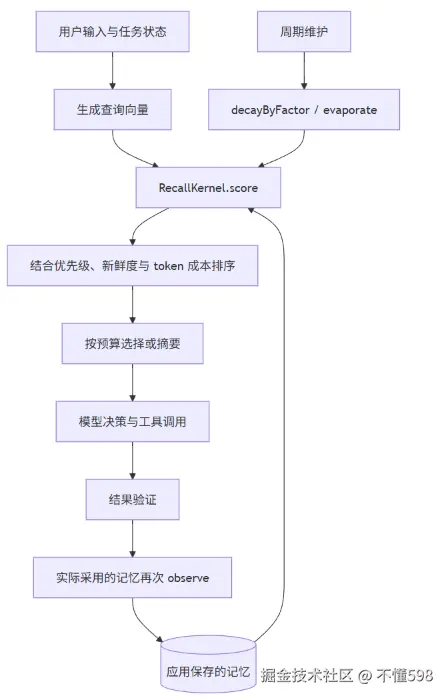
这条流程把职责分开:
- 编码器把记忆和查询变成同维度向量。
- **
RecallKernel**学习局部关联并提供候选分数。 - 应用层选择器处理硬约束、token 预算和摘要策略。
- 模型与工具层执行任务并产生结果。
- 验证器确认结果是否真的可复用,再决定哪些记忆需要强化。
五、完整接入示例
下面的示例使用仓库内置的 ngramEmbed,演示记忆写入、候选召回、token 预算选择、使用反馈和时间衰减。生产环境可以把 ngramEmbed 替换为已有的 embedding 服务,但所有向量必须保持相同维度和编码方式。
ini
import { RecallKernel, ngramEmbed } from "pheromone_network";

type MemoryKind =
  | "fact"
  | "constraint"
  | "decision"
  | "tool"
  | "observation"
  | "task";

type MemoryItem = {
  id: string;
  text: string;
  kind: MemoryKind;
  vector: number[];
  tokens: number;
  priority: number; // 0 到 1,由应用定义
  required: boolean;
  createdAt: number;
  usedAt: number;
  usedCount: number;
};

type RankedMemory = MemoryItem & {
  relationScore: number;
  finalScore: number;
};

export class ContextMemory {
  private readonly dim: number;
  private readonly kernel: RecallKernel;
  private readonly items = new Map<string, MemoryItem>();

  constructor(dim = 4096) {
    this.dim = dim;
    this.kernel = new RecallKernel(dim, {
      codeDim: Math.min(512, dim),
      seed: 1,
    });
  }

  private embed(text: string) {
    return ngramEmbed(text, this.dim);
  }

  remember(input: Omit<MemoryItem, "vector" | "createdAt" | "usedAt" | "usedCount">) {
    const now = Date.now();
    const item: MemoryItem = {
      ...input,
      vector: this.embed(input.text),
      createdAt: now,
      usedAt: now,
      usedCount: 0,
    };

    this.items.set(item.id, item);
    this.kernel.observe(item.vector);
  }

  recall(queryText: string, tokenBudget: number): RankedMemory[] {
    const queryVector = this.embed(queryText);
    const now = Date.now();

    const ranked = [...this.items.values()]
      .map((item): RankedMemory => {
        const relationScore = this.kernel.score(queryVector, item.vector);
        const ageDays = (now - item.usedAt) / 86_400_000;
        const freshness = Math.exp(-ageDays / 30);
        const finalScore =
          relationScore * 0.7 +
          item.priority * 0.2 +
          freshness * 0.1;

        return { ...item, relationScore, finalScore };
      })
      .sort((a, b) => {
        if (a.required !== b.required) return a.required ? -1 : 1;
        return b.finalScore - a.finalScore;
      });

    let usedTokens = 0;
    const selected: RankedMemory[] = [];

    for (const item of ranked) {
      if (usedTokens + item.tokens > tokenBudget) continue;
      selected.push(item);
      usedTokens += item.tokens;
    }

    return selected;
  }

  markUsed(ids: string[]) {
    for (const id of ids) {
      const item = this.items.get(id);
      if (!item) continue;

      // 只有实际采用或验证成功的记忆才强化
      this.kernel.observe(item.vector);
      item.usedAt = Date.now();
      item.usedCount += 1;
    }
  }

  decayByFactor(factor: number) {
    return this.kernel.decayByFactor(factor);
  }
}

const memory = new ContextMemory();

memory.remember({
  id: "project-language",
  text: "项目文档默认使用英文,必要时提供中文说明",
  kind: "constraint",
  tokens: 14,
  priority: 1,
  required: true,
});

memory.remember({
  id: "release-notes-style",
  text: "发布说明使用短句和项目符号,先写用户可见变化",
  kind: "decision",
  tokens: 18,
  priority: 0.8,
  required: false,
});

const selected = memory.recall(
  "请为这次版本更新写发布说明",
  120,
);

const contextText = selected.map((item) => item.text).join("\n");
console.log(contextText);

// 将 selected 实际传给模型,并确认模型采用了哪些记忆后再反馈
memory.markUsed(selected.map((item) => item.id));

// 业务周期结束时显式衰减旧关系
memory.decayByFactor(0.9);
示例中的几个重要决策
required: true的约束在排序时优先,但仍要由应用检查 token 预算;预算不足时应该单独处理,而不是静默截断安全规则。relationScore只代表网络学到的关联程度。示例中的priority和freshness是应用层策略,不是内核内置的频次权重。remember和markUsed都会调用observe,真实项目应避免对同一条内容重复、无条件地强化。ContextMemory只保存进程内状态。需要跨进程、跨重启或多租户共享时,应把MemoryItem持久化,并为不同范围创建独立内核或独立状态。
六、如何进行长上下文压缩
1. 先保留不可丢失的内容
安全规则、用户明确要求、任务目标、接口契约和未完成待办不应该只由相似度决定。它们可以单独放入固定上下文区,或者标记为 required 后由应用优先注入。
2. 再选择高关联内容
对历史事实、工具结果、项目约定和任务经验调用 score,再结合 priority、来源可信度和新鲜度排序。对相似内容先做应用层摘要,保留摘要和原始记录 ID,避免重复占用窗口。
3. 最后处理低价值内容
与当前任务无关、已经被新版本替代、长期没有被使用的内容可以暂时移出上下文。不要立即物理删除,先通过应用存储的生命周期字段或 decayByFactor 降低它们再次被选中的机会。
七、如何让智能体减少"虎头蛇尾"
上下文召回只能解决"模型看到了什么",不能单独保证"任务完成了什么"。建议把以下信息作为独立记忆保存:
任务目标 → 已完成步骤 → 工具调用 → 工具结果 → 验证结论 → 下一步模型执行工具后,应用应更新任务状态并验证结果。只有被验证成功的步骤和结果才适合强化;失败路径可以记录失败原因和修正方案,避免下一次重复同样的错误。
一个完整的 Agent 回路可以概括为:
markdown
用户输入 + 任务状态
        ↓
生成查询向量 → 召回候选 → 按 token 预算选择上下文
        ↓
模型决策 → 工具执行 → 结果验证 → 更新任务状态
                                      ↓
                         强化实际采用的记忆
八、接入已有 embedding
ngramEmbed 适合短文本、近重复文本、日志模板和快速原型。需要跨措辞的语义等价判断时,可以传入已有 embedding 函数:
typescript
import { RecallKernel, type Embedder } from "pheromone_network";

const embed: Embedder = (text) => existingEmbeddingModel.embed(text);
const kernel = new RecallKernel(1536, { codeDim: 256 });
const memories: Array<{ text: string; vector: number[] }> = [];

function remember(text: string) {
  const vector = embed(text);
  memories.push({ text, vector });
  kernel.observe(vector);
}

function recall(query: string, limit = 3) {
  const queryVector = embed(query);
  return memories
    .map((item) => ({
      text: item.text,
      score: kernel.score(queryVector, item.vector),
    }))
    .sort((a, b) => b.score - a.score)
    .slice(0, limit);
}
传给 RecallKernel 的 dim 必须与 embedding 输出维度一致,查询和候选也必须使用同一个编码方式。
九、边界与使用建议
- 它是关联召回组件,不是完整的语义理解模型。
- 它不会自动保存候选文本,不会自动计算 token,也不会自动决定哪些内容可以删除。
- 它不会自动读取系统时间;时间衰减需要应用显式调用。
- 它不替代权限控制、事务处理、结构化过滤、全文检索或最终结果验证。
- 建议为用户、租户、项目、设备或版本建立隔离的内核状态,避免不同范围的反馈互相污染。
- 建议用真实任务日志建立离线评估集,比较召回命中率、上下文 token 数、工具调用重复率和任务完成率,再调整排序权重与衰减周期。
十、最小接口速查
scss
kernel.observe(vector);                     // 写入并强化一条向量
kernel.score(queryVector, candidateVector); // 比较查询与候选
kernel.evaporate(rate);                    // 按比例蒸发信息素
kernel.decayByFactor(factor);               // 按因子衰减信息素
kernel.encode(vector);                     // 投影到联想空间