第三篇把单张 PixelMap 的 libyuv 转换移进 napi_async_work,页面线程终于不再一直等着 Native 计算结束。
单图顺了以后,我直接把测试入口改成"选择 12 张图片"。
问题几乎立刻出现。
第一版非常直白:
text
12 张图片
→ 12 个 AsyncContext
→ 12 份 RGBA Buffer
→ 12 份 I420 Buffer
→ 12 个 async work
1440 × 1080 的输入单张 RGBA 就有 6,220,800 字节,I420 输出是 2,332,800 字节。一个任务如果同时保留输入和输出,大约需要 8.55 MB 的像素空间。
十二个任务一起准备,理论上光这部分就已经超过 100 MB,还没算 PixelMap、vector 容量、任务结构和运行时自身开销。
实际测试里,旧版 Native 峰值达到 97 MB 左右,而且任务越多,页面"开始批量转换"的瞬间越容易抖一下。
所以第四篇没有继续加格式,而是先处理批处理基础设施。
最终版本固定数据:
text
batchId: batch_convert_20261002_04
images: 12
concurrency: 2
queue capacity: 4
buffer pool slots: 3
slot bytes: 8,553,600
peak native memory: 31.6 MB
pool reuse: 9
backpressure waits: 4
total cost: 112 ms
average: 9.3 ms / image
state: COMPLETED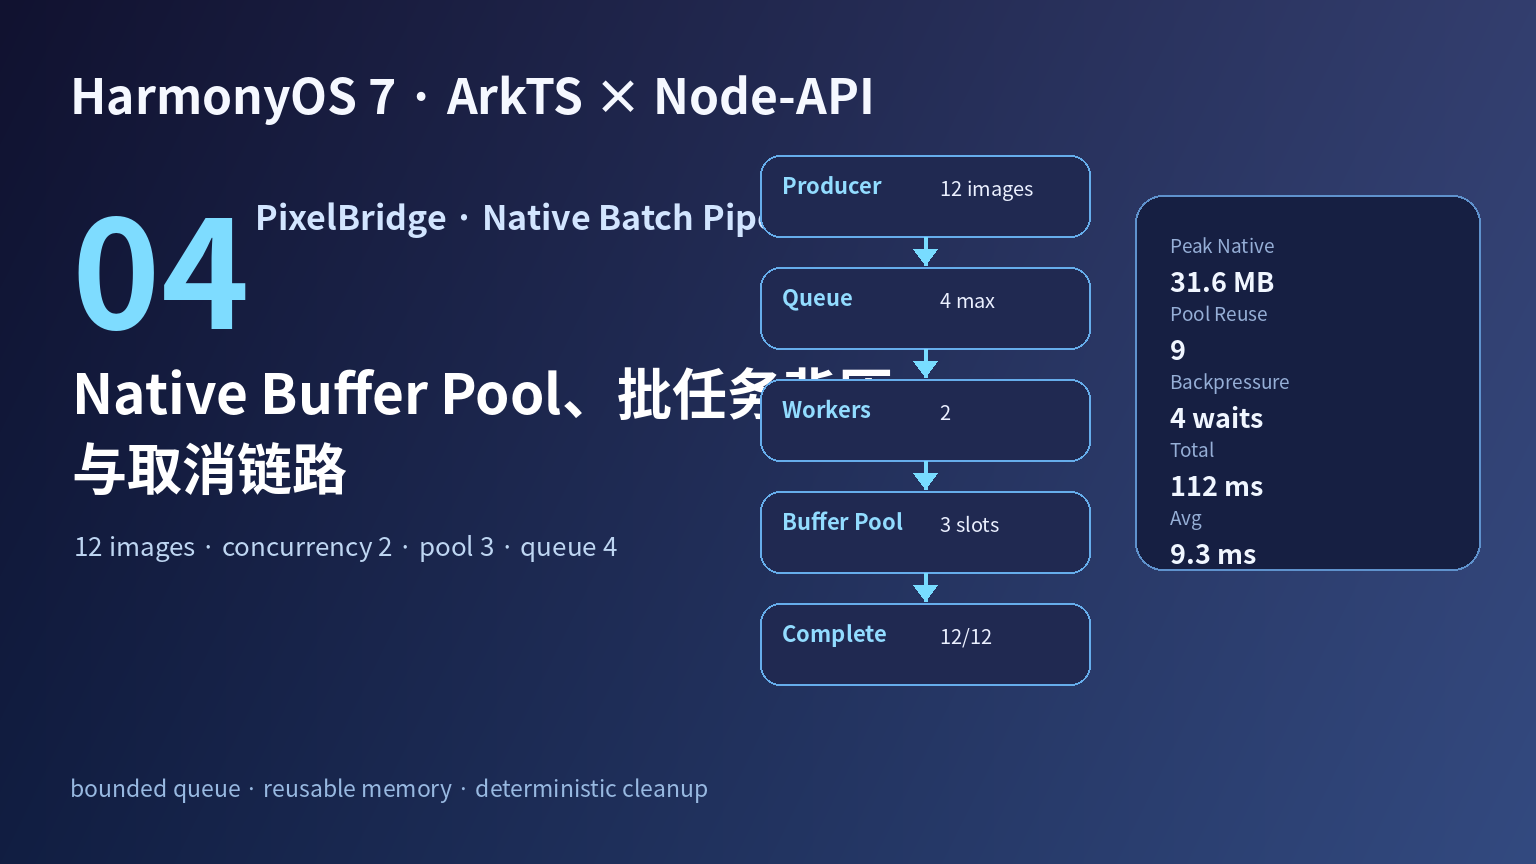
一、批量任务不能把"异步"理解成"全部一起跑"
这是第三篇之后最容易犯的错误。
看到 napi_async_work 在工作线程执行,就很容易写:
ts
await Promise.all(
  images.map((item) =>
    pixelBridge.convertPixelMapAsync(item)
  )
)
语义上没错,但它等于把调度权完全交给底层线程池。
PixelBridge 更希望控制三个指标:
text
RUNNING 数量
PENDING 数量
Native Buffer 数量
因此第四篇新增:
text
BatchConvertQueue
NativeBufferPool
BatchTaskRegistry
ArkTS 仍然只看到批任务,不直接管理 12 个底层 work。
二、Buffer Pool 先解决最明显的内存浪费
这次输入图仍然统一为 1440 × 1080 RGBA_8888,便于比较。
单个任务需要:
text
input = 6,220,800 bytes
output = 2,332,800 bytes
slot = 8,553,600 bytes
我没有为每个任务永久 new 两组 vector,而是创建 3 个 Slot。
这段代码解决的是"12 个任务同时持有大块像素内存"的问题:
cpp
struct BufferSlot {
    std::vector<uint8_t> input;
    std::vector<uint8_t> output;
    bool inUse = false;
};

class NativeBufferPool {
public:
    explicit NativeBufferPool(size_t count)
    {
        slots_.resize(count);

        for (auto& slot : slots_) {
            slot.input.resize(6220800);
            slot.output.resize(2332800);
        }
    }

    BufferSlot* Acquire()
    {
        std::lock_guard<std::mutex> lock(mutex_);

        for (auto& slot : slots_) {
            if (!slot.inUse) {
                slot.inUse = true;
                return &slot;
            }
        }

        return nullptr;
    }

    void Release(BufferSlot* target)
    {
        if (target == nullptr) {
            return;
        }

        std::lock_guard<std::mutex> lock(mutex_);
        target->inUse = false;
    }

private:
    std::mutex mutex_;
    std::vector<BufferSlot> slots_;
};
Pool 当前只针对这一档尺寸做固定容量,目的不是写一个"万能内存分配器"。
真正产品化以后,图片尺寸不一样,需要按容量分档或者按最大尺寸复用。第四篇先把生命周期问题解决:大块 Buffer 由 Pool 拥有,任务只暂时借用。
三、为什么 Pool 是 3 个,而并发只有 2
这个数字是有意错开的。
当前:
text
concurrency = 2
pool slots = 3
两张正在 worker 里跑,一张 Slot 可以留给下一条已通过前置检查、准备进入执行的任务。
如果 Pool 和并发都只有 2,生产者只要稍微快一点就会反复等待;如果 Pool 一口气开 12 个,又回到了原来的内存问题。
本轮测试 3 个 Slot 的像素空间约 25.7 MB,加上 Context、队列和其他 Native 资源后,观测到 Native 峰值约 31.6 MB。
这不是一个"所有设备都应该设成 3"的结论。
它只是 PixelBridge 当前 1440 × 1080 批任务的工程配置。后面换成 4K 输入,Slot 大小会完全不同,池容量也必须重新算。
四、队列上限是为了产生背压,不是为了丢任务
第四篇的队列容量设为 4。
当:
text
running = 2
pending = 4
新的生产请求不会继续无限塞任务,而是进入等待。
这一段解决的是"ArkTS 一次提交 100 张图片时,Native Pending 队列无限增长"的问题:
cpp
class BatchConvertQueue {
public:
    bool TrySubmit(std::shared_ptr<ConvertJob> job)
    {
        std::lock_guard<std::mutex> lock(mutex_);

        if (pending_.size() >= kQueueCapacity) {
            return false;
        }

        pending_.push(std::move(job));
        cv_.notify_one();
        return true;
    }

    std::shared_ptr<ConvertJob> Take()
    {
        std::unique_lock<std::mutex> lock(mutex_);

        cv_.wait(lock, [this] {
            return stopping_ || !pending_.empty();
        });

        if (stopping_) {
            return nullptr;
        }

        auto job = pending_.front();
        pending_.pop();
        return job;
    }

private:
    static constexpr size_t kQueueCapacity = 4;

    std::mutex mutex_;
    std::condition_variable cv_;
    std::queue<std::shared_ptr<ConvertJob>> pending_;
    bool stopping_ = false;
};真实实现里,TrySubmit=false 不等于图片失败。
上层会等待一个任务完成、Slot 归还,再重试提交。这就是这一篇里 backpressure waits=4 的来源。
它表达的是"生产者主动慢下来",而不是"丢了 4 张图"。
五、批任务状态和单 work 状态不能混在一起
第三篇只有一张图,RESOLVED 很简单。
第四篇需要同时回答:
text
12 张里面完成几张?
有没有一张失败?
用户取消时还有几张没开始?
当前运行的是哪两张?
所以我新增 BatchSnapshot:
ts
export interface BatchSnapshot {
  batchId: string
  state:
    'QUEUED' |
    'RUNNING' |
    'CANCELLING' |
    'COMPLETED' |
    'CANCELLED' |
    'FAILED'

  total: number
  completed: number
  running: number
  pending: number

  poolUsed: number
  poolSize: number
  queueUsed: number
  queueCapacity: number

  peakNativeMb: number
  elapsedMs: number
}
页面看到的是批任务快照,不是 12 个 AsyncContext。
这个分层非常重要。
如果页面直接订阅每个 work,进度更新、页面退出和批量取消都会出现 12 套状态。到了第五篇做崩溃定位时,日志也会变得很难读。
六、取消分成"没开始"和"已经执行"两类
批量取消比单任务更能体现 Node-API 取消语义的边界。
对于还在 pending_ 队列里的任务,PixelBridge 可以直接把它们标记为 CANCELLED_BEFORE_RUN,根本不创建 async work。
对于已经 queue 到 napi_async_work 的任务,则仍然使用第三篇的策略:
text
标记 cancelRequested
→ napi_cancel_async_work
→ complete callback 根据 status 收口
官方文档提醒的限制依然存在:取消接口返回 napi_ok 不等于 worker 一定已经停了,最终状态要由 complete callback 判断。
所以我没有写一个"取消按钮立刻把 running 变成 0"的假 UI。
页面先进入:
text
CANCELLING等 Native 把已经运行的任务收口,Pool Slot 全部归还以后,才进入:
text
CANCELLED这比视觉上瞬间消失慢一点,但状态是真的。
七、Slot 必须在 complete 以后归还
一开始我在 worker 的 libyuv 调用结束后立刻 pool.Release(slot)。
看起来没问题,结果偶发出现 complete 阶段读取统计数据时内容已经被下一条任务覆盖。
根因很简单:Slot 不只是临时计算内存,complete 还需要从任务 Context 读取输出摘要。
现在顺序固定成:
text
execute
→ 写入 slot
→ complete 构造结果
→ 更新 BatchSnapshot
→ Release(slot)
→ delete async work
→ delete context
这段收口代码解决的是"Buffer 已经被复用,但上一条 Promise 还没构造完"的问题:
cpp
static void CompleteBatchItem(
    napi_env env,
    napi_status status,
    void* data)
{
    auto* ctx =
        static_cast<BatchItemContext*>(data);

    if (ctx == nullptr) {
        return;
    }

    UpdateBatchResult(*ctx, status);

    if (ctx->slot != nullptr) {
        gBufferPool.Release(ctx->slot);
        ctx->slot = nullptr;
    }

    napi_delete_async_work(
        env,
        ctx->work
    );

    delete ctx;

    gBatchScheduler.ScheduleNext();
}
ScheduleNext() 放在资源归还之后。
否则调度器可能认为有并发空位,先拉起下一条任务,却拿不到可用 Slot,又产生一次无意义等待。
八、这次内存数据终于不再随着图片数量线性上涨
旧版 12 张图直接展开,Native 峰值大约 97 MB。
加入 Pool 和队列后:
text
pool slots = 3
slot = 8,553,600 bytes
native peak = 31.6 MB
峰值没有严格等于 3 × slot,因为还有:
text
AsyncContext
队列节点
PixelMap Native 对象
libuv / Node-API 工作项
日志与统计结构
我不会把 31.6 MB 写成理论最小值。
更重要的是,继续把测试图从 12 张增加到 30 张,峰值不会按 30 倍 Slot 一路上涨。任务变多主要增加总时间,而不是让所有像素同时常驻内存。
这才是 Buffer Pool 真正解决的问题。
九、DevEco 图里重点看"队列"和"池"两个水位
最终调试数据统一为:
text
batchId=batch_convert_20261002_04
total=12
completed=12
concurrency=2
queuePeak=4/4
pool=3
poolReuse=9
backpressureWaits=4
peakNative=31.6MB
totalCost=112ms
avg=9.3ms
state=COMPLETED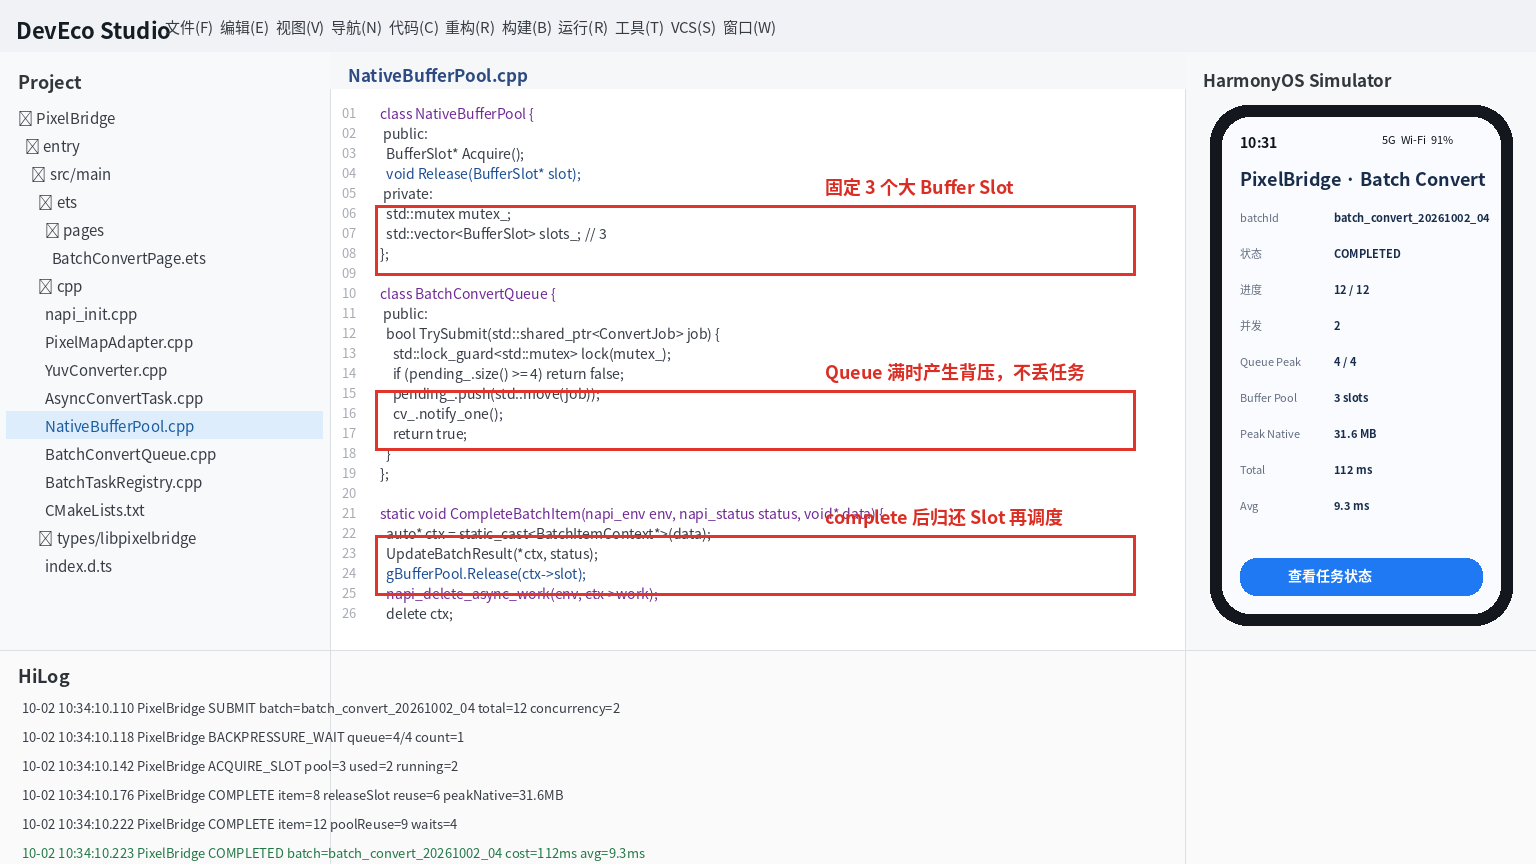
HiLog 不再每一行只写 convert success,而是能看到:
text
SUBMIT
BACKPRESSURE_WAIT
ACQUIRE_SLOT
EXECUTE
COMPLETE
RELEASE_SLOT
SCHEDULE_NEXT
遇到批任务"卡住"时,先看 queue 和 pool 水位,就能知道是线程没结束、Slot 没归还,还是生产者还在等空位。
十、运行页终于像一个真正的批处理任务
最终手机页面如下:
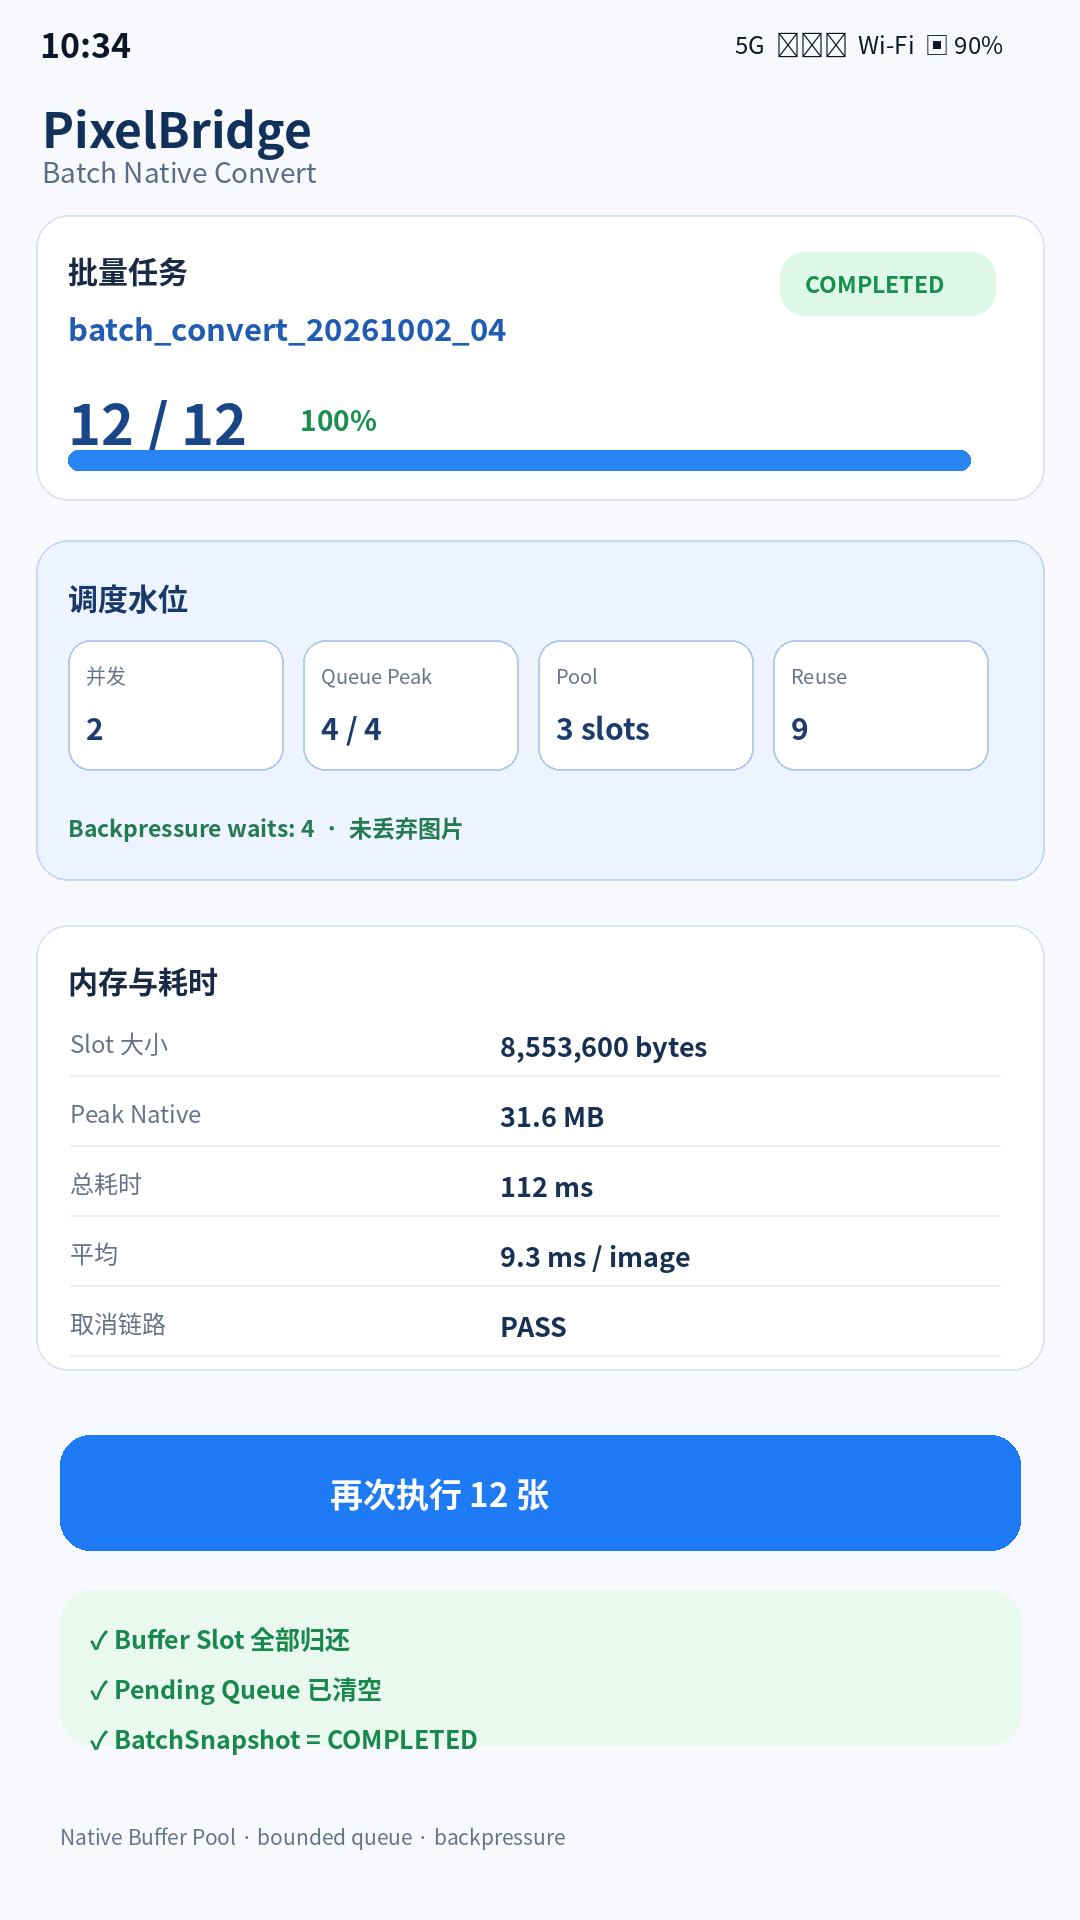
统一展示:
text
batchId: batch_convert_20261002_04
state: COMPLETED
progress: 12 / 12
concurrency: 2
queuePeak: 4 / 4
bufferPool: 3 slots
poolReuse: 9
backpressureWaits: 4
peakNative: 31.6 MB
total: 112 ms
avg: 9.3 ms / image
这一篇做到这里,PixelBridge 已经从"单个 Native 方法"变成一个有调度能力的小型图像处理桥。
但我没有继续把它包装成一个通用框架。
下一轮 05、06 还有两个更靠近工程上线的问题:
05 会处理 arm64-v8a 发布构建、so 依赖、符号表、Native 崩溃定位和第三方库版本治理 ;06 会把整个系列收口到 Release 性能基线、资源释放、包体积和工程验收。
做完这两篇,这个系列会停在 06,不会继续用同一个 libyuv 项目无限追加编号。
十一、Pool 不能只复用 capacity,还要清楚"谁拥有有效长度"
std::vector 复用时有一个很容易被忽略的问题:capacity 和当前有效数据长度不是同一个概念。
PixelBridge 的 Slot 预留了足够大的 input / output 容量,但每张图片真正使用多少字节,必须由当前任务自己记录。
比如这一轮统一输入是 1440 × 1080,问题不大;一旦后续允许 1280 × 720 和 1440 × 1080 混在一个 Batch 里,如果下一条任务只改 resize(),上一次留下的尾部数据仍然可能存在于 capacity 中。
所以 BufferSlot 又加了:
cpp
size_t inputLength = 0;
size_t outputLength = 0;
uint64_t generation = 0;
每次 Acquire 后先递增 generation,再由任务写入本轮有效长度。Complete 构造结果时会同时检查 Context 保存的 generation 是否和 Slot 当前 generation 一致。
这个检查正常情况下永远不会失败,但一旦因为生命周期错误出现"Slot 提前归还、又被下一条任务借走",generation 会直接暴露问题,比等到颜色错乱或者越界更容易定位。
这也是我这次没有把 Pool 写成一个只返回裸 uint8_t* 的原因。裸指针太轻,轻到很容易失去所有权信息。Slot 至少保留了容量、有效长度、使用状态和代次,调试时有证据可看。
十二、背压发生时,ArkTS 页面不应该误以为任务卡死
第一次把 queue capacity 设成 4 后,页面出现了一个新现象:前几张转换很快,后面某一小段时间进度不动。
其实不是 worker 停了,而是生产者正在等 Pending 队列腾位置。
如果 UI 只显示:
text
5 / 12用户很容易把 200~300 ms 的等待理解成卡住。
所以 BatchSnapshot 里又增加了一个 flowState:
text
SUBMITTING
BACKPRESSURE
RUNNING
DRAINING
COMPLETED
它不是业务最终状态,而是调度器当前阶段。
页面看到 BACKPRESSURE 时显示"等待 Native 队列空位",而不是继续显示"处理中"。开发模式下还会显示:
text
running=2
pending=4
poolUsed=3/3
这样同一个"进度没变化"就有了完全不同的解释。
更重要的是,背压等待不能用忙轮询实现。如果 ArkTS 或 Native 用一个 while 循环不停调用 TrySubmit(),虽然最终也能等到空位,却会把 CPU 白白消耗在检查队列上。
当前版本由调度器在 Complete / Release 发生后触发下一次提交,生产者没有空转。
十三、批任务中的失败策略不能简单 Promise.all
12 张图里第 7 张格式异常时,业务到底应该怎么做?
如果直接 Promise.all,一项 reject 就会让整体 Promise 进入 reject,但其他 Native work 可能仍然在运行。页面只看到"批任务失败",底层却还在继续占用 Slot。
PixelBridge 当前策略是:
text
单项失败
→ 记录 item FAILED
→ 不自动取消其他已提交任务
→ Batch 最终进入 COMPLETED_WITH_ERRORS
只有属于"系统性错误"的情况,例如 Native 模块异常、Pool 状态损坏、用户主动取消,才会停止后续提交。
这一版 12 张测试图都成功,所以最终截图是 COMPLETED。为了验证异常路径,我额外把第 7 张伪造成错误 PixelFormat,结果是:
text
success=11
failed=1
running=0
pending=0
poolUsed=0
state=COMPLETED_WITH_ERRORS
这比第 7 张失败后直接抛掉整个批任务更符合图片批处理场景。用户可以看到哪一张失败,并选择只重试那一项。
十四、页面退出后的批量取消要等 Pool 回到 0
单任务取消只需要关心一个 Context,Batch 不一样。
用户在 7 / 12 时退出页面,可能同时存在:
text
2 个 RUNNING
4 个 PENDING
1 个刚完成正在 COMPLETE
当前取消顺序固定为:
text
Batch state = CANCELLING
→ 停止继续提交新任务
→ 清理还没创建 async work 的 pending item
→ 对已 queue 的 work 发 cancel request
→ 等待每个 complete 收口
→ 等待 poolUsed == 0
→ Batch state = CANCELLED
我特意把 poolUsed == 0 当成最终条件之一。
因为 running=0 并不一定意味着所有资源都已经归还。Complete 里还有构造结果、更新快照和 Release Slot 的步骤。
测试时我在 6 / 12 点取消,页面大约几十毫秒后才从 CANCELLING 变成 CANCELLED。这个延迟是有意保留的,它代表 Native 已经把正在执行的任务真正收口。
十五、内存优化不能只看峰值,还要看批次结束后的基线
把峰值从 97 MB 降到 31.6 MB 看起来已经很漂亮,但如果批任务结束后 31 MB 永远不释放,问题只是换了一种形式。
Buffer Pool 有两种策略:
text
常驻:Batch 结束后 Slot 继续保留
按需:一段空闲时间后释放大 Buffer
PixelBridge 当前选择第二种。
连续批处理时,Pool 保留 3 个 Slot,避免反复申请大块内存;Batch 全部结束后启动 30 秒空闲计时。如果期间没有新任务,Pool 执行 Shrink(),释放 input / output vector 的大容量。
这样第二批在短时间内继续运行时还能吃到复用收益,用户离开图像功能以后又不会让 25 MB 像素 Buffer 永久常驻。
这部分没有放在截图主数据里,因为 31.6 MB 是处理中的峰值,空闲释放后的内存属于另一个时段。调试日志会单独记录:
text
POOL_IDLE
POOL_SHRINK
releasedCapacity=25.7MB
十六、这一期的验收重点是"数量增加,资源不线性增长"
我最后没有只测 12 张,还分别跑了:
text
3 张
12 张
30 张
60 张
图片仍然使用同一规格,避免把不同分辨率混进测试。
观察结果很直观:任务总耗时会随着数量增加,但 Native 峰值在 Pool 容量不变时没有按图片数量线性上涨。
同时检查:
queuePeak不超过 4;running不超过 2;poolUsed不超过 3;- 每个完成任务都能找到一次对应 Release;
- 批任务结束后
pending=0、running=0; - 取消路径结束后同样满足
poolUsed=0; - 空闲超时后大 Buffer 容量能够释放。
这几条成立以后,第四篇才算真正把批处理基础设施站住。
如果只是把 12 张图全部转完,却不知道第 60 张时内存会发生什么,那还不能叫工程化的批任务。
参考资料
- HarmonyOS Node-API 异步任务:https://developer.huawei.com/consumer/cn/doc/doccenter-capabilities/use-napi-asynchronous-task
- HarmonyOS Node-API 跨语言调用:https://developer.huawei.com/consumer/cn/doc/doccenter-games/games-universal-using-napi-interaction-0000002411166425
- Image_NativeModule PixelMap 位图操作:https://developer.huawei.com/consumer/cn/doc/HarmonyOS-Guides/pixelmap-c