为什么要把文档切成 Chunk
文档解析完成后,通常不能直接把整份内容做成一个向量。用户问的往往只是局部问题,整篇文档作为检索单元会混入大量无关内容;同时,长文档也可能超过 Embedding 模型或生成模型的输入限制。
于是需要把文档切成较小的 Chunk。Chunk 是检索系统返回的基本单位,它决定模型最终能看到多少上下文。
切得太大,向量会混合多个主题,检索不够精确;切得太小,完整答案会散落到多个片段中,甚至连主语和条件都被切开。分块的本质,是在"语义完整"和"定位精确"之间找平衡。
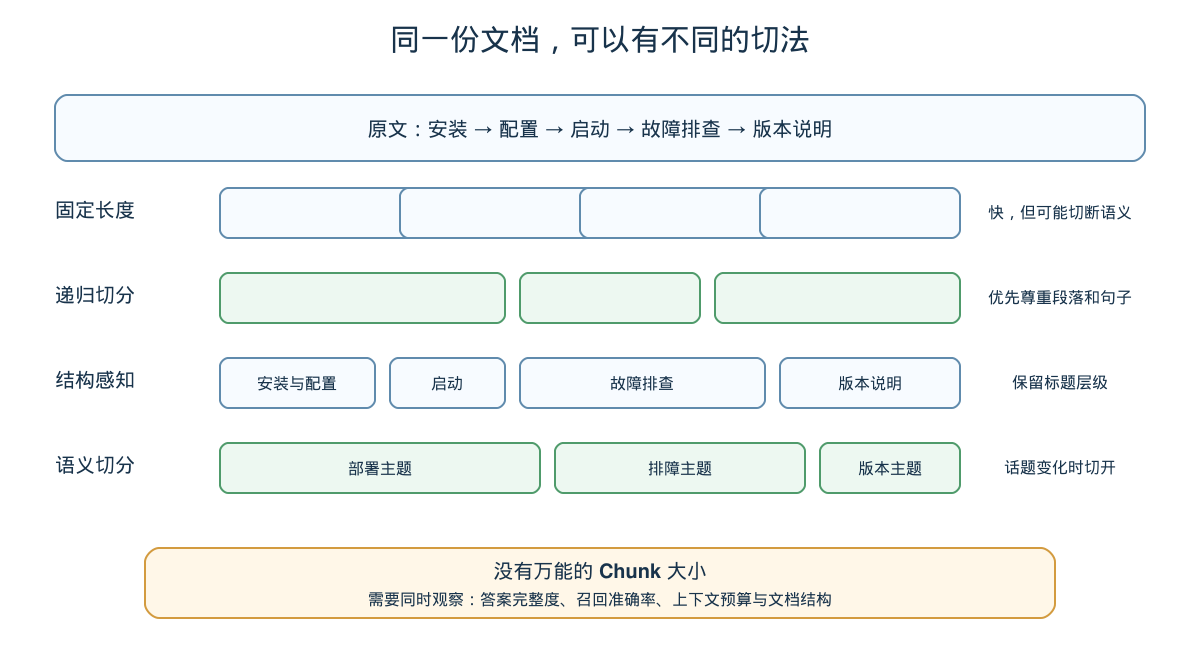
1. 固定长度分块
固定长度是最直接的方案:每 N 个字符或 Token 切一块。为了避免边界处丢失上下文,通常设置一段重叠区。
python
def fixed_chunks(text, size=500, overlap=80):
    chunks = []
    start = 0
    while start < len(text):
        chunks.append(text[start:start + size])
        start += size - overlap
    return chunks
它速度快、结果稳定,适合结构很弱的纯文本。问题也很明显:现象1可能留在上一块,解释却落到下一块;代码、表格和句子都可能被从中间切断。重叠能缓解边界问题,却会增加存储量,并使多个召回结果包含重复内容。
2. 按句子分块
这种方法先识别句子边界,再把若干句组合为一个 Chunk。它至少不会从句子中间切开,适合新闻、FAQ 和普通说明文。
python
sentences = sentence_splitter.split(text)
chunks = pack_by_token_limit(sentences, max_tokens=350)
难点在于句号不一定代表句子结束,例如版本号、缩写、小数和代码都可能包含点号。只按标点写正则,面对中英文混排时尤其容易误切。此外,一个句子保持完整,并不代表它脱离上一段后仍然有意义。
3. 递归分块
递归分块会按一组从强到弱的分隔符尝试切分,例如先按章节和空行,再按句子、空格,最后才按字符硬切。
python
separators = ["\n\n", "\n", "。", "!", "?", ";", " ", ""]

def recursive_split(text, limit, level=0):
    if token_count(text) <= limit:
        return [text]
    sep = separators[level]
    parts = text.split(sep) if sep else list(text)
    packed = pack_with_separator(parts, sep, limit)
    return sum(
        (recursive_split(x, limit, level + 1) for x in packed),
        [],
    )
它比固定长度更尊重自然边界,而且不依赖额外模型,因此常被用作通用基线。它仍然不理解主题,只是尽量在更自然的位置断开。
4. 结构感知分块
若输入已经保留 Markdown 标题、HTML 标签或文档层级,应优先利用这些结构。例如把一个二级标题及其正文视为候选块,过长时再在内部递归切分。
text
文档标题
└── 一级章节
    ├── 二级章节 A  → 一个或多个 Chunk
    └── 二级章节 B  → 一个或多个 Chunk
结构分块的优势是每个片段都能携带标题路径。即使正文写着"执行上述命令",检索结果也能同时带上"安装 > Linux 环境 > 启动服务"这样的语境。
它的局限是章节长度可能极不均匀,而且依赖上游解析质量。标题若识别错误,分块边界也会跟着错。因此常见做法是"结构定位 + 递归控制大小"。
5. 语义分块
语义分块先把相邻句子或段落转成向量,再比较相似度。当相邻内容的语义相似度明显下降时,说明话题可能发生了变化,可以在这里切开。
python
vectors = embed(sentences)
similarities = [
    cosine(vectors[i], vectors[i + 1])
    for i in range(len(vectors) - 1)
]
boundaries = detect_drops(similarities, threshold=0.68)
这种方式对访谈、会议记录和话题频繁切换的长文本很有用。不过它需要额外计算 Embedding,阈值也会影响结果:过高会产生大量碎片,过低又无法分开不同主题。阈值不能凭经验一次定死,应在真实问题集上调试。
6. 针对特殊内容分块
代码、表格和问答对不适合套用普通段落规则。
- 代码应尽量按类、函数或方法切分,并保留文件路径与符号名。
- 表格应保留表头,并让每个数据块都能理解列含义。
- FAQ 最自然的单元通常是一组问题与答案。
- 对话记录需要保留说话人和时间,必要时按话题而非轮次切分。
例如,表格按行分块时可以把表头展开到每条记录:
text
产品=A;版本=2.1;状态=可用
产品=B;版本=1.8;状态=停止维护
这样做牺牲了一点紧凑性,却让每个 Chunk 单独出现时仍然可读。
7. 使用大模型分块
大模型可以识别主题、论点、前置条件和引用关系,并按"能够独立回答一个问题"的标准切分。它适合结构混乱但价值很高的复杂资料。
text
请把下列内容切成若干语义完整的知识片段。
每个片段必须:
1. 能脱离上下文独立理解;
2. 保留条件、例外和结论;
3. 返回标题、摘要和原文起止位置。
代价是调用成本、延迟和结果不完全稳定。大模型也受自身上下文窗口限制,因此更常作为高价值数据的精加工手段,而不是默认处理所有文件。
Chunk 大小怎样确定
不存在适用于所有项目的固定数字。合理大小取决于文档结构、问题粒度、Embedding 模型上限和生成阶段的上下文预算。
可以从一个中等大小开始,再围绕三类指标调整:
- 检索命中率:标准答案所在片段能否进入 Top-K。
- 片段纯度:召回块中无关内容有多少。
- 答案完整度:模型是否拿到了条件、步骤和例外。
若经常命中主题却答不全,可增大 Chunk、增加重叠,或在命中后补充相邻块;若结果总是宽泛而不精确,应缩小 Chunk,或改用结构和语义边界。
实用的选型顺序
面对结构清楚的 Markdown、HTML 或技术手册,先按标题切,再对超长章节递归切分。普通纯文本可从递归分块开始。会议记录和话题跳跃明显的内容,可以尝试语义分块。代码、表格、FAQ 则应使用专门规则。
不要只观察切出来的文本是否整齐。最终目标是让真实问题稳定命中正确证据。把分块参数纳入检索评估,远比争论"500 还是 800 个字符"更有意义。
小结
分块不是文档预处理中的机械步骤,而是在设计知识库的最小语义单元。好的 Chunk 既能独立理解,又不会包含太多无关话题;既能被准确召回,也能为答案保留足够上下文。
实际项目中,组合策略往往比单一策略更可靠:利用结构确定大边界,用递归规则控制长度,对少量复杂内容再用语义或大模型精细处理。