多模态 Agent 如何规划 UI 测试路径
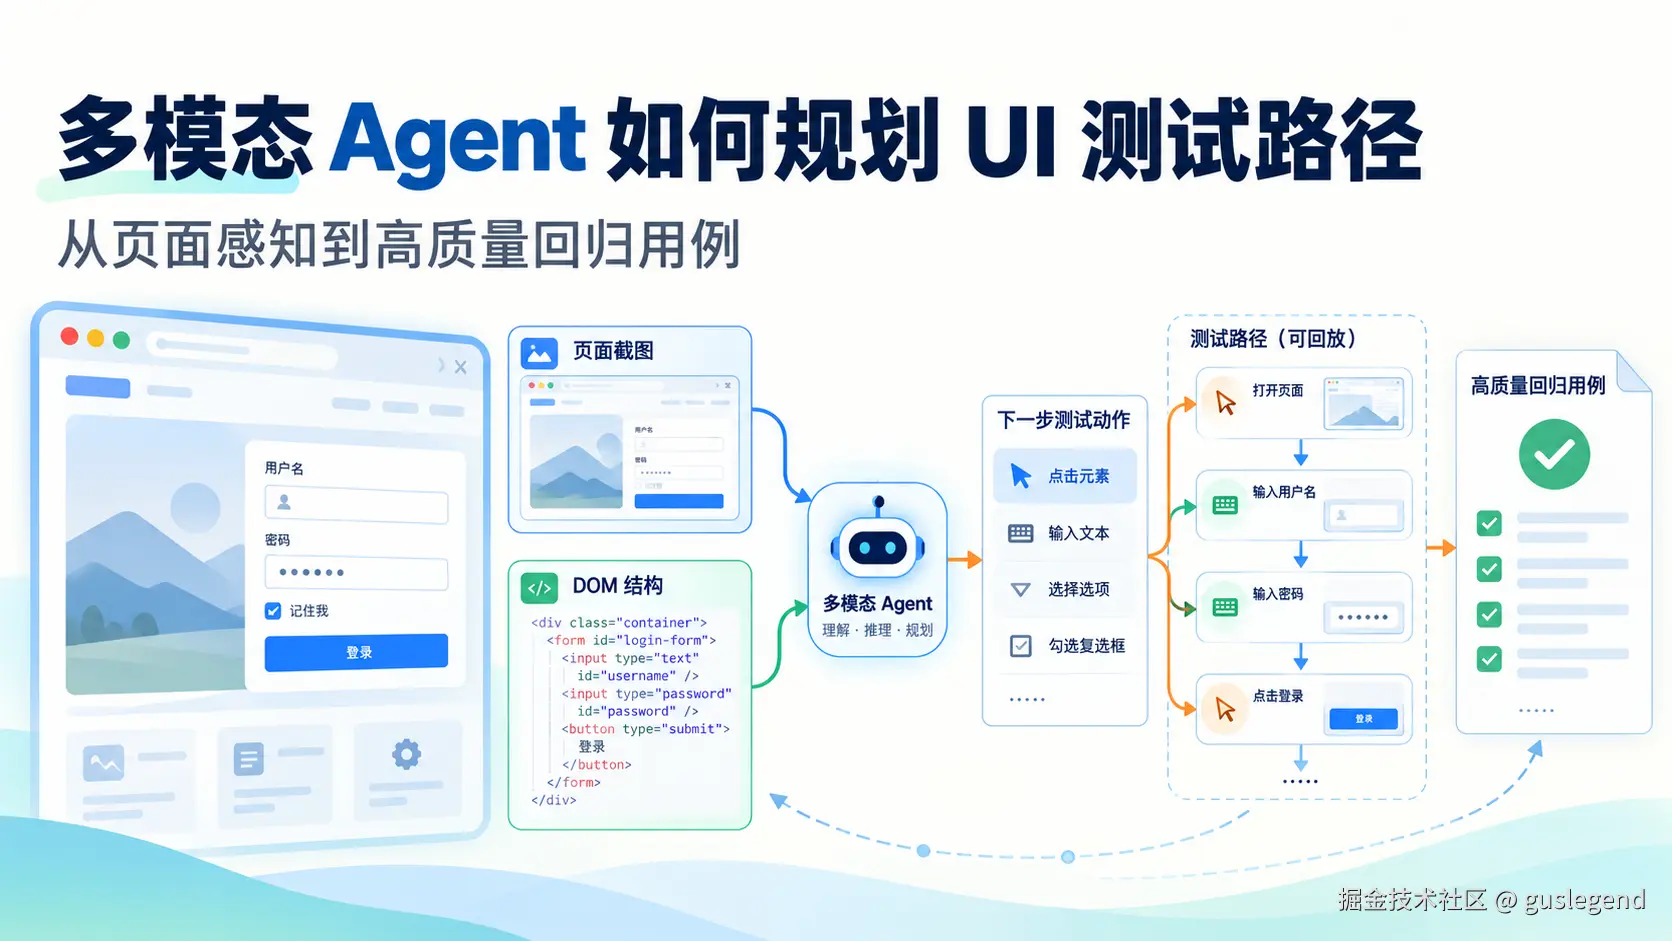
UI 自动化的难点,表面看是脚本维护成本高,深层看是测试设计无法持续跟上系统变化。传统自动化更多是在验证主流程"没坏",但营销配置类页面真正高风险的地方,往往藏在异常输入、边界条件和复杂校验组合里。
多模态 Agent 的价值,不是把脚本换一种写法,而是让系统具备持续感知页面、动态规划路径、执行后反馈修正的能力。目标也从"写自动化脚本"升级为"生成可回放、可审阅、可纳管的高质量测试用例"。
背景:营销中台里的 UI 自动化瓶颈
营销中台在大促节奏下会持续承受高频变化:营销玩法不断迭代,页面结构、按钮文案、表单字段和校验规则都会快速调整。与此同时,配置类核心链路不能因为变化而降低校验完整性,因为配置错误可能直接影响资金链路和商家体验。
典型质量诉求包括两类:一是主链路必须稳定,二是异常与边界场景必须覆盖到位。但传统人工写脚本存在明显产能上限。按照过往经验,单人单模块平均产出有效自动化用例约 10 条/天,且用例往往集中在正向主流程。
高频变更下的配置链路质量压力
| 场景特征 | 具体表现 | 质量影响 |
|---|---|---|
| 高频变更 | 营销玩法随大促节奏迭代,页面结构与文案频繁调整 | 自动化和人工测试都需要快速跟随变化 |
| 配置复杂 | 活动配置表单字段多,校验规则多,控件形态多 | 配置链路容易出现遗漏和异常 |
| 容错要求高 | 配置错误会影响资金与商家体验 | 异常场景和边界场景必须重点覆盖 |
边界覆盖长期存在真空:边界类用例占比不足 30%,配置表单的校验缺失仍大量依赖人工测试。问题主要集中在空填、异常输入、格式错误、非法操作、边界条件和复杂校验组合。
传统 UI 自动化的三重困境
| 困境 | 具体表现 | 后果 | 底层原因 |
|---|---|---|---|
| 维护成本高 | 按钮文案变更、前端组件重构 | 大批脚本失效 | 定位器与实现细节强耦合 |
| 覆盖存在盲区 | 空填、格式错误、非法操作难以穷举 | 边界和异常覆盖不足 | 正向流程占主导 |
| 缺陷发现滞后 | 只能确认链路"没坏" | 难以发现未知问题 | 自动化沦为主流程验证工具 |
根因在于:脚本是"对系统认知的一次性固化",而不是"对系统的持续理解"。人写下的是结论,不是推理过程;页面一变,原先固化的结论就会失效。
因此,真正要解决的是三个问题:
- 机器能否自己看懂页面当前状态
- 机器能否自主决定下一步测什么
- 生成的路径能否直接回放并纳入测试资产
Agent 测试闭环:感知、决策、执行、反馈
多模态 Agent 的核心思路,是把"测试设计"交给系统,让自动化从提前写死脚本,变成持续感知和反馈的闭环。
| 环节 | 作用 |
|---|---|
| 感知 | 识别页面当前状态 |
| 决策 | 判断下一步需要测试什么 |
| 执行 | 按生成路径进行操作 |
| 反馈 | 根据执行结果反哺后续判断 |
这个闭环带来三个关键变化:从人工提前写死脚本,转向 Agent 动态理解页面;从只验证主流程,转向可持续探索异常与边界场景;从一次性固化结论,转向"感知 - 决策 - 执行 - 反馈"的持续迭代。
从脚本回放到 Agent 探索
以"创建双11满件打折活动,并验证活动名称字段校验规则"为例,UI 自动化可以分为三代路线。
三代路线:录制回放、PO 驱动与 Agent 探索
第一代是录制 / 回放,核心方式是所见即所录。
java
click(By.xpath("/html/body/div[3]/div[2]/form/button[1]"));
sendKeys(By.css("#app>div.container>input:nth-child(2)"),
         "双11满件打折");
这种方式对页面结构非常敏感。如果"新建"按钮挪进下拉菜单,只是多包了一层 div,div[3] 整体错位,相关脚本就可能全部失效。
第二代是关键字 / PO 驱动,通过页面对象抽象降低耦合。
java
class ActivityCreatePage {
    By nameInput = By.css("[data-testid=activity-name]");
    void fillName(String s) { ... }
}

page.fillName("双11满件打折");
page.submit();
PO 能提升定位器可维护性,文案变化时只需改一处。但它仍然没有解决"写什么"的问题。留空、超长、时间逆序等边界场景,仍要人工想出并手写。
第三代是 Agent 探索。人只提供目标,不提供路径;模型基于当前页面语义实时生成操作步骤。
yaml
goal: 验证「活动名称」字段的校验规则是否完整
steps:
  - 定位「活动名称」输入框并留空
  - 点击「提交」
- 断言:应出现校验提示| 代际 | 方式 | 核心能力 | 主要问题 |
|---|---|---|---|
| 第一代 | 录制 / 回放 | 所见即所录 | 页面结构轻微变化就可能导致整块脚本失效 |
| 第二代 | 关键字 / PO 驱动 | 通过 PO 抽象降低耦合 | 定位器可维护性提升,但边界场景仍要人工设计 |
| 第三代 | Agent 探索 | 模型基于当前页面实时生成操作路径 | 重点转向探索能力与目标表达 |
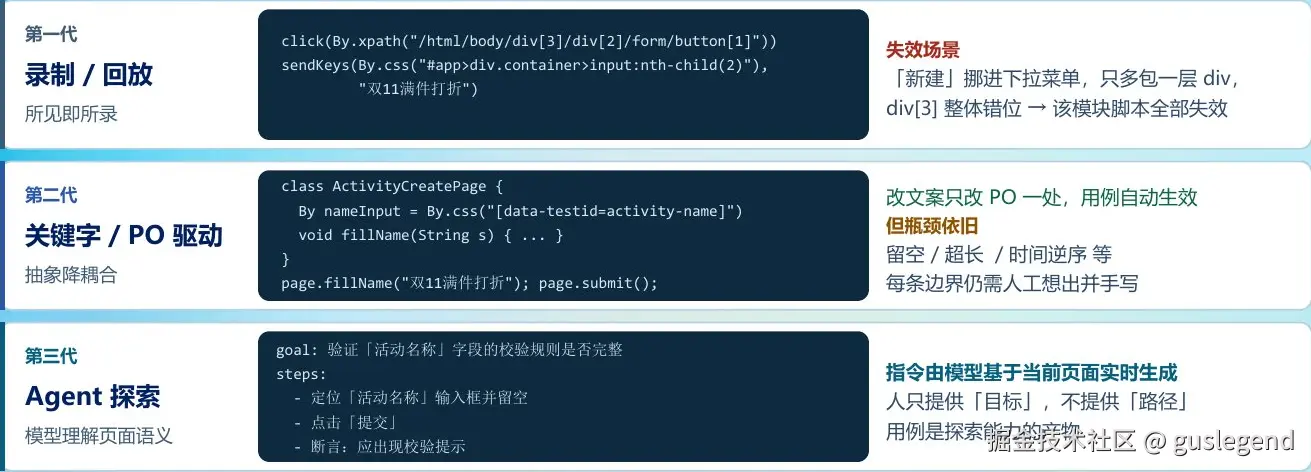
这张对比图把重心变化放在同一个需求上:定位器抽象改善"怎么写",而边界场景仍需要回答"写什么"。
前两代解决的是"怎么写",真正没有解决的是"写什么"。定位器可以抽象,测试设计不能简单抽象。
通用智能体与专用路径规划的差别
通用智能体也可以完成单条边界 case 探索,但差别不在"能不能探索一条",而在能否把探索做成工程能力。
| 对比维度 | 通用智能体 | 路径智能规划 |
|---|---|---|
| 驱动方式 | 人工逐条驱动 | 自主分阶段推进:主链路、边界、发散 |
| 覆盖策略 | 缺少全局覆盖策略 | 面向整模块系统覆盖,专攻校验空白 |
| 收敛机制 | 单次会话,易重复、易跑飞 | 操作 + 路径双层收敛,抑制死循环 |
| 产物形态 | 会话结束即消失 | 可回放、可审阅、可纳入回归资产 |
| 规模化 | 一次一条,难并发 | 可并发批量探索,探索策略可复用 |
通用 Agent 把探索当成一次性任务,专用探索 Agent 要把探索做成可收敛、可规模化、能沉淀资产的工程能力。
把 UI 探索建模为序贯决策问题
UI 探索不能一次规划到底。每一步都要根据当前真实状态决定下一个动作,只能边走边规划。
开环计划的问题很典型:一次输出 10 步计划,如果第 3 步意外弹出确认框,后面 7 步就会全部失效。根因是计划建立在"想象中的页面"上,而不是建立在真实页面上。
STATE、ACTIONS、DECIDE、REWARD 闭环
闭环规划把每一步都当成一次完整决策:观察状态,生成候选动作,选择动作,观测反馈。
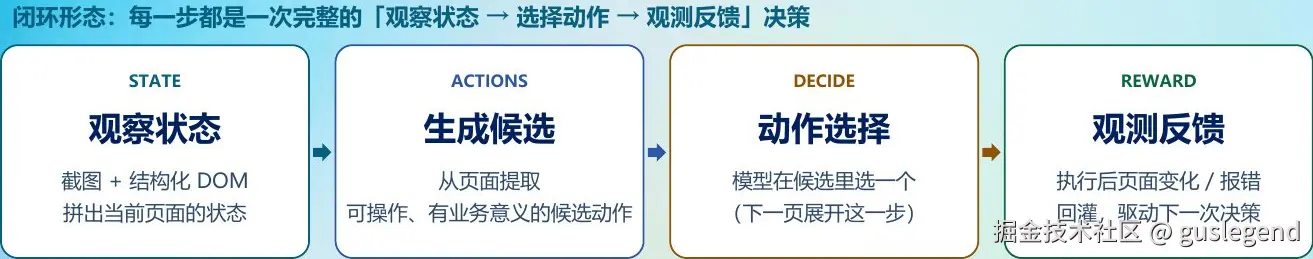
真实页面状态先生成候选动作,再由模型选择并执行;页面变化或报错回灌,下一步据此重新决策。
| 环节 | 中文含义 | 输入 / 依据 | 输出 / 作用 |
|---|---|---|---|
STATE |
观察状态 | 截图 + 结构化 DOM | 拼出当前页面状态 |
ACTIONS |
生成候选 | 从页面提取 | 可操作、有业务意义的候选动作 |
DECIDE |
动作选择 | 候选动作集合 | 模型选择下一步动作 |
REWARD |
观测反馈 | 执行后的页面变化 / 报错 | 回灌结果,驱动下一次决策 |
核心取舍是:用更多次模型调用,换取不会一错到底。UI 状态转移本来就不可预测,开环计划在探索场景中天然脆弱。
动作选择需要目标、现状、经验与约束
动作选择不是随机点击。规划真正做的是四件事:明确意图、感知真实现状、注入领域经验、约束住不跑飞。
| 事情 | 核心含义 | 关键做法 |
|---|---|---|
| 明确意图 | 带着阶段目标选择路线 | 明确主链路、步骤承接、边界校验和验证功能点 |
| 感知真实现状 | 让模型接近真实页面 | 提供截图与加工过滤后的 DOM,并回灌已走步骤 |
| 注入领域经验 | 让用例生成更全面 | 注入业务基础知识、历史用例、业务规则 |
| 约束住不跑飞 | 防止重复或无价值探索 | 回灌轨迹、设置步数上限、无新价值时主动停止 |
选得准不准,取决于喂给模型的信息质量。这部分可以通过工程上下文、业务知识和收敛策略持续优化。
生产级路径规划系统架构
生产级 UI 探索系统可以拆成四层:接入层、调度层、智能规划层和执行层。
| 层级 | 分工定位 | 关键能力 |
|---|---|---|
| 接入层 | 让使用者发起探索 | 起始 URL、规划策略、业务域、探索深度、步骤上限 |
| 调度层 | 把长耗时探索变成可并发、可控的任务 | 异步调度、会话状态管理、并发与配额控制 |
| 智能规划层 | 看懂页面、决定下一步、保证指令可执行 | 多模态决策、结果校验 / 改写、生成 DSL |
| 执行层 | 把决策落到真实浏览器 | Playwright 执行适配、执行结果校验、结果采集 |
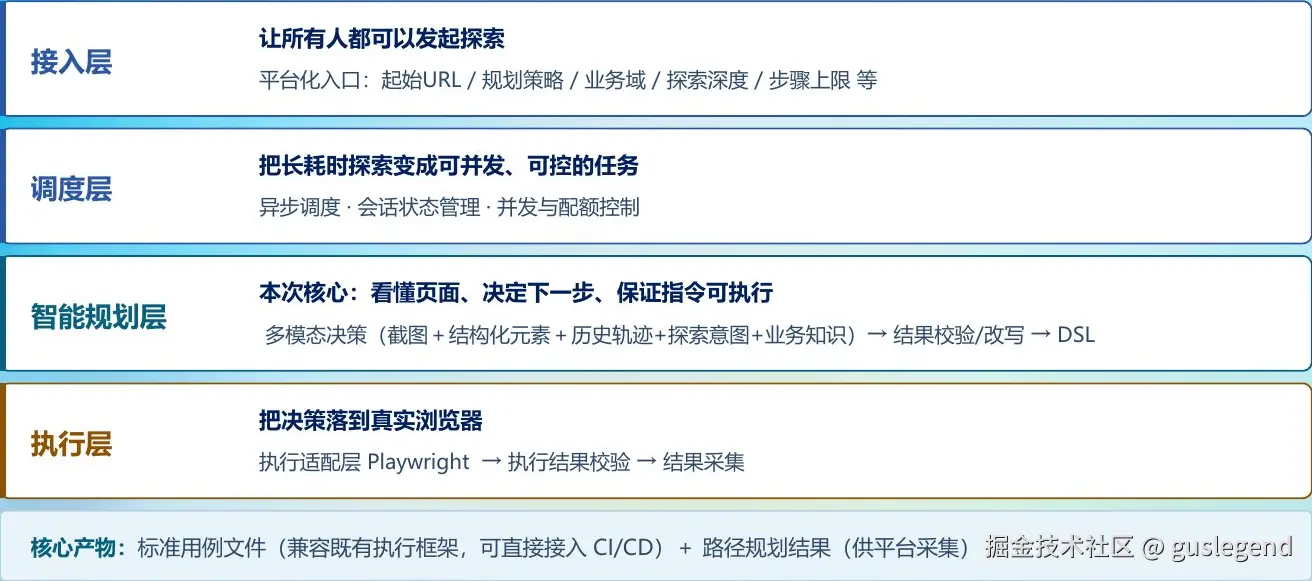
四层分工把发起任务、并发调度、智能规划和浏览器执行串起来,规划层在下发 DSL 前还要校验或改写结果。
系统最终产物不是一段临时会话,而是标准用例文件和路径规划结果。标准用例文件需要兼容既有执行框架,并能接入 CI/CD;路径规划结果则供平台采集、审阅和资产沉淀。
从 Demo 到生产必须跨过的四道坎
Demo 能跑通,不代表生产可用。生产环境中,LLM 提供的是"可能性",工程需要补上"确定性"。每一道坎,本质上都对应一个工程约束,目标是把不确定性收敛到可控范围。
| 坎 | 问题 | 具体表现 |
|---|---|---|
| 坎 1 | 感知失真 | 截图看不到滑块没有滑到的地方,DOM 看不出置灰、红字报错、浮层遮挡 |
| 坎 2 | 指令不可执行 | 语法正确的指令,在真实页面上点不到、填不进 |
| 坎 3 | 探索失控 | 陷入"开弹窗 - 取消 - 再开"的死循环,路径高度重复 |
| 坎 4 | 执行中断 | 定位漂移、意外弹窗、网关抖动导致路径中断 |
感知失真:DOM 出候选,截图判状态
单一信号一定有缺陷:截图看不出元素能不能点,DOM 看不出置灰、红字报错和浮层遮挡。更稳妥的方式是让 DOM、截图和历史轨迹各司其职。
DOM 侧需要通过四级过滤构造候选项。
| 层级 | 过滤 / 增强方式 | 关键判断 |
|---|---|---|
| 1 | 可见性过滤 | rect > 5px、display、opacity |
| 2 | 噪音剔除 | 帮助、FAQ、客服、导航 |
| 3 | 可交互判定 | tag + role + onclick + 子元素探测 |
| 4 | 语义增强 | label 回溯、父级 context、表单约束 |
还需要处理中文空格归一化,并对视口外元素打上 requiresScroll 标记。
| 信号 | 作用 | 提供的信息 |
|---|---|---|
| DOM 结构化元素 | 出候选 | text、label、placeholder、type、required、maxLength、pattern |
| 页面截图 | 判状态 | 布局、遮挡、置灰等视觉证据 |
| 历史操作轨迹 | 防重复 | 已执行指令序列,帮助模型知道已经做过什么 |
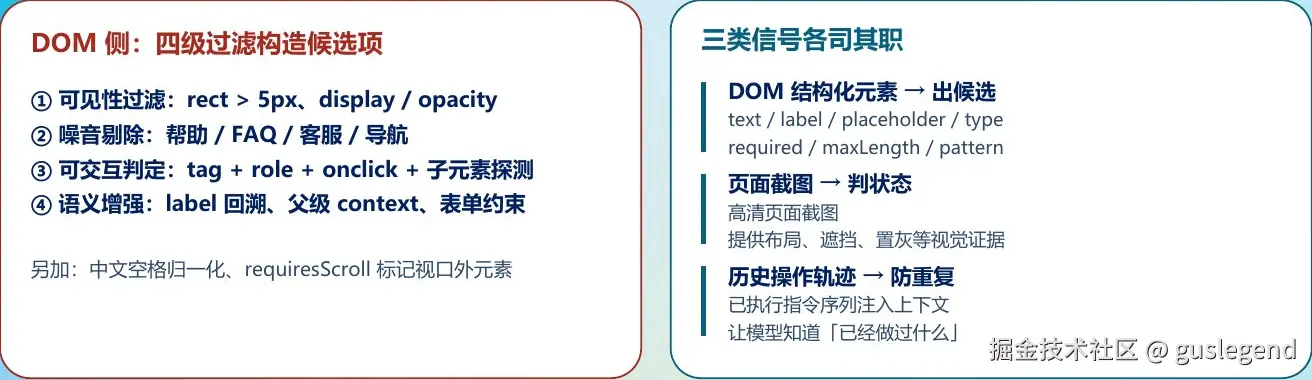
图中左侧是 DOM 候选元素的四级过滤,右侧说明截图负责状态判断、历史轨迹负责防重复。工程化关键是让视觉信号进入结构化上下文,而不是指望模型单纯从图里自己悟出来。
指令不可回放:生成之后还要校验与改写
模型生成的指令语法正确,不代表真实页面可执行。指令下发前必须经过确定性校验和改写。
| 场景 | BAD 指令 | 失败原因 | 工程处理 |
|---|---|---|---|
| 日期控件误用拦截 | 在开始时间输入 2026-01-01 |
日历控件展开时输入无效 | 判定字段 isDatePicker,返回重新规划信号,不下发指令 |
| 视口外自动改写 | 点击视口外的提交按钮 | 元素不在当前视口,直接点击不可执行 | 命中 requiresScroll 标记,改写为滚动到对应元素,并查历史防重复 |
校验流程可以拆成四步:先检查元素类型,再检查视口位置;对不可执行指令进行改写或拦截;最后结合历史轨迹防止重复滚动和重复执行无效路径。
设计原则很明确:不要试图用 prompt 修正一切。凡是能用确定性代码判定的内容,例如元素类型、视口位置,都应该从概率模型手里收回。校验改写层就是模型自由度和工程可靠性之间的缓冲带。
探索失控:分阶段推进与双层收敛
探索不能一开始就完全放开,否则很容易退化为低效重复。更稳妥的方式是先建立标准路径基线,再有控制地探索错误路径和隐藏路径。
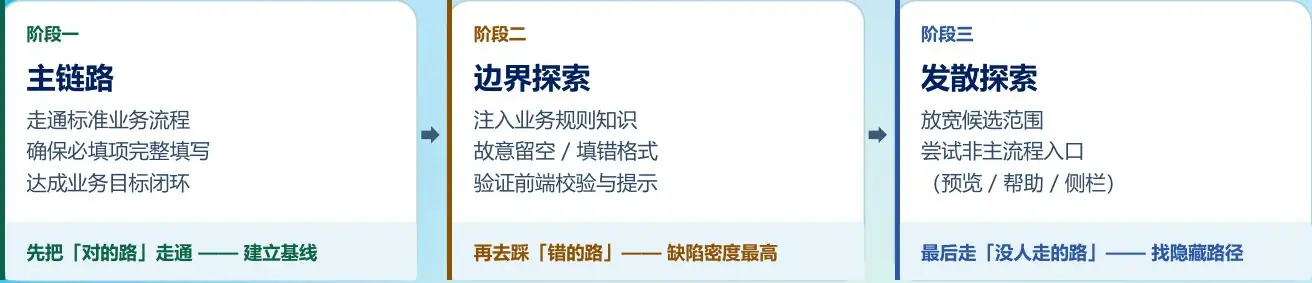
探索先建立可回放的正常路径基线,再验证错误输入和隐藏入口。
| 阶段 | 探索重点 | 具体做法 | 目标 |
|---|---|---|---|
| 阶段一 | 主链路 | 走通标准业务流程,完整填写必填项,达成业务目标闭环 | 先把对的路走通,建立基线 |
| 阶段二 | 边界探索 | 注入业务规则,故意留空、填错格式,验证前端校验与提示 | 再去踩错的路,覆盖高缺陷密度区域 |
| 阶段三 | 发散探索 | 放宽候选范围,尝试预览、帮助、侧栏等非主流程入口 | 最后寻找隐藏路径 |
收敛机制分两层。
操作收敛关注单步重复:把已执行的指令序列注入上下文,让模型显式看到刚才做过什么,并在连续操作之间做相似性判别。
路径收敛关注整体路径重复:对历史规划路径做相似度判定。前置重复操作越多,新操作选择新候选项的比重越大,让探索逐步转向新的可能性。
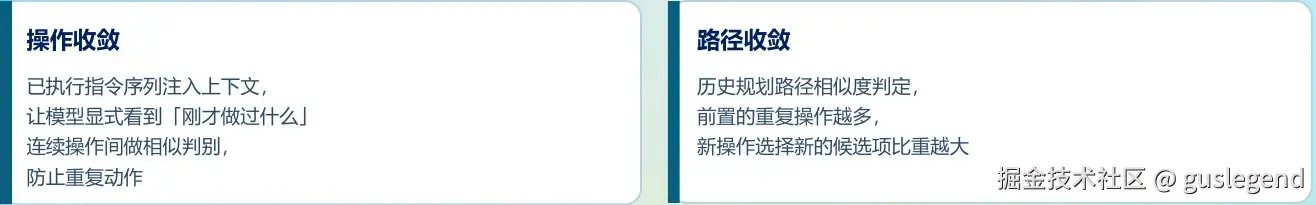
操作层检查连续动作是否重复,路径层比较历史路径相似度;两层共同限制无价值循环。
没有约束的探索会很快陷入死循环,例如反复"打开弹窗 - 点取消 - 再打开"。这种循环会让有效路径占比极低。
执行中断:按失败类型分流自愈
执行中断后不能统一补救,必须先判断失败类型,再决定是否自愈、如何自愈,以及是否终止路径。
可自愈失败的通用流程是:检测失败类型,做对应补救,再重放原指令。
| 失败类型 | 典型原因 | 补救方式 |
|---|---|---|
| 元素不可达 | 元素在视口外,或尚未渲染 | 先语义滚动"滚到看见 X",不行再物理滚动兜底,然后重放 |
| 定位漂移 | 模型描述与页面对不上,或 DOM 已变化 | 重新提取候选,交回规划侧重新规划 |
| 意外阻挡 | 非预期弹窗、遮罩、二次确认框拦住点击 | 识别浮层,先关闭或确认,再重放原指令 |
不可自愈失败要区分基础设施抖动和环境态失效。
| 失败类型 | 典型原因 | 处理方式 |
|---|---|---|
| 基础设施抖动 | 模型网关问题、网络超时 | 调用层重试,并加入退避间隔 |
| 环境态失效 | 前置数据缺失、登录态过期 | 不尝试自愈,直接终止该路径探索并标注原因 |
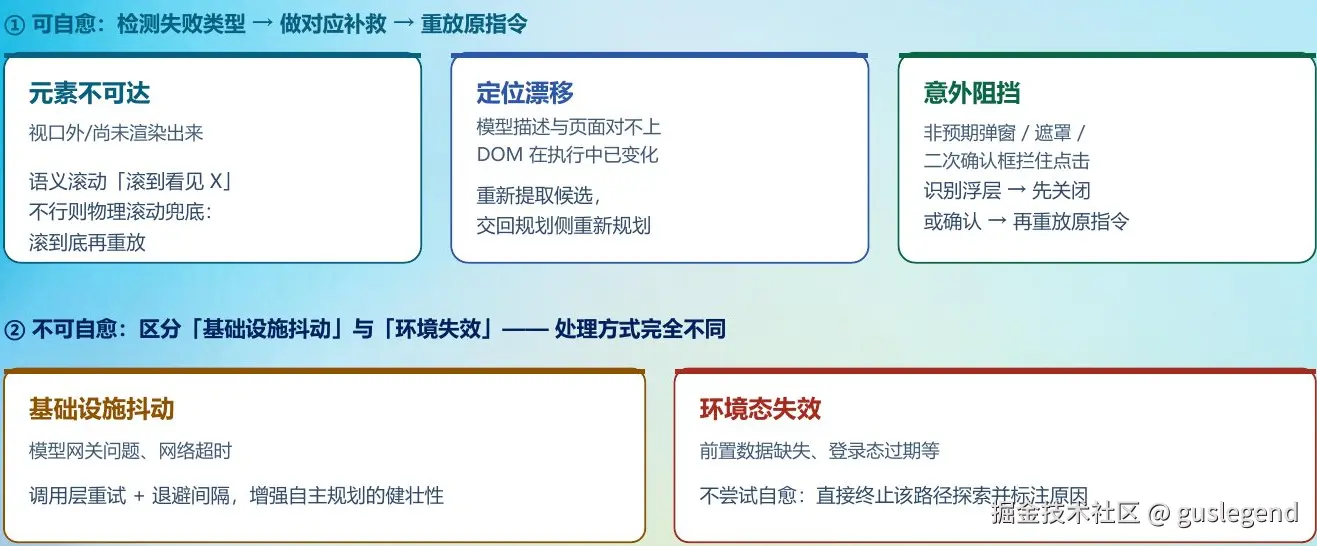
图中将元素不可达、定位漂移、意外阻挡分别交给滚动重放、重新规划和浮层处理;基础设施抖动可重试,环境态失效应终止并标注原因。
复盘:模型自由度要被工程确定性包住
多模态 Agent 能提升探索能力,但不能把判断、终止和质量把控完全交给模型。模型的"自觉"并不可靠,工程系统必须提供规则、上限和产出标准。
失败做法与修正方向
| 踩过的坑 | 现象与代价 | 现在的做法 |
|---|---|---|
靠 prompt 修正一切 |
控件误用、视口外点击反复出现;提示词越写越长仍不稳定 | 可判定的事收回工程,做确定性校验改写 |
| 让模型自己决定何时停止 | 模型持续认为"还需继续",一个表单跑 20+ 步仍在循环 |
硬性步数上限 + 功能完结检测 |
| 只关注跑通,不管产出质量 | 产出无断言、步骤冗余、路径重复,难以进入回归资产 | 先定义产出标准:有断言、步骤精简、去重 |
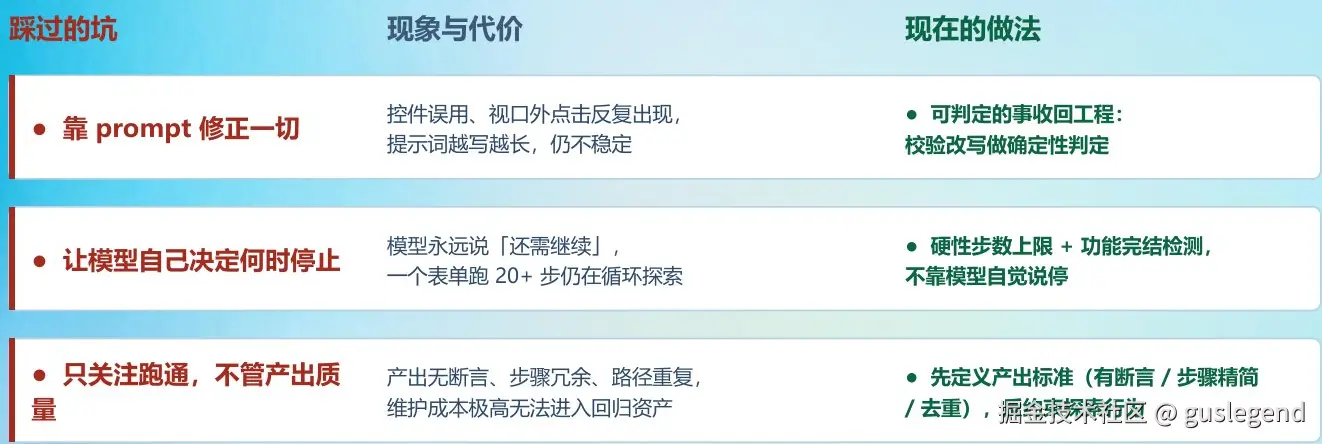
这张复盘表对应三道兜底:用规则处理可判定问题,用上限停止循环,用产出标准保证用例可以进入回归资产。
共同根因是模型无法稳定自我约束。修正方向是三类工程兜底:规则兜判定,上限兜终止,标准兜产出。
后续方向:测新、缺陷模式与主动复检
探索能力可以进一步融入"测新"环节。一次提测不只交付需求验收结果,还可以同时交付边界缺陷清单。
| 维度 | 内容 |
|---|---|
| PRD 说了的 | 按 PRD 生成功能验证用例,跑通主流程,校验预期结果 |
| PRD 没说的 | Agent 探索留空、超长、逆序、异常态,补齐需求文档之外的盲区 |
另一个方向是缺陷模式沉淀与主动复检。一次 bug 不应只停留在单点修复,而要抽象为可迁移模式。例如"日期区间控件 + 结束时间早于开始时间 = 无拦截",可以剥离业务语义,沉淀为"日期逆序"模式,再拿去同类字段和同类控件中主动复检。
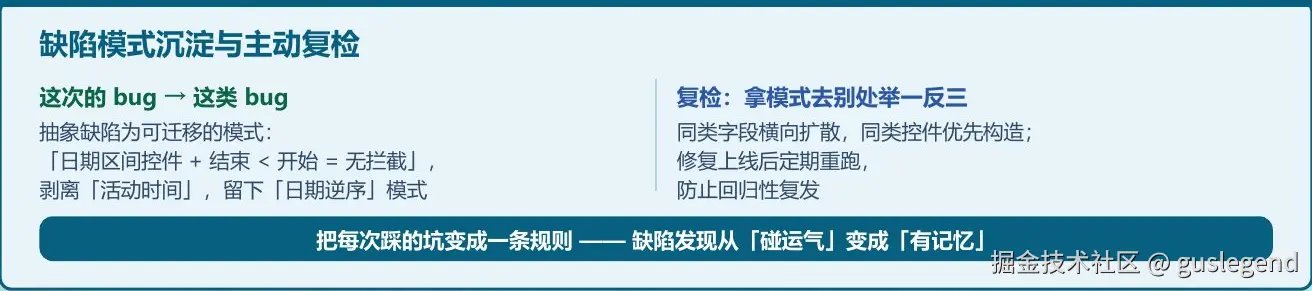
日期逆序的例子说明如何把一次缺陷抽象为跨字段、跨控件可复用的模式,并在修复后定期复检。
这种机制能让缺陷发现从"碰运气"变成"有记忆":每次踩的坑都沉淀为一条规则,修复上线后还能定期重跑,防止回归性复发。
Takeaway:测试设计、探索价值与分层治理
第一,真正的问题不是"怎么写",而是"写什么"。前两代自动化主要解决脚本表达和定位器维护,测试设计仍然依赖人脑穷举。更合理的分工是人定义目标,Agent 规划路径。
第二,自动化的价值不止在回放,还有探索。能确认主流程没坏,不等于能发现问题。Agent 没有人类测试者的先验偏见,因此可能执行一些人认为"不会有人这么干"的操作。
第三,概率与确定性必须分层。模型只适合做不可判定的事;凡是可判定的,都应该通过规则、标准和工程机制固化下来。
结语:让自动化从回放工具变成有记忆的探索系统
基于多模态 Agent 的 UI 自动化路径规划,关键不在于让模型替人点页面,而在于重构测试设计方式:人定义目标,系统感知状态,Agent 规划路径,工程约束负责校验、收敛和资产化。
当前可核对的基线是人工有效用例约 10 条/天、边界用例占比不足 30%。系统投入后的覆盖率、缺陷检出率和执行成本未给出量化对比,需要用真实回归数据验证提升幅度。
当自动化具备感知、决策、执行和反馈闭环后,它就不再只是主流程回放工具,而可以成为持续发现边界问题、沉淀缺陷模式、反哺回归验证的探索系统。真正的跃迁,是从"脚本能不能跑"走向"系统能不能持续理解、持续探索、持续生成高质量用例"。