AI 写代码越来越普遍之后,我反而觉得 Git 比过去更重要了。
以前自己写代码,改动范围心里有底;现在一句话下去,AI 可能一次改掉几十个文件,出问题的时候如果没有任何版本记录,排查成本会高得离谱。没有版本控制的 AI 编程等于开盲盒。
这篇文章用一个"待办清单"小项目,把 Git 的核心工作流系统走一遍,共四部分:安装、存档与回滚、分支与合并、GitHub 操作。
一、概念先行:本地软件 + 远端网站
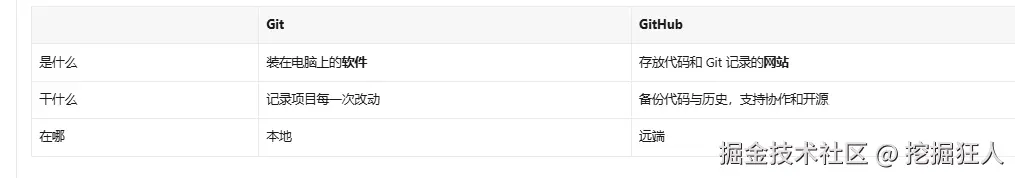
先把这一层分清楚,后面就不会有"我以为备份了其实没有"的尴尬。
二、安装:让 Agent 代劳是最快的
如果你在用 Codex / Claude Code 之类的编程 Agent,直接让它帮你装是最省事的路径,它会自己检测环境、自己跑安装、装完告诉你结果。已经装过的话它会检测到并跳过。 手动安装: 1.** Windows**:官网下载安装包 → 一路 Next → 关掉 View Release Notes 选项(那个只是展示发布记录,没什么价值)→ 完成后在开始菜单打开 Git Bash → git --version 验证。 2.** macOS**:终端执行 git --version,很多软件会顺带装上 Git。如果提示需要 Xcode Command Line Tools,按提示安装并同意协议;这套工具包含编译器和调试工具,做开发早晚要装。装完再次 git --version 即可。
三、初始化与三个区域
项目文件夹/ ├── index.html ┐
├── README.md ┘ → 工作区(working directory / working tree)
└── .git/ → 暂存区(staging area / index)+ 提交历史
git init 在当前目录创建 .git 文件夹,项目从此具备版本管理能力。.git 文件夹本身是隐藏的,建议保持隐藏------日常用不到,显示出来只会让文件列表变乱。
提交分两步:
-
git add index.html # 工作区 → 暂存区(支持一次加多个文件)
-
git commit -m "添加待办页面" # 暂存区 → 提交历史,生成一个 commit
暂存区存在的意义是什么? 允许你一点点挑选这次要提交的内容。前面例子里只提交 index.html,暂存区的作用看不出来;但如果重构之后多出一堆文件,你就可以先挑 index.html,再挑 JS/CSS,全部确认后再统一提交。
提交前配置身份(一台机器设一次):
-
git config --global user.name "mark"
-
git config --global user.email "mark@example.com"
这不是登录,只是告诉 Git 提交人是谁,会写进 commit,不做校验,填个合适的即可。
验证结果:
- git status # 看当前状态
- git log # 看提交历史
- git log --oneline # 每条 commit 一行,commit 多时更清爽
.gitignore 则用来忽略不想纳入版本管理的文件:新建一个 .gitignore,把文件名写进去即可(比如 macOS 自动生成的 .DS_Store)。被忽略的文件不会被删除,只是不再出现在 git status 里。这个文件本身属于项目的一部分,应该提交上去,这样换台电脑继续开发时规则还在。
四、回滚:按改动所处阶段选命令
① 改动只在工作区(changes not staged for commit):
- git restore . # 当前目录所有改动
- git restore index.html # 指定文件
git status 的输出里 working tree clean 表示工作区没有改动,说明回滚生效。
②** 已经 add 进暂存区**(changes to be committed)------两步:
- git restore --staged . # 从暂存区撤下(onstage 的反操作)
- git restore . # 再从工作区撤掉
注意:只执行第一步时,文件内容是没变的,只是 Git 那边的记录状态变了。
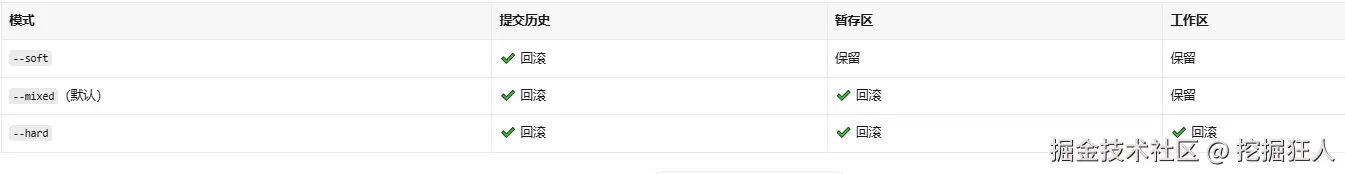
③ 已经提交成 commit: git reset --hard HEAD~1 # HEAD 指最新 commit,~1 是它前面那个;三区域一起回滚
--hard 很彻底,工作区里其他未提交的改动也会一起消失。执行前务必先 git status 看一眼。
git reset 三种模式对比:
还有一种思路是不删 commit,而是加一个反向 commit:
git revert HEAD
它会自动把工作区改回去(等于帮你按了几次撤销键),然后提交成一个新 commit。原 commit 保留在历史中,哪天想恢复那个功能还能找回来。命令会弹出一个 vim 界面让你编辑 commit 说明,直接 :wq 保存退出即可,默认说明已经写得很准确(Revert "xxx" + 被回滚的 commit ID),以 # 开头的行都是注释会被忽略。
五、分支与合并
分支本质上是贴在 commit 上的标签 ,每提交一次就往前挪一步,git log 展示的就是当前分支的提交历史。 为什么要开分支? 一个功能往往要几个 commit 才能做完,如果直接在 master 上提交,中间那些半成品的 commit 也进了主分支。而 master/main 在 Git 里是特殊分支,通常被视为项目主分支,大家默认它是稳定可用的。半成品放上去,用户点到未完成的按钮就会报错。
- git switch -c feature/due-date # 创建 + 切换,等价于两条命令合并
- git branch # 列出所有分支,带 * 的是当前分支
注意:创建分支和切换分支是两件事,git branch 只创建不切换。git switch -c 是现在的推荐写法,git checkout -b 是更老的等价写法,但 checkout 职责太杂,知道它在干什么就行,自己用建议 switch -c。 新分支从 master 最新 commit 岔出,两边指向同一 commit,代码完全一样。真正的区别要等你提交新 commit 才显现。
合并:
- git switch master
- git merge feature/due-date
冲突处理流程:
git
# 打开冲突文件,删除 <<<<<<< ======= >>>>>>> 三行标记,改成最终想要的内容
git add .
git commit -m "合并 feature/complete-all,解决冲突"
git status 会贴心地给出提示:先解决冲突再 git commit;不想合了可以 git merge --abort 放弃。
为什么两次合并的步骤不一样? 第一次是 fast-forward(快进),排序分支就接在 master 当前位置后面,master 直接挪过去即可,不产生新 commit。第二次 master 已经往前走了,全部完成分支从更早的位置岔出,直接挪会把排序功能弄丢,所以 Git 新建一个 commit 把两边合起来------没冲突时自动提交,有冲突时等你处理完手动提交。
六、Rebase:主动让冲突早暴露
功能开发周期长、commit 多,最后一刻才合并的话,冲突可能一堆,甚至发现实现思路跟主分支完全不兼容。更好的做法是开发过程中定期把自己的分支挪到 master 最新位置后面:
- git rebase master
rebase 是"重新换地基":不是整体搬运,而是把分支上的 commit 逐个在新地基上重做一遍。中途冲突:
- git add .
- git rebase --continue # 注意:rebase 场景下不是 git commit
完成后会显示 Successfully rebased,剩下的 commit 自动继续搬。之后再合回 master,通常就是一次快进,无需额外 commit。 好处很明确:没做完的代码始终留在自己分支上,不污染主分支;master 的新代码随时能拿到;冲突早早暴露、当场解决。
七、Stash:临时把半成品收起来
开发到一半需要切分支处理别的事时,会报 Your local changes would be overwritten------因为切分支时 Git 要改写工作区文件,你未提交的改动会被覆盖,所以它停下来让你自己决定。
Git 给了两条路:commit changes(但那意味着提交半成品,不理想)或 stash。
perl
git stash        # 把工作区和暂存区未提交的改动整体挪进 stash
git stash pop    # 用完再取回工作区
.git 里除了暂存区和提交历史,还有一块专放临时改动的区域叫 stash。执行后 git status 显示 nothing to commit, working tree clean,文件也回到上一次提交的样子。输出里的 index 指暂存区,WIP 是 Work In Progress,即未提交的改动。
stash 适合"临时打断一下、很快回来"的场景。如果要同时开发多个分支,频繁 stash / stash pop 就很折腾,这时该用下一节的 worktree。
八、Worktree:一个仓库,多个工作目录
问题根源是只有一个项目目录,同一时刻只能放一条分支的代码。既然如此,再开一个目录就行:
- git worktree add ../项目统计 -b feature/statistics master
拆开看两个要素:基于 master 创建 feature/statistics 分支;工作目录放在上级目录的 项目统计 文件夹里。
git worktree list
小提示:git worktree list 打印路径时会把中文转义成八进制编码,这是历史遗留问题,先执行 git -c core.quotepath=false ... 之类的方式关闭转义即可正常显示。
核心概念: 每个 worktree 都有独立的工作区和暂存区,但所有 worktree 共用同一份提交历史。在哪个目录提交 commit,另一个目录马上就能看到。这也是它跟"直接复制一份文件夹"最大的区别------复制出来的是两个各自独立的仓库,一边提交另一边完全不知道。 用完要删掉时不要直接拖进废纸篓,因为 Git 那边还存着这个目录的记录,需要用命令一起清理:
- git worktree remove ../项目统计
九、GitHub:远端备份
SSH Key 配置:GitHub 已不支持账号密码推送,目前常用 SSH Key。它是一对文件------私钥留在本地绝不外发,公钥交给 GitHub。推送时你的电脑用私钥生成一个签名,GitHub 用公钥验证,能对上就确认是你本人操作。
- ssh-keygen -t rsa -C "你的邮箱"
生成过程中会问两个问题,都直接回车即可(路径用默认,密码可留空,个人电脑不设也没关系)。然后复制公钥内容:
- cat ~/.ssh/id_rsa.pub
到 GitHub → Settings → SSH and GPG keys → New SSH key,粘贴保存。测试连接:
- ssh -T git@github.com
第一次会问是否信任这台主机,输入 yes 回车,看到成功提示就配好了。
创建仓库并推送 :GitHub 上 New repository,填仓库名(不能用中文,中文可以写在 Description 里),选 Public 或 Private,三个初始化选项都不勾选(我们是要推已有仓库上去,不需要它额外生成文件)。创建后页面会给"push an existing repository from the command line"的提示,照着执行:
perl
git remote add origin git@github.com:用户名/仓库名.git
# 第二条把 master 改名成 main 的命令按需跳过
git push -u origin master
origin 只是给远端地址起的习惯性名字,取别的也行。-u 把本地 master 与远端绑定,以后直接 git push 即可。
推送成功后刷新页面,能看到三个项目文件、README 内容和完整的 commit 记录------推上去的不仅是文件,而是整个 Git 历史。之后本地 git status 会显示 Your branch is ahead of origin/master by N commits,提示你该推送了;推送完变成 up to date with origin/master。
日常四步: 改代码 → git add → git commit → git push。
验证备份: 删掉本地文件夹,然后 git clone git@github.com:用户名/仓库名.git 项目名,历史与文件全部回来。
小结
| 操作 | 命令 |
|---|---|
| 初始化 | git init |
| 查看状态 / 历史 | git status / git log --oneline |
| 存档 | git add + git commit -m |
| 回滚(工作区) | git restore . |
| 回滚(暂存区) | git restore --staged . + git restore . |
| 回滚(提交历史) | git reset --hard HEAD~1 / git revert HEAD |
| 分支 | git switch -c 名字 / git branch |
| 合并 | git merge 分支名 |
| 换地基 | git rebase master / git rebase --continue |
| 临时收起 | git stash / git stash pop |
| 多目录 | git worktree add / git worktree remove |
| 远端 | git remote add origin / git push -u origin master / git clone |