Nginx监控配置及管理
-
- [4、 监控工具Prometheus](#4、 监控工具Prometheus)
- 5、监控工具Zabbix
-
- 5.1、Zabbix简介
- 5.2、Zabbix环境搭建
- [5.3、Zabbix Agent安装](#5.3、Zabbix Agent安装)
- 5.4、Zabbix获取Prometheus数据
4、 监控工具Prometheus
Nginx的ngx_http_stub_status_module模块及第三方的主机状态监控模块都提供了自身状态数据的统计和输出功能,但作为监控管理,仍需要进一步实现对各种状态数据的收集、存储、统计展示、阈值报警等工作。为实现监控管理的完整性,需要使用更专业的监控工具来实现后续的工作。
4.1、Prometheus简介
Prometheus是由SoundCloud开源的监控告警解决方案,其在GitHub上的Star数已经超过3.1万,已成为很多大公司首选的监控解决方案。Prometheus由Prometheus Server、PushGateway、Alertmanager、Exporter等4个组件共同组成。其中,Exporter可以由用户自行开发,只需输出符合Prometheus的规范数据即可;Prometheus Server提供了api接口并支持自定义的PromQL查询语言对外实现监控数据查询输出,结合Grafana强大的图形模板功能,可以非常直观地以监控数据统计图表的形式进行展示。Prometheus结构如图所示。
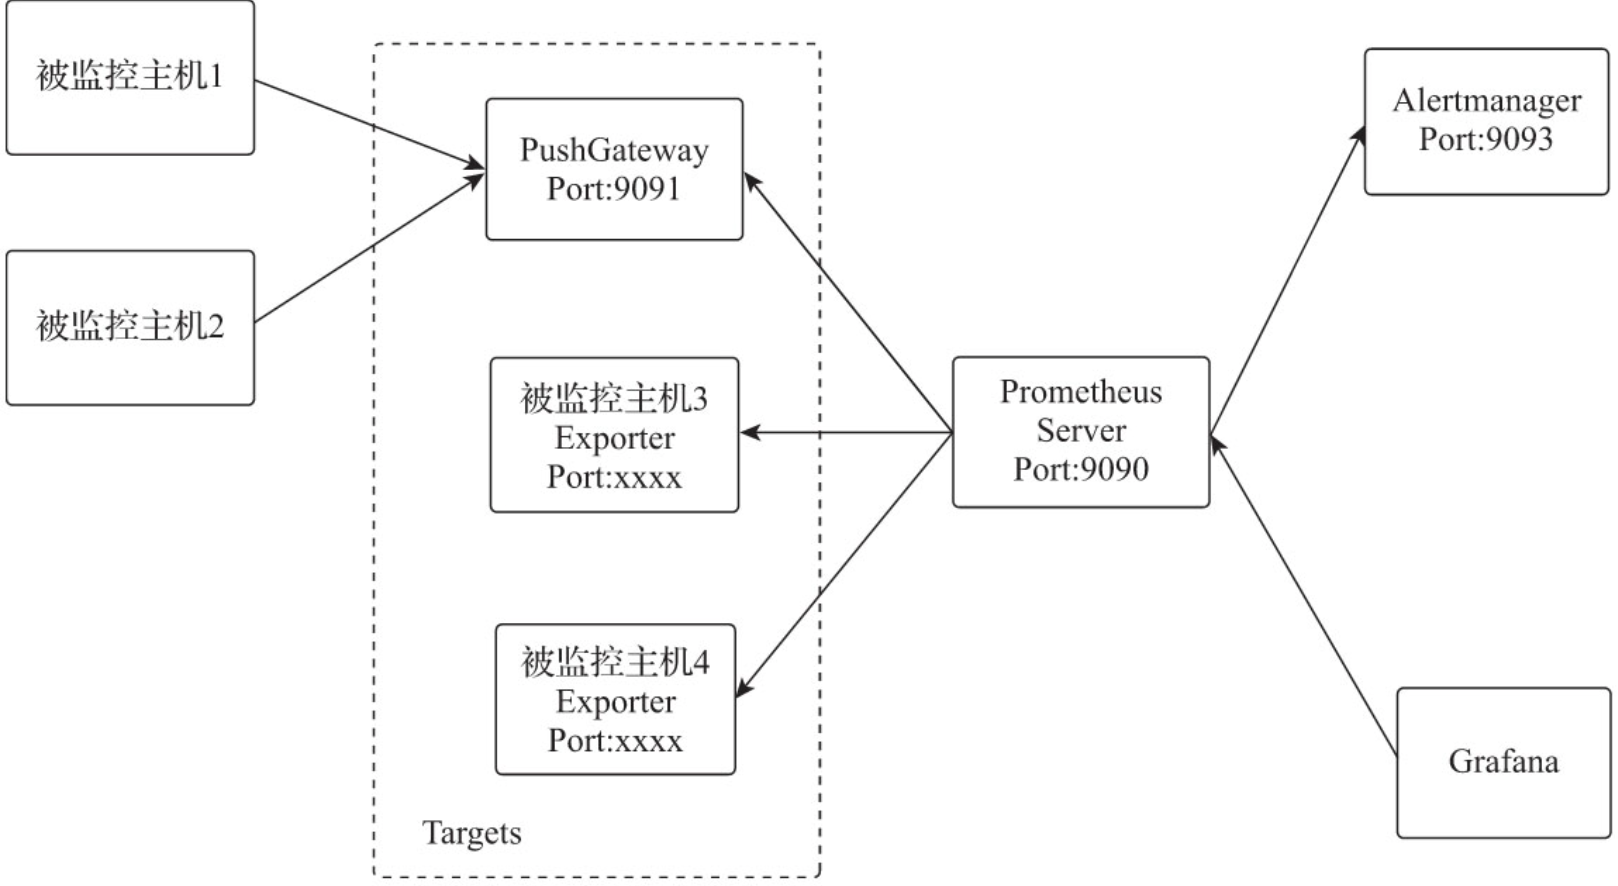
- Prometheus Server: Prometheus的基础服务,其从配置文件中job配置的tagrets目标服务器拉取监控数据,拉取数据周期由配置参数scrape_interval设置,同时开放api接口提供监控数据的对外查询和聚合分析功能。
- PushGateway: Prometheus的推送网关服务。Prometheus默认都是从被监控服务器上拉取监控数据的,但由于网络原因无法直接访问目标服务器时,可在被监控服务器上通过脚本或工具采集监控数据,然后推送给推送网关服务(PushGateway),Prometheus的基础服务则实时地从推送网关服务提供的端口9091拉取监控数据,完成监控操作。
- Alertmanager: Prometheus的告警服务,其对外开放端口9093接收Prometheus Server发送的告警信息,并按照告警规则将告警信息发送给接收目标。
- Exporter:监控数据采集接口服务,该服务可由用户按照Prometheus的数据规范自行开发,只需提供对外访问接口,并能输出Prometheus数据格式的监控数据即可。
4.2、Prometheus部署
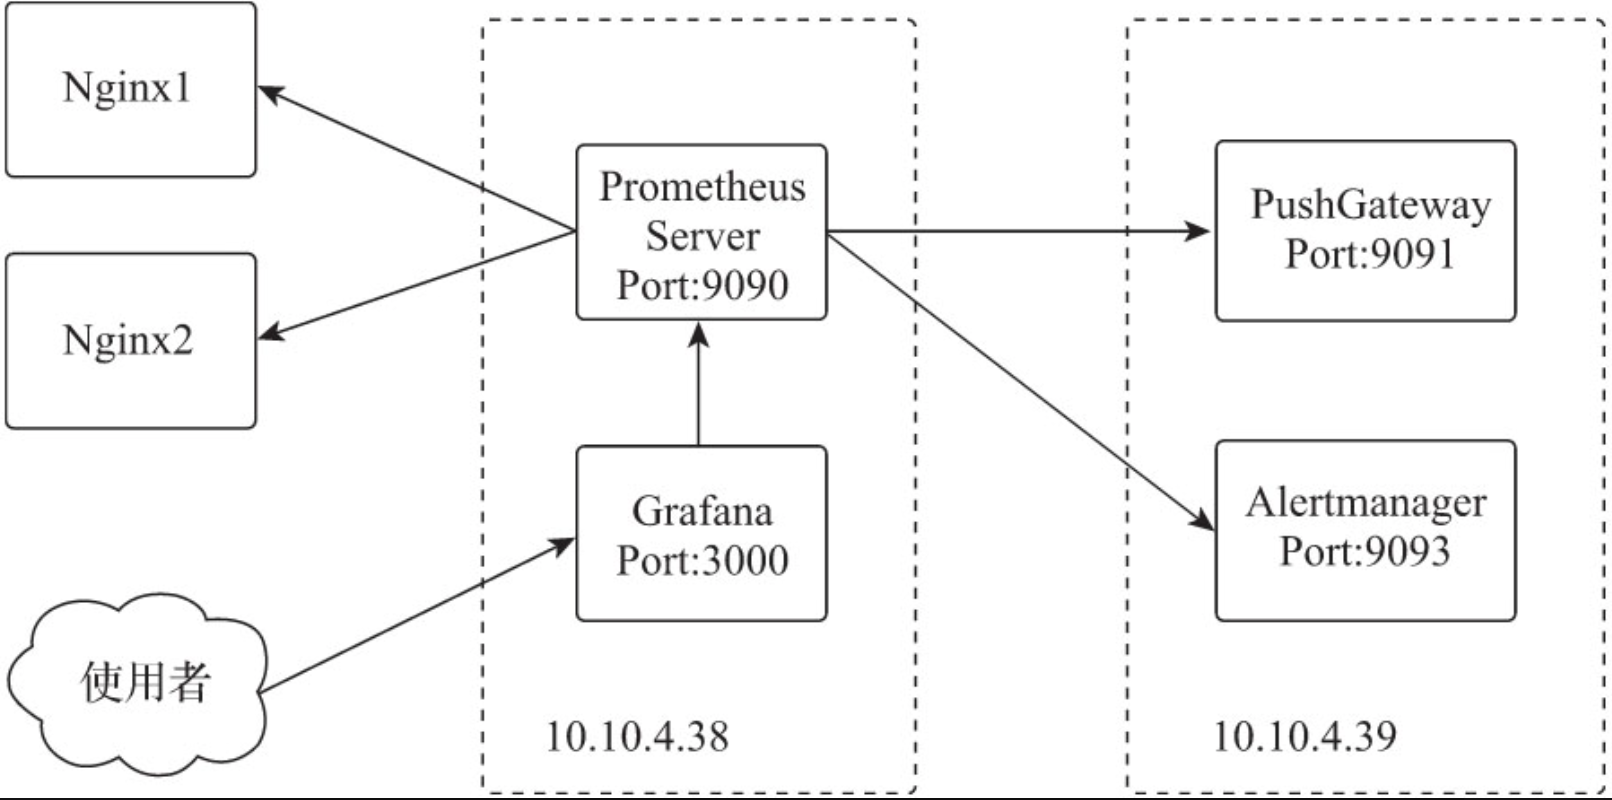
Prometheus支持多种方式部署,鉴于Docker化部署的便捷性,此处选择基于docker-compose脚本部署Docker化的Prometheus环境,部署示意如图所示。
-
在服务器10.10.4.38上部署Prometheus的基础服务和Grafana服务。
-
在服务器10.10.4.39上部署Prometheus的推送网关服务和Prometheus的告警服务。
-
(1)安装Prometheus和Grafana
在服务器10.10.4.38上初始化Prometheus和Grafana的docker-compose脚本。
bashcat>prometheus.yaml<<EOF version: '3.5' services: prometheus: hostname: prometheus container_name: prometheus restart: always image: prom/prometheus ports: - "9090:9090" stop_grace_period: 1m grafana: hostname: grafana container_name: grafana restart: always image: grafana/grafana ports: - "3000:3000" stop_grace_period: 1m EOF # 启动镜像 docker-compose -f prometheus.yaml up -d -
(2)配置Prometheus
配置Prometheus并持久化Prometheus及Grafana数据。
bashcd /opt/data/apps mkdir -p {prometheus,grafana} # 复制配置文件 docker cp prometheus:/etc/prometheus prometheus/prometheus # 复制监控数据文件 docker cp prometheus:/prometheus prometheus/prometheus_data # 配置Alertmanager服务器地址 sed -i "s/# - alertmanager:9093/ - 10.10.4.39:9093/g" prometheus/prometheus/prometheus.yml # 配置告警规则文件目录 sed -i "/rule_files:/a\ - /etc/prometheus/*.rules" prometheus/prometheus/prometheus.yml # 配置PushGateway地址 cat>>prometheus/prometheus/prometheus.yml<<EOF - job_name: pushgateway # 监控job名称,全局唯一 static_configs: - targets: ['10.10.4.39:9091'] # 被监控主机的IP及Exporter的端口 labels: instance: pushgateway # 被监控主机的标识,多为主机名或docker实例名称 EOF # 设置目录权限 chown -R 65534:65534 prometheus/* # 复制Grafana配置文件 docker cp grafana:/etc/grafana grafana/config # 复制Grafana数据文件 docker cp grafana:/var/lib/grafana grafana/data # 设置目录权限 chown -R 472:472 grafana/* # 修改docker-compose脚本 cat>prometheus.yaml<<EOF version: '3.5' services: prometheus: hostname: prometheus container_name: prometheus restart: always image: prom/prometheus ports: - "9090:9090" volumes: - /etc/localtime:/etc/localtime:ro - /opt/data/apps/prometheus/prometheus:/etc/prometheus - /opt/data/apps/prometheus/prometheus_data:/prometheus stop_grace_period: 1m grafana: hostname: grafana container_name: grafana restart: always image: grafana/grafana ports: - "3000:3000" volumes: - /etc/localtime:/etc/localtime:ro - /opt/data/apps/grafana/config:/etc/grafana - /opt/data/apps/grafana/data:/var/lib/grafana stop_grace_period: 1m EOF # 重建并运行镜像 docker-compose -f prometheus.yaml up -d- 通过浏览器访问http://10.10.4.38:9090/targets,就可以看到Prometheus和PushGateway这两个Endpoint。
- 通过浏览器访问Grafana Web管理页面http://10.10.4.38:3000,初始用户名和密码都是admin。
-
(3)安装Alertmanager和PushGateway
在服务器10.10.4.39上初始化Alertmanager和PushGateway的docker-compose脚本。
bashcat>prometheus.yaml<<EOF version: '3.5' services: alertmanager: hostname: alertmanager container_name: alertmanager restart: always image: prom/alertmanager ports: - "9093:9093" stop_grace_period: 1m pushgateway: hostname: pushgateway container_name: pushgateway restart: always image: prom/pushgateway ports: - "9091:9091" stop_grace_period: 1m EOF # 运行镜像 docker-compose -f prometheus.yaml up -d -
(4)配置Alertmanager
配置Alertmanager并持久化Alertmanager及PushGateway数据。
bashcd /opt/data/apps mkdir -p prometheus # 复制Alertmanager配置文件 docker cp alertmanager:/etc/alertmanager prometheus/alertmanager # 复制Alertmanager数据文件 docker cp alertmanager:/alertmanager prometheus/alertmanager_data # 配置目录权限 chown -R 65534:65534 prometheus/alertmanager chown -R 65534:65534 prometheus/alertmanager_data # 配置prometheus.yaml cat>prometheus.yaml<<EOF version: '3.5' services: alertmanager: hostname: alertmanager container_name: alertmanager restart: always image: prom/alertmanager ports: - "9093:9093" volumes: - /etc/localtime:/etc/localtime:ro - /opt/data/apps/prometheus/alertmanager:/etc/alertmanager - /opt/data/apps/prometheus/alertmanager_data:/alertmanager stop_grace_period: 1m pushgateway: hostname: pushgateway container_name: pushgateway restart: always image: prom/pushgateway ports: - "9091:9091" volumes: - /etc/localtime:/etc/localtime:ro EOF # 重建并运行镜像 docker-compose -f prometheus.yaml up -d- 通过浏览器访问http://10.10.4.39:9093,可以查看Alertmanager的告警信息及配置。
- 通过浏览器访问http://10.10.4.39:9091,可以查看PushGateway的相关信息。
4.3、监控HTTP主机状态
Prometheus针对被监控主机,是通过轮询Exporter接口的形式获取监控数据的,nginx-module-vts模块虽然也提供Prometheus数据格式输出,但数据并不详细,推荐使用nginx-vts-exporter实现Prometheus数据输出。nginx-vts-exporter是由Go语言开发的,不仅提供了针对信息的监控数据,还提供了配套的Grafana模板。
-
(1)在Nginx服务器上安装nginx-vts-exporter
bash# 获取nginx-vts-exporter二进制文件 wget https://github.com/hnlq715/nginx-vts-exporter/releases/download/v0.10.3/nginx-vts-exporter-0.10.3.linux-amd64.tar.gz tar zxmf nginx-vts-exporter-0.10.3.linux-amd64.tar.gz cp nginx-vts-exporter-0.10.3.linux-amd64/nginx-vts-exporter /usr/local/nginx/sbin/ # 运行测试 nginx-vts-exporter -nginx.scrape_timeout 10 -nginx.scrape_uri http://127.0.0.1: 8080/vts/format/json curl http://127.0.0.1:9913/metrics -
(2)将nginx-vts-exporter配置为进程服务
bash# 安装supervisor yum install supervisor # 配置nginx-vts-exporter服务管理配置 cat>/etc/supervisord.d/nginx-vts-exporter.ini<<EOF [program:nginx-vts-exporter] ;配置进程运行命令 command=/usr/local/nginx/sbin/nginx-vts-exporter -nginx.scrape_timeout 10 -nginx.scrape_uri http://127.0.0.1:8080/vts/format/json directory=/usr/local/nginx/sbin ;进程运行目录 startsecs=5 ;启动5秒后没有异常退出表示进程正常启动,默认为1秒 autostart=true ;在supervisord启动的时候也自动启动 autorestart=true ;程序退出后自动重启 EOF # 启动supervisord并配置为开机运行 systemctl start supervisord systemctl enable supervisord # nginx-vts-exporter进程服务管理 # 查看nginx-vts-exporter进程服务状态 supervisorctl status nginx-vts-exporter # 重启nginx-vts-exporter进程服务 supervisorctl restart nginx-vts-exporter # 启动nginx-vts-exporter进程服务 supervisorctl start nginx-vts-exporter # 停止nginx-vts-exporter进程服务 supervisorctl stop nginx-vts-exporter # 访问测试 curl http://10.10.4.8:9913/metrics -
(3)在Prometheus上配置监控job
bashcd /opt/data/apps cat>>prometheus/prometheus/prometheus.yml<<EOF # nginx-vts-exporter job - job_name: nginx_exporter static_configs: - targets: ['10.10.4.8:9913'] labels: instance: nginx-1 EOF docker restart prometheus -
(4)导入Grafana模板实现图表化展示
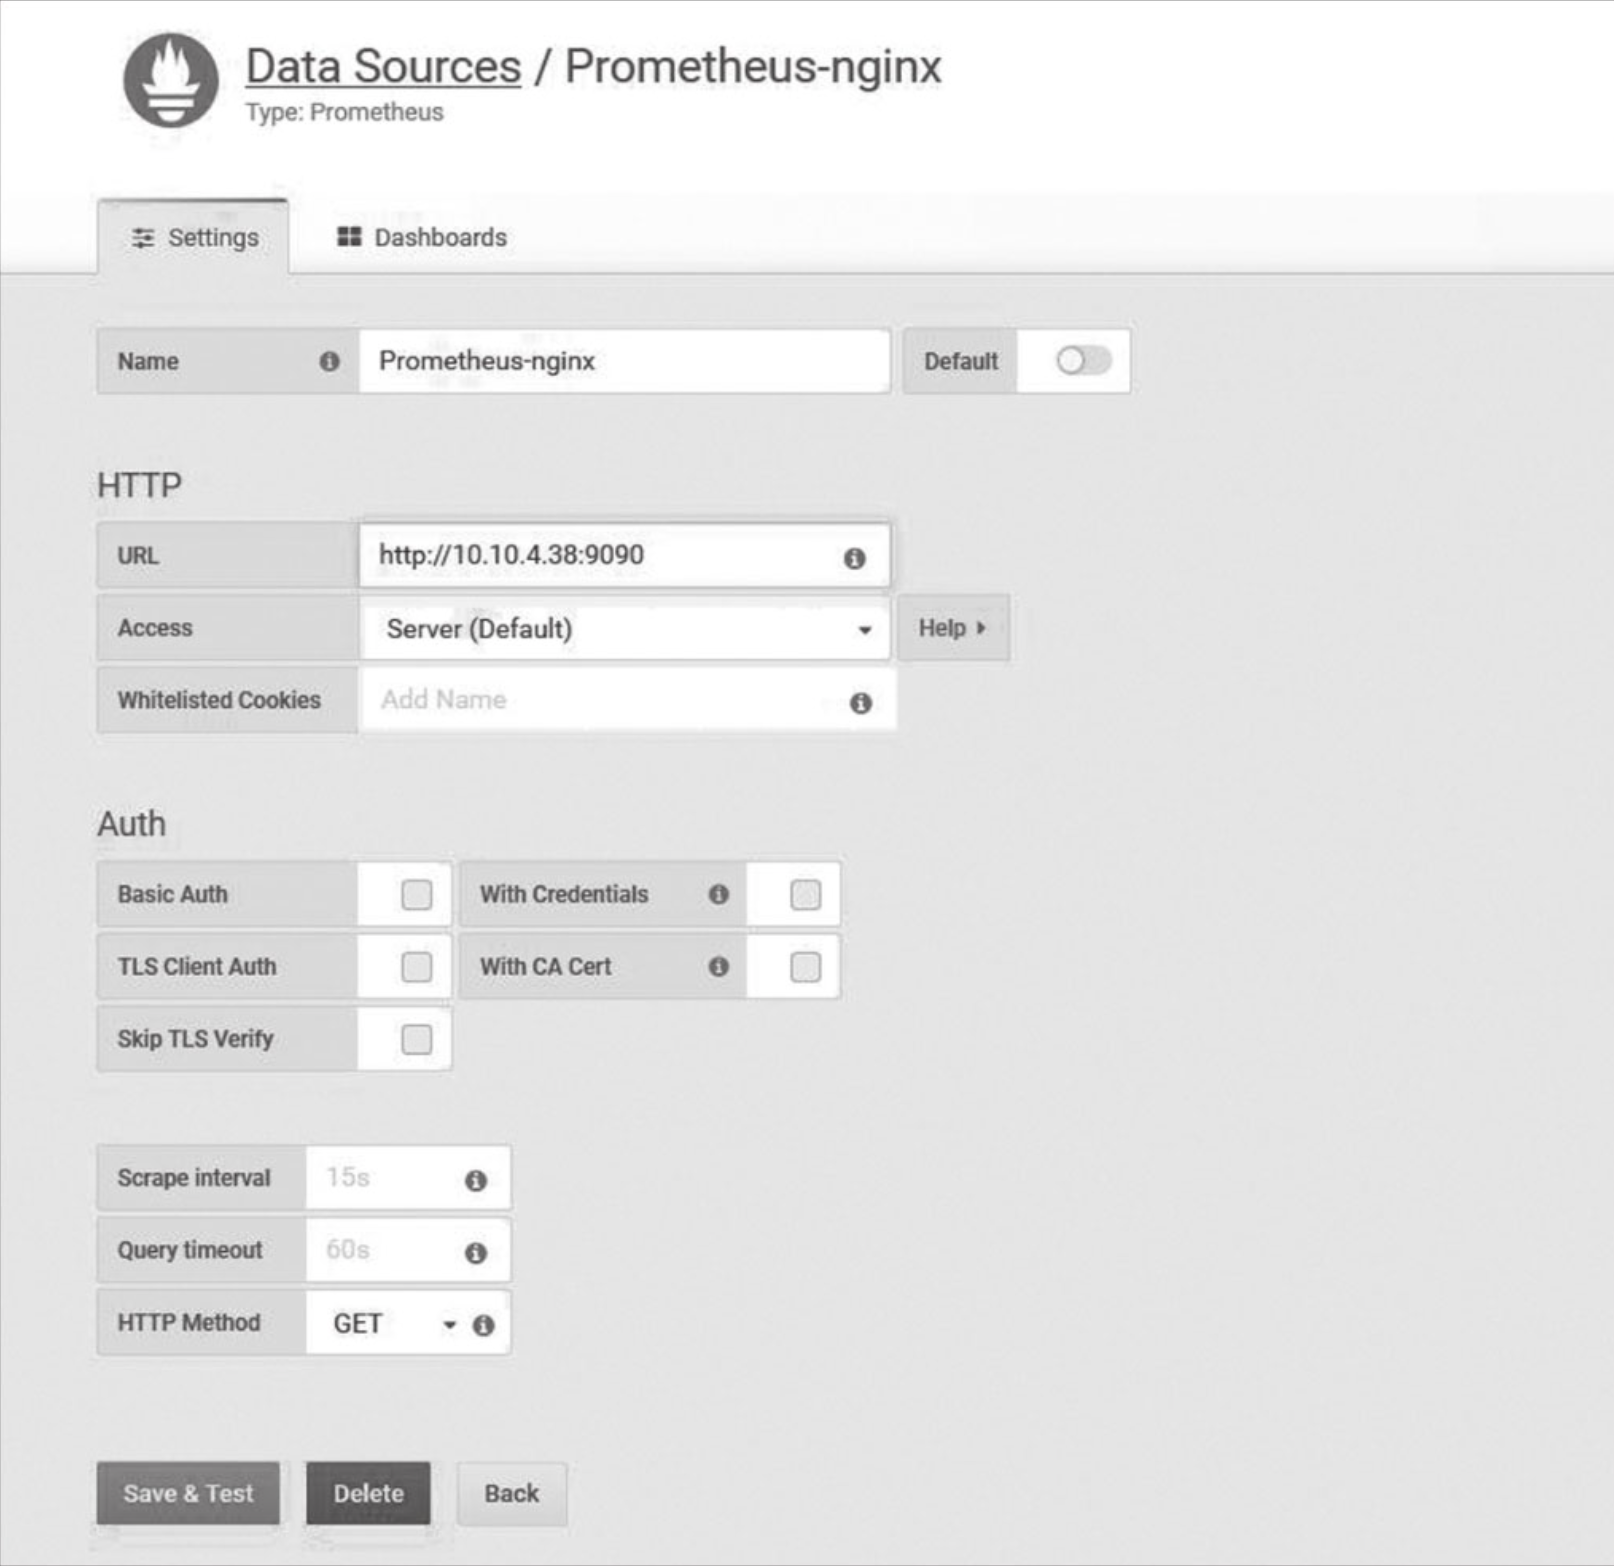
登录Grafana后,在左侧菜单点击Configuration→Adddata source,选择Prometheus图标后进入数据源配置页面,配置如图所示。
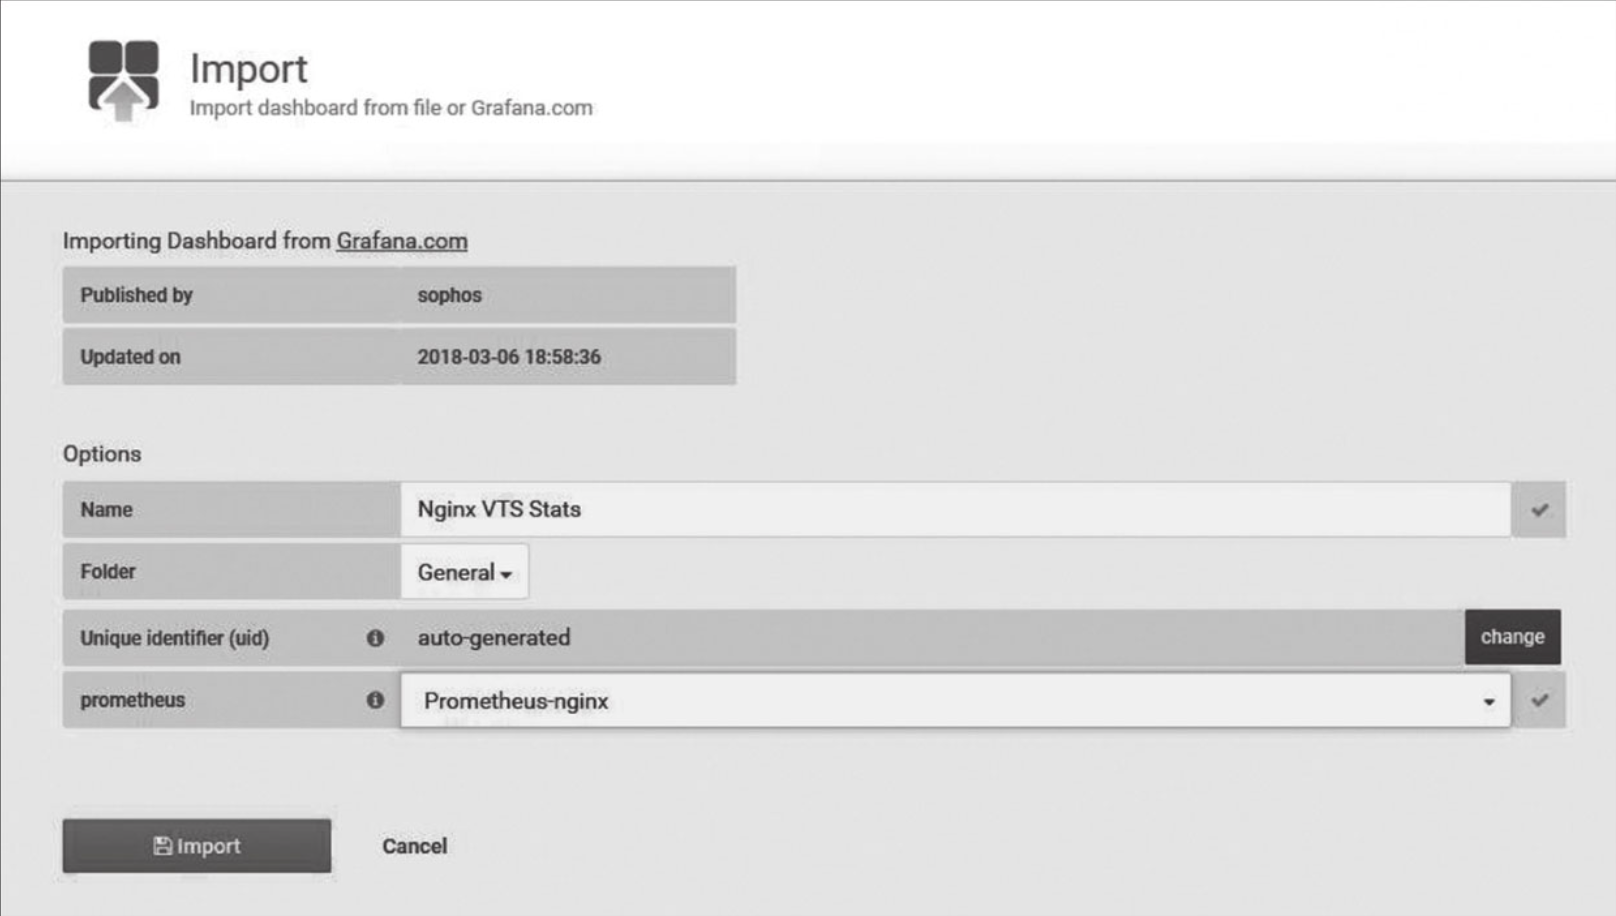
在左侧菜单点击Create→Import,在标题为Grafana.comDashboard的输入框输入模板ID 2949后,点击任意位置进入模板导入页,如图所示。
4.4、监控TCP/UDP主机状态
TCP/UDP主机状态模块nginx-module-sts虽然也提供了Prometheus格式数据输出,但仍然不够详细,同时也没有可用的开源Exporter。为实现Nginx TCP/UDP主机状态数据的采集,可以按照Prometheus的数据规范编写一个Exporter。
-
(1)Prometheus的数据类型
- 计数类型(Counter):计数类型用于累加值,一直增加或一直减少,重启进程后,会被重置。如记录请求次数、错误发生次数等。
- 计量类型(Gauge):计量类型用于常规数值,用以表示瞬间状态的数值,可大可小,重启进程后,会被重置,如硬盘空间、内存使用等。
- 直方图(Histogram):直方图可以理解为柱状图,常用于表示一段时间内数据的采样,能够对其指定区间及总数进行统计。
- 合计统计(Summary):合计统计和直方图相似,常用于表示一段时间内数据采样的结果。Histogram需要通过_bucket计算quantile(按百分比划分跟踪的结果),而Summary直接存储了quantile的值。
-
(2)Exporter数据输出格式
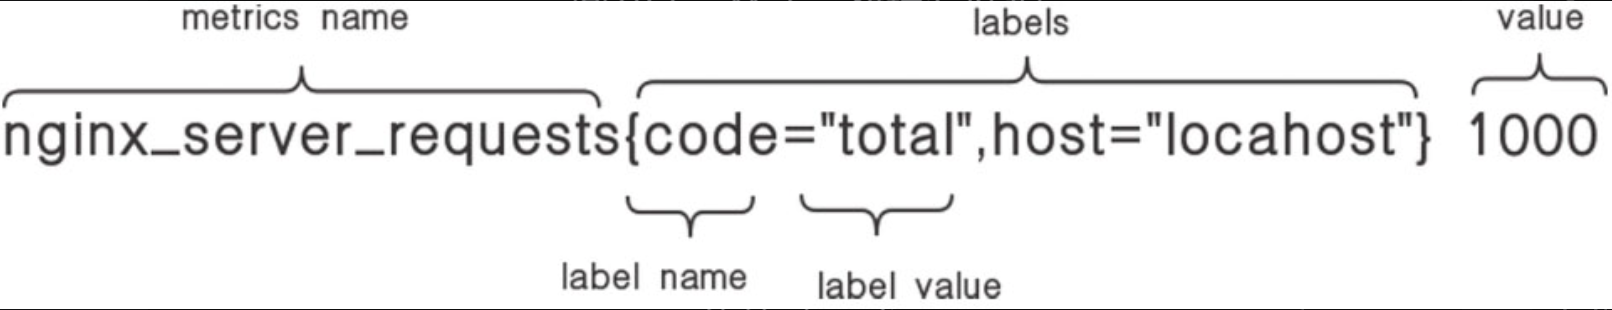
Exporter输出的数据是以Metric行为单位的文本数据,数据输出格式规范如下。
- Exporter输出数据的Content-Type必须是text类型(text/plain)。
- Exporter输出内容以行为单位,空行将被忽略,文本内容最后一行为空行。
- 每个输出监控数据的行被称为Metric行,每一行文本的最后不能有空格,否则会不被识别。
- 以"# HELP"开头的行为注释行,表示帮助信息。
- 以"# TYPE"开头的行为类型声明行,用以声明至下一个注释行间Metric数据的数据类型。
类型声明与注释行间的文本为Metric数据,每行结构如图所示。
-
(3)编写Exporter脚本
Python下的prometheus_client模块可以实现Prometheus Exporter的快速开发,因Prome-theus是采用拉取方式获取监控数据的,所以还需要用flask实现Web框架和访问路由功能。脚本代码如下:
bashimport prometheus_client from prometheus_client import Counter,Gauge import requests import sys import json import time from flask import Response, Flask # 初始化监控项 nginx_info = Gauge("nginx_info", "nginx_info nginx info",['hostName','nginxVersion']) nginx_server_info = Gauge("nginx_server_info", "nginx_server_info nginx server info",['host','port','protocol']) nginx_server_connections = Gauge("nginx_server_connections", "nginx connections", ['status']) nginx_server_bytes = Counter("nginx_server_bytes","request/response bytes", ['direction','host']) nginx_upstream_responses = Counter("nginx_upstream_requests","requests counter", ['backend','code','upstream']) app = Flask(__name__) @app.route("/metrics") def requests_metrics(): metrics="" url = "http://127.0.0.1:8080/sts/format/json" res = requests.get(url) all_data = json.loads(json.dumps(res.json())) # server_info nginx_info.labels(hostName=all_data["hostName"],nginxVersion=all_data["nginx-Version"]).set(time.time()) metrics+=prometheus_client.generate_latest(nginx_info) # connections connections=["accepted","active","handled","reading","requests","waiting", "writing"] for con in connections: nginx_server_connections.labels(status=con).set(all_data["connections"][con]) metrics+=prometheus_client.generate_latest(nginx_server_connections) # streamServerZones for k,streamServer in all_data["streamServerZones"].items(): nginx_server_bytes.labels(direction="in",host=k).inc(streamServer["inBytes"]) nginx_server_bytes.labels(direction="out",host=k).inc(streamServer["outBytes"]) nginx_server_info.labels(host=k,port=streamServer["port"],protocol=stream-Server["protocol"]).set(1) metrics+=prometheus_client.generate_latest(nginx_server_bytes) metrics+=prometheus_client.generate_latest(nginx_server_info) # streamUpstreamZones status_code=["1xx","2xx","3xx","4xx","5xx"] for ups,stream in all_data["streamUpstreamZones"].items(): for v in stream: for code in status_code: nginx_upstream_responses.labels(backend=v["server"],code=code,up-stream=ups).inc(v["responses"][code]) metrics+=prometheus_client.generate_latest(nginx_upstream_responses) return Response(metrics,mimetype="text/plain") @app.route('/') def index(): html='''<html> <head><title>Nginx sts Exporter</title></head> <body> <h1>Nginx sts Exporter</h1> <p><a href="/metrics">Metrics</a></p> </body> </html>''' return html if __name__ == "__main__": app.run( host="0.0.0.0", port= 9912, debug=True )在此处只选了几个监控项做样例,感兴趣的读者可继续补充完整。
-
(4)Exporter脚本部署
将Exporter脚本保存为/usr/local/nginx/sbin/nginx-sts-exporter.py。
bash# 配置运行环境 yum install python2-pip pip install prometheus_client requests flask # 运行Exporter python /usr/local/nginx/sbin/nginx-sts-exporter.py # 测试 curl http://127.0.0.1:9912/metrics -
(5)在Prometheus上配置监控job
具体配置样例如下:
bashcd /opt/data/apps cat>>prometheus/prometheus/prometheus.yml<<EOF # nginx-vts-exporter && nginx-sts-exporter job - job_name: nginx_exporter_8 static_configs: - targets: ['10.10.4.8:9913','10.10.4.8:9912'] labels: instance: nginx-8 EOF # 重启Prometheus,使配置生效 docker restart prometheus
4.5、Prometheus监控告警
Prometheus监控告警是通过Alertmanager组件实现的。Alertmanager提供标准的RESTful api接口接收警报信息,其将告警信息按照规则重定向给接收者,接收者可以是邮箱、webhook和微信等。Alertmanager会对已发送的告警进行智能记录并做延时、去重等处理,从而有效避免告警风暴的产生。
-
(1)Prometheus监控告警处理流程如下:
- Prometheus Server根据配置参数evaluation_interval的时间间隔按照告警规则进行计算。
- 当不满足expr设定计算规则的阈值时,该告警规则被置为inactive状态。
- 当满足expr设定计算规则的阈值并小于for设定的持续时间时,该告警规则被置为pending状态。
- 当满足expr设定计算规则的阈值并大于for设定的持续时间时,该告警规则被置为firing状态,并发送告警信息给Alertmanager处理。
- Alertmanager接收到告警信息后,根据labels进行路由分拣,告警信息会根据group_by配置进行分组,如果分组不存在,则新建分组。
- 新创建的分组将等待group_wait指定的时间(等待时如收到同一分组的告警信息,将其进行合并),然后发送通知。
- 已有分组时将等待group_interval指定的时间,当上次发送通知到现在的间隔大于repeat_interval或者分组有更新时会发送通知。
-
(2)告警规则格式
bashALERT <alert name> # 告警标识符,可以不唯一 IF <expression> # 触发告警阈值规则 [ FOR <duration> ] # 触发告警通知的持续时间 [ LABELS <label set> ] # 分组标签,用以Alertmanager进行分拣路由 [ ANNOTATIONS <label set> ] # 告警描述信息 -
(3)Prometheus Server配置告警规则格式
bashcat>prometheus/prometheus/nginx.rules<<EOF groups: - name: NginxAlert # 规则组名称 rules: - alert: ResponseTimeAlert # 规则的名称 # 告警阈值计算规则为响应时间大于1000ms并持续10s的发送告警 expr: (nginx_upstream_responseMsec > 1000) for: 10s # 持续时间为10s labels: # 定义告警路由标签 severity: critical service: nginx annotations: # 告警信息 summary: "Nginx响应大于1000ms" description: "Nginx {{ $labels.instance }}后端集群{{ $labels.upstream }} 中{{ $labels.backend }}的响应时间大于1000ms。当前值为:{{ $value }} ms" EOF # 重启Prometheus docker restart prometheus- $labels是Metric行数据的labels内容。labels的内容可用对象数据类型方法引用。
- $value是Metric行的value。
- $labels是多条时,会自动遍历内容,每条记录生成一个annotations信息。
-
(4)Alertmanager配置
bashcd /opt/data/apps # 配置Alertmanager cat>prometheus/alertmanager/alertmanager.yml<<EOF # 全局配置,配置smtp信息 global: resolve_timeout: 5m # 处理超时时间,默认为5min smtp_smarthost: 'smtp.exmail.qq.com:465' # 邮箱smtp服务器代理,请替换自己的smtp # 服务器地址 smtp_from: 'monitor@nginxbar.org' # 发送告警信息的邮箱地址,请替换自己的 # 邮箱地址 smtp_auth_username: 'monitor@nginxbar.org' # 邮箱账号,请替换自己的邮箱账号 smtp_auth_password: '12345678' # 邮箱密码,请替换自己的邮箱密码 smtp_require_tls: false # 定义发送邮件的模板信息 templates: - 'template/*.tmpl' # 定义发送告警邮件的路由信息,这个路由不仅可以接收所有的告警,还可以配置多个路由 route: group_by: ['alertname'] # 告警信息分组依据,按照同类alertname # 进行分组 group_wait: 10s # 最初等待10s发送告警通知 group_interval: 60s # 在发送新告警前的等待时间 repeat_interval: 1h # 发送重复告警的等待周期为1小时,避免产 # 生邮件风暴 receiver: 'email' # 全局默认告警接收者的名称,与receivers # 的name对应 routes: - match: # 匹配labels存在如下标签的告警信息 severity: critical service: nginx receiver: nginx_email #Nginx服务器警报接收者的名称 # 定义默认警报接收者信息 receivers: - name: 'email' # 路由中对应的receiver名称 email_configs: # 告警接收者邮箱配置 - to: 'xiaodong.wang@freemud.com' # 告警接收者的邮箱配置 - name: 'nginx_email' # 路由中对应的receiver名称 email_configs: # 告警接收者邮箱配置 - to: 'xiaodong.wang@freemud.com' # 告警接收者的邮箱配置 EOF # 重启alertmanager docker restart alertmanagerNginx监控项的阈值触发设置的告警规则时,Prometheus就会自动发送告警到目标邮箱。
5、监控工具Zabbix
Zabbix是一款开源的企业级、分布式网络监控解决方案,Zabbix系统最初于2001年发布,目前由Zabbix公司维护。Zabbix系统可以通过Web界面完成对各监控项的设置,实时对被监控设备的状态、性能等监控数据进行获取和存储。Zabbix通过Web端可对存储的监控数据进行报表化和可视化展示。在监控响应方面其提供了灵活的通知机制,让用户可以快速响应和处理问题。Zabbix一直处于活跃开发状态,当前版本为4.2。新版本支持Prometheus数据源,并可以使用PromQL语言进行Prometheus数据处理。因Zabbix应用比较早,覆盖的监控设备的类型比较多,且使用上也比较成熟,所以为实现监控管理的统一性,本节将介绍Zabbix与Prometheus结合实现Nginx监控。
5.1、Zabbix简介
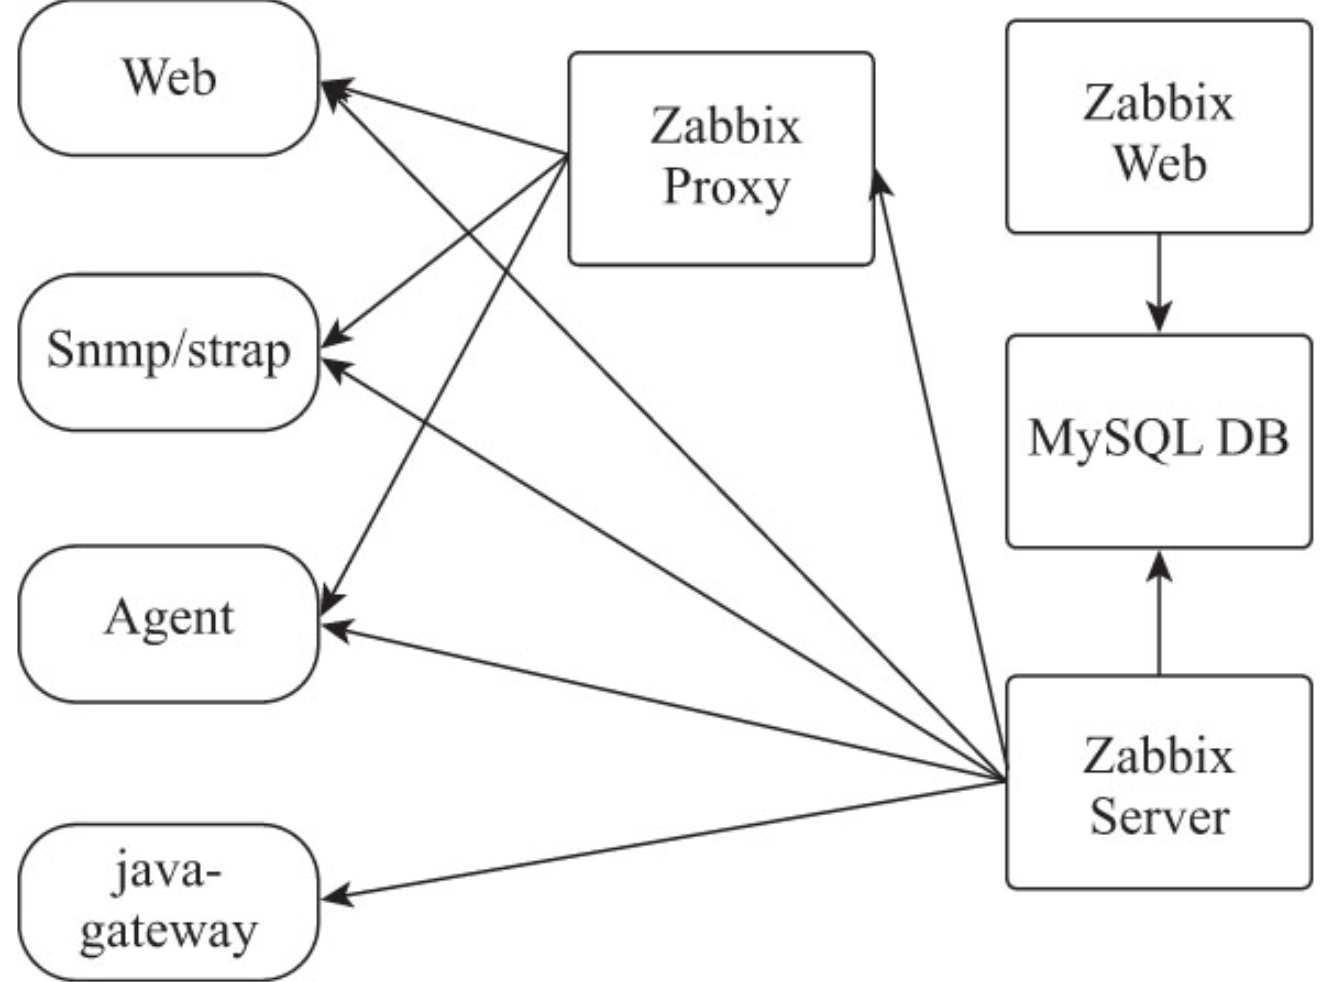
Zabbix系统由服务端和Agent端构成,支持以主动轮询(Polling)和被动捕获(Trapping)两种方式实现监控数据的获取。Zabbix服务端由Server、Web、java-gateway、Proxy、Snmp/strap这5个组件组成,架构图如图所示。
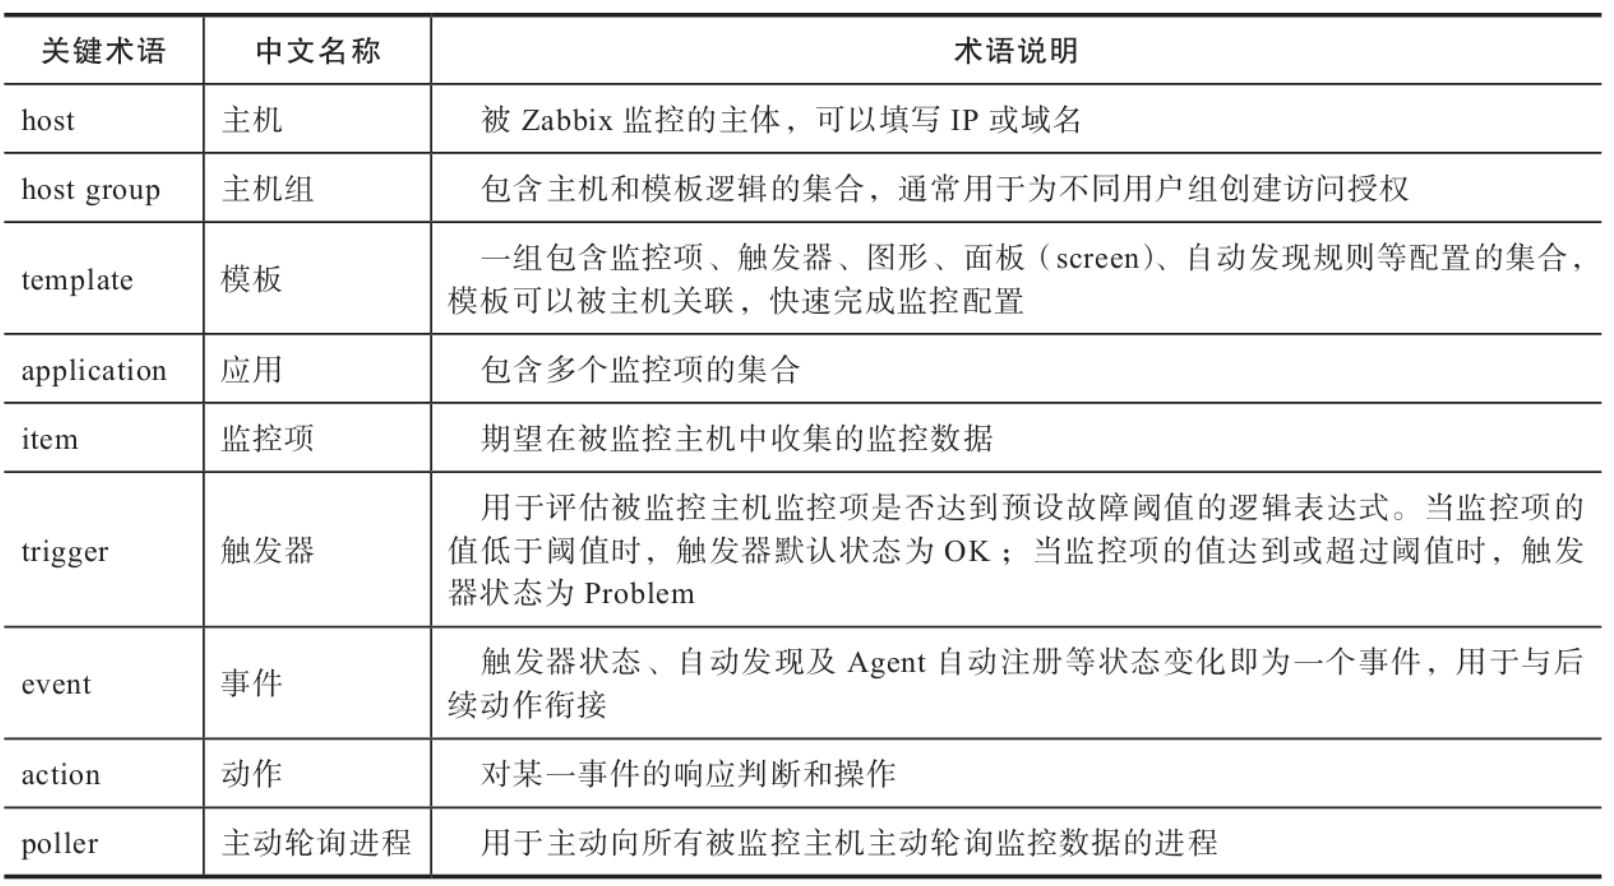
在Zabbix系统配置中有一系列的关键术语,如表所示。
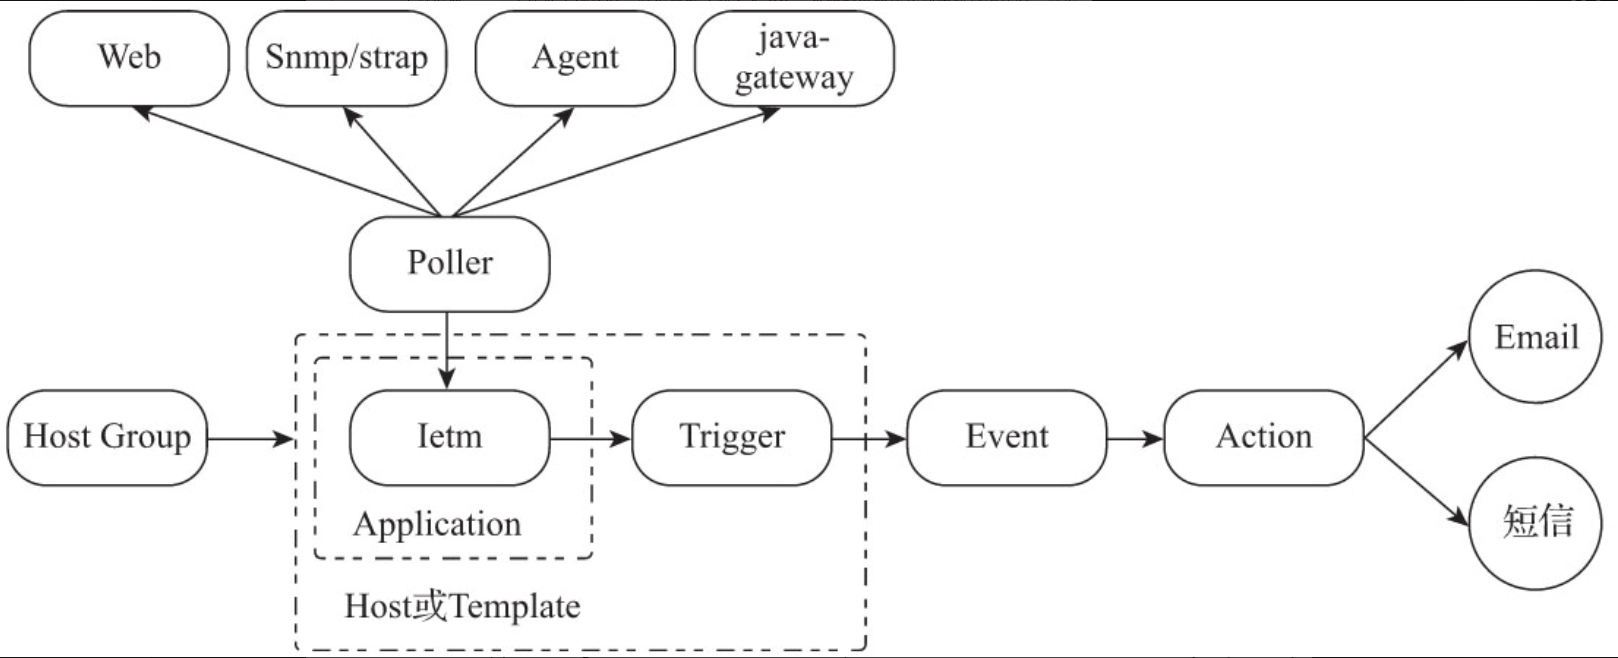
关键术语的逻辑关系如图所示。poller进程在默认配置下会向所有被监控主机轮询监控项数据。
5.2、Zabbix环境搭建
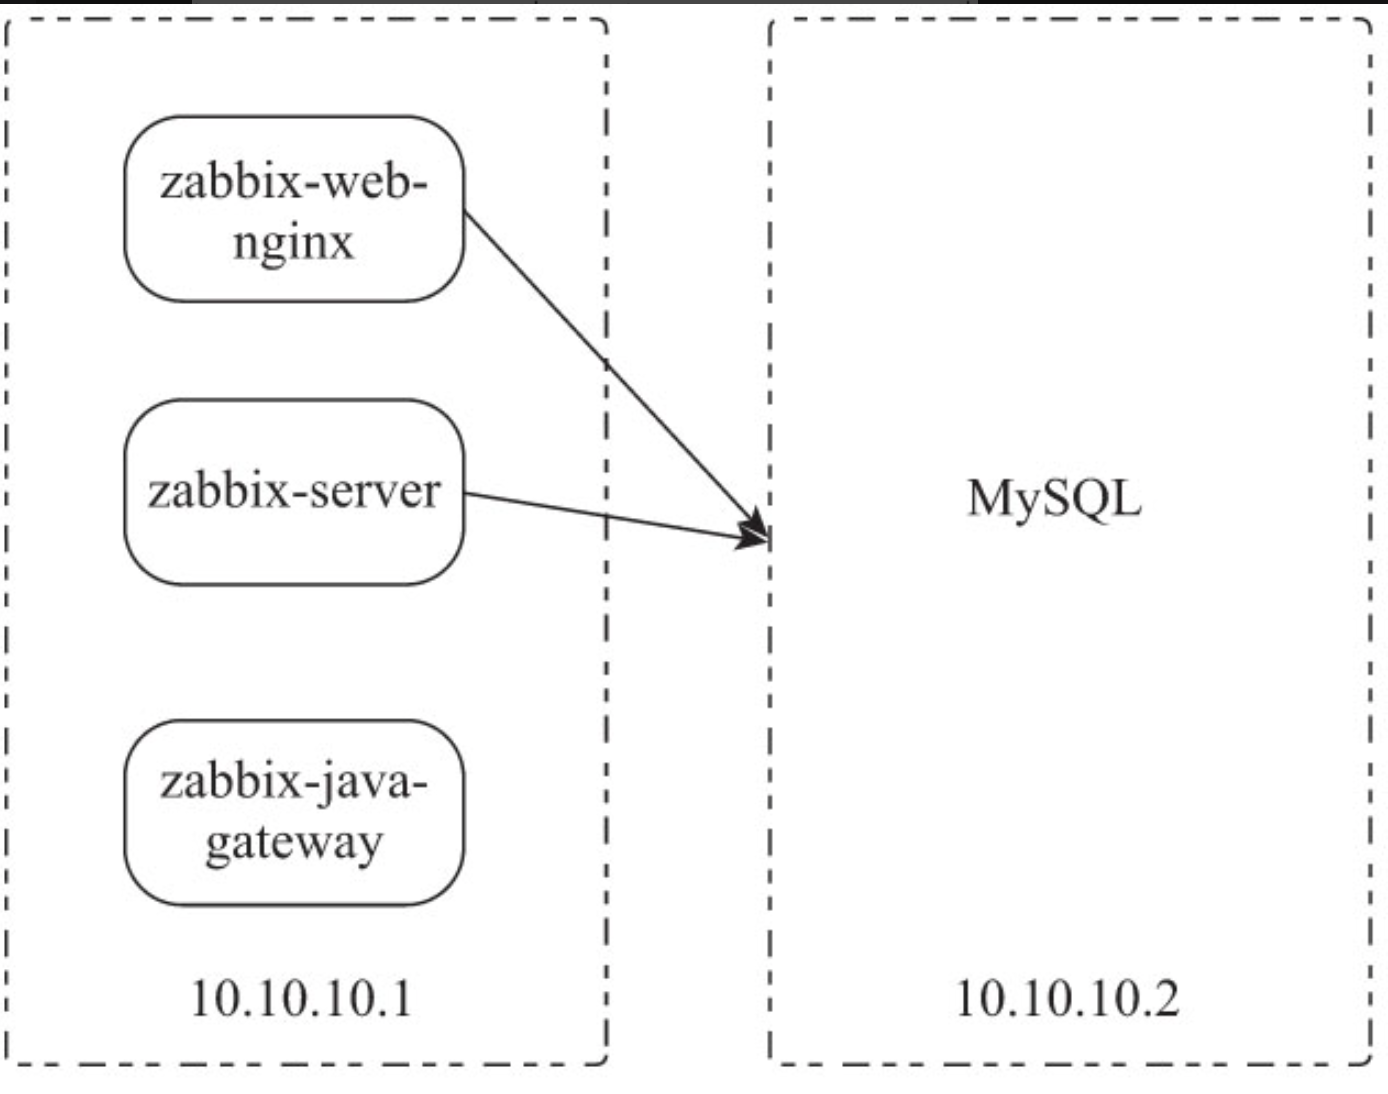
因为Docker具有灵活部署的特性,所以Zabbix环境可采用Docker化部署,Zabbix官方为每个组件都提供了Docker镜像。在配置样例场景中,Zabbix的Server、Web、java-gateway组件以Docker化方式部署在IP为10.10.10.1的主机系统中,MySQL独立部署在IP为10.10.10.2的主机系统中,部署架构如图所示。
-
(1)MySQL部署
主机10.10.10.2的操作系统为CentOS 7.2,安装步骤如下:
bashrpm -ivh http://repo.mysql.com/mysql57-community-release-el7-8.noarch.rpm # 安装MySQL的安装源 yum -y install --nogpgcheck mysql-server # 安装MySQL服务 systemctl start mysqld # 启动MySQL服务 cat /var/log/mysqld.log |grep pass |awk -F "host: " '{print $2}' # 获取初始化的MySQL root密码 # 将root的初始化密码修改为fHFUOVj7Iz309r1Z mysql -uroot -p -e "GRANT ALL PRIVILEGES ON *.* TO 'root'@'10.10.10.1' IDENTIFIED BY 'fHFUOVj7Iz309r1Z' WITH GRANT OPTION;FLUSH PRIVILEGES;"MySQL优化非本书主要内容,优化方法请参考其他相关资料。
-
(2)Zabbix Docker化部署
主机10.10.10.1的操作系统为CentOS 7.2,初始化Docker环境如下:
bashyum install -y yum-utils # 安装yum工具 yum-config-manager --add-repo https://download.docker.com/linux/centos/docker-ce.repo # 安装Docker安装源 yum install -y docker-ce docker-compose # 安装Docker和docker-compose systemctl enable docker # 将Docker注册为自启动服务 systemctl start docker # 启动Docker服务Zabbix的Docker化安装使用docker-compose命令及相应的docker-compose脚本即可快速完成,docker-compose脚本如下:
bashcat zabbix-server.yaml version: '3.5' services: zabbix-server: hostname: zabbix-server # 设置容器系统主机名 container_name: zabbix-server # 设置容器名称 restart: always # 设置系统重启后自动启动 image: zabbix/zabbix-server-mysql # 使用的镜像名称 ports: - "10051:10051" # 配置容器对外及内部端口 links: - zabbix-java-gateway:zabbix-java-gateway # 关联容器名称 ulimits: # 容器系统文件打开数设置 nproc: 65535 nofile: soft: 20000 hard: 40000 env_file: - .env_db_mysql # MySQL相关环境变量文件 - .env_srv # Zabbix Server运行环境变量文件 user: root # 以root用户运行容器 depends_on: - zabbix-java-gateway # 容器运行时依赖的其他容器 stop_grace_period: 30s # 关闭容器时等待30s sysctls: # 容器系统内核参数 # 容器系统UDP和TCP连接的本地端口取值范围为1024~65000 - net.ipv4.ip_local_port_range=1024 65000 - net.ipv4.conf.all.accept_redirects=0 # 禁止接收路由重定向报文 - net.ipv4.conf.all.secure_redirects=0 # 禁止转发安全ICMP重定向报文 - net.ipv4.conf.all.send_redirects=0 # 禁止转发重定向报文 zabbix-web-nginx-mysql: hostname: zabbix-nginx container_name: zabbix-nginx restart: always image: zabbix/zabbix-web-nginx-mysql ports: - "80:80" - "443:443" links: - zabbix-server:zabbix-server env_file: - .env_db_mysql - .env_web # 系统环境变量文件 user: root depends_on: - zabbix-server healthcheck: # 容器健康检查 # 健康检查命令 test: ["CMD", "curl", "-f", "http://localhost"] interval: 10s # 健康检查周期为10s timeout: 5s # 健康检查超时时间为5s retries: 3 # 健康检查重试3次 start_period: 30s # 容器启动间隔时间为30s stop_grace_period: 10s # 关闭容器时等待10s sysctls: - net.core.somaxconn=65535 # 允许建立并发连接的最大数为65535 zabbix-java-gateway: hostname: zabbix-java-gateway container_name: zabbix-java-gateway restart: always image: zabbix/zabbix-java-gateway ports: - "10052:10052" user: root stop_grace_period: 5s # MySQL环境变量文件 cat >.env_db_mysql<<EOF DB_SERVER_HOST=10.10.10.2 # 设置MySQL服务器地址 # DB_SERVER_PORT=3306 MYSQL_USER=zabbix # 设置访问MySQL的用户名 MYSQL_PASSWORD=zabbix # 设置访问MySQL的密码 MYSQL_ROOT_PASSWORD=fHFUOVj7Iz309r1Z # 设置访问MySQL的root密码 EOF # zabbix server运行环境变量文件 cat >.env_srv<<EOF ZBX_JAVAGATEWAY_ENABLE=true # 配置zabbix server启用jmx支持 ZBX_STARTJAVAPOLLERS=5 # 设置zabbix server初始pooler进程为5 EOF # zabbix-nginx系统环境变量文件 cat >.env_web<<EOF ZBX_SERVER_NAME=Composed installation PHP_TZ=Asia/Shanghai # 设置Zabbix Web的php时区为Asia/Shanghai EOF docker-compose -f zabbix-server.yaml up -d配置好DB_SERVER_HOST及MYSQL_ROOT_PASSWORD,zabbix-server容器启动时会自动在MySQL中创建数据库。
-
(3)数据持久化
Docker镜像(Image)文件存放在只读层,而容器(Container)的文件则存放在可写层,当运行的容器被删除或重建时,该容器变更的文件将会丢失,所以需要通过外挂卷的方式将变更的配置和文件保存到主机系统中。Zabbix中有Server和Nginx两个容器需要实现数据持久化。
持久化zabbix-server容器文件的方法如下:
bash# 创建Zabbix Server持久化存储目录 mkdir -p /opt/data/apps/zabbix/server # 从容器中复制Zabbix运行的文件到/opt/data/apps/zabbix/server中 docker cp zabbix-server:/var/lib/zabbix /opt/data/apps/zabbix/server # 创建配置,监控报警脚本和自定义脚本目录 mkdir -p /opt/data/apps/zabbix/server/{alertscripts,externalscripts} # 从容器中复制zabbix_server.conf docker cp zabbix-server:/etc/zabbix /opt/data/apps/zabbix/server/config chown -R 100:1000 /opt/data/apps/zabbix/server # 创建zabbix-server容器的docker-compose卷挂载命令 cat >/tmp/tmpfile<<EOF volumes: - /etc/localtime:/etc/localtime:ro # 本地时间文件 - /etc/timezone:/etc/timezone:ro # 本地时区文件 # 挂载告警脚本目录 - /opt/data/apps/zabbix/server/alertscripts:/usr/lib/zabbix/alertscripts - /opt/data/apps/zabbix/server/externalscripts:/usr/lib/zabbix/external-scripts # 挂载自定义脚本目录 # 挂载Zabbix Server配置文件 - /opt/data/apps/zabbix/server/config:/etc/zabbix # 挂载Zabbix目录 - /opt/data/apps/zabbix/server/zabbix:/var/lib/zabbix EOF # 将挂载卷命令添加到zabbix-server.yaml文件中 sed -i '/"10051:10051"/r /tmp/tmpfile' zabbix-server.yaml持久化zabbix-nginx容器文件的方法如下:
bash# 创建Zabbix Nginx持久化存储目录 mkdir -p /opt/data/apps/zabbix/nginx # 复制Zabbix Web文件目录 docker cp zabbix-nginx:/usr/share/zabbix /opt/data/apps/zabbix/nginx/web # 复制Nginx配置文件 docker cp zabbix-nginx:/etc/nginx /opt/data/apps/zabbix/nginx # 复制Nginx的Zabbix配置文件 docker cp zabbix-nginx:/etc/zabbix /opt/data/apps/zabbix/nginx chown -R 101:101 /opt/data/apps/zabbix/nginx/web # 创建zabbix-nginx容器的docker-compose卷挂载命令 cat >/tmp/tmpfile<<EOF volumes: - /etc/localtime:/etc/localtime:ro # 本地时间文件 - /etc/timezone:/etc/timezone:ro # 本地时区文件 - /opt/data/apps/zabbix/nginx/zabbix:/etc/zabbix # 挂载Nginx Zabbix配置文件目录 - /opt/data/apps/zabbix/nginx/nginx:/etc/nginx # 挂载Nginx配置文件目录 - /opt/data/apps/zabbix/nginx/web:/usr/share/zabbix # 挂载Zabbix Web文件目录 EOF # 将挂载卷命令添加到zabbix-server.yaml文件中 sed -i '/"443:443"/r /tmp/tmpfile' zabbix-server.yaml docker-compose -f zabbix-server.yaml up -d- zabbix-server默认以主动轮询(Polling)的方式运行。
- Zabbix默认Web的登录账号是admin,密码是zabbix。
Zabbix运行是需要一定量的内存和磁盘空间的,内存和磁盘空间的大小取决于被监控主机的数量和配置参数。每个Zabbix守护进程都会与数据库建立多个连接,连接占用内存的大小取决于数据库引擎的配置。Zabbix的整体性能取决于为Zabbix Server及数据库分配的CPU性能及内存的大小。
5.3、Zabbix Agent安装
Zabbix的Agent端是部署在被监控对象上的进程,能够监控本地资源和应用。Zabbix的Agent端可以通过官方提供的rpm源进行快速安装。Zabbix的Agent端默认监听10050端口。
bash
rpm -ivh https://repo.zabbix.com/zabbix/4.2/rhel/7/x86_64/zabbix-release-4.2-1.el7.noarch.rpm
yum install zabbix-agent
systemctl enable zabbix-agent

# 配置允许获取监控数据的Zabbix服务器IP地址
sed -i 's/^Server=.*/Server=10.10.10.1/g' /etc/zabbix/zabbix_agentd.conf

# 配置主动发送监控数据的目标Zabbix服务器IP地址,不指定端口时,默认端口为10051
sed -i 's/^ServerActive=.*/ServerActive=10.10.10.1/g' /etc/zabbix/zabbix_agentd.conf

# 配置使用当前系统的主机名,不进行自定义
sed -i "s/^Hostname=/^# Hostname=/g" /etc/zabbix/zabbix_agentd.conf

systemctl start zabbix-agent
当启用Agent主动监控模式时,Hostname参数的值必须与服务端配置主机的字段Host name输入的内容一致且全局唯一,Agent将以该值为关键字从服务端查询待检测的监控项。当不设置Hostname参数时,则默认使用被监控主机的主机名。
5.4、Zabbix获取Prometheus数据
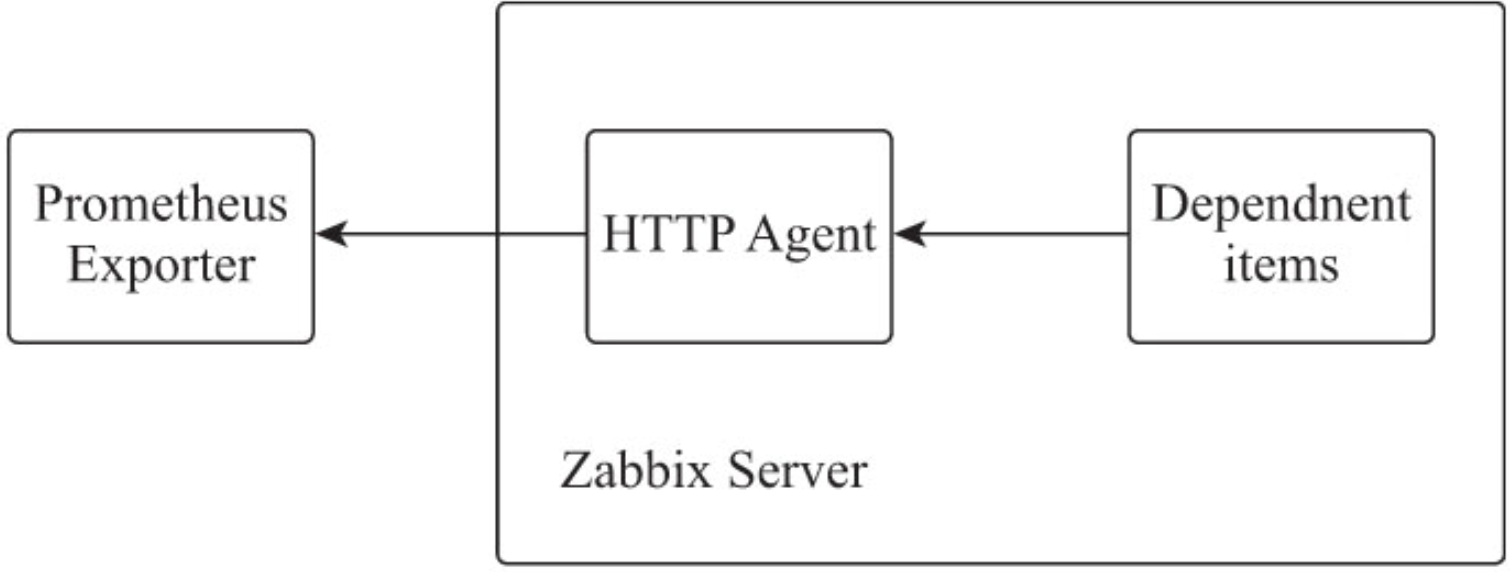
Prometheus是通过定时从部署在被监控主机上的Exporter获取监控数据来实现监控的,Zabbix 4.2版本可利用自身监控组件定时拉取Exporter的监控数据,并对Prometheus数据进行解析从而实现对Prometheus数据的监控处理,实现逻辑如图所示。
-
(1)添加监控模板
- 1)创建分组(Host groups):Configure→Host groups,创建分组Nginx-Prometheus。
- 2)创建模板(Templates):Configure→Templates,创建模板Nginx-Prometheus。
- 3)配置模板宏(Macros):Configure→Templates,点击模板Nginx-Prometheus,点击Macros创建宏变量
{$ADDRESS}、{$PORT},值为空即可。 - 4)创建应用(Applications):Configure→Templates,点击模板Nginx-Prometheus中的Applications,创建应用nginx_server_requests。
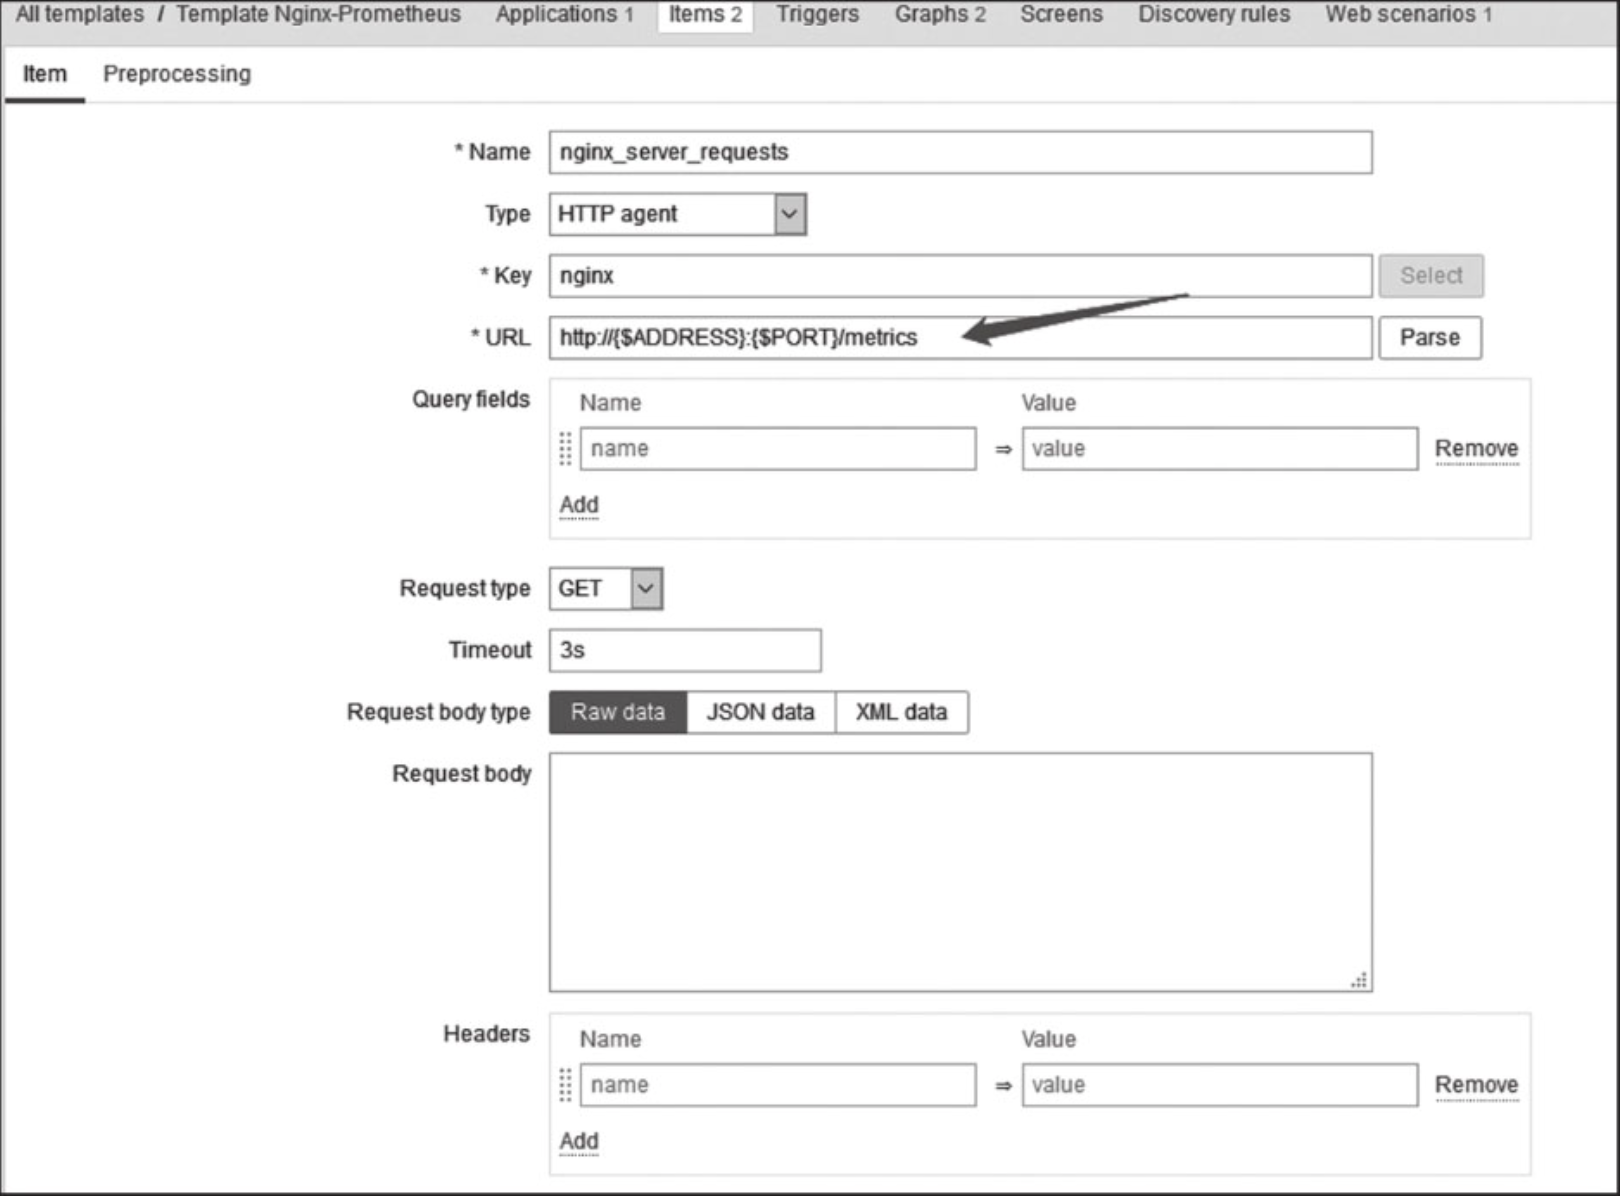
- 5)创建HTTP Agent类型监控项(Items):Configure→Templates,点击模板Nginx-Prometheus中的Items,创建HTTP Agent类型的监控项nginx_server_requests,如图所示。需注意Typeof information的选择为Text格式。
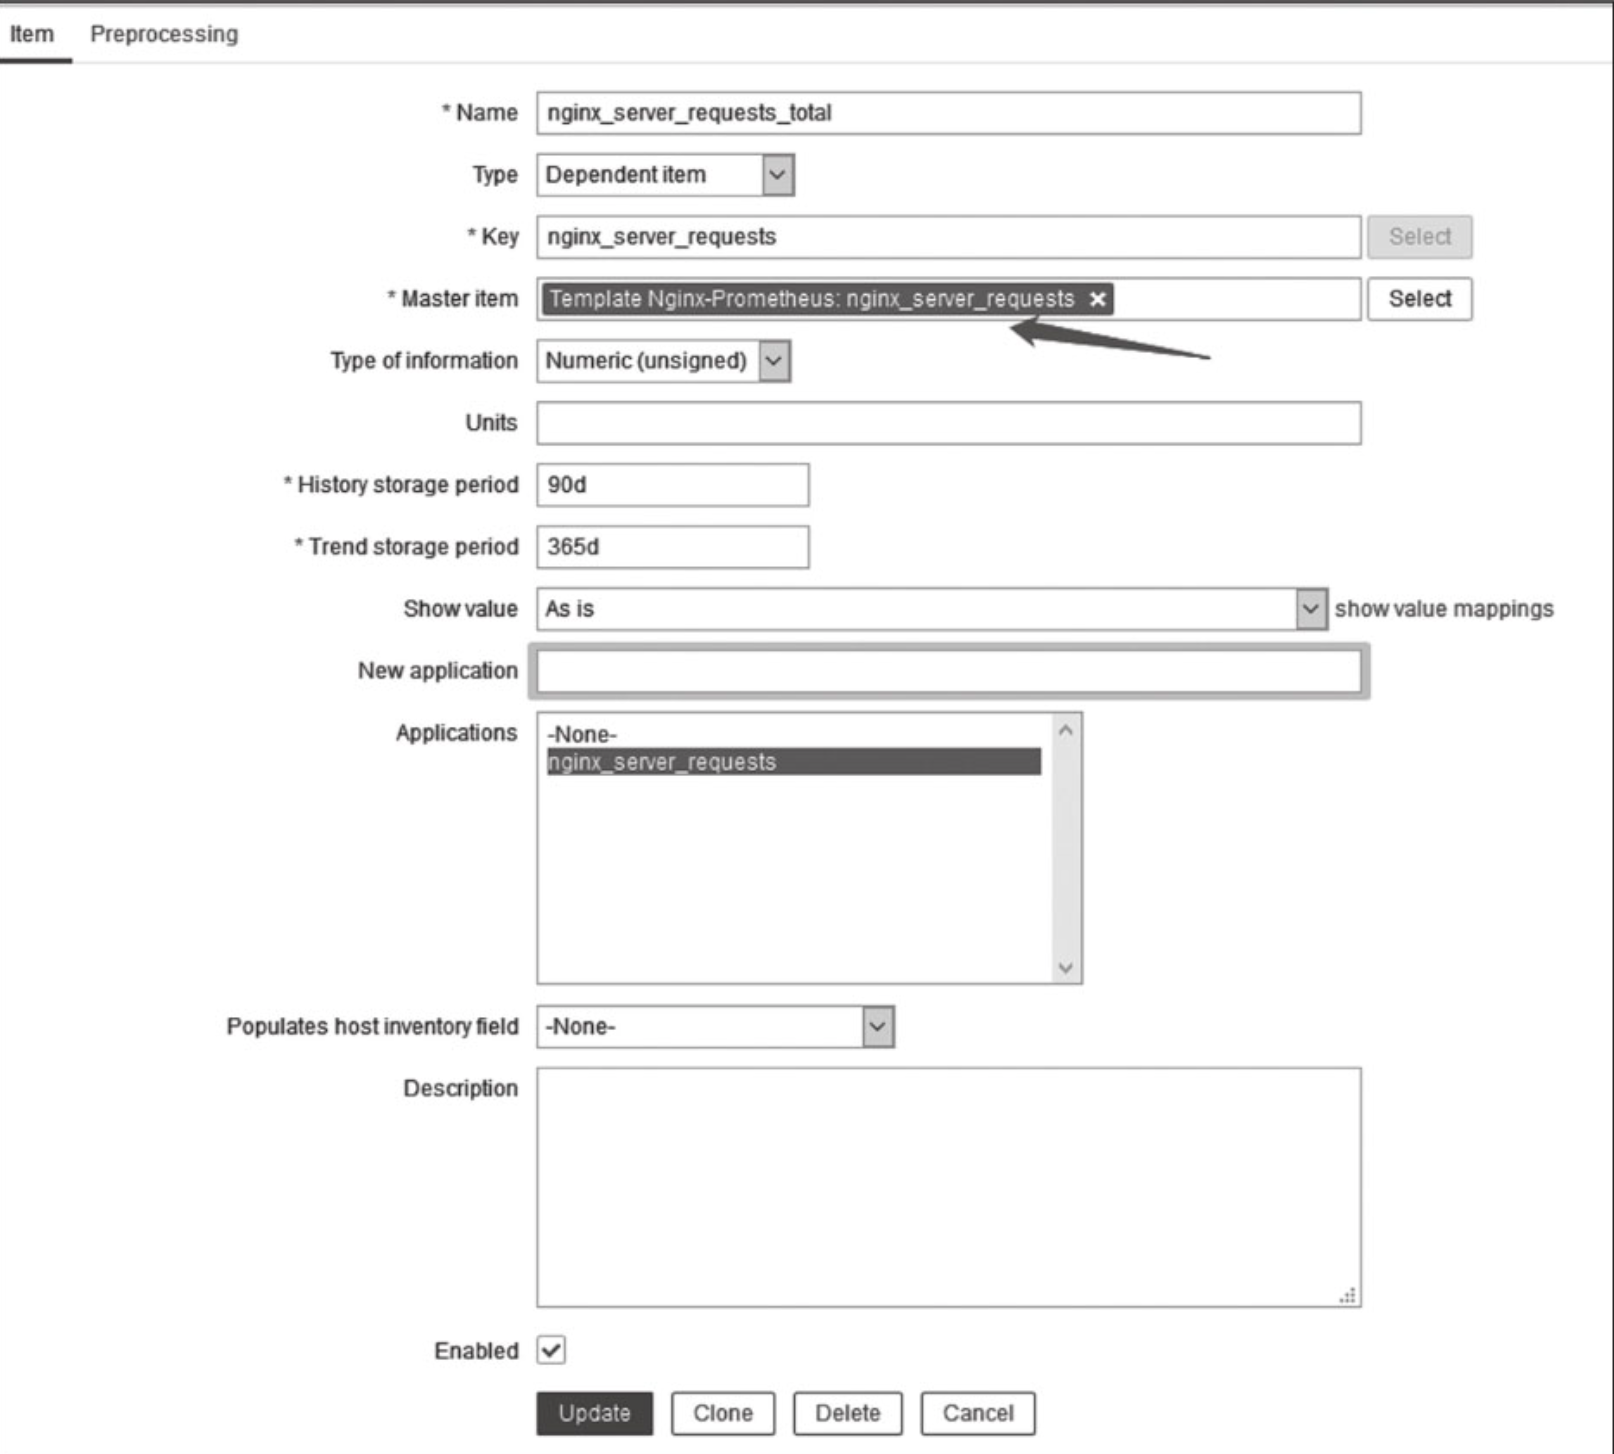
- 6)创建Dependent items类型监控项(Items):Configure→Templates,点击模板Nginx-Prometheus中的Items,创建Dependent items类型的监控项nginx_server_requests_total,如图所示。
- 7)创建监控项处理过程(Preprocessing):Configure→Templates,点击模板Nginx-Prome-theus中的Items,点击监控项nginx_server_requests_total,点击Preprocessing,创建的监控项处理过程如图所示。
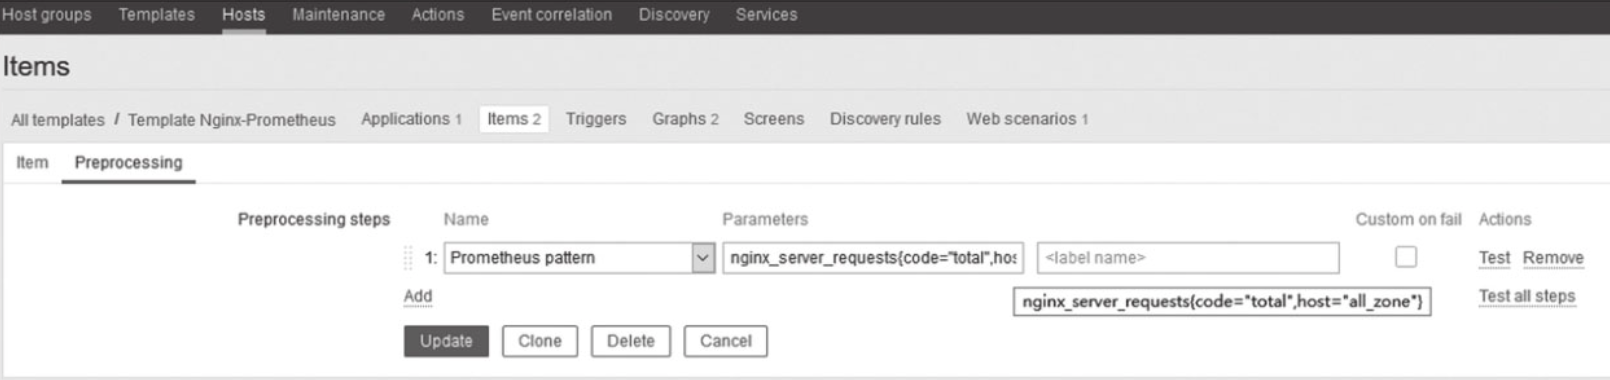
监控项处理过程支持Prometheus pattern和Prometheusto JSON的两种方式处理Pro-metheus数据,以及以Prometheus pattern为标准的PromQL语法对Metric文本数据进行解析。 - 8)创建图形(Graphs):Configure→Templates,点击模板Nginx-Prometheus中的Graphs,选择监控项nginx_server_requests_total,创建图形。
-
(2)添加监控主机
通过Configure→Hosts,创建主机,Templates关联为Nginx-Prometheus, Macros创建宏变量
{$ADDRESS},对应值为Nginx主机IP;创建{$PORT},对应值为Exporter的端口。至此,Zabbix就可以对Prometheus的Exporter进行监控 并生成图形了。