我们做的地图平台有 5 个,每个平台都要实现图层管理、要素高亮、属性表联动、绘制编辑。第一版是复制粘贴的,第二个平台改一处 bug 要改三个文件。
后来把这些抽成一套地图组件,5 个平台复用,新平台接入从一周缩到两天。
这篇讲这套组件是怎么设计的,以及踩过的坑。
一、痛点:在 Vue 页面里直接写 OL 代码会发生什么
最早做地图功能的时候,我们把 OpenLayers 的代码直接写在页面组件里:一个页面里 new Map()、建 layer、建 source、绑事件,第一版功能跑通了,看起来没问题。
然后第二个平台来了,情况开始不对。
问题一:地图实例和页面生命周期对不上。 一个系统里往往有多个页面用到地图,从详情页跳到列表页再跳回来,路由切换时如果没手动销毁,地图实例会一直活着。表现就是内存越用越高,地图容器上出现多个叠加的 canvas,点哪儿都不对。
问题二:状态无处安放。 图层显隐、当前选中要素、属性表分页、筛选条件,这些状态散落在十几个 ref 里。业务需求一改(比如"点图层名要同时更新目录树和属性表"),就得满页面找哪里改了、哪里漏了。
问题三:事件监听只增不减。 地图上要监听 click、dblclick、pointermove,还要监听图层的数据变化。每接一个业务组件就往地图上挂一组监听,没人负责解绑。写到后面,一个页面里对同一个 feature 的 click 回调能触发三次,选中态莫名其妙被覆盖。
问题四(最隐蔽的):选中态在数据刷新后丢失。 这个后面会详细讲,它是我在这套封装里印象最深的一个坑。
到第二个平台结束的时候,我判断这么下去第三个平台会写不动了。问题不是不会用 OpenLayers,是没有把"和 Vue 打交道"和"和 OpenLayers 打交道"这两件事分开。
二、组件分层
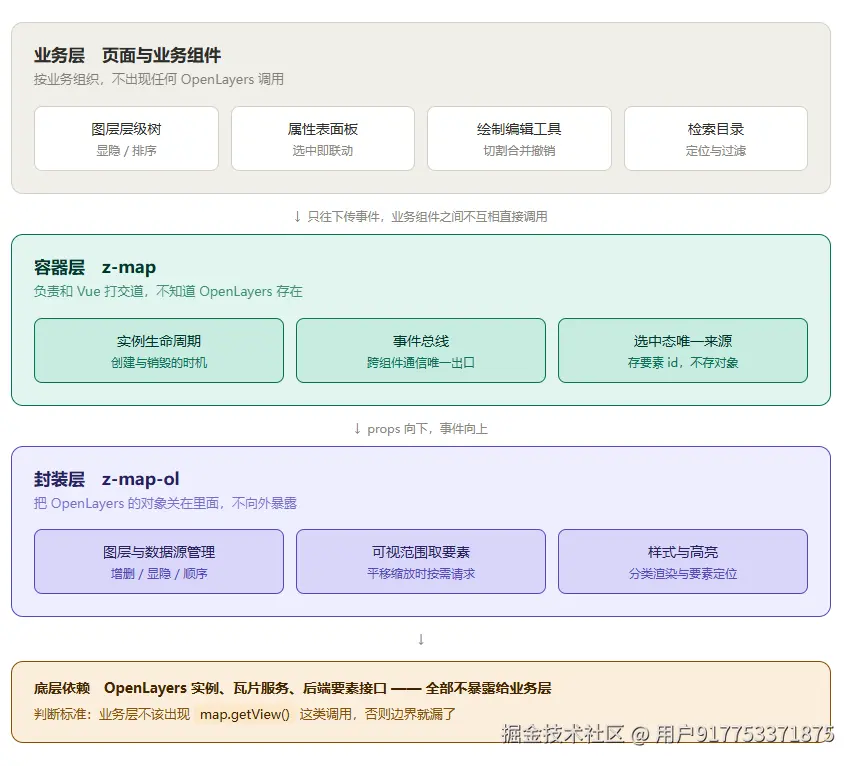
我把它拆成了两层,核心的判断依据只有一条:
上层不该知道下层存在。
arduino
z-map            容器层:负责和 Vue 打交道
                 ------ 生命周期、事件总线、选中态的唯一来源
                 ------ 它不该 import 任何 OpenLayers 的东西

  └─ z-map-ol    封装层:负责和 OpenLayers 打交道
                 ------ 图层、数据源、要素加载、高亮、绘制
                 ------ Map / View / Layer / Source 一律不外泄

      ├─ 图层属性表组件
      ├─ 目录 / 检索组件
      └─ 绘制编辑工具
为什么要分两层,而不是揉成一个?
容器层管"和 Vue 的关系" :什么时候创建地图实例、什么时候销毁、组件之间怎么通信、选中态的唯一来源在哪。它完全不需要知道 OpenLayers 的存在。
封装层管"和 OpenLayers 的关系" :图层怎么组织、要素怎么取、样式怎么控制、绘制怎么实现。它完全不需要知道外面有谁在用。
这样分之后有两个直接好处:换地图库只需要重写封装层;业务代码里如果开始出现 map.getView() 这类调用,就说明边界漏了,这个判断标准非常机械,不靠主观感觉。
对外暴露什么
对外只有 5 个左右的接口,事件一律只传要素 id,不传要素对象:
scss
// z-map 容器组件
props: {
  layers: Array,        // 图层配置
  selectable: Boolean,   // 是否开启要素选中
  fitOnLoad: Boolean     // 初始化后是否自动定位到全图
}

events: {
  'feature-selected'      (fid)   // 要素被选中
  'feature-unselected'    (fid)   // 取消选中
  'feature-edited'        (fid)   // 要素被编辑
  'layer-visibility-changed' (layerId, visible)
}

methods: {
  getFeatureById(fid)      // 按 id 取要素
  fitToLayer(layerId)      // 定位到某图层范围
  setLayerVisible(layerId, visible)
}
为什么事件只传 id? 这是被坑出来的 ------ 传对象会引入第二、四节讲的那个 bug。传 id 意味着接收方需要自己再查一次,一次查询换来的是状态永远指向一个稳定标识,不会因为底层对象被替换而失效。
什么被封在里面
Map、View、Layer、Source 这些实例一个都不外泄。
业务层如果拿得到 Map 实例,需求一复杂就一定会出现 map.getLayers().getAt(0).getSource().setExtent(...) 这种调用。一旦这样写,业务代码就绑死在 OpenLayers 上了 ------ 后面换库、升级大版本,全部要跟着改。
超出库能力时怎么办
没有做过度抽象。库覆盖不了的需求按优先级处理:能用 prop / 插槽解决的 加扩展点不改核心;业务特有的交互 写成独立业务组件,挂在封装层 API 之上,不塞进 z-map-ol;确实要改核心的直接改,但集中记录方便后续统一处理。
怎么被复用
我们目前是把组件目录复制到各项目的方式,没做成 npm 私有包。原因有三点:项目间的构建配置(Vite 版本、别名、依赖)不完全统一,强行共用一个包要处理的兼容问题比复制成本更高;地图组件的改动频率远高于业务组件,做成包之后每次改动都得考虑各项目要不要同步升级;实际复用的项目数量还不够多,发布流程的固定成本高于收益。
如果后续项目数量继续增加,第一步会先抽出「组件源码包 + 构建配置模板」,而不是直接上 npm ------ 先让版本同步这件事可控,再解决依赖管理。
三、两个关键设计
3.1 按可视范围取要素
地图上要素多的时候,一次性把全部要素加载出来渲染,性能是撑不住的。
我的做法是:地图 moveend 之后拿到当前视口范围,请求这个范围内的要素。
javascript
// 封装层内部
async function loadFeaturesInView() {
  const extent = map.getView().calculateExtent(map.getSize())
  const layers = activeLayers()          // 当前可见且开启按需加载的图层
  if (!layers.length) return

  // 平移缩放密集触发时,丢弃过期请求
  const token = ++requestToken

  const results = await Promise.all(
    layers.map(cfg => fetchFeatures(cfg.code, extent))
  )

  // 关键:即使请求成功返回,也可能已经不是最新的一次了
  if (token !== requestToken) return

  layers.forEach((cfg, i) => {
    source.getSource().clear()
    source.getSource().addFeatures(
      new GeoJSON().readFeatures(results[i], {
        dataProjection: 'EPSG:4326',
        featureProjection: 'EPSG:3857'
      })
    )
  })
}
两个容易被忽略的点:
一是平移缩放要节流。 直接监听 moveend 在快速拖动时依然会密集触发,我加了一层 debounce(约 200ms)。
二是要有 token 机制。 请求是异步的,快速连续拖动会同时发出多个请求,返回顺序不保证。如果不校验 token,后发先至的那次响应会覆盖先发的数据,地图上显示的就是过期数据 ------ 而且这个 bug 表现为"偶尔错位",极难复现。
3.2 选中态:唯一来源 + 只传 id
选中态是这个组件库设计得最反复的一块。
需求是这样的:
- 地图上点击要素 → 属性表自动跳到对应行并高亮
- 属性表里点某一行 → 地图定位到该要素并高亮
- 关闭属性表 / 切换图层 → 选中态清空
第一版的问题 :地图和属性表各自维护一份 selected 状态,双向同步。结果是两边都存了对象引用,而地图数据一刷新,对象就被替换了。
现在改成:
scss
// 容器层:选中态唯一来源
const selectedFid = ref(null)

function selectFeature(fid) {
  selectedFid.value = fid
  // 通知所有订阅方
  bus.emit('selection-change', fid)
}

// 地图和属性表都只订阅,不各自存状态
watch(selectedFid, (fid) => {
  applyMapHighlight(fid)     // 地图层:根据 id 重新找到要素并高亮
  scrollTableToRow(fid)     // 属性表:滚动并高亮对应行
})
关键点:所有地方都存 fid,不存要素对象。 地图数据刷新后,fid 不变,高亮照旧。
高亮本身也很直接,直接操作 feature 的样式:
scss
function applyMapHighlight(fid) {
  // 先清掉旧高亮
  clearPreviousHighlight()

  const feature = findFeatureById(fid)
  if (!feature) return

  const style = buildHighlightStyle(feature)
  highlightLayer.getSource().addFeature(
    new OlFeature(feature.clone())     // 用副本,避免污染源数据
  )
}

function clearPreviousHighlight() {
  highlightLayer.getSource().clear()
}
用副本而不是原要素,是为了不把高亮样式写进数据源 ------ 否则用户手工改了样式,高亮就撤不掉了。
四、踩过的坑
坑一:地图移动后选中高亮消失
这是前面反复提到的那一个。
现象:用户在属性表里选中一条记录,地图上高亮正常;然后拖动地图,视野一变,高亮没了。
排查过程 :一开始以为是渲染问题,加了半天气泡,加边框、加描边都没用。加日志发现,地图移动会触发可视范围取要素,clear() 之后 addFeatures() 重新塞了新的要素对象 ------ 而我的 selected 里存的还是原来那个对象引用。新对象进来了,旧的被移除了,高亮的自然对不上。
一开始的修法很直接:每次取完数据重新用 id 找一遍要素再高亮。但这引入了另一个问题 ------ 如果用户选中的要素不在当前可视范围内(很常见,比如在属性表里翻到了一条很远的数据),就找不到了,高亮直接丢失。
最终修法 :不存对象,存 fid。selected 里始终是一个字符串 / 数字,地图数据怎么刷新都不影响它。高亮时再根据 fid 从当前数据里找,找不到就先不显示,等要素进入视野时再补上。
这个坑之后我加了一条约定:跨组件传递一律传 id,不传对象。 后面的事件接口都是按这个设计的。
坑二:路由切换回来,地图变成空白
现象 :从地图页面跳到别的页面再回来,地图容器是空的,控制台有 Cannot read properties of null。
原因 :z-map 组件的 mounted 里创建地图实例,但路由切走时组件被销毁,我没在 beforeUnmount 里销毁 OL 实例。第二次进入时 mounted 又跑了一次,容器 div 上已经残留了上一次的 canvas,新的地图画在下面看不见。
修法 :beforeUnmount 里显式 map.setTarget(null) 并 map.dispose()。另外在 mounted 里加了一层判断 ------ 如果容器里已经存在 canvas,说明上一次没清干净,先清掉再建。
顺带一个坑 :后来又遇到"页面滚走再滚回来地图变形",是因为监听 window.resize 时 debounce 没做,用户快速拖动窗口会连续触发重算。这两个问题一起修之后,地图相关的问题基本清零了。
坑三:接口没接好时,前端"假死"
现象:后端要素接口响应慢的时候,整个页面卡住,点什么都无响应。
原因:取要素的请求是同步等待的,接口一慢,主线程就一直等着。更糟的是我在这个流程里还串了几个后置操作(解析、样式计算、渲染),一起卡住。
修法:改成异步 + 状态分离:
- 请求发起时立刻把图层标记成
loading状态,先给用户一个可交互的底图
- 请求回来后再更新要素,底图保留
- 请求失败时图层标记成
error状态,界面上给出提示,而不是静默失败
css
layerState.value = { [code]: 'loading' }
// ...异步请求
layerState.value = { [code]: 'success' }
// catch
layerState.value = { [code]: 'error', message: '要素加载失败' }
改完之后,慢接口不再阻塞界面,用户能明确看到"哪个图层在加载、哪个失败了"。
五、效果
- 5 个平台复用同一套组件
- 新平台接入成本从一周左右降到两天(主要是省掉了反复调图层交互的时间)
- 地图相关的问题基本收敛在组件内部,业务侧不再出现 OL 的调用
- 改公共组件后,业务侧需要跟着改的地方从多处降到 0 处 ------ 这条是封装真正的收益,以前改一个交互要全项目找
六、这套设计还留下的问题
这套东西不是完美的,有几个当时判断不值得做、现在回头看需要补的:
量级问题。 组件库的假设是"要素量不大、按可视范围取"。如果单个图层要素量到十万级,或者图层数量到几十个,可视范围取要素的策略需要重新设计,可能要引入聚合和分块加载。这一块我没有实际验证过,只是预判。
类型定义。 项目当时是 JS,没上 TS,导致 prop 和事件的定义全靠注释和文档维护。现在回头看,事件总线是这套设计里最容易出错的地方,有类型约束会好很多。
测试。 地图交互的自动化测试成本高(要模拟画布、事件、异步渲染),当时没做。这导致几个问题都是靠手动点出来的,后来改了组件只能靠人再点一遍 ------ 这个代价不小。
如果重做一次 ,我会先做两件事:把事件总线换成有类型的定义,以及把 beforeUnmount 里的清理逻辑写成一个可复用的钩子,而不是每个组件自己写一遍。
本文案例均已脱敏,仅用于技术交流。