大家好,我是晚安code。
这篇不打算重复那些「定义 + 通信流程 + 框架对比」的套路,我想聊的是:RPC 的甜头来自「像本地调用一样」,它所有的坑也全部来自「它毕竟不是本地调用」。
一、RPC 是什么:一次调用,怎么就跑到了另一台机器上
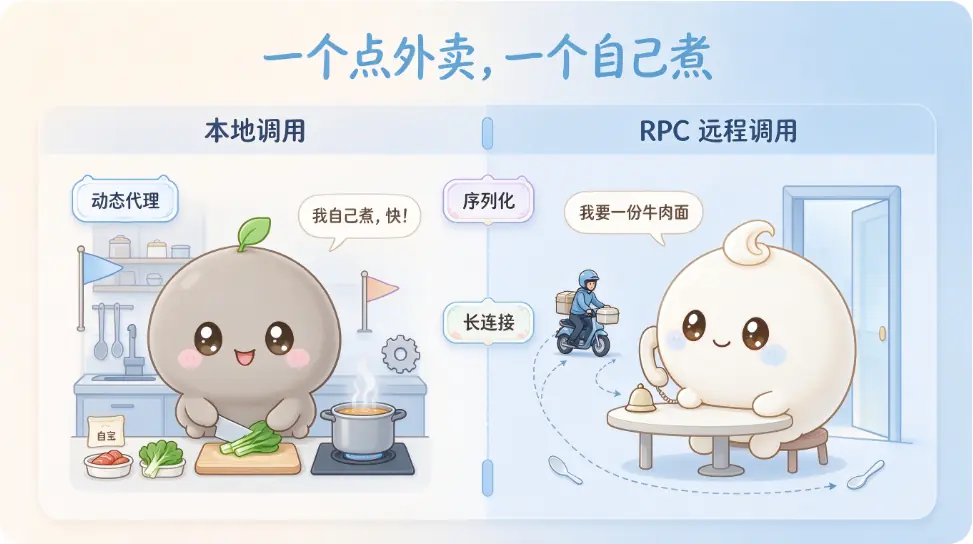
RPC(Remote Procedure Call,远程过程调用):让调用方像调用本地方法一样,去调用另一台机器上的方法,把寻址、序列化、网络收发这些事全部藏进框架里。类比:你在外卖软件上下单点一份牛肉面,只要说清楚要什么,骑手怎么找路、厨房在哪栋楼、配送箱保不保温,都不用你管。
这个类比得往下再走一步,因为这里正好是第一个分岔口------外卖送到你手上,和你在楼下自己煮一碗面,中间差着的东西,恰恰是 RPC 隐藏掉的全部复杂度。
序列化(Serialization):把内存里的对象转成能在网络上传输的字节流,接收端再还原成对象,后者叫反序列化。类比:把一台组装好的家具拆成平板打包寄走,收件人照着图纸拼回去------拆和拼都不难,难的是图纸不能有歧义。
一次 RPC 调用,代码上只有一行,实际跑起来是这么一条链:
1)你写的 userService 其实不是实现类,是一个动态代理生成的桩,它长得像接口,干的却是打包的活。
2)代理把「接口名 + 方法名 + 参数」序列化成一段二进制。网络只认字节,不认 Java 对象,这一步绕不开。
3)二进制顺着一条已经建好的长连接发出去。注意是长连接------每次调用都重新握手,那是 HTTP/1.1 时代的做法。
4)对端的解码器把字节还原成对象,查路由表找到真正的实现类,反射调用它。
5)返回值再反过来走一遍序列化和网络,最后你的 getUser(id) 拿到了一个 User 对象。
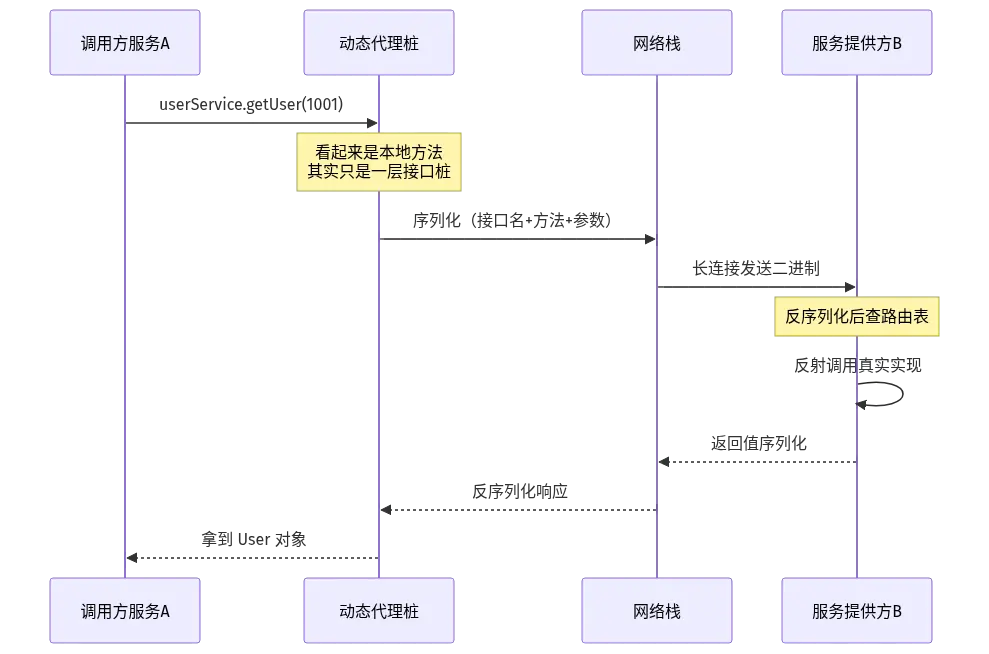
图里我特意把「动态代理」放在最前面。很多人以为 RPC 的魔法发生在网络上,其实第一步就发生了:那行代码从写下的一刻起,就不是本地调用。
二、RPC 到底解决了什么问题(它最早真不是为了性能)
搜 RPC 的文章,十篇里有九篇会说「为了性能」。这个说法不算错,但顺序反了。
RPC 这个概念的源头是 1980 年代的 Bruce Jay Nelson,他在论文里给的目标是「简单、高效、通用」------注意,简单排在高效前面。而微服务时代我们真正被它救过的,也不是那点吞吐量,是下面这三件具体的事。
第一件:不用每个团队自己重写一遍连接池。
三个团队各自用 HttpClient 封装了一套调用层。半年后的结果是:A 团队的重试是无限次,B 团队的重试是三次但不做退避,C 团队压根没超时。同一个上游服务抖了一下,三家的表现完全不同。后来统一 RPC 框架进来,第一件砍掉的事就是这三套各写各的。
序列化、收发线程、连接池、超时、状态机------这些是「业务之外」的技术劳动。一个团队写一遍是本事,十个团队写十遍是浪费。
第二件:调用方不该关心对端在哪台机器上。
服务实例会扩容、会缩容、会上线、会挂掉。如果调用方靠配置文件写死 IP,那运维每加一台机器,就得推一次配置重启一批应用。RPC 框架配一个**服务发现(Service Discovery)**就解决了:实例启动时把自己注册到注册中心,调用方从本地缓存里拿地址列表,节点变化时自动同步。类比:你不用背下全城每一家面馆的地址,打开外卖软件它自己知道谁在营业。
第三件:把「这是远程」这件事从业务代码里抹掉。
如果不封装,你每调一个远端方法都要手写一段「拼 URL、发请求、判状态码、解析 JSON、异常处理」。业务逻辑被稀释得只剩三成,剩下七成在跟网络打交道。RPC 把这七成收进了框架。
三、为什么用 RPC,而不是 HTTP、MQ 或者 WebSocket
先把一个常见的说法掰正:HTTP 是一种应用层协议,而 RPC 是一类调用模型。「HTTP 和 RPC 谁更强」这个问法本身就不成立,gRPC 的底座就是 HTTP/2。它们真正的分野在建模方式上------HTTP/REST 面向资源,RPC 面向方法。
GET /users/1001 描述的是「我要拿编号 1001 这个资源」;UserService.getUser(1001) 描述的是「我要执行 getUser 这个方法」。你的微服务边界是按业务能力切的,而业务能力天然是「一个个能调用的方法」,不是「一堆资源目录」。这是 RPC 在内部调用里更顺手的第一层原因。
第二层是工程上的具体差别,列成表更清楚:
| 对比维度 | HTTP/REST | RPC 框架(gRPC / Dubbo) |
|---|---|---|
| 建模方式 | 面向资源:/users/1001 |
面向方法:UserService.getUser(id) |
| 数据格式 | 文本 JSON,Header 偏大 | 二进制 Protobuf / Hessian,报文紧凑 |
| 连接方式 | HTTP/1.1 多为短连接 + Keep-Alive | 长连接 + 多路复用 + 连接池 |
| 服务发现 | 依赖 DNS 或网关转发 | 内置注册中心,实例上下线自动感知 |
| 对外兼容 | 浏览器、第三方直接可用 | 需要 SDK 或 IDL,浏览器不直接支持 |
| 调试成本 | 低,curl 就能打 | 中,得先有 .proto 和生成的桩 |
**那什么时候该用 HTTP,什么时候该用 RPC?**我的划分很土,但用了几年没出过问题:对外用 HTTP,内部用 RPC,异步用 MQ,推送用 WebSocket。
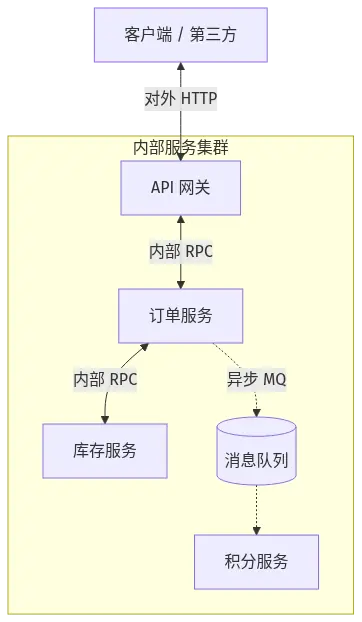
边界画清楚之后有个附带好处:团队吵「用哪个」的次数明显变少了。给第三方开放的接口,你必须用 HTTP,因为这由对方的接入成本决定,不由你的偏好决定;反过来,订单服务调库存服务这种内部一跳,用 HTTP 就是给自己找麻烦。
有两个判断句我想单独拎出来说,因为它们和网上的主流说法相反:
**「HTTP 更简单,所以内部调用也应该用 HTTP」------这句话只在接口数量少、团队规模小的时候成立。**接口数一旦过百,没有契约约束的 JSON 就会变成一场灾难:字段名靠口口相传,类型靠运行时才发现,改一个字段没人知道影响了谁。
**MQ 和 RPC 不是替代关系,是两种时间观。**RPC 是你现在就要答案,MQ 是你先收下这件事、回头再处理。下单后扣积分这种「必须成功但可以晚一点」的操作,用 RPC 硬扛只会把两个服务绑在一条命上。
四、怎么应用:RPC 藏起来的三件事
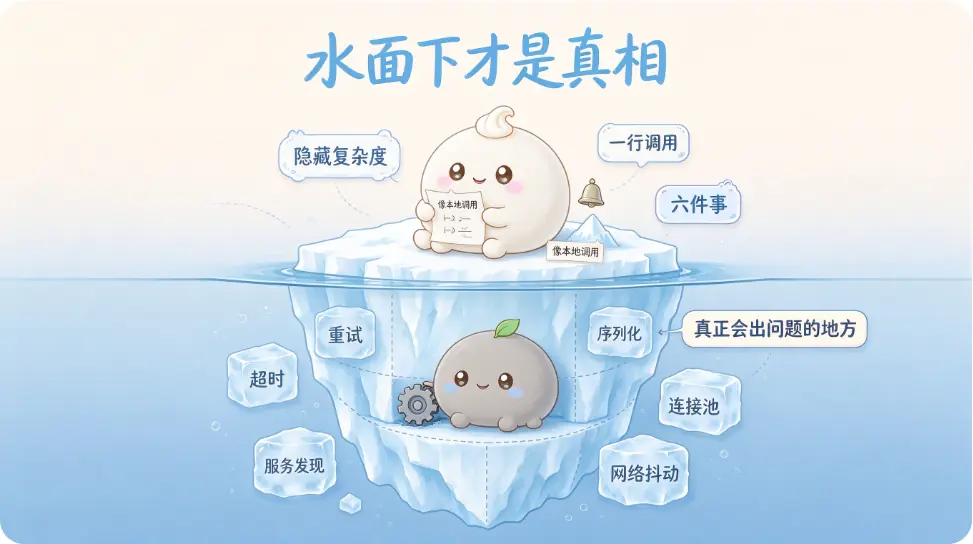
这一节是全文我最想让你记住的部分。前面说了半天「像本地调用一样方便」,现在得说硬币的另一面。
第一件:它看起来是本地调用,但它会超时。
本地方法调用只有三种结局:返回、抛异常、死循环。RPC 有第四种:没有结局。请求发出去了,对方可能正在 GC、可能网络在丢包、可能对端进程已经挂了但 TCP 连接还没断。你的线程就那么挂着,一直挂着。
我见过最典型的一次事故:一个查询接口,上游给它的超时是 30 秒,它给下游的也是 30 秒。下游卡住的时候,上游连接池被占满,整个服务雪崩。正确的做法是给超时做预算,而不是给每一跳都配一个「默认值」------上游总共 800ms 的容忍度,那给下游最多 300ms,剩下 500ms 留给自己的处理和网络往返。超时不是越大越安全,越大越危险。
第二件:它看起来只会执行一次,但它可能重试。
「网络超时」这四个字是有歧义的。它可能是请求没发到,也可能是请求发到了、对方处理完了、但响应回来的路上丢了。你这边看到的结果一样,服务端那边的状态却完全不同。所以无脑重试一个「扣库存」的接口,就等着用户投诉吧。
幂等(Idempotent):同一个操作执行一次和执行多次,对系统状态的影响完全相同。类比:电梯的「关门」按钮你按几下都一样,门就是关上------它不因为你多按了三次就关三次。
工程上的落点很简单:调用方生成一个全局唯一的请求 ID 带上去,服务端拿它做去重,处理过的直接返回上次的结果。这件事必须在设计接口的时候就想,事后补的代价通常是改数据库。
第三件:它看起来像函数,但接口设计不该照着本地函数来。
这条最容易踩,因为它不报错。有些团队用 RPC 用得跟没用一样------一个接口叫 doSomething,参数是一个大的 JSON 字符串,返回值也是 JSON 字符串,业务字段全靠字符串里解析。这就麻烦了:你把 RPC 当成了 HTTP 用,那么 RPC 的好处你一样没拿到。
所以 RPC 的接口要切得细一点、语义明确一点:getOrderById 和 listOrdersByUser 就是两个接口,不该为了「少写两个方法」硬合并成一个 queryOrder。接口数量少不等于设计好,语义清楚才算好。
正确的用法长这样------先用 IDL 写契约,再生成调用桩,调用方拿到的是一份有类型的接口:
五、RPC 真正的好处:它把跨进程调用变回一份可检查的合同
知道了坑在哪,再回头看好处,你会发现它们其实是同一件事的两面。
好处一:契约是编译期的。
这是我认为 RPC 最被低估的价值。写完 .proto 或者接口定义,代码生成器会给你一份带类型的桩。字段类型改了、方法签名变了,调用方编译就过不去。**这不是「节省时间」,这是把一整类线上事故提前到了本地。**用裸 HTTP + JSON 的时候,字段对了错了,只有跑起来才知道。
好处二:跨语言是真的跨语言。
服务 A 用 Java,服务 B 用 Go,服务 C 用 Rust,只要它们认同一份 IDL,互相调用就不用为对方改写架构。这一点在收购、合并、多团队并行的时候价值特别明显------你不用劝另一个团队换语言。
好处三:服务治理是内建的,不是外挂的。
负载均衡、失败重试、熔断降级、灰度路由、链路追踪、实例上下线无感------这些东西如果自己基于 HTTP 搭,每一项都是一个独立项目。RPC 框架把它们做成了配置项。
好处四:长连接扛得住高并发。
对内部的短平快调用来说,每次请求都走一遍三次握手是纯浪费。长连接 + 多路复用把这块开销压掉了。这也是为什么秒杀、Feed 流这类场景,内部链路基本清一色是 RPC。
截至 2026 年 10 月,主流选择基本就三个:gRPC (HTTP/2 + Protobuf,多语言、支持流式,跨语言场景首选)、Dubbo (Java 生态里服务治理最完整的,triple 协议在语义上和 gRPC 对齐)、Thrift(老牌,多语言,但生态热度不如前两个)。选型的顺序我建议是:先看团队主语言,再看要不要跨语言,最后才比性能------因为对绝大多数业务来说,这三者的性能差距都不是瓶颈。
可能有人会问:gRPC 底层就是 HTTP/2,那「内部用 RPC 不用 HTTP」这句话是不是自相矛盾?
不矛盾。协议是运输工具,RPC 是说怎么建模、怎么治理。gRPC 用 HTTP/2 当底座,但它给你的是 IDL 契约、代码生成、流式语义和一套治理能力------这些东西 HTTP/2 本身并不提供。你完全可以手写 HTTP/2 请求,只是那样你就得自己把 RPC 框架又实现一遍。
可能有人会问:我们团队接口不到 20 个,是不是没必要上 RPC 框架?大概率是的。接口少、团队小的时候,裸 HTTP + 一份约定好的 JSON schema 跑得又轻又快,引入 RPC 框架反而增加了构建和调试成本。我的经验阈值是「服务数过 10 个、或者有跨团队调用」------到这个时候,寻址和契约的一致性会开始收税。
六、写在最后:RPC 让你忘记网络,但你不能真的忘
回到开头那个 userService.getUser(id)。
RPC 做的事情,本质上是在工程上给「分布式」这件事做了一次精致的包装:它让你写代码的时候可以假装没有网络。这个假装是有价值的,它让业务逻辑重新变成业务逻辑。
但假装归假装,线上不会陪你演戏。每一次「像本地调用」的舒适,背后都该有一次「它不是本地调用」的清醒------超时写了没有,重试幂等了没有,这个接口的语义是不是切得够清楚。
把这三件事做到,RPC 才真的帮你省事;做不到,它就只是把一次故障从三天前挪到了上线当天。
我是晚安code,持续分享编程干货。觉得有用的话记得点赞收藏和关注~也欢迎在评论区聊聊:你们项目里的 RPC 调用,超时和幂等这两件事,是设计的时候就定好的,还是出事之后补上的?