GPU 利用率很低不一定是模型慢;利用率很高也不代表整条视频任务足够快。用户等待的是从输入视频到可播放结果的总时间,而这段时间由读取解码、预处理、推理、后处理、绘制和编码共同组成。本文用固定视频任务说明怎样定位瓶颈,而不是只报一个模型 FPS。
目录
- 先拆开端到端耗时
- 不同瓶颈该怎么处理
- [最小测量实现、测试与 SQL](#最小测量实现、测试与 SQL)
- 验收边界
- 性能结论怎样才能比较
- 小结
一、先拆开端到端耗时
text
总耗时 = 探测/解码 + 预处理 + 推理 + 后处理 + 绘制/合成 + 编码/写盘同一模型在图片基准中很快,放进视频任务仍可能受解码、CPU 内存复制或编码限制。性能记录必须按阶段保留帧数、总耗时、平均耗时和长尾耗时。
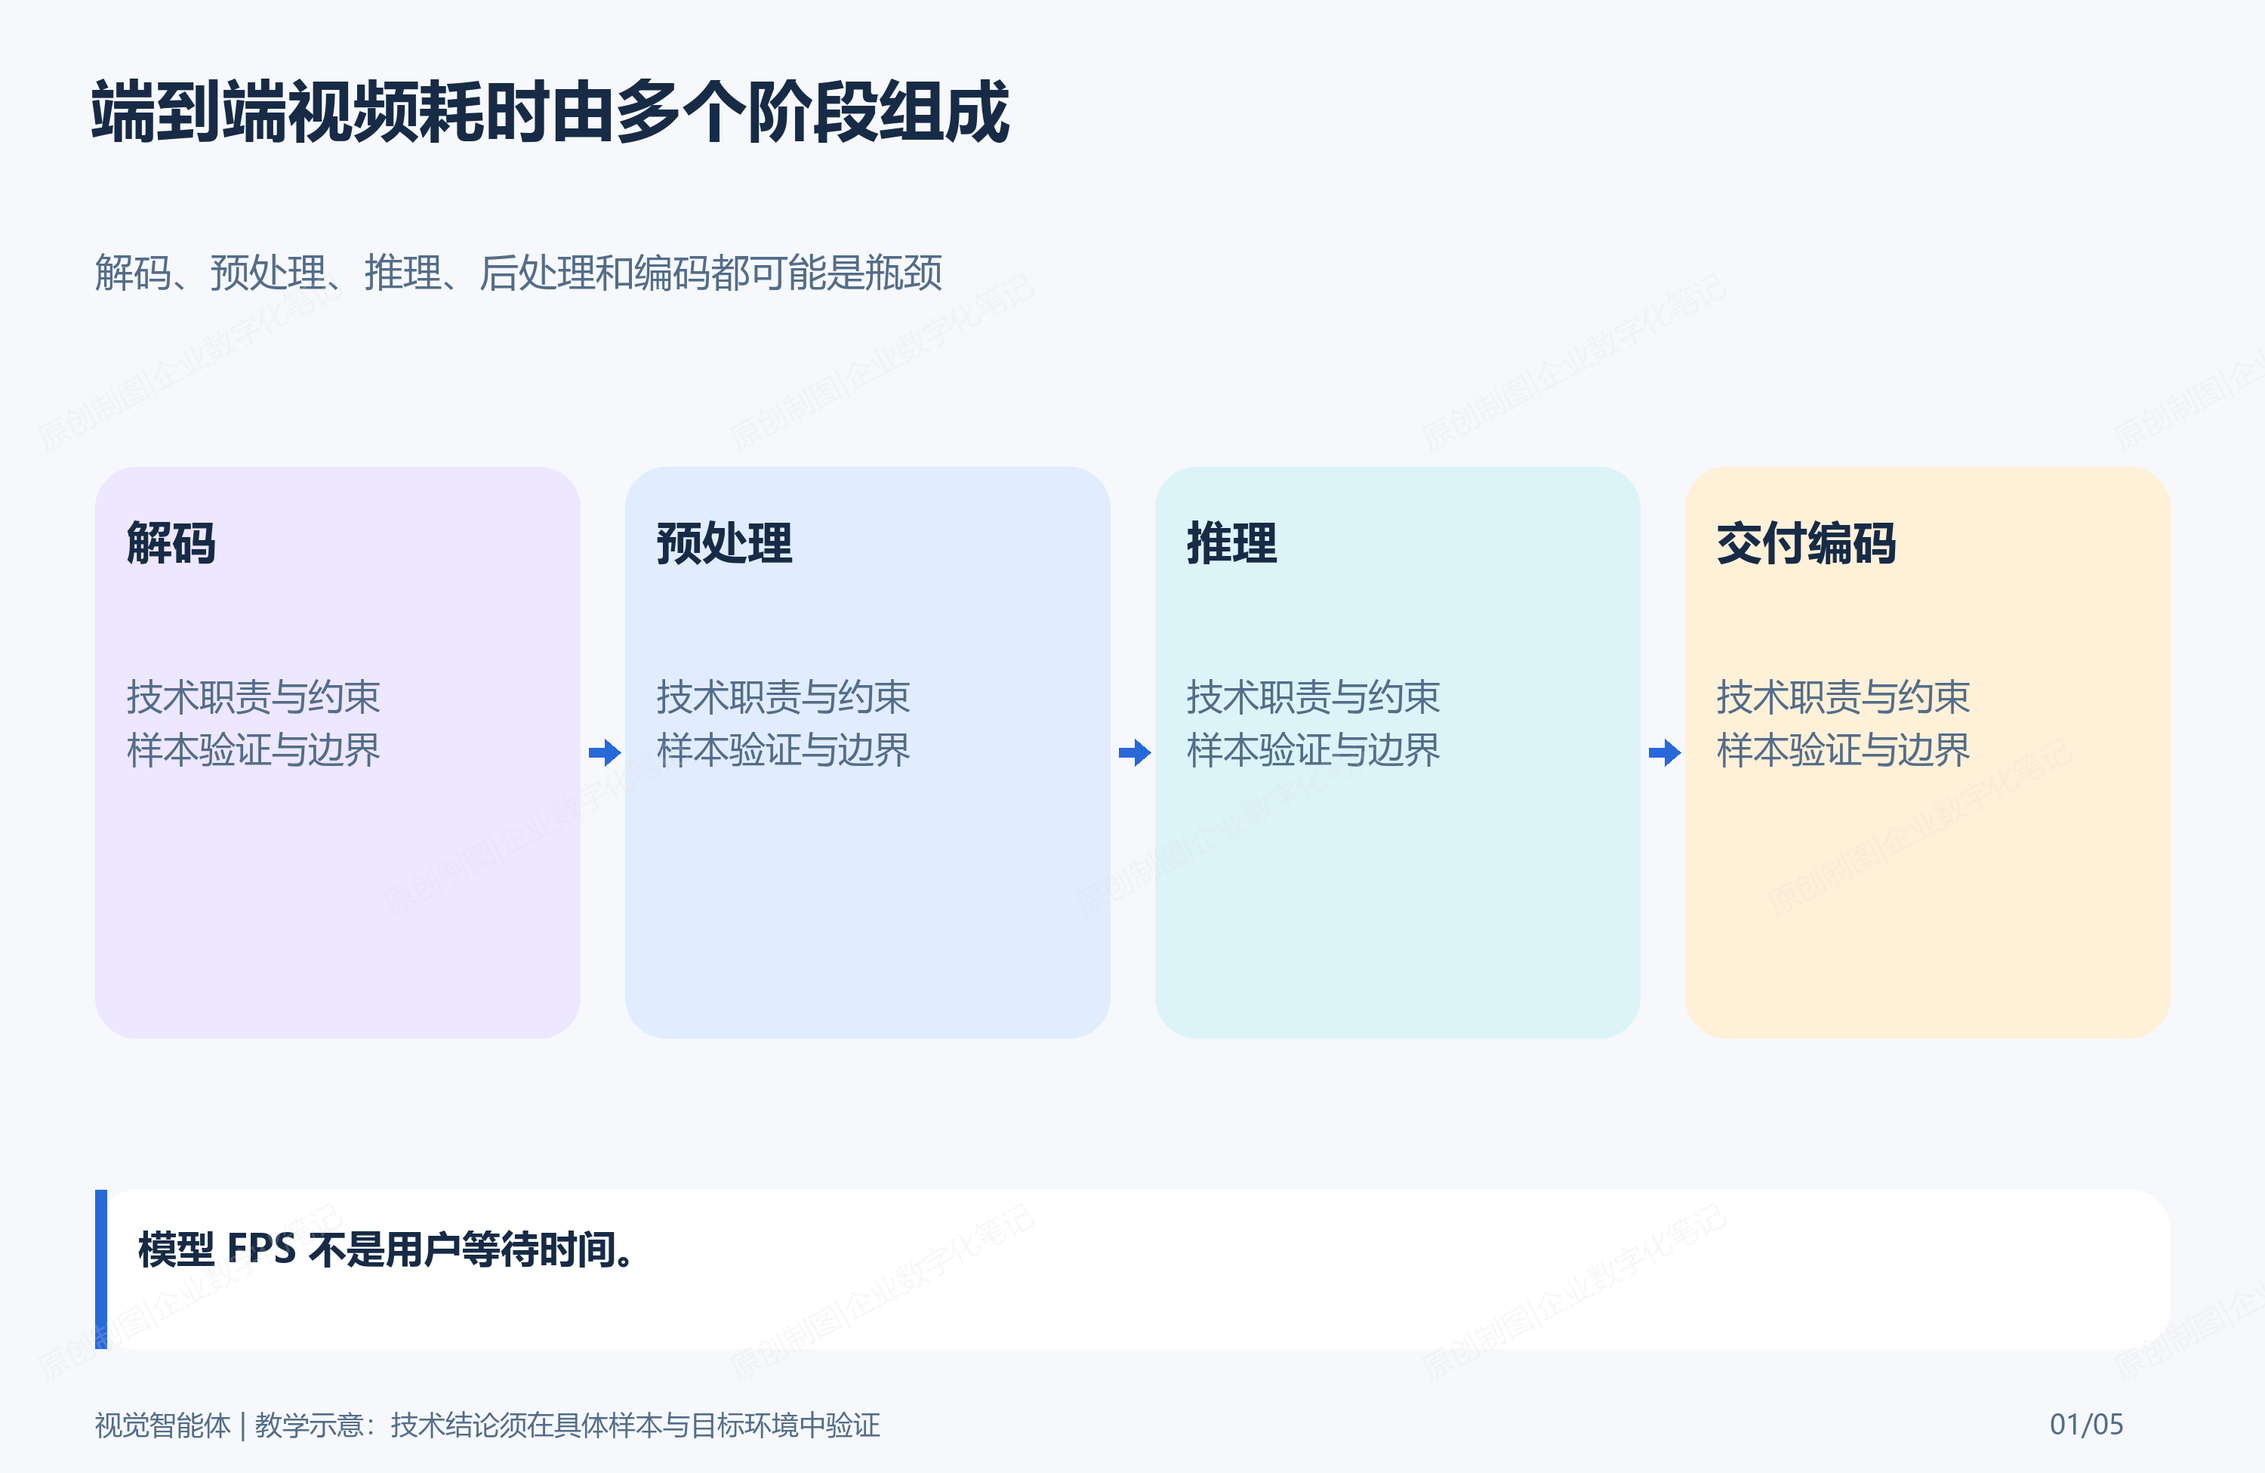
图1:模型 FPS 不是用户等待时间,性能必须落到整条视频处理链。
二、不同瓶颈该怎么处理
| 瓶颈 | 典型症状 | 首先检查 | 可行方向 | 不应直接做 |
|---|---|---|---|---|
| 解码/读取 | GPU 空闲、读帧不足 | 编码、磁盘、读取耗时 | 批量读取、合适解码器 | 盲目换更大 GPU |
| 预处理 | CPU 高、推理等待 | resize、颜色转换、内存复制 | 合并操作、减少复制 | 降模型精度掩盖问题 |
| 推理 | GPU 阶段占比最高 | 输入尺寸、batch、运行时 | 选择模型规格与运行时 | 只报单图 FPS |
| 后处理/绘制 | 模型快但整体慢 | NMS、轨迹、文字绘制 | 减少重复计算 | 丢掉必要证据 |
| 编码/写盘 | 处理后仍长时间卡住 | 编码器、码率、磁盘 | 合适编码与异步交付 | 把临时文件当结果 |
表格只能提供第一眼的判断,真正排查时应从任务时间线倒推,而不是看到 GPU 利用率低就先怀疑模型。下面以固定的 VP-20261005-001 视频任务为例:输入为 90 秒、1080P、25fps 的 MP4,输出为同分辨率标注 MP4。先记录每个阶段处理了多少帧、花了多少时间、是否出现重试;再只改一个变量复测,避免一次同时改模型、编码器和 batch 后无法判断收益来自哪里。
1. 解码慢:先确认不是输入媒体或读取路径在拖后腿
如果 VideoCapture.read() 经常等待、CPU/GPU 都不忙,或同一视频在不同机器耗时差异极大,先检查输入编码、磁盘位置和实际读帧速度。不要只看文件大小:高码率、长 GOP、网络盘读取、损坏帧重试都可能让解码成为主耗时。ffprobe 用于记录编码、帧率、时长和流信息;FFmpeg 的 -benchmark_all 可辅助观察解码/编码阶段耗时。
bash
ffprobe -v error -select_streams v:0 \
  -show_entries stream=codec_name,width,height,r_frame_rate,avg_frame_rate \
  -show_entries format=duration,size -of json source.mp4

ffmpeg -benchmark_all -i source.mp4 -f null -
若媒体侧耗时占比高,优先比较本地磁盘与网络路径、输入编码差异、目标帧抽取策略;若业务只需每 5 帧分析一次,应在任务定义中明确采样策略,而不是悄悄跳帧后仍按全帧结果宣传速度。
2. 预处理慢:查重复转换与 CPU-GPU 数据搬运
视觉模型通常需要固定尺寸和颜色排列,例如 BGR 转 RGB、缩放、归一化、HWC 转 CHW,再把数组复制到 GPU。逐帧创建新数组、重复 cvtColor、每个小步骤都在 CPU/GPU 间同步,会让模型等待数据。先在日志中把 read、resize、color_convert、to_device 单独计时,再检查是否有两次缩放或不必要的 numpy -> tensor -> numpy 往返。
python
frame = timer.measure("decode", capture.read)
rgb = timer.measure("bgr_to_rgb", lambda: cv2.cvtColor(frame, cv2.COLOR_BGR2RGB))
input_tensor = timer.measure("preprocess", lambda: to_model_tensor(rgb, size=640))
input_tensor = timer.measure("host_to_device", lambda: input_tensor.to("cuda", non_blocking=True))
这里的目标不是把代码压成一行,而是让每次内存搬运都有名字。若 host_to_device 占比异常,才进一步检查 batch、固定输入形状、页锁定内存或运行时配置;不能先假定 GPU 算力不足。
3. 推理慢:区分模型算子、输入形状与运行时开销
确认推理是真瓶颈后,再比较模型大小、输入尺寸、batch 和运行时。输入边长从 640 提升到 1280,计算量并非简单翻倍;动态输入形状也可能引入额外的运行时开销。PyTorch 可用 Profiler 查算子和显存,TensorRT 可用 trtexec 或逐层信息查引擎执行;但任何 FP16/INT8、TensorRT、ONNX 的速度收益都必须配合关键类别的 recall 和标注帧复检。
不要把"推理时间下降"直接写成"系统性能提高"。若量化后小目标漏检增多,或动态形状在真实输入上出现首帧长尾,整体任务并没有真正变好。
4. 后处理与编码慢:模型完成以后仍有大量工作
NMS、跟踪关联、掩膜缩放、文字绘制和将帧写回视频都发生在模型之后。特别是逐帧绘制大量中文文本、逐帧创建编码器、或把临时图片落盘再读回,常会让"模型只占 30%"的任务被误诊为推理慢。编码阶段还要区分 CPU 编码、GPU 编码、码率控制和写盘等待;优化时保持输出分辨率、帧率和媒体校验一致,不能以降低交付要求换取好看的数字。
text
推荐排查顺序:媒体探测 -> 分阶段计时 -> 确认最大阶段 -> 只改一个变量 ->
重新检查输出帧数、检测结果和媒体属性 -> 写入新的基线或回滚。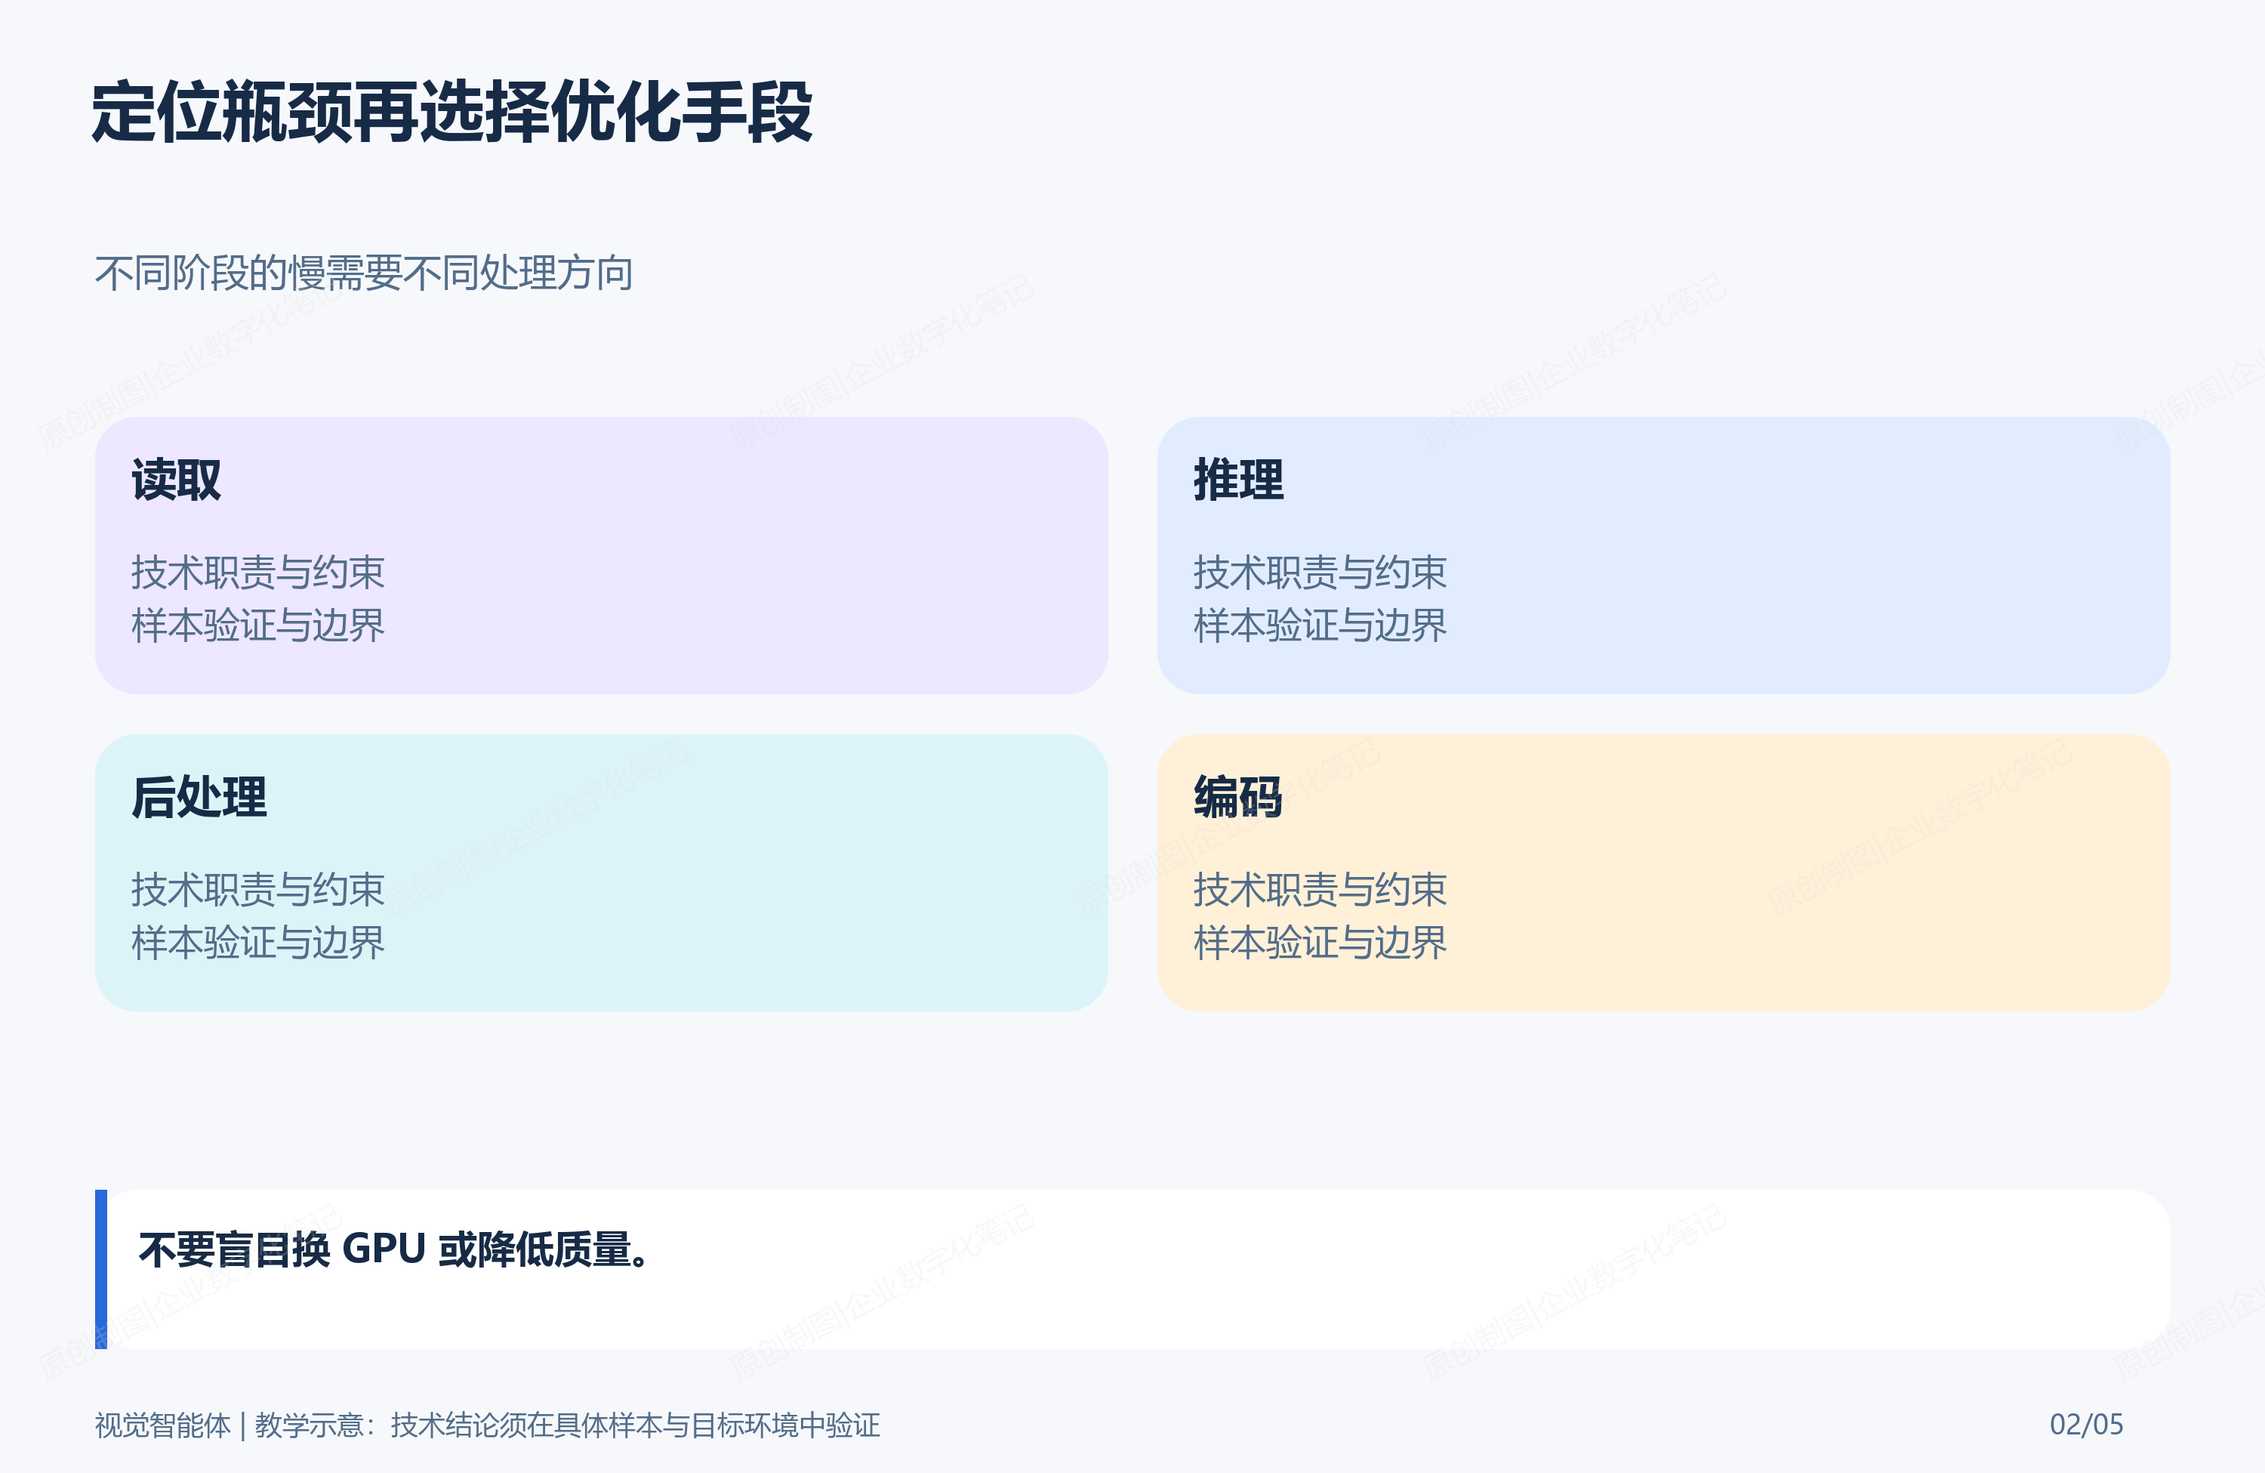
图2:瓶颈不同,优化方向不同;模型推理不是唯一可优化对象。
三、最小测量实现、测试与 SQL
python
from time import perf_counter

class StageTimer:
    def __init__(self): self.total = {}
    def measure(self, name, fn):
        begin = perf_counter(); result = fn()
        self.total[name] = self.total.get(name, 0.0) + (perf_counter() - begin) * 1000
        return result

def bottleneck(total: dict[str, float]) -> str:
    return max(total, key=total.get)
GPU 计时不能只包住一行 model(frame)
CUDA 调用通常是异步提交的:CPU 代码继续往下走,并不代表 GPU 已完成计算。因此直接用 perf_counter() 包住推理调用,可能得到的只是提交开销。基准前需要预热,计时边界需要同步,并将解码、拷贝、推理、后处理分开记录:
python
import time
import torch

def timed_inference(model, batch):
    for _ in range(10):
        model(batch)                       # 预热,不计入结果
    torch.cuda.synchronize()
    started = time.perf_counter()
    output = model(batch)
    torch.cuda.synchronize()
    return output, (time.perf_counter() - started) * 1000
这段示例只适用于 CUDA 可用时;CPU、ONNX Runtime 或不同推理引擎应采用各自的同步与计时方式。一次基准还应记录 P50、P95 和最大值。平均 20ms、但每 100 帧有一次 400ms 卡顿的系统,对实时预览和视频队列都是不同的问题。
用 Profiler 找到"推理慢"背后的具体阶段
阶段计时告诉我们哪一段慢,torch.profiler 可以进一步观察 CPU、CUDA、显存、算子输入形状和调用栈。Profiler 本身有开销,应只对有限帧采样,不能混入正式性能数字:
python
with torch.profiler.profile(
    activities=[torch.profiler.ProfilerActivity.CPU,
                torch.profiler.ProfilerActivity.CUDA],
    record_shapes=True,
    profile_memory=True,
) as profiler:
    for _ in range(20):
        model(batch)

print(profiler.key_averages().table(sort_by="cuda_time_total", row_limit=12))
看到 resize、颜色转换或 CPU 到 GPU 的复制占比高时,换更大模型没有意义;看到 NMS 或绘制占比高时,应审查后处理;若 GPU 算子本身占主导,才进入模型规格、输入尺寸、batch、运行时和精度的选择。
python
def test_bottleneck_is_largest_stage():
    assert bottleneck({'decode': 12, 'infer': 50, 'encode': 20}) == 'infer'
固定基准与预期输出
基准任务 VP-20261005-001 使用同一份 90 秒、25fps、1080P 脱敏视频,固定模型版本、输入尺寸、阈值和输出编码。每次运行输出以下摘要,而不是只有"总用时":
json
{
  "frameCount": 2250,
  "decodeMs": 18400,
  "preprocessMs": 6200,
  "inferenceMs": 33200,
  "postprocessMs": 5800,
  "encodeMs": 19100,
  "outputFrames": 2250
}
例如推理占比不足 30% 时,优先优化模型很可能没有收益;若编码耗时占比最高,则需要检查交付编码策略和存储,而不是压低检测阈值。基准输入和输出质量不变,是任何前后对比成立的前提。
媒体基准与推理基准必须分开看
FFmpeg 可以通过 -benchmark 或 -benchmark_all 输出编码、解码相关的时间信息;它适合确认媒体侧是否成为瓶颈,但不能证明模型算子是否高效。相反,TensorRT 或 ONNX 等推理运行时的基准也不应拿来代表整条 MP4 工作流。
bash
# 只用于收集媒体侧基准信息;实际编码参数按交付要求确定。
ffmpeg -benchmark -i source.mp4 -c:v libx264 -c:a aac output.mp4

# 运行时基准要固定输入形状、batch、精度和设备,不能与端到端时长混写。
trtexec --onnx=model.onnx --shapes=images:1x3x640x640 --useCudaGraph
运行时选择也不是"TensorRT 一定更快"。TensorRT 可使用 FP16、INT8 等精度和图优化来改善 NVIDIA GPU 推理,但需要对量化或精度切换后的关键类别结果重新验证;CPU 部署则可能更适合 ONNX 或 OpenVINO 等路径。先建立统一输出质量的基线,再比较运行时,才能避免用速度掩盖感知退化。
sql
CREATE TABLE visual_performance_profile (
  id BIGINT PRIMARY KEY AUTO_INCREMENT,
  run_no VARCHAR(64) NOT NULL,
  frame_count INT NOT NULL,
  decode_ms DECIMAL(12,3) NOT NULL,
  preprocess_ms DECIMAL(12,3) NOT NULL,
  inference_ms DECIMAL(12,3) NOT NULL,
  postprocess_ms DECIMAL(12,3) NOT NULL,
  encode_ms DECIMAL(12,3) NOT NULL,
  UNIQUE KEY uk_visual_profile_run_no (run_no)
);

SELECT run_no FROM visual_performance_profile
WHERE frame_count <= 0 OR decode_ms < 0 OR inference_ms < 0 OR encode_ms < 0;
java
@Transactional(rollbackFor = Exception.class)
public PerformanceSummary record(PerformanceCommand command, StageCosts costs) {
    if (costs.frameCount() != command.expectedFrames()) {
        throw new BizException("性能结果帧数不完整");
    }
    profileRepository.save(command.runNo(), costs);
    return PerformanceSummary.of(costs, costs.largestStage());
}
自动测试除最大阶段识别外,还应覆盖帧数减少、阶段耗时为负、输出编码失败和运行时版本改变四种情况。任何一项发生时,不能把结果和上一轮基准放进同一张性能趋势图。
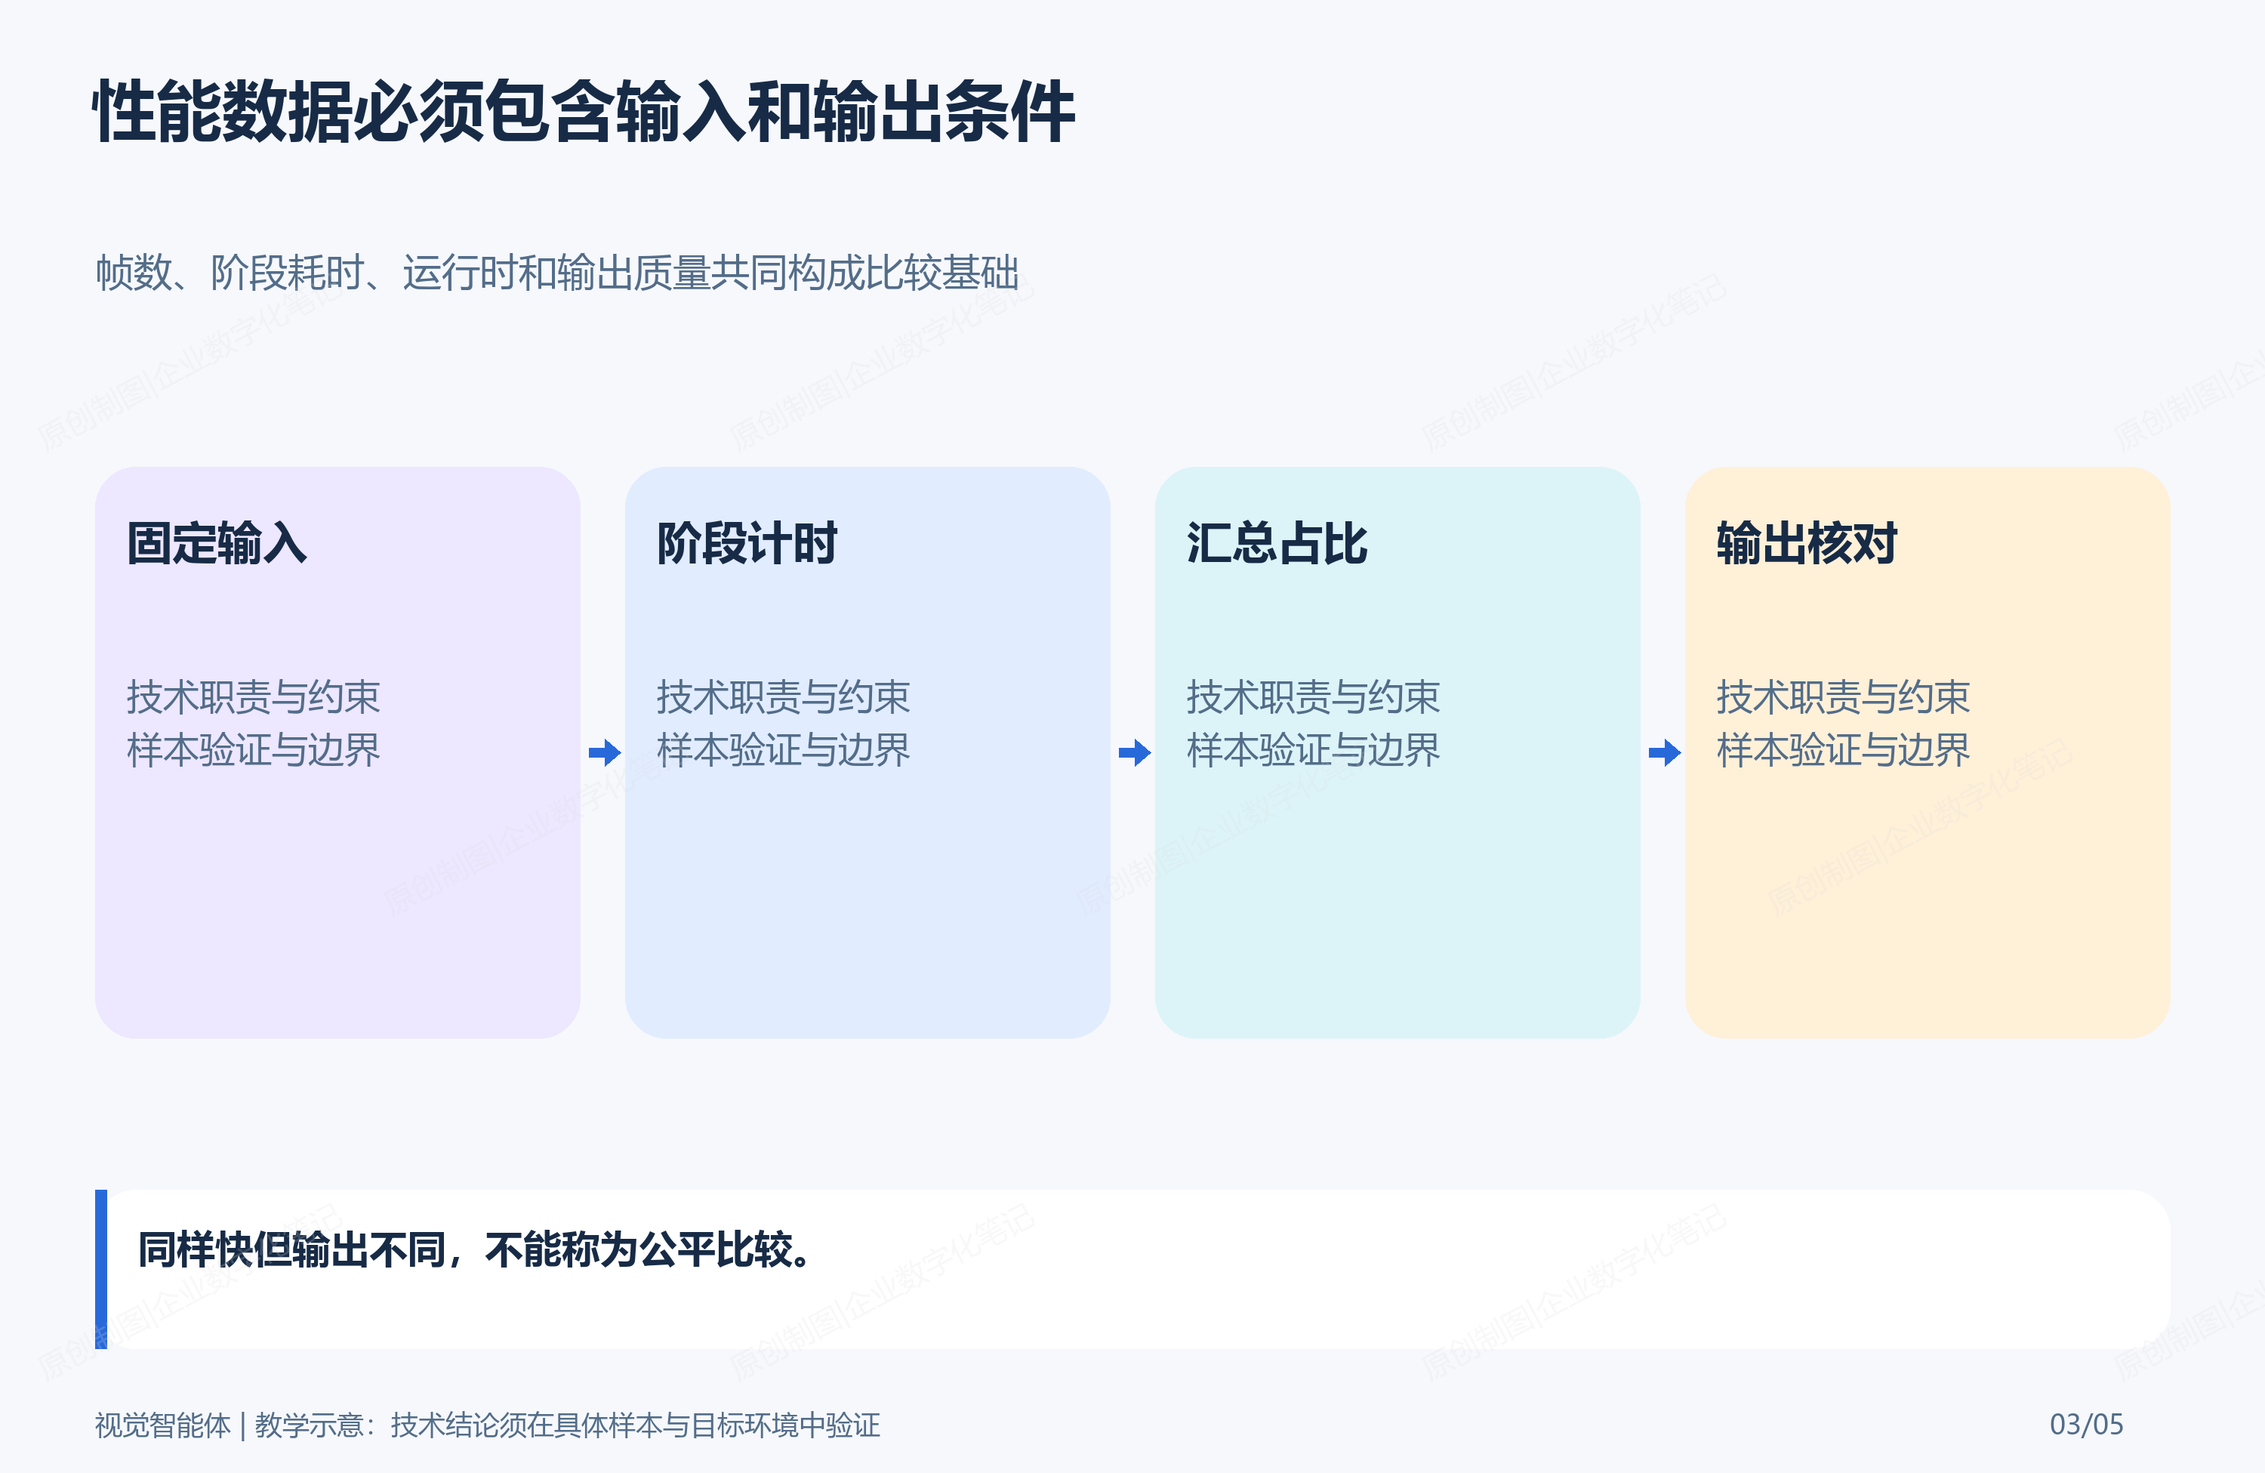
图3:相同输入、输出质量与阶段数据是性能比较的基础。
四、验收边界
优化后仍应核对输入帧数、输出帧数、模型/阈值、最终媒体流和视觉抽检。报告需要区分平均值与长尾耗时,避免偶发解码或写盘阻塞被均值掩盖。速度提升不能以少处理帧、丢失证据或损坏成片为代价。
性能通过不等于结果通过
一次优化可以改变运行时、batch、精度、编解码器或并行策略,但不能悄悄改变任务的业务含义。验收时至少把"速度是否提升"和"结果是否等价"拆成两张检查表:前者关注总耗时、P50、P95、显存和失败率;后者关注处理帧范围、关键类别结果、事件数量、掩膜/标注质量和最终媒体属性。
| 验收层 | 优化后必须保持或重新证明的事实 | 常见伪优化 |
|---|---|---|
| 输入范围 | 源文件摘要、起止时间、采样策略、实际读取帧数 | 悄悄少读尾部帧或提高抽帧间隔 |
| 感知结果 | 关键类别 recall、置信度阈值、检测/跟踪/掩膜抽检 | 降低输入尺寸或量化后漏检增加 |
| 事件结果 | 事件数、唯一性、时间窗口与证据引用 | 后处理跳过导致重复事件或少记事件 |
| 视频交付 | 宽高、fps、时长、视频/音频流、可播放性 | 降分辨率、去音频或输出损坏文件 |
| 稳定性 | 连续多次运行的 P95、失败率、显存峰值 | 只挑一次最快运行作为结论 |
例如,若为提升吞吐把输入从逐帧改为每 5 帧分析,必须将其登记为采样策略变更,重新评估快速移动目标的 recall 和事件时间偏差;它不是同等条件下的性能优化。若从 FP32 改为 INT8,也必须在关键类别、困难样本和输出视频上重新验收,不能只看引擎的毫秒数。
三道验收门:自动完整性、视觉抽检、媒体探测
第一道门是自动完整性:输入和输出帧数、任务状态、阶段记录、异常码是否齐全。第二道门是视觉抽检:在固定时间点对照优化前后的标注画面,检查检测框、轨迹编号、掩膜边缘或事件标记是否改变。第三道门是媒体探测:用 ffprobe 核对正式文件存在预期视频流、时长和分辨率;必要时再抽样播放,确认浏览器或目标播放器没有黑屏、无声或时间轴异常。
python
def performance_result_acceptable(before, after):
    same_frames = before["output_frames"] == after["output_frames"]
    recall_ok = after["key_recall"] >= before["min_key_recall"]
    latency_ok = after["p95_ms"] <= before["p95_ms"]
    media_ok = after["video_stream"] and after["duration_delta_ms"] <= 100
    return same_frames and recall_ok and latency_ok and media_ok

def test_faster_run_with_missing_frames_is_rejected():
    before = {"output_frames": 2250, "min_key_recall": 0.90, "p95_ms": 80}
    after = {"output_frames": 2200, "key_recall": 0.93, "p95_ms": 40,
             "video_stream": True, "duration_delta_ms": 0}
    assert not performance_result_acceptable(before, after)
什么时候可以更新性能基线
只有当三道门都通过,且连续多次运行没有出现异常长尾、显存泄漏或媒体失败,才应将该版本写为新基线。基线记录应同时包含源文件摘要、模型和运行时版本、设备信息、输出配置、均值/P95、关键质量指标和验收日期。任何一项改变都应创建新行而不是覆盖旧记录,这样性能回退时才能知道是模型、驱动、输入还是交付策略发生了变化。
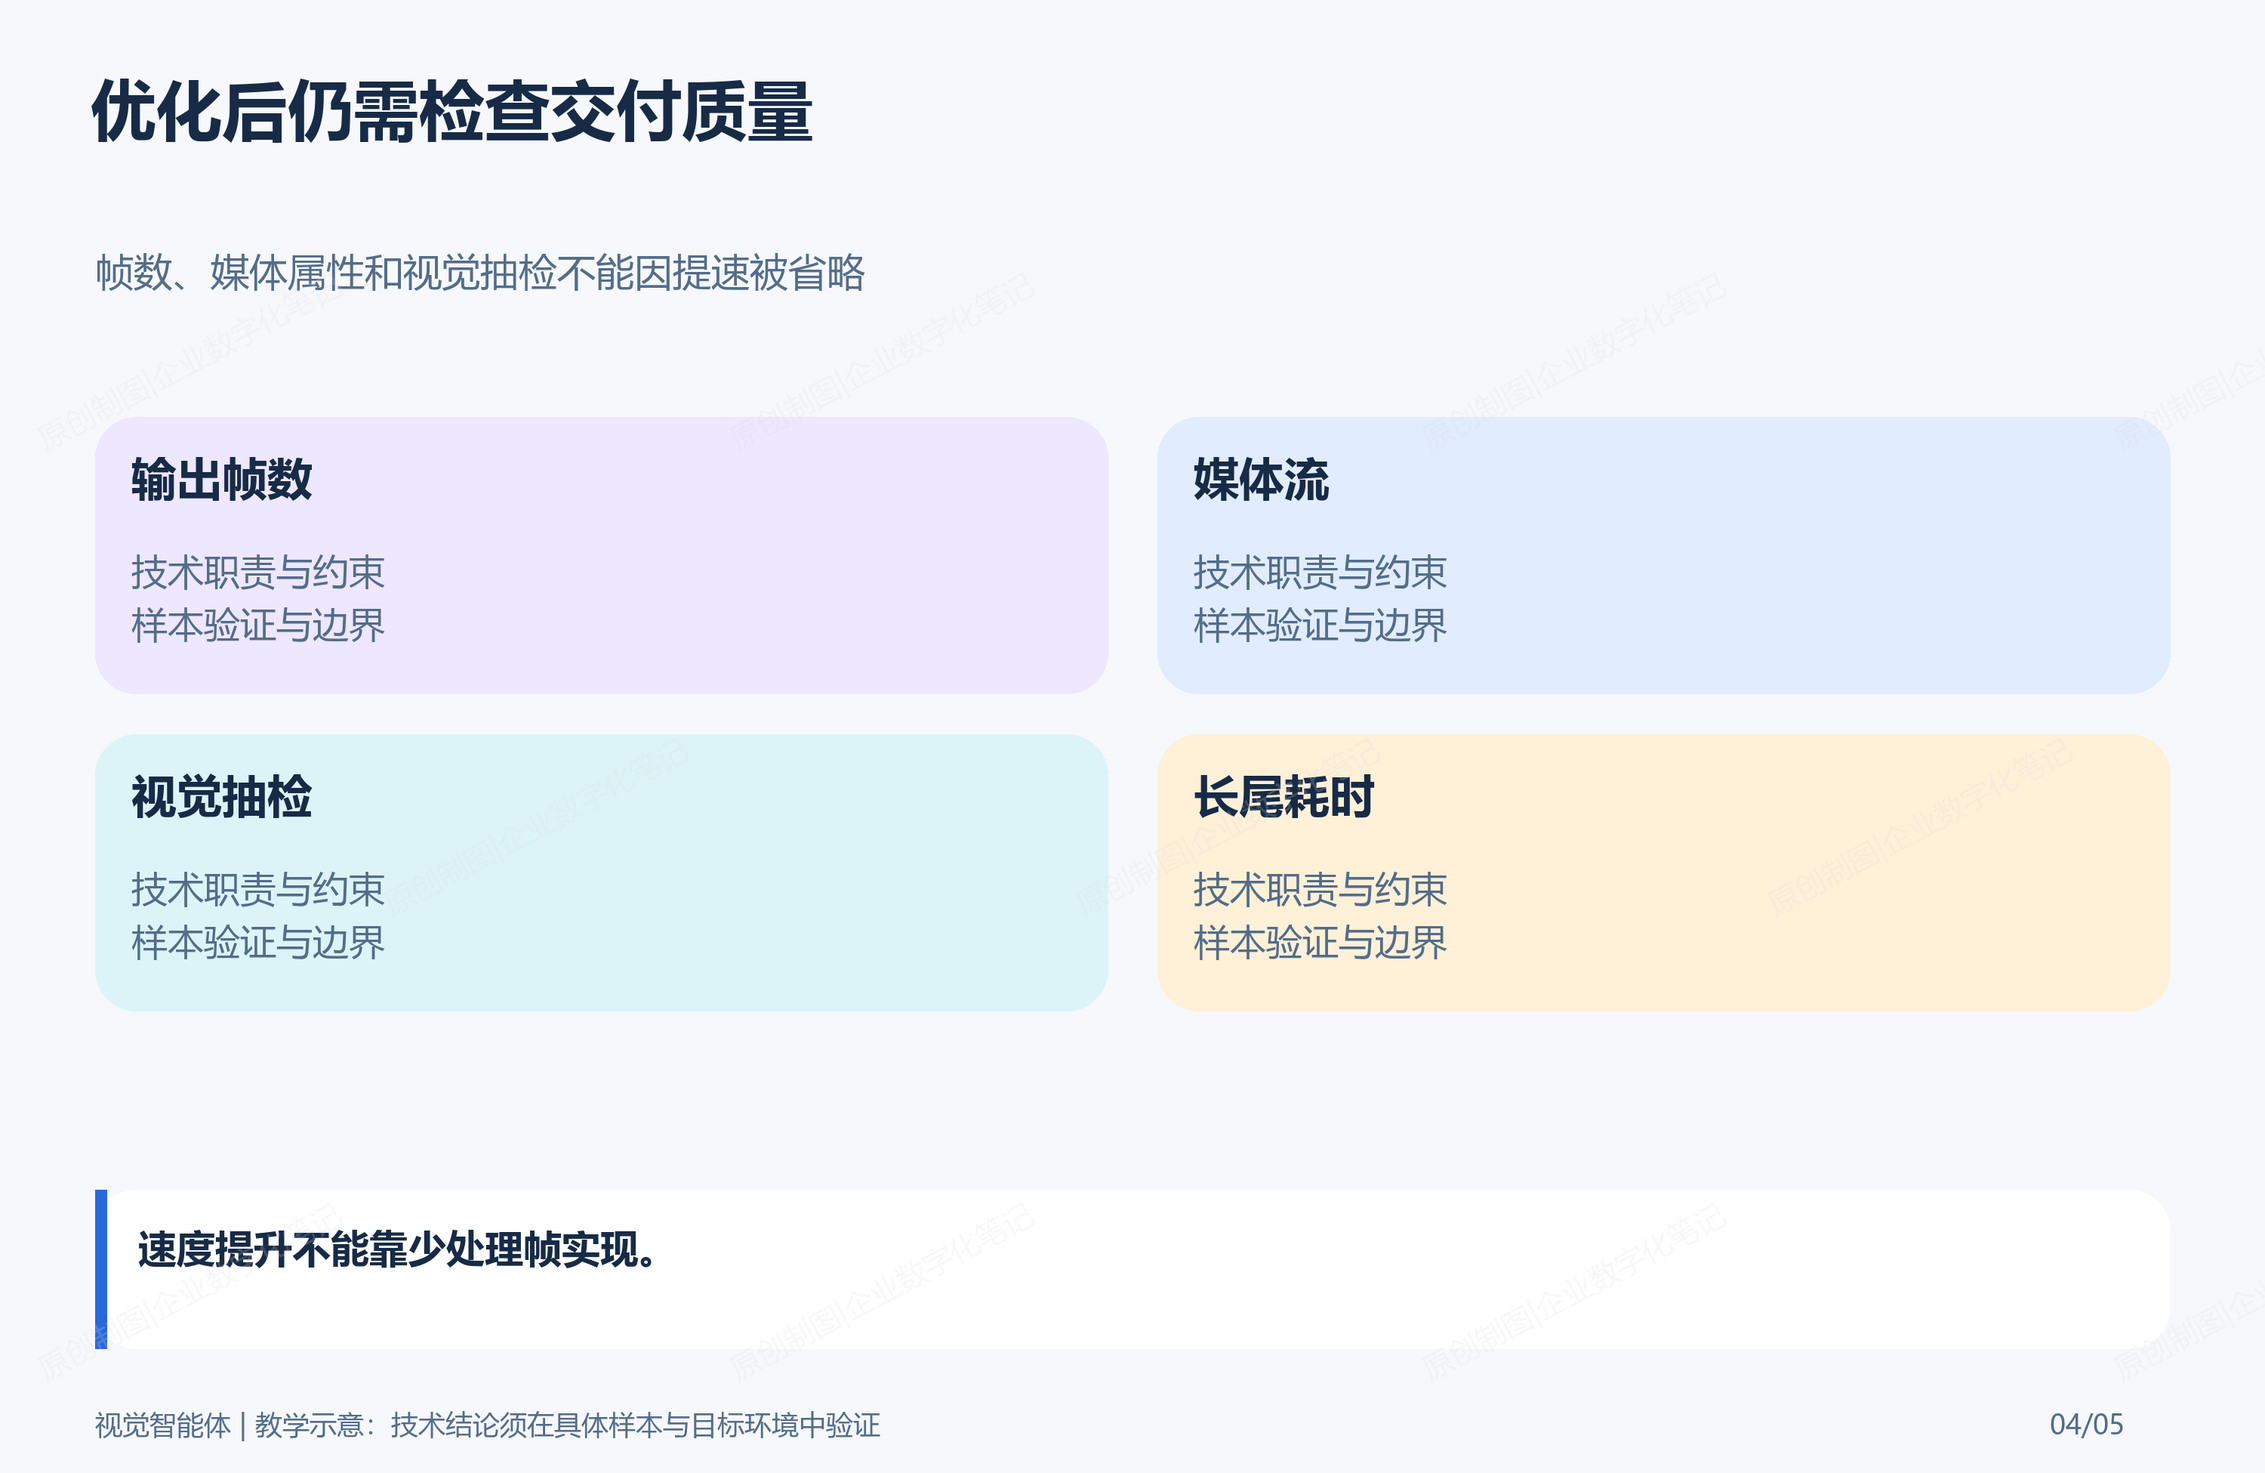
图4:提速后仍要证明输出与优化前具有相同的处理范围和交付质量。
五、性能结论怎样才能比较
一份性能报告至少要说明"比较了什么"和"没有比较什么"。例如,把 FP32 的小模型、INT8 的大模型、不同输入尺寸和不同编码器混在一张 FPS 表里,数字即使真实,也不能帮助读者或团队作出选择。性能优化前后必须冻结输入视频、帧数、模型版本、阈值、运行时、设备、输出分辨率和编码要求。
| 比较项 | 必须保持一致 | 为什么 |
|---|---|---|
| 输入 | 同一视频、同一帧范围、同一解码策略 | 避免素材复杂度改变造成假提升 |
| 感知结果 | 同一模型/类别/阈值,或明确记录改变 | 防止靠放宽阈值减少后处理工作 |
| 交付要求 | 同一输出分辨率、帧率、编码和媒体校验 | 防止靠降低成片质量换速度 |
| 运行环境 | 设备、驱动、运行时、批次策略 | 让其他人能够复现结论 |
| 指标 | 总时长、各阶段均值与 P95 | 平均值不能掩盖长尾卡顿 |
当确实需要改变模型、输入尺寸或量化精度时,应把它记录为一次方案切换,而不是把它混成"同一方案优化"。此时除了比较速度,还要重新比较关键类别的 recall、标注帧抽检和最终输出帧数。只有速度和视觉质量同时满足目标,才允许写入新的性能基线。
python
def comparable(run_a, run_b):
    keys = ("source_sha256", "frame_count", "input_size", "runtime", "output_profile")
    return all(run_a[k] == run_b[k] for k in keys)

def test_changed_output_profile_is_not_same_baseline():
    assert not comparable(
        {"source_sha256":"a", "frame_count":100, "input_size":640, "runtime":"trt", "output_profile":"h264-1080p"},
        {"source_sha256":"a", "frame_count":100, "input_size":640, "runtime":"trt", "output_profile":"h264-720p"},
    )
图5:性能结论必须同时说明快在哪里、慢在哪里以及输出是否仍可靠。
六、小结
性能优化不是让某个 GPU 指标变漂亮,而是缩短可交付视频任务的真实等待时间。先测量,再定位最大阶段;优化后保持可比条件,并用同一输出质量重新验收,才能得到可复用的性能结论。
参考资料:PyTorch Profiler、PyTorch Profiler Tutorial、NVIDIA TensorRT Performance Benchmarking、NVIDIA TensorRT Best Practices、FFmpeg Benchmark Options。