生产级别的Rag不会完全按照前面Agentic RAG -2的去实现,最常见的生产级别的处理是下面的流程
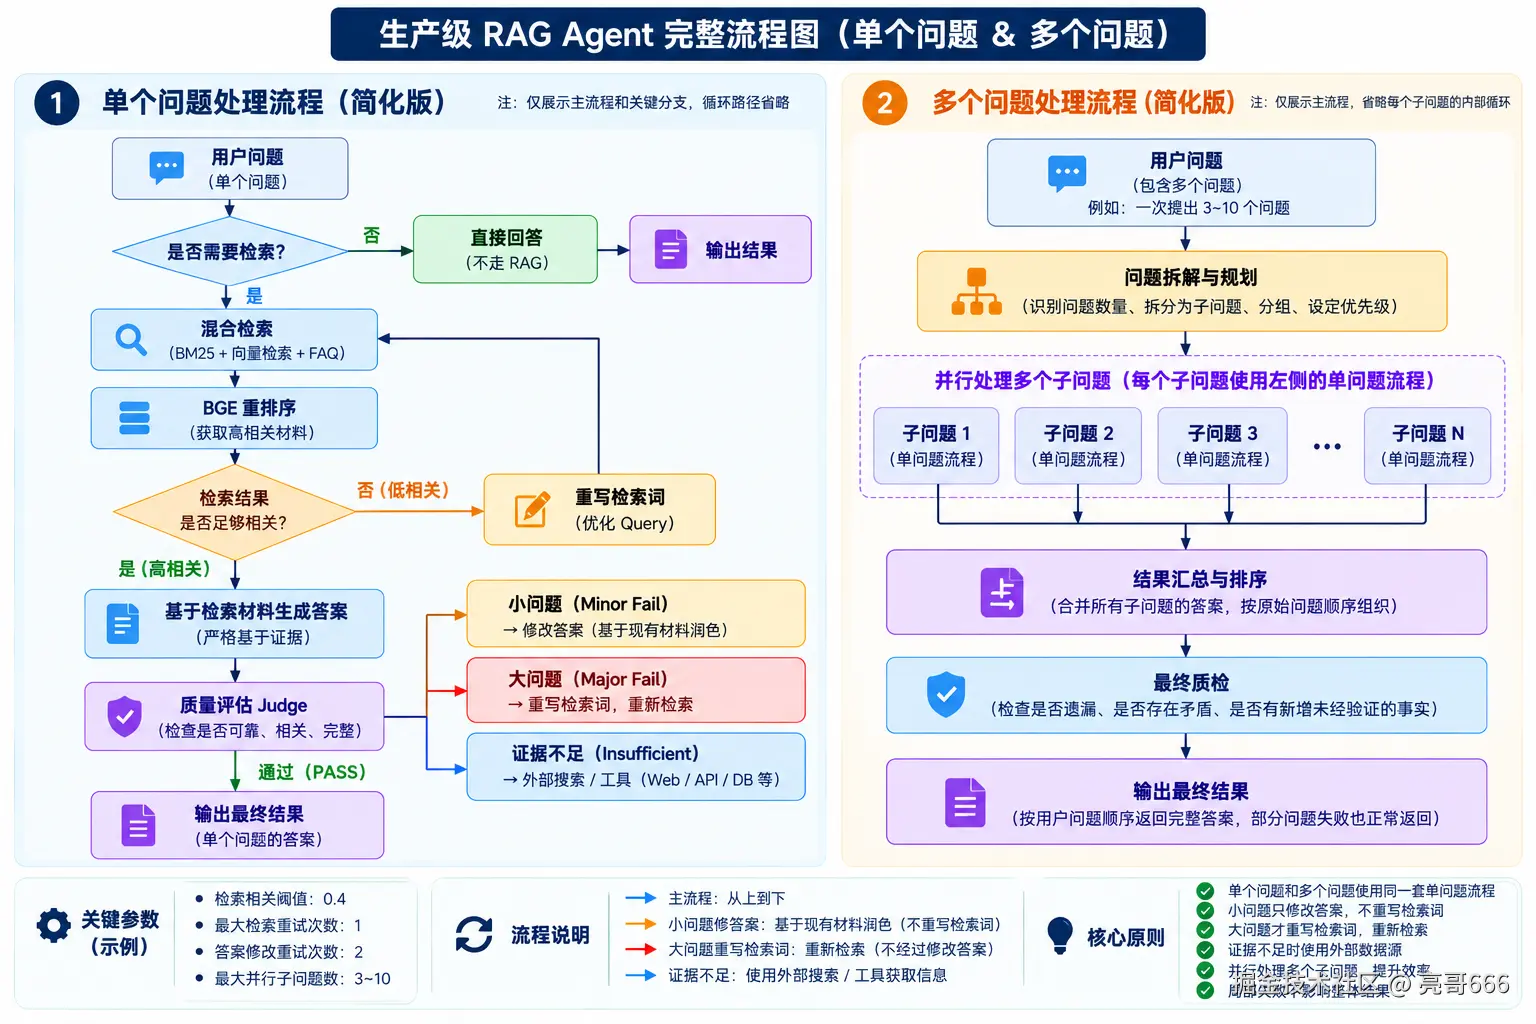
python
"""多问题、自愈式 LangGraph RAG 示例。

安装(Python 3.10+,建议使用独立虚拟环境)::

    pip install -U langgraph langchain-openai pydantic FlagEmbedding rank-bm25 jieba numpy
    export OPENAI_API_KEY=你的密钥
    export OPENAI_MODEL=gpt-4.1-mini
    python rag_agent.py "普通退款多久到账?信用卡退款呢?发票如何下载?"

这是可运行的架构示例,知识库是内存中的演示数据。首次运行会下载 BGE 模型。
外部搜索函数是明确的扩展点,默认返回空列表;接入真实数据源前,不能把
演示数据、0.40 阈值或自动质检结果当作生产环境的质量保证。

结构:Question Planner -> Send 动态分发 -> 每题 Sub-RAG -> Aggregate
      -> Final Judge -> Final Revise(最多一次)-> Final Judge -> 输出。

官方 API 参考:
https://docs.langchain.com/oss/python/langgraph/use-graph-api
https://github.com/FlagOpen/FlagEmbedding/blob/master/examples/inference/embedder/README.md
https://github.com/FlagOpen/FlagEmbedding/blob/master/examples/inference/reranker/README.md
"""

from __future__ import annotations

import json
import operator
import os
import re
import sys
import threading
from typing import Annotated, Literal, TypedDict

import jieba
import numpy as np
from FlagEmbedding import FlagAutoModel, FlagAutoReranker
from langchain_openai import ChatOpenAI
from langgraph.graph import END, START, StateGraph
from langgraph.types import Send
from pydantic import BaseModel, Field
from rank_bm25 import BM25Okapi


# 一、可调参数。阈值须根据真实语料和标注集校准;归一化分数不是概率。
RERANK_THRESHOLD = 0.40
MAX_ATOMIC_QUESTIONS = 10
MAX_PARALLEL_WORKERS = 3
MAX_RETRIEVAL_RETRIES = 1  # 每个子问题最多重写检索词一次
MAX_ANSWER_RETRIES = 2     # 每个子问题最多局部修订答案两次
MAX_FINAL_RETRIES = 1      # 汇总答案最多整体修订一次
BM25_TOP_K = 5
DENSE_TOP_K = 5
RERANK_TOP_K = 3

MODEL_NAME = os.getenv("OPENAI_MODEL", "gpt-4.1-mini")
EMBEDDING_MODEL = os.getenv("BGE_EMBEDDING_MODEL", "BAAI/bge-m3")
RERANKER_MODEL = os.getenv("BGE_RERANKER_MODEL", "BAAI/bge-reranker-v2-m3")


# 二、演示知识库。文档 id 要稳定;接真实库时应同时保留来源和权限信息。
KNOWLEDGE_BASE: list[dict[str, str]] = [
    {"id": "refund_001", "source": "退款规则.md",
     "text": "普通支付退款审核通过后,通常会在 1 到 3 个工作日内原路退回;具体到账时间可能受支付渠道影响。"},
    {"id": "refund_002", "source": "信用卡退款.md",
     "text": "信用卡退款处理时间通常为 3 到 7 个工作日;部分银行可能需要更长时间完成入账。"},
    {"id": "refund_003", "source": "退款异常处理.md",
     "text": "退款超过预计到账时间仍未到账时,先查看订单退款状态。如果状态显示成功但资金未到账,请联系支付机构或客服核查。"},
    {"id": "invoice_001", "source": "发票规则.md",
     "text": "完成支付的订单可以申请电子发票;申请成功后可在订单详情的发票入口查看。"},
    {"id": "invoice_002", "source": "电子发票.md",
     "text": "电子发票开具完成后,用户可以进入订单详情页面下载 PDF 格式的电子发票。"},
    {"id": "account_001", "source": "账号安全.md",
     "text": "用户可以在账号安全页面修改绑定手机号;修改时需要验证当前账号身份。"},
    {"id": "account_002", "source": "密码管理.md",
     "text": "忘记密码时,可在登录页面选择忘记密码,通过绑定手机号验证身份后重新设置密码。"},
    {"id": "account_003", "source": "账号注销.md",
     "text": "账号注销前须确保没有未完成订单、未处理退款或其他未完成业务,满足条件后可提交注销申请。"},
]


# 三、LLM 的结构化输出。字段都设为必填,避免不同模型对默认值的兼容差异。
class AtomicQuestion(BaseModel):
    question: str = Field(description="可独立检索、包含必要上下文的原子问题")
    topic: str = Field(description="主题,例如 refund、invoice、account")
    priority: Literal["high", "medium", "low"] = Field(description="执行优先级")


class QuestionPlan(BaseModel):
    questions: list[AtomicQuestion] = Field(description="按原始提问顺序列出所有原子问题")


class RetrievalDecision(BaseModel):
    needs_retrieval: bool = Field(description="是否需要专有、实时或外部事实")
    direct_answer: str = Field(description="不需要检索时的简短答案;否则为空字符串")
    reason: str = Field(description="路由理由")


class JudgeResult(BaseModel):
    passed: bool
    grounded: bool = Field(description="答案中的事实是否均有资料支持")
    relevant: bool = Field(description="答案是否针对问题")
    complete: bool = Field(description="问题是否完整回答")
    failure_type: Literal["none", "minor", "major", "insufficient_evidence"]
    reason: str
    unsupported_claims: list[str]


class FinalJudgeResult(BaseModel):
    passed: bool
    reason: str
    missing_questions: list[str]
    contradictions: list[str]
    unsupported_claims: list[str]


# 四、图状态。子问题的重试计数彼此隔离;主图只有 sub_results 使用 reducer。
class SubRAGState(TypedDict, total=False):
    question_id: str
    order: int
    original_question: str
    query: str
    topic: str
    priority: str
    needs_retrieval: bool
    candidate_docs: list[dict]
    docs: list[dict]
    top_score: float
    answer: str
    final_answer: str
    judge_result: dict
    retrieval_retry_count: int
    answer_retry_count: int
    external_search_used: bool
    external_docs_found: bool
    status: Literal["success", "partial", "fallback", "failed"]


class MainState(TypedDict, total=False):
    user_query: str
    questions: list[dict]
    omitted_questions: list[str]
    sub_results: Annotated[list[dict], operator.add]
    draft_answer: str
    final_answer: str
    final_judge_result: dict
    final_retry_count: int
    final_status: Literal["success", "partial", "needs_review"]


def tokenize(text: str) -> list[str]:
    """演示版中文 BM25 分词;生产环境可换为搜索引擎的 analyzer。"""
    return [word.strip() for word in jieba.lcut(text) if word.strip()]


def cosine_similarity(vector: np.ndarray, matrix: np.ndarray) -> np.ndarray:
    """批量余弦相似度;只用于 Dense 初召回,不充当最终可信度。"""
    denominator = np.linalg.norm(matrix, axis=1) * np.linalg.norm(vector) + 1e-8
    return (matrix @ vector) / denominator


def message_text(message: object) -> str:
    """普通 ChatOpenAI 文本响应的提取入口。"""
    content = getattr(message, "content", "")
    if not isinstance(content, str):
        raise TypeError("LLM 返回非文本内容,请按所选模型适配 message_text")
    return content.strip()


def build_context(docs: list[dict]) -> str:
    """把证据、稳定文档 id 和来源传给生成器及质检器。"""
    blocks = []
    for index, doc in enumerate(docs, start=1):
        blocks.append(
            f'[资料 {index}] id={doc.get("id", "unknown")};来源={doc.get("source", "unknown")}\n'
            f'{doc["text"]}'
        )
    return "\n\n".join(blocks)


def call_external_search(query: str) -> list[dict[str, str]]:
    """外部搜索占位函数:接入可信 API 后返回 id/source/text 三个字段。

    可接企业 SQL、CRM、工单、搜索服务或 MCP 工具。接入时要处理权限、
    超时、来源校验和时效性;不能把未验证的网页片段直接当作企业规则。
    """
    _ = query
    return []


class RAGAgent:
    """封装模型、索引和两层 LangGraph,方便替换检索器或 LLM。"""

    def __init__(self, knowledge_base: list[dict[str, str]] | None = None) -> None:
        self.knowledge_base = knowledge_base if knowledge_base is not None else KNOWLEDGE_BASE
        if not self.knowledge_base:
            raise ValueError("知识库不能为空;如需纯外部检索,请改写 hybrid_retrieve")
        if not os.getenv("OPENAI_API_KEY"):
            raise RuntimeError("请先设置 OPENAI_API_KEY")

        self.llm = ChatOpenAI(model=MODEL_NAME, temperature=0)
        # 模型只初始化一次。共享本地模型是否支持多线程取决于部署方式;
        # 此锁串行化推理,避免示例在多题并发时竞争同一模型实例。
        self.model_lock = threading.Lock()
        self.embedding_model = FlagAutoModel.from_finetuned(
            EMBEDDING_MODEL, use_fp16=False
        )
        self.reranker = FlagAutoReranker.from_finetuned(
            RERANKER_MODEL, use_fp16=False
        )

        texts = [doc["text"] for doc in self.knowledge_base]
        self.bm25 = BM25Okapi([tokenize(text) for text in texts])
        # BGE-M3 的 encode_corpus 返回 dict,Dense 向量在 dense_vecs。
        with self.model_lock:
            vectors = self.embedding_model.encode_corpus(
                texts, return_dense=True, return_sparse=False,
                return_colbert_vecs=False,
            )["dense_vecs"]
        self.corpus_embeddings = np.asarray(vectors, dtype=np.float32)

        self.sub_graph = self._build_sub_graph()
        self.graph = self._build_main_graph()

    # ---------- Hybrid Retrieval:BM25 + BGE Dense;候选集并集后交给 Reranker ----------
    def hybrid_retrieve(self, query: str) -> list[dict]:
        bm25_scores = self.bm25.get_scores(tokenize(query))
        with self.model_lock:
            vector = self.embedding_model.encode_queries(
                [query], return_dense=True, return_sparse=False,
                return_colbert_vecs=False,
            )["dense_vecs"][0]
        dense_scores = cosine_similarity(
            np.asarray(vector, dtype=np.float32), self.corpus_embeddings
        )

        bm25_indexes = np.argsort(bm25_scores)[::-1][:BM25_TOP_K]
        dense_indexes = np.argsort(dense_scores)[::-1][:DENSE_TOP_K]
        # 两路初召回去重;不同量纲的分数不直接相加。
        indexes = list(dict.fromkeys([*bm25_indexes.tolist(), *dense_indexes.tolist()]))
        return [
            {**self.knowledge_base[i], "bm25_score": float(bm25_scores[i]),
             "dense_score": float(dense_scores[i])}
            for i in indexes
        ]

    def bge_rerank(self, query: str, documents: list[dict]) -> list[dict]:
        if not documents:
            return []
        pairs = [[query, doc["text"]] for doc in documents]
        with self.model_lock:
            scores = self.reranker.compute_score(pairs, normalize=True)
        # 单候选时 FlagEmbedding 可能返回标量。
        if np.isscalar(scores):
            scores = [scores]
        ranked = [
            {**doc, "rerank_score": float(score)}
            for doc, score in zip(documents, scores, strict=True)
        ]
        ranked.sort(key=lambda doc: doc["rerank_score"], reverse=True)
        return ranked[:RERANK_TOP_K]

    # ---------- 子图节点:每道题有自己的检索、答案和重试状态 ----------
    def retrieval_gate(self, state: SubRAGState) -> dict:
        result = self.llm.with_structured_output(RetrievalDecision).invoke(
            "判断以下问题是否需要企业知识、产品规则、实时或外部事实。"
            "对闲聊或无需专有事实的简单问题可直接回答;不得编造企业规则。\n"
            f'问题:{state["original_question"]}'
        )
        return {"needs_retrieval": result.needs_retrieval,
                "answer": result.direct_answer.strip()}

    @staticmethod
    def route_after_gate(state: SubRAGState) -> Literal["retrieve", "direct_output"]:
        return "retrieve" if state["needs_retrieval"] else "direct_output"

    def direct_output(self, state: SubRAGState) -> dict:
        answer = state.get("answer", "").strip()
        if not answer:
            answer = message_text(self.llm.invoke(
                f'直接简短回答以下不需要外部知识的问题:{state["original_question"]}'
            ))
        return {"final_answer": answer, "status": "success"}

    def retrieve(self, state: SubRAGState) -> dict:
        return {"candidate_docs": self.hybrid_retrieve(state["query"])}

    def rerank(self, state: SubRAGState) -> dict:
        docs = self.bge_rerank(state["query"], state.get("candidate_docs", []))
        return {"docs": docs,
                "top_score": docs[0]["rerank_score"] if docs else 0.0}

    @staticmethod
    def route_after_rerank(
        state: SubRAGState,
    ) -> Literal["generate", "rewrite_query", "external_search", "fallback"]:
        if state.get("docs") and state.get("top_score", 0.0) >= RERANK_THRESHOLD:
            return "generate"
        if state.get("retrieval_retry_count", 0) < MAX_RETRIEVAL_RETRIES:
            return "rewrite_query"
        if not state.get("external_search_used", False):
            return "external_search"
        return "fallback"

    def rewrite_query(self, state: SubRAGState) -> dict:
        reason = state.get("judge_result", {}).get("reason", "检索相关性不足")
        rewritten = message_text(self.llm.invoke(
            "你是检索词改写器。保留用户意图,补足关键实体,去除口语化表述。"
            "只输出一条新的检索词,不要回答。\n"
            f'原问题:{state["original_question"]}\n'
            f'当前检索词:{state["query"]}\n原因:{reason}'
        ))
        return {"query": rewritten or state["query"],
                "retrieval_retry_count": state.get("retrieval_retry_count", 0) + 1,
                # 新检索周期不能沿用旧答案或旧质检结论。
                "answer": "", "judge_result": {}}

    def external_search(self, state: SubRAGState) -> dict:
        raw_docs = call_external_search(state["query"])
        # 接入实际工具后先校验 schema,再用同一 reranker 判断相关性。
        docs = [doc for doc in raw_docs if all(doc.get(k) for k in ("id", "source", "text"))]
        ranked = self.bge_rerank(state["query"], docs)
        found = bool(ranked and ranked[0]["rerank_score"] >= RERANK_THRESHOLD)
        update: dict = {"external_search_used": True, "external_docs_found": found}
        if found:
            update.update({"docs": ranked, "top_score": ranked[0]["rerank_score"],
                           "answer": "", "judge_result": {}})
        # 没找到新证据时保留原有资料和质检结果,供受限的部分回答使用。
        return update

    @staticmethod
    def route_after_external_search(
        state: SubRAGState,
    ) -> Literal["generate", "fallback"]:
        return "generate" if state.get("external_docs_found", False) else "fallback"

    def generate(self, state: SubRAGState) -> dict:
        answer = message_text(self.llm.invoke(
            "严格根据下列资料回答;不要添加资料外事实。无法确认的部分明确说明。"
            "引用资料时使用其 id,答案简洁,不要提及内部检索机制。\n"
            f'问题:{state["original_question"]}\n\n资料:\n{build_context(state["docs"])}'
        ))
        return {"answer": answer}

    def judge(self, state: SubRAGState) -> dict:
        result = self.llm.with_structured_output(JudgeResult).invoke(
            "质检以下 RAG 答案。检查事实是否有资料支持、是否切题、是否完整。"
            "none=通过;minor=证据正确但表达有小错,可直接修答案;"
            "major=答非所问或资料明显找偏,必须重新检索;"
            "insufficient_evidence=资料不足。passed 与 failure_type 必须一致。\n"
            f'问题:{state["original_question"]}\n'
            f'资料:{build_context(state.get("docs", []))}\n答案:{state["answer"]}'
        )
        return {"judge_result": result.model_dump()}

    @staticmethod
    def route_after_judge(
        state: SubRAGState,
    ) -> Literal["success_output", "revise_answer", "rewrite_query", "external_search", "fallback"]:
        result = state["judge_result"]
        if result["passed"] and result["failure_type"] == "none":
            return "success_output"
        failure = result["failure_type"]
        if failure == "minor":
            if state.get("answer_retry_count", 0) < MAX_ANSWER_RETRIES:
                return "revise_answer"
            return "fallback"  # 答案修订熔断器
        if failure == "major":
            if state.get("retrieval_retry_count", 0) < MAX_RETRIEVAL_RETRIES:
                return "rewrite_query"  # 走检索链,不能原地再 Judge
            if not state.get("external_search_used", False):
                return "external_search"
            return "fallback"  # 检索熔断器
        if failure == "insufficient_evidence" and not state.get("external_search_used", False):
            return "external_search"
        return "fallback"

    def revise_answer(self, state: SubRAGState) -> dict:
        revised = message_text(self.llm.invoke(
            "只依据现有资料修正答案中的轻微错误;保留正确内容,不新增事实。"
            "只输出修订后的答案。\n"
            f'问题:{state["original_question"]}\n'
            f'资料:{build_context(state.get("docs", []))}\n'
            f'原答案:{state["answer"]}\n质检意见:{state["judge_result"]}'
        ))
        return {"answer": revised,
                "answer_retry_count": state.get("answer_retry_count", 0) + 1}

    @staticmethod
    def success_output(state: SubRAGState) -> dict:
        return {"final_answer": state["answer"], "status": "success"}

    @staticmethod
    def fallback(state: SubRAGState) -> dict:
        # 只有质检明确确认"已有部分完全有据且切题"时,才保留部分答案。
        judge = state.get("judge_result", {})
        if (state.get("answer") and judge.get("grounded") and judge.get("relevant")
                and judge.get("failure_type") == "insufficient_evidence"):
            return {"final_answer": state["answer"] + "\n其余部分暂无足够资料核实。",
                    "status": "partial"}
        return {"final_answer": "当前资料不足,无法可靠回答这个问题。",
                "status": "fallback"}

    def _build_sub_graph(self):
        builder = StateGraph(SubRAGState)
        for name, node in (
            ("retrieval_gate", self.retrieval_gate), ("direct_output", self.direct_output),
            ("retrieve", self.retrieve), ("rerank", self.rerank),
            ("rewrite_query", self.rewrite_query), ("external_search", self.external_search),
            ("generate", self.generate), ("judge", self.judge),
            ("revise_answer", self.revise_answer),
            ("success_output", self.success_output), ("fallback", self.fallback),
        ):
            builder.add_node(name, node)
        builder.add_edge(START, "retrieval_gate")
        builder.add_conditional_edges("retrieval_gate", self.route_after_gate)
        builder.add_edge("retrieve", "rerank")
        builder.add_conditional_edges("rerank", self.route_after_rerank)
        builder.add_edge("rewrite_query", "retrieve")
        builder.add_conditional_edges("external_search", self.route_after_external_search)
        builder.add_edge("generate", "judge")
        builder.add_conditional_edges("judge", self.route_after_judge)
        builder.add_edge("revise_answer", "judge")
        for terminal in ("direct_output", "success_output", "fallback"):
            builder.add_edge(terminal, END)
        return builder.compile()

    # ---------- 主图:计划、动态并行、确定性聚合、最终质检及修订 ----------
    def plan_questions(self, state: MainState) -> dict:
        user_query = state["user_query"].strip()
        if not user_query:
            raise ValueError("user_query 不能为空")
        plan = self.llm.with_structured_output(QuestionPlan).invoke(
            "将输入拆成可独立检索的原子问题。单问题原样保留;多问题需补齐代词"
            "所指的上下文。去重、保留原顺序,并给出主题与优先级。"
            "不要回答,也不要遗漏问题。\n"
            f"用户输入:{user_query}"
        )
        seen: set[str] = set()
        questions: list[dict] = []
        for item in plan.questions:
            question = item.question.strip()
            key = re.sub(r"\W+", "", question).lower()
            if question and key not in seen:
                seen.add(key)
                questions.append({"id": f"q{len(questions) + 1}", "order": len(questions),
                                  "question": question, "topic": item.topic.strip(),
                                  "priority": item.priority})
        if not questions:
            questions = [{"id": "q1", "order": 0, "question": user_query,
                          "topic": "general", "priority": "medium"}]
        omitted = [q["question"] for q in questions[MAX_ATOMIC_QUESTIONS:]]
        return {"questions": questions[:MAX_ATOMIC_QUESTIONS],
                "omitted_questions": omitted, "final_retry_count": 0}

    @staticmethod
    def dispatch_questions(state: MainState) -> list[Send]:
        priority_rank = {"high": 0, "medium": 1, "low": 2}
        # Send 动态 fan-out。最多并发数在 ask() 的调用配置中硬限制。
        ordered = sorted(state["questions"],
                         key=lambda q: (priority_rank[q["priority"]], q["order"]))
        return [Send("run_sub_rag", q) for q in ordered]

    def run_sub_rag(self, question: dict) -> dict:
        initial: SubRAGState = {
            "question_id": question["id"], "order": question["order"],
            "original_question": question["question"], "query": question["question"],
            "topic": question["topic"], "priority": question["priority"],
            "retrieval_retry_count": 0, "answer_retry_count": 0,
            "external_search_used": False, "external_docs_found": False,
            "candidate_docs": [], "docs": [], "answer": "", "judge_result": {},
        }
        try:
            # 内层有循环,显式设足够的图步数;次数仍由三个独立计数器控制。
            result = self.sub_graph.invoke(initial, {"recursion_limit": 60})
            return {"sub_results": [{"id": question["id"], "order": question["order"],
                                     "question": question["question"],
                                     "answer": result["final_answer"],
                                     "status": result["status"]}]}
        except Exception as exc:
            # 单题异常不让同批其他 Send 失败。生产环境应在此记录结构化日志。
            return {"sub_results": [{"id": question["id"], "order": question["order"],
                                     "question": question["question"],
                                     "answer": "处理该问题时发生错误,暂时无法可靠回答。",
                                     "status": "failed", "error": type(exc).__name__}]}

    @staticmethod
    def aggregate(state: MainState) -> dict:
        # reducer 收集并行结果的顺序不可依赖,按用户原始提问顺序复原。
        results = sorted(state.get("sub_results", []), key=lambda item: item["order"])
        lines = [f'{i}. {item["question"]}\n{item["answer"]}'
                 for i, item in enumerate(results, start=1)]
        if state.get("omitted_questions"):
            lines.append("其余问题超出本次最多 10 题的处理上限,请分批继续提问:"
                         + ";".join(state["omitted_questions"]))
        draft = "\n\n".join(lines)
        return {"draft_answer": draft, "final_answer": draft}

    def final_judge(self, state: MainState) -> dict:
        result = self.llm.with_structured_output(FinalJudgeResult).invoke(
            "复核最终汇总:各已处理问题是否都有对应答案,是否有互相矛盾或"
            "超出子答案的新事实。某题明确说明资料不足、失败或超过处理上限,"
            "不算凭空遗漏;不要要求系统编造缺失答案。\n"
            f'子问题结果:{json.dumps(state.get("sub_results", []), ensure_ascii=False)}\n'
            f'超限问题:{json.dumps(state.get("omitted_questions", []), ensure_ascii=False)}\n'
            f'汇总答案:{state["final_answer"]}'
        )
        return {"final_judge_result": result.model_dump()}

    @staticmethod
    def route_after_final_judge(
        state: MainState,
    ) -> Literal["final_revise", "finalize"]:
        if state["final_judge_result"]["passed"]:
            return "finalize"
        if state.get("final_retry_count", 0) < MAX_FINAL_RETRIES:
            return "final_revise"
        return "finalize"  # 最终答案独立熔断器

    def final_revise(self, state: MainState) -> dict:
        revised = message_text(self.llm.invoke(
            "根据质检意见修订汇总答案。只能使用已有子答案的事实;"
            "保留每题对应关系、资料不足提示和超限提示。不要凭空补答。"
            "只输出修订后的汇总答案。\n"
            f'子答案:{json.dumps(state.get("sub_results", []), ensure_ascii=False)}\n'
            f'超限问题:{json.dumps(state.get("omitted_questions", []), ensure_ascii=False)}\n'
            f'原答案:{state["final_answer"]}\n'
            f'质检意见:{state["final_judge_result"]}'
        ))
        return {"final_answer": revised,
                "final_retry_count": state.get("final_retry_count", 0) + 1}

    @staticmethod
    def finalize(state: MainState) -> dict:
        statuses = [item["status"] for item in state.get("sub_results", [])]
        if not state.get("final_judge_result", {}).get("passed", False):
            # 整体修订仍未通过时,退回只拼接经过各子图处理的答案,显式提示人工核对。
            return {"final_answer": state["draft_answer"] + "\n\n汇总复核未通过,请人工核对。",
                    "final_status": "needs_review"}
        if state.get("omitted_questions") or any(s != "success" for s in statuses):
            return {"final_status": "partial"}
        return {"final_status": "success"}

    def _build_main_graph(self):
        builder = StateGraph(MainState)
        builder.add_node("plan_questions", self.plan_questions)
        builder.add_node("run_sub_rag", self.run_sub_rag)
        builder.add_node("aggregate", self.aggregate)
        builder.add_node("final_judge", self.final_judge)
        builder.add_node("final_revise", self.final_revise)
        builder.add_node("finalize", self.finalize)
        builder.add_edge(START, "plan_questions")
        builder.add_conditional_edges("plan_questions", self.dispatch_questions,
                                      ["run_sub_rag"])
        builder.add_edge("run_sub_rag", "aggregate")
        builder.add_edge("aggregate", "final_judge")
        builder.add_conditional_edges("final_judge", self.route_after_final_judge)
        builder.add_edge("final_revise", "final_judge")
        builder.add_edge("finalize", END)
        return builder.compile()

    def ask(self, user_query: str) -> dict:
        """返回最终答案、各题状态及计数;LangGraph 同时最多运行 3 个任务。"""
        result = self.graph.invoke(
            {"user_query": user_query, "sub_results": []},
            {"max_concurrency": MAX_PARALLEL_WORKERS, "recursion_limit": 30},
        )
        return {"answer": result["final_answer"], "status": result["final_status"],
                "questions": result["questions"],
                "sub_results": sorted(result["sub_results"], key=lambda r: r["order"]),
                "omitted_questions": result.get("omitted_questions", []),
                "final_retry_count": result.get("final_retry_count", 0)}


def main() -> None:
    query = " ".join(sys.argv[1:]).strip()
    if not query:
        query = "普通退款多久到账?信用卡退款呢?超过 7 天没到账怎么办?发票如何下载?"
    agent = RAGAgent()
    print(json.dumps(agent.ask(query), ensure_ascii=False, indent=2))


if __name__ == "__main__":
    main()