摘要
网页里的视频迟迟不出画面,导出器并不一定需要重新编码。先要确认交付的究竟是普通 MP4、分片 MP4,还是尚未写入完整时长与寻址信息的录制 WebM。本文用三组实测连接文件结构、HTTP 读取和播放器状态:普通 MP4 的 48 个用例、真实产品产物的 16 个播放用例,以及 WebM 的 18 个交叉播放用例。重点是建立能复查的诊断过程,不给不同输入的产物排性能名次。
版本声明
实验日期为 2026 年 9 月 30 日,主机为 macOS 26.5.2,Apple arm64。浏览器使用独立测试资料,构建版本分别为 Chromium 149.0.7827.55、Firefox 151.0、WebKit 26.5。文中的 WebKit 不代表正式 Safari。普通 MP4 各组合重复两次;产品产物的 Chromium 组合两次,另外两种内核各一次;WebM 的每个播放组合一次。下文会按这些次数解释结果。
适用边界
本文检查已经完成的文件如何起播和寻址,不研究码率画质取舍,也没有上线 HLS 或 DASH 服务。网络条件由本地服务器控制,未测移动网络、真实 CDN 与反向代理。帧回调用于观察浏览器报告的媒体时间,并非高速摄影意义上的屏幕测量。录制、导出、传输、显示四个环节的结果不能互相代替,尤其不能把产物保存成功当作网页播放已经通过。
文章目录
一 视频等待从哪一层查起
- 产物身份比文件后缀更具体
- 首帧和目标帧必须分别记录
二 普通文件如何建立公平对照
- 头尾版本保留相同媒体负载
- 限速必须约束整个用例
- 范围请求需要实际响应佐证
三 索引提前能消除哪些等待
- 尾部索引可以被提前读取
- 早期寻址受当前范围限制
- 报错不能被延长等待覆盖
四 真实导出为何不能只看头部
- 本轮产物采用分片结构
- 头部元信息不等于全片索引
- 相同文件仍有不同读取路径
五 录制文件为何显示不同的时长
- 文件字段和播放器结果分开检查
- 相同编码包重封装后表现改变
- 录制完成不等于寻址信息齐全
六 三类产物怎样进入同一排查流程
- 先归档文件再选择对照变量
- 检查顺序取决于失败位置
七 哪些测量细节会误导结论
- 时间和字节采样存在边界
- 事件原文比派生状态可靠
- 容器检查不能依靠文本搜索
八 交付验收怎样留下真实取舍
- 通过条件必须绑定测试条件
- 后续验证优先补齐未知项
一 视频等待从哪一层查起
产物身份比文件后缀更具体
我希望从一次文件导出里得到的不只是"可播放"三个字,还包括下游可以据此安排读取的结构信息。文件名和 MIME 类型提供了入口。它们没有描述全部布局。面对同样的 MP4 后缀,播放器可能先寻找文件末尾的元信息,也可能拿到开头的初始化信息后继续检查后续分片;这两种路径不应套同一条解释。
我测产品导出时用的是图映 ImgIng的视频压缩工作台,它提供浏览器内的视频处理与导出。我分别导入两段已有海浪素材,选择体积优先和 MP4,再保存实际输出。同时还建立了普通 MP4 与录制 WebM 的对照。产品操作和实验构造是两条来源,后续记录一直保留这个区分,避免把人为制作的测试文件写成工具原生产物。
普通 MP4 组的任务最窄。将相同媒体内容放入头部索引和尾部索引两种布局,检验读取索引的时机能改变什么。真实产品组保留导出器实际写下的封装,再观察浏览器如何消费。WebM 组则检查浏览器录制结果中的时长及寻址信息,并验证不改编码包的重封装对读取有什么影响。三组各自回答一个问题。
这样分组也决定了哪些话不能说。普通文件更早出现首帧,不代表某个导出器的编码速度更快;产品文件含有分片,不代表播放器已配置自适应版本选择;WebM 重封装后显示有限时长,也不能证明画面重新生成过。先确定文件经历了哪些步骤,才能决定后面的比较是否还有共同前提。
首帧和目标帧必须分别记录
起播先定义为设置媒体地址到第一次视频帧回调的间隔。这个定义比较贴近首个呈现帧。它仍然是浏览器提供的观察点。它不等于解码器内部耗时。请求等待、索引读取、缓冲和调度都可能落在其中。不能把总时间直接挂到某个模块名下。
寻址采用另一套起点。本轮先等首帧出现,再等待 500 毫秒,暂停并把目标设到第 6 秒。计时从这个动作重新开始。普通 MP4 的成功判据是后续帧回调里的 mediaTime 落入 6±0.15 秒。仅有 seeked 或 currentTime 变化还不够。目标被限制到别处时必须单列。
我还保留了事件发生时的当前位置和可寻址区间。它们有不同用途。目标时间描述测试意图,currentTime 描述播放器报告的位置,seekable 则对应读取该属性时的可寻址范围。把这三个值放在一条记录里,才能区分"请求的目标没接受"与"位置改变但目标画面尚未得到证据"。
对于完整下载后的拖动,应当另建一次观察。它不能替代早期拖动。用户可能在首帧出现后立刻跳过开场,此时浏览器手里的数据远少于顺序播放结束以后;如果测试只在下载完成后执行,就可能得到一个正确但不回答实际问题的通过结果。测试时机本身也是条件。报告也需要写明。
二 普通文件如何建立公平对照
头尾版本保留相同媒体负载
两份素材分别记为 A 和 B。来源是已存在的 Wikimedia Commons 海浪文件。A 来自冰岛海岸,B 来自 Herzliya 海滩。准备阶段先截取、缩放并转码为普通 MP4,统一到 8 秒、960×540、25fps、H264 和无音轨。原片并不是这套参数,因此后文所说的内容不变只指已经准备好的头尾对照版本。
每份准备好的视频再复制媒体流进行重封装,得到索引在前和索引在后的两个版本。我比较的是 mdat 有效负载的 SHA256。两个版本保持一致。这个结果比看截图是否相似更直接。它说明用于对照的编码数据没有因为移动容器布局而重新产生,不需要再用画质评分解释起播差异。
文件整体哈希则是另一件事。容器的内容与顺序已经调整。整份文件出现不同哈希并不意外。整体字节数相同也不自动证明媒体内容一致。验证时应当先说清楚比较对象是整个文件、一个数据区,还是解析出来的编码包,再为这个对象保存校验值。混用层级会让控制变量失去依据。
普通 A 文件为 1433114 字节,B 为 5068844 字节。较大样本拉长了等待过程。部分读取行为在小文件上不容易观察。但这不是扩大统计代表性的充分条件。两份海浪同样属于固定内容样本,不能把它们变成对所有视频的成功率估计,更不能代表多音轨、字幕或复杂编辑列表的覆盖情况。
这套对照的价值在于约束解释。若头尾版的媒体负载相同,而首帧等待出现变化,可以优先研究索引位置和读取路径。它仍然没有严格剥离浏览器的全部内部变量。解复用和缓冲策略也会参与。我保留了真实请求与事件,用它们对应结构与行为观察。
限速必须约束整个用例
服务器为一个用例的所有活动视频响应共享每秒 256 KiB 的写入预算,每 40 毫秒调度一次。每条请求还需要经过 80 毫秒的起始等待。这里共享预算很重要。若每条 Range 请求各自拿到一份完整带宽,浏览器并发多发请求就会获得更高总吞吐,比较出来的结果会混入测试服务器额外赠送的容量。
这个设置不是完整网络仿真。操作系统缓冲、socket 写入、任务调度和浏览器解码仍会影响到达时刻。80 毫秒只是请求启动延迟。它没有完整模拟一个同等往返时延的网络。报告中应保留它的真实名称,不能为了让数字看起来熟悉就直接改写成移动网络延迟。
缓存同样要控制。每个用例使用新的浏览器上下文,媒体响应禁止缓存,以减少上一轮读过的数据对下一轮的影响。这样得到的更接近首次读取条件。它不能替代缓存命中场景。若实际产品需要验证重复观看,应该另起一组保留缓存的测试,并清楚标注两组的差别。
矩阵由两个样本、三个内核、两种索引位置、两种 Range 模式和两次重复构成,共 48 个用例。每条记录都有独立身份。初始地址、请求范围、返回状态、写出量与播放器事件可以对应到同一用例,之后才有条件问某次迟迟没有画面的过程究竟停在哪里。
范围请求需要实际响应佐证
这里的"支持 Range"不是只在响应上多加一个声明。服务器确实解析请求里的字节起点与终点,返回对应区间及 206 状态;忽略模式则按整份资源响应。两种模式的媒体文件相同。交付行为才是变量。实际测试中必须把请求和响应放在一起看,单侧记录无法证明区间已经被正确提供。
RFC 9110允许服务端忽略 Range。Accept-Ranges 也只是能力提示。对于工程验收,我会另外核对状态、范围边界、返回长度与内容是否对应。此次原始记录保存了状态和解析后的起止范围,但没有单独序列化完整的 Content-Range 原始标头。这个缺口必须承认。程序按预期生成标头不等于完整捕获线上证据。
把实验迁移到网站时,还需要跟踪最终媒体地址。跳转、鉴权或代理可能改变实际返回的资源。能够在本地端口验证区间读取,不说明经过真实 CDN 后仍会得到同样结果。本文没有执行这一步。建议保留最终地址的请求与返回内容,是后续检查动作,不是这次已经修复线上服务的记录。
三 索引提前能消除哪些等待
尾部索引可以被提前读取
A 样本在 Chromium 中给出了一组清楚的对照。尾部索引配合忽略 Range 时,首帧中位数为 5.782 秒,两次落在 5.773 到 5.792 秒之间。保持尾部布局并允许范围读取后,中位数为 0.795 秒,范围为 0.776 到 0.813 秒。首帧已经提前。文件索引并没有搬家。原因可以从一次请求轨迹中找到线索。播放器先请求起点为 0 的内容,随后请求从 1409024 字节开始的尾部区域,再回到 32768 字节开始的位置。它先取到了尾部所需信息。尾部 moov 的存在要求读取那部分字节,并不强制把中间所有媒体数据都按文件顺序收齐。
第一次首帧约为 0.776 秒。随后采到的服务器累计写出量为 139425 字节。它约占整份文件的 9.73%。这是近似观察。采样发生在回调之后。服务器写出也不等于客户端准确接收。因此它只用来排除"当时必须已经发完整份文件"的解释,不能制定成下载达到某个百分比就会起播的规则。
索引在前的 A 文件也作了对照。Chromium 支持 Range 时的首帧中位数为 0.495 秒,范围为 0.483 到 0.508 秒;忽略 Range 时为 0.481 秒,范围为 0.479 到 0.483 秒。这里的小差别不适合解释成 Range 有固定性能损耗。两次样本不足以稳定分离调度噪声。较可靠的结论是这两组都较早取得首帧。
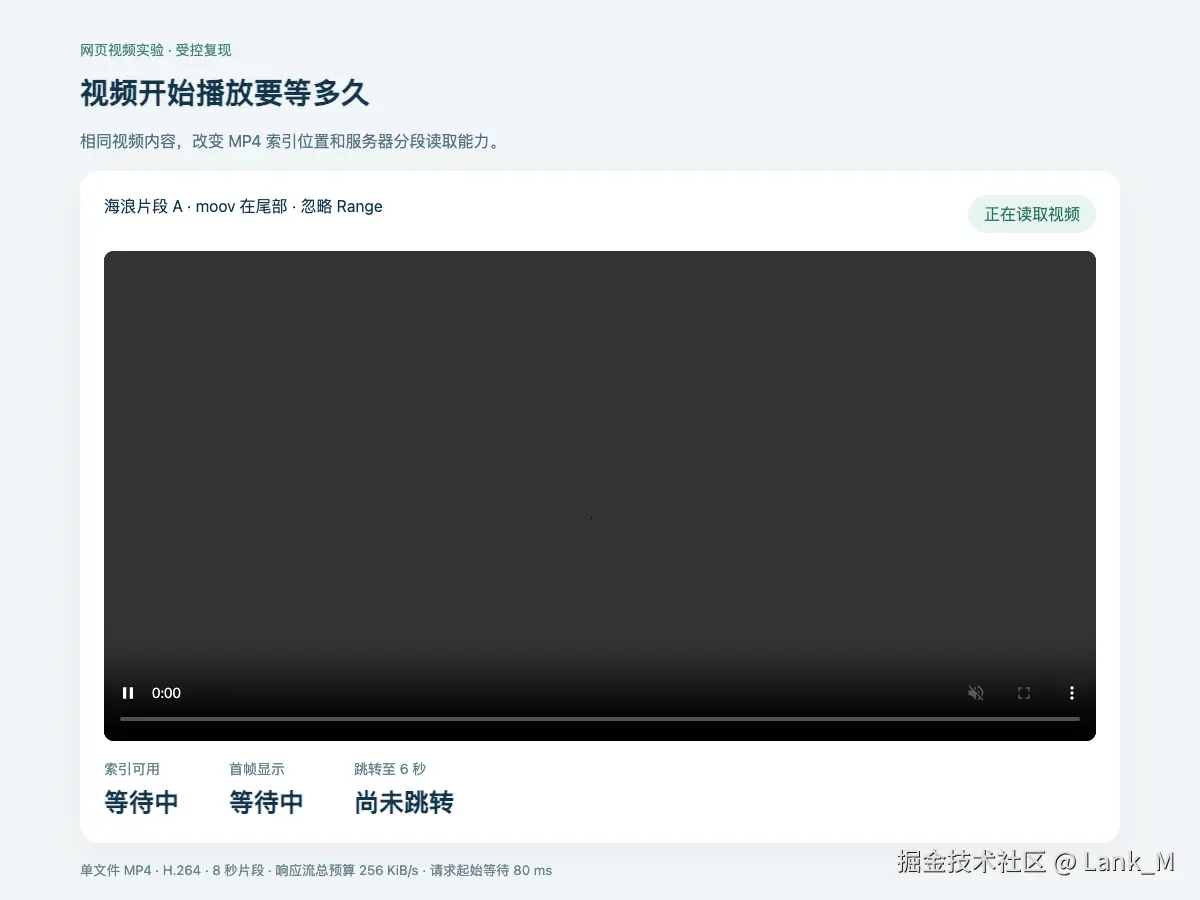
这张图记录 A 尾部索引、忽略 Range 时仍在读取的状态。此时尚未开始寻址。它没有拍到最终结果。把截图放在这里是为了对应"等待索引"的现象,首帧的具体统计仍以上面的两次记录为准,不能从黑画面推导文件损坏,也不能用截图截取时刻冒充最终等待时间。
早期寻址受当前范围限制
当目标改为首帧后跳到第 6 秒,布局优势不再等于操作通过。A 头部版在 Chromium 忽略 Range 时已经有首帧,但当时 seekable 为 0,0。两次目标都被钳到 0 秒。文件总时长仍为 8 秒。目标小于总时长,只说明没有越过片尾,并不能证明该位置在当前读取条件下可寻址。
Firefox 在相同 A 头部、忽略 Range 的组合中,两个实际落点为 1.16 秒和 0.36 秒。它们同样没有到达目标。这里应记录为钳位,不给它计算成功耗时。若只等到 seeked 就停止计时,很容易把错误位置上的结束误报为快速跳转,之后的截图或封面生成也会沿用这个错误判定。
支持 Range 也不意味着每次都会发一个新的目标区间请求。A 头部文件在 Firefox 第一次测试里只有从 0 开始的那条请求,浏览器继续沿原响应读取,最终仍到达 6 秒。两次目标帧等待中位数为 3.919 秒,范围为 3.917 到 3.921 秒。请求数量不能单独判断寻址成功与否。
Chromium 读取同一 A 头部版时,目标帧等待中位数为 0.605 秒,范围为 0.601 到 0.608 秒。这是一次有用的行为差异。它提示验收要观察实际目标帧,而不是拿某个浏览器的请求策略给其他浏览器规定同一条执行路径。本轮没有追踪内核内部选择阈值。这些数值不能作为策略保证。
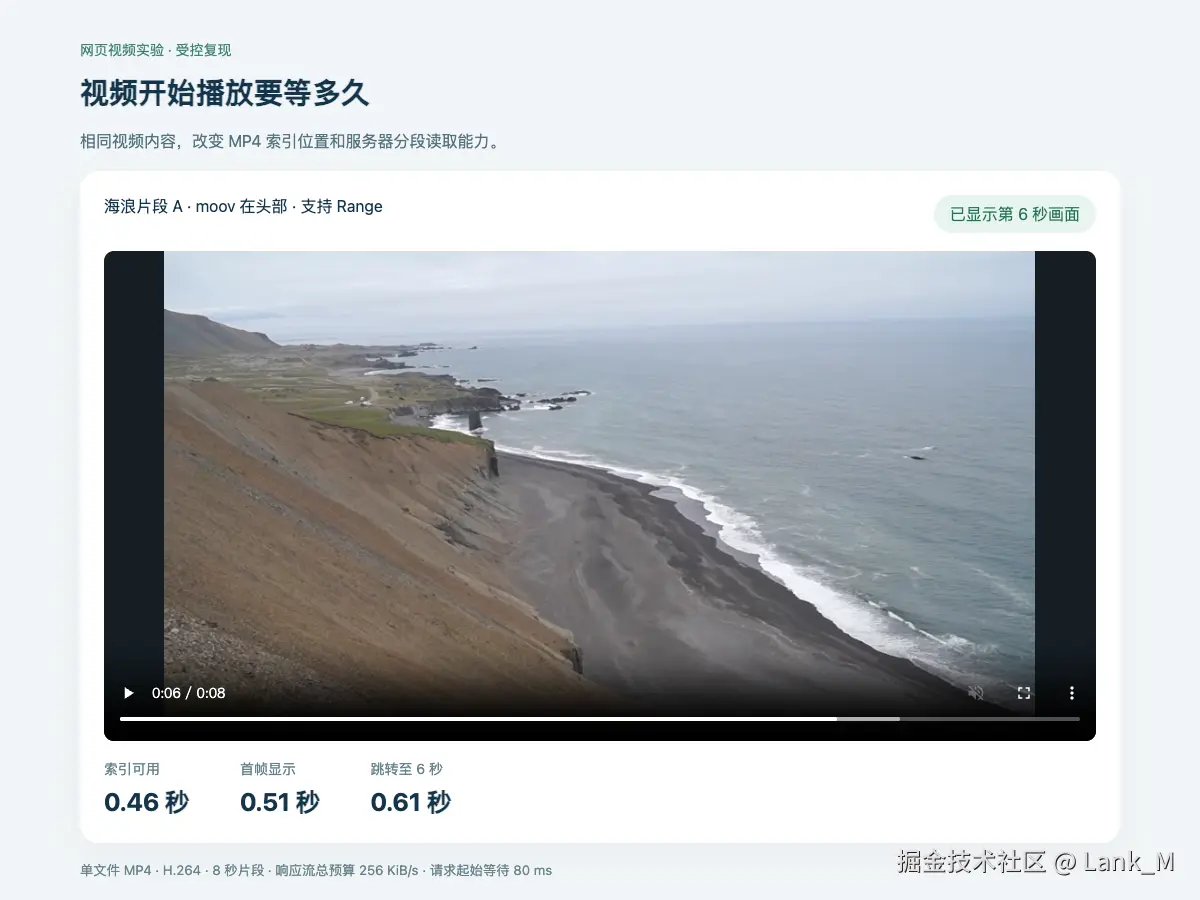
这张图来自 A 头部索引配合 Range 的 Chromium 成功用例,界面已经明确显示第 6 秒。首帧和跳转分别计时。它不是前面钳位组合的画面证据,只承担成功对照的作用;图中单次四舍五入后的显示值,也不能取代正文中位数和范围。两类状态需要保留各自的来源。
报错不能被延长等待覆盖
较大的 B 样本在 WebKit 中出现了另一类结果。尾部索引加忽略 Range 的两次测试,分别在 18.161 秒和 18.159 秒触发媒体 error,35 秒观察窗内没有首帧。服务器后来发送完全部文件。播放器没有自动恢复。不能将其描述为"只要耐心等完就能看"。
它也不能被写成"Safari 永远不支持"。测试对象是 WebKit 26.5 构建。根因没有继续定位。能够确认的边界是固定文件、固定交付模式和固定观察窗口下的两次失败。此时寻址测试没有进入,报告里应该留为未测试,而不是与其他用例一起算一个拖动通过率。
B 头部版在 WebKit 忽略 Range 时又是不同状态:seeked 到来,currentTime 报告为 6 秒,却在 26 秒观察窗内没有取得符合条件的目标帧回调。这一行需要保留为画面未验收。位置数值、事件和目标画面之间的区别,不能因为要压缩报表而被合并成一个"完成"字段。
四 真实导出为何不能只看头部
本轮产物采用分片结构
回到真实工作台,需要重新确认输入身份。产品实验使用两段完整原始 WebM,并非普通对照组截取后的无音轨文件。两次都选择体积优先和 MP4。任务状态显示完成。保存环节取得了工具实际写出的数据。这里没有用另一套转码程序替代导出内容,再把自制文件称作产品输出。
A 产物为 912701 字节,B 为 2198495 字节。文件探测得到两份成品的时长为 8.73 秒与 12.54 秒。它们都包含音轨。输入时长和轨道已不同于普通实验的 8 秒无音轨版本。即使它们在页面上都显示海浪,也必须分开维护身份,不能只按视觉相似性把数据合到一起。
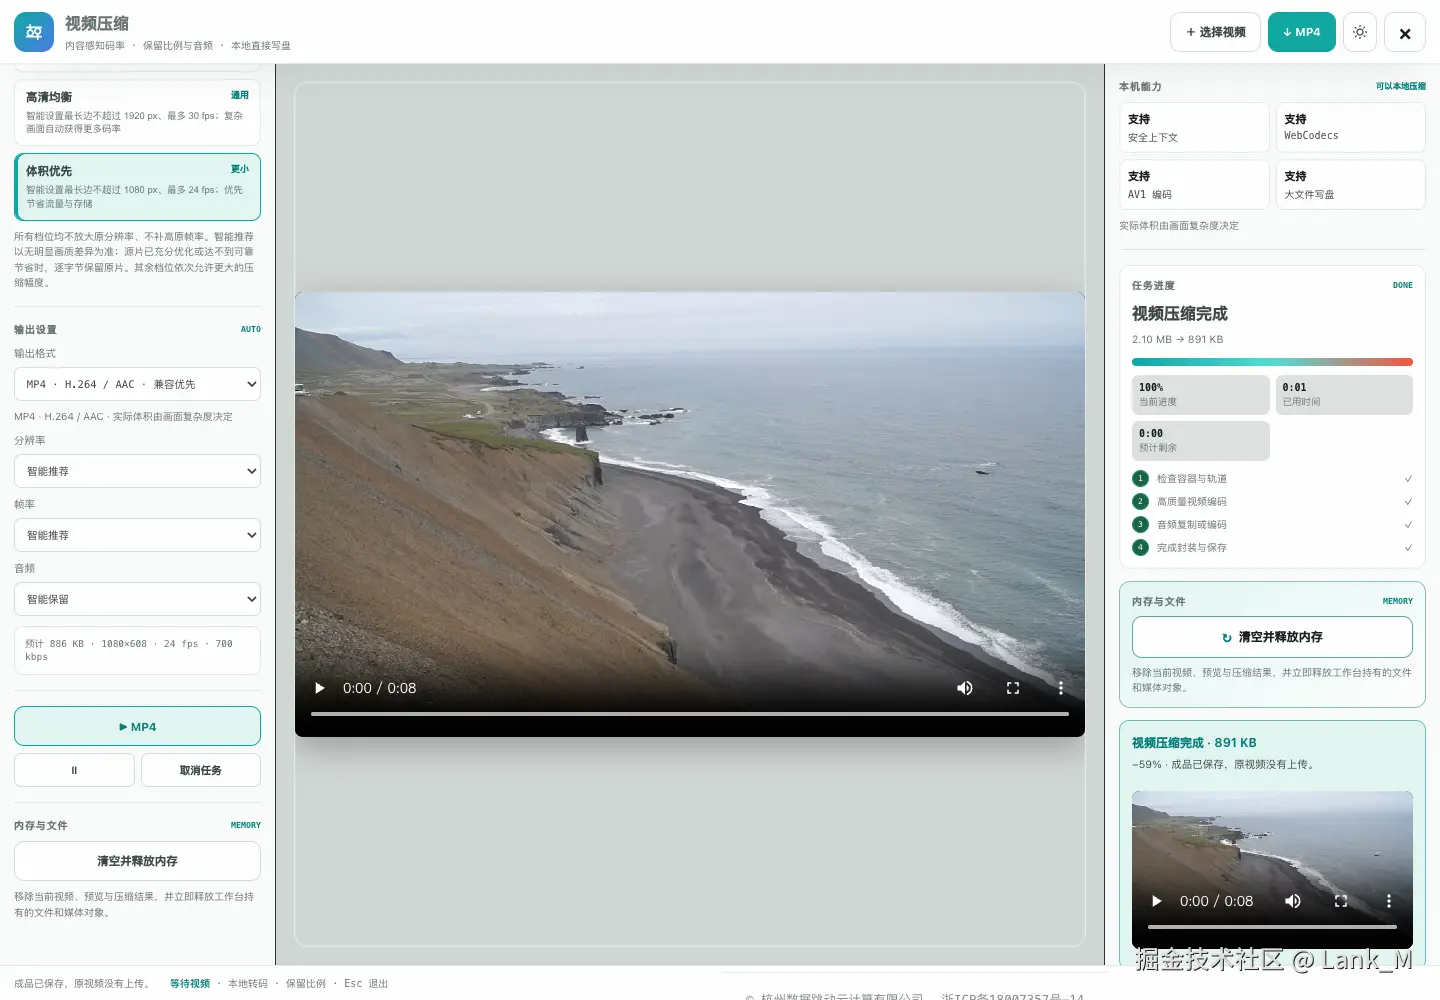
图中的完成状态证明了这次操作走到保存结果阶段。页面展示的预计体积、实际体积与导出计时,属于工具界面的各自字段,不是接下来网络播放的首帧耗时。容器结构更不能从页面截图直接读出。结构判断来自保存后的文件解析。截图补充的是输入、设置与操作完成的可追溯性。
解析顶层 box 后,两份产物都从 ftyp 开始,moov 位于偏移 28 字节的位置。后面不是单一完整数据区,而是重复的 moof 与 mdat,最后还有 mfra。这是本轮文件的实际排列。它比只记 moov 在头更完整,也为不同于普通 MP4 的读取行为提供了检查方向。
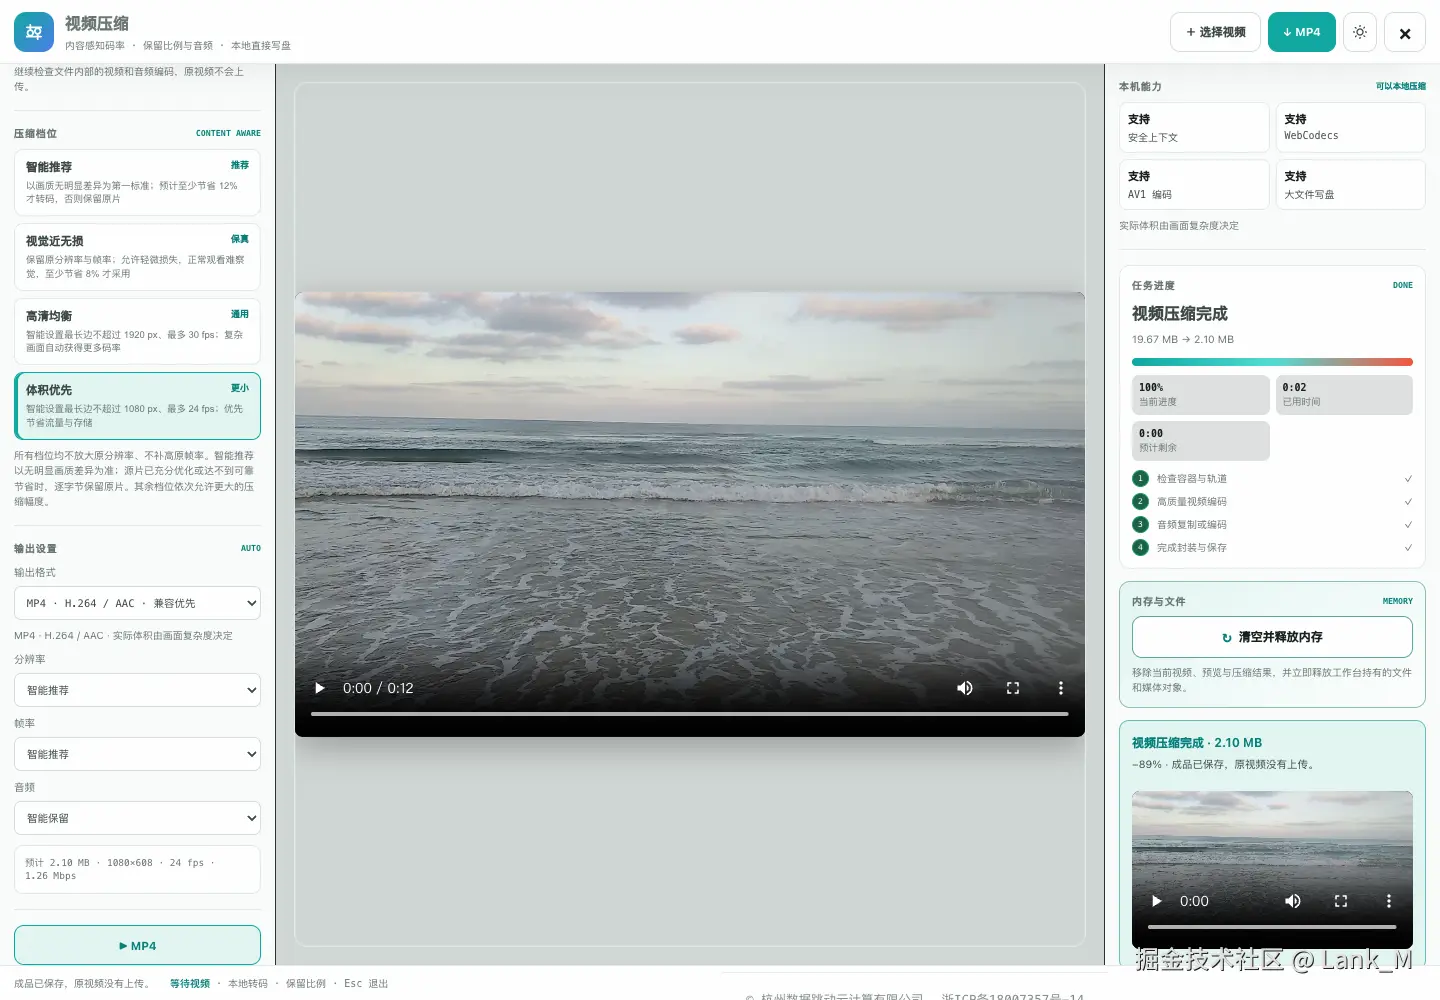
B 的页面显示另一个输入及其完成状态。两份输出体积不能互相替用。两张截图中都能看到真实海浪内容,但它们不构成画质对比实验。本文没有主观盲评或客观画质测量,也不借这些界面数字讨论哪种档位更好。图片用来交代真实产物来源。后面仍回到结构与读取证据。
头部元信息不等于全片索引
普通 MP4 的 faststart 通常是在完成文件后把 moov 移到前面;分片输出则让片段相关信息随后续片段组织。这是两个不同的封装安排。FFmpeg 格式文档对两者分别说明。相同的 moov 前置结果,不足以证明文件使用了哪一种生成过程,更不足以证明内部采用了某个工具。
W3C 的 ISO BMFF 字节流说明区分初始化部分与媒体片段:前者由 ftyp、moov 组织,后者涉及 moof 与 mdat。这个区分有助于理解,为什么不能仅凭头部元信息已经出现,就认为全片所有样本的相关索引都已经收齐。本文用它解释结构角色,不声称本轮页面通过 MSE 播放,也没有做完整的规范符合性认证。
检查分片文件还要看后续片段。找到第一个 moov 并不意味着检查结束。片段是否完整,后续数据是否持续可读,目标位置需要读取哪些信息,这些问题要结合播放器行为判断。尾部出现 mfra 也只是一项结构记录。它不能证明内核会采用相同的随机访问路径。
这一步对导出链路的取舍有实际意义。使用分片封装时,验收应该接受它与普通成品文件不同的布局,并为后续扫描或范围读取留出观察项。若业务要求的是下载后完整本地播放,检验路径又会不同。结构没有脱离使用场景的统一优劣。一个 box 的偏移量也不能代替整个交付契约。
相同文件仍有不同读取路径
把真实产物接到同一限速服务后,Chromium 对 B 分片文件出现了醒目的差异。支持 Range 的两次首帧为 7.888 秒和 7.930 秒,中位数 7.909 秒;忽略 Range 时为 1.410 秒和 1.396 秒,中位数 1.403 秒。网络记录显示前者发出了多个范围请求并扫描后续分片。头部已有 moov,并没有带来与普通头部版相同的起播路径。
这个观察应当留下。解释也要止于证据。可以说浏览器在这份文件上选择了不同读取路线,不能仅凭结果倒推出导出器应该关闭某个功能。更不应全局禁用 Range。前面普通尾部 MP4 已经展示过,不支持范围读取会暴露长等待,某些组合甚至出现媒体错误。一个产物的局部收益不能自动成为所有产物的配置。
A 分片产物在 Chromium 也没有呈现"有 Range 一定更快":支持时首帧中位数为 2.597 秒,范围 2.587 到 2.606 秒;忽略时为 0.987 秒,范围 0.983 到 0.990 秒。不过只看一个内核仍不够。产品 B 在 WebKit 的单次观察中,支持与忽略 Range 分别为 2.636 秒和 8.846 秒,方向已经不同。
Firefox 对产品 B 的两种模式单次结果为 0.978 秒和 0.985 秒。两次来自不同条件,不能组成某一个条件的统计区间。它们也不支持浏览器速度排行榜。产品网络组共有 16 条记录。只有 Chromium 做了重复。其余内核的单次数据主要用于发现需要补验的路径,不适合推广成稳定性能差异。
这里最容易犯的错误,是把真实产品 A 或 B 与普通 MP4 同名样本并排计算提升百分比。两边的内容时长、轨道及处理过程不同。需要读取的媒体数据也不相同。可比较的是同一产物在不同交付方式下的行为。若要评价导出方案,需要重新准备严格匹配的输入与输出约束,这不是本轮已经做过的工作。
五 录制文件为何显示不同的时长
文件字段和播放器结果分开检查
WebM 实验从浏览器录制开始。三个内核各把相同海浪视频的画面绘入画布,再从画布流录制约 4 秒,分块间隔设为 250 毫秒,停止后拼接全部数据块。来源是真实视频画面。它不是摄像头录制,也没有真人屏幕录制过程。录制调度会使三个文件的实际结束位置略有不同,不能把它们当作完全相同的逐帧输入。
三个内核本次都支持 WebM 录制。结构检查发现,原始文件都没有 Cues;Chromium 与 WebKit 生成的 Info 中没有 Duration,Firefox 则写出了 Duration=0。字段缺失与数值为零要分别记录。它们并未回答浏览器最终会显示什么。播放器可能根据其他信息推算时长。
在 Chromium 播放端,这三份原始录制文件在 loadeddata 后读出的 duration 都是 Infinity。录制并没有持续无限长时间。这只是当时读到的属性值。报告中若只写"视频没有时长",读者就无法判断这是文件中没有对应字段,还是浏览器暂时没有给出有限的时长,两者排查方向不同。
Firefox 的显示又不相同。它读取 Chromium、Firefox、WebKit 三种原始录制文件时,得到的时长分别为 3.464 秒、1.093 秒、0.800 秒。后两个值显著短于约 4 秒的录制过程,但这不证明编码内容只剩这么长。相同文件交给 WebKit 后,显示又分别为 3.950 秒、3.993 秒、3.985 秒。播放端同样是实验变量。
为了让这些结果可比较,我把取值阶段固定在 loadeddata 之后,而不是有的行取 loadedmetadata、有的行等播放结束再读。阶段不同可能影响属性值。记录中仍保留 durationchange 等事件,避免后续出现变化时只有最后一个覆盖值。研究变化过程需要保存时序。只留最终截图做不到这一点。
相同编码包重封装后表现改变
接着对每份原始录制文件各自进行复制编码流的重封装,不重新编码。成品有了有限 Duration 与 Cues,时长分别为 3.912 秒、3.993 秒和 3.969 秒。三个播放内核都显示了相应值。这里的"相同"限定在单份来源的前后配对。三个内核各自录出的内容与时间戳并不完全一致。
这个结论还需要编码包校验支撑。三对文件在重封装前后的媒体编码包哈希相同,所以可以把变化归入容器组织与读取行为的对照,而不需要假定重编码改善了画面。它和普通 MP4 组检查 mdat 有效负载的做法不同,但目的相近:都先确认没有把待比较的媒体内容换掉。
配对后重新播放,能够给前面的短时长现象提供反证。Firefox 对同一编码内容的重封装版本显示完整有限时长,说明原先的 1.093 或 0.800 不能直接解释为只录到了这么少的数据。内部估算规则仍未全部定位。播放器如何决定扫描范围与结束条件需要额外追踪。本轮没有把推测写成实现事实。
寻址结果也要克制使用。原始文件中有部分在设置 3 秒目标后被钳到 1.093 秒或 0.8 秒,位置记录可以支持"本次没有到目标"的判断。然而这组脚本最初保存的 frameTime 来自首次回调,可能对应旧帧。它不能像普通 MP4 那组持续筛选目标时间的记录一样,直接用来证明准确截图已经到达。
因此,本节采用的是文件结构、加载后时长、seekable、currentTime 和事件序列这些证据。重封装后时长恢复与位置变化可以如实报告,逐帧准确性则保留未验收状态。明知采样条件不同还把两组数据套同一个通过标签,会把一个有价值的结构对照变成不可靠的万能修复结论。
录制完成不等于寻址信息齐全
MediaRecorder 的停止与数据块收齐,主要解决录制生命周期是否结束。W3C 录制规范说明分时取得的单个 Blob 不一定各自可播。完成录制后的全部 Blob 组合则应当可播放。这一要求并不等同于保证所有封装都包含完整有限时长与随机寻址信息。能播和方便跳转仍需要分别检验。
Matroska 元素表分别定义 Duration、SeekHead 和 Cues。它们不是同一个"索引字段"的不同叫法。检查时应记录存在性、数值及所在结构。一项缺失不能代替全部结论。对本轮原始 WebM,能够确认的是没有 Cues 以及 Duration 的具体状态;本文没有额外声称每种录制器都必然省略所有寻址辅助元素。
如果业务接收的是录制完成后的文件,可以把重封装作为一个值得验证的后处理候选。验证条件应包括媒体包保持一致、时长读取正常,以及实际目标位置的画面另行通过。若业务需要的是录制过程中持续消费片段,问题就不同了。不能把本轮停止录制后的文件处理直接宣称为实时录制链路的解决方案。
另一个取舍是何时执行结构整理。拿到完整文件后再处理,有机会依据全部媒体内容补齐容器信息。这个过程也需要读取并写出文件。本文没有测量它的峰值内存与端侧耗时。因此没有设备处理能力或文件大小阈值的结论。需要把性能与资源实验另列,而不是从时长变正常推出处理成本很低。
六 三类产物怎样进入同一排查流程
先归档文件再选择对照变量
可执行的第一步是固定待测对象。保存原始输入、实际输出、导出设置和文件校验值,另外记下预期播放用途。不要先覆盖原文件。如果只提供不断更新的链接,排查者很难确定今天观察到的回跳和昨天的等待是否来自同一份字节内容,后面的结构分析即使正确,也可能分析错了对象。
然后识别容器实际结构。普通 MP4 记录 moov 与媒体数据区的位置,分片产物继续列出后续 moof、mdat 及相关索引结构,WebM 则记录 Duration 与寻址元素状态。文件可正常打开,并不是跳过这一步的理由。可播放性只说明至少有一条消费路径工作。其他目标位置仍需检查。
接下来选择只改变一个主要条件的副本。对于普通成品文件,可以比较保持媒体负载的头尾布局;对于完整录制 WebM,可以比较媒体包相同的原始版和重封装版;对于真实分片输出,则先保持产物不变,比较服务的范围读取行为。不能为了套统一模板而把三个分支都改成再次编码,否则原先想定位的变量已经消失。
执行前就写下预期观察。若怀疑尾部索引,需要看到取索引的请求路径;若怀疑当前范围限制,需要保存操作前的 seekable;若只是时长显示异常,首先比较字段和属性读取阶段。测试失败也能缩小问题范围。它不再只是脱离上下文的成功或超时。
检查顺序取决于失败位置
完全没有首帧时,先区分读取仍在继续、媒体错误已经发生和没有足够事件证据三个状态。继续读取可以检查索引与数据的到达次序,明确报错就保留错误发生的时间及附近请求。不要先执行依赖首帧的后续测试。未进入的步骤必须保持空缺,不能在统计时用默认零值替它填一个快速成功。
如果首帧已有而拖动失败,就把目标、当前位置、可寻址区间和目标帧判据放到一起。钳位要求解释目标为何不在当前范围;位置正确但画面未验证,则需要继续追踪帧回调与播放状态。两者不能用同一项超时重试覆盖。重试可能改变数据可用量。现象可能消失,原先的失败却还没有解释。
如果文件到不同浏览器后时长不同,优先固定同一份文件进行交叉播放。它把录制端和播放端分开。只测"自己录、自己播"难以区分生成结构与读取策略的影响。同一文件在多端的结果,加上一次保留编码包的重封装对照,才更有机会把问题定位到结构读取层。
最后才进入真实网站交付。把本地可复现条件迁到最终地址后,需要重新核对缓存、代理、鉴权、返回范围与内容。这个阶段应使用前面归档的确定文件。同时换掉文件与服务配置会失去归因依据。网站验收通过之后,再检查回归样本是否仍然覆盖原来那条失败路径。
七 哪些测量细节会误导结论
时间和字节采样存在边界
一次起播总时间里包含多个环节,两个终点事件之间的差也不自动等于某个内部处理阶段。网络等待可以与解码重叠。事件回调还受任务调度影响。本文因此只使用从明确动作到明确观察点的耗时名称。若要进一步量化解码成本,需要额外的内部测量点,不能把现有时差重新命名后当成新证据。
服务器日志与页面计时还可能使用不同时间基准。本轮浏览器阶段耗时由页面内计时得到,服务端另有自己的事件记录。两者可以用请求身份关联。未经时钟校准不能直接相减。跨进程时间看起来都像毫秒,语义并不相同;混减以后得到的负数或漂亮的小数,可能只是在暴露记录方法的差异。
样本数量也决定表达方式。两次普通 MP4 结果应同时给出范围,单次 WebM 或产品跨内核结果只能作为观察值。中位数不是精度保证。小数用来追溯记录。换设备以后未必复现同一个毫秒数。更不能把固定矩阵中的首帧通过比例直接解释为真实用户覆盖率。
事件原文比派生状态可靠
本轮 WebKit 的媒体错误暴露了测试判据自身的问题。错误信息字符串为空。早期等待逻辑曾把这个字段直接当作布尔值判断。结果等待走到了超时,但事件序列已经存在 error。准确解释应当依据事件本身。派生的 timeout 标记不能抹去已经发生的错误。应保留原始记录再修正汇总口径。失败行也不能静默擦除。错误类型、发生时刻和之后是否有帧都各有意义。报告里的"35 秒没有首帧"仍然成立,但它必须同时附带约 18 秒已经报错的事实。两句话合在一起才能描述实际状态,否则下一位维护者可能继续沿着延长等待的方向排查。
截图也有类似问题。通用复现页最初的头尾标签并不适合描述产品分片文件,因此那批产品播放器截图没有用于本文。真实请求数据仍可分析。图片却不能充当正确的结构说明。页面标签是测试人员写上的解释,并不是文件内容自己作出的声明,验收材料也需要检查它是否与当前产物匹配。
普通 MP4 的目标帧容差是另一个不能藏起来的条件。6±0.15 秒允许一定邻近范围。它没有要求精确命中某一帧。它适合本轮"是否到达目标附近"的问题,不足以直接承诺帧级截图精度。若业务要逐帧定位,应缩小或重新定义判据,并增加对应的画面验证,而不是沿用同一个通过名称。
容器检查不能依靠文本搜索
结构检查应沿着容器边界解析,而不是在二进制文件里搜到几个字母就判断布局。媒体数据内部也可能出现相同字节组合。只有确定它处在合法结构位置,名称、长度与边界才有意义。遇到截断或无法解析的结构,应当把错误留下,不能跳过这部分后仍宣称整个文件已经检查完整。
校验媒体负载时也要说明处理范围。普通 MP4 的一个数据区与 WebM 解出的编码包,是两种不同的比较单位。校验相同可以支持对应层面的内容保持,却不检查所有容器字段和时序是否满足业务要求。它用于控制变量。文件正确性还需要其他验证。后续播放仍需要单独验证。
可复跑材料应让下一位读者找到同一文件、复现同一操作并检查同一终点。仅仅启动脚本还不够。对于这次实验,文件身份、浏览器构建、限速方式、首帧后的等待、目标时间和事件记录缺一项,复现结果都可能回答另一个问题。材料越清楚,异常值越有机会被解释,而不是被当成噪声删掉。
八 交付验收怎样留下真实取舍
通过条件必须绑定测试条件
导出完成可以作为文件生成阶段的通过条件,保存的字节也需要与输入及设置关联。之后对完整性、结构、首次显示和目标寻址分别给出结论。某个阶段没有执行就明确写未测试。这样后续使用者不会把"文件已经保存"理解成"任何交付方式都能顺利播放"。
对普通 MP4,我会优先保留头尾布局和 Range 配对的结果;对分片产物,保留完整片段序列的结构信息及浏览器实际读取轨迹;对录制 WebM,保留录制端、播放端、读取时点以及重封装前后的配对关系。它们共享证据格式。成功路径则可以不同。不能要求所有产物都长成普通 faststart 文件。
实际选择需要回到用途。下载后离线播放、页面刚打开就拖动、录制后生成封面,对读取时机和目标精度的要求都不同。本文只给出了能支撑这些讨论的局部实验。若某个候选方案在首帧指标上占优,还要检查它是否改变其他必须满足的条件,不能让一个更短的等待数覆盖尚未验证的功能。
后续验证优先补齐未知项
下一轮值得先补的是已经出现分歧的环节:WebKit 普通 B 文件的媒体错误原因,分片产物在各内核中的扫描路径,以及 WebM 目标画面的独立验证。这些实验应分别设计。反复测试已经稳定的成功组合不能补齐上述未知。需要新增的证据应直接回答尚未解决的问题。
真实网络链路也是待补项。应从最终访问地址核对范围响应和实际文件,再扩展到缓存状态、代理路径与目标设备。资源占用另开测量。文件变小不能证明内存下降。自适应流媒体也需要自己的清单和版本切换验证,本轮单个文件的分段读取并没有完成这些工作。
在这些验证完成之前,当前可以交付的结论仍然具体:普通尾部 MP4 的等待受索引可达性影响;真实导出分片文件的读取不能只按 moov 位置解释;录制 WebM 的结构字段与播放端估算必须分开记录。遇到新文件时先保留原件、确认产物类型,再选择能控制变量的对照,并把失败和未测试项目一起留下。这样后续改动才有明确的复查对象。
参考资料
- FFmpeg Formats Documentation:普通 MOV/MP4 的 faststart 与 fragmentation 说明。
- RFC 9110 Range Requests:Range、Accept-Ranges 与部分响应语义。
- W3C ISO BMFF Byte Stream Format:初始化与媒体片段的结构说明,本文未据此声称完成 MSE 播放验证。
- W3C MediaStream Recording:录制生命周期及完成录制后的数据块组合要求。
- Matroska Element Specification:Duration、SeekHead、Cues 等元素定义。
- MDN HTMLMediaElement seekable:读取时刻的可寻址范围语义。
- MDN requestVideoFrameCallback:帧回调与媒体时间观察。
素材 A 为 Alexander Grebenkov 的 Ocean waves at Lækjavik beach Iceland,许可 CC BY 3.0。素材 B 为 דוד שי 的 Water waves in Herzliya beach,许可 CC BY-SA 4.0。两份均复用已有文件并核对来源页校验值,非本人拍摄。普通测试有截取、缩放、去音轨与转码,录制组有画布录制,产品组使用原始输入;配图为对应受控页面或实际工作台截图。