🔥 本文专栏:CUDA
🌸作者主页:努力努力再努力wz


💪 今日博客励志语录:
真正属于你的东西,不是某一次运气给你的高度,而是环境变化以后,你依然能够重新爬上去的能力。
思维导图
text
CUDA 程序
│
├── Host / CPU
│    ├── main() 程序入口
│    ├── 选择 GPU
│    │    ├── cudaGetDeviceCount()
│    │    └── cudaSetDevice()
│    │
│    ├── 准备 Host 数据
│    │
│    ├── 准备 Device Memory
│    │    ├── cudaMalloc()
│    │    └── cudaMemset()
│    │
│    ├── Host → Device
│    │    └── cudaMemcpy()
│    │
│    ├── 配置 Kernel
│    │    └── <<<grid, block, sharedMem, stream>>>
│    │
│    ├── 发起 Kernel
│    │    └── Host 与 Device 异步推进
│    │
│    ├── 同步与结果获取
│    │    ├── cudaDeviceSynchronize()
│    │    └── cudaMemcpy(DeviceToHost)
│    │
│    ├── 错误检测
│    │    ├── cudaError_t
│    │    ├── cudaGetErrorName()
│    │    ├── cudaGetErrorString()
│    │    ├── cudaGetLastError()
│    │    └── cudaDeviceSynchronize()
│    │
│    └── 资源释放
│         ├── cudaFree()
│         └── cudaDeviceReset()
│
└── CUDA 异步执行模型
     ├── CUDA Context:GPU 执行环境
     ├── Stream:有序 GPU 工作流
     │    ├── 单 Stream:保证顺序
     │    └── 多 Stream:提供并发机会
     │
     └── Event:Stream 中的完成标记
          ├── cudaEventCreate()
          ├── cudaEventRecord()
          ├── cudaEventQuery()
          ├── cudaEventSynchronize()
          ├── cudaStreamWaitEvent()
          └── cudaEventDestroy()
一、从"CUDA 是什么"过渡到"CUDA 程序到底怎么写"
在此前学习 CUDA 的过程中,我们更多是在建立理论层面的认识,例如:
text
CPU 与 GPU 的分工
Grid / Block / Thread
Warp
SM
CUDA Core
Global Memory
Shared Memory
Register
PTX
Compute Capability
Runtime API 与 Driver API
这些内容解决的是:
CUDA 为什么能够进行大规模并行计算,以及 GPU 内部到底如何组织线程和计算资源。
但是当真正开始写一个 CUDA 程序以后,我们会遇到另外一个更加实际的问题:
CPU 究竟如何把一段计算任务交给 GPU?
一个 CUDA 程序并不是只有 GPU 代码,而是同时包含:
text
Host Code
+
Device Code
其中:
text
Host Code
→ CPU 执行

Device Code
→ GPU 执行
而整个程序真正的入口依然是:
cpp
int main()也就是说,程序首先运行在 CPU 一侧。
GPU 并不会自己主动寻找任务,而是 CPU 在程序运行过程中发现某一部分计算适合交给 GPU,然后通过 CUDA Runtime 将对应工作提交给 GPU。
因此,一个最基础的 CUDA 程序可以先建立下面这条执行链:
text
程序启动
   ↓
CPU 从 main() 开始执行
   ↓
选择 GPU 设备
   ↓
CPU 准备原始数据
   ↓
GPU 申请显存
   ↓
Host → Device 数据拷贝
   ↓
配置 Grid / Block
   ↓
CPU 发起 Kernel
   ↓
GPU 执行计算
   ↓
等待 / 同步
   ↓
Device → Host 拷回结果
   ↓
CPU 使用结果
   ↓
释放资源
下面这张图正好描述了一个 CUDA 程序最基础的代码框架。
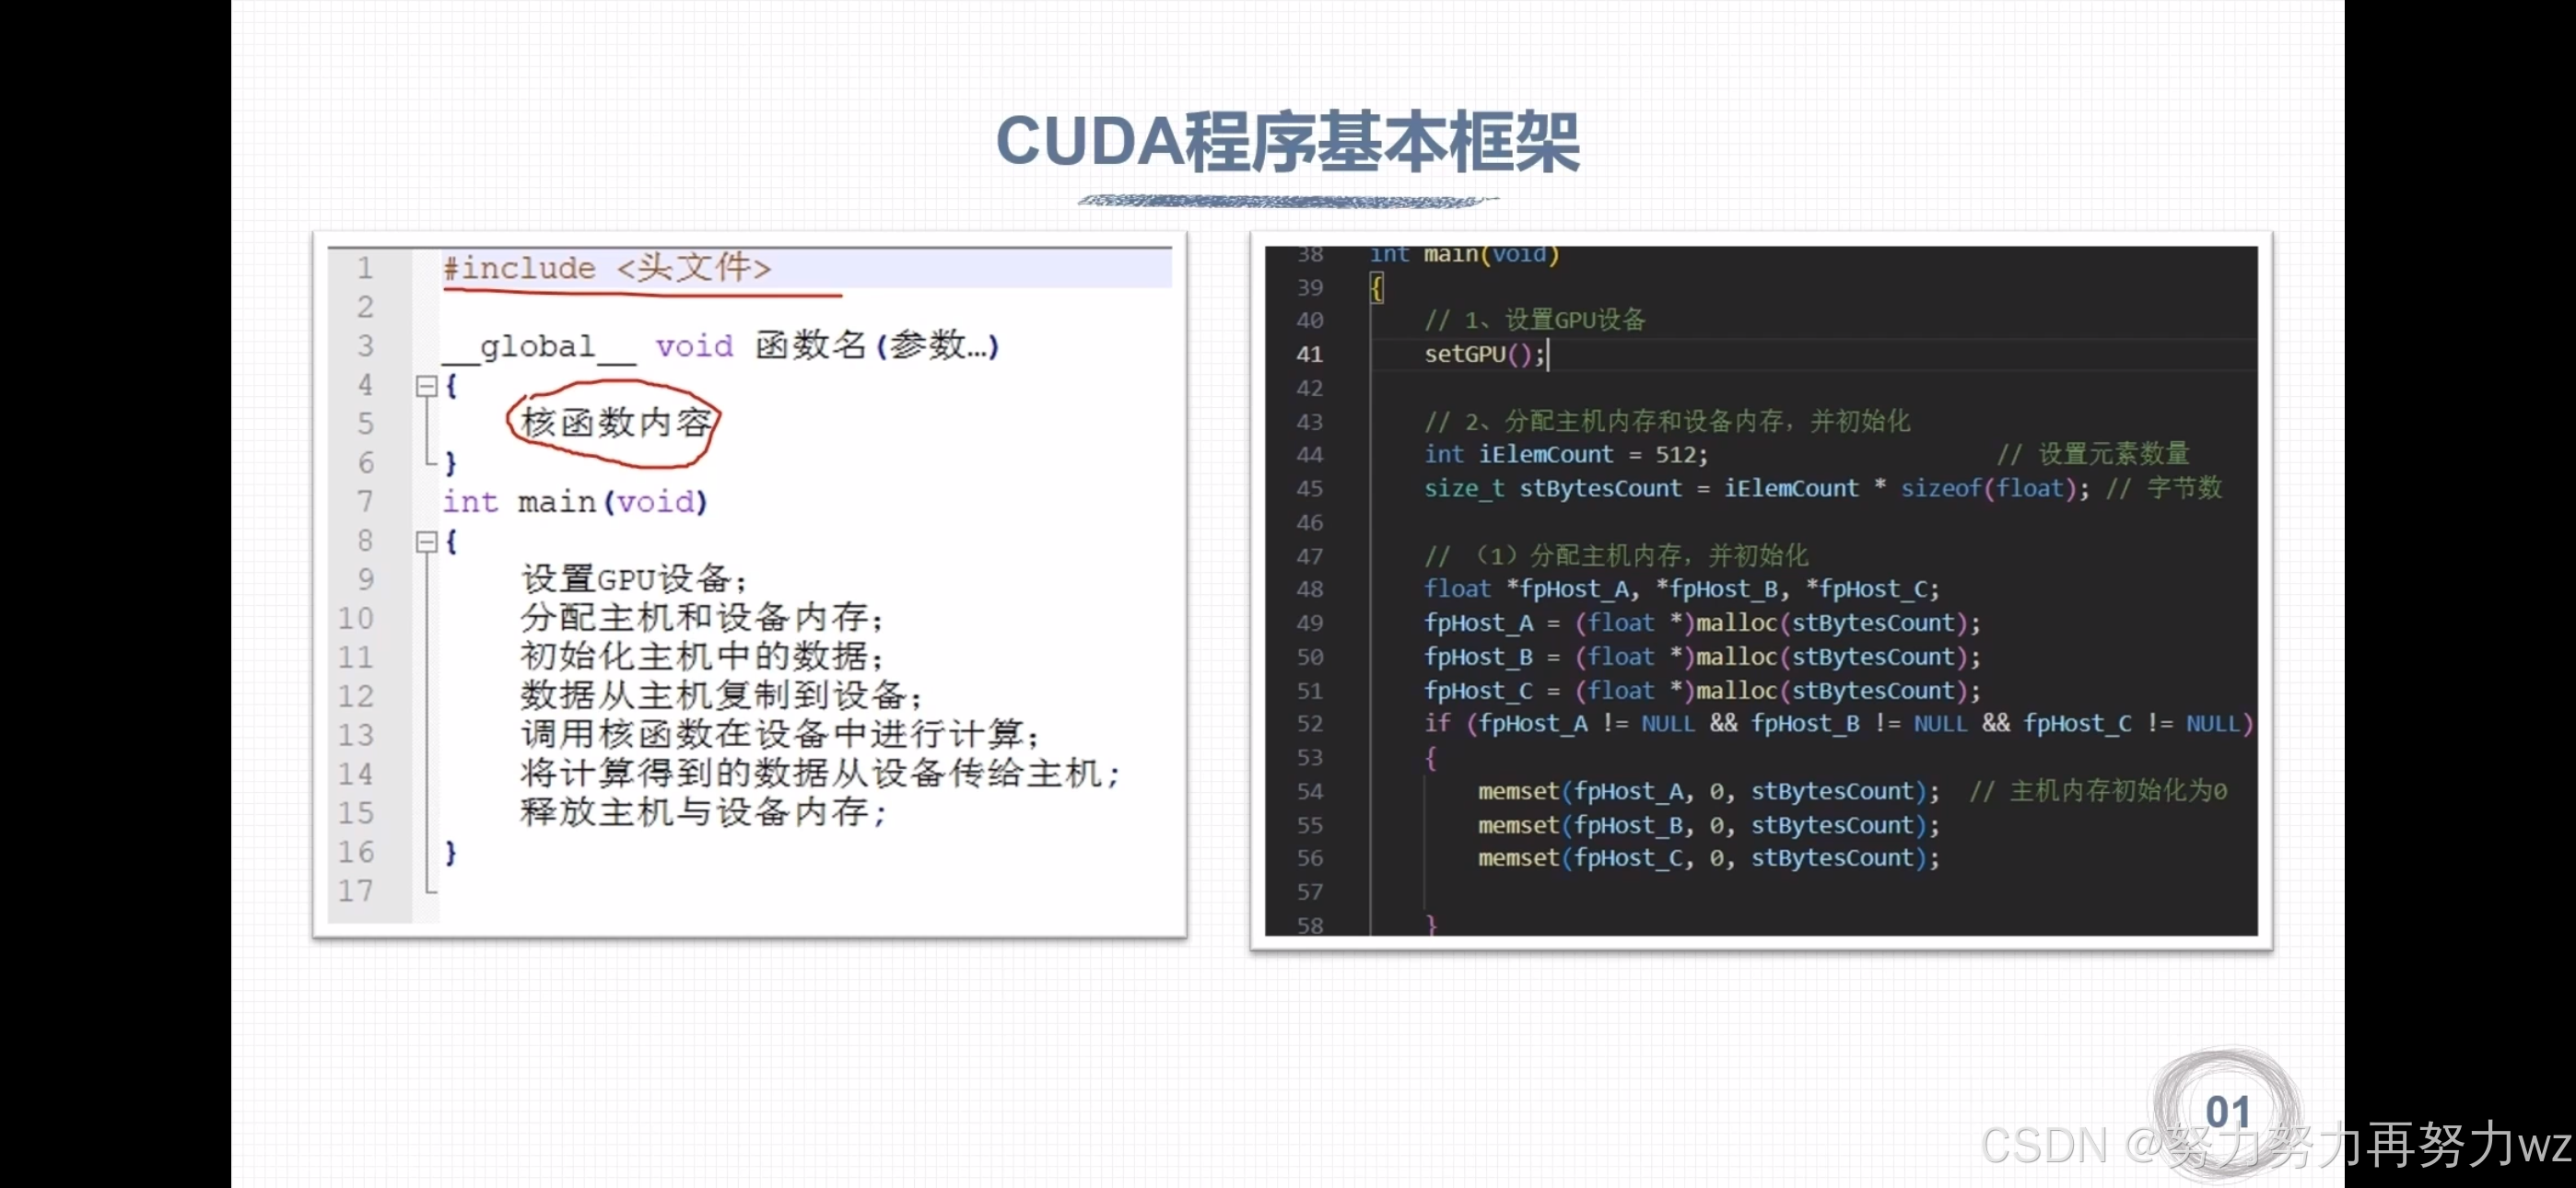
接下来就沿着这条执行链逐步展开,而不是孤立地记忆一个个 CUDA API。
二、第一步:CPU 先确定后面的任务交给哪块 GPU
1. 为什么需要选择 GPU
一台机器并不一定只有一块 GPU。
例如:
text
CPU
 │
 ├── GPU 0
 ├── GPU 1
 └── GPU 2
当 CPU 后面需要执行:
text
申请显存
拷贝数据
启动 Kernel
这些操作时,就必须明确:
后续 CUDA 工作到底针对哪一个 GPU?
因此 CUDA Runtime 提供了两个非常基础的 API:
cpp
cudaGetDeviceCount()
cudaSetDevice()
它们分别解决两个不同的问题。
2. cudaGetDeviceCount:机器上有多少个 CUDA 设备
例如:
cpp
int deviceCount = 0;
cudaGetDeviceCount(&deviceCount);
如果:
text
deviceCount = 3那么可以理解为当前 CUDA Runtime 能够看到:
text
GPU 0
GPU 1
GPU 2
这里需要注意:
cpp
cudaGetDeviceCount()只是一个查询操作。
它解决的是:
text
"有多少块 GPU?"而不是:
text
"我要使用哪一块 GPU?"3. cudaSetDevice:真正选择 GPU
真正选择设备的是:
cpp
cudaSetDevice(0);它可以先理解为:
当前 Host 线程后续的 CUDA 工作使用 CUDA 可见设备中的 GPU 0。
例如:
cpp
cudaSetDevice(1);就是选择 GPU 1。
所以两个 API 的关系可以整理为:
text
cudaGetDeviceCount()
        ↓
查询:有几块 GPU?

        ↓
程序自己选择

cudaSetDevice(deviceId)
        ↓
确定:后续使用哪块 GPU?
如果程序没有显式调用:
cpp
cudaSetDevice()基础场景下通常使用 CUDA 可见设备中的:
text
device 0注意,这和有没有调用 cudaGetDeviceCount() 没有关系。
4. 将设备选择逻辑封装成 setGPU
设备查询与选择属于一段相对独立的初始化逻辑,因此可以直接封装:
cpp
bool setGPU(int deviceId = 0)
{
    int deviceCount = 0;

    cudaError_t error = cudaGetDeviceCount(&deviceCount);
    if (error != cudaSuccess)
    {
        return false;
    }

    if (deviceCount == 0)
    {
        return false;
    }

    if (deviceId < 0 || deviceId >= deviceCount)
    {
        return false;
    }

    error = cudaSetDevice(deviceId);
    if (error != cudaSuccess)
    {
        return false;
    }

    return true;
}
于是主流程中只需要:
cpp
if (!setGPU(0))
{
    return -1;
}
外层代码只关心:
text
GPU 是否准备好了?至于内部:
text
有几块 GPU?
设备编号是否合法?
设备选择是否成功?
则全部由 setGPU() 完成。
三、CUDA Context:为什么 CPU 与 GPU 协同工作需要"上下文"
在继续学习显存之前,可以顺手建立一个非常重要的概念:
text
CUDA ContextCUDA 程序运行以后,CPU 并不是只向 GPU 发一次任务就结束。
后面还会不断涉及:
text
选择 Device
申请 Device Memory
加载 GPU 代码
创建 Stream
创建 Event
提交 Kernel
进行数据拷贝
释放资源
这些操作显然不能全部作为彼此孤立的动作存在。
CUDA 系统需要维护:
text
当前对应哪个 Device
有哪些显存分配
有哪些 Stream
有哪些 Event
加载了哪些 Module / Kernel
还有哪些与 GPU 执行相关的状态
所以可以将 CUDA Context 理解成:
一个进程使用某块 GPU 时,由 CUDA 软件栈维护的一套 GPU 执行环境和相关状态集合。
这个概念和网络服务器中的连接上下文非常相似。
例如服务器维护一个连接时,往往会有:
text
Connection
│
├── fd
├── state
├── input buffer
├── output buffer
├── Channel
├── timer
└── 其他生命周期状态
因为一个连接不是只发生一次 read() 就结束,而是在整个生命周期中不断发生各种操作。
同理,CUDA 也需要维护 GPU 使用过程中的整体状态:
text
CUDA Context
│
├── Device
├── Device Memory
├── Stream
├── Event
├── Module / Kernel
└── 其他 CUDA 状态
不过要注意:
CUDA Context 是逻辑上的执行环境,不要把它简单理解成 CPU 内存中的某一个普通
struct。
在我们目前主要使用的 CUDA Runtime API 中,Context 大部分由 Runtime / Driver 帮助管理,所以基础 CUDA 程序中通常并不需要手动创建和切换 Context。
等以后学习更底层的 CUDA Driver API 时,才会更直接地接触:
text
CUcontext目前知道它为什么存在即可。
四、第二步:CPU 准备数据,GPU 准备显存
GPU 被选择以后,下一步就是准备真正要计算的数据。
假设 CPU 需要让 GPU 处理 512 个 float:
cpp
int elemCount = 512;
size_t bytes = elemCount * sizeof(float);
CPU 一侧可以先准备 Host Memory:
cpp
float* h_data = (float*)malloc(bytes);这里常见的命名习惯是:
text
h_xxx
→ Host

d_xxx
→ Device
因此:
cpp
float* h_data;
float* d_data;
一眼就能区分它们分别代表 CPU 侧数据和 GPU 侧数据。
1. Host Memory 与 Device Memory
在最基础的独立显卡模型中,可以先理解为:
text
CPU / Host                        GPU / Device

Host Memory                       Device Memory
┌──────────────┐                 ┌──────────────┐
│ h_data       │                 │ d_data       │
│ 0            │                 │              │
│ 1            │                 │              │
│ 2            │                 │              │
│ ...          │                 │              │
└──────────────┘                 └──────────────┘
CPU 已经有了数据,但是 GPU 还没有地方保存这些数据。
于是下一步就是:
text
先申请 GPU 显存五、cudaMalloc:Host 端申请 Device Memory
GPU 显存申请对应:
cpp
cudaMalloc()例如:
cpp
float* d_data = nullptr;

cudaMalloc(&d_data, bytes);
这里需要建立两个认识。
1. cudaMalloc 是 Host 端 Runtime API
虽然它申请的是 GPU 显存,但是:
cpp
cudaMalloc()本身是由 Host 代码调用的。
也就是:
text
CPU / Host
   │
   │ cudaMalloc()
   ↓
CUDA Runtime / Driver
   │
   ↓
申请 Device Memory
不要把:
text
"给 GPU 申请显存"错误理解为:
text
"这个函数在 GPU Kernel 中调用"设备端如果自己进行动态内存申请,是另外一套机制,例如设备代码中的 malloc(),和这里不是同一个问题。
2. 为什么传的是 &d_data
d_data 最终需要保存 GPU 显存地址。
因此:
cpp
cudaMalloc(&d_data, bytes);可以理解成:
text
调用前:

d_data
  ↓
nullptr


cudaMalloc(&d_data, bytes)
        ↓
在 GPU 上申请显存
        ↓
得到 Device Memory 地址
        ↓
把地址写入 d_data


调用后:

d_data
  │
  └────→ Device Memory
所以 d_data 本身依然是 Host 代码中的一个指针变量,但是它保存的是 Device Memory 的地址信息。
六、cudaMemset:初始化 Device Memory
显存申请以后,其中的原始内容并没有自动初始化。
因此,如果需要把显存清零,可以使用:
cpp
cudaMemset(d_data, 0, bytes);它和 C 语言中的:
cpp
memset()非常相似。
而且:
cpp
cudaMemset()同样属于 Host 端调用的 CUDA Runtime API。
可以理解成:
text
cudaMalloc()
      ↓
申请一块 Device Memory

┌───────────────┐
│ ? ? ? ? ? ? ? │
└───────────────┘

cudaMemset(..., 0, ...)
      ↓

┌───────────────┐
│ 0 0 0 0 0 0 0 │
└───────────────┘
这里需要特别注意:
cudaMemset()和普通memset()一样,本质是按字节填充。
例如:
cpp
cudaMemset(d_data, 1, bytes);如果 d_data 是 int*,并不意味着每一个整数都会变成:
text
1一个 4 字节 int 更接近被填成:
text
01 01 01 01所以实际最常见的场景依然是:
cpp
cudaMemset(..., 0, ...);用于清零。
七、cudaMemcpy:真正把数据交给 GPU
现在:
text
CPU 一侧已经有数据
GPU 一侧也已经有显存
下一步才是真正进行数据传输。
最基础的接口是:
cpp
cudaMemcpy()例如:
cpp
cudaMemcpy(
    d_data,
    h_data,
    bytes,
    cudaMemcpyHostToDevice
);
可以把它直接拆成:
cpp
cudaMemcpy(
    目标地址,
    源地址,
    拷贝字节数,
    拷贝方向
);
所以:
cpp
cudaMemcpyHostToDevice表达的是:
text
Host Memory
     ↓
Device Memory
整个过程可以画成:
text
CPU / Host                     GPU / Device

h_data                         d_data
┌──────────────┐              ┌──────────────┐
│ 0            │ ───────────→ │ 0            │
│ 1            │ ───────────→ │ 1            │
│ 2            │ ───────────→ │ 2            │
│ ...          │ ───────────→ │ ...          │
└──────────────┘              └──────────────┘

          cudaMemcpyHostToDevice
这里一定要区分:
text
cudaMalloc()
→ 解决"GPU 有没有地方放数据"

cudaMemcpy()
→ 解决"数据怎样真正进入 GPU"
cudaMalloc() 并不会自动把 Host 数据一起带过去。
八、第三步:配置 Kernel 的 Grid 与 Block
数据准备好以后,就可以真正发起 GPU 计算任务。
此前最常见的写法是:
cpp
kernel<<<grid, block>>>(...);例如:
cpp
dim3 block(256);
dim3 grid((N + block.x - 1) / block.x);

kernel<<<grid, block>>>(...);
其中:
text
grid
→ Grid 中有多少个 Block

block
→ 每个 Block 中有多少个 Thread
而 dim3 可以理解成 CUDA 提供的一个三维尺寸类型:
text
x
y
z
例如:
cpp
dim3 block(256);可以理解为:
text
(256, 1, 1)而:
cpp
dim3 block(16, 16);可以理解为:
text
(16, 16, 1)九、Kernel 启动其实最多有 4 个执行配置参数
此前只写:
cpp
kernel<<<grid, block>>>(...);并不意味着 Kernel 只有两个启动配置参数。
完整形式是:
cpp
kernel<<<grid, block, sharedMem, stream>>>(kernelArgs...);分别表示:
text
<<<
    grid,
    block,
    sharedMem,
    stream
>>>
1. grid
表示:
text
整个 Grid 有多少个 Block2. block
表示:
text
每个 Block 有多少个 Thread3. sharedMem
第三个参数表示:
每个 Block 需要额外申请多少字节的动态 Shared Memory。
例如:
cpp
kernel<<<grid, block, 1024>>>(...);表示每个 Block 额外申请:
text
1024 Bytes动态共享内存。
Kernel 中常常和:
cpp
extern __shared__ float data[];配合使用。
如果不需要动态共享内存,则:
text
sharedMem = 04. stream
第四个参数表示:
这个 Kernel 被提交到哪个 CUDA Stream。
例如:
cpp
kernel<<<grid, block, 0, stream>>>(...);表示:
text
动态共享内存 = 0

Kernel 提交到 stream
所以此前:
cpp
kernel<<<grid, block>>>(...);可以先概念性理解为:
cpp
kernel<<<grid, block, 0, 0>>>(...);也就是说:
text
没有额外动态共享内存
+
使用默认 Stream
因此我们此前虽然没有主动学习 Stream,但是并不意味着 Kernel 执行时完全没有 Stream 这一层抽象。
5. <<< >>> 与普通函数参数不是一回事
例如:
cpp
kernel<<<grid, block, 0, stream>>>(d_data, N);这里其实有两组不同的参数:
text
<<<grid, block, 0, stream>>>
          ↓
Kernel 执行配置
而:
text
(d_data, N)
     ↓
真正传给 Kernel 函数的参数
例如:
cpp
__global__ void kernel(float* data, int N)对应的就是:
cpp
kernel<<<...>>>(d_data, N);十、Kernel Launch 为什么天然适合异步执行
真正发起 Kernel:
cpp
kernel<<<grid, block>>>(...);以后,一个非常重要的特点就是:
Kernel Launch 对 Host 线程通常是异步的。
CPU 并不是:
text
提交 Kernel
   ↓
站在原地等待 GPU
   ↓
GPU 执行结束
   ↓
CPU 再继续
而更接近:
text
CPU                             GPU

kernel<<<>>>();
    │
    ├──────── 提交任务 ───────→ Kernel
    │                            │
    ↓                            │
继续执行 Host 代码              │ 执行
    │                            │
    │                            ↓
    │                         完成
    ↓
后续 CPU 逻辑
这和我们做高性能服务器时的思想非常相似。
如果一个 CPU 线程发起某个外部任务以后必须一直等待,那么 CPU 的执行资源就会被白白浪费。
所以更合理的方式是:
text
CPU 提交 GPU 工作
        ↓
CPU 继续自己的执行流

与此同时

GPU 独立执行对应任务
CPU 与 GPU 因此可以在时间上并行推进。
这里可以借助多线程做一个直觉类比:
text
CPU 将任务交给另一个执行者
然后自己继续做其他事情
但是不要真的把 Kernel Launch 理解成创建一个 CPU Thread。
GPU 后面执行的是大量 GPU Thread,其硬件执行模型和 CPU 线程完全不同。
十一、异步以后必然产生一个问题:什么时候同步?
异步并不是意味着 CPU 永远不关心 GPU。
真正应该建立的认识是:
CPU 不需要在每次提交 GPU 任务以后立即等待,但是当 CPU 后续逻辑真正依赖 GPU 结果时,必须在依赖发生之前建立同步。
这就是:
cpp
cudaDeviceSynchronize();出现的原因。
例如:
cpp
kernel<<<grid, block>>>(...);

cudaDeviceSynchronize();

printf("GPU finished\n");
逻辑可以理解为:
text
CPU                         GPU

提交 Kernel ─────────────→ 执行 Kernel
   ↓                          │
cudaDeviceSynchronize()       │
   │                          │
   │       CPU 等待           │
   │                          ↓
   │                       Kernel 完成
   │                          │
   ←──────────────────────────┘
   ↓
CPU 继续
cudaDeviceSynchronize() 会让当前 Host 线程等待当前 Device 上此前提交的相关工作完成。
十二、为什么很多基础程序没有显式调用 cudaDeviceSynchronize
一个非常常见的程序结构是:
cpp
kernel<<<grid, block>>>(d_result);

cudaMemcpy(
    h_result,
    d_result,
    bytes,
    cudaMemcpyDeviceToHost
);
这里没有显式写:
cpp
cudaDeviceSynchronize();原因在于,在我们目前讨论的基础阻塞式 Device → Host 拷贝场景中,cudaMemcpy() 本身就会形成 Host 侧等待点。
因为:
text
GPU 的结果还没计算出来
        ↓
就不可能正确完成 Device → Host 拷贝
因此在同一条有序执行链中:
text
Kernel
   ↓
D2H Copy
必须先完成 Kernel,才能完成结果拷贝。
最终:
text
cudaMemcpy() 返回
        ↓
CPU 可以安全使用 h_result
但是这里要注意:
cudaMemcpy()不能简单等价成cudaDeviceSynchronize()。
不同拷贝方向、Host Memory 类型、Stream 以及同步方式会影响实际语义。
目前只需要记住最基础的场景:
text
Kernel
↓
阻塞式 D2H cudaMemcpy
↓
CPU 得到结果
往往不需要为了"拿到这一次结果"额外再插一个 cudaDeviceSynchronize()。
十三、CUDA Runtime API 为什么需要错误检测
此前写 Linux/C++ 项目时,我们几乎不会直接假设:
text
socket()
bind()
listen()
epoll_ctl()
一定成功。
正常的工程代码一定会:
text
调用 API
   ↓
检查返回值
   ↓
失败
   ↓
获取错误码与错误描述
   ↓
记录日志
CUDA 程序同样如此。
很多 CUDA Runtime API 都会返回:
cpp
cudaError_t例如:
cpp
cudaError_t error = cudaMalloc(&d_data, bytes);如果调用成功:
cpp
error == cudaSuccess如果失败,则会返回对应的 CUDA 错误枚举。
十四、cudaGetErrorName 与 cudaGetErrorString
拿到:
cpp
cudaError_t error以后,可以继续获得更容易阅读的信息。
1. cudaGetErrorName
cpp
cudaGetErrorName(error)用于获取错误名称,例如:
text
cudaErrorMemoryAllocation2. cudaGetErrorString
cpp
cudaGetErrorString(error)用于获取错误描述。
于是可以写:
cpp
void checkCudaError(cudaError_t error, const char* api)
{
    if (error == cudaSuccess)
    {
        return;
    }

    fprintf(
        stderr,
        "[CUDA ERROR] api=%s code=%d name=%s message=%s\n",
        api,
        static_cast<int>(error),
        cudaGetErrorName(error),
        cudaGetErrorString(error)
    );
}
使用时:
cpp
checkCudaError(
    cudaMalloc(&d_data, bytes),
    "cudaMalloc"
);
这和 Linux 中常见的:
text
返回值
↓
errno
↓
strerror(errno)
在工程思想上非常接近。
十五、普通 Runtime API 好检查,Kernel 为什么更麻烦?
对于:
cpp
cudaMalloc()
cudaMemcpy()
cudaSetDevice()
CPU 是直接调用这些普通 Runtime API 的。
因此:
text
CPU 调用 API
   ↓
API 返回
   ↓
直接得到 cudaError_t
这一次 API 调用与返回状态的对应关系非常明确。
但是 Kernel 不一样:
cpp
kernel<<<grid, block>>>(...);它存在两个特点:
text
1. __global__ Kernel 的返回类型是 void
2. Kernel Launch 对 Host 通常是异步的
所以不能写:
cpp
cudaError_t error = kernel<<<...>>>(...); // 错误更重要的是:
text
Kernel 成功提交
≠
Kernel 最终成功执行完成
因此 Kernel 的错误检测需要拆成两个阶段。
十六、Kernel 错误的两个阶段:Launch 与 Execution
1. 第一阶段:Launch Error
第一类错误发生在:
text
Kernel 发起阶段例如执行配置本身就不合法。
这时候 Kernel 可能根本没有正常进入实际执行阶段。
可以在 Kernel 后立刻调用:
cpp
cudaGetLastError();例如:
cpp
kernel<<<grid, block>>>(...);

cudaError_t launchError = cudaGetLastError();
checkCudaError(launchError, "kernel launch");
可以把它理解成:
text
kernel<<<>>>();
      ↓
cudaGetLastError()
      ↓
检查:
"刚才这个 Kernel 在发起阶段有没有明显问题?"
注意:
cpp
cudaGetLastError()操作的是 CUDA Runtime 当前维护的错误状态,并不是每一个 Kernel 都有一个独立的"错误结果对象"。
这里还有一个名字很像的 API:
cpp
cudaPeekAtLastError();两者最大的区别可以先记成:
text
cudaGetLastError()
→ 读取当前错误状态
→ 读取以后会把这个错误状态清回 cudaSuccess

cudaPeekAtLastError()
→ 读取当前错误状态
→ 但不清除这个状态
所以调试时如果只是想"看一眼"当前错误状态,而暂时不希望把它消费掉,可以使用 cudaPeekAtLastError()。
2. 第二阶段:Execution Error
即使:
cpp
cudaGetLastError() == cudaSuccess也不能说明 Kernel 已经完整执行成功。
因为此时 GPU 很可能还在真正执行:
text
CPU                         GPU

Kernel Launch
   │ ─────────────────────→ Kernel
   ↓                          │
cudaGetLastError()            │
   ↓                          │ 正在执行
cudaSuccess                   │
                              ↓
                           这里才发生错误
例如:
text
非法显存访问
越界访问
执行阶段资源问题
这些错误需要等 GPU 真正执行以后才能暴露。
所以调试时常见的结构是:
cpp
kernel<<<grid, block>>>(...);

// 1. 检查 Launch 阶段
checkCudaError(
    cudaGetLastError(),
    "kernel launch"
);

// 2. 等待真正执行完成,检查 Execution 阶段
checkCudaError(
    cudaDeviceSynchronize(),
    "kernel execution"
);
可以把两者简单记成:
text
cudaGetLastError()
→ "任务派出去的时候有没有问题?"

cudaDeviceSynchronize()
→ "任务真正执行完以后有没有问题?"
十七、为什么调试阶段常在每个 Kernel 后同步
假设:
cpp
kernelA<<<...>>>();
kernelB<<<...>>>();
kernelC<<<...>>>();

cudaDeviceSynchronize();
如果最后:
cpp
cudaDeviceSynchronize()返回错误,那么只能大概知道:
text
前面这一批异步 GPU 工作中存在问题但具体是:
text
A?
B?
C?
定位就比较困难。
所以调试阶段经常会写成:
cpp
kernelA<<<...>>>();
checkCudaError(cudaGetLastError(), "kernelA launch");
checkCudaError(cudaDeviceSynchronize(), "kernelA execution");

kernelB<<<...>>>();
checkCudaError(cudaGetLastError(), "kernelB launch");
checkCudaError(cudaDeviceSynchronize(), "kernelB execution");
这样就能迅速缩小错误范围。
但是要注意:
这种写法主要用于调试,不应该机械地放进所有高性能代码中。
因为:
text
发一个 Kernel
↓
等一个 Kernel
↓
再发下一个
会严重破坏 CPU 与 GPU 的异步并行。
十八、CUDA_LAUNCH_BLOCKING=1 到底是什么
调试 CUDA 时还经常看到:
bash
CUDA_LAUNCH_BLOCKING=1 ./program这里的:
text
CUDA_LAUNCH_BLOCKING不是 API,而是一个环境变量。
它做的事情非常单纯:
调试时把本来异步的 GPU 工作从 Host 视角强制变得更加同步。
正常情况下:
text
CPU:提交 A → 提交 B → 提交 C → 继续
GPU:      A → B → C
设置以后更接近:
text
提交 A
↓
等 A
↓
提交 B
↓
等 B
↓
提交 C
↓
等 C
这里一定要注意:
CUDA_LAUNCH_BLOCKING=1本身不是错误检测器,也不会替程序记录错误码和错误描述。
它只是改变异步执行行为,让错误更容易暴露在真正相关的调用位置附近。
真正获取错误状态,仍然依赖:
text
cudaGetLastError()
cudaDeviceSynchronize()
其他 Runtime API 返回值
调试工具
因此,对于自己编写的小型 CUDA 程序,直接在关键 Kernel 后显式检查通常更加直观。
而 CUDA_LAUNCH_BLOCKING=1 更适合:
text
大型项目
第三方 CUDA 库
PyTorch / TensorRT
大量 Kernel 调用点
不方便逐个修改代码时,用作全局辅助调试开关。
十九、资源释放:cudaFree 与 cudaDeviceReset
GPU 计算完成以后,还需要释放资源。
1. cudaFree
通过:
cpp
cudaMalloc(&d_data, bytes);申请的显存,对应使用:
cpp
cudaFree(d_data);可以和 C/C++ 建立下面的对应关系:
text
CPU Memory

malloc / new
    ↓
free / delete


GPU Device Memory

cudaMalloc
    ↓
cudaFree
cudaFree() 释放的是:
text
某一块具体的 Device Memory2. cudaDeviceReset
另外还有:
cpp
cudaDeviceReset();它和 cudaFree() 不是同一级别的操作。
可以先理解为:
text
cudaFree(d_data)
→ 释放 d_data 这一块显存

cudaDeviceReset()
→ 清理当前进程中当前 CUDA Device 相关的 Runtime 状态和资源
所以正常资源管理仍然应该是:
text
谁申请
谁释放
而不是:
text
反正最后 cudaDeviceReset()
前面就不用 cudaFree()
cudaDeviceReset() 更适合作为程序结束时可选的设备级清理动作,而不是替代正常资源生命周期管理。
二十、为什么 CUDA 高性能的核心一定会走向"异步"
到这里,最基础的 CUDA 程序已经能够跑通。
但是如果真正考虑性能,就会发现一个问题:
text
CPU
GPU
本身就是两个独立的执行主体。
如果每一次 CPU 提交 GPU 工作以后都立即:
text
等待 GPU那么 CPU 和 GPU 根本无法充分重叠工作。
这种问题和高性能服务器非常类似。
网络服务器不会希望:
text
线程发起一次 I/O
↓
跟着这个 I/O 一起阻塞
↓
I/O 完成以后才继续
因为这样会白白浪费 CPU 执行资源。
CUDA 也是一样。
真正理想的模型是:
text
CPU 提交 GPU 工作
        ↓
CPU 继续执行 Host 逻辑

与此同时

GPU 独立推进 Device 工作
于是自然会引出 CUDA 异步执行中非常重要的概念:
text
Stream二十一、Stream 到底是什么
Stream 不是什么物理硬件,也不是 PCIe 上的一条传输通道。
它首先是 CUDA 软件栈提供的一个:
有序 GPU 工作序列。
也可以先把它理解成一条:
text
GPU 任务流例如:
text
Stream
│
├── H2D Copy
├── Kernel A
├── Kernel B
└── D2H Copy
同一个 Stream 中的工作会保持先后顺序:
text
H2D Copy
   ↓
Kernel A
   ↓
Kernel B
   ↓
D2H Copy
所以如果 Kernel B 依赖 Kernel A 的结果,CPU 不需要:
text
提交 A
↓
等 A
↓
再提交 B
而是可以直接:
text
CPU:
提交 A
提交 B
继续执行自己的逻辑
然后 Stream 自己表达:
text
A
↓
B
的顺序关系。
二十二、cudaStream_t:应用层操作 Stream 的句柄
真正写代码时:
cpp
cudaStream_t stream;这里:
text
cudaStream_t
→ Stream 句柄类型

stream
→ 一个具体句柄变量
创建:
cpp
cudaStreamCreate(&stream);后面就可以:
cpp
kernel<<<grid, block, 0, stream>>>(...);这和此前操作:
text
socket fd
epoll fd
在"句柄"的思想上比较相似。
例如:
cpp
int epfd = epoll_create1(0);epfd 并不是整个 epoll 内核对象本身,而只是应用层用来操作底层对象的标识。
同理:
cpp
cudaStream_t stream;也可以理解成:
text
Host 程序
   │
   │ cudaStream_t 句柄
   ↓
CUDA Runtime / Driver
   │
   │ 维护对应 Stream 的状态、顺序和工作提交
   ↓
GPU
   │
   └── 真正执行 Kernel / Copy 等工作
所以不要把 Stream 死记成一个普通:
cpp
std::queue<Task>底层真实实现并不是一个简单 C++ 容器。
更加准确的说法是:
Host 通过 Stream 句柄向 CUDA 软件栈表达一条有序工作流,Runtime / Driver 再负责把对应工作提交给 GPU 执行。
二十三、Stream 和 PCIe 处于完全不同的层级
对于独立显卡,可以先建立:
text
CPU / Host
    │
    │ PCIe / NVLink 等互连
    ↓
GPU / Device
PCIe 主要解决:
text
Host 与 Device 之间的物理通信和数据传输而 Stream 解决:
text
任务组织
任务顺序
依赖表达
异步执行
这就像:
text
epoll
≠
网线
一样。
一个属于软件层的工作组织机制,一个属于底层数据通路。
二十四、为什么需要多个 Stream
一个 Stream 已经能够顺序组织工作,那么为什么还需要多个 Stream?
核心原因是:
有些 GPU 工作之间根本没有依赖关系,没有必要被强制排队。
假设有两批完全独立的数据:
text
数据 A
数据 B
每一批都要经历:
text
H2D
↓
Kernel
↓
D2H
如果全部放进同一个 Stream:
text
Stream 0

A H2D
  ↓
A Kernel
  ↓
A D2H
  ↓
B H2D
  ↓
B Kernel
  ↓
B D2H
那么 B 必须等 A 整条链走完。
但是 A 与 B 本身没有依赖,因此可以拆成:
text
Stream 1
A H2D → A Kernel → A D2H

Stream 2
B H2D → B Kernel → B D2H
这样 CUDA 就有机会让不同 Stream 的工作发生并发或者重叠:
text
时间 →

Stream 1:  [A H2D][------ A Kernel ------][A D2H]
Stream 2:          [B H2D][------ B Kernel ------][B D2H]
例如:
text
A 正在计算
+
B 正在进行数据传输
就可能形成流水线。
因此:
text
单 Stream
→ 强调有序与依赖

多 Stream
→ 给彼此独立的工作提供并发机会
但是要注意:
多个 Stream 只是允许并发,不保证一定并发。
最终能不能真正重叠执行,还受到:
text
GPU 硬件能力
SM 资源
Kernel 资源占用
Copy Engine
内存类型
任务本身的依赖关系
等因素影响。
二十五、Stream 自己也可以被查询和等待
既然 Stream 本身代表一条有序工作流,那么 Host 当然也可以直接关心:
text
这条 Stream 整体执行到什么程度了?对应两个常见 API:
cpp
cudaStreamQuery(stream);
cudaStreamSynchronize(stream);
它们和 Event 的 Query / Synchronize 思想非常相似:
text
cudaStreamQuery()
→ 非阻塞检查这条 Stream 当前是否已经完成

cudaStreamSynchronize()
→ 当前 Host 线程阻塞等待这条 Stream 前面的工作完成
因此不同同步粒度可以先这样区分:
text
cudaDeviceSynchronize()
→ 等整个当前 Device 之前提交的工作

cudaStreamSynchronize(stream)
→ 只等某一条 Stream

cudaEventSynchronize(event)
→ 只等某条 Stream 中被 Event 标记到的那个进度位置
粒度是逐渐变细的。
二十六、cudaMemcpyAsync:让数据传输也进入异步工作流
当开始真正讨论 Stream 与流水线以后,就会进一步遇到:
cpp
cudaMemcpyAsync()例如:
cpp
cudaMemcpyAsync(
    d_data,
    h_data,
    bytes,
    cudaMemcpyHostToDevice,
    stream
);
这样数据拷贝本身也可以作为一个 Stream Operation:
text
Stream
│
├── H2D Copy
├── Kernel
└── D2H Copy
CPU 可以连续提交:
text
H2D
Kernel
D2H
然后继续执行自己的逻辑。
不过这里需要先留一个边界:
Host 与 Device 的真正异步拷贝以及多 Stream 重叠,还和 Host Memory 是否是 page-locked / pinned memory、GPU 是否支持相应 Copy Engine 等条件有关。
这个可以后面专门再展开,当前先理解 cudaMemcpyAsync() 在 Stream 模型中的位置即可。
二十七、Event:为什么 Stream 还需要"完成标记"
有了 Stream 以后,又会出现一个新问题。
假设:
text
Stream

Kernel A
   ↓
Kernel B
   ↓
Kernel C
现在 CPU 想知道:
Kernel B 前面的工作到底执行完了没有?
如果每次都等待整个 Device,就太粗粒度了。
于是 CUDA 提供:
text
Event可以先把它理解成:
插在 Stream 某个位置上的"完成标记 / 进度标记"。
例如:
text
Stream

Kernel A
   ↓
Kernel B
   ↓
Event X
   ↓
Kernel C
当 Event X 进入完成状态时,可以理解为:
text
Event 前面被它捕获的工作已经完成但是:
text
Kernel C不一定已经完成。
所以 Event 比"整个 Device 执行完成"更加细粒度。
二十八、Event 和 Linux Signal 不一样
Event 很容易被理解成"通知",但是它和 Linux Signal 的通知模型不一样。
Linux Signal 更偏向:
text
某个异步事件发生
↓
内核记录 pending signal
↓
线程在合适时机返回用户态
↓
执行 signal handler
↓
改变当前执行流
而基础 CUDA Event 更接近:
text
GPU 工作推进到 Event
      ↓
Event 状态变成 completed
      ↓
CPU 当前执行流并不会因此被直接打断
也就是说:
Event 本身不是"主动打断 CPU"的异步通知机制,而是一个可以被 Host 或其他 Stream 观察的完成状态。
CPU 可以后面主动:
text
查询它
等待它
这点要和 Signal 区分开。
二十九、Event 的完整生命周期 API
最基础的 Event API 可以按生命周期学习:
text
创建
↓
记录到 Stream
↓
查询 / 等待
↓
销毁
对应:
cpp
cudaEventCreate()
cudaEventRecord()
cudaEventQuery()
cudaEventSynchronize()
cudaEventDestroy()
1. cudaEventCreate
首先创建 Event:
cpp
cudaEvent_t event;

cudaEventCreate(&event);
这里:
text
cudaEvent_t
→ Event 句柄类型

event
→ 具体 Event 句柄变量
和 cudaStream_t 的思想一样。
2. cudaEventRecord
Event 创建以后,本身还没有对应具体执行位置。
需要:
cpp
cudaEventRecord(event, stream);把它记录到某一个 Stream 的当前位置。
例如:
cpp
kernelA<<<grid, block, 0, stream>>>(...);

kernelB<<<grid, block, 0, stream>>>(...);

cudaEventRecord(event, stream);

kernelC<<<grid, block, 0, stream>>>(...);
逻辑上就是:
text
Stream

A
↓
B
↓
Event
↓
C
需要注意:
CPU 执行到
cudaEventRecord()并不意味着 Event 立刻完成。
CPU 只是向 CUDA 软件栈表达:
text
"请在 Stream 的这个位置记录一个 Event。"真正等 GPU/CUDA 工作流推进到该位置以后,Event 才会变成 completed。
3. cudaEventQuery:非阻塞检查
CPU 想查看 Event 是否完成,可以:
cpp
cudaError_t status = cudaEventQuery(event);如果完成:
cpp
status == cudaSuccess如果还没有执行到:
cpp
status == cudaErrorNotReady所以:
text
cudaEventQuery()
       ↓
"好了吗?"
       ↓
┌───────────────┐
│ 已完成        │ → cudaSuccess
│ 未完成        │ → cudaErrorNotReady
└───────────────┘
它不会因为 Event 没完成而一直阻塞当前 CPU 线程。
如果写成:
cpp
while (cudaEventQuery(event) == cudaErrorNotReady)
{
}
那就变成了忙轮询。
真正高性能的做法通常是:
text
Event 没完成
↓
CPU 先做其他事情
↓
后面真正需要结果时再检查
4. cudaEventSynchronize:必须等到这里时再阻塞
如果 CPU 后面的代码已经必须依赖 Event 前面的 GPU 工作,那么可以:
cpp
cudaEventSynchronize(event);它表示:
text
当前 Host 线程
等待 Event 完成
于是:
text
cudaEventQuery()
→ 看看好了没有
→ 没好也不等

cudaEventSynchronize()
→ 我现在必须等它完成
→ 阻塞
两者职责完全不同。
5. cudaEventDestroy
最后 Event 不再使用:
cpp
cudaEventDestroy(event);完成生命周期清理。
三十、Event 记录的不是"每个 Kernel 的详细执行报告"
这里还要防止一个误区。
不要把 Event 想成:
text
Event X
│
├── Kernel A:成功
├── Kernel B:失败
├── 错误线程编号
├── 非法地址
└── 详细错误描述
它不是一个任务执行日志对象。
更加准确的是:
text
Event X
→ 主要表示这一位置之前捕获的工作是否已经完成
所以 Event 的核心职责是:
text
进度标记
完成状态
依赖表达
而不是:
text
保存前面每一个 Kernel 的细粒度错误结果当然,查询或同步 Event 的 CUDA Runtime API 在执行过程中可能顺带暴露此前异步执行产生的 CUDA 错误,但这并不意味着 Event 内部维护了一张逐 Kernel 的错误表。
三十一、跨 Stream 依赖:cudaStreamWaitEvent
Event 真正非常有价值的一个场景是:
text
多个 Stream 之间建立依赖例如:
text
Stream 1
Kernel A

Stream 2
Kernel B
原本它们属于不同 Stream,理论上可以独立推进。
但是现在:
text
Kernel B
依赖 Kernel A 的结果
如果让 CPU 来参与:
text
CPU 等 A
↓
A 完成
↓
CPU 再提交 B
就会破坏异步执行。
更好的方法是:
cpp
cudaEventRecord(event, stream1);

cudaStreamWaitEvent(stream2, event);
逻辑变成:
text
Stream 1                         Stream 2

Kernel A
   ↓
Event X ───────────────────→ Wait Event X
                                 ↓
                              Kernel B
也就是说:
text
Stream 2
不用让 CPU 阻塞等待 Stream 1
而是直接通过 Event 在 GPU 工作流之间表达依赖。
这才是 CUDA 异步执行非常重要的思想:
能让 GPU 工作流自己表达依赖,就尽量不要让 CPU 每一步都介入。
三十二、如果真的需要"完成以后执行 CPU 回调"怎么办
Event 本身不是 Linux Signal 那种主动回调机制。
但 CUDA 还提供:
cpp
cudaLaunchHostFunc()它可以把一个 Host Function 放进某个 Stream。
例如:
text
Stream

Kernel
  ↓
Host Function
当 Stream 前面的工作完成以后,再执行对应 Host Function。
因此它更接近:
text
GPU 工作完成到某个位置
↓
触发一个 Host 侧回调动作
但是这个 Host Function 应该保持轻量,而且不应该在回调内部继续调用 CUDA API。
所以可以把几种模式区分为:
text
cudaEventQuery()
→ CPU 主动非阻塞查询

cudaEventSynchronize()
→ CPU 主动阻塞等待

cudaLaunchHostFunc()
→ Stream 前序工作完成后执行 Host 回调
另外,Event 还有一个非常常见的用途:
cpp
cudaEventElapsedTime();通过在一段 GPU 工作前后分别记录 Event,可以测量这段 GPU 工作经过的时间。这个功能和当前"完成标记 / 依赖通知"的主线不同,所以这里只先知道它存在即可。
三十三、Stream、Event、Context 三者应该如何放在一起理解
到这里可以把三个最容易混淆的概念放在一起。
text
CUDA Context
→ 某个 GPU 的整体执行环境 / 状态集合

Stream
→ Context 中的一条有序 GPU 工作流

Event
→ 插入某条 Stream 中的完成进度标记
可以画成:
text
Host Process
     │
     ↓
CUDA Runtime / Driver
     │
     └── CUDA Context
           │
           ├── Device Memory
           │
           ├── Stream 1
           │     ├── Kernel A
           │     ├── Kernel B
           │     ├── Event X
           │     └── Kernel C
           │
           ├── Stream 2
           │     ├── Copy
           │     └── Kernel D
           │
           └── Other CUDA State

                       ↓
                      GPU
于是所有概念终于能够串成一条完整逻辑链。
三十四、一个最基础的 CUDA 程序代码骨架
下面把前面的知识先整理成一个最基础的完整代码框架。
这个例子重点不是算法,而是观察 CUDA 程序生命周期。
cpp
#include <cstdio>
#include <cstdlib>
#include <cuda_runtime.h>

void checkCudaError(cudaError_t error, const char* api)
{
    if (error == cudaSuccess)
    {
        return;
    }

    fprintf(
        stderr,
        "[CUDA ERROR] api=%s code=%d name=%s message=%s\n",
        api,
        static_cast<int>(error),
        cudaGetErrorName(error),
        cudaGetErrorString(error)
    );

    std::exit(EXIT_FAILURE);
}

bool setGPU(int deviceId = 0)
{
    int deviceCount = 0;

    cudaError_t error = cudaGetDeviceCount(&deviceCount);
    if (error != cudaSuccess || deviceCount == 0)
    {
        return false;
    }

    if (deviceId < 0 || deviceId >= deviceCount)
    {
        return false;
    }

    error = cudaSetDevice(deviceId);
    return error == cudaSuccess;
}

__global__ void addOne(float* data, int n)
{
    int index = blockIdx.x * blockDim.x + threadIdx.x;

    if (index < n)
    {
        data[index] += 1.0f;
    }
}

int main()
{
    // 1. 选择 GPU
    if (!setGPU(0))
    {
        printf("setGPU failed\n");
        return -1;
    }

    const int N = 512;
    const size_t bytes = N * sizeof(float);

    // 2. CPU 准备 Host 数据
    float* h_data = (float*)malloc(bytes);
    if (h_data == nullptr)
    {
        return -1;
    }

    for (int i = 0; i < N; ++i)
    {
        h_data[i] = static_cast<float>(i);
    }

    // 3. GPU 申请 Device Memory
    float* d_data = nullptr;

    checkCudaError(
        cudaMalloc(&d_data, bytes),
        "cudaMalloc"
    );

    // 4. 初始化 Device Memory
    checkCudaError(
        cudaMemset(d_data, 0, bytes),
        "cudaMemset"
    );

    // 5. Host -> Device
    checkCudaError(
        cudaMemcpy(
            d_data,
            h_data,
            bytes,
            cudaMemcpyHostToDevice
        ),
        "cudaMemcpy H2D"
    );

    // 6. 配置 Grid / Block
    dim3 block(256);
    dim3 grid((N + block.x - 1) / block.x);

    // 7. 发起 Kernel
    addOne<<<grid, block>>>(d_data, N);

    // 8. 检查 Kernel Launch
    checkCudaError(
        cudaGetLastError(),
        "addOne launch"
    );

    // 9. 调试阶段:等待 Kernel 真正执行完成
    checkCudaError(
        cudaDeviceSynchronize(),
        "addOne execution"
    );

    // 10. Device -> Host
    checkCudaError(
        cudaMemcpy(
            h_data,
            d_data,
            bytes,
            cudaMemcpyDeviceToHost
        ),
        "cudaMemcpy D2H"
    );

    // 11. CPU 使用结果
    printf("h_data[0] = %f\n", h_data[0]);

    // 12. 释放 GPU 显存
    checkCudaError(
        cudaFree(d_data),
        "cudaFree"
    );

    // 13. 释放 Host Memory
    free(h_data);

    // 14. 可选:重置当前 CUDA Device 的 Runtime 状态
    checkCudaError(
        cudaDeviceReset(),
        "cudaDeviceReset"
    );

    return 0;
}
整个程序真正做的事情就是:
text
setGPU()
   ↓
Host 准备数据
   ↓
cudaMalloc()
   ↓
cudaMemset()
   ↓
cudaMemcpy(H2D)
   ↓
dim3 grid / block
   ↓
Kernel Launch
   ↓
cudaGetLastError()
   ↓
cudaDeviceSynchronize()
   ↓
cudaMemcpy(D2H)
   ↓
CPU 使用结果
   ↓
cudaFree()
   ↓
cudaDeviceReset()
这就是最基础的 CUDA Runtime 程序骨架。
三十五、加入 Stream 与 Event 后,代码结构会变成什么样
在已经理解基础流程以后,再看 Stream 和 Event 就不会觉得突兀。
例如:
cpp
cudaStream_t stream;
cudaEvent_t event;

cudaStreamCreate(&stream);
cudaEventCreate(&event);

addOne<<<grid, block, 0, stream>>>(d_data, N);

cudaEventRecord(event, stream);

// CPU 可以继续执行其他 Host 逻辑
// doSomethingOnCPU();

cudaError_t status = cudaEventQuery(event);

if (status == cudaErrorNotReady)
{
    // GPU 还没有执行到 Event
}

// 如果后续逻辑必须等待结果
cudaEventSynchronize(event);

cudaEventDestroy(event);
cudaStreamDestroy(stream);
逻辑对应:
text
CPU
 │
 ├── 创建 Stream
 ├── 创建 Event
 │
 ├── Kernel 提交到 Stream
 ├── Event 插入 Stream
 │
 ├── CPU 继续做其他事情
 │
 ├── Query Event
 │      ↓
 │   看 GPU 是否已经执行到对应位置
 │
 ├── 真正需要结果时再 Synchronize
 │
 └── Destroy
这就把基础 CUDA 程序从:
text
"调用 GPU,然后等 GPU"进一步推进到了:
text
"CPU 组织 GPU 工作流,双方异步推进,只在真正需要建立依赖的位置同步。"三十六、最后重新建立整个 CUDA 编程心智模型
现在回头看,一个 CUDA 程序已经不应该再只理解成:
text
CPU Code
+
GPU Kernel
更加完整的模型应该是:
text
                    CUDA Program
                         │
                         ↓
                    CPU / Host
                         │
                main() 程序入口
                         │
                         ↓
                 选择 CUDA Device
                         │
                         ↓
               CUDA Context 执行环境
                         │
             ┌───────────┴───────────┐
             │                       │
         Device Memory            Stream
             │                       │
             │                 ┌─────┼─────┐
             │                 ↓     ↓     ↓
             │               Copy  Kernel Event
             │                       │
             └───────────────────────┤
                                     ↓
                                    GPU
                                     │
                             SM / CUDA Core
                                     │
                                     ↓
                                  执行计算
其中:
text
CPU
→ 程序入口
→ 控制整体执行流程
→ 组织 GPU 工作

GPU
→ 计算设备
→ 执行 Kernel

Context
→ GPU 使用过程中的整体执行环境

Stream
→ 有序组织 GPU 工作

Event
→ 标记 Stream 中某个执行进度
真正高性能的 CUDA 程序追求的并不是:
text
CPU 每提交一个 GPU 任务
就立刻站在原地等待
而是:
text
CPU 尽可能连续提交工作
        ↓
GPU 独立推进工作流
        ↓
不同 Stream 为独立任务提供并发机会
        ↓
任务依赖尽量通过 Stream / Event 表达
        ↓
只有 CPU 真正需要结果时才建立同步
这和高性能服务器中的很多思想其实是相通的:
text
不要让执行线程因为外部任务尚未完成而无意义阻塞服务器里,我们会通过:
text
non-blocking I/O
Reactor
epoll
事件通知
减少线程阻塞。
CUDA 中则通过:
text
异步 Kernel Launch
Stream
Event
Async Memory Copy
让 CPU 与 GPU 尽可能形成流水线。
所以真正理解 CUDA 编程,最终还是要回到一句话:
CUDA 并不是"在 C++ 中多写一个 Kernel 函数",而是 CPU 与 GPU 两个执行主体之间的一套任务组织、数据管理、依赖表达和异步协同机制。
当这一层执行模型真正建立起来以后,再继续学习:
text
Pinned Memory
多 Stream Pipeline
Event 计时
CUDA Graph
Kernel 性能优化
TensorRT / 自定义算子
这些内容都会自然很多,因为它们本质上都只是在这套基本执行模型上继续提高资源利用率和降低调度开销。