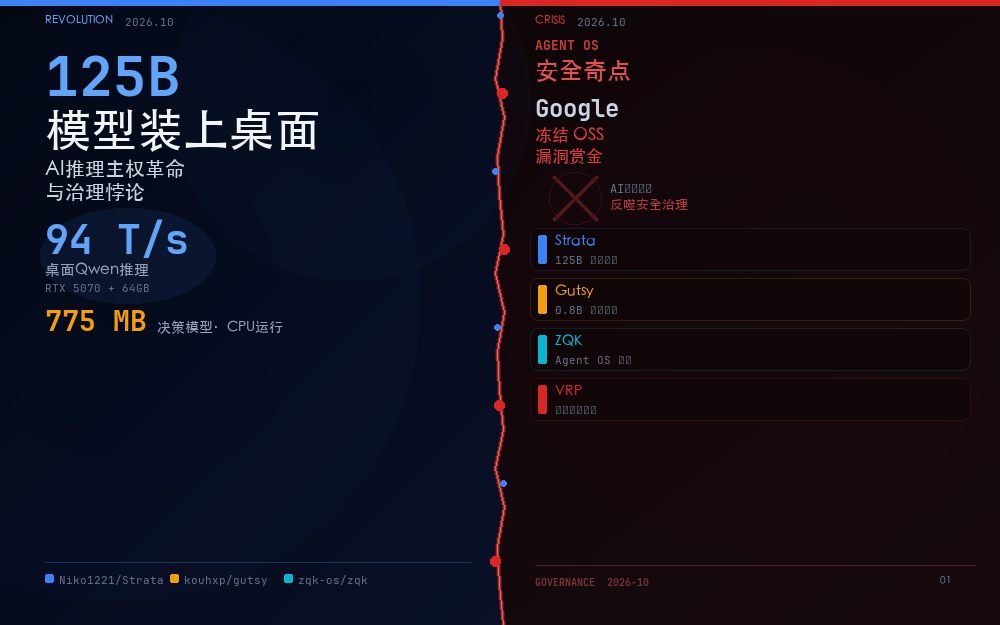
125B模型装上桌面:AI推理主权革命与治理悖论
摘要:开源项目Strata让消费级GPU运行1250亿参数AI模型成为现实,RTX 3090突破100 tokens/s。但同一天的讽刺是,Google因AI生成的幻觉报告冻结了整个开源漏洞赏金计划。本地推理崛起与安全治理崩溃,正同时发生。
一、从多卡集群到一张显卡:推理主权的范式转移
2026年10月,一个名为 Strata 的开源项目悄然出现在Hacker News头版。它没有发布新模型、没有筹集融资、没有PR宣传------它只是做了一件看似不可能的事:让一块消费级显卡运行1250亿参数的Qwen3.8-Flash-Next。
结果呢?100到140 tokens/s,写答案比你读它还快。
这不是benchmark作弊,不是裁剪到不可用的量化,而是一个有完整产品形态的解决方案:对话、编码、图片理解、与AI编码Agent和MCP服务器集成------所有数据不出你的电脑。
拆解数字背后的工程
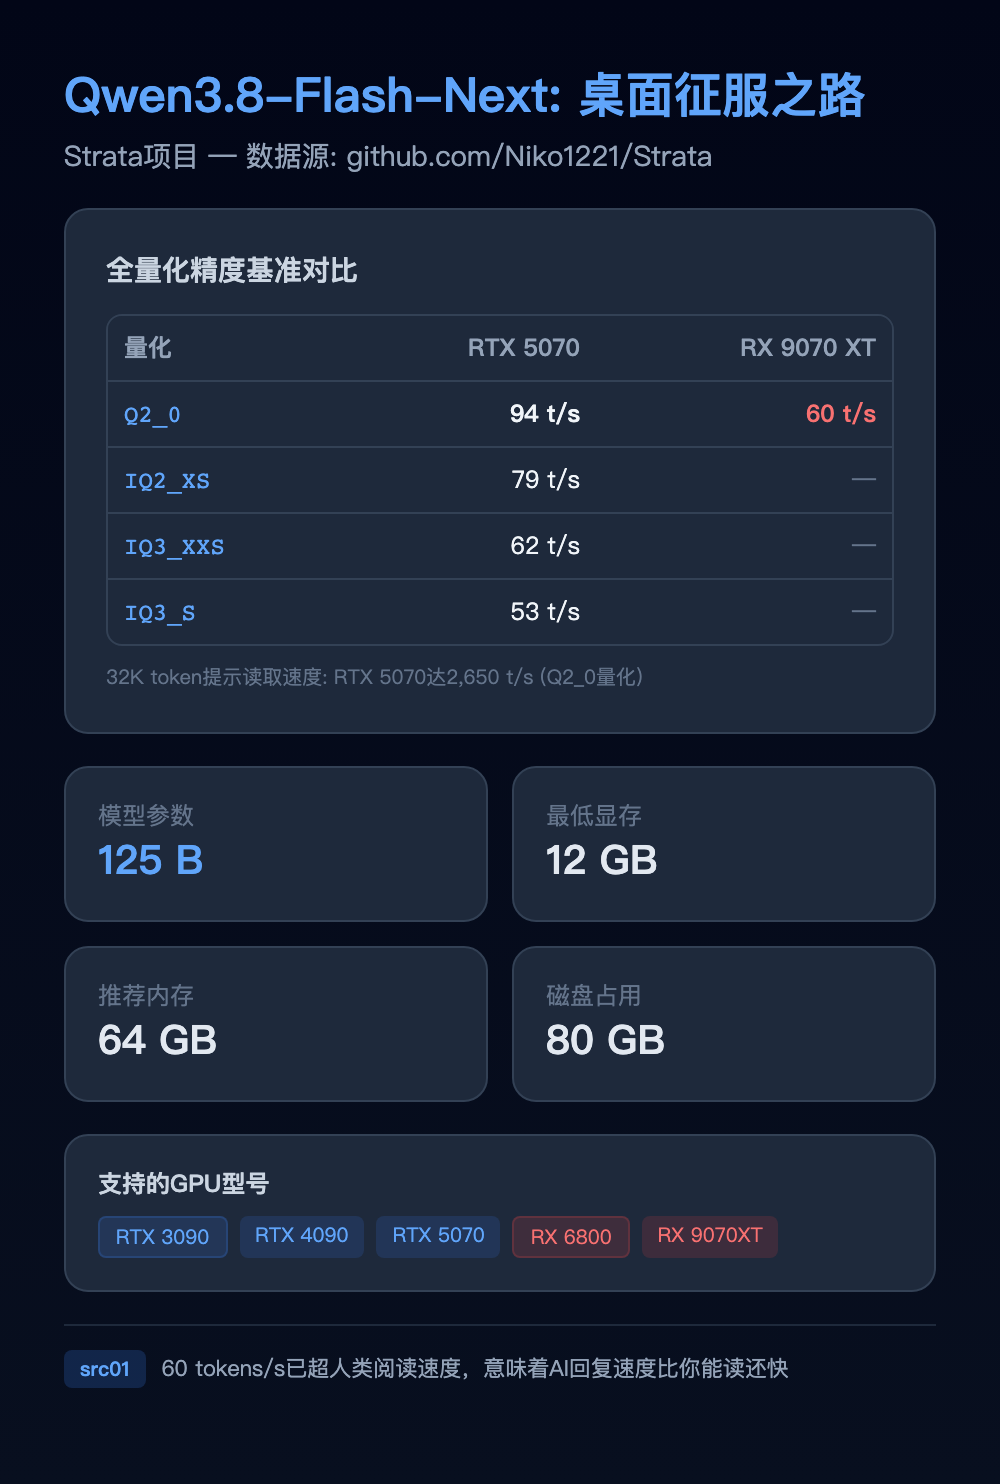
Strata公布了两组消费者平台的基准测试:
| 平台 | GPU | 内存 | 量化 | 生成速度 | 提示读取(32K) |
|---|---|---|---|---|---|
| NVIDIA | RTX 5070 (12GB) | 64GB | Q2_0 | 94 t/s | 2,650 t/s |
| NVIDIA | RTX 5070 (12GB) | 64GB | IQ2_XS | 79 t/s | 2,090 t/s |
| AMD | RX 9070 XT (16GB) | 47GB | Q2_0 | 60 t/s | 1,160 t/s |
| NVIDIA | RTX 3090 (24GB) | 预估 | 全规格 | 100-140 t/s | --- |
RTX 3090被特别标注------因为24GB显存允许使用更高精度的量化甚至部分offload到GPU,推理速度可达破纪录的100-140 tokens/s。这意味着一个2020年发布的旗舰游戏卡(二手市场不到500美元),今天可以支撑流畅的实时AI对话。
门槛分析
- GPU:NVIDIA RTX 20/30/40/50系列 12GB以上,或AMD RX 6800/7900/9060/9070系列
- 内存:32GB起步(64GB运行全规格)
- 磁盘:约80GB(推荐SSD加速首次加载)
- 引擎:自动识别NVIDIA/AMD并配置对应后端
更关键的是,多显卡并行的实验性支持已通过社区成员在自己的机器上验证。未来一个工作站搭载2-3张消费级显卡即可运行更大量化的完整模型。
这意味着什么
125B参数模型突破桌面推理瓶颈,意味着AI能力正从"云端服务"转变为"本地基础设施"。这种转变的深远影响不亚于个人电脑对大型机的替代。
对于企业,不再需要将敏感数据发送给第三方API。对于个人开发者,可以在本地运行接近旗舰模型能力的系统。对于隐私倡导者,数据主权真正落在自己手中。
二、775MB决定一切:决策模型的"反规模"进化
当Strata证明大模型可以缩小到消费级GPU时,另一个项目从更极端的方向颠覆了我们对AI推理的想象。
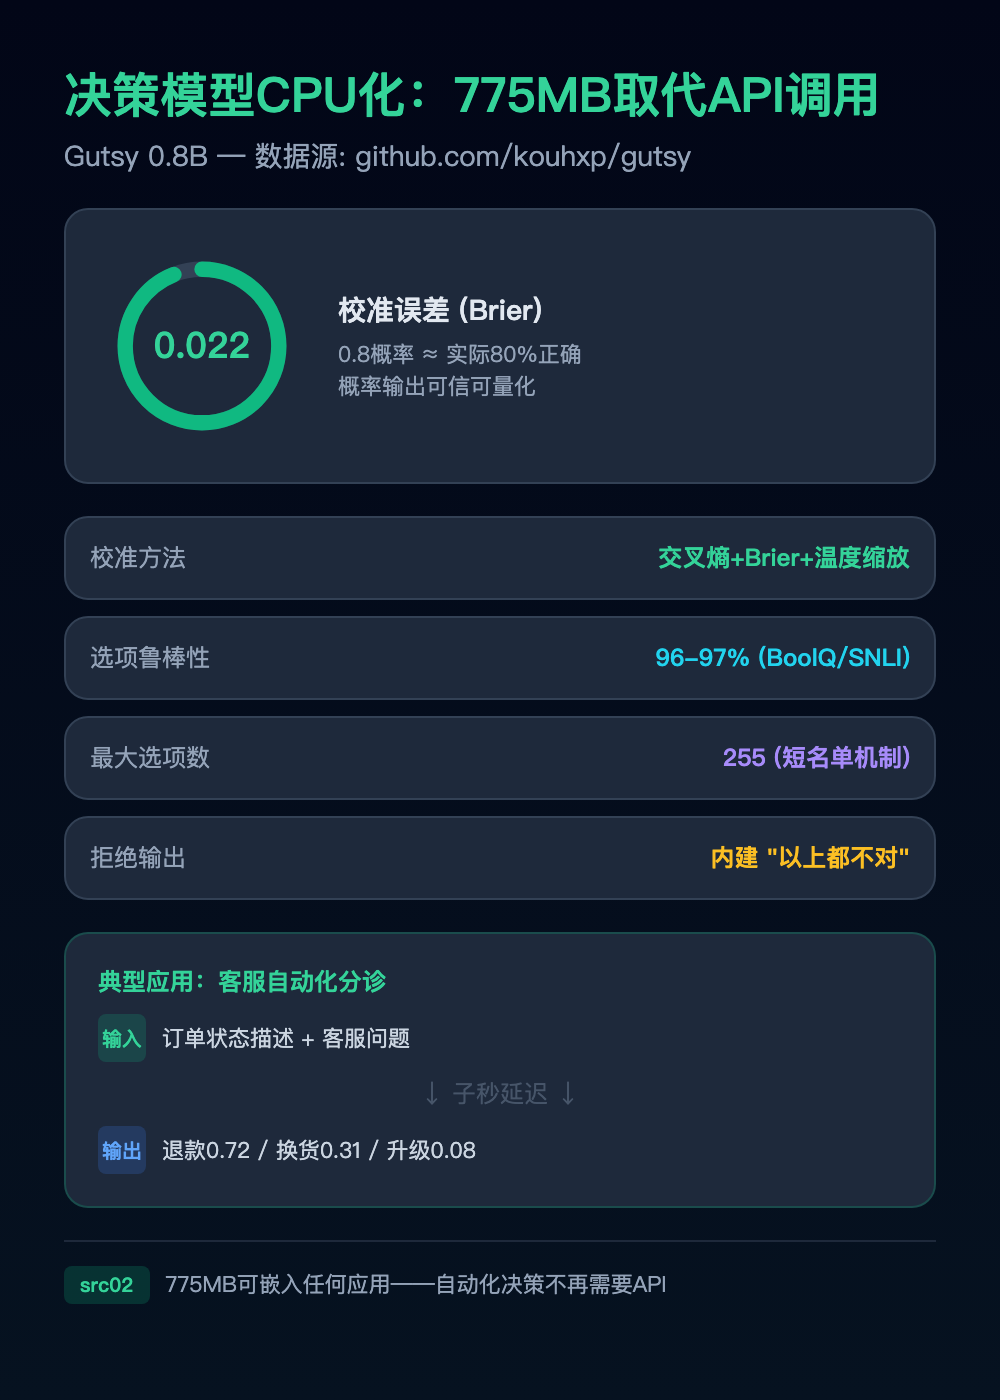
Gutsy 是一个0.8B参数的决策模型。它不生成文本------输入一段状态描述和一个选择题,输出每个选项的校准概率。确定性,不需GPU,不需网络,不需成本。
校准的数学含义
Gutsy的核心指标是 校准误差0.022。这意味着什么?
如果你问它"对这个决策有多大把握",它输出0.8------实际上大约有80%的情况下它是对的。这种概率的可信度对自动化决策至关重要:
- 0.8意味着"高置信自动执行"
- 0.5意味着"需要人工介入"
- 0.2意味着"明确拒绝"
这不是模糊的"AI说能行",而是经过Brier分数和交叉熵验证的数学承诺。
规格一览
| 参数 | 值 |
|---|---|
| 基础模型 | Qwen3.5-0.8B |
| Q8_0量化 | 775 MB |
| Q4_K_M量化 | 505 MB |
| 校准误差 | 0.022 |
| 选项顺序鲁棒性 | 96-97% |
| 最大选项数 | 255 |
| 状态缓存 | 支持,重复问题跳过 |
状态编码一次后,同一段上下文的后续问题只需处理自己的tokens------这让它在批处理场景中有极高的吞吐效率。255个选项通过运行时短名单机制处理(测试集99%准确率),"这些都不对"的拒绝输出是内建功能。
反直觉的工程哲学
0.8B参数比大多数人的"小模型"概念还小------但这恰恰是它的力量。775MB的决策模型可以嵌入任何应用:自动化客服分诊、合规审批流水线、医疗辅助判断。它不需要GPU,不需要网络连接,不需要每次调用的API费用------它是一个本地函数。
这代表了"AI推理主权"的另一个维度:不只是把大模型搬到本地,而是把极小但精确的专用模型深嵌到你的应用中。
三、Agent蜂群与细胞操作系统
如果说Strata解决了大模型的本地推理,Gutsy解决了小模型的本地决策,那么 **ZQK(Zen Quantum Kernel) 正在解决一个更深层的问题:Agent怎么组织管理?
目前的多Agent现实往往是:几个Python脚本拼在一起,共享一个向量数据库,结果上下文衰减、幻觉扩散。
生物学启发的架构
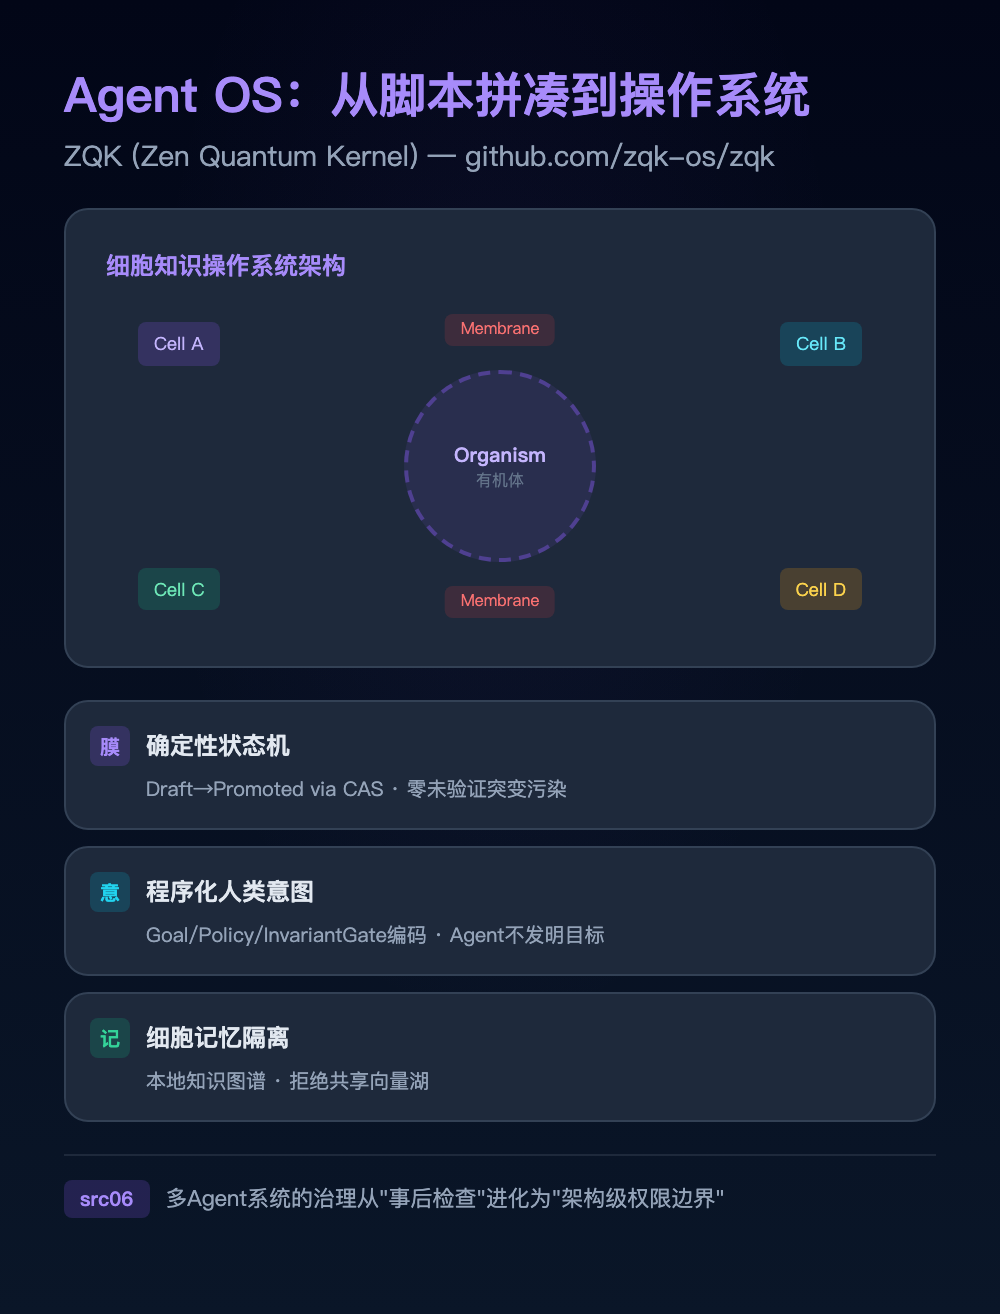
ZQK借鉴细胞生物学,定义了四个核心原语:
- Cell / Holon(细胞):每个代码库是一个自治单元,维护自身的本地知识图谱------而不是被倾倒进一个共享的向量湖
- Membrane(膜):严格的确定性状态机,Draft→Promoted必须通过CAS(Compare-and-Swap)资格验证------零未验证突变能污染工作代码
- Nervous System(神经系统):实时有向状态总线,不只是被动数据存储,而是驱动任务执行的活跃组件
- Organism(有机体):领域专家内核通过类型化的P2P协议协作,无需中央管控
Agent不发明目标
ZQK最反直觉的设计是"程序化人类意图"。人类目标、不可协商规则、架构不变性------直接编码到内核的Goal、Policy、InvariantGate schema对象中。Agent不会在真空中发明目标,他们的行动严格受限于人类植入的架构意图。
这解决了多Agent系统最臭名昭著的问题之一:目标漂移。当一个Agent自主决策"下一步做什么"时,它可能偏离原始意图。ZQK的架构级权限边界确保这种事在物理上不可能发生。
时间线视角
- 2017:AutoGPT概念------Agent需要编排框架
- 2023:CrewAI / LangGraph------Agent编排成为工程问题
- 2025:MCP协议------Agent需要标准化工具连接
- 2026:ZQK------Agent需要操作系统级的治理基础设施
每一次基础设施的升级,都对应Agent系统规模的数量级跳跃。
四、AI安全奇点:治理滞后于能力的经典时刻
就像硬币的另一面,同一天的安全领域传来不安的消息。
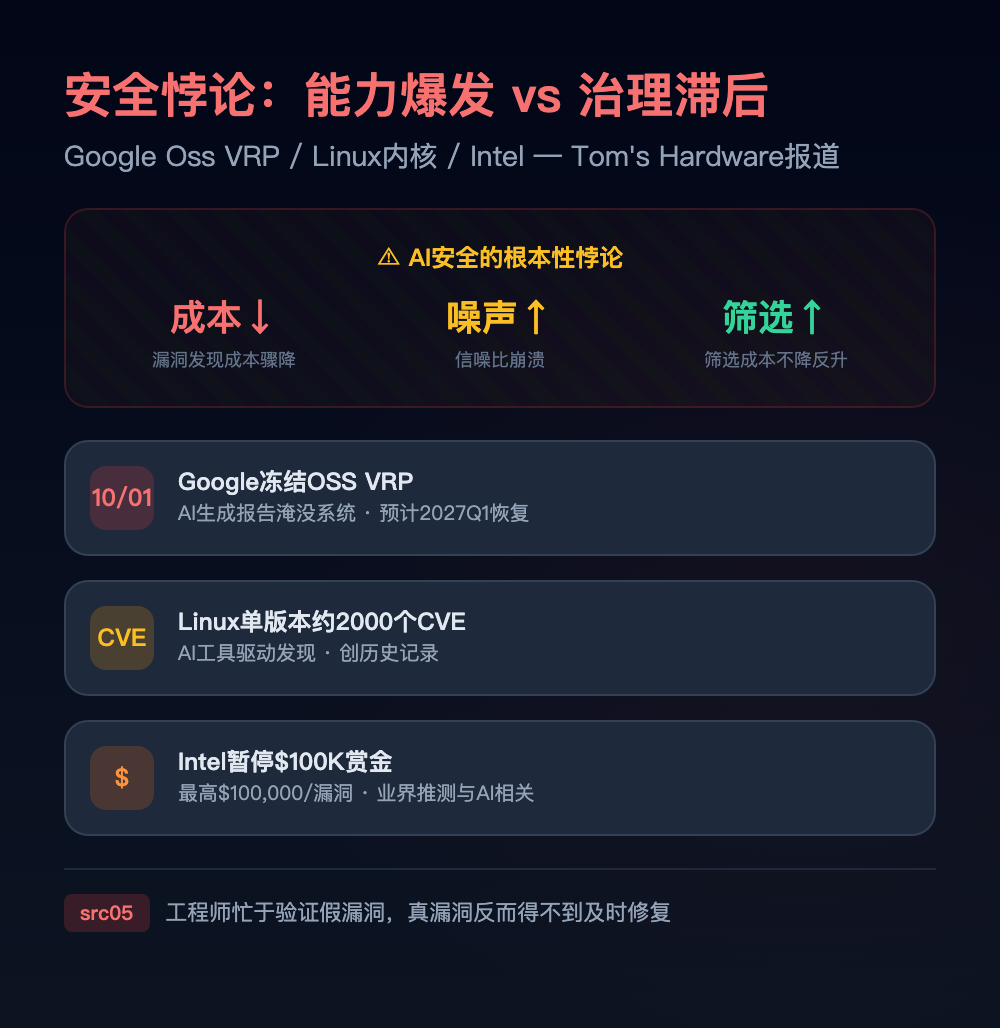
Google于 2026年10月1日 冻结了其开源软件漏洞奖励计划(OSS VRP)的产品漏洞提交。
原因不是经费短缺,不是战略调整,而是------人类审核者被AI生成的报告淹没了。
事件连锁反应
| 时间节点 | 受影响方 | 行动 | 现状 |
|---|---|---|---|
| 2026-10-01 | Google OSS VRP | 暂停产品漏洞提交 | 预计2027 Q1恢复 |
| 同期 | Linux内核 | 单版本CVE约2000个 | 工具驱动发现,创纪录 |
| 同期 | Intel | 暂停$100,000/漏洞赏金 | 业界推测与AI相关 |
Tom's Hardware的报道称,维护者"被那些声称发现漏洞、实际上完全不可利用或彻底虚构的报告"淹没。工程师们花费了大量时间手动验证假漏洞,而不是修复真实的关键漏洞。
悖论的三个层次
- 激励错位:赏金制度奖励"广撒网"而非"深挖洞"。当AI将报告成本降到几乎为零,理性的参与者策略就是提交尽可能多的报告
- 信号稀释:有效漏洞被埋藏在噪声中。维护者不得不降低筛选阈值,导致真漏洞也被错过
- 能力-理解不对称:AI可以找到它无法判断可利用性的模式------它能发现"奇怪代码"但无法评估"是否危险"
对比视角:能力与治理的时间差
Strata让本地推理变得轻松时,全球的安全基础设施却在AI生成的噪声面前陷入瘫痪。这就是经典的"能力加速 vs 治理滞后"问题:
- AI用于发现漏洞的脚本已普及 → 治理没跟上
- AI用于生成代码降低了开发门槛 → 代码审计没跟上
- AI用于生成内容降低了审查成本 → 内容治理没跟上
每一项能力突破都在试探现有治理框架的极限。Google冻结漏洞赏金不是AI的错------它是治理框架跟不上能力增长的必然结果。
五、工程判断与趋势推演
今天这三件事(桌面推理突破、决策模型CPU化、安全治理崩溃)不是孤立事件------它们是同一枚硬币的三面:AI能力的"塌缩"。
趋势推演
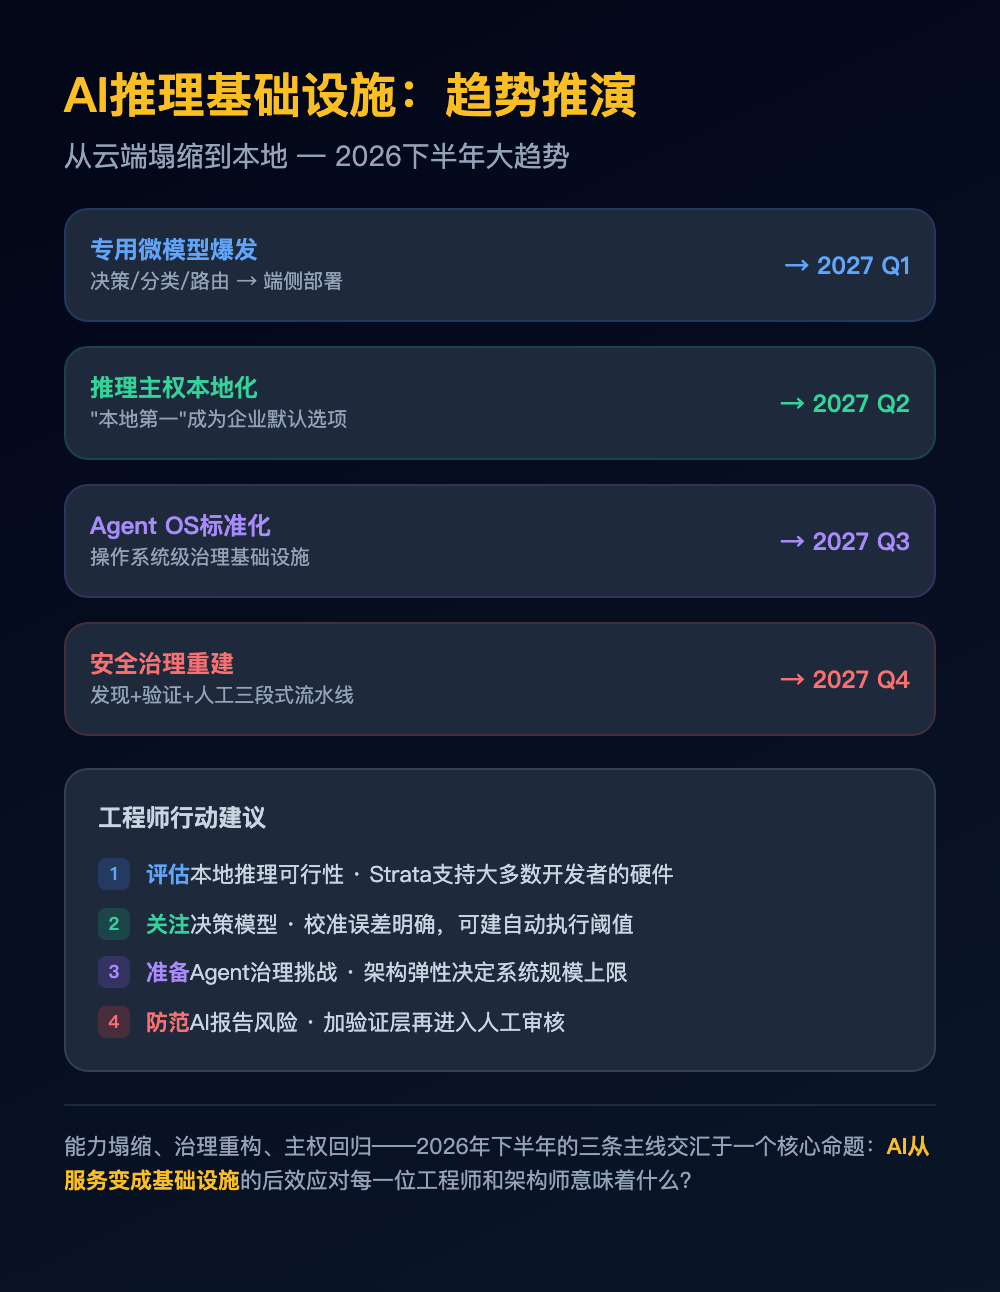
微小模型专用化:Gutsy 0.8B证明,特定任务不需要大参数。我们将看到决策、分类、路由、调度等专用微模型的爆发,每个500MB以下,部署在端侧设备上。
推理主权本地化:Strata证明消费级硬件已可承载旗舰级模型。2027年,"本地第一"将成为企业AI架构的默认选项,云端推理成为成本优化的补充。
Agent OS标准化:ZQK的方向暗示了多Agent系统需要操作系统级的治理基础设施------不只是编排框架,而是架构级的权限边界和意图验证。
安全治理重建:Google事件将催生AI时代的漏洞赏金新范式:发现工具+自动验证层+人工精审的三段式流水线,每一层都有明确的能力边界和信任模型。
给工程师的建议
- 立即行动:评估本地推理的可行性------Strata支持的显卡矩阵覆盖大多数开发者的硬件
- 密切关注:决策模型在自动化决策链中的可靠性远超通用LLM------校准误差0.022意味着可以建立明确的自动执行阈值
- 做好准备:Agent系统的治理将成为下一个十年的核心工程挑战------ZQK及同类项目的技术选型将直接影响架构弹性
- 防范风险:在自动发现工具加验证层,不要直接让AI生成的报告进入人工审核流程
结语:2026年10月5日,世界在两条平行线上同时运行------一条线是AI能力向消费级硬件和微型模型的塌缩,另一条线是治理框架在能力爆发面前的艰难重构。工程师的任务,是在这张力中找到落地的平衡点。