摘要 :本文解读 ICLR 2025 论文 SCoRe,它用两阶段多轮强化学习训练语言模型进行内生自我纠错。文章先厘清"测试时不给对错反馈"的信息条件,再用"错改对"与"对改错"两个转移量说明纠错收益的度量;随后分析监督微调为何难以教会纠错(分布偏移与行为坍塌),并拆解 SCoRe 两阶段训练与分轮奖励设计,指出"把纠错奖金乘到整条对话"是常见实现误区。主实验显示 SCoRe 在 MATH500 净提升 4.4 pp、HumanEval 净提升 12.2 pp,消融与更长推理实验则给出方法边界。检查模型是否真正学会纠错,应同时看两个方向的转移,而不是数它改了多少次。
"检查一下刚才的答案,如果有错就改正。"
这句提示很合理,却可能产生两种相反结果:模型发现一个遗漏条件,修好了答案;或者它原本已经答对,因为被要求检查,反而改成了错答案。
因此,自我纠错不能只看模型是否修改,也不能只看第二次答案有多好。我们需要知道:它修好了多少错误,又破坏了多少正确答案。
ICLR 2025 论文 Training Language Models to Self-Correct via Reinforcement Learning 提出 SCoRe,用两阶段多轮强化学习训练这种能力。它面对的条件尤其严格:测试时,模型看不到判题器给出的对错反馈,需要自己判断是否修改。
本文依据指定会议版,核对主体实验和附录中关于奖励分配、三轮扩展、更多次尝试及开放模型的结果。本文没有训练 Gemini 或复现模型效果。1
先把"自我纠错"的信息条件说清楚
SCoRe 的主设置是 intrinsic self-correction,即内生纠错。第一次生成答案后,同一个模型看到问题、自己的答案和一条检查提示,再生成第二次答案。
测试期间,提示不告诉它"你刚才答错了",也不给标准解、错误定位、执行测试的失败日志或另一位老师的批改意见。模型必须自行决定有没有错,若有错该改哪里。
训练期间则不同。作者假设能使用一个正确性判定器:数学答案可与参考答案比较,程序可用测试检查。这个判定器把模型自己的输出转换成二元奖励。训练轨迹由模型生成,不等于训练完全不需要外部标准。
这与 Reflexion 的部分实验有明确差别:Reflexion 可以根据环境失败信号或内部测试结果写反思,再尝试下一次;SCoRe 的主评测不把这样的对错信息交给模型。2
Agent-R 也不能直接放到同一排行榜里。它针对交互环境,利用树搜索和终局奖励构造纠正数据,再做监督微调(SFT);SCoRe 主要研究数学与代码的多次回答,并更新 RL 策略。对象和反馈条件都不同。3
两个转移,决定纠错到底有没有收益
设 N 道题各有第一次和第二次作答。第一轮正确率记为 A₁,第二轮记为 A₂。把"第一轮错、第二轮对"的题数除以 N,得到 p_i→c;把"第一轮对、第二轮错"的题数除以 N,得到 p_c→i。
于是有:
Δ = A₂−A₁ = p_i→c−p_c→i
这两项的分母都是全部题目 N,并不是第一轮错误题或正确题的数量。
举一个实际可计算的例子。原论文 SCoRe 的 MATH500 结果中,首次正确率 60.0%,第二次 64.4%,错改对为 5.8%,对改错为 1.4%。对应 500 道题,是先答对 300 题,修好 29 题,又改坏 7 题,最终答对 322 题。
如果你问"已有错误中修好了多少",分母应该是第一次错的 200 题,结果是 29/200=14.5%。不能把原表的 5.8% 写成"错误修复率只有 5.8%"。本文的换算依据原表显示值,计算文件随素材包提供。
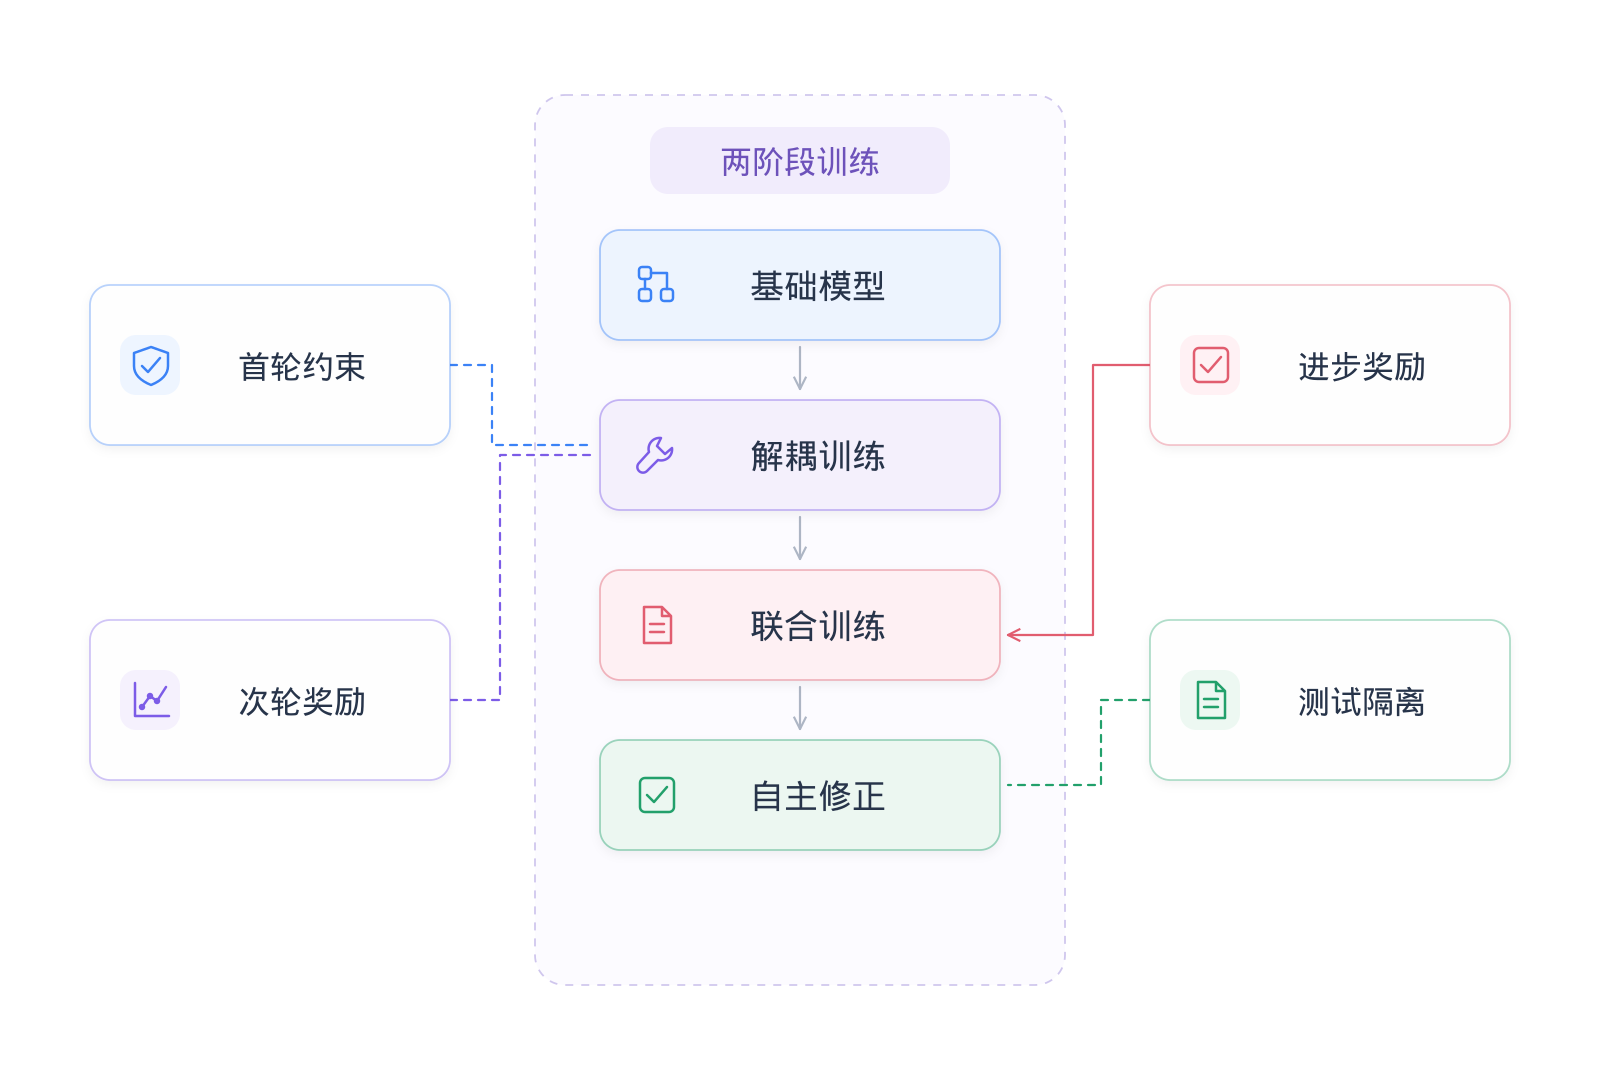
图 1|评价纠错行为时,两种方向需要一起保留。共同分母让差值对应净准确率变化;如果另外报告条件修复率,则必须重新声明分母。图为本文依据原指标定义整理的原创示意。1, §3
修改得多并不一定好。完全不修改,两个转移都为零;无差别大改,也可能让错误与损害一起增加。需要学习的是根据问题和原答案选择合适的修正。
为什么成功修正样本,也可能没有教会纠错
论文先考察自生成数据上的监督训练。
STaR 型做法从模型采样中保留成功修正的轨迹,再进行训练;Pair-SFT 则把错误答案和正确答案组织成修正对,让同一个模型学习第二次回答。论文还测试额外加入"正确到正确"样本的版本,尝试减少把对答案改错的行为。
但在 Gemini 1.5 Flash 的 MATH 实验中,Pair-SFT 的首次与第二次准确率为 52.4% 和 54.2%,净收益仅 1.8 个百分点。进一步加入"正确到正确"数据后,一种 Pair-SFT 变体两次都是 55.0%,两个方向的转移都为零。1, §4及表1
作者从中分析出两种不同问题。
分布偏移:收集训练数据的旧模型,会产生一种错误;更新后的模型,又会产生另一种错误。一个修正器在旧答案上表现更好,不表示面对当前模型的新答案也会更好。论文比较固定初答与当前模型自生成初答,观察到后一种纠错能力退化。
行为坍塌:学习者找到一种容易优化的模式,例如尽量第一次答对,第二次只做小改动。最终答案概率可以提高,但模型没有真正学会根据错误历史实施修正。加入大量"正确到正确"样本,还可能把它进一步推向不修改。
因此,论文的结论不是"恢复 SFT 永远无效"。它检验的是这些自生成数据、这些监督变体和特定模型任务;不能抹掉强教师标注、不同数据构造或交互恢复任务的可能收益。这里需要保留的是:让数据跟上当前策略,仍不能单独解决不愿纠错的行为模式。
在线 RL,还需要解决为什么它愿意修改
在线采样可以让第一轮答案来自当前模型,减少"只会修旧模型错误"的问题。但作者发现,直接优化多轮表现,仍可能把两轮答案耦合成相似的输出。
原因在于,训练题上至少有两条看起来都能获得高分的路线:第一轮已经给出好答案,第二轮基本保留;或者第一轮有错,第二轮真正纠正。只奖励最终正确,未必能让模型学到第二种行为,并将它推广到新题。1, §5
SCoRe 把训练拆成两阶段。第一阶段先获得一个愿意且能够利用前次答案修正的初始化;第二阶段再同时优化两轮表现,并明确奖励正确性上的进步。
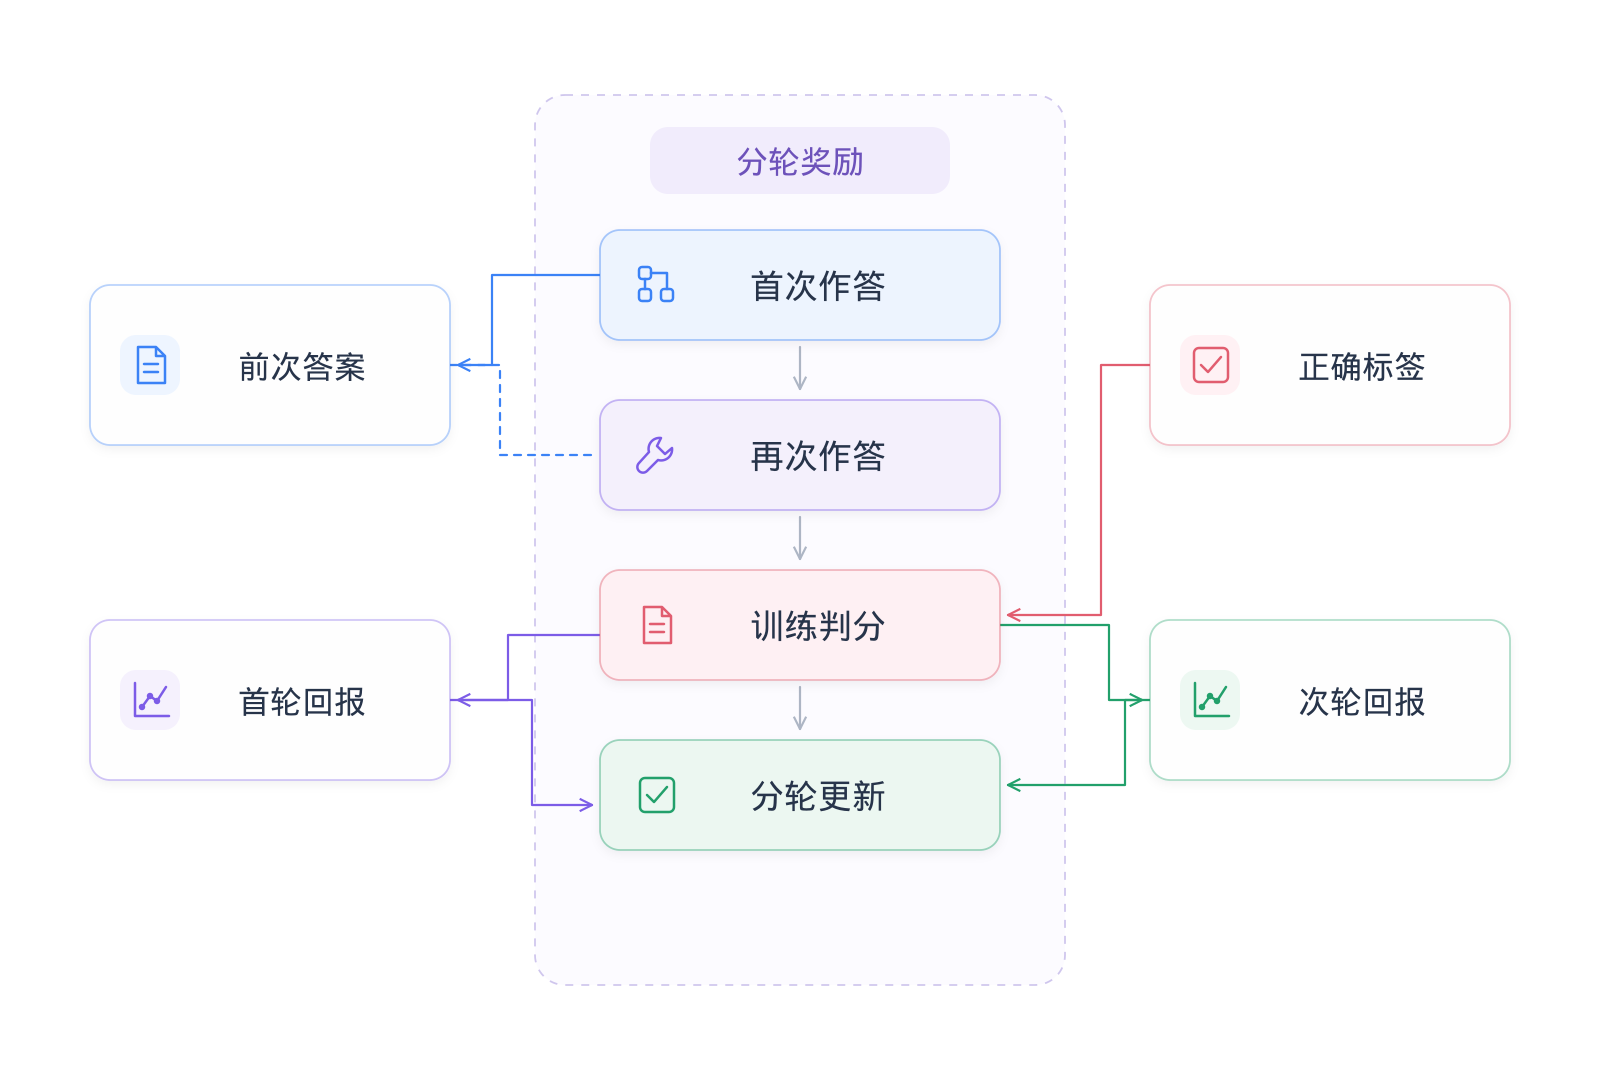
图 2|训练阶段与测试阶段的边界。首轮约束主要用于第一阶段初始化,第二阶段加入进步奖励;测试时不给模型训练判分结果。图中"自主修正"不表示测试始终成功,只表示该信息条件。根据第 5 节重绘。
第一阶段:保留基础模型的初答分布,训练第二次回答
作者在第一轮引入较强的 Kullback--Leibler 散度(KL)约束,使学习者的初答分布保持接近基础参考模型。同时,训练第二轮提高正确性奖励。
这个约束不是把第一轮硬冻结,也不是把旧答案直接替换成老师答案。它通过惩罚分布漂移,保留基础模型原有的错误与状态覆盖,让第二轮有机会学到针对这些答案的修正。
原文还保留较弱的默认 KL 正则。若只看简化公式,不能认为第二轮完全没有正则。1, §5.1
第二阶段:同时提高首答和改答,奖励正确性进步
第二阶段从上述初始化出发,同时训练两次回答。设 r₁、r₂ 是两轮各自的正确性奖励,取值为 0 或 1。第二轮的奖励改成:
r₂′ = r₂ + α(r₂−r₁)
α 是正系数,原论文实验中取 10。奖励比较的是正确性变化,不是改了多少字,也不是是否说出"我犯了错误"。
| 首答与改答 | r₁ | r₂ | α=10 时的第二轮奖励 r₂′ | 鼓励的行为 |
|---|---|---|---|---|
| 错误到正确 | 0 | 1 | 11 | 大幅奖励有效修正 |
| 正确到正确 | 1 | 1 | 1 | 保留正确答案仍有奖励 |
| 正确到错误 | 1 | 0 | −10 | 惩罚破坏正确答案 |
| 错误到错误 | 0 | 0 | 0 | 没有正确性进步 |
这是一张按原公式计算的表,不是模型实测效果。
最容易写错的实现:把纠错奖金乘到整条对话上
如果"先错再对"能拿到 11 分,会不会鼓励模型故意先答错?
需要看奖励作用于哪些 token。论文附录 A.4 和图 9 明确说明,第二阶段第一轮按自己的正确性奖励训练;纠错塑形只作用于第二轮。
w₁ = r₁;w₂ = r₂ + α(r₂−r₁)
实际策略梯度还包含基线与 KL 正则。上式只表示分轮的奖励分配,不能直接当成完整训练 loss。
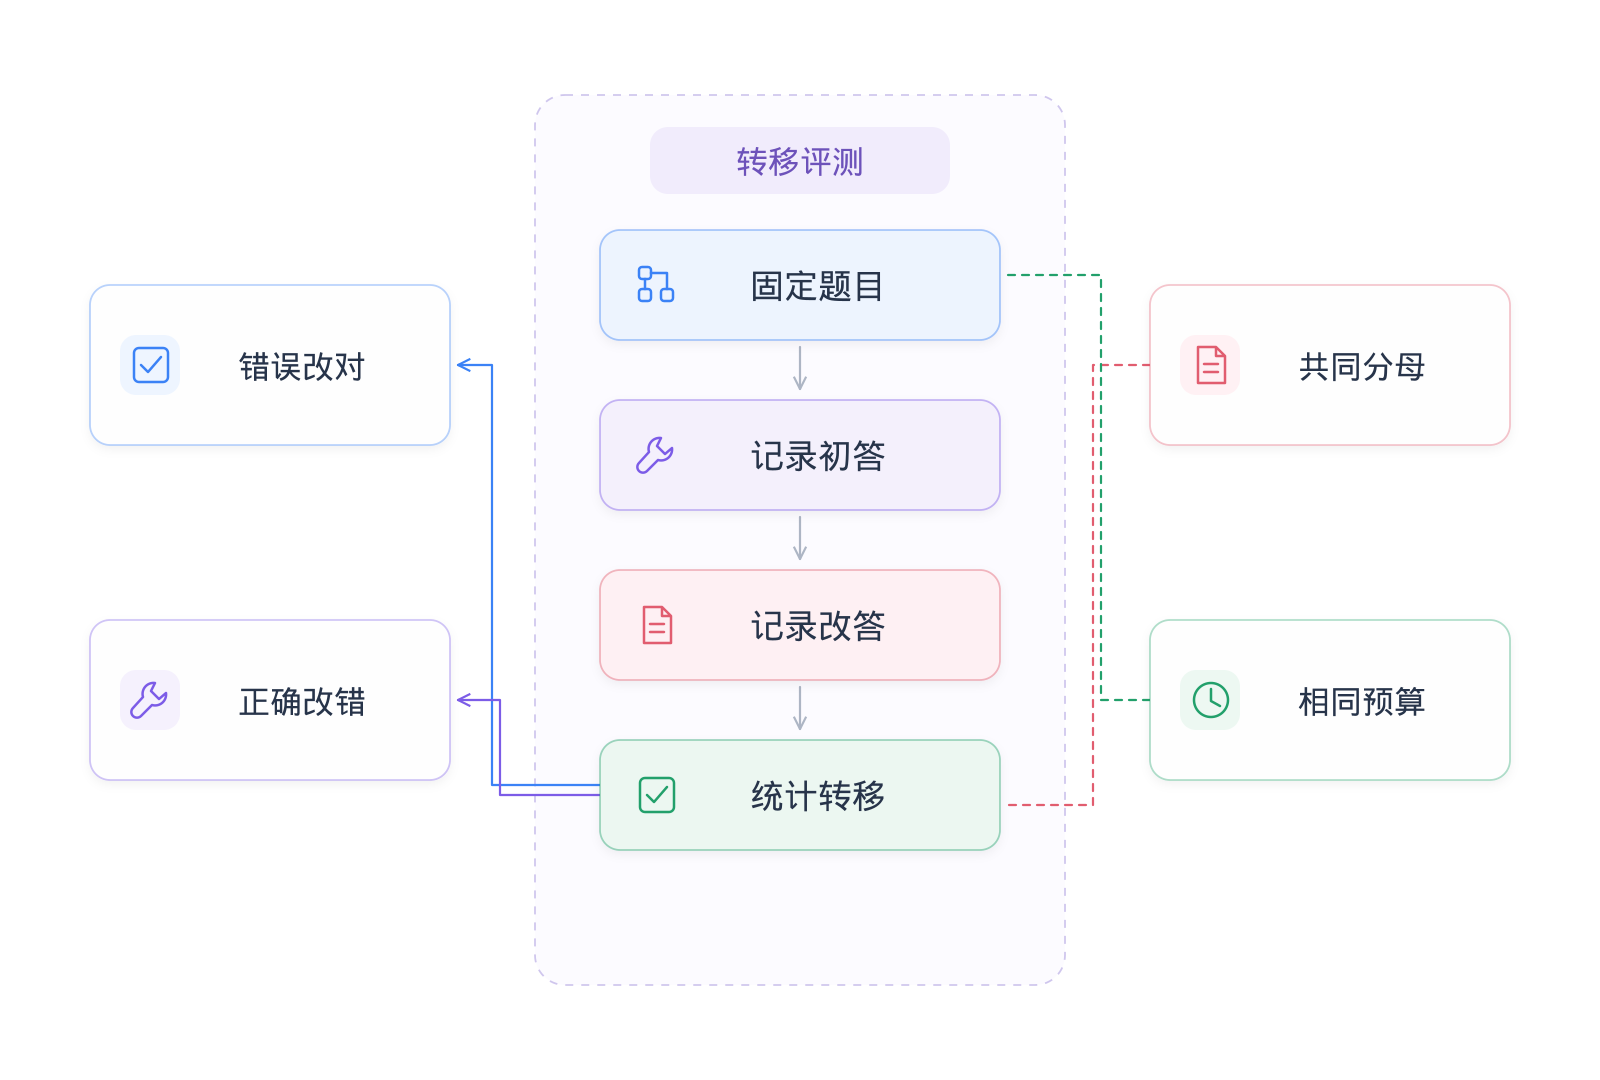
图 3|第一轮与第二轮不能共享同一个纠错奖金。前次答案进入第二轮上下文,正确性标签在训练时产生;图中的"训练判分"不接入测试提示。分轮更新还需要合适的奖励基线和 KL 项。根据原文附录 A.4、图 9 整理。
论文实现使用即时奖励,对应折扣因子 γ=0。第一轮没有直接获得来自第二轮的纠错奖金,因此这里没有把"主动制造一个第一轮错误"设置成奖励目标。共享模型参数仍会产生相互影响,这个分配方式也不等于任意场景都不会出现策略漏洞。
若把最终塑形奖励乘到第一轮与第二轮全部生成 token 上,就改变了该实现的重要信用分配条件。附录还测试了 γ=0.8、α=1.0 的另一设置,仍观察到不纠错的行为坍塌;不能只凭"加一个差分奖励"就声称复现 SCoRe。
基础优化器使用 REINFORCE 类方法,并采用 leave-one-out 奖励基线与 KL 约束,即论文所称的 RLOO(REINFORCE Leave-One-Out)。它不是因为出现"多条采样"就自动变成 GRPO,也不是这篇论文的主要新算法贡献。贡献在于怎样组织多轮训练、初始化和奖励,避免学到退化行为。
主实验数字,保留首答与改答两列
数学训练使用 MATH,并按论文协议加入原测试集中的 4,500 道题,保留另外 500 道作为 MATH500 评测。它不是未经改变的原始完整测试划分。
代码训练使用 MBPP,评估 HumanEval;测试时不把判题用例结果暴露给模型。MBPP-R 是另一种固定错误程序修复评测,需要单独列出。1, §6
| MATH500,Gemini 1.5 Flash | 首答 A₁ | 改答 A₂ | 净变化 Δ | 错改对 | 对改错 |
|---|---|---|---|---|---|
| 基础模型 | 52.6% | 41.4% | −11.2 pp | 4.6% | 15.8% |
| Self-Refine | 52.8% | 51.8% | −1.0 pp | 3.2% | 4.2% |
| STaR 的增强数据版本 | 53.6% | 54.0% | +0.4 pp | 2.6% | 2.2% |
| Pair-SFT | 52.4% | 54.2% | +1.8 pp | 5.4% | 3.6% |
| SCoRe | 60.0% | 64.4% | +4.4 pp | 5.8% | 1.4% |
数据:表 2。pp 表示百分点,错改对和对改错的分母都是全部测试题。
摘要提到的 MATH"15.6"可以从净变化理解:4.4−(−11.2)=15.6 个百分点。它不是"同一个首次正确率直接提高了 15.6 个百分点"。从表格也能看到,改善既来自首答能力,也来自大幅减少正确答案被改坏的情况。
| HumanEval,Gemini 1.0 Pro | 首答 A₁ | 改答 A₂ | 净变化 Δ | 固定修复任务 MBPP-R |
|---|---|---|---|---|
| 基础模型 | 53.7% | 56.7% | +3.0 pp | 47.3% |
| Self-Refine | 53.7% | 52.5% | −1.2 pp | 30.7% |
| Pair-SFT | 56.1% | 54.3% | −1.8 pp | 59.8% |
| SCoRe | 52.4% | 64.6% | +12.2 pp | 60.6% |
数据:表 3,保留原表四舍五入值。固定旧模型错误的修复任务与当前模型自己生成初答的在线评测,不能混合解释。
这张表还有一个值得注意的现象:SCoRe 的代码首答并非最高,但改答最好。Pair-SFT 在固定修复任务上有较好表现,却在自身两轮作答中出现负收益,正好对应"会修某一批旧错误"与"会修自己当前错误"的区别。
消融结果与更长推理,给了哪些边界
在 MATH 消融中,完整 SCoRe 的净收益为 4.4 pp;去掉多轮训练为 −2.4 pp,去掉第一阶段为 2.2 pp,去掉奖励塑形为 2.6 pp,去掉在线首轮样本则仅 0.2 pp。1, 表4
这些对照支持各组件在该实验中的作用。论文同时说明,一些设置会混入基础模型产生的初答,以扩大状态覆盖。因此,不能把方法写成"从头到尾只用纯当前策略样本,绝不含离线提示"。
推理预算实验比较了两种做法:独立生成 2K 份答案,或者生成 K 份初答,再各进行一次修正。两者生成答案的次数相同,最后做一致性选择。在 32 份生成预算下,论文报告并行采样准确率增益 7.4 pp,加入顺序修正为 10.5 pp。1, §6.2
这里对齐的是生成样本数量,不是严格相同的全部输入 token、墙钟延迟或服务成本。第二轮需要读取第一轮答案,顺序依赖也限制并行;不能直接把这个结果翻译成"任何部署都更省时间"。
附录还给了开放的 Gemma 2 2B 实验与三轮训练扩展。MATH 上第二阶段的三轮准确率为 23.0%、24.0%、24.0%;Functional MATH 与 MathOdyssey 上也报告了相应结果。它说明方案可以在这些设置中扩展,不意味着第三轮必然带来新的提升。
主模型只按两轮训练时,继续测试到十次修改,收益也出现平台。作者将它与越来越不同的后续答案分布联系起来。要支持更长的纠错链,训练覆盖和行为约束还得继续跟上。1, 附录A.1--A.3
训练成本和可复现性也有边界:主实验使用专有 Gemini 模型,作者没有发布微调后的模型。附录给出超参数:数学学习率 5×10⁻⁶、batch 512、3,000 steps;代码为 10⁻⁵、batch 128、1,500 steps。论文提供方法细节,不等于可以从公开权重直接复刻其全部成绩。
SCoRe 使"自我纠错"变成一个可以分解的训练目标:生成自己的问题状态,保留有效修改的探索机会,奖励纠正,惩罚破坏,再按信息条件评测。检查一个系统有没有学会这件事,最直接的方法是同时看错改对和对改错,而不是数它写了多少次"重新检查"。
参考资料与阅读说明
- Kumar, A., Zhuang, V., Agarwal, R., Su, Y., et al. Training Language Models to Self-Correct via Reinforcement Learning. ICLR 2025。指定会议版 PDF。核对主体实验、阶段目标、分轮奖励、附录 A--D 与部分定性例子;没有复现训练。
- Shinn, N., et al. Reflexion: Language Agents with Verbal Reinforcement Learning. NeurIPS 2023。会议版。用于比较反馈条件与参数更新方式,未把其成绩与 SCoRe 直接排名。
- Yuan, S., et al. Agent-R: Training Language Model Agents to Reflect via Iterative Self-Training. arXiv v1。用于区分交互环境纠正 SFT 与本篇的内生多轮 RL。