MoE训练的难题
MoE的训练关键是路由层,但关键问题是路由层是不可微分的,无法反向传播,有三种解决方法
- RL学习路由
- 加上随机扰动
- 启发式的负载均衡loss
RL路由
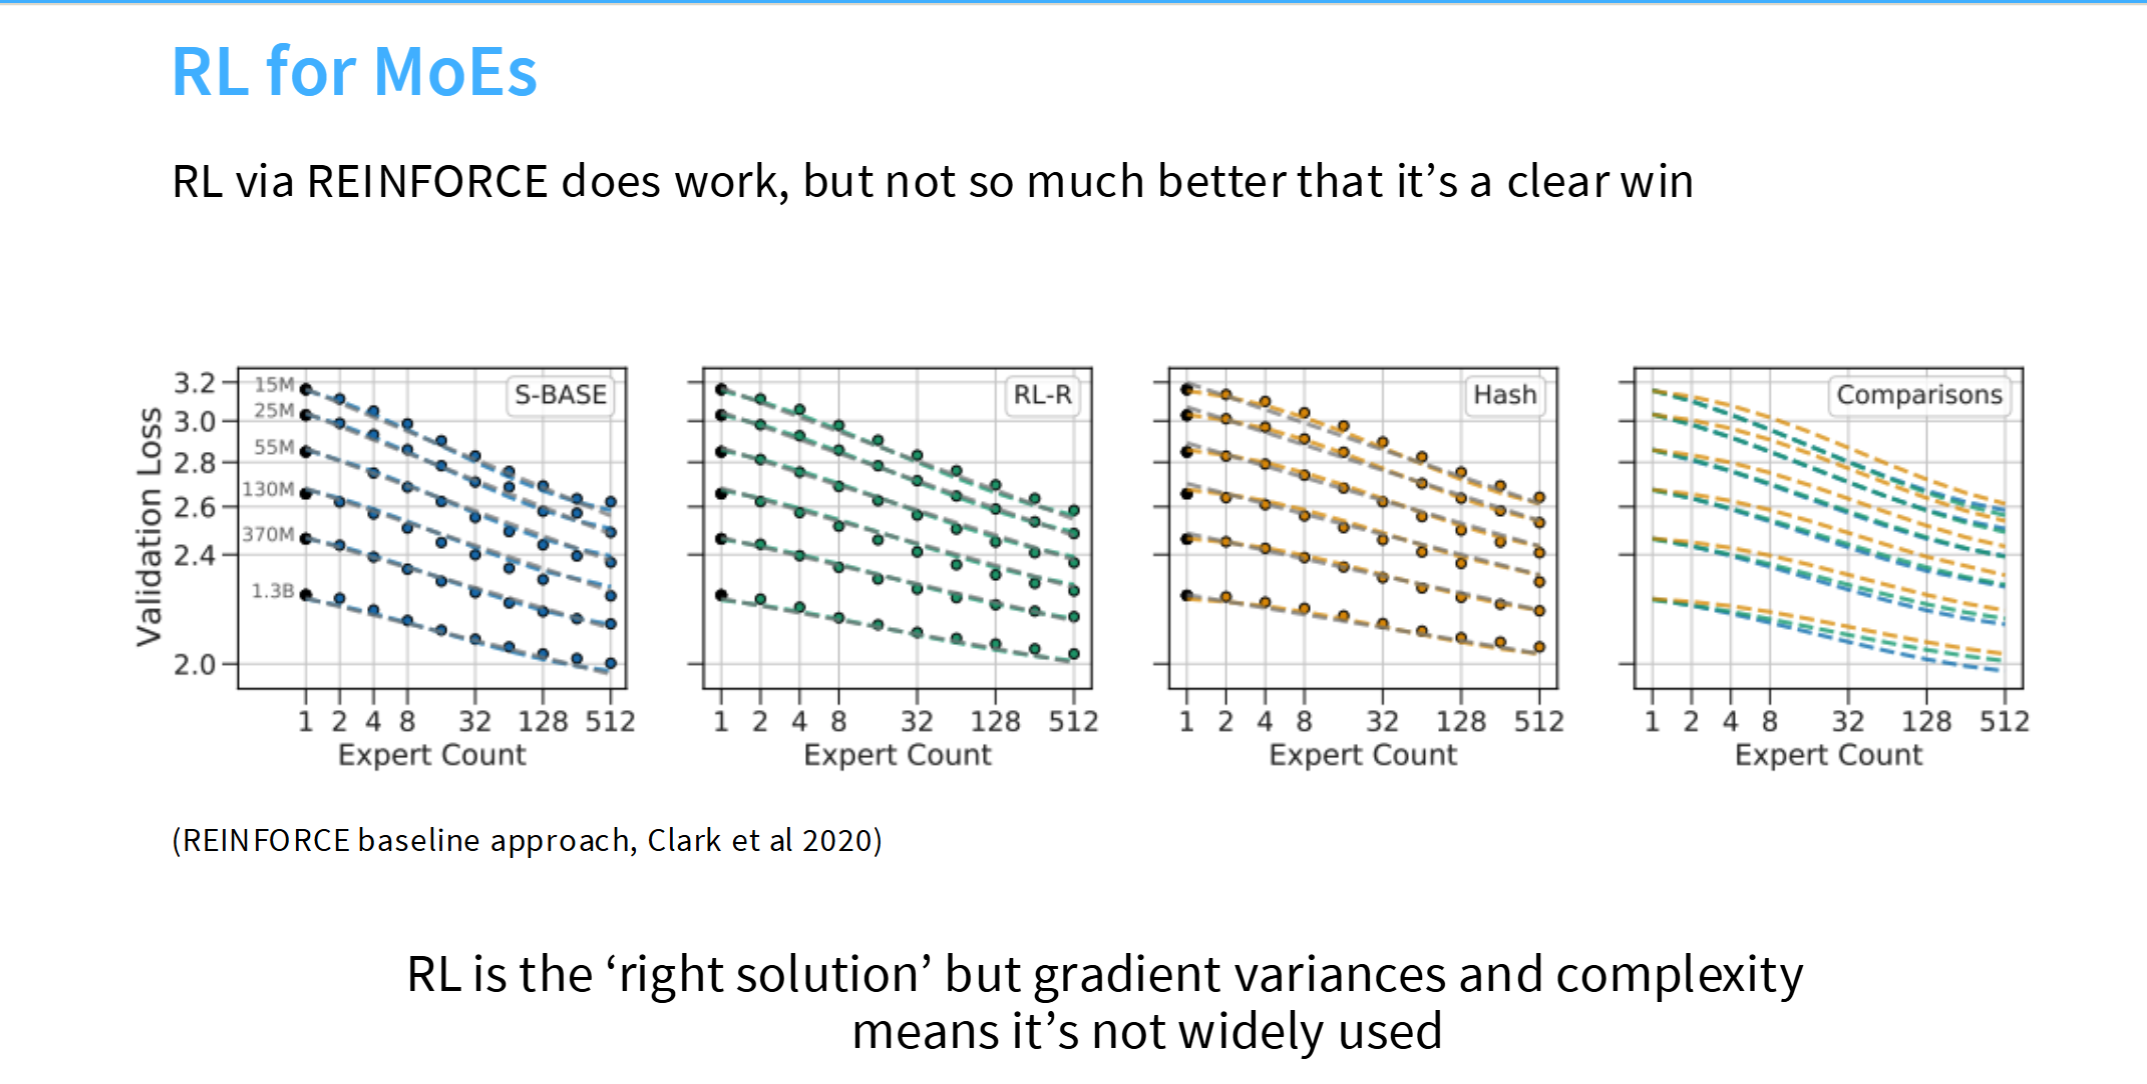
RL理论上有效,但实验中和另外两种baseline比,没有明显的优势
随机扰动
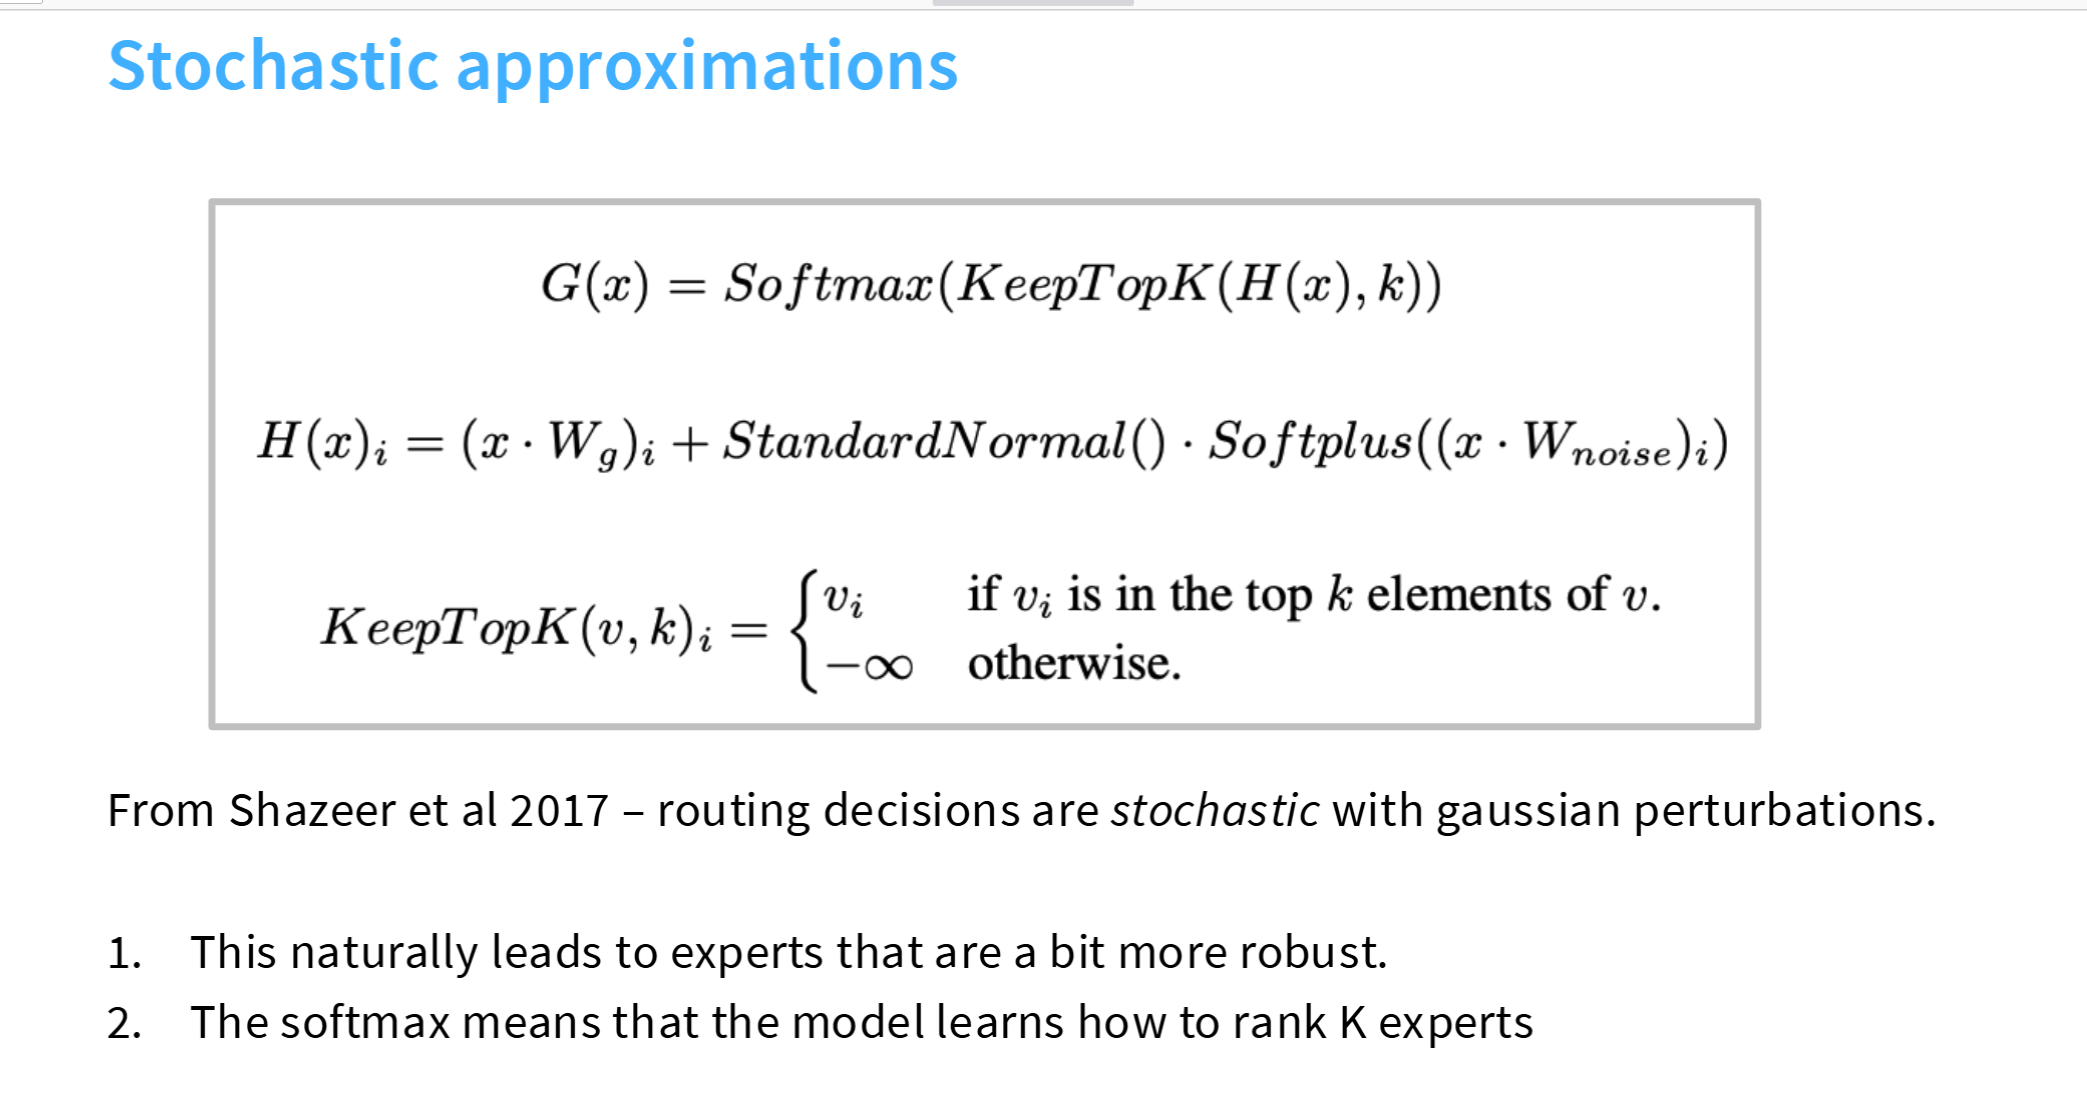
另一个做法是,给路由时加上随机扰动,这样可以让负载更均衡一点,不容易出现一个专家永远被选,或者永远不被选。
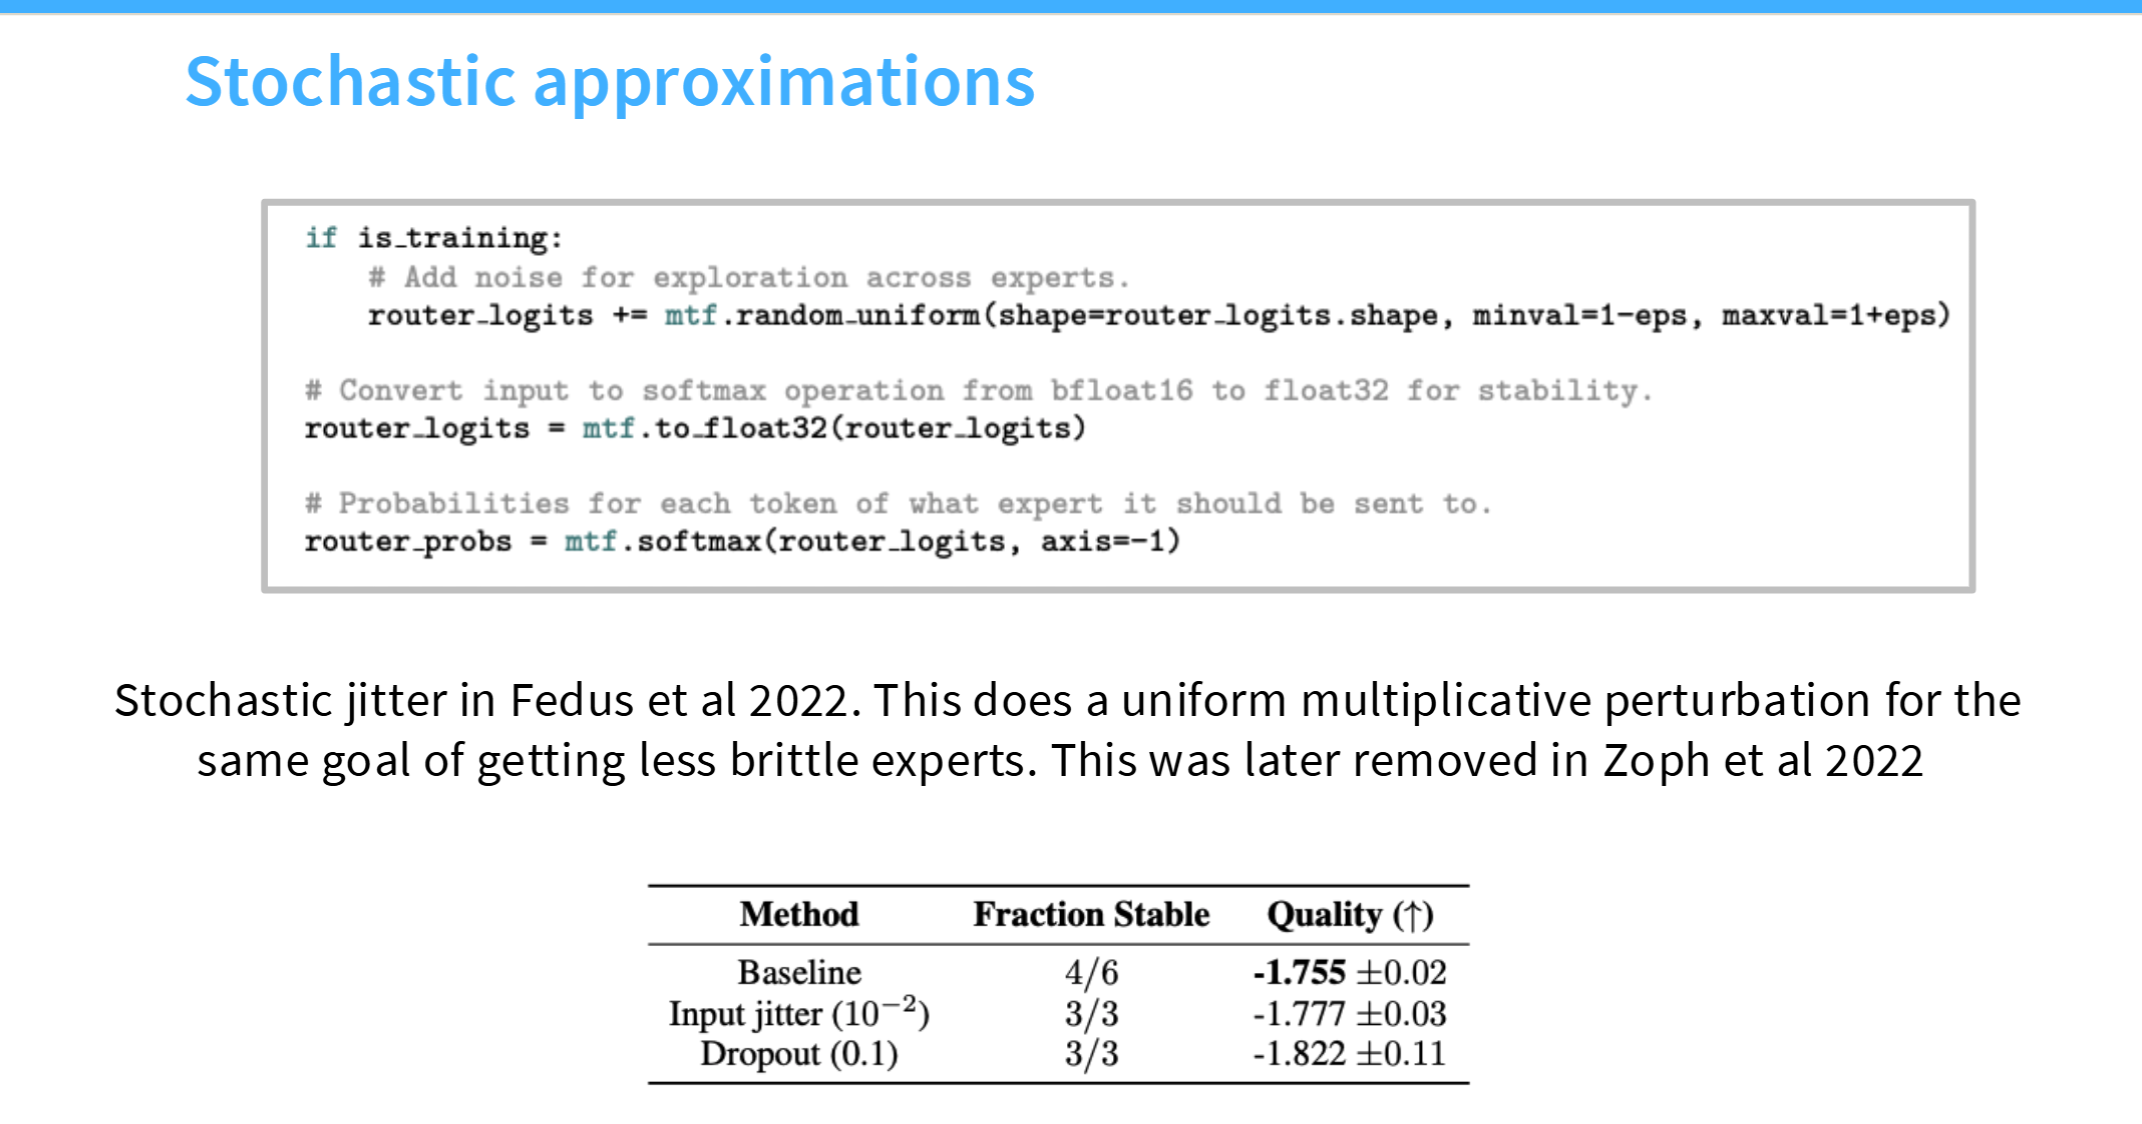
实验表明,训练时加入随机扰动,确实可以减少训练崩溃,图中下面的表,第二列是正常训练的比例,加入扰动后从4/6提升到了3/3.但是,模型能力变弱了,见表中第三列,模型最终收敛时的表现不如不加扰动的baseline,因此这个方法最终还是被废弃了。
启发式负载均衡loss
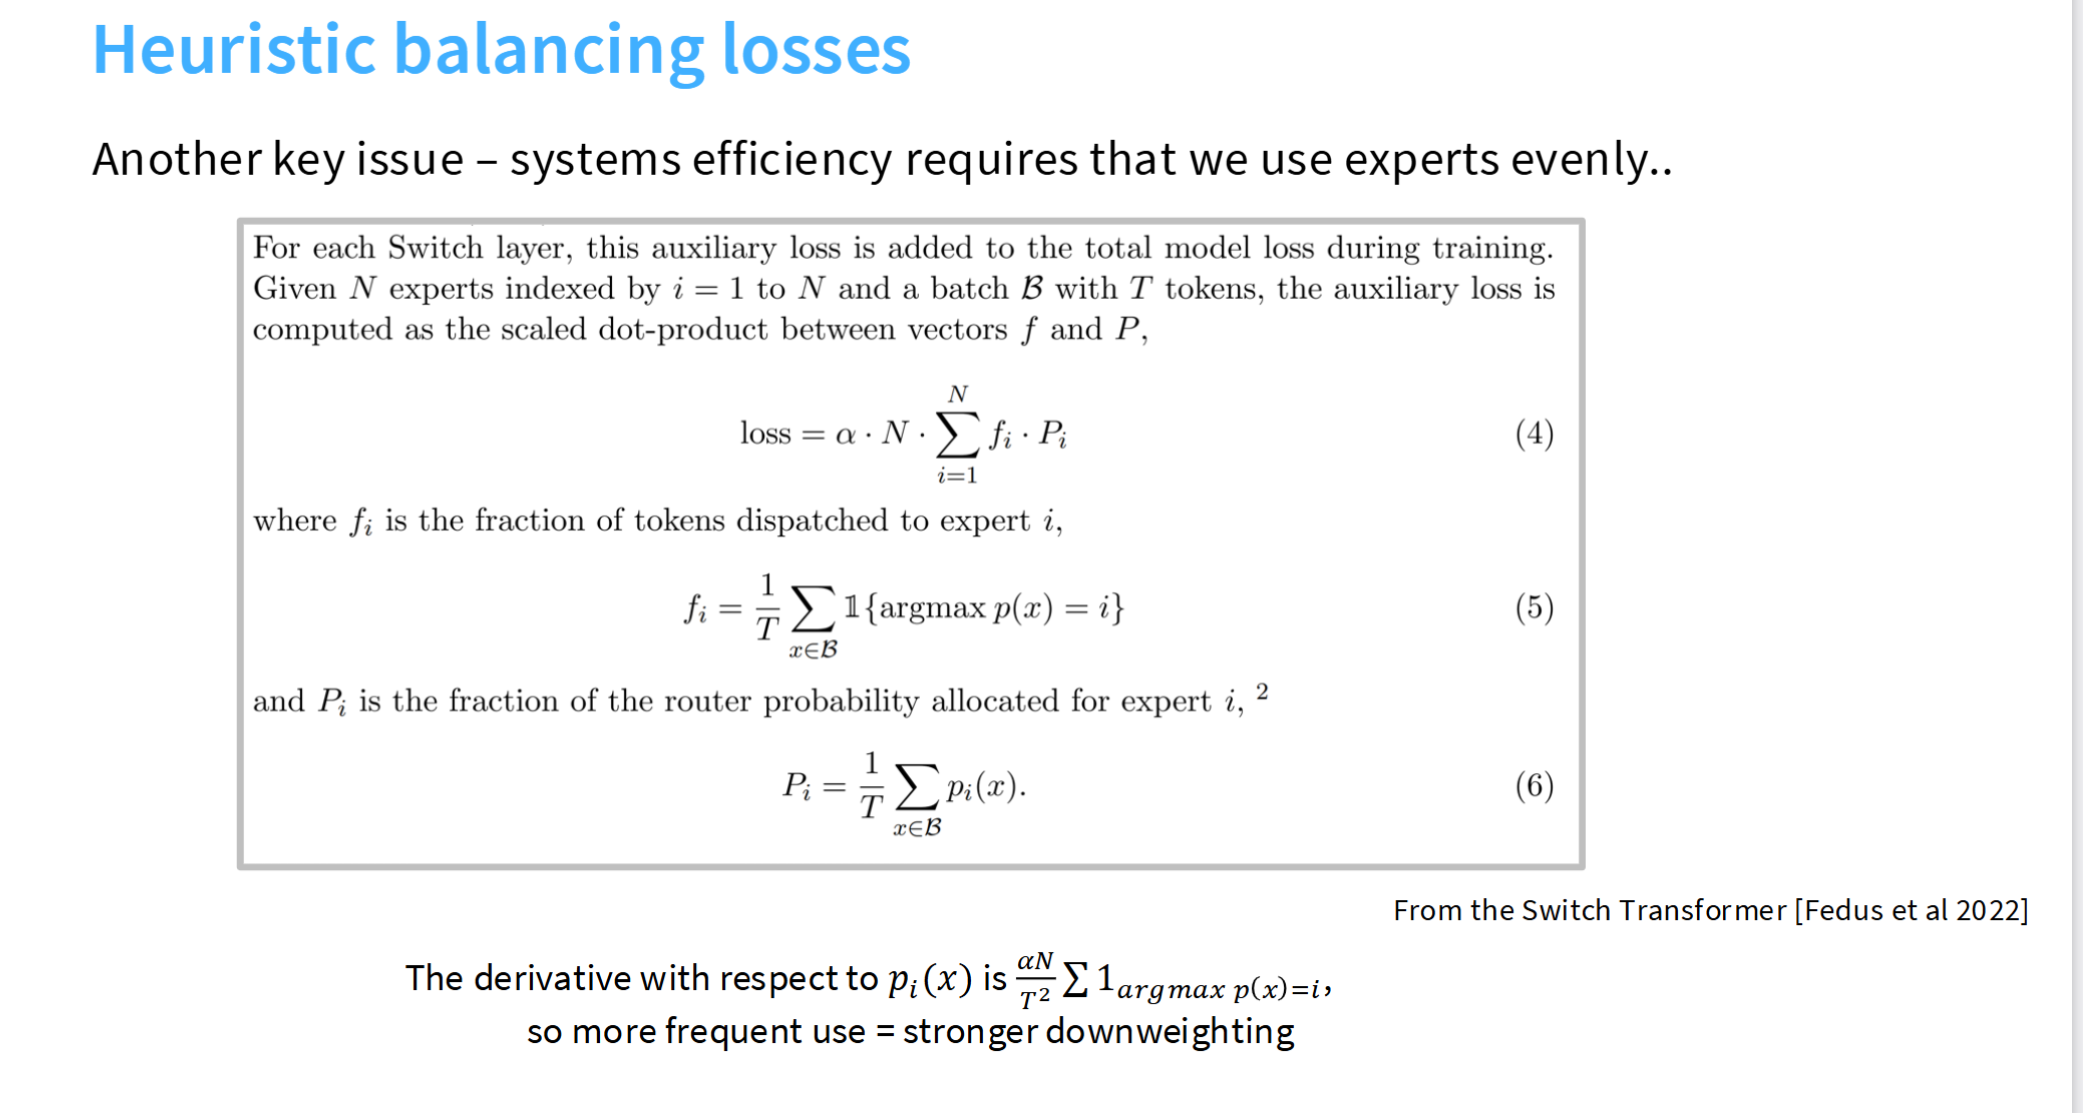
第三种方法,也是最主流的。加一个启发式的loss来实现负载均衡。这里loss的公式是(4),可以看到对每个专家的f,p两个值乘积求和。
其中f是这批token中被路由到这个专家的比例,p是这批token,每个token路由到这个专家的原始概率的均值。这两个值都刻画了这个专家被选中的概率。
这个loss是可导的!并且可以反应负载均衡情况,可以让模型学习到路由规则。
专家/设备负载均衡
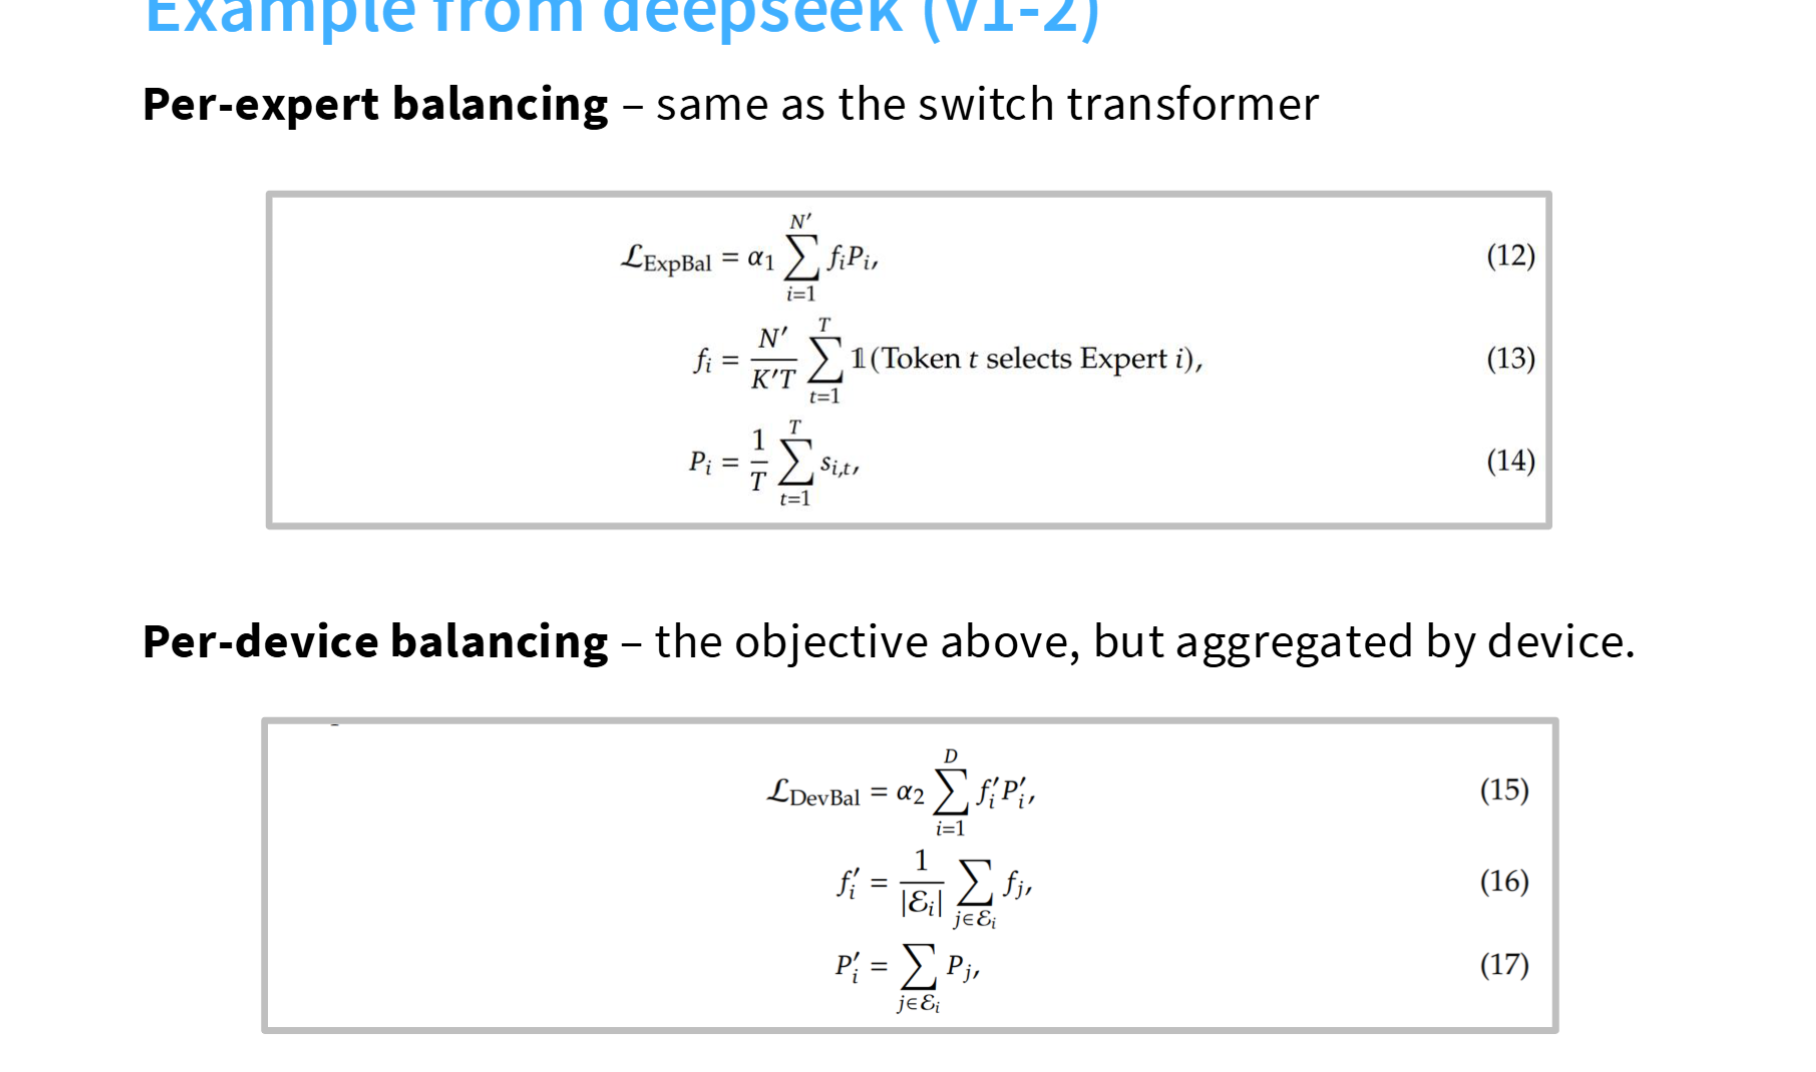
原始的公式是对于每个专家计算负载均衡的loss,更进一步还可以对并行训练时每个设备做负载均衡,f,p改成每个设备的路由token个数,以及设备上的所有专家的路由概率均值。毕竟除了专家均衡,提高训练稳定性,让设备均衡提高设备利用率也是重要的,这可以提高训练效率。
无辅助损失均衡
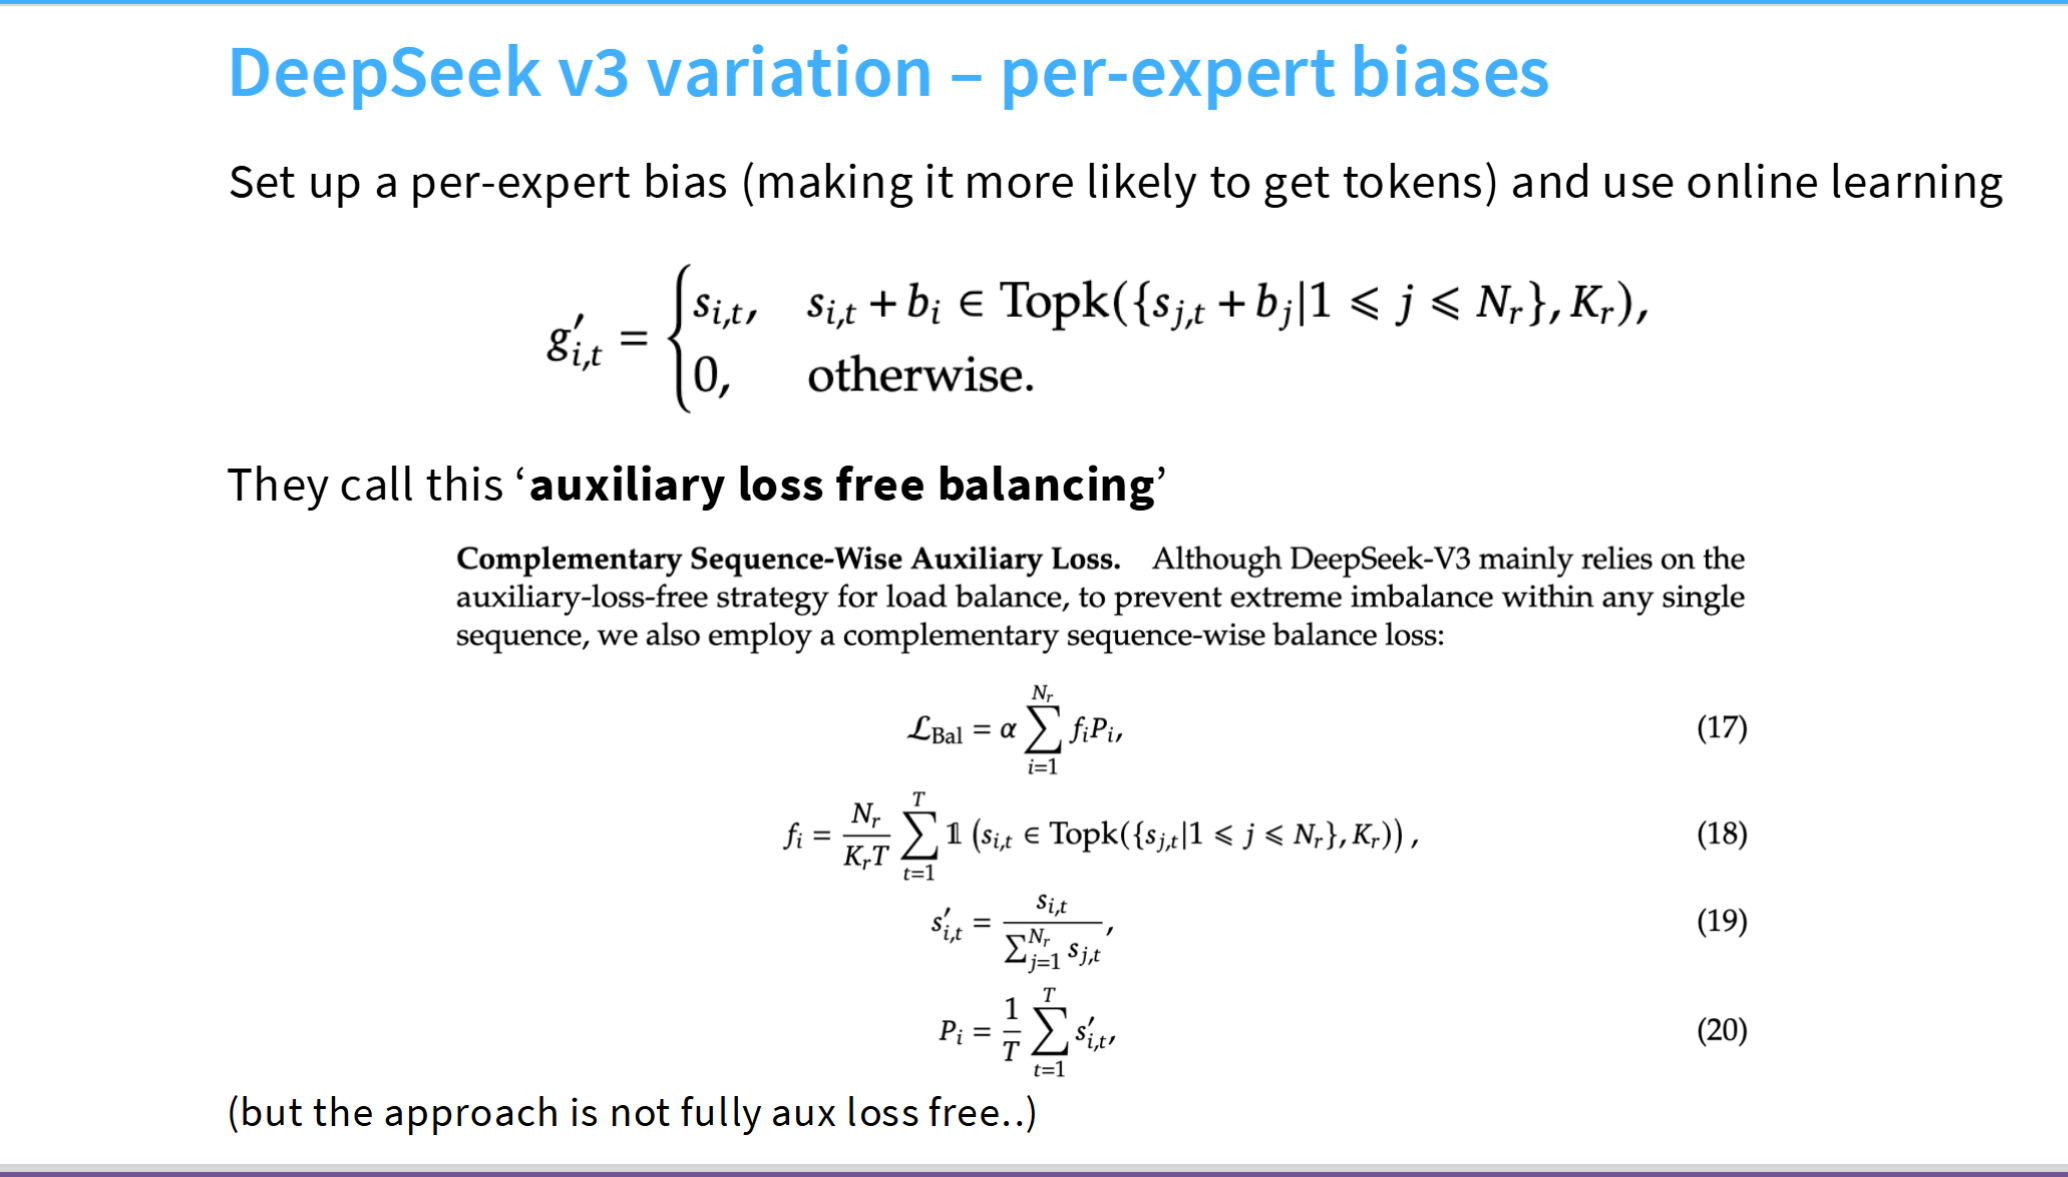
更进一步在Deepseek V3中提出了新的负载均衡方法,不改变loss项。而是给每个专家加一个偏置项b,计算每个token和专家的得分s后,临时加上专家的偏置b,来做topk排序,如果在前k大则路由到这个专家,但路由后的输出里不包含偏置项b。
每一轮统计每个专家被路由到的次数,如果大了就降低b,小了就增大b。这样可以在不碰loss的情况下实现负载均衡。
这样做的意义是,修改loss来实现负载均衡,可能强迫模型把不适合给某个专家的token,为了负载均衡的考虑塞给专家,导致输出质量低。
消融实验
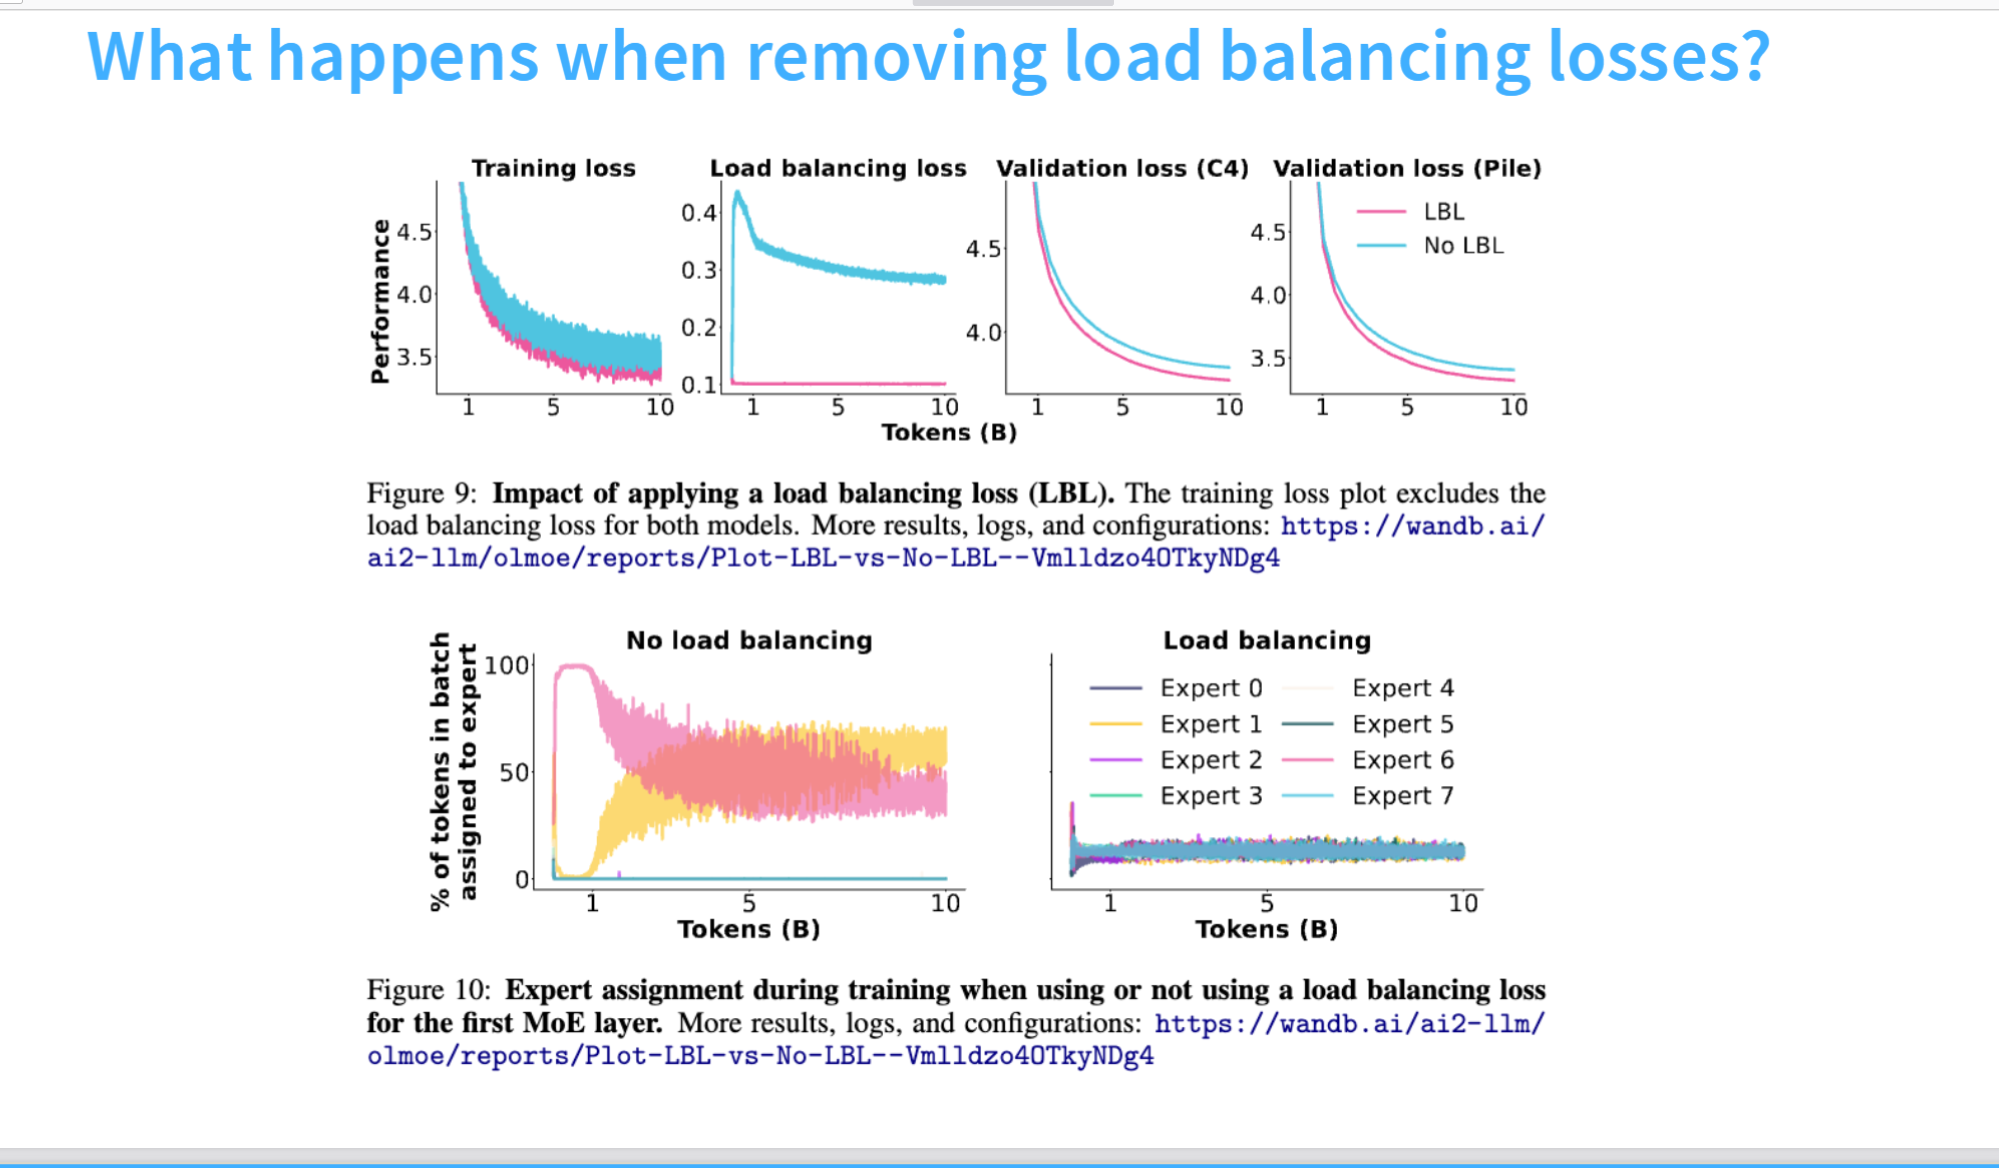
去掉负载均衡后,模型的loss下降更慢,如上图,粉色是带负载均衡loss的,蓝色不带。
去掉负载均衡,确实也会导致专家负载不均,如下图,八根线表示八个专家被路由到的次数,左边是没有负载均衡,有两个专家主要被路由到,剩下的专家几乎没用。右侧是带负载均衡loss,八种专家的路由次数都比较接近。
并行
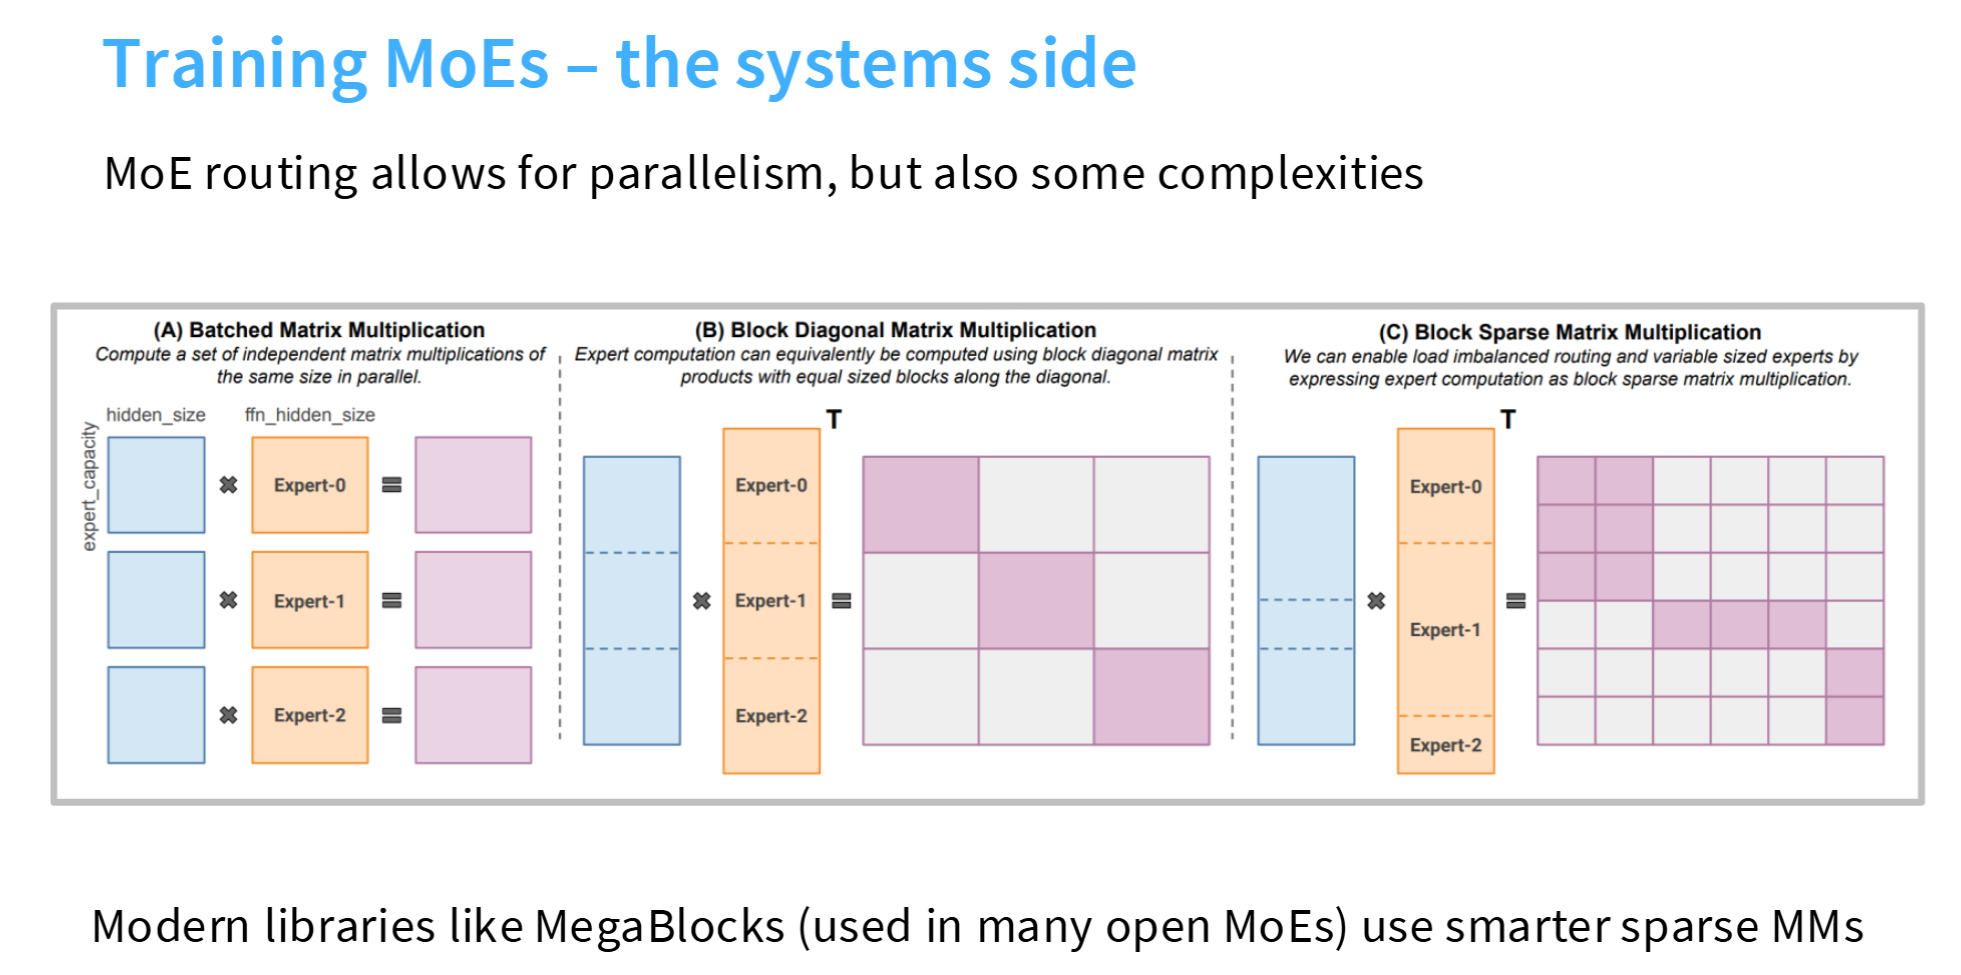
对于一个设备上的多个专家,朴素的做法是每个专家,和路由到他的token组成的矩阵分别做矩阵乘法,如左图。
但既然在一个设备上,一个自然的优化是,把专家和token都拼起来,得到两个大矩阵,做一次大矩阵乘法,这样对GPU更友好,GPU喜欢大量数据流,大量小数据导致的同步开销会造成吞吐浪费。但这样的问题是,只有对角线上的块是有效的结果,其他部分都浪费了,如中图。
多次计算融合成一次GEMM是好的,为了解决了一次GEMM的冗余计算,使用结构化稀疏,这是英伟达硬件就支持的功能,可以传入一些元数据,表示最终的结果矩阵中,有哪些位置是需要计算的,然后利用硬件的稀疏算力,只算这些稀疏位置的结果,一般来讲要求每四个位置,有且只有两个位置需要计算,然后可以把吞吐提升一倍。现在有很多现成的库,可以帮我们把数据重新排布,满足每四个位置有且只有两个有效,然后调用显卡的结构化稀疏GEMM接口。
下采样
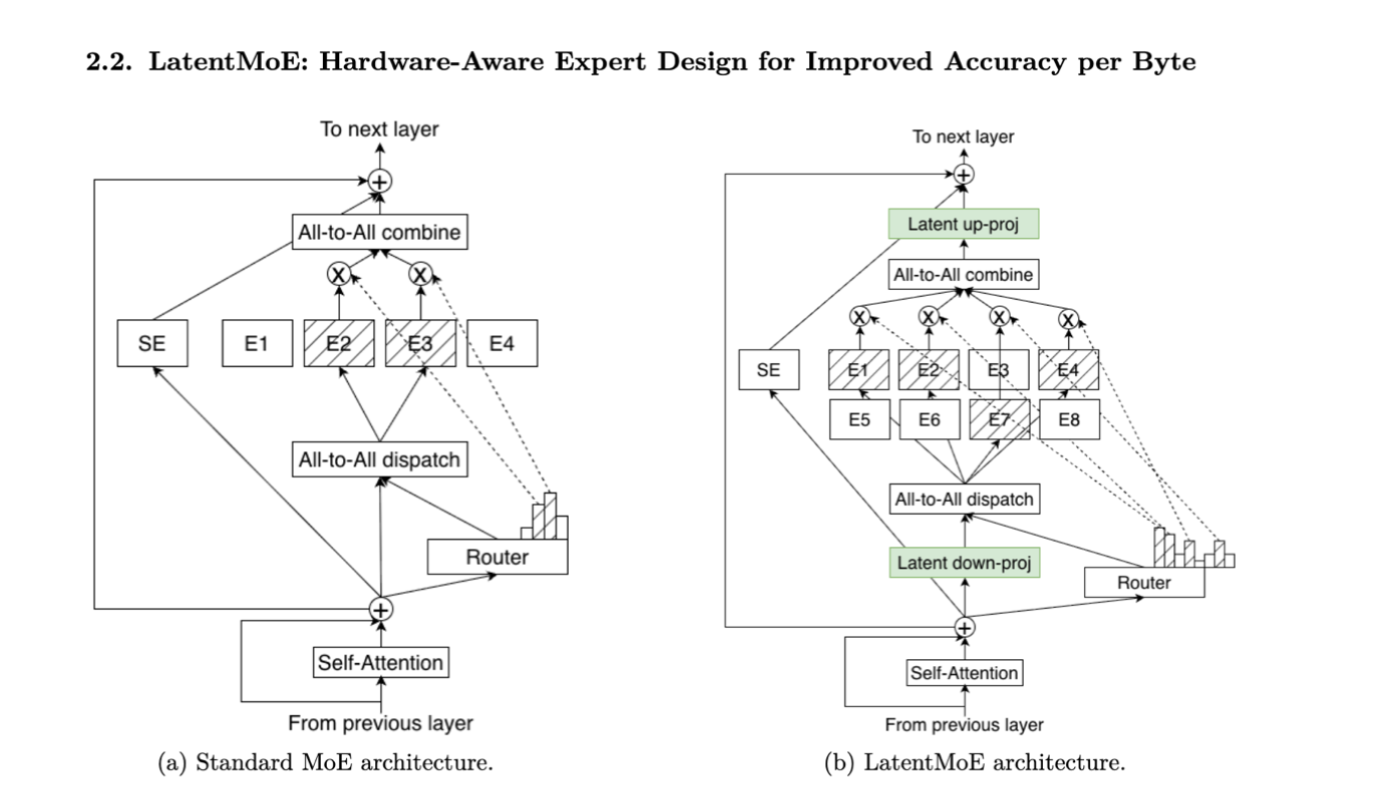
另外还有一些优化思路,比如英伟达的Nemotron3,在进入MoE计算前对激活值做一个下采样,压缩到更小的维度,这样可以减少MoE计算量,降低MoE的专家大小,从而还可以支持更多专家。最后MoE层计算完毕后再上采样回原来的大小。
MoE的随机性
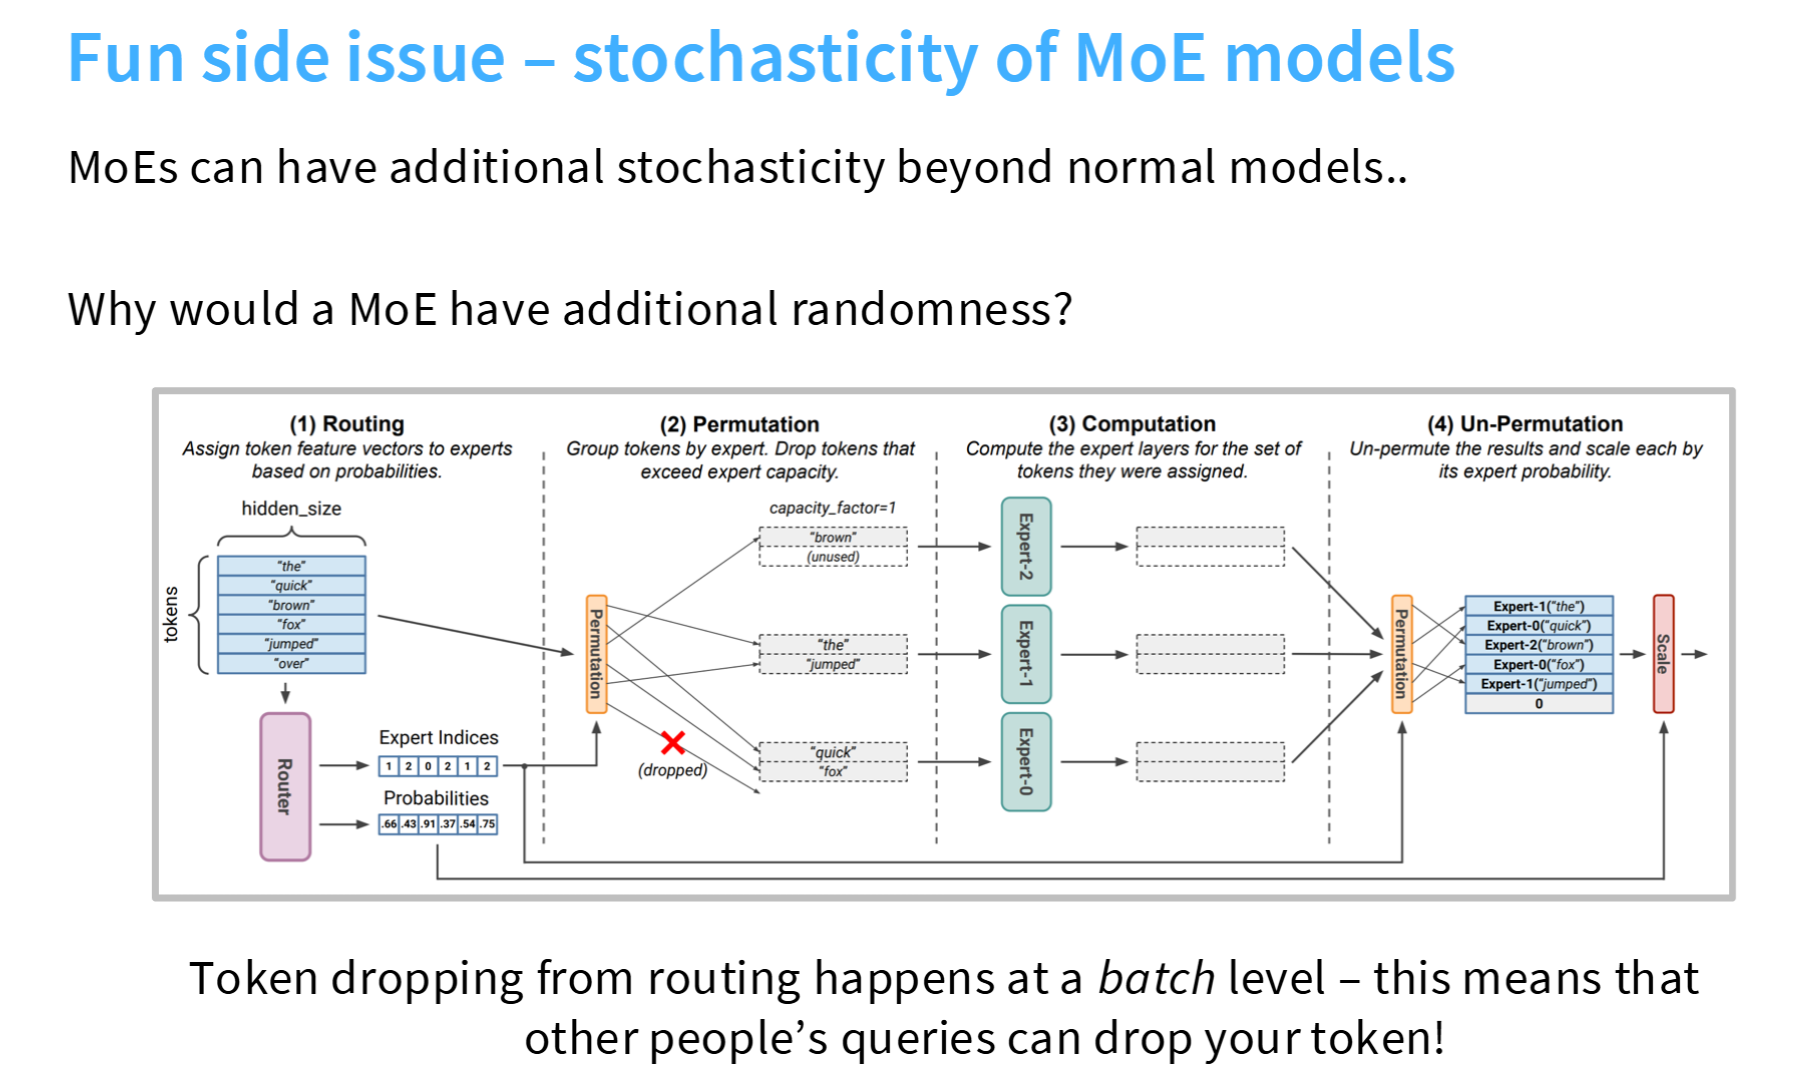
MoE的推理结果具有更大随机性(对比Dense模型)。这是因为在多用户推理系统中,多个用户的请求会被打包成一个batch,发送给MoE层,先做路由。由于每个专家一般会设置接受的token上限,如果一个专家能处理的token满了,剩余原本被路由到这个专家的token会被重新路由,或者丢弃,等待下一轮路由。
这导致其他人的推理请求可能会影响你的请求的路由情况,如果你的请求在一个batch的靠前的位置,更可能路由到想要的专家,如果在一个batch靠后的位置,更可能被丢弃,路由不到想要的专家。而你的请求在一个batch的靠前还是靠后,这是纯随机的,可能和系统的随机策略,甚至网速有关。
训练稳定性
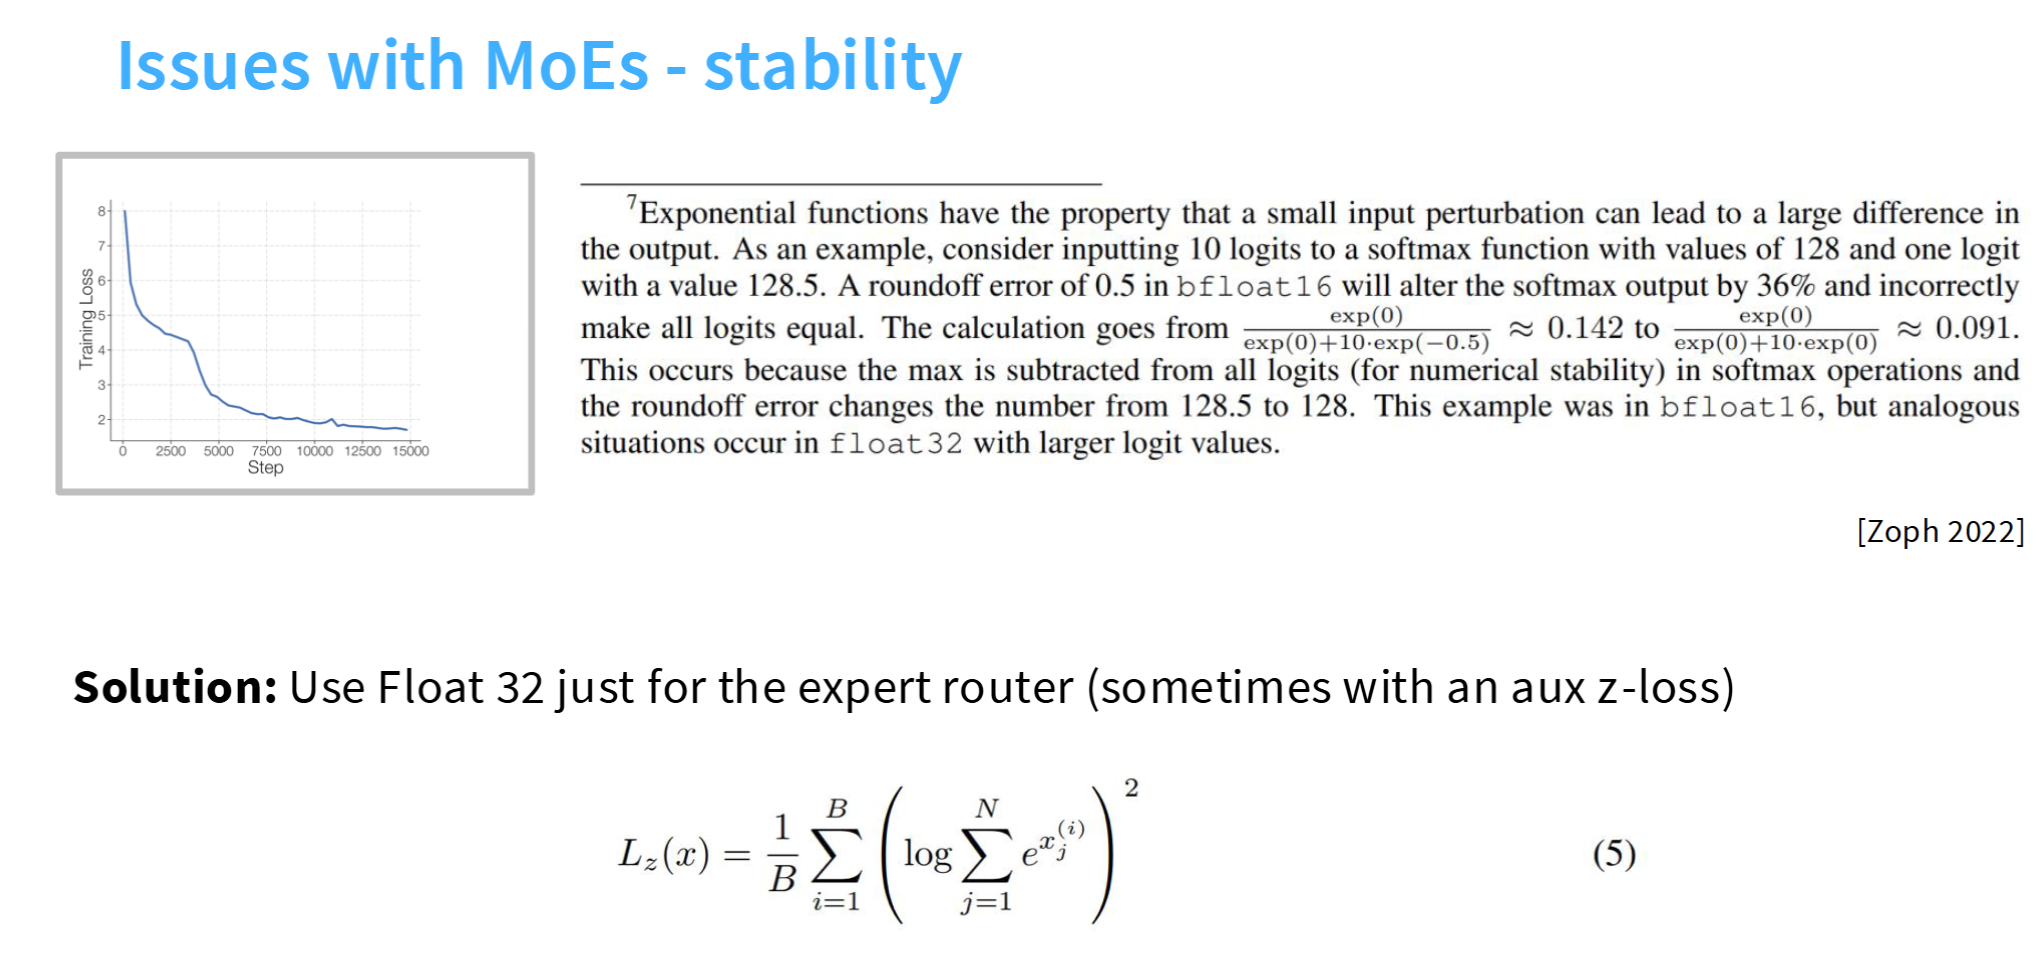
路由结果非常影响MoE模型的训练稳定性,而bf16位数有限,舍入误差可能导致实际得分不一样的两个专家,在bf16下得到相同的路由分数,从而进行错误的调度,导致loss下降缓慢,甚至上升。解决方法是在计算路由分数的地方使用fp32高精度
另一个解法是下方的公式(5),增加一个loss项,被称为z-loss,把所有结果求以e为底数的幂,求平均。这能有效惩罚数值过大的结果。数值过大也是浮点溢出的主要原因。
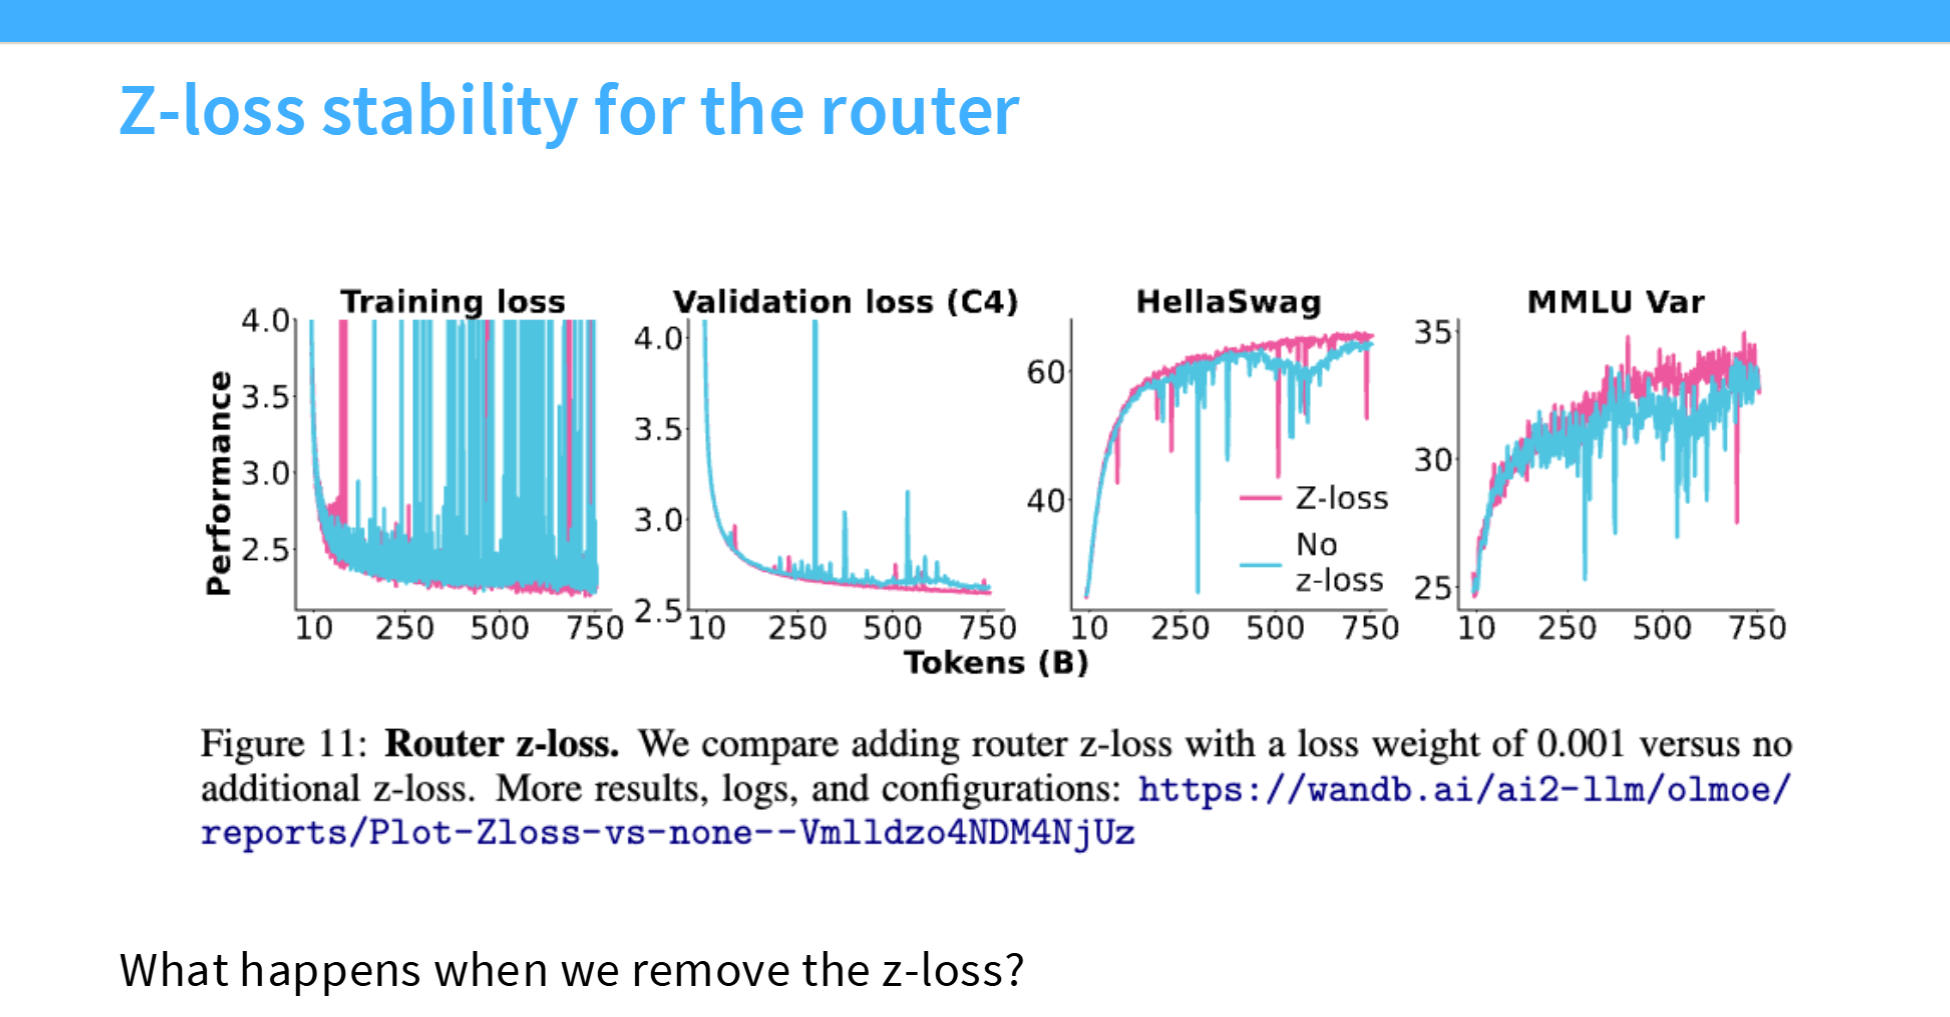
消融实验验证了zloss确实有效,粉色是有zloss,蓝色是无zloss,可以看到蓝色在训练过程中明显多很多尖峰,这都是训练中不稳定的时候。
过拟合
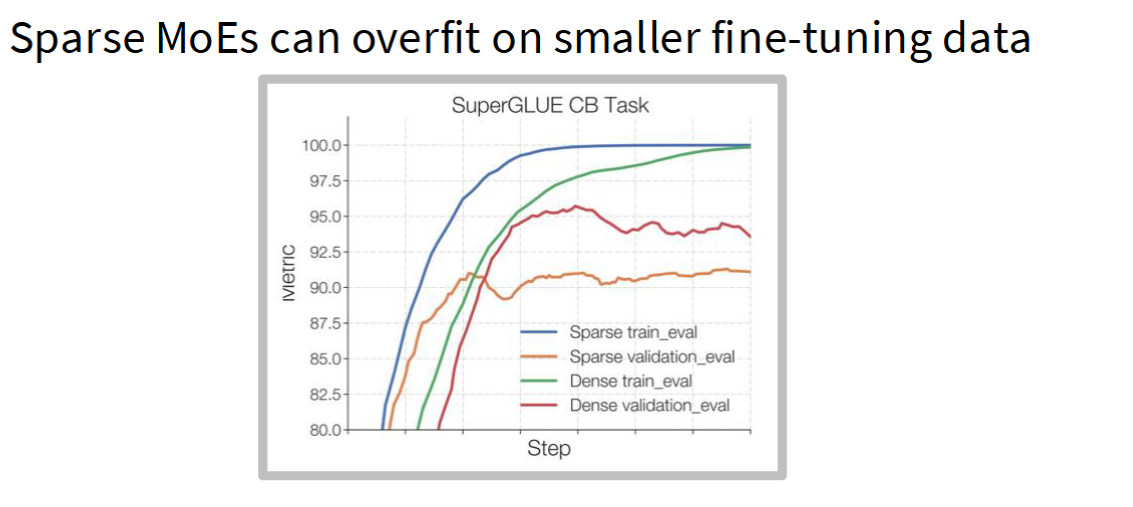
MoE更容易过拟合。蓝绿分别是MoE,稠密模型的训练集表现,MoE收敛得更快。但MoE在验证集上表现更差,明显出现了过拟合,橙,红分别是MoE和稠密模型的验证集表现。
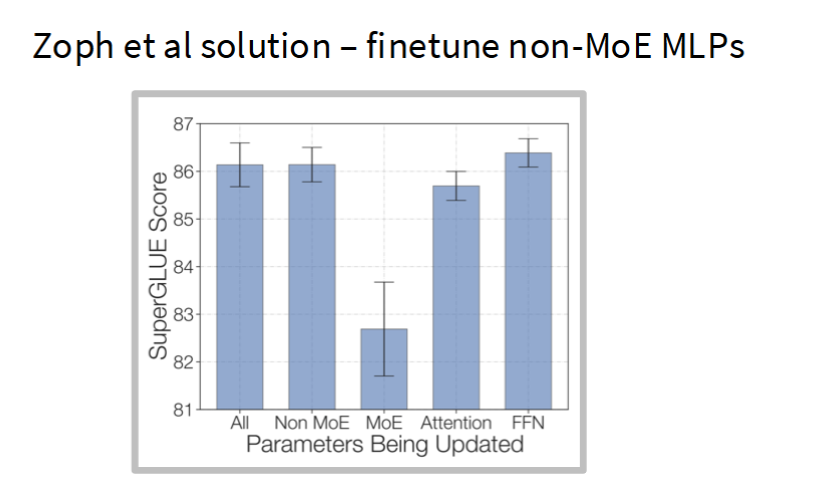
一种解决方法是,微调是冻结MoE层,微调其他层。例如上图,分别微调不同层,可以发现微调其他层,benchmark得分都很高,只有微调MoE时得分明显低。
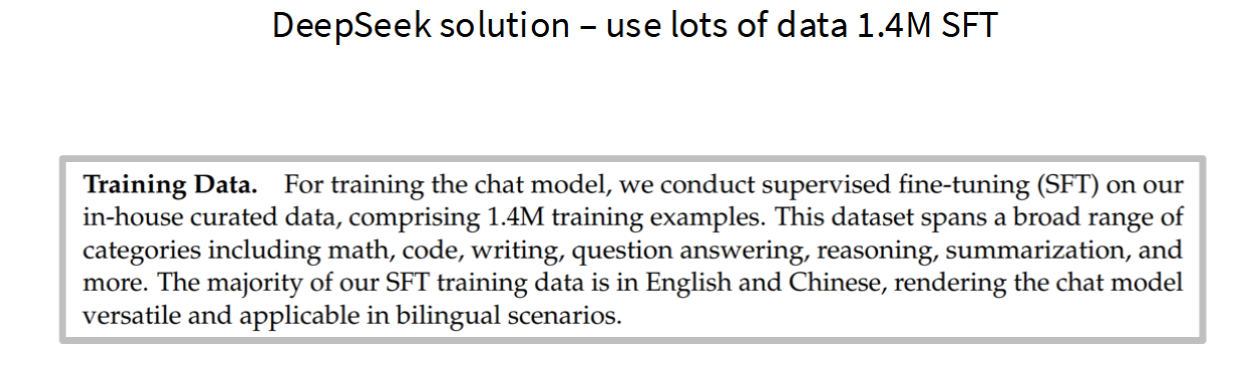
另一种简单但有效的方法是增加微调数据,过拟合的一个重要原因就是数据集太小,Deepseek的解法是SFT阶段增加大量数据。
Upcycling
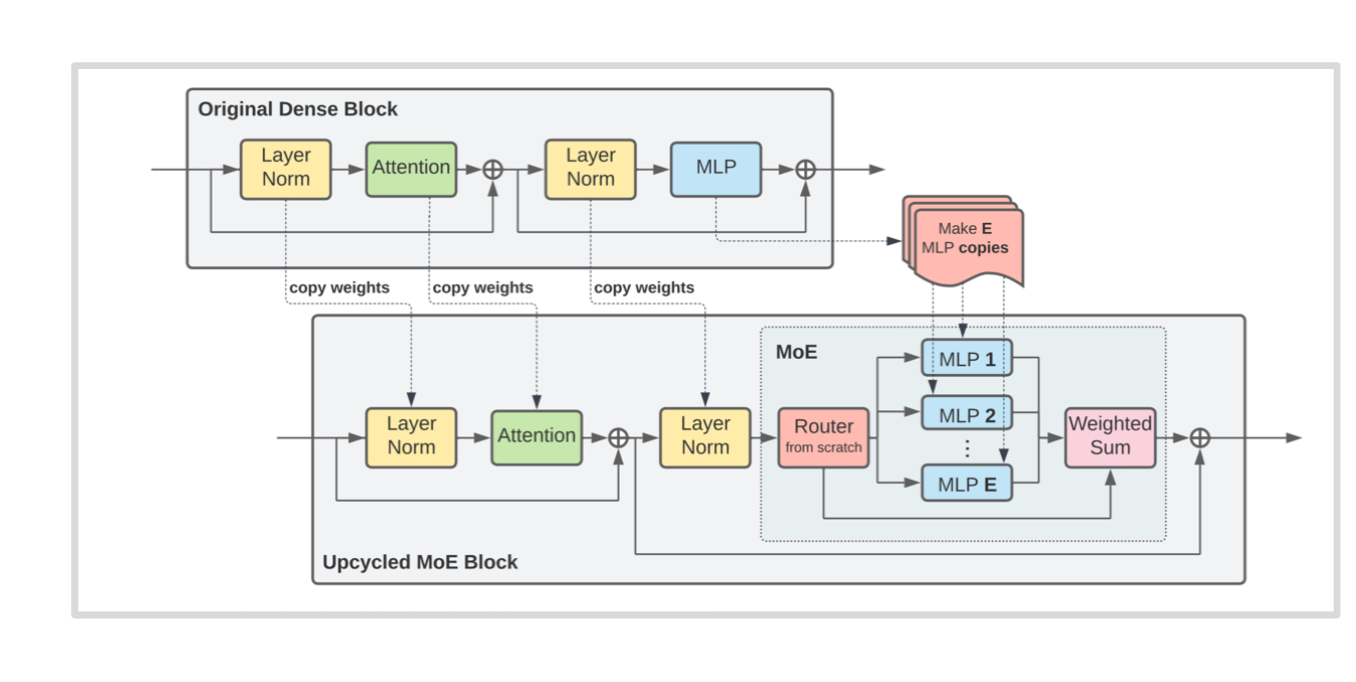
翻译成中文是回收,再利用。意思是我们可以用一个已经训练好的稠密模型,作为MoE的基础模型。见上图,具体架构是,注意力层和归一化层都直接使用稠密模型的参数。MoE层的多个专家,都使用稠密模型的相同线性层。也就是开始初始化了多个相同的专家,后续在训练中再让这些专家学习分工。
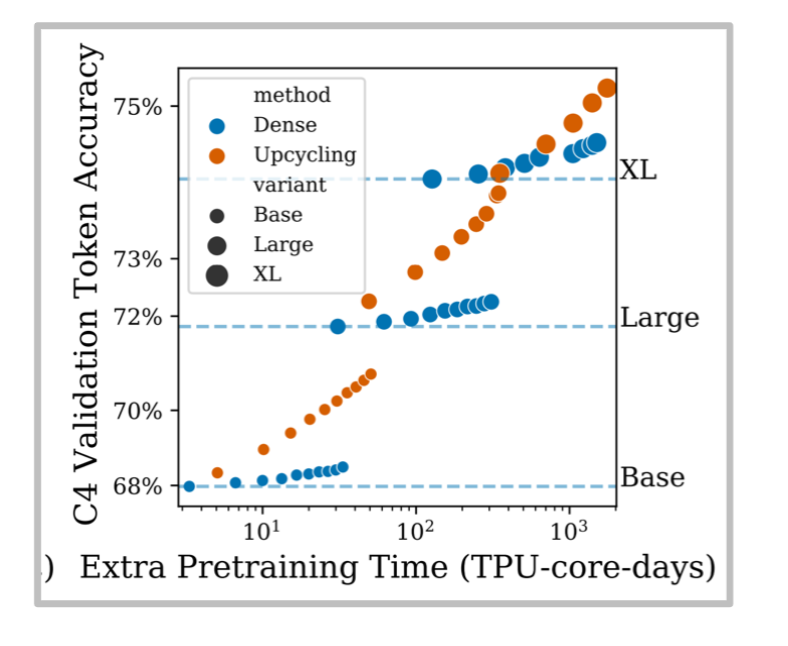
可以看到在相同的训练轮数后,橙色的Upcycling明显比蓝色的稠密模型表现好。甚至large级别的Upcycling MoE模型,表现反超了更大规模的XL级别稠密模型。
举例:MiniCPM
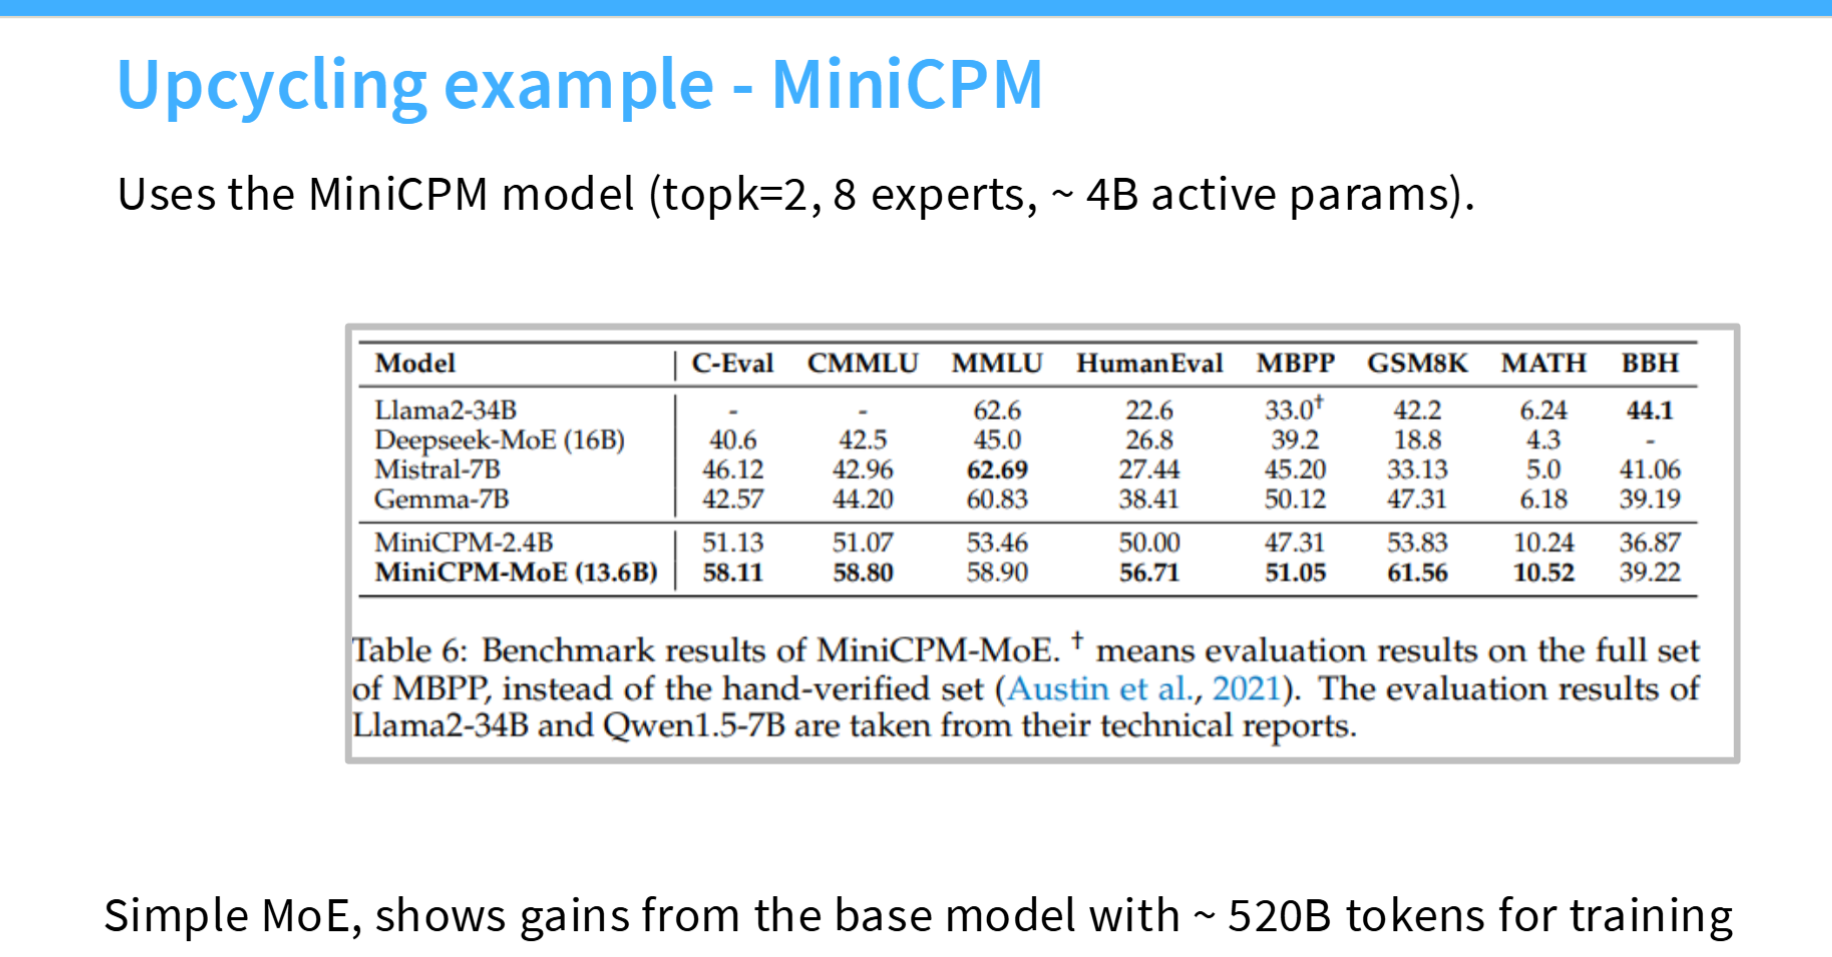
采用这个路线的经典例子是面壁智能的MiniCPM,这个模型主打小参数,高性价比,定位是端侧(手机,车载)部署。采用Upcycling MoE的13.6B版本,性能远超激活参数大小接近的其他稠密模型。
回顾Deepseek演进
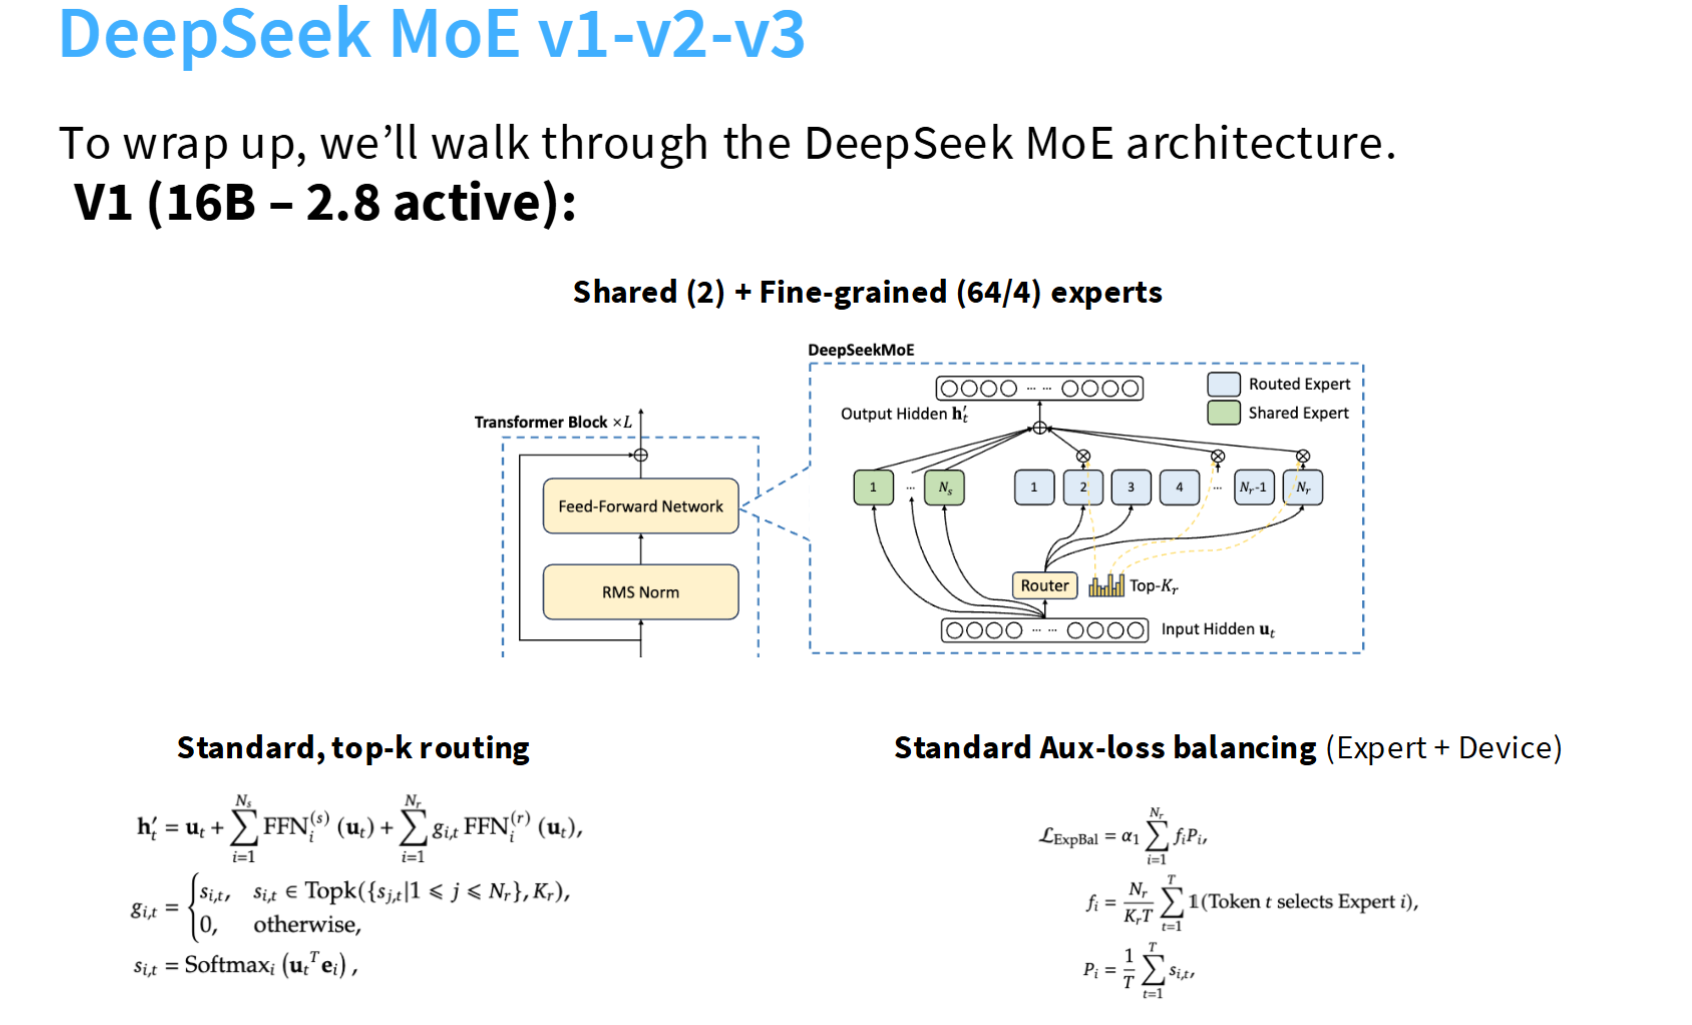
MoE这节大部分计数都是在讨论Deepseek,这里全面回顾一下DS的演进路线
V1就采用了MoE,使用了topk路由,负载均衡loss,共享专家和细粒度专家。
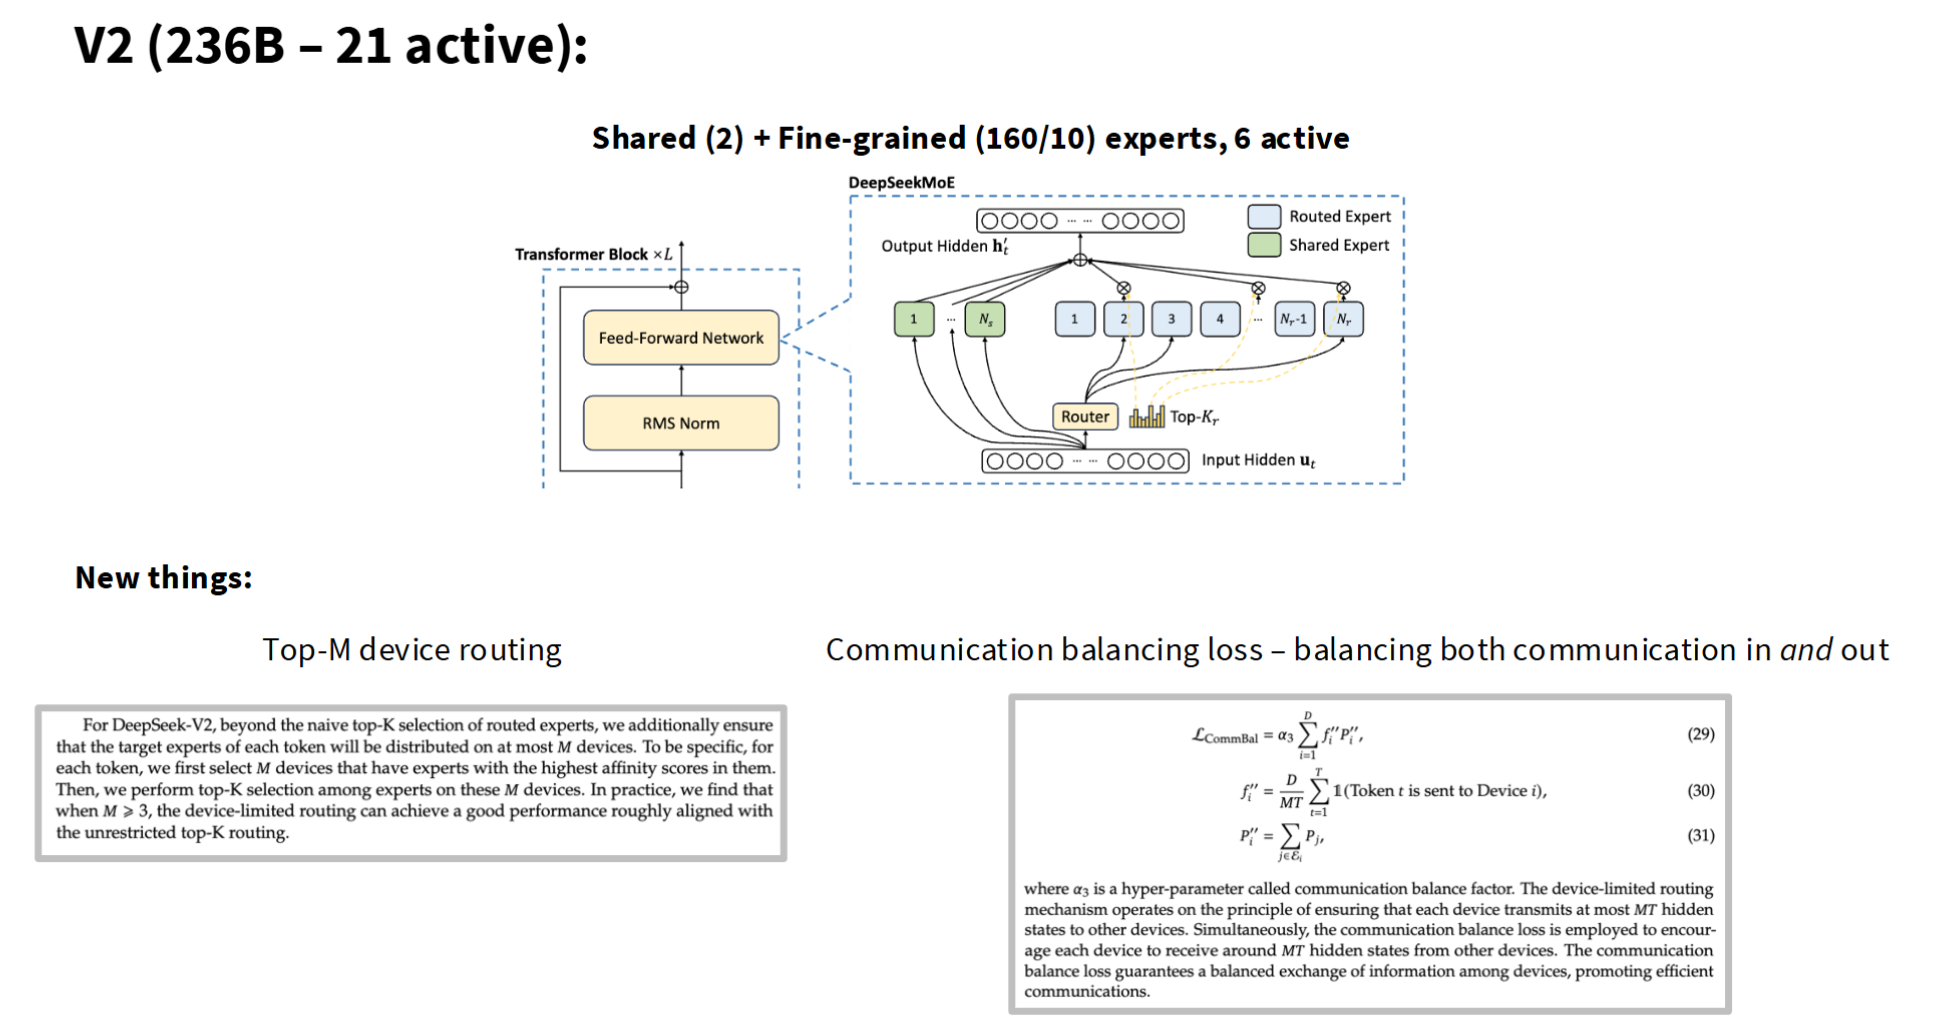
V2参数量增大,专家划分更细,160个专家,激活10个。
此外还有很多系统级别的优化:
- 比如topm的设备路由,对每个设备的得分,就是这个设备上的所有专家得分之和,据此选出得分前m的设备。对这些设备上的专家,再做topk专家路由。这样的好处是,最后选出来的topk的专家,一定是在不超过m个设备上的,MoE的all-to-all通信量是和设备数成二次方关系的,限制设备数可以优化通信,提高吞吐。
- 设备负载均衡,不以专家为单位,而是以设备为单位计算负载均衡loss,这强迫模型学习如何在设备间负载均衡。
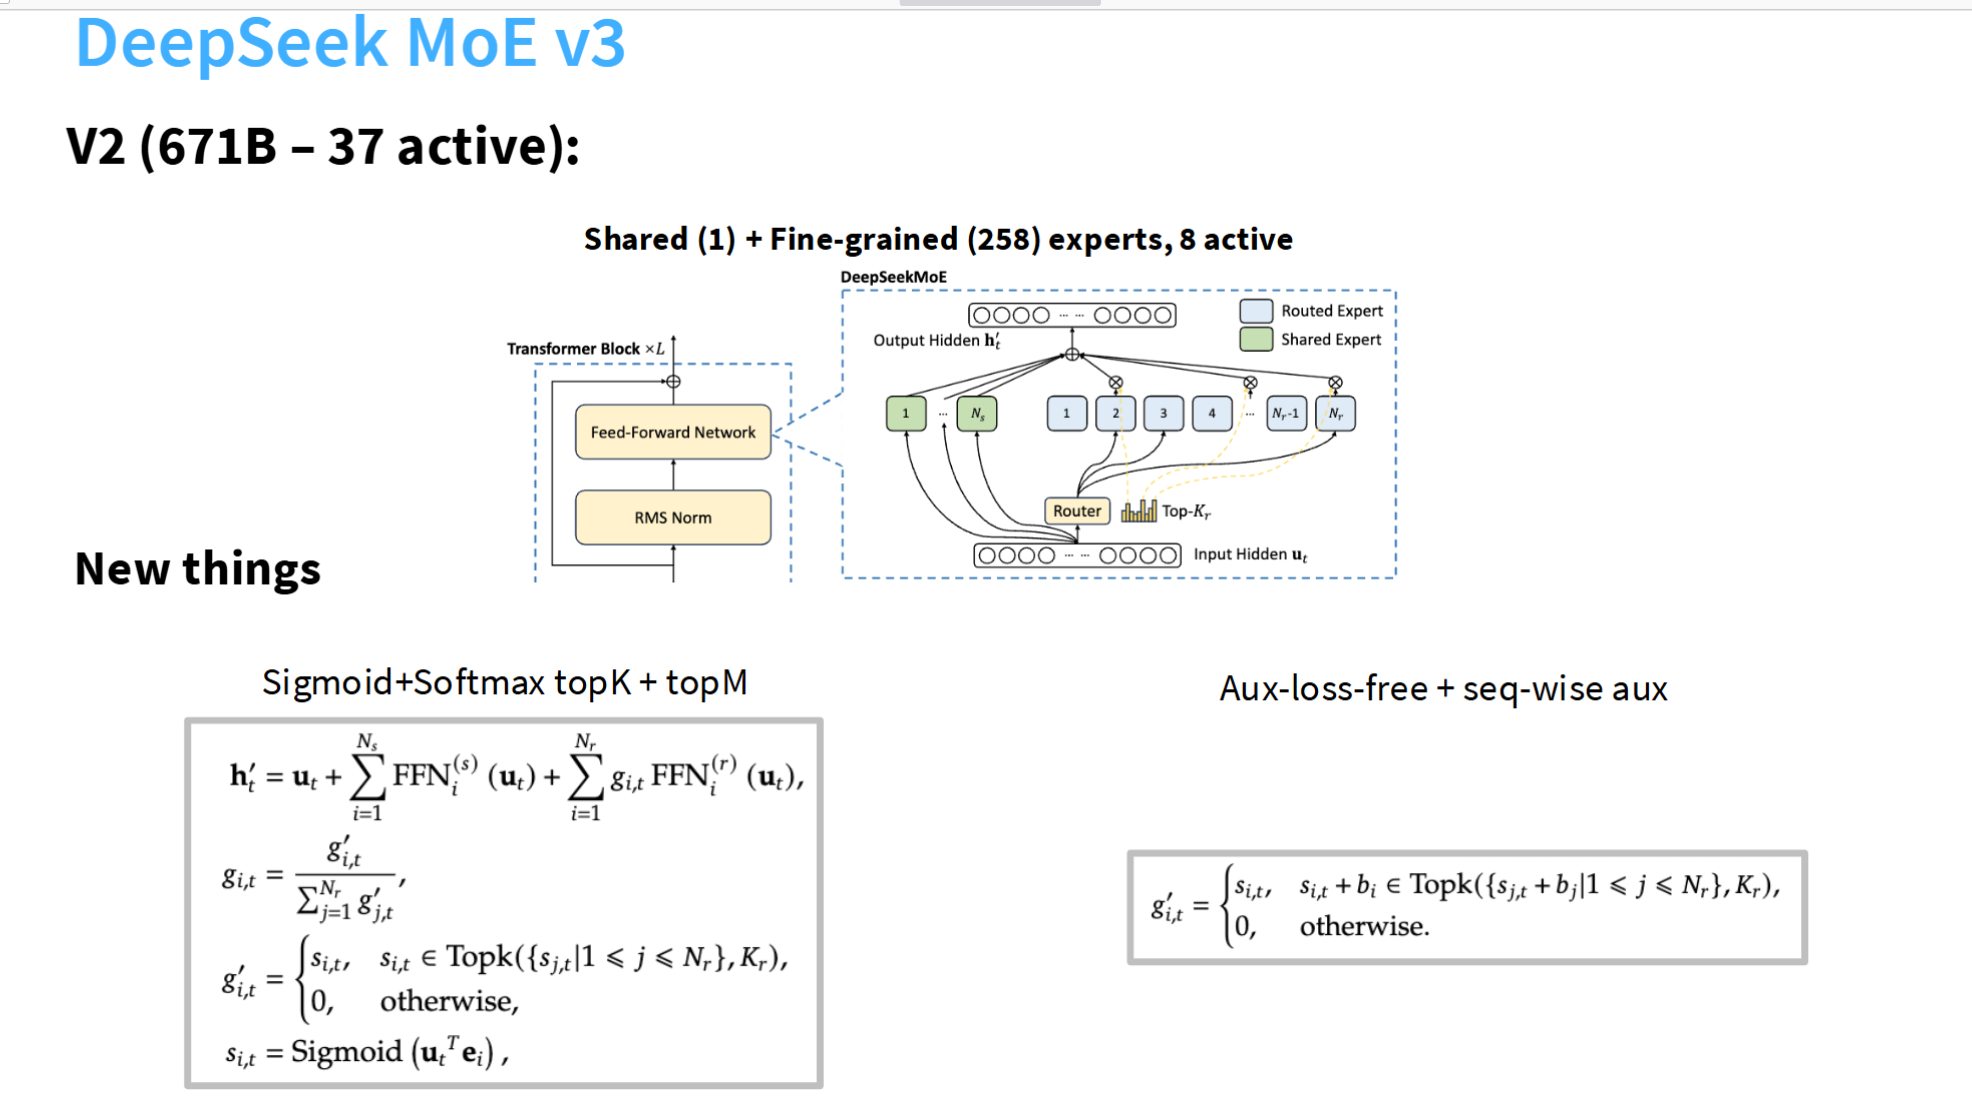 V3专家力粒度进一步细分,258个专家激活8个。
在topk阶段,把专家打分的softmax换成了sigmoid,因为softmax中,每个人的得分都是和其他人分数相关的,给一个专家分数提高,会挤压其他专家的分数,容易导致赢家通吃,负载不均。而sigmoid每个专家的分数都是独立计算的。
另外去掉了aux-loss(辅助损失),也就是loss里的负载均衡项,改为一个偏置项b,如果一个专家这轮负载过重了就减小b,这也可以实现负载均衡,但不动loss项,不会让模型为了负载均衡,强行把token塞给不合适的专家。
当然还保留了一点负载均衡loss,不过不是在token级别的了,而是在序列级别的,也就是处理一个序列,各个专家之间需要负载均衡。
MLA
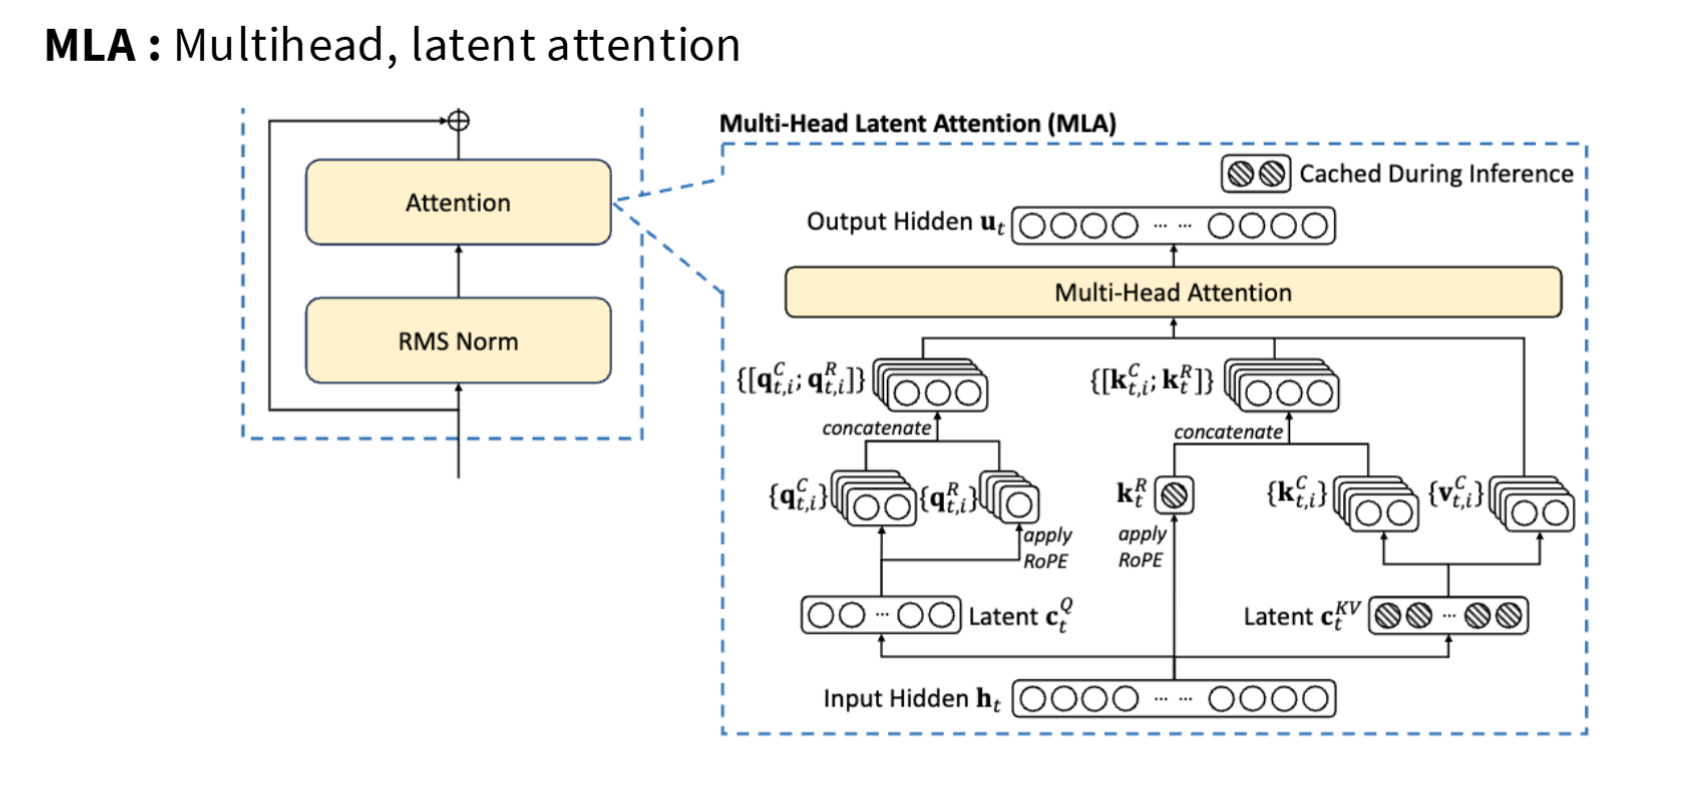
另外,V3的另一个优化是MLA,多头潜在注意力,这和MoE没啥关系但也是个重要的优化。核心思想是推理过程中一个经典优化是KV Cache,但是cache很占显存,想要压缩cache大小,于是考虑把kv cache做一个下采样,压缩到一个潜空间(latent space),存入显存,使用时再上采样解码。
这能带来显存优化,从而可以跑更长的上下文,更大的模型,同时减少搬运量还能优化吞吐。另外,惊喜的是这样似乎还能优化模型表现,这可能是因为kv cache有冗余信息,多加了两层下采样,下采样,让模型学会了提取最重要的信息。
MTP
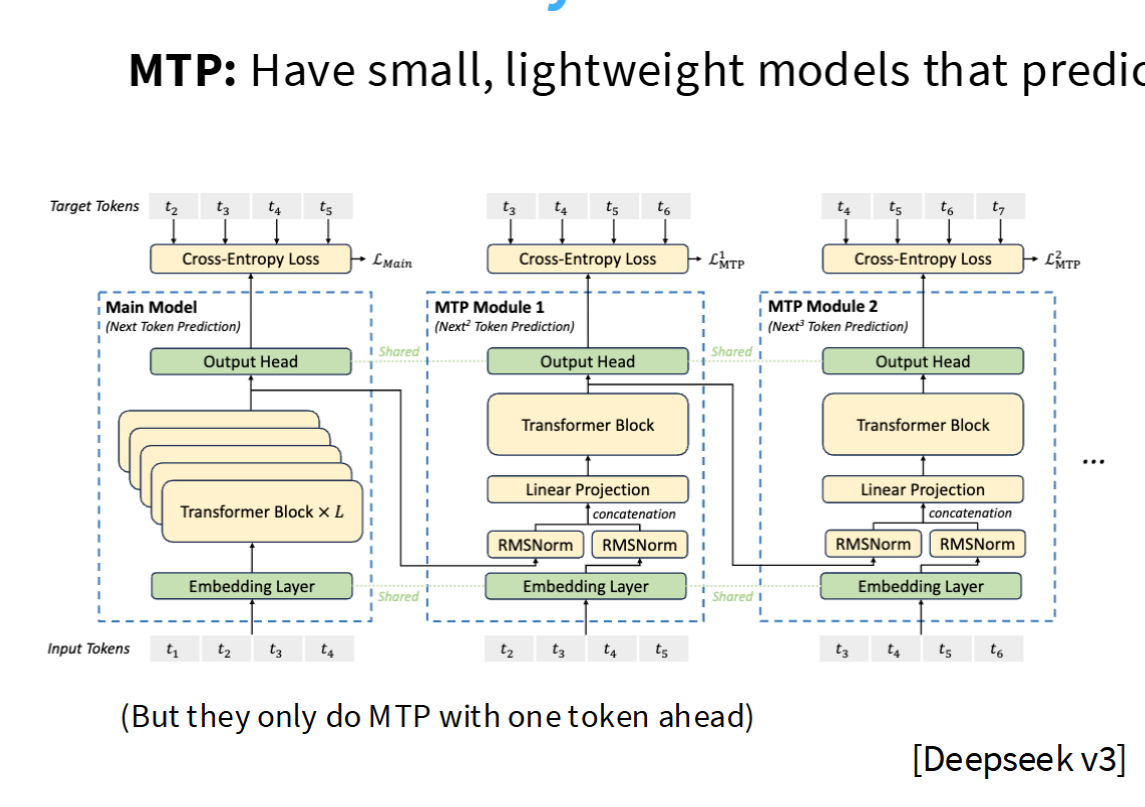
另一个优化点是MTP,在主要的大部分注意力block结束后,最后接几个简单MTP block,每层基于前面的结果预测一个token,这样一次完整的前向传播可以预测多个token