17 份异构销售数据的合并清洗方案:30 万行处理耗时 9.64 秒
月底汇总时,各分公司提交的 17 份销售表格式各异:文件类型涵盖 .xls、.xlsx、.csv 三种,同一字段存在 9 种命名方式,日期格式亦不统一。采用人工方式合并,单次耗时约两小时,且难以核验输出结果的完整性。
采用脚本处理后,全流程耗时 9.64 秒,且每一行数据的取舍均可追溯。
本文记录该方案的实现过程,以及开发阶段遇到的 6 个问题。
一、问题背景与处理结果
需求:将 17 份销售数据合并为一张可直接用于透视分析的标准总表。
人工处理方式通常为逐文件复制粘贴、人工核对字段名、手动调整日期格式。面对 30 万行规模的数据,不仅耗时较长,且输出结果的完整性缺乏有效核验手段。
程序化处理结果如下:
- 读入 301,564 行,输出 263,454 行,处理耗时 9.64 秒
- 字段命名自动统一、日期格式自动归一、缺失数据与重复数据自动剔除
- 全流程打印处理明细,各项数字均可追溯;最终执行数字自洽校验
263454 + 37947 + 163 = 301564,校验不通过则程序终止并拒绝输出结果
运行环境:Python 3.14 / pandas 3.0.6 / Windows 兼容范围:Python 3.9 及以上、pandas 2.2 及以上 已在两套环境实测通过:Python 3.14 + pandas 3.0.6、Python 3.9 + pandas 2.2
依赖清单
shell
pandas>=2.2
charset-normalizer>=3.0      # CSV 编码识别
xlrd>=2.0                    # 读取老式 .xls
xlsxwriter>=3.0              # 输出 Excel
python-calamine>=0.2 # 读取 .xlsx / .xls| 包 | 实际用途 | 引入方式 |
|---|---|---|
pandas |
数据处理主体 | 直接 import |
charset-normalizer |
CSV 编码识别 | 直接 import |
python-calamine |
读取 .xlsx / .xls |
通过 engine= 指定 |
xlrd |
读取老式 .xls |
通过 engine= 指定 |
xlsxwriter |
输出 Excel | 通过 engine= 指定 |
说明一:为什么后面三个包必须手写进清单。
engine="calamine"这类参数是字符串而非 import 语句,pipreqs等自动工具扫描不到,生成的清单会漏掉全部引擎包。漏包的后果不会在本地暴露------本机依赖已装全------只会在他人环境运行时报错。因此 Excel 读写相关的引擎依赖,必须手工补入。说明二:读取环节的选型。
python-calamine基于 Rust 的 calamine 库,读取速度明显优于纯 Python 实现,且一种引擎通吃.xlsx/.xls两种格式,无需分别维护。这是 30 万行数据能在 9.64 秒内处理完成的原因之一。xlrd保留用于老式.xls的兼容场景。说明三 :依赖清单建议用
pipreqs --mode no-pin生成后再手工补全引擎包,避免写入与本机不符的版本号。
二、数据质量问题
该批数据存在以下五类问题,异常数据规模如下。
1. 文件命名与类型不统一
10月份销售.xls           sales_05.xlsx            销售数据_01月.xlsx
11月份销售 - 副本.xlsx    (该文件为空文件)
销售数据_补充_BOM.csv     销售数据_补充_GBK.csv      (两个 CSV 文件编码不一致)
2. 同一字段存在多种命名方式。以金额字段为例,17 个文件中共出现 9 种写法:
scss
销售额、销售金额、金额、金额(元)、营业额、amount、sales、revenue、gmv日期字段存在「日期 / 销售日期 / 订单日期 / date」等写法,地区字段存在「地区 / 大区 / 区域 / 省份」等写法,各有八九种变体。
3. 日期格式不统一 :2024年12月13日、2024.12.13、2024/12/13 等多种格式并存。
4. 数值列夹杂文本内容:金额列中包含「暂无」「-」「N/A」等非数值内容。
5. 地区名称带有注记:「华东(大区)」与「华东」指向同一地区,若不作处理将被拆分为两个分组。
异常数据规模统计:
| 问题类型 | 行数 |
|---|---|
| 金额无法解析 | 24,071 |
| 数量无法解析 | 15,054 |
| 关键字段缺失(去重后合计) | 37,947 |
| 完全重复记录 | 163 |
说明一:金额异常与数量异常存在重叠,其中 1,178 行两个字段同时异常,去重后仅计一次,故关键字段缺失合计为 37,947 行,不等于 24,071 与 15,054 之和(39,125)。
说明二:本批数据的缺失集中于金额与数量两个字段,日期、地区、产品三个字段无缺失记录。
关于数据分布的说明
本批数据的行数分布并不均衡:
| 构成 | 行数 | 占比 |
|---|---|---|
| 10 月份文件 | 300,000 | 99.48% |
| 其余 15 份合计 | 1,564 | 0.52% |
其中 10 月份的单份数据量为其余各份平均值(约 104 行)的 2,877 倍。该构成是为验证脚本在大数据量下的处理表现而设定的,并非真实业务分布。
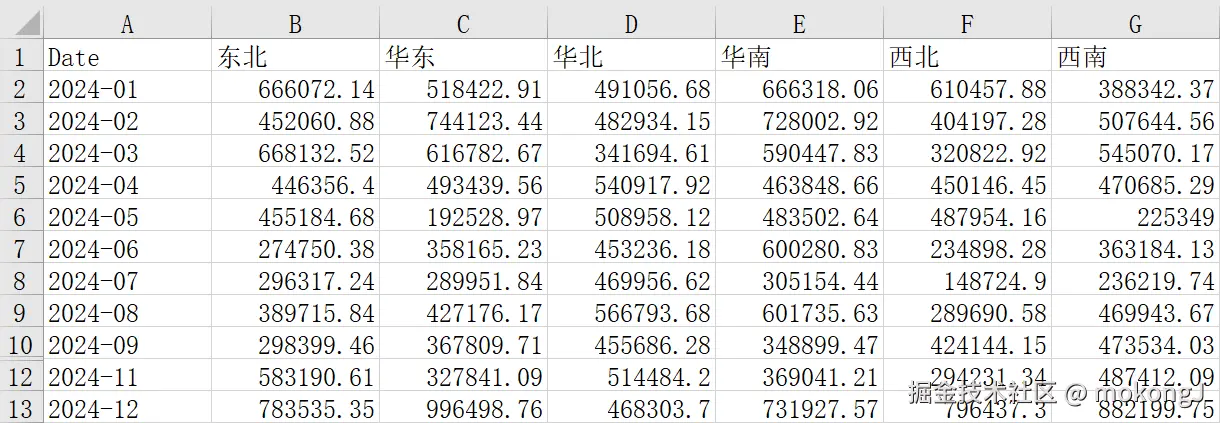
此处引出一个值得注意的结论:**数字自洽校验只能保证账目平衡,无法识别数据本身的业务异常。**在本例中,10 月份数据量异常这一问题并非由校验逻辑发现------因为 300000 + 1564 = 301564 完全成立,账目是平的;这一问题是在观察透视表分布时才暴露的。
因此,数据质量报告需要与可视化结果交叉验证:前者回答「有没有丢数据」,后者回答「数据是否合理」,二者缺一不可。
三、处理方案
整体流程分为六步,核心思路为:先统一、再合并、后判重,每一步保留处理明细。
1. 遍历目录并按扩展名分派读取
遍历时过滤两类文件:Excel 打开过程中生成的 ~$ 临时文件,以及扩展名不属于 .xlsx / .xls / .csv 的文件。
每个文件的读取操作单独以 try/except 包裹------单个文件损坏不应中断整批处理,失败文件名记入清单,最后统一提示。
python
for file_path in sorted(input_dir.iterdir()):
    if file_path.name.startswith("~$"):
        continue                       # Excel 临时文件
    if file_path.suffix.lower() not in (".xlsx", ".xls", ".csv"):
        continue
    try:
        df = read_any(file_path)       # 按扩展名分派读取
    except Exception as e:
        failed.append((file_path.name, str(e)))
        continue
    frames.append(df)
2. 字段名标准化与别名映射
各文件列名先经 norm() 函数标准化:去除首尾空格、空格 / 下划线 / 短横线、括号及括号内内容,并统一转为小写;随后通过别名表将金额字段的多种写法映射至标准名 Amount。
python
def norm(s):
    s = s.strip()
    s = re.sub(r"[\s_-]", "", s)          # 去除空格/下划线/短横线
    s = re.sub(r"[((].*?[))]", "", s)    # 「金额(元)」->「金额」
    s = s.lower()
    return s

alias = {  # 标准名 -> 别名列表(节选)
    "Amount": ["销售额", "销售金额", "金额", "营业额", "amount", "sales", "revenue", "gmv"],
    ...
}
由于 norm() 已剥离括号内容,「金额(元)」会被规范化为「金额」,故别名表中无需单独列出该写法。
需注意两点:
norm()会移除下划线,若别名表中使用order_date这类带下划线的英文名,将无法与实际列名orderdate匹配。别名表中的英文写法应统一为无下划线形式。- 比对时须对两侧同时 施加
norm()------只规范化实际列名、而不处理别名表,同样会导致匹配失败。
3. CSV 编码自动检测
GBK 与 UTF-8-BOM 两种编码并存,采用 charset_normalizer 自动检测编码,而非人工指定:
python
encoding = from_path(file_path).best().encoding
df = pd.read_csv(file_path, encoding=encoding)
4. 日期格式归一
先将「年 / 月 / . / /」统一替换为 -、去除「日」字符,再按固定格式解析;解析失败的值置为 NaT 并计数(本批数据解析失败 0 行):
python
merge_df["Date"] = pd.to_datetime(
    merge_df["Date"].astype(str).str.strip()
      .str.replace(r"[年月./]", "-", regex=True)
      .str.replace(r"日", "", regex=True),
    errors="coerce", format="%Y-%m-%d",
)
一个易被忽略的陷阱 :上述写法假设日期列是字符串。若某个文件的日期列已是 datetime 类型(Excel 中设为日期格式时常如此),
.astype(str)会得到2024-12-13 00:00:00,与format="%Y-%m-%d"严格不匹配,整列会被静默置为 NaT。规避方式有两种:读取时对日期列统一指定
dtype=str,或在转换前截断时分秒部分:
python.str.slice(0, 10) # 仅保留前 10 位,兼容带时分秒的情形由于本方案对解析失败数做了计数并打印,一旦发生上述整列失效,计数会立刻暴露异常,不会无声通过。
5. 清洗顺序的设计
该环节的执行顺序不可随意调整:
- 地区名归一化(「华东(大区)」并入「华东」)须置于去重之前------顺序颠倒将导致此类记录无法被识别为重复
- 数值列须先经
pd.to_numeric(errors="coerce")将文本转为 NaN,缺失剔除环节才能完整覆盖这些记录 - 上述两项完成后,再依次执行
dropna(剔除关键字段缺失行)与drop_duplicates(剔除完全重复行),每一步均记录剔除行数
6. 数字自洽硬校验
python
if total_rows != rows_after_drop_dup + dropna_rows + rows_drop_dup:
    sys.exit("合并后数据行数与原始数据行数不一致,终止处理")
校验逻辑为:读入行数 = 输出行数 + 缺失剔除行数 + 重复剔除行数。校验不通过则终止程序,不输出未经核验的结果。
四、开发阶段遇到的 6 个问题
问题 1:数量列输出为 17.0。 列中一旦出现 NaN,pandas 会将整列推断为 float 类型,整数显示为 17.0。处理方式是使用可空整数类型(注意首字母大写):
python
merge_df["Quantity"] = merge_df["Quantity"].astype("Int64")问题 2:金额列求和结果异常。 「暂无」「-」属于文本而非缺失值,直接调用 df["Amount"].sum() 将得到错误结果。须先执行 pd.to_numeric(errors="coerce") 将文本转为 NaN 后再计算。经验总结:isna() 无法识别此类伪缺失值,必须先转换再统计。
问题 3:Excel 临时文件被误读。 Excel 打开文件时会在同目录生成 ~$ 开头的临时文件,读取该文件既无意义也可能报错。处理方式为在遍历时增加过滤:
python
if file_path.name.startswith("~$"):
    continue
问题 4:空文件混于其中。 「11月份销售 - 副本.xlsx」为空文件。处理方式为明确打印「为空,跳过」并计入失败清单,既不静默忽略,也不中断整批处理。
问题 5:输出文件被占用。 上一轮生成的输出文件若正在 Excel 中打开,xlsxwriter 写入时将触发 PermissionError。处理方式为单独捕获该异常并给出明确提示,请用户关闭 Excel 后重新运行。
问题 6:如何证明 30 万行数据剔除 3.8 万行后不存在误删。
这是整个方案中最关键的一环。
删除数据本身不难,难的是向数据使用方证明:被剔除的每一行都有明确原因,留下的每一行都可追溯来源。仅依赖人工抽查无法完成这一核验------30 万行的体量下,抽查既覆盖不全,也无法复现。
本方案的处理方式是:每一步剔除操作均记录行数与原因,最终通过自洽校验串联全部数字。读入 301,564 行,输出 263,454 行,中间差额 38,110 行的去向逐项列明:关键字段缺失 37,947 行、完全重复 163 行,两者相加恰为 38,110,无一行下落不明。校验不通过则程序终止,绝不输出账目不平的结果。
该机制并非理论设计。在后续项目的开发中,它实际拦截过一次数据丢失------某次清洗逻辑调整后,自洽校验立即报错,经排查发现是新引入的过滤条件误删了有效记录。若没有这道校验,错误结果会直接交付出去。
**但自洽校验并非万能,需要明确它的边界。**它保证的是「账目平衡」,而非「数据合理」。本例中 10 月份单份数据 30 万行、占总量 99.48%,这一问题校验逻辑无法发现------因为
300000 + 1564 = 301564完全成立。业务口径层面的异常,只能通过与可视化结果的交叉验证来识别(详见第二节末尾的说明)。因此,一道自洽校验加上一张分布图,二者缺一不可:校验回答「有没有丢数据」,图表回答「数据是否合理」。
五、运行结果
执行 python clean_sales_data.py:
- 9.64 秒完成 16 个文件(17 份中 1 份为空文件已跳过)、301,564 行数据的合并清洗
- 输出
cleaned_sales_data.xlsx:包含明细数据 263,454 行与「月份 × 地区」销售额透视表两个 sheet,日期统一为YYYY-MM-DD格式,可直接排序与筛选 - 同步落盘
docs/数据质量报告.txt:记录读入行数、各原因剔除行数、输出行数,全部数字满足自洽关系
图 1|运行结果:控制台输出的处理明细,包含各文件读取行数、9.64 秒耗时与三项自洽数字。
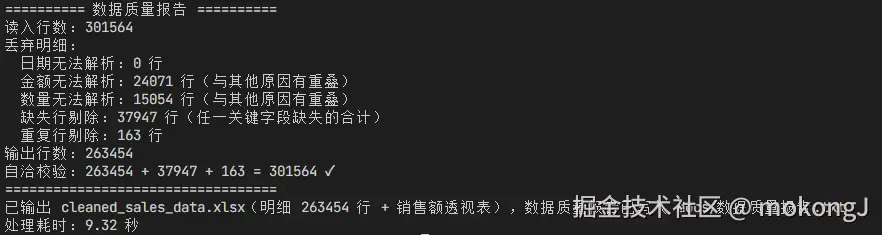
图 2|透视表输出(已排除 2024-10):10 月份单份数据 30 万行、占总量 99.48%,若纳入则其余月份在图上不可见。故此处筛除该月,以呈现其余 11 个月的真实分布;完整数据见仓库中的输出文件。
六、总结
复盘该项目,技术实现本身难度不高,真正具备价值的是三点方法论层面的结论:
- 先统一、再合并、后判重 ------ 处理顺序错误时,不规范数据会在错误的环节被遗漏,且事后难以察觉
- 每一行数据的取舍都必须可追溯 ------ 交付数据的前提是账目能够自洽,这既是技术要求,也是对数据使用方的责任
- 自洽校验有边界,须与可视化交叉验证 ------ 校验能证明「没有丢数据」,但无法证明「数据合理」;业务口径层面的异常,只有分布图能暴露
后续一篇将基于国家统计局 31 个省份的 GDP 数据展开趋势分析,聚焦地区排位变化与增速差异的背离现象,具体分析将在后续文章中介绍。
如有类似的多文件合并、数据清洗需求,欢迎交流:
- Gitee 仓库:gitee.com/ridgeline/s...
- GitHub 仓库:github.com/mokong-J/sa...
- 邮箱:1182618567@qq.com
- 微信:wx_mokong-J