Manus 之后,问「怎么学 agent 开发」的人突然多了起来。
但大部分人的第一课是从一个能跑通的 demo 开始的:给模型几个工具,写个 while 循环,跑起来了,很兴奋。然后要上线,发现真正的问题一个都不在模型上------是钱算不清、是状态丢了、是发布错配、是失败没有终点。
这篇文章分三段:先讲搭一个 agent 系统的方法(顺序很重要) ,再讲一个「理想态」长什么样(有判据,能自查) ,最后用我们自己的实践做案例,把原理剥出来。第三段里的每一个坑都是真的踩过的。
第一部分 · 方法:搭一个 agent 系统的八个步骤
一、先把 agent 拆成五个部件
「Agent」这个词被用得很糊。先把它的构成拆开,后面所有的讨论才有落点:
text
        ┌──────────────────────────────────────────────┐
        │  ① 能力(Capability)    能做什么             │
        │  ② 描述(Description)   怎么告诉模型能做什么  │
        │  ③ 循环(Loop)          谁来决定下一步        │
        │  ④ 上下文(Context)     模型每一轮看到什么    │
        │  ⑤ 边界(Boundary)      什么绝对不许发生      │
        └──────────────────────────────────────────────┘
                              │
                    模型 = 这五者的使用者,不是它们的替代品
一句话概括 agent 与「聊天机器人」的区别:
Chatbot 把自然语言映射成文字;Agent 把自然语言映射成一组受约束的动作,再把动作的结果喂回去继续决策。
这个区别决定了三个必然结果:
- 动作是有副作用的。 会花钱、会占资源、会对外产生真实产出。所以 agent 系统天生是「有状态的、要计量的、要能收尾的」。
- 循环是有次数的。 每一轮都是一次真实调用、一笔真实记录。没有上限的循环不是自主性,是事故。
- 动作的结果会回到上下文里。 所以「上下文里到底放了什么」和「动作到底做了什么」必须对得上,否则模型会基于幻觉做下一步。
二、八个步骤,顺序很重要
下面这八步的顺序不是随意的:后一步的不变式,往往由前一步的结构决定。很多团队是倒着来的------先写循环,再补工具,最后发现计费装不进去、状态恢复不了、失败收不了尾,只能推翻重来。
第 0 步:把「工具面」写成契约,而不是函数
工具是这个系统里唯一的对外能力接口,它必须是一份契约:
text
工具 = 名字 + 一句话它能干什么 + 参数结构(含类型、范围、枚举)+ 返回值结构 + 失败语义三条纪律:
- 名字是协议,不是实现。 发布出去就不能改(要么保留别名,要么新开一个)。
- 参数只收「意图」,不收「手段」。 让模型说「把这段音频从 30 秒切到 60 秒」,不要让模型拼 ffmpeg 参数------那是在给模型开一个远程命令执行的口子。
- 参数校验必须在执行侧再做一遍。 工具的参数是模型生成的,属于不可信输入。它不是「我们自己人传的」。
判据:如果这个工具的参数里出现了「命令」「脚本」「表达式」,说明工具面切错了。
第 1 步:决定循环的宿主------客户端还是服务端
这是最容易吵起来、也最该早点定下来的一件事。它不该由「哪端写着舒服」决定,而由三个问题决定:
| 问题 | 偏客户端 | 偏服务端 |
|---|---|---|
| 时长:秒级还是分钟级以上? | 秒级 | 分钟到小时级 |
| 存活:用户关掉页面,它还该继续吗? | 不该 | 该 |
| 确认:中间需不需要人点一下头? | 不需要 | 需要 |
三个都偏右边,循环就该做成服务端的状态机;三个都偏左边,循环留在客户端更划算(少一条推送通道,延迟最低,前端最简单)。
但真正的判据不是「长还是短」,而是「循环里有没有不可外包的东西」:
- 计费规则------比如「同一次请求里完全相同的调用只执行一次」(防重复扣费)。写在客户端就是一个可以被绕过的建议。
- 循环上限------客户端里的「最多 4 轮」只是一个常量,改掉就能无限循环,而每一轮都是真实的钱。
- 动作的真正执行------客户端可以是请求的发起者,但不能是能力的持有者。
判据:凡是「违反了就涉及钱、安全或一致性」的规则,都不属于客户端。
客户端可以驱动流程,但不能拥有不变式。
一个成熟的系统里这两种形态应该同时存在:一个三秒钟就结束的来回,硬搬到服务端,你得为它造一条「服务端→浏览器」的推送通道去传「我在调工具了」,把一条流拆成两条,纯亏。
第 2 步:先把对外协议冻结,再写实现
用户在循环里要看到的不是「最终答案」,而是过程:这一轮开始了吗?模型说了什么?它要调哪个工具?工具返回了什么?哪一步失败了?
这些过程的最小集合,就是你的对外协议。先把它写成一张表:
text
事件名 / 数据体的键(含顺序)/ 各自在什么时机发 / 前端拿它做什么三条纪律:
- 事件名和数据键是对外契约。 一旦发布,改一个键名就是一次破坏性变更。键的顺序也管住------JSON 的键序在抓包里看得见,乱序会让每次排查对比都出现无意义的 diff。
- 过程事件的数量要克制。 每加一种事件,前端就多一条要处理的分支、多一处要测的路径。够用就好。
- 别把「模型的原始输出流」直接当协议。 上游的流式分片形状是各家不一样的,把它透出去等于把上游的实现细节焊死在你的前端里。
第 3 步:定上下文------历史必须能被「重建」
模型每一轮看到的 messages,是它做决策的唯一依据。而一个多轮 agent 的消息序列里,除了 user/assistant 之外还有第三类:
text
user       用户说了什么
assistant  模型说了什么(其中可能带 tool_calls)
tool       每个 tool_call 的执行结果(必须与 tool_calls 一一对应)
这里有一个隐蔽的硬约束:消息序列必须合法。 有 tool_calls 就必须有对应的 role:tool 回复,否则下一轮请求会被上游直接拒绝。于是:
- 如果一次执行中途失败/被中断 ,你只追加了部分工具结果------这时要么把这一轮的往返整体丢掉,要么把缺的结果补齐成一条「已取消」 ,绝不能留下悬空的
tool_calls。 - 反过来,刷新页面后能不能把历史重建出来,是这套设计成不成立的试金石。 如果只有内存里的消息数组才对,那说明你的上下文层没有真正落库。
判据:把服务重启一次、把浏览器刷新一次,看 conversation 还能不能接着聊。 能,说明上下文是数据;不能,说明它是变量。
落库的形状也有讲究:一条工具结果写进库时,必须是结构化的 ({toolCalls:[...]} 这种明确的信封),不能是「一个裸数组」或者 Map.toString()。因为读取方要靠它重建消息,格式一漂移,重建出来的历史就是残的------而且不会报错,只会静默少一条。
第 4 步:定边界------三条不变式,必须在服务端
一个要花钱的 agent,至少有三条不变式:
不变式一:额度不能透支。 做法是「准入 + 冻结」:在一条原子 SQL 里同时完成「检查余额」和「占用额度」。
sql
UPDATE credit_service SET credit_frozen = credit_frozen + ?
WHERE md5 = ?
  AND (credit_limit < 0 OR credit_used + credit_frozen + ? <= credit_limit)
影响行数为 0 就是余额不足。注意这里的写法:检查与占用在同一条语句里,中间没有窗口。
不变式二:实扣 ≤ 冻结。 最好的做法是让它成为数学结论 ,而不是一条断言------冻结按上限算,结算时「释放整笔冻结、只加实扣」,于是「结算扣款失败」在算术上不可能发生。
能靠构造消除的错误,不要靠断言去拦。
不变式三:上限与幂等。 「最多几轮」「同一个动作重复出现只执行一次」「并发点击只产生一份账单」------都属于安全边界,全部放服务端。
第 5 步:定失败语义------每一种失败都要有终点
这是最容易被忽略、也最容易变成「资源泄漏」的一步。agent 系统里的失败至少有六类,每一类都要有一个明确的、有终点的归宿:
| 失败 | 归宿 |
|---|---|
| 模型调用失败 | 这一轮标记失败,释放这一轮的冻结,告诉用户 |
| 模型返回空(一个字都没有) | 不能当成功,走「没有返回内容」分支 |
| 工具执行失败 | 把失败当成结果回灌给模型,让它自己决定改参数重试还是向用户说明 |
| 中断(用户点了停止) | 已经花掉的不退,没开始的绝不再执行 |
| 重试耗尽 | 必须有一条兜底的过期清理:把记录判死、释放资源、给出明确失败 |
| 进程重启 | 没有终点的那些必须有一个「超时即判死」的兜底 |
判据:任何「靠重试往前推进」的机制,都要问一句「它永远推不动的时候,谁来收尸」。 答案不能是「不会发生」。
第 6 步:定观测------一轮一条记录
把「每一次模型往返」落成一条可查询的记录,而不是只打日志。这条记录要能回答:这一轮花了多少、什么状态、模型看到了什么、它决定做什么、工具返回了什么。
好处是复利的:
- 计费有据:额度是挂在记录上的,不是挂在内存里的。
- 排查有据:用户说「我那次没出结果」,你查记录,而不是求他复现。
- 恢复有据:刷新后的重建、重启后的对账,都从这张表来。
不要在记录之外另建「UI 状态表」。 任务卡的标题、阶段、产物、按钮状态,都挂在记录的一个可扩展结构字段 (JSON)里。代价是要容错------结构是弱类型的,格式一定会漂移,所以读取侧解析失败时降级(退化成「只有状态」),而不是让整个查询报 500。
弱类型不是问题,对弱类型不做容错才是问题。
第 7 步:定演进规则------把「同源」的东西放进同一条流水线
三条规则,每一条都是我们踩过之后写的:
-
描述能力的东西,必须和交付能力的东西同批发布。 工具表和系统提示词是一对(提示词说「你支持 X」,工具表里却没有 X,模型就会告诉用户「平台不支持」)。前端校验和服务端校验是一对。分开部署的两样东西,迟早会被分开部署------这不是纪律问题,是结构问题。修法只有一个:让它们在结构上无法分家,走同一个入口注入、同一批发布。
-
要改语义,就开新类型,不要给老类型加字段。 老消费者的校验通常只拦「字段不够」,不拦「多余」,于是多余字段被静默接受 ,然后照旧逻辑做一遍 ------结果是最坏的一类 bug:不报错,但做错事。
凡是「旧版本会静默接受并做错」的演进路径,都要改成「旧版本显式失败」。
-
给「描述」加版本号。 提示词是会被不断修改的资产,而它一旦改动,行为就会变。给它一个版本号,让「这次上线到底改了哪一版提示词」有据可查。
第二部分 · 理想形态:一个「好」的 agent 系统长什么样
方法讲完了,接下来给一把尺子。下面是十条特征,每一条都能直接自查。
三、正面清单:十条特征
1. 能力的所有权在服务端。 加一个新能力不需要发客户端------移动端不用等审核,小程序不用等发布,老版本用户也不会被告知「不支持」。
2. 描述与实现同源。 提示词和工具表走同一个入口注入、同一批发布,结构上不可能错配。
3. 能力注入是可判定、零侵入的。 一个通用的 LLM 代理被 agent 复用时,凭什么判定这是 agent 的请求 必须由结构化标记决定(比如请求里已有的一个 client 字段),而不是嗅探内容;不是目标调用方时,一个字段都不能被改动------并且这条约定要用测试锁住。
4. 过程是可感知的。 用户永远知道现在在干什么:第几轮、模型说了什么、正在调哪个工具。黑箱超过十秒,用户就会以为它挂了。
5. 状态是可恢复的。 刷新页面、重启进程,对话还在,任务还在。做不到这一点的系统,本质上是个玩具。
6. 循环是有界的。 轮数上限、单轮超时、整体超时,三者都有,且都在服务端。
7. 钱是算得清的。 每一次往返都有记录、有预冻结、有结算;「实扣 ≤ 冻结」是数学结论而不是断言。
8. 失败有终点。 每一类失败都有归属,没有「永远转圈」的状态。
9. 上下文是数据,不是变量。 它的形状被约束住(消息序列合法、工具结果结构化),并且能被重建、能被回放。
10. 演进是显式失败的。 协议改语义就开新类型;描述与实现同批发布;每个演进动作都能回滚,而不是被静默接受。
四、反面清单:demo 级 agent 的十个症状
同样的尺子,反过来量。下面这些症状,命中两条以上,说明它还只是一个 demo:
| # | 症状 | 后果 |
|---|---|---|
| 1 | 工具表、提示词写在前端 | 加能力要发版;老客户端用不了新能力 |
| 2 | 循环只在内存里 | 刷新即失忆;重启即丢任务 |
| 3 | 没有轮数上限,或者上限在客户端 | 一次误触烧掉一片额度 |
| 4 | 不落库,或落库只记「成功」 | 排查无从下手,计费无据可查 |
| 5 | 失败只有一句「出错了」 | 余额被冻结、任务永远在转圈 |
| 6 | 模型返回空被当成功 | 用户什么也没看到,也没人报错 |
| 7 | 工具参数直接拼进 shell | 一个提示注入就是一次远程命令执行 |
| 8 | 工具结果用 toString() 落库 |
重建出来的历史是残的,还不报错 |
| 9 | 中断只在客户端生效 | 用户已经点了停止,服务端还在替他下单、冻额度 |
| 10 | 上下游不设超时,或超时语义搞错 | 长生成被误杀,或者一个卡死的连接占住线程 |
第三部分 · 案例:我们把上面这些真的做了一遍
前三部分是「应该怎么做」,这一部分是「我们怎么做、以及付出了什么代价」。
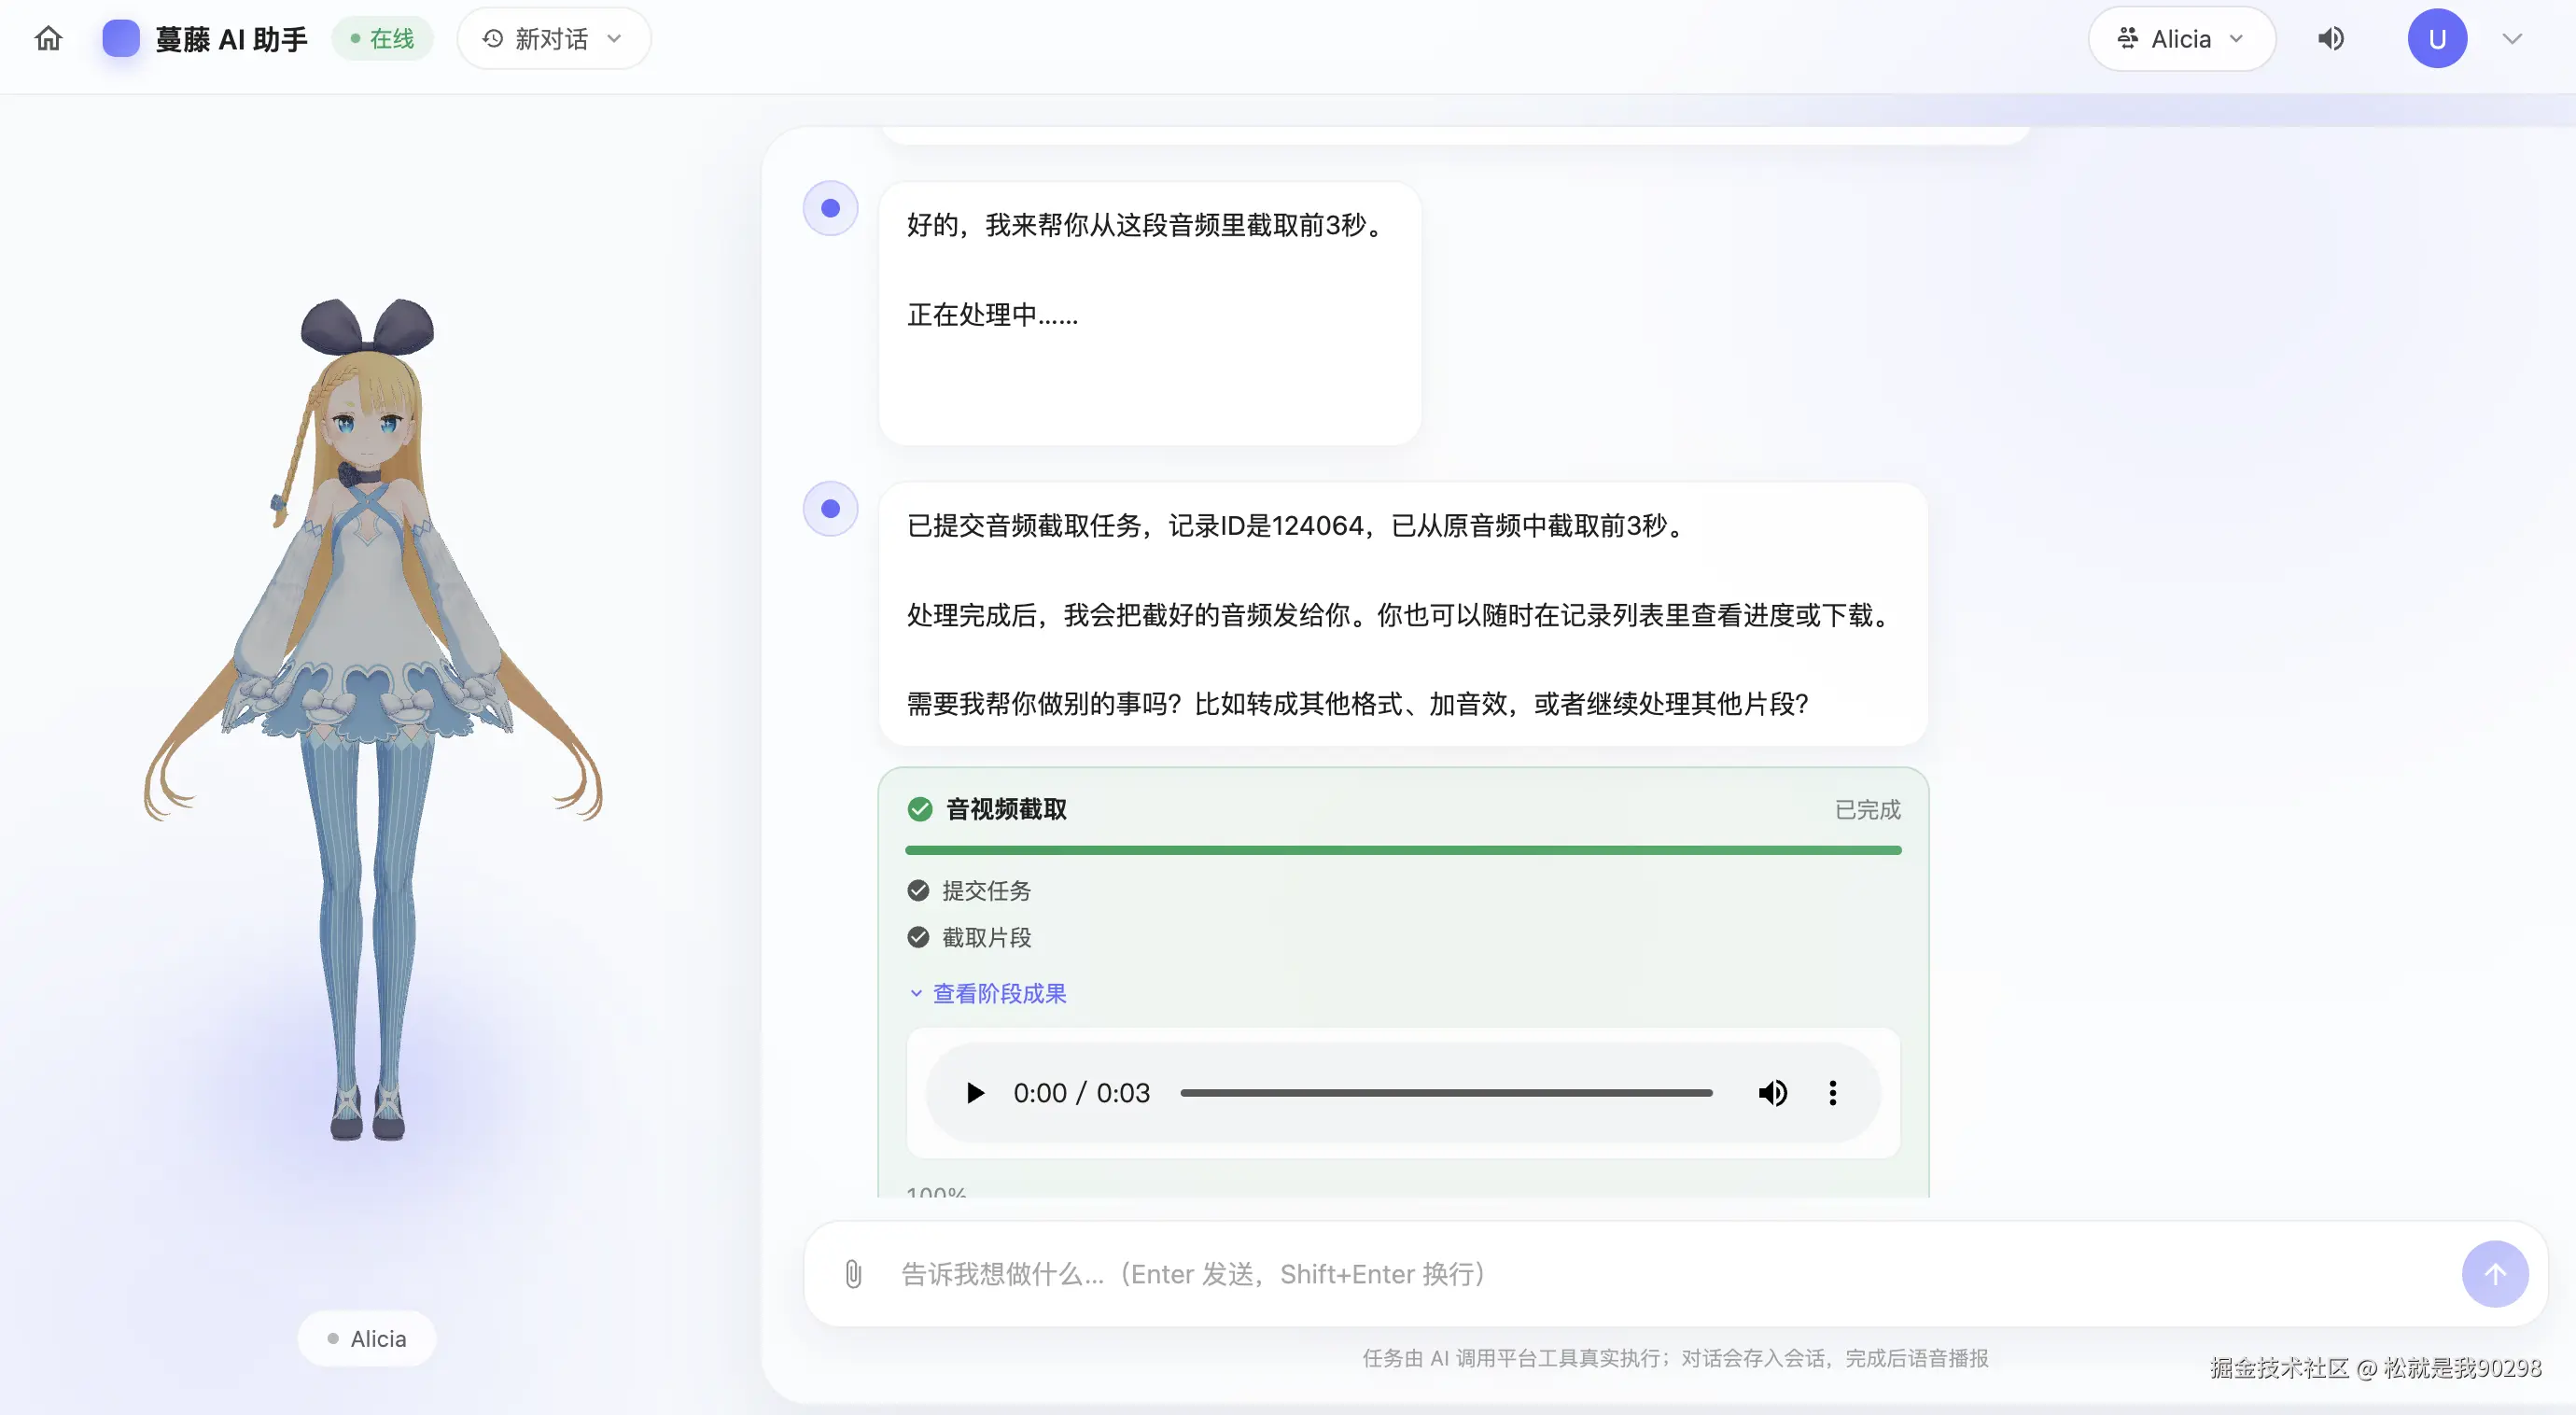
案例是蔓藤AI 数字人创作平台 的通用 AI 助手:用户上传音频、视频或 PPT,用一句中文说「帮我把这段前 30 秒转成 mp3」「把这份 PPT 做成一集讲解视频」,助手真的把任务提交下去、盯着它跑完、把产物挂回对话里。
这个场景有三个特点,正好把第一部分讲的东西全部逼了出来:
- 所有能力都是分钟级的异步任务(语音合成、人声分离、音色转换、音频剪辑、视频剪辑、PPT 讲解视频)。没有一个能在 HTTP 请求里同步跑完。
- 每一个任务都要花钱(按时长/次数计费,提交即冻结额度)。
- 模型面对的是「生成的文件」,不是「生成的文字」。用户要的是那个能播的东西。
五、全貌
text
浏览器(Vue3)
  │  ① POST /agent/turns        { sessionId, content }        ← 整个请求体只有这两个字段
  │  ② ▲ SSE:round / assistant / tool_call / tool_result / error / done / [DONE]
  │  ③ GET  /agent/tools/status?recordId=...                    任务卡轮询(4s 一拍)
  │  ④ POST /agent/tools/confirm?recordId=...                   闸门确认
  ▼
后端(Spring Boot)------ agent 没有自己的服务,它长在现有的通用 LLM 代理里
  │
  ├─ AgentTurnController ──▶ AgentTurnService.startTurn ──▶ agentTurnExecutor(专用线程池)
  │        │
  │        └─ runTurn:一次用户发言 = 最多 4 轮
  │              每一轮:
  │                LlmExecutionOrchestrator.startExecution()   ← 落一行记录 + 冻结额度
  │                completeChatCompletionStreaming()            ← 上游流式,聚合成整条响应
  │                AgentTurnToolCalls.extract()                 ← 取 tool_calls
  │                串行执行每个工具(执行前检查中断)              → tool_result 事件
  │                completeExecution()                          ← 结算
  │
  ├─ AgentToolSupport.injectIfAgent()     仅当 metadata.client == "agent"
  │        ├─ AgentSystemPrompt.TEXT(542 字)+ VERSION   → 插到 messages[0]
  │        └─ AgentToolRegistry.openAiTools()             → 9 个工具的 OpenAI 声明
  │
  ├─ AgentToolExecutionService  工具执行的唯一入口(归属校验 + 参数解析)
  ├─ AgentTurnContextBuilder    从 interactive_record 重建历史
  └─ AgentToolController        任务卡读 / 闸门确认
  │
  │  sse_message(interactive_record 上的一列)
  ▼
worker(内网 GPU 主机)
     独立校验消息 → ffmpeg / 模型推理 → 回调后端 → 记录置终态 → 结算
这张图里最值得注意的一点 :agent 不是一个新服务。它是「一个已有的通用 LLM 代理」+「一个工具注册表」+「一段轮次循环」。agent 这一层自己的东西只有 1 个 controller、1 个 service、1 个注册表和 9 个工具类------其余全是复用:LLM 代理、计费、任务调度、SSE 通道、worker。
这是我们做的最重要的一个决定,也是这篇案例的主线。
六、八个关键决策(含代价)
决策一:循环放在服务端
第一部分给过三个问题,这个场景把它们一次性问清楚了:
- 时长:每一个动作都是分钟级的异步任务,没有一个能在一次请求里同步跑完。
- 存活 :用户关掉页面,任务该继续吗?------该,那个 PPT 讲解视频要跑十几分钟。
- 确认 :中间需要人点一下头吗?------需要,长链路在花钱之前要有个「试跑一下看看」的停顿。
三条都指向服务端。上限、去重、计费规则回到了不可绕过的位置;而「等用户确认」也没有被做成对话里的一次提问,而是记录上的一个状态(见决策八)。
但代价必须在动手之前就接受,而不是上线之后才发现的 :循环一旦放在服务端,你就欠了自己一条「服务端 → 浏览器」的推送通道,并且要在这条通道上显式回答四个问题------而这四个问题在客户端循环里是「免费」的:
text
① 过程怎么告诉用户?    → 一套过程事件(第七节那张表)
② 用户点了停止怎么办?  → 一条「不再产生新动作」的检查链
③ 连接还在但没人读了?  → 超时收尾,不能永远挂在 PROCESSING
④ 用户关掉页面走了?    → 这一轮照样要有终点(成功、失败、或者超时判死)
这四个问题不是实现细节,是这套架构的入场费。 一个只做了①②、没做③④的服务端循环,会比客户端循环更难收拾------因为它在用户看不见的地方占着线程、占着额度。
决策二:一次用户发言 = 一个 turn = 最多 4 轮 = 每轮一行记录
循环的每一次模型往返,都落一条独立的 interactive_record。
这不是为了好看,是为了三个「有据可查」:计费有据 (额度挂在记录上,不挂在内存里)、排查有据 (用户说「那次没出结果」,查记录而不是求他复现)、恢复有据(刷新重建、重启对账,都从这张表来)。
于是「一次用户发言」在库里是 N 行,每行都是可独立审计的一次往返;done 事件把这些行的 id 一并带回给前端:
text
done: { turnId: 1762..., rounds: 2, recordIds: [1001, 1002] }代价 :库里一行 ≠ 用户看到的一条消息。前端要把「一条用户输入 + N 条记录」重新拼回视图,而且顺序有陷阱------一轮里可见正文的记录 id 比工具记录大,一遍扫描看不见「未来的消息」,必须扫两遍。这个坑值得单独说,见第八节第 11 条。
判据:上限(4 轮)写在服务端,且是一个配置项;客户端里没有这个常量。
决策三:提示词和工具表,同一个入口注入
能力注入点只有一个,判据是请求里已有的一个业务字段:
java
// AgentToolSupport.injectIfAgent
if (!AGENT_CLIENT.equals(metadata.get("client"))) {
    return;   // 不是 agent 的请求:一个字段都不能动
}
messages.add(0, ChatMessage.systemMessage(AgentSystemPrompt.TEXT));
if (request.getTools() == null) {          // 只填 null,不覆盖调用方显式传的
    request.setTools(agentToolRegistry.openAiTools());
    request.setToolChoice("auto");
    request.setParallelToolCalls(Boolean.FALSE);
}
系统提示词只有 542 字 ,刻意只放三样东西:角色、语气、政策 (「说人话、别用 Markdown、素材让用户先传、做不到就说做不到、说『记录ID』别念 recordId」)。具体的参数、枚举、取值范围,全在各工具的声明里,不重复写第二遍。
理由很简单:参数写两遍就一定会不一致,而不一致的那一份会被模型当成事实。
代价 :一个通用的 LLM 代理里从此有了一个特例分支。所以必须用测试把「零侵入」锁住------断言非 agent 请求的消息数、tools、参数一个都不变。这类测试的价值不在覆盖率,在于它把一句口头约定变成了回归约束。
决策四:工具不是配置表,是服务端的一组声明
一个很自然的想法是「建一张 agent_tool 表,让工具可以热配」。我们没这么做,工具就是一组服务端的 bean,启动时由注册表收集:
java
public AgentToolRegistry(List<AgentTool> tools) { ... } // 重名 / 重复认领 service_type → 启动即失败九个工具:语音合成、人声分离、音色转换、音频处理、视频处理、PPT 讲解视频、任务查询、音色清单、形象清单。
好处在演进成本:加一个能力 = 加一个类 + 在提示词里改一句话,不需要发客户端,不需要改任何 DTO。代价是「改工具要发版」------但这正是我们要的(见决策三)。
注册表在启动时做两件事:重名直接抛异常 、两个工具认领同一个 service_type 直接抛异常 。这类错误的特征很典型------单测全绿,容器起不来,或者更糟:容器起来了,但收款的工具是另一个。
判据:「组件图能不能装配」不该靠人肉保证。 有没有循环依赖、有没有 bean 名冲突、有没有两个组件抢同一个标识------这不是逻辑问题,是图的问题,只有真的把容器装起来才验得到。
决策五:一轮一块,不逐字推
模型说的话按轮成块到达,不是逐字:
text
assistant: { round: 1, recordId: 1001, content: "好的,我来把前 30 秒切出来。" }三个理由:
- 这个产品的出口是数字人朗读。逐字推既没有意义,还会把文本抖动放大到语音上。
- 前端拼装变成一行
content += event.content,不需要处理「分片边界切断了半个字」。 - 上游的分片形状不外泄。上游一次吐几个字、按什么分片,是它的实现细节;把它透给前端,等于把你的前端焊死在某个供应商的流式协议上。
代价 :长回答的「等待感」更强。我们的补偿是过程事件 ------模型一旦决定要调工具,tool_call 立刻到,用户至少知道它在动。
决策六:钱------冻结按上限,于是「实扣 ≤ 冻结」是数学结论
准入是一条原子 SQL,同时完成「检查余额」和「占用」:
sql
UPDATE credit_service SET credit_frozen = credit_frozen + ?
WHERE md5 = ?
  AND (credit_limit < 0 OR credit_used + credit_frozen + ? <= credit_limit)
影响行数为 0 就是余额不足,抛业务异常------它是业务失败,原样回给模型,模型转告用户「额度不够了」。
冻结按上限 算(5 分钟 = 音频 750 / 视频 1500),结算做的是「释放整笔冻结、只加实扣」:
sql
UPDATE credit_service
SET credit_frozen = GREATEST(0, credit_frozen - ?),   -- 释放全部冻结
    credit_used   = credit_used + ?
WHERE ...
因为准入时已经保证 used + frozen + 上限 ≤ limit,结算时的准入守卫不可能失败------「结算扣款失败」在数学上被排除了。
能靠构造消除的错误,不要靠断言去拦。
代价:冻结按上限算,用户可用额度会短暂降低(可接受:上限本身就是 5 分钟,且任务跑完立刻释放)。
决策七:任务卡的状态挂在记录上,不另建表
任务卡要显示标题、阶段、进度、产物、一个「等用户确认」的按钮。我们没有建 agent_task 表,这些全在记录的一个 payload(jsonb)里:
json
{
  "toolKey": "edit_audio",
  "title": "音频处理",
  "detail": "截取 00:30 → 01:00,转 mp3",
  "stages":   [ { "id": "submit", "name": "提交任务", "state": "COMPLETED" } ],
  "artifacts":[ { "kind": "audio", "url": "https://.../out.mp3" } ],
  "checkpoint": { "after": "preview", "reason": "继续将生成完整视频", "confirmText": "确认,继续" }
}写入方(工具)和读取方(接口)之间只隔一个键名约定 。加一种「会报阶段的工具」,只需要把 payload 写对------不用改 DTO、不用给工具接口加方法、不用加列。
代价是必须容错 :结构是弱类型的,格式一定会漂移,所以读取侧解析失败一律降级成「只有状态」,而不是让整个查询报 500。
阶段这个字段还有两种用法:只给 id + name 时它是模板 (状态由前端按记录整体状态按下标推导,后端不假装知道更多);工具真的知道「第几页/共几页」时它是上报(前端以服务端为准)。
决策八:闸门是一个状态,不是一个问题
长链路(PPT 讲解视频)在花钱之前需要一个停顿。用对话实现是不可靠的------用户可能答非所问,模型也可能自己就继续了。
所以我们把停顿做成记录上的一个状态 :payload 里放 checkpoint,前端渲染成一个按钮,点击走一条确定的接口。推进的判定完全在工具里(含 CAS 并发保护------用户连点两下不该产生两份账单),接口只负责归属校验。
注意一个细节:确认失败返回 false 不是错误。用户对同一个闸门点两下、或点了已自动推进的任务,都会走这条路径,前端把按钮收起来就行。
七、两张必须冻结的表
7.1 过程事件(对外契约)
text
event: round
data: { "turnId": 1762..., "round": 1, "recordId": 1001 }

event: assistant
data: { "round": 1, "recordId": 1001, "content": "好的,我来把前 30 秒切出来。" }

event: tool_call
data: { "round": 1, "id": "call_1", "name": "edit_audio", "arguments": "{\"media_url\":...}" }

event: tool_result
data: { "round": 1, "id": "call_1", "ok": true, "toolKey": "edit_audio", "recordId": 1002, "stages": [...] }

event: error
data: { "round": 1, "recordId": 1001, "code": null, "message": "请先登录后再使用 AI 助手" }

event: done
data: { "turnId": 1762..., "rounds": 2, "recordIds": [1001, 1002] }

data: [DONE]
三条纪律,我们都写进了代码注释:
- 键名和键序都别动 (data 体一律用
LinkedHashMap,JSON 的键序在抓包里看得见,乱序会让每次排查对比都出现无意义的 diff)。 - 帧的格式手写 (
event: X\ndata: {json}\n\n),不用框架的 SSE 封装------这样「协议长什么样」只由一处决定。 [DONE]哨兵必须有。 前端靠它结束解析循环并主动cancel()掉读取流;没有它,一次异常收尾就可能让前端一直等下去。
7.2 记录表(对内契约)
text
interactive_record
  id / uid / service_type / prompt / status / result_url / quota / error_message
  retry_count / sse_message / session_id / turn_id / payload(jsonb) / ...
  索引:(session_id, turn_id, id)
status 复用平台已有的状态词表(QUEUE / PROCESSING / COMPLETED / FAILED / BLOCKED),不为 UI 另造一套------多一套词表,就多一处映射错的机会。
而 payload 有两个不同的形状 ,靠 prompt 是不是「带 model 的对话信封」来区分:
- 对话行:
{ "toolCalls": [ {id, name, arguments, result}, ... ] } - 任务行:
{ toolKey, title, stages, artifacts, checkpoint, ... }
重建历史只读前者,渲染任务卡只读后者。 这个区分不是设计出来的优雅,是被逼出来的------见下一节第 6 条和第 11 条。
八、十二个坑(这一节最值得看)
1. 能力的描述和能力的实现分家,产生了一次线上事故
现象:描述能力的提示词里写了「支持音频截取」,而交付这个能力的工具表里还没有。模型按工具表如实回答------「平台不支持这个功能」。用户看到的是「你们没有这个功能」,可实际上代码早就写好了。
根因 :不是「发版不仔细」,而是两样能被分开部署的东西,迟早会被分开部署。它们分处两个仓库、两条流水线,中间态就是必然的。
修法:让它们在结构上无法分家------提示词与工具表走同一个入口注入、同一批发布,客户端不持有任何一份能力描述。
原则:任何「A 描述 B」的配对,都要检查它们是不是同一条发布流水线。(提示词/工具表、文档/API、前端校验/后端校验。)
2. 声明与实现相反:告诉模型「可以并行」,代码却是串行
现象 :请求里 parallel_tool_calls=true,但轮次循环是一轮一个、执行完再下一个。
根因:默认值。字段不填时上游按自己的默认(并行)来,而我们想要的是串行。
修法 :显式填 false------不是删掉,是填 false 。因为请求体上是 @JsonInclude(NON_NULL),不给值等于不上报,上游就按并行来。
教训 :声明必须与实现一致。 声称能并行而实际排队,等于给模型一份从开始就不成立的行动计划。
顺带一个细节:只填 null,不覆盖。调用方显式传了就按它的来------代理对其他接入方的透明性是既有契约。
3. 模型一次返回两个一模一样的调用 → 下两笔单
现象:模型偶尔会一次返回两个完全相同的工具调用,于是提交了两个相同的任务、冻了两份额度。
修法 :同轮内按 name + arguments 去重,第二次不执行,把结果标上 duplicated 和一句说明回灌给模型:
text
"notice": "同一次请求里已经提交过完全相同的任务,这一条重复调用被忽略,不要重复提交"为什么必须回灌:只静默忽略的话,模型下一轮还会再试一次。
4. 用户点了停止,服务端还在替他下单
现象 :前端「停止」只做了 AbortController.abort()------断的是浏览器这一侧。而服务端的循环并不知道。
根因 :请求断了不等于业务该停。已发出的模型调用收不回来,但没开始的绝不能开始。
修法 :SSE 通道上维护一个 abort 标志(由 onCompletion / onError / onTimeout 置位),循环在三个检查点收手------每轮开始、每个工具执行之前、追加消息之后。
代码注释写得很直白:
停在这里而不是继续执行:用户已经点了停止,不能替他再下单冻结额度
注意这是 best-effort :已经发出的模型调用不可取消。这一点必须诚实------能保证的是「不再产生新动作」,不是「立刻回滚」。
5. 中断会让消息序列非法(悬空 tool_calls)
现象 :一轮里模型要调 3 个工具,用户在第 2 个之后中断。如果这时把 3 个 tool_calls 都写进历史,就会有 1 个没有对应的 role:tool 回复------下一轮请求会被上游直接拒绝。
修法 :只把已执行的那些追加进历史。
原则 :上下文是一个有合法性约束的结构,不是一串随便拼的文本。写入方必须保证「有 tool_calls 必有 tool 回复」。
6. 工具结果用错形状落库,读取时静默少一条
现象:工具结果先写成裸数组,重建历史时读不回来,被当成「这行没有工具链」。
根因 :弱类型字段没有 schema,读不到就是读不到,不会报错。
修法 :落库形状固定成 {toolCalls:[...]} 信封;读取侧对畸形数据整行退化成纯文本而不是抛异常。
7. 长生成不要压在非流式调用上
一个很常见的踩法 :上游用非流式 调(模型全部生成完才返回),同时给这条链路配了一个「读超时」当作保护。看起来没问题,实际上是把「多久没收到字节算卡住」的守卫,变成了「这一轮总共能生成多久」的预算------因为非流式下,从请求发出到第一个字节之间一个字节都没有。默认值通常是 60 秒,长一点的生成就会被误杀;而超时异常往往没有 message,用户看到的只是一句兜底的「请求失败,请稍后重试」。
正确做法 :这一层用流式 调用,在服务端把分片聚合成一条完整响应再交给业务层。业务层拿到的形状与同步调用完全一致,但它对「慢」的容忍度,从「整段生成的预算」变成了「空闲间隔」。
几个必须一起考虑的设计点:
- 聚合必须让调用方无感。 轮次循环要的还是「一条完整响应」(文本 + 工具调用 + usage),所以聚合发生在支撑层,下游一行不用改。
- 工具的 arguments 是分片流出来的 ,必须按
tool_calls[].index合并、把function.arguments的碎片按顺序拼成完整的 JSON。这是整件事里唯一真正新的逻辑------拼错了,工具就会收到半截 JSON,或者被归一化成空参数。 usage必须独立于choices取 :带include_usage的尾帧choices是空的,少了它,计费会静默地退化成估算。- 什么都没攒到时必须返回 null ,让「模型没有返回内容」那条失败分支保持可达。返回一个空响应会让空流静默地成功:用户什么也没看到,也没有任何人报错。
超时的计时对象也必须想清楚。 读超时如果挂在连接 上,而连接是复用的(连接池一般不会淘汰闲置连接),那么复用一条闲置了 X 秒的连接时,这次调用的有效预算只剩下「超时 − X」。按请求装、响应结束就卸,这个数才是确定的。
这条坑的普适版本是 :上下游之间的每一个超时,都要问清楚它计的是「整段」还是「间隔」。 计时对象搞错,长任务会被误杀,而且日志里只会留下一句空的超时异常。
8. 空流被当成成功
见上一条的最后一点。单独拎出来是因为它太常见:「没有报错」不等于「成功了」 。模型返回空、上游返回空(甚至只有 [DONE]),都必须走失败分支,同时释放这一轮的冻结。
9. 重启会丢什么:说清楚边界,比假装不丢更重要
进程重启会丢的是内存态:正在跑的对话消息(边跑边攒,不落库)、SSE 的活跃连接、进程内的派发队列(100 个槽位)。
但库里的每一轮记录都在。 卡在 QUEUE / PROCESSING 的行由超时兜底扫描收拾:超过 90 分钟无人认领或没人回调的,判 FAILED(原因写清楚:「任务处理超时」/「任务长时间未被执行,已自动终止」),并释放冻结额度。
这就是第 5 步说的「每一种失败都要有终点」的落地方式:不追求「重启不丢」,追求「重启后每一行都能收敛到一个终态」。
10. 回调不校验归属 = 用户可以给自己退款
现象 :worker 完成任务后回调更新记录。如果回调接口只按 id 写记录、不校验归属,那么任何登录用户提交一个别人的记录 id,就能把那个任务改成失败并触发退款。
修法 :回调时校验 record.md5 与调用方身份一致,不匹配直接拒。(worker 侧本来就带着 Authorization: Bearer <md5>。)
原则 :凡是「按 id 写记录」的接口,都必须先问一句「这条记录是不是你的」。 尤其是那些会触发资金动作的写。
11. 上下文重建的顺序依赖:为什么必须扫两遍
现象 :前端要把每条任务卡挂回它那一轮的正文气泡 上。但一轮里正文记录的 id 比工具记录大------第一遍扫描时,「未来的那条消息」还没被处理到。
修法 :分两遍。第一遍逐条建消息、把「有个任务要挂」记进 pending;第二遍为每条 pending 找宿主(优先按 turnId 匹配同一轮,退不回本轮最后一条 assistant 正文,再找不到就补一条空壳兜住这张卡)。
教训 :一遍扫描看起来更干净,但它天然看不见「后面才出现的消息」。 分开两遍之后,规则是确定的,不再依赖记录到达的顺序。
12. 重投必须有终点
异步任务靠消息派发给 worker。消息派发失败会重试,重试次数用完了怎么办?
如果没有兜底,就会出现这种死局:消息发不出去 → 记录永远停在排队中 → 额度永远被冻结 → 前端一直转圈 → 没有任何人报错。
我们的做法是把「重投」和「收尸」分开:
text
重投:每 60 秒扫一次,窗口 10 分钟,每次批量 10 条,靠记录上的 sse_message 原样重放
收尸:超过 90 分钟仍是 QUEUE 且重试余额耗尽 → 判死 + 释放额度
判据 :任何「靠重试往前推进」的机制,都要有一条对称的兜底清理。答案不能是「不会发生」。
九、我们还没做到的
一个只讲优点的架构文章没有参考价值。下面是这套系统现在真实存在的边界:
- 中断是 best-effort。 已发出的模型调用不可取消;我们只能保证「不再产生新的动作」。真正的中断需要一个可取消的执行上下文,那是另一层改造。
- 正在跑的对话不落库。 重启会打断进行中的 turn(库里已结算的行不受影响,卡住的行由超时兜底判死退款)。循环状态还没有持久化。
- 刷新页面后,正在跑的任务卡不会自动恢复轮询。 历史任务是只读的,这是前端为「刷新还原」做的简化------代价是运行中的任务卡停在刷新那一刻的样子。
- 单条消息没有长度上限(只有工具级的文本上限,比如合成语音 5000 字)。历史取最近 200 条,更早的不进上下文------这对长会话是否足够,还需要真实数据说话。
round事件还没有消费者。 它已经发出去了,前端现在没有用它(留给「显示第几轮」这类 UI)。协议里有一个没被使用的事件,是负债,不是储备------要么用起来,要么删掉。- 工具参数的类型归一化偏严:「拿不准就当没给」。这减少了误操作,但也意味着模型偶尔会因为参数写法不标准而多试一轮。
十、测试:有几类性质,单测在原理上就证明不了
这套系统的 agent 模块有 16 个测试文件、近 4000 行测试代码,但真正救过命的是下面三类。
一、装配 (只有真的把容器装起来才验得到):有没有循环依赖、bean 名有没有冲突、有没有两个工具认领同一个 service_type。
二、透明性(断言的是「不变量」而不是「结果」):非 agent 的请求,一个字段都不能被 agent 的注入逻辑改动。
三、契约 (断言的是「发出去的东西」而不是「内部的调用」):事件名、事件顺序、键序。我们用一个「记录型 emitter」把 SSE 帧原样收集起来,断言的是真正发出去的帧序列------因为那是前端和模型唯一能看到的事实。
这三类测试有个共同点:它们不测「功能对不对」,它们测「约束有没有被破坏」。
功能坏了用户会告诉你;约束坏了往往没人知道------直到某天以一种很难追的方式爆出来。
第四部分 · 十条经验,可以带走
把前面的东西压成十条。它们不依赖你用什么语言、什么模型,做的是数字人还是客服:
-
先把 agent 拆成五个部件:能力、描述、循环、上下文、边界。任何一次设计讨论都应该能落到其中之一上。
-
能力的所有权必须在服务端。 判据:如果一件事「改了不需要发客户端」,它就该在服务端。 工具清单、提示词、参数校验、额度规则,全都属于这一类。
-
描述能力的东西,必须和交付能力的东西同批发布。 这不是纪律问题,是结构问题------能被分开部署的东西,迟早会被分开部署。
-
循环放在哪,取决于它有多长、要不要活过关页、中间要不要人点头 ;而不取决于你更熟悉哪一端。但不变式只放服务端:凡是「违反了就涉及钱或安全」的规则,客户端可以驱动流程,但不能拥有它。
-
对外协议要先冻结再实现。 事件名、数据键、键序都是契约。协议里的每一个字段都要有人用------没人用的字段是负债。
-
上下文是一个有合法性约束的结构,不是一串文本。 有
tool_calls就必须有tool回复;刷新和重启后能重建,才算真的落了库。 -
钱要算得清 :准入和占用在一条原子 SQL 里;冻结按上限;「实扣 ≤ 冻结」应该是数学结论而不是断言。
能靠构造消除的错误,不要靠断言去拦。
-
每一种失败都要有终点。 尤其是那些「靠重试推进」的机制,必须配一条对称的收尸路径。答案不能是「不会发生」。
-
超时要问清楚它计的是「整段」还是「间隔」。 计时对象搞错,长任务会被误杀;而日志里只会留下一句空的超时异常。
-
测试要覆盖那些单测证明不了的性质 :装配(图的问题)、透明性(不开的东西一个字没动)、契约(真正发出去的帧)、不变式(扣费不可能超过冻结)。它们测的不是功能,是约束。
如果只让我留一句:
让能力、描述、规则和上限都留在服务端;让客户端只负责转发和渲染;让每一次演进都能被回滚,而不是被静默接受;让每一种失败都有终点。
Agent 系统里最难的部分,从来不是「让模型会调工具」------那个照着文档就能做出来。难的是它上线半年、发了二十个版本、有三四个入口之后,还能不能保持清醒。
十一、关于本文
本文的案例是 蔓藤AI · AI 助手(蔓藤AI 数字人创作平台)的服务端实现:九个工具、一次用户发言最多四轮、每轮一条记录、冻结---结算的计费模型、SSE 的六事件契约。
如果你在搭自己的 agent 系统,欢迎在评论区聊聊------尤其是「循环放哪端」和「失败收尸」这两块,我们很想知道别人是怎么做的。
附:上线前自查清单
text
能力面
  □ 工具清单、提示词、参数校验、额度规则,全部在服务端
  □ 提示词与工具表走同一个入口注入、同一批发布
  □ 工具参数只收「意图」,不收命令/脚本/表达式;执行侧再校验一遍

循环
  □ 轮数上限是服务端配置项,客户端里没有这个常量
  □ 每一轮都有超时;中断在每个「产生副作用之前」都会被检查
  □ 声明与实现一致(并行/串行、同步/异步)

上下文
  □ 消息序列的合法性由写入方保证(tool_calls 必有 tool 回复)
  □ 工具结果结构化落库,读取侧对畸形数据降级而不抛错
  □ 刷新 / 重启后能重建出同一段对话

钱与边界
  □ 准入与占用是一条原子 SQL
  □ 冻结按上限;结算「释放整笔 + 加实扣」
  □ 每一次模型往返都有一条可独立审计的记录

失败
  □ 模型返回空 → 失败分支,不是成功
  □ 每一条重试路径都有对称的过期收尾(判死 + 释放资源)
  □ 按 id 写记录的接口都校验归属

协议
  □ 事件名 / 键名 / 键序已冻结;每个字段都有消费者
  □ 有结束哨兵;异常收尾不会让客户端一直等
  □ 改语义 = 开新类型,而不是给老类型加字段
关键词:AI Agent、Agent 架构、Function Calling、工具调用、SSE、多轮循环、上下文重建、计费设计、异步任务、幂等、Spring Boot、工程实践