第 3 章课后练习与答案
本练习中的 Token 划分和概率均为教学示例。实际结果由模型的分词器、词表、上下文和生成设置决定。
建议先完成前四部分,再查看答案。
🌈 关于《AI 零基础 36 讲》课后训练
📚 与正式讲解配套学习
本篇是《AI 零基础 36 讲》的配套课后训练,与对应章节的正式讲解一起使用。整个系列面向初学者,从日常 AI
使用逐步进入编程、模型训练和大模型应用开发。
✍️ 先独立作答,再核对答案
训练围绕本章知识安排概念判断、结果分析或动手任务,并提供参考答案与解释。建议先读完对应的正式文章,再独立作答;遇到困难时回看相关例子,最后核对答案。
💻 代码题请亲手运行
观察程序输出,确认自己能解释结果、发现错误并完成修复。做完一道题,也要弄清答案为什么成立。
第一部分 模拟分词
下面是一段人为设计的模拟分词。
text
原句  今天下午去图书馆看书。
模拟 Token  [今天] [下午] [去] [图书馆] [看书] [。]
回答下面三个问题。
- 这段模拟结果一共有几个 Token。
- 一个 Token 是否总等于一个汉字。
- 换一个模型以后,分词结果是否一定相同。
再试着给"我正在学习大语言模型"设计两种不同的模拟切分方法。
第二部分 上下文改变含义
阅读下面两组文字。
text
A  苹果已经熟了,咬一口很甜。
B  苹果发布了新的系统版本。
回答下面两个问题。
- 两句话里的"苹果"分别指什么。
- 哪些 Token 帮助你作出判断。
把 B 中的"系统版本"删掉,只保留"苹果发布了新的",再判断后续有哪些合理可能。上下文变少以后,答案会不会更难确定。
第三部分 选择下一个 Token
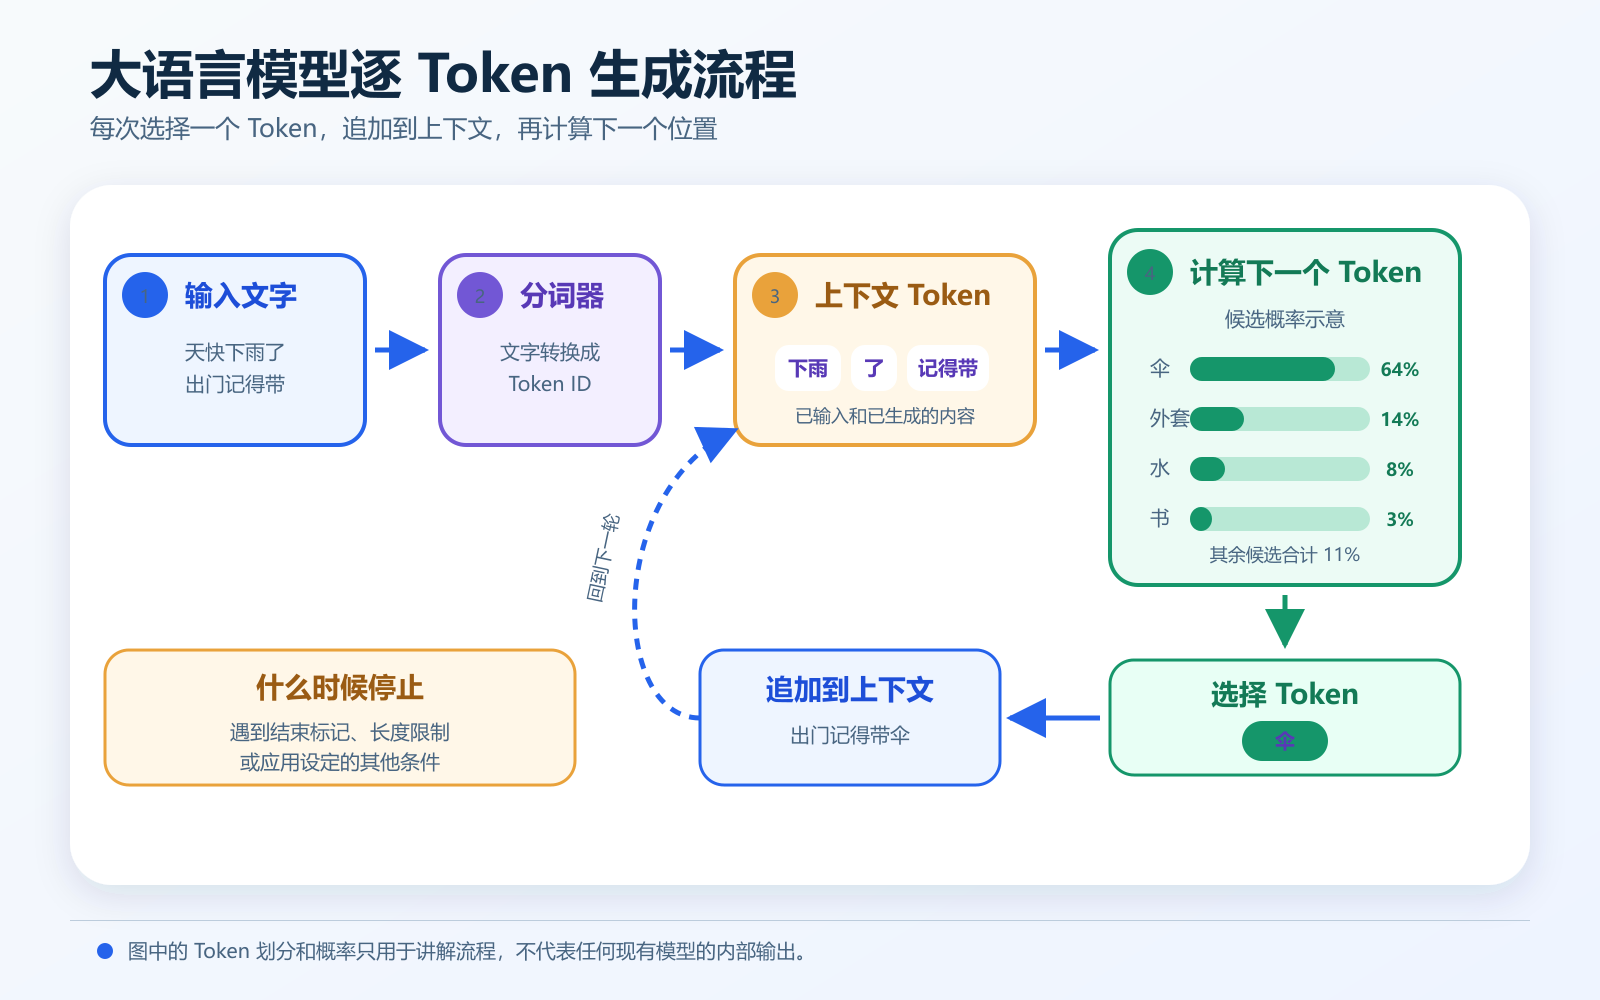
当前上下文如下。
text
天快下雨了,出门记得带教学用概率表如下。
| 候选 Token | 示例概率 |
|---|---|
| 伞 | 64% |
| 外套 | 14% |
| 水 | 8% |
| 书 | 3% |
| 其他候选合计 | 11% |
回答下面三个问题。
- 使用贪心选择时,下一个 Token 会是什么。
- 使用概率采样时,是否一定选择"伞"。
- 选出"伞"以后,模型下一轮看到的上下文是什么。
第四部分 观察分叉
下面给出两个可能的第一步。
text
路径一  天快下雨了,出门记得带伞
路径二  天快下雨了,出门记得带外套
分别给两条路径续写一句话。续写以后比较结果,看看第一个 Token 怎样影响后面的候选。
再回答一个使用问题。用户需要模型稳定输出固定格式的表格,应该倾向较低随机性还是较高随机性。用户需要十个差异较大的故事点子,选择会有什么变化。
第五部分 找出需要核验的内容
假设模型给出下面的回答。
text
《雨天算法》由林桥写于 2018 年,全书共 312 页,并在当年获得某技术图书奖。这段话句子通顺,仍要回答下面三个问题。
- 哪些信息可以通过外部来源核对。
- 流畅程度能否证明书名、作者和奖项存在。
- 如果找不到可靠来源,应该怎样处理这段回答。
参考答案
第一部分答案
模拟结果包含六个 Token。一个 Token 可以对应多个汉字,也可能只是一个字符或标点。不同模型使用的分词器和词表不同,切分结果可能变化。
"我正在学习大语言模型"可以模拟切成 [我] [正在] [学习] [大语言模型],也可以切成 [我] [正] [在] [学习] [大] [语言] [模型]。这两种切法只用于练习。
第二部分答案
A 中的苹果指水果,"熟了""咬一口""很甜"提供了线索。B 中的苹果指公司,"发布""系统版本"提供了线索。删掉"系统版本"后,后续可能接新品、公告、财报或其他内容,模型得到的约束减少了。
第三部分答案
贪心选择会取概率最高的"伞"。概率采样允许其他候选被选中,因此不保证每次都得到"伞"。选出以后,新上下文是"天快下雨了,出门记得带伞"。模型会基于这段更长的序列继续预测。
第四部分答案
路径一后面可能接句号,也可能继续说明雨势。路径二容易继续谈气温、防水或衣着。第一步改变了下一轮上下文,后续概率也随之变化。
固定格式任务通常更适合较低随机性,并且还要配合格式校验。创意任务可以提高多样性,让更多候选参与选择。随机性提高以后,离题和不稳定的概率也可能增加。
第五部分答案
书名、作者、出版时间、页数和获奖记录都可以核对。句子流畅只能说明文字组织得像一条完整信息,不能证明事实存在。找不到可靠来源时,应把它标记为未核实,不要继续引用或传播。
自我检查
完成后,试着不用看正文回答下面五个问题。
- Token 与字词是什么关系
- 上下文怎样影响下一个 Token
- 模型为什么要重复多轮生成
- 温度和采样改变了什么
- 流畅回答为什么仍需核验
五个问题能够说清楚,并能完整走完第三部分的两轮生成,就可以进入第 4 章。