Strata 是一个高性能推理引擎,目标是在单张消费级显卡(≥12GB VRAM)+ ≥32GB 系统内存 + SSD 的家用 PC 上运行 1250 亿参数的 MoE 模型(Qwen3.8-Flash-Next),达到 60--95 tokens/s 的生成速度
一句话总结
GPU 做每个 token 都要做的密集部分 + 热门专家,CPU 与 GPU 并行算冷门专家(专家全驻留 RAM),SSD 只放 n-gram 表,再用 MTP + prompt lookup 投机解码一次产出多个 token------通过把整个 PC 变成推理流水线,把 125B 模型塞进了 12GB 显卡。
核心思想:三级分层卸载
模型是 MoE 架构:48 层、共 24,576 个专家,但每个 token 只激活约 10 个专家------所以不需要把所有专家都放进显存
Strata 把工作分摊到三个硬件层级:
- GPU(VRAM) :存放每个 token 都需要的部分------attention 与 DeltaNet mixer、门控残差权重、路由器(router)、共享专家、输出头、MTP 草稿层、KV cache(长上下文时部分从 RAM 流式读取),以及一个自适应专家缓存 ,剩余显存全部用来装最常用专家(每多 1GB 显存约多放 ~700 个专家) 3
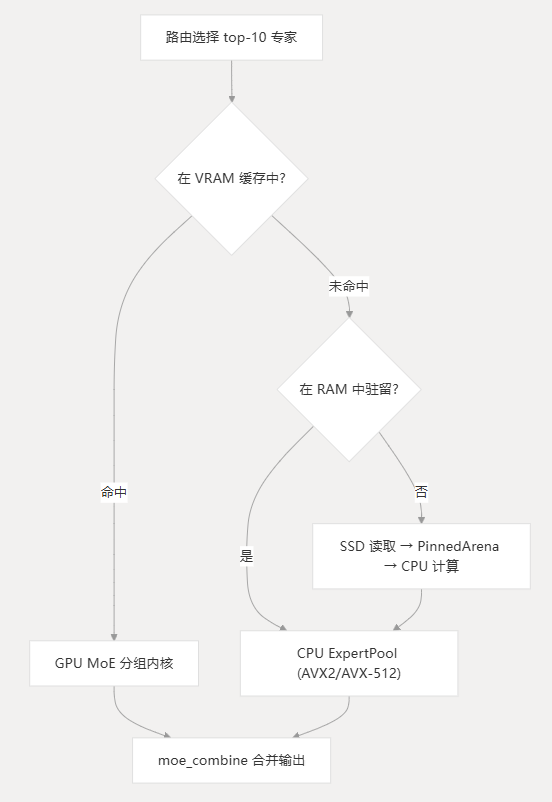
- 系统 RAM :pin 住全部 24,576 个专家。当路由选中了不在 GPU 缓存中的专家时,CPU 用 AVX-512/AVX2 内核就地计算,与 GPU 并行,互不等待。低内存模式下可只保留 GPU 放不下的那部分专家
- SSD:存放 28.8GB 的 n-gram 查找表,每 token 只读几行,走 OS 页缓存
同一套引擎既编译为 NVIDIA CUDA 也可编译为 AMD HIP
专家放置与取回路径
ExpertCache维护(layer, expert)→ VRAM 槽位的驻留表,并按每层配额分配槽位,防止靠前的层垄断显存- 缓存未命中时走
ExpertSource/FileExpertSource:RAM 驻留专家由PinnedArena管理(可用大页、可部分注册给 CUDA 做 DMA),非驻留的从 SSD 按区间加载 resident_stage_swaps负责 GPU 缓存与 RAM 之间的专家换入换出
执行流程:
重叠执行与 CUDA Graph
session_token()串行调度 48 层的前向传播;由于残差链严格串行,CPU 专家计算通过解耦的 host 线程与 GPU 的非 MoE 块(attention 等)重叠,用 doorbell 异步协议隐藏 CPU 延迟SessionState预先分配 KV cache、GDN 循环状态、激活缓冲和 PLE 状态(session_bytes/session_init),token 路径上零分配SessionGraphs为每层捕获 CUDA graph,消除 kernel launch 开销(每层 kernel 很小,launch 开销是主要瓶颈)
投机解码("先猜后验")
- 模型自带的 MTP 层每次最多起草 3 个 token,一次 48 层前向即可验证全部草稿,平均每次接受 2.4--3.2 个 token,加速 1.6--1.8×
- Prompt lookup :当回复与上下文重复(代码编辑、引用文本)时,
SuffixDrafter从前文中起草最多 5 个 token;DraftPolicy只在实测接受率和成本划算时启用(代码编辑快 6--11%,其他场景不变) - 关键性质:草稿只是猜测,大模型验证决定每个词,输出质量完全不变。
长上下文预填充
- 以最多 8,192 token 的大块做 prefill,吞吐超 1,000 tok/s;下一层专家在 attention 运行的同时经 PCIe 流式传输到 GPU
- 会话有缓存(conversation cache),后续消息只读新增部分,秒级开始