省流
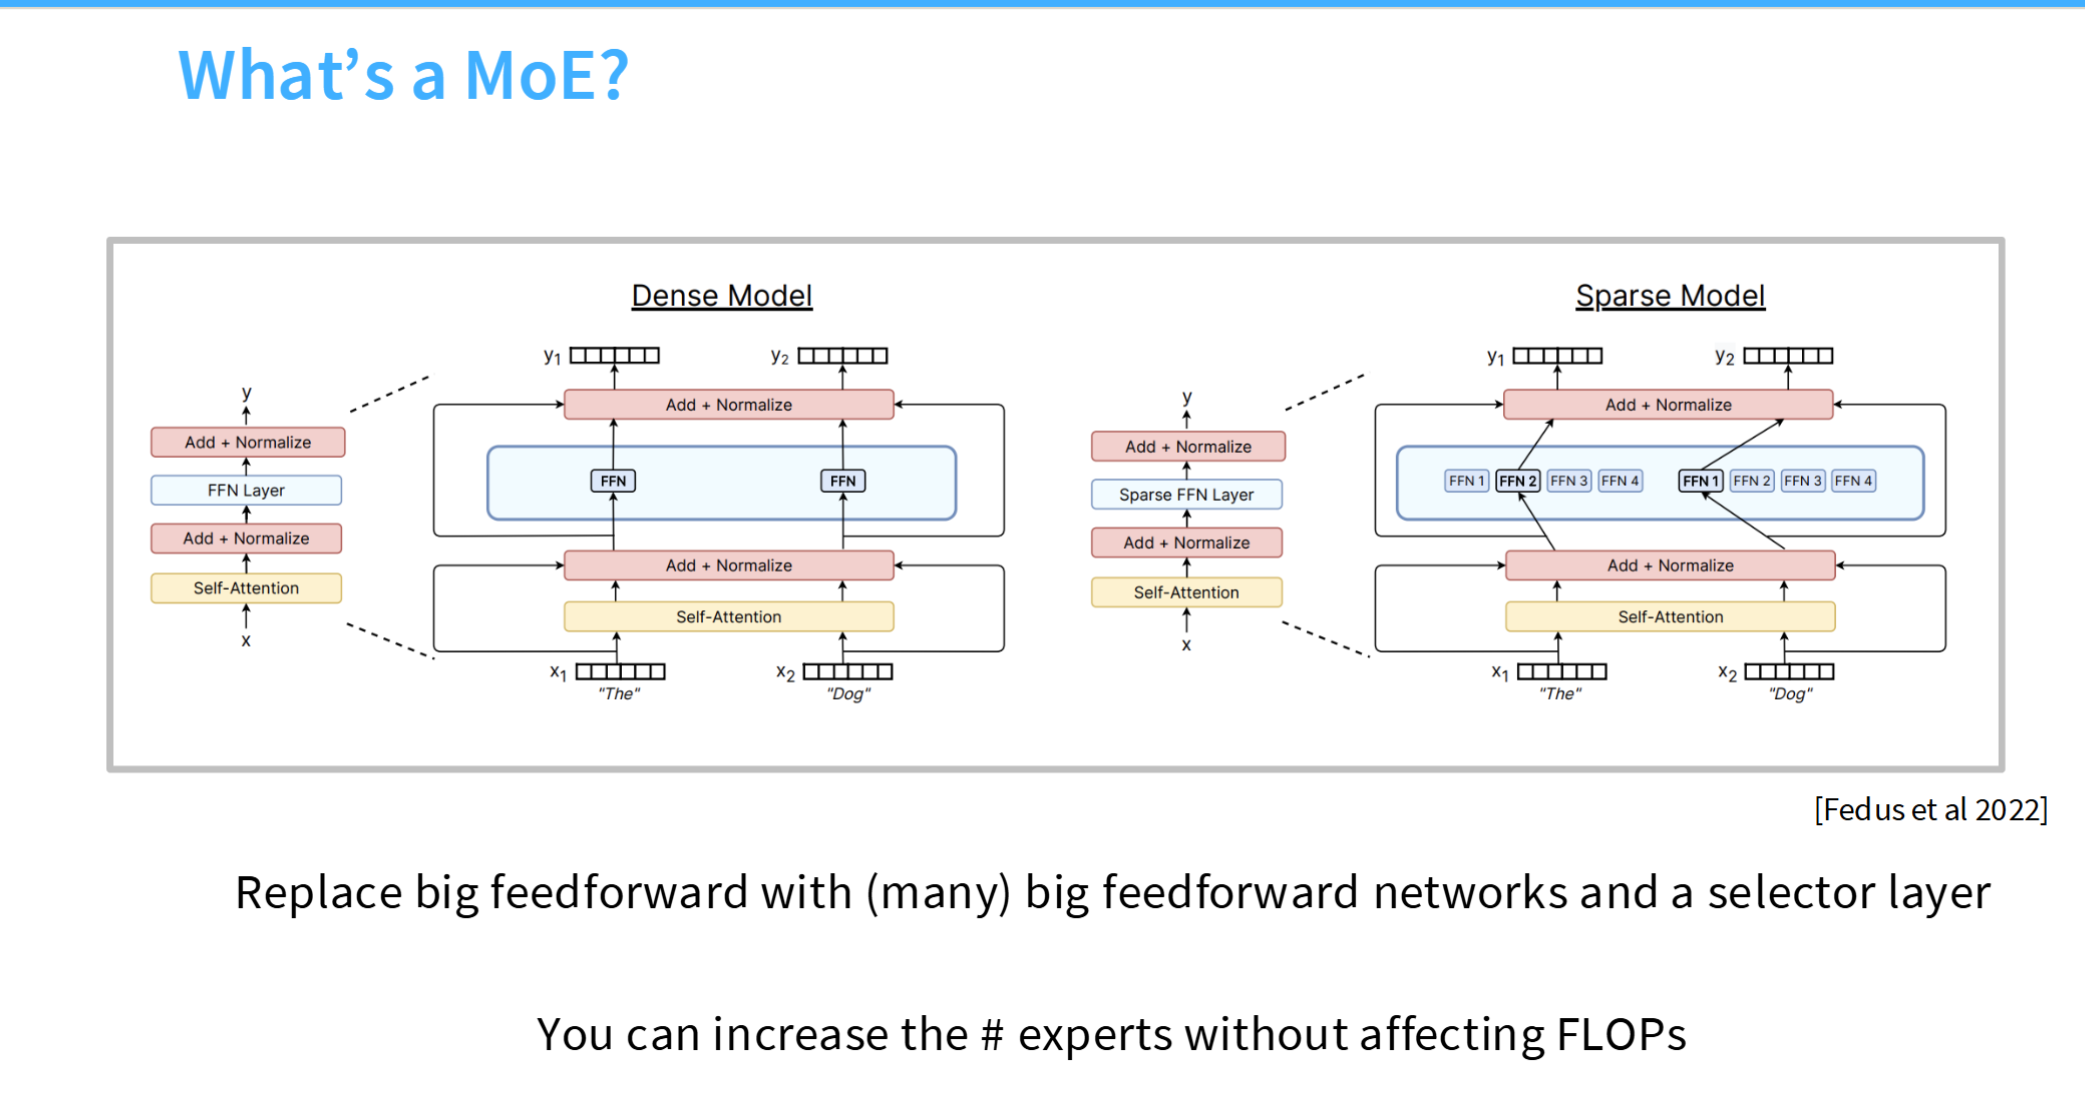
啥是MoE?
就是原本模型有一个大线性层(FFN),不管来什么token都走一遍,这也是推理时主要的计算开销。现在改成多个小FFN层,对于每个token,选一些最相关的FFN做前向传播,因为不是所有token都需要整个FFN的知识。
好处是可以降低推理开销,并且可以增加专家数量,提升模型能力,只会导致显存增加,但不会增加计算开销。
优势
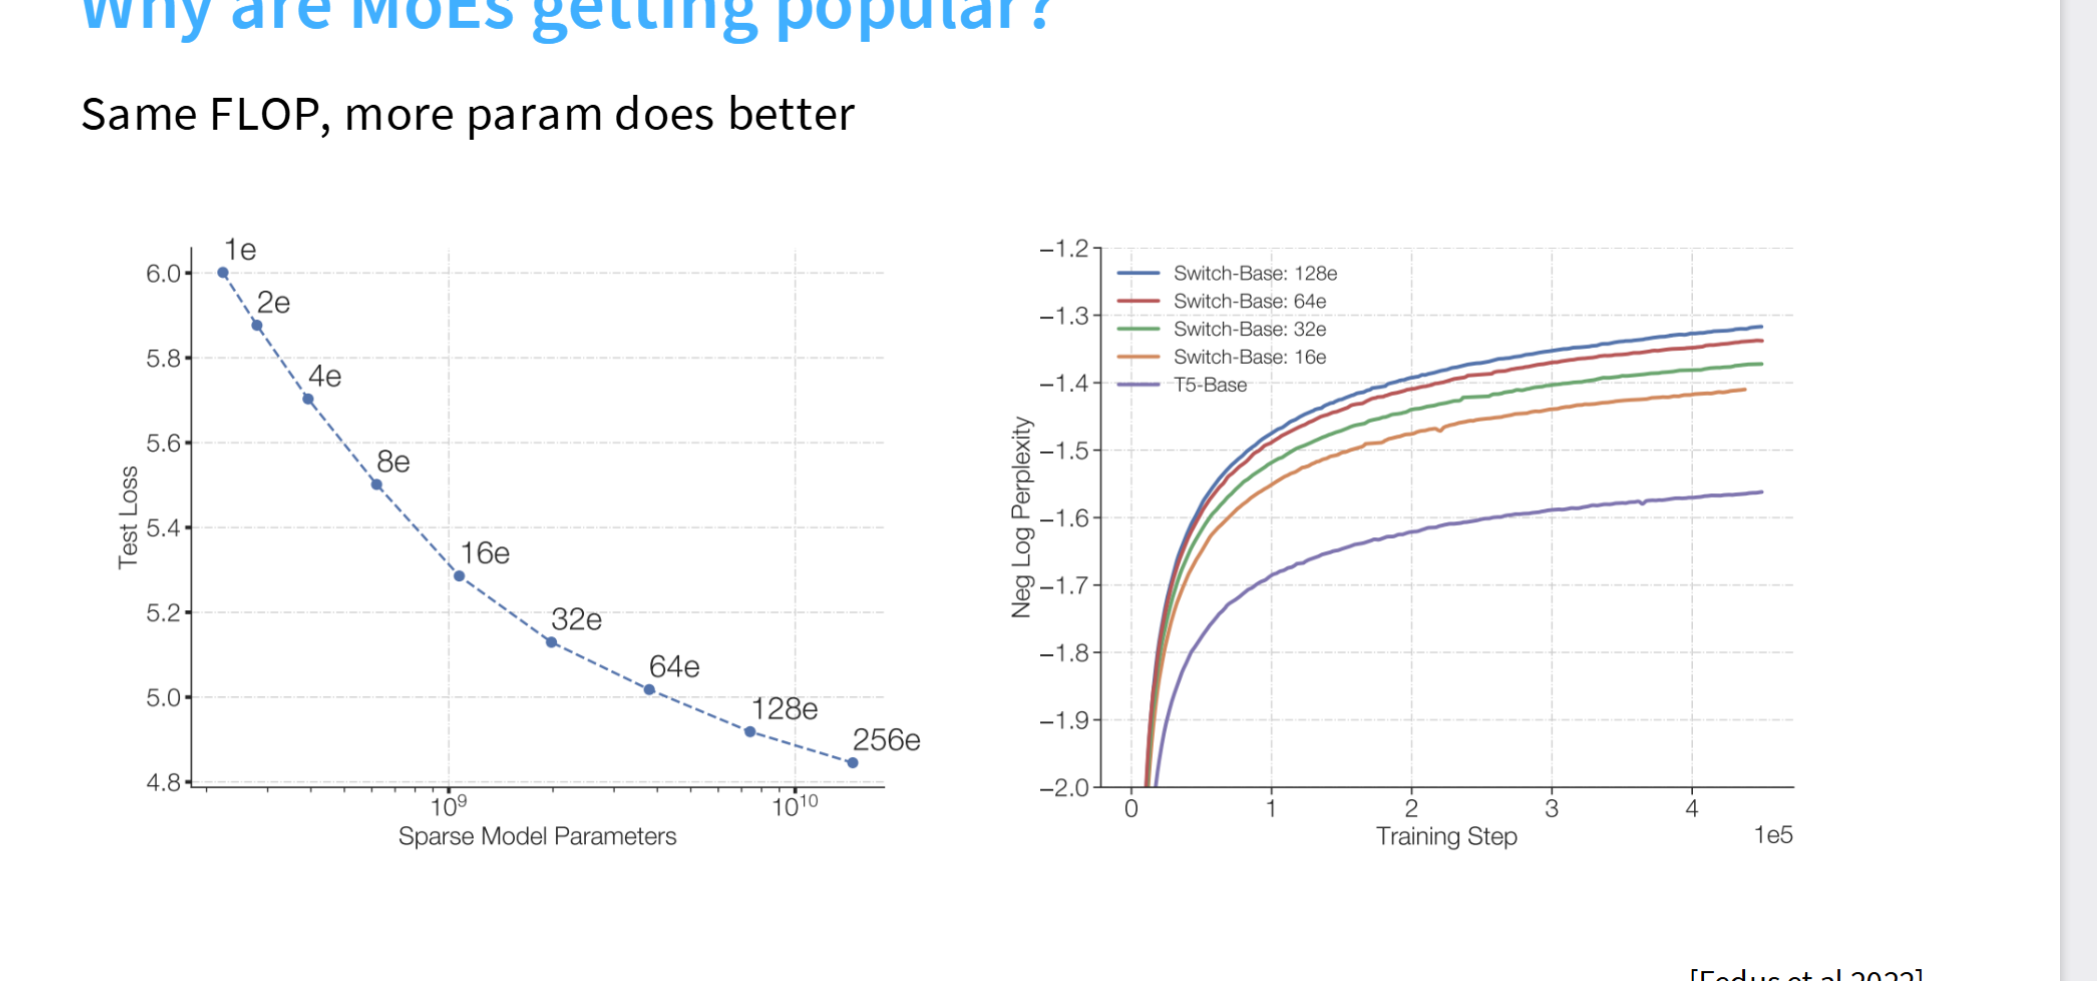
在不改变计算量的情况下,也就是激活专家数是固定的,增加专家数可以优化模型表现,左图是训练loss,右图是perplexity的负对数,都表示了专家越多效果越好,上面标的128e,64e就是专家个数
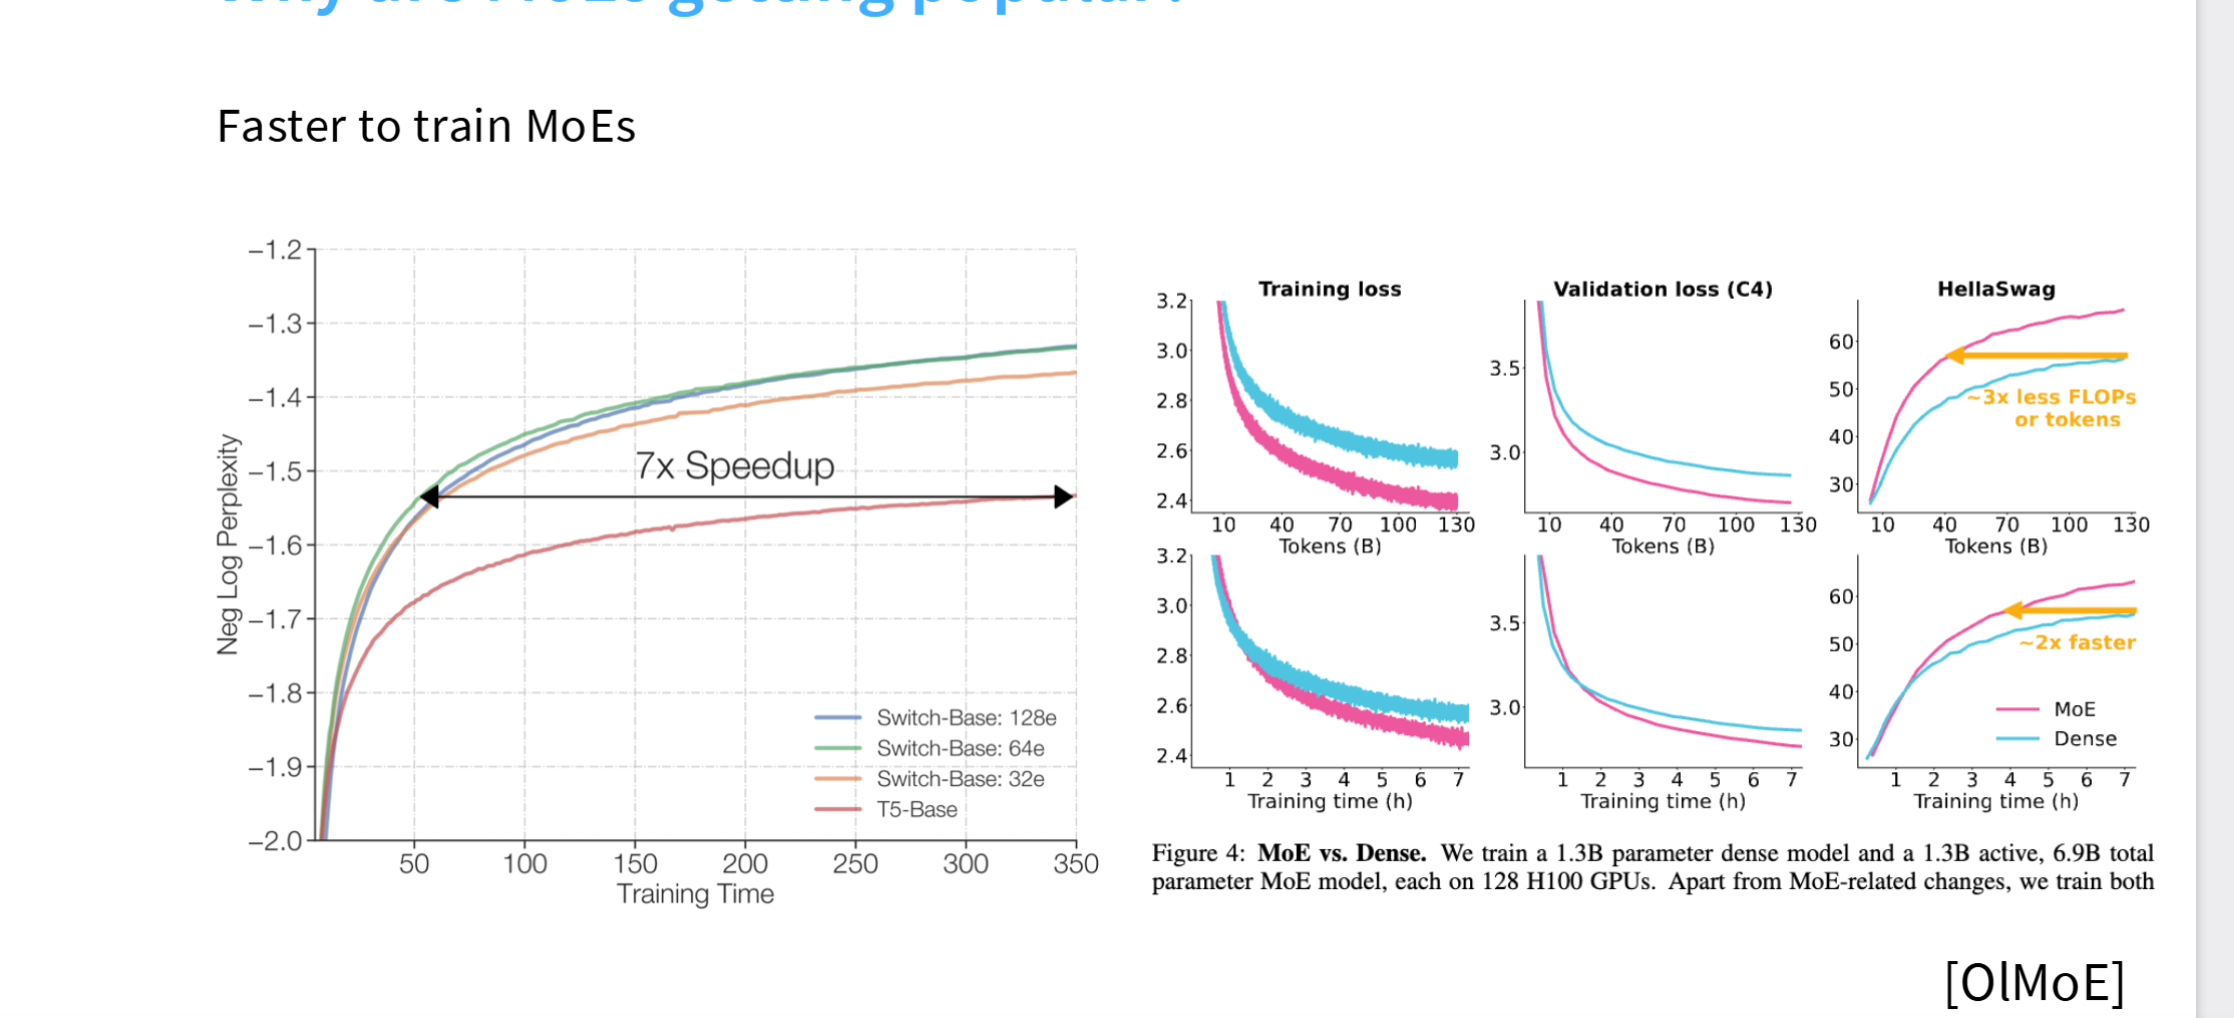
左图具体描述了训练速度的加速,达到相同的perplexity,MoE所需时间减少了7倍
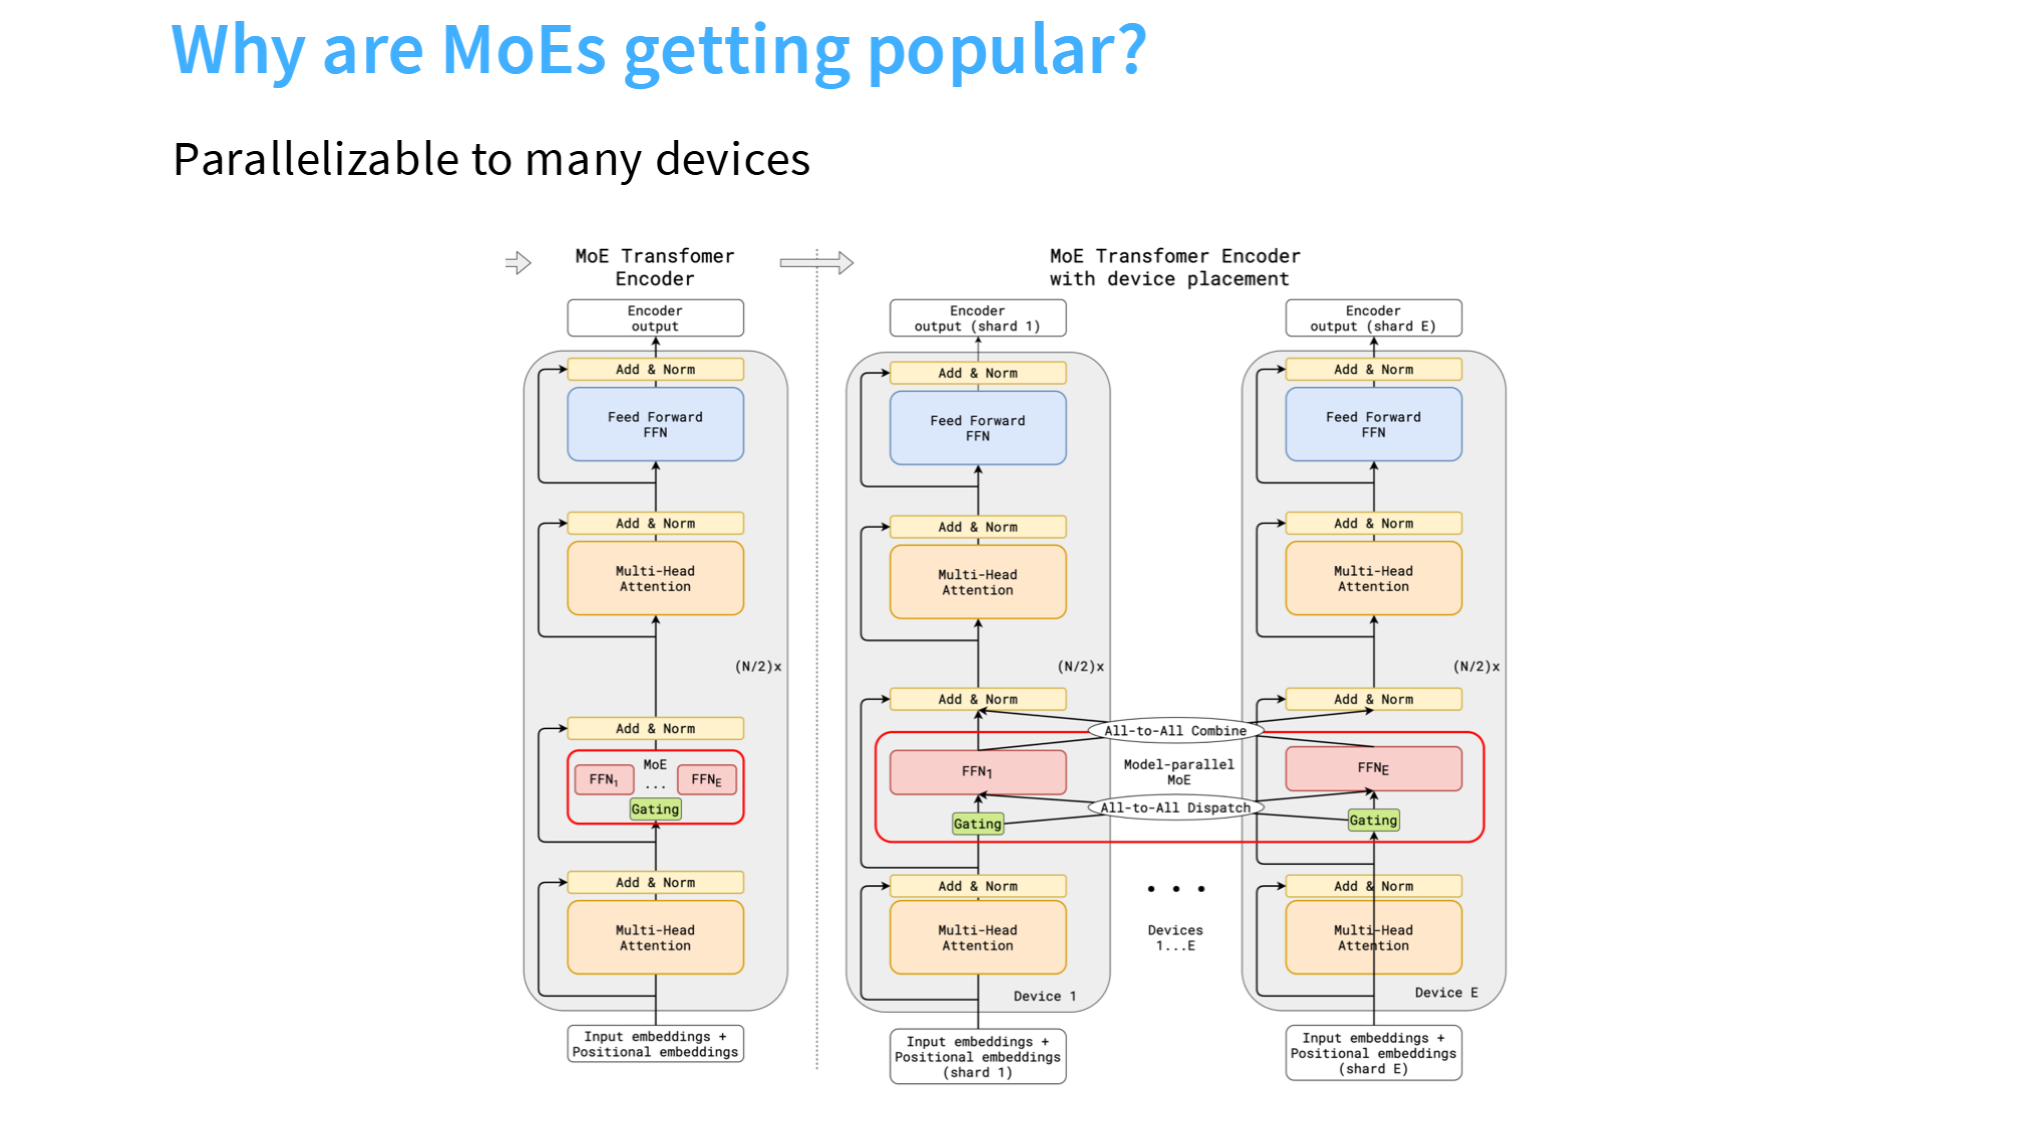
并且MoE天然适合多机并行,一般的并行需要把FFN层矩阵切开,做张量并行,而MoE的多个FFN天然就是切开的,可以部署到不同机器上,只是开始和最后需要两次all-to-all通信
举例:主流MoE模型
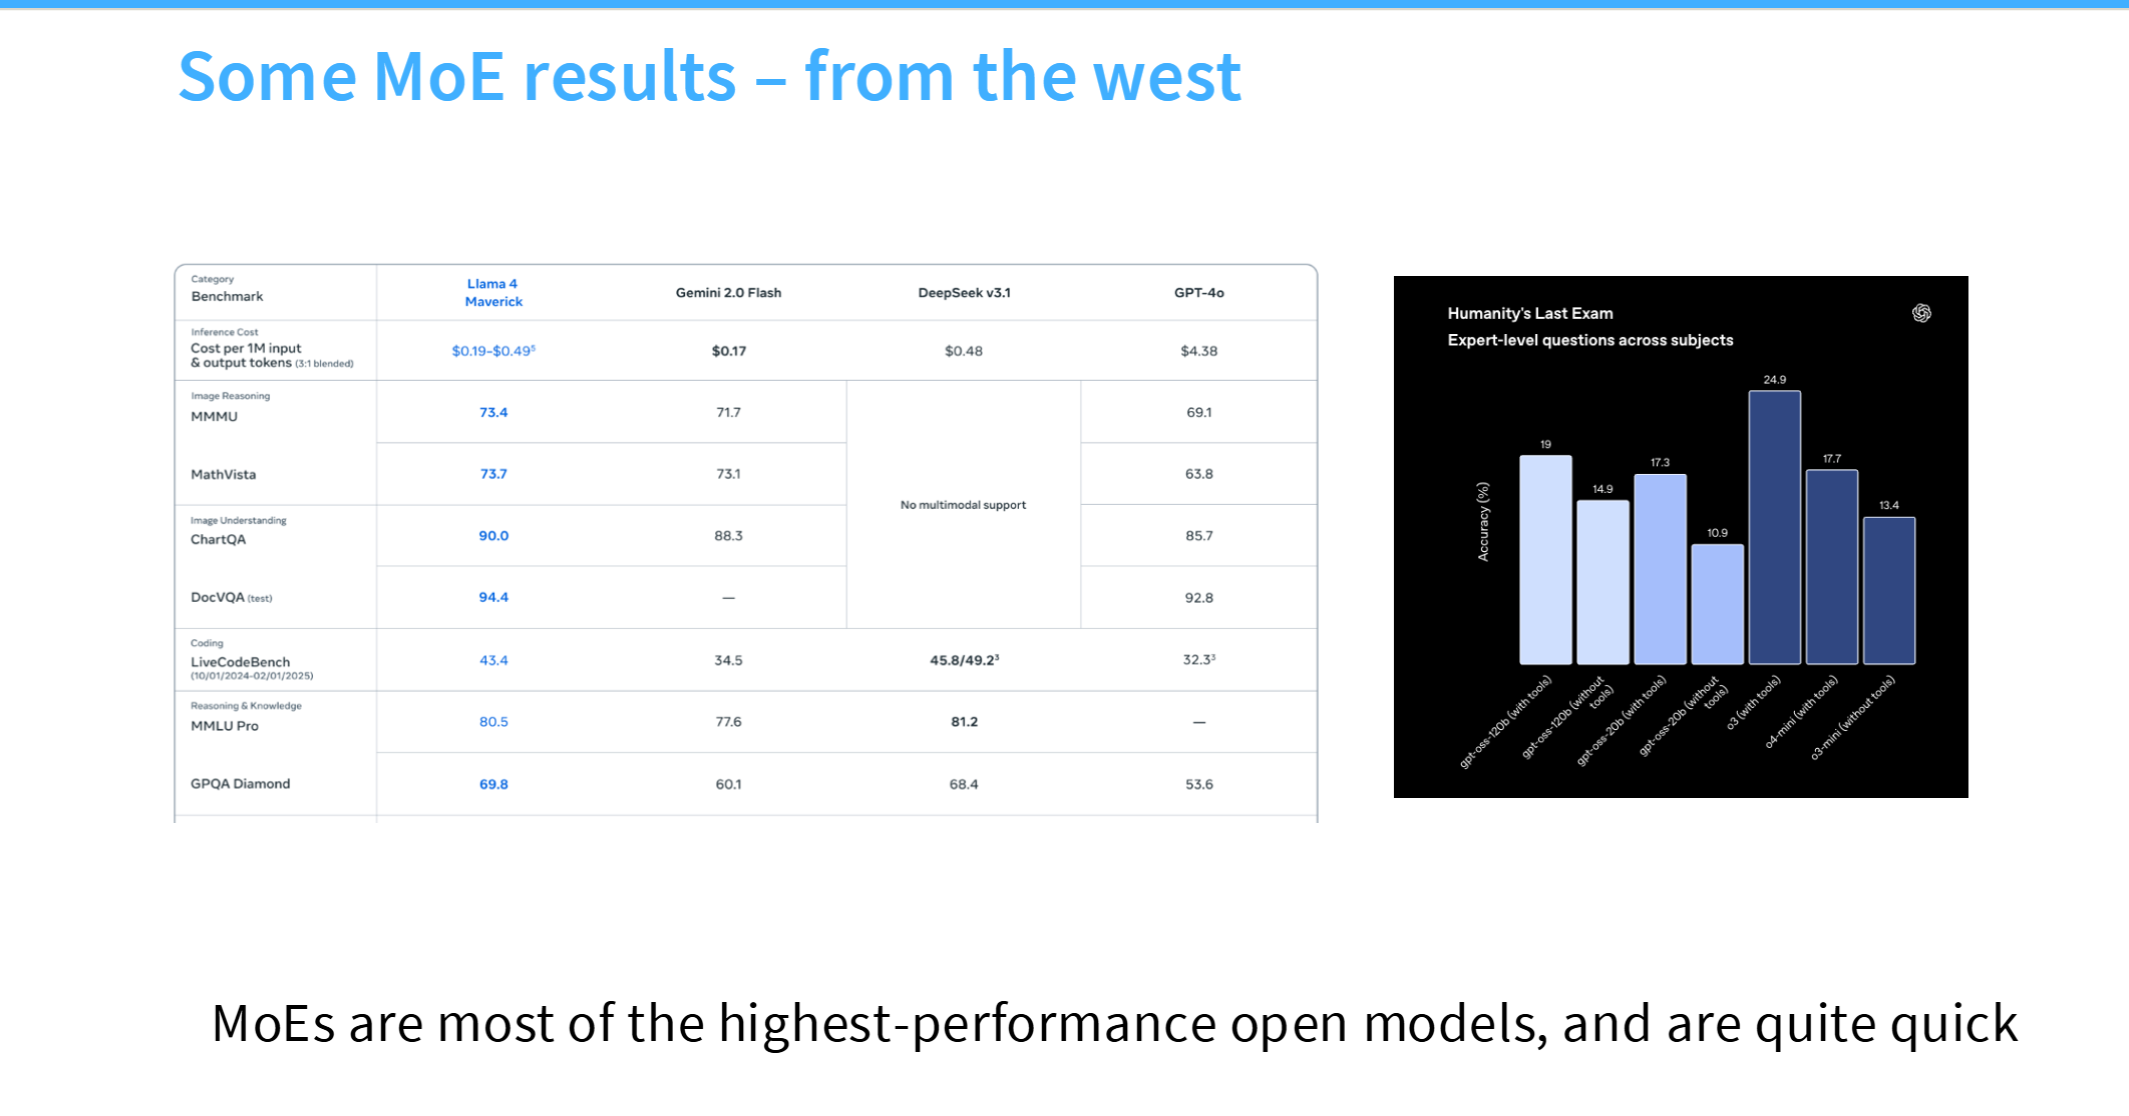
主流旗舰模型都采用了MoE,包括Deepseek V3.1,Gemini2,GPT4
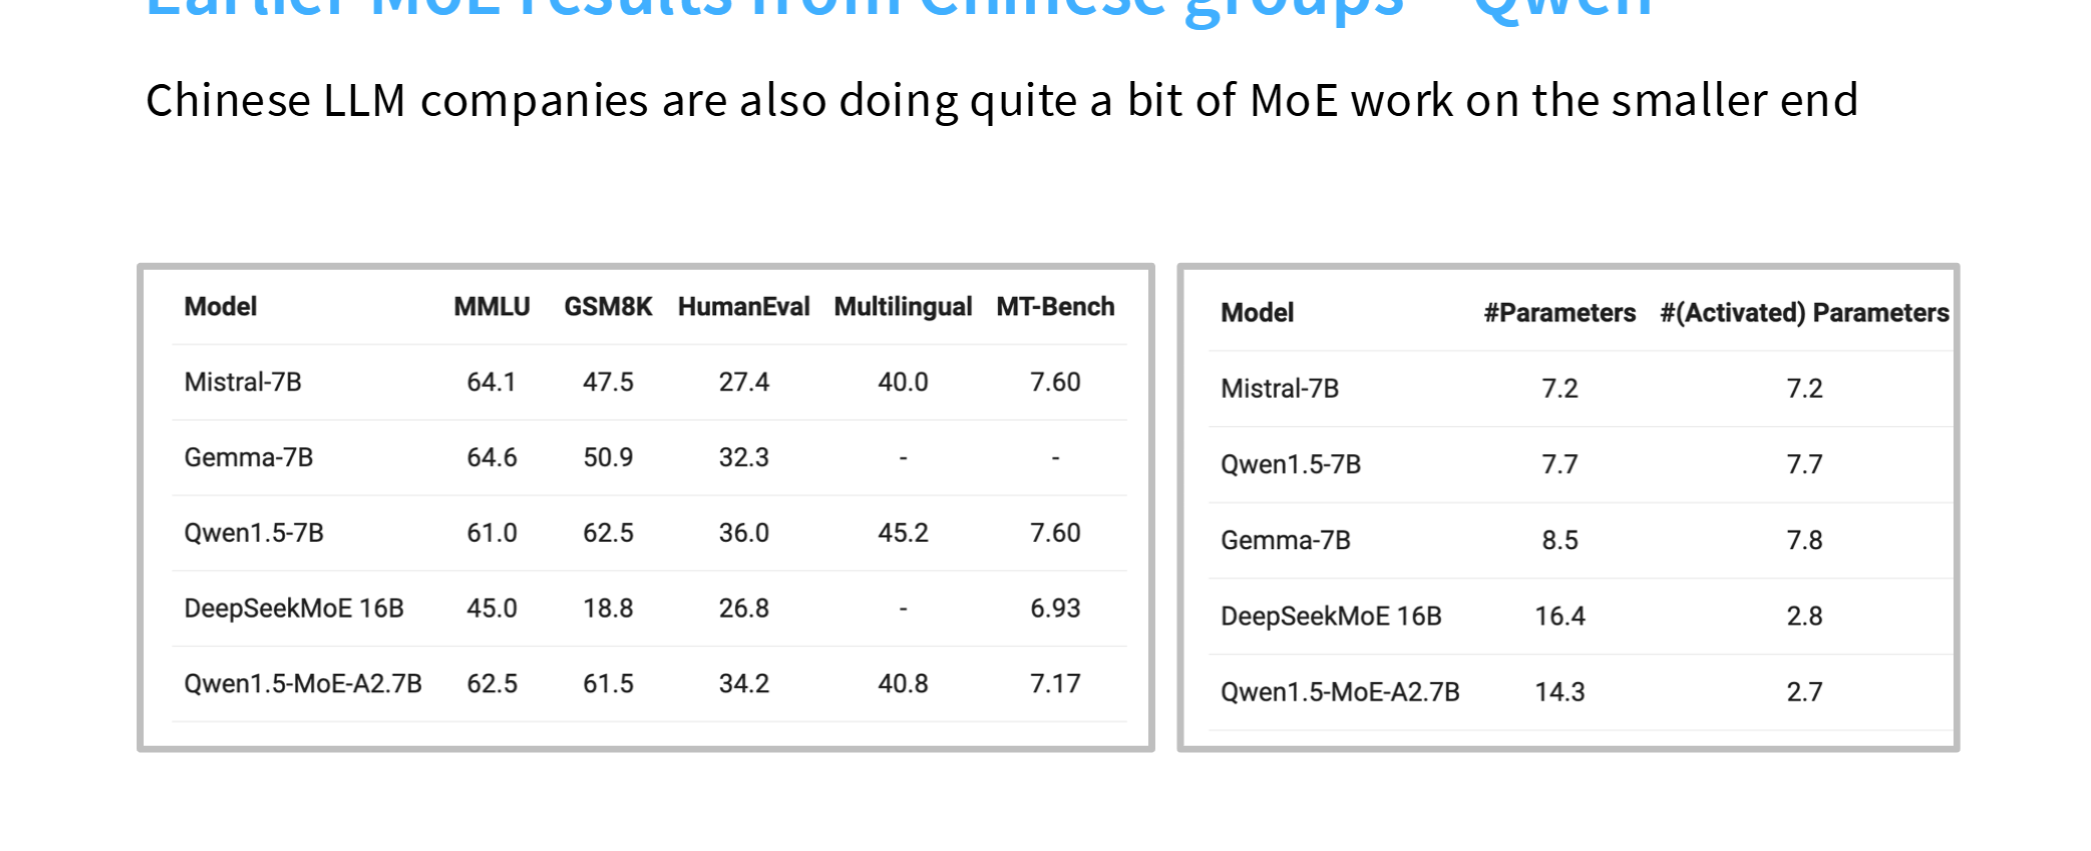
开源小模型也有很多采用了MOE,比如Qwen1.5
消融实验
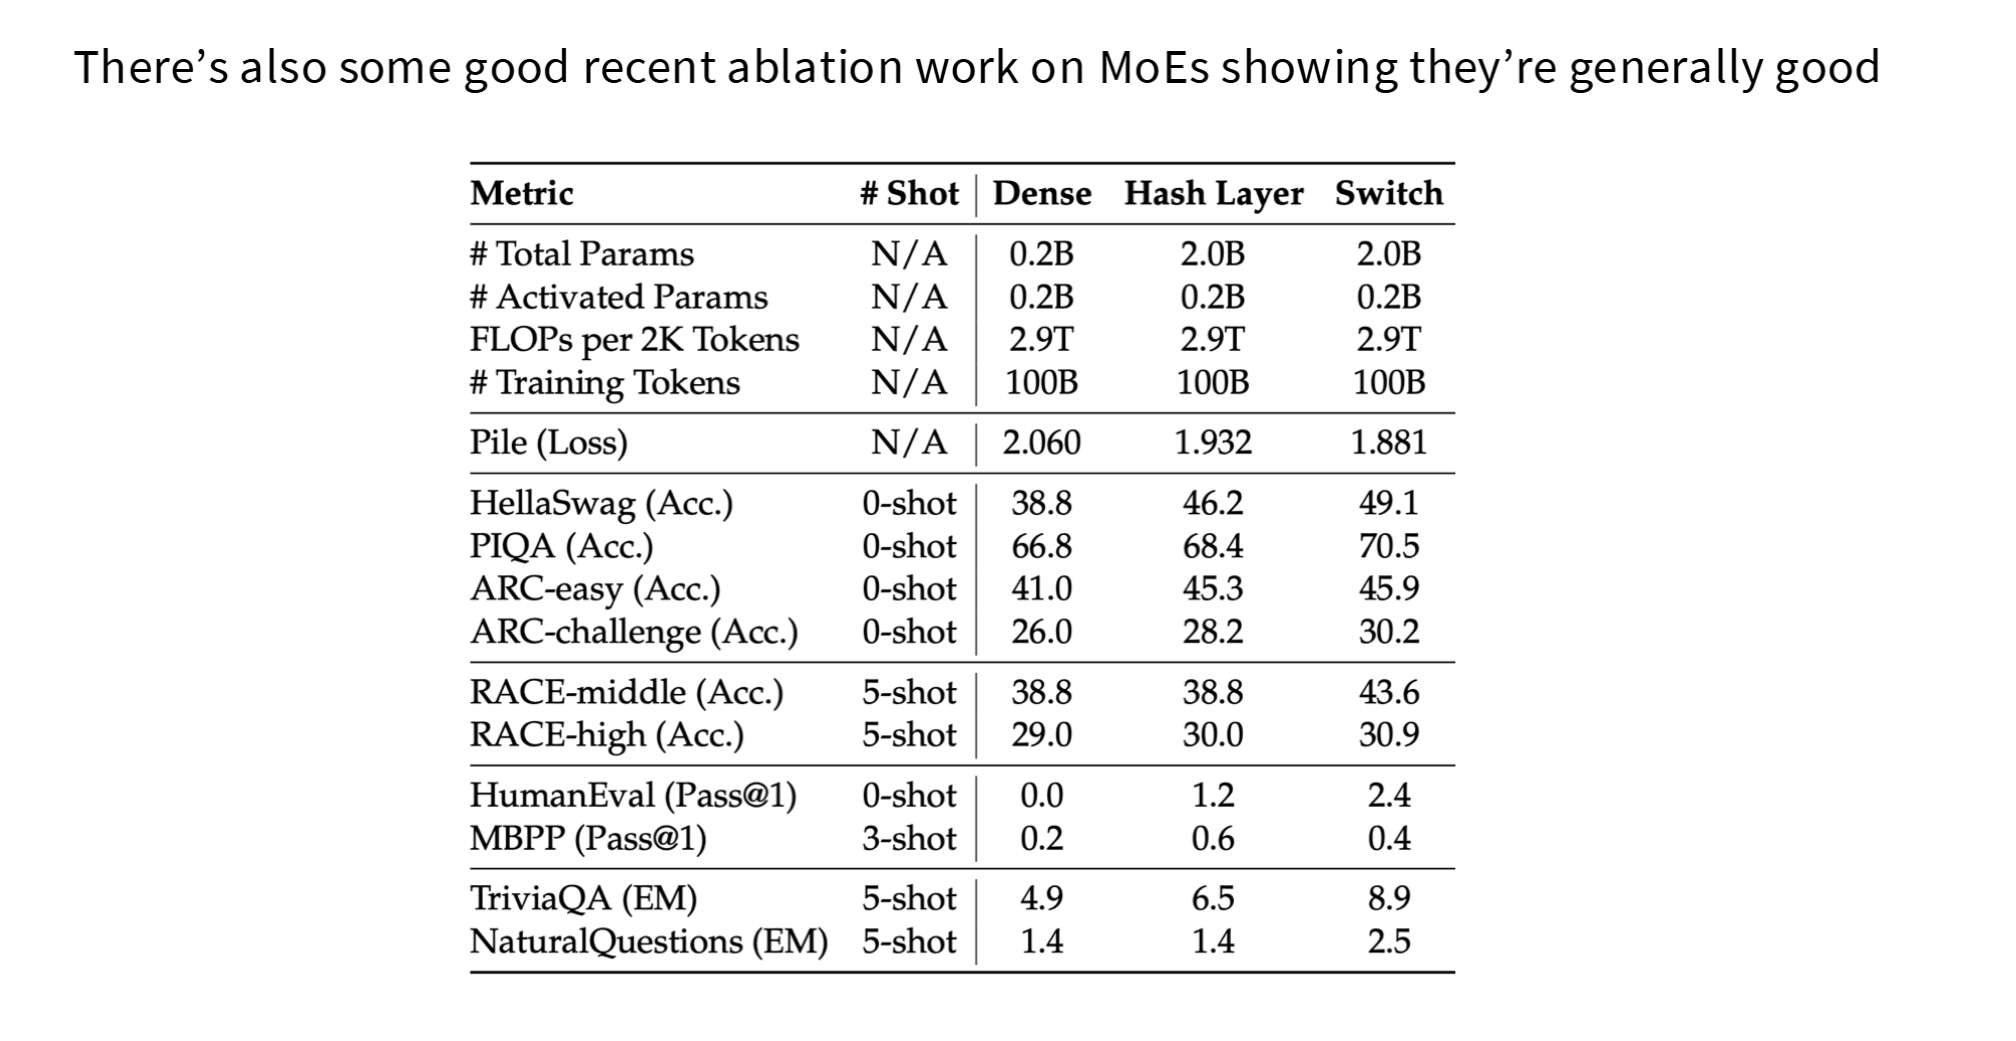
Deepseek的经典消融实验,相同激活参数量的MoE和Dense模型,MoE在各个benchmark都明显表现更好
缺点
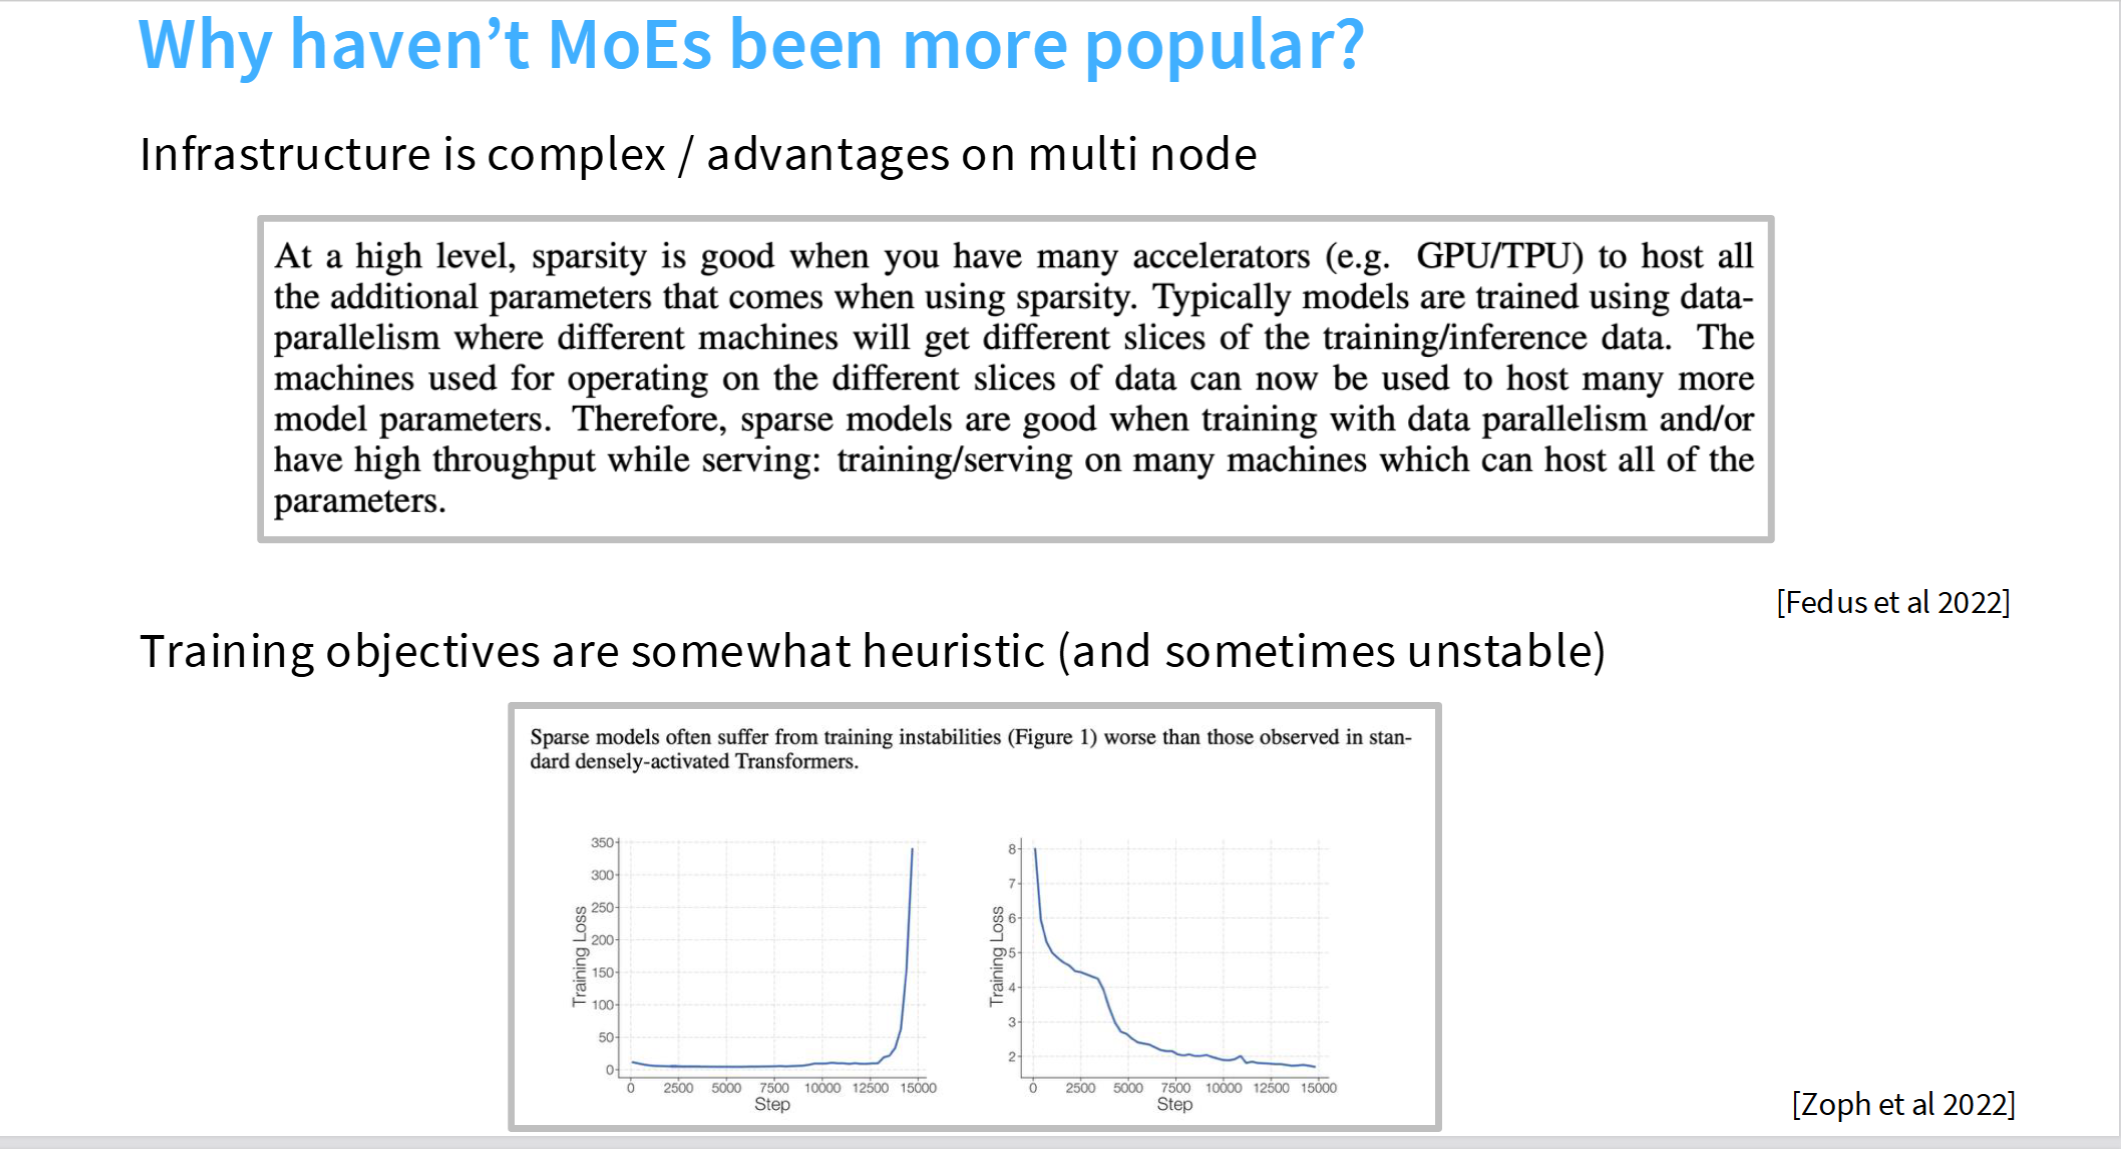
当然MoE也有缺点。首先就是MoE参数量大,多机并行实现起来需要较高的infra水平。其次训练不稳定,如下,左图是MoE右图是Dense,Dense的loss很少出现突然上升,但MoE由于专家路由的问题,可能出现loss突然上升,训炸了
常见MoE架构
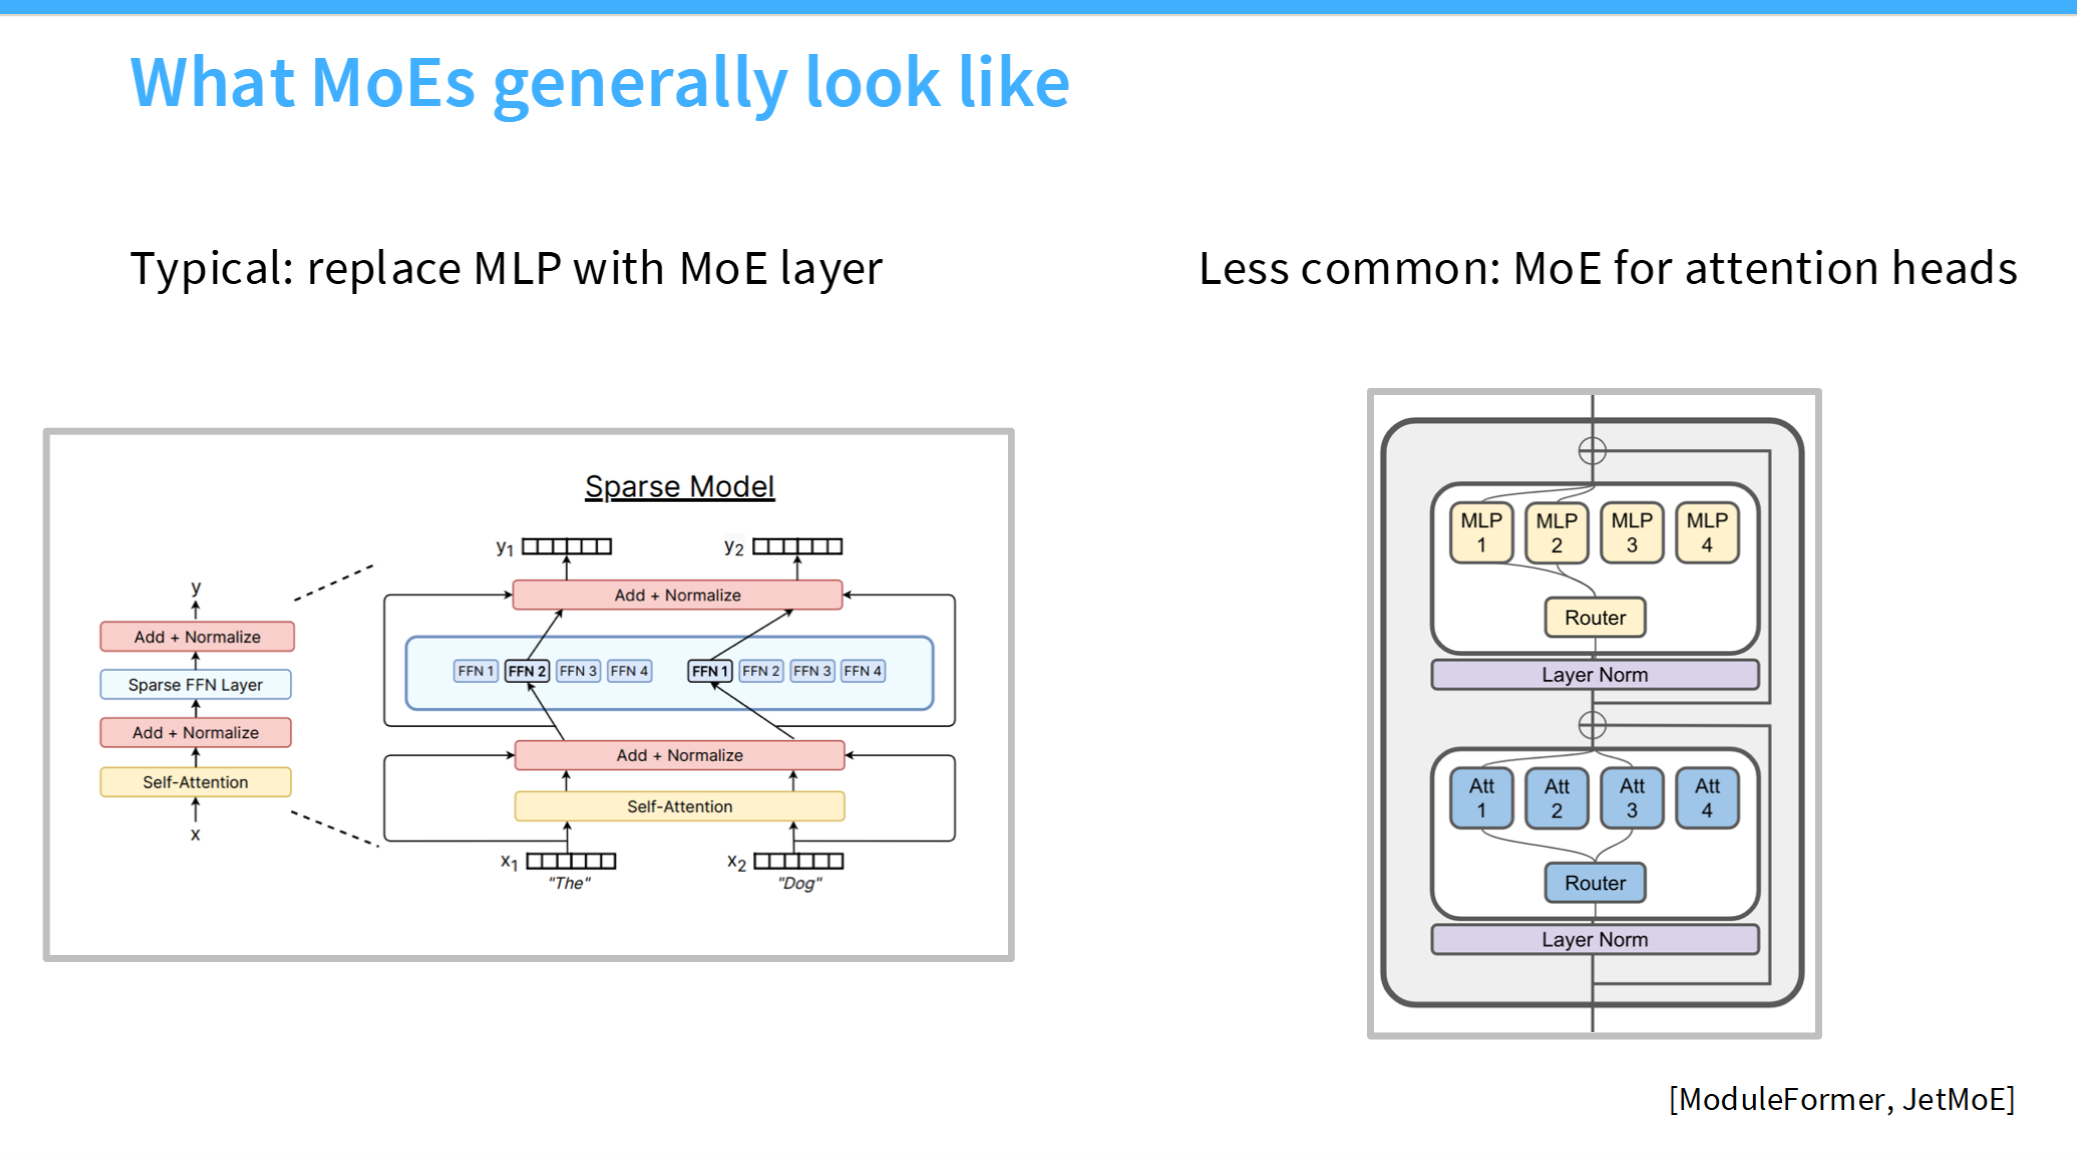
最常见的是左图,前面见过了,每个token路由到一些FFN层。比较少见的是,如右图,除了FFN层,给注意力层也做MoE,每次路由到一部分注意力权重矩阵
MoE要点
一般的MoE架构,主要考虑的点有
- 路由策略
- 专家大小
- 训练方式(可能遇到的障碍)
路由概览
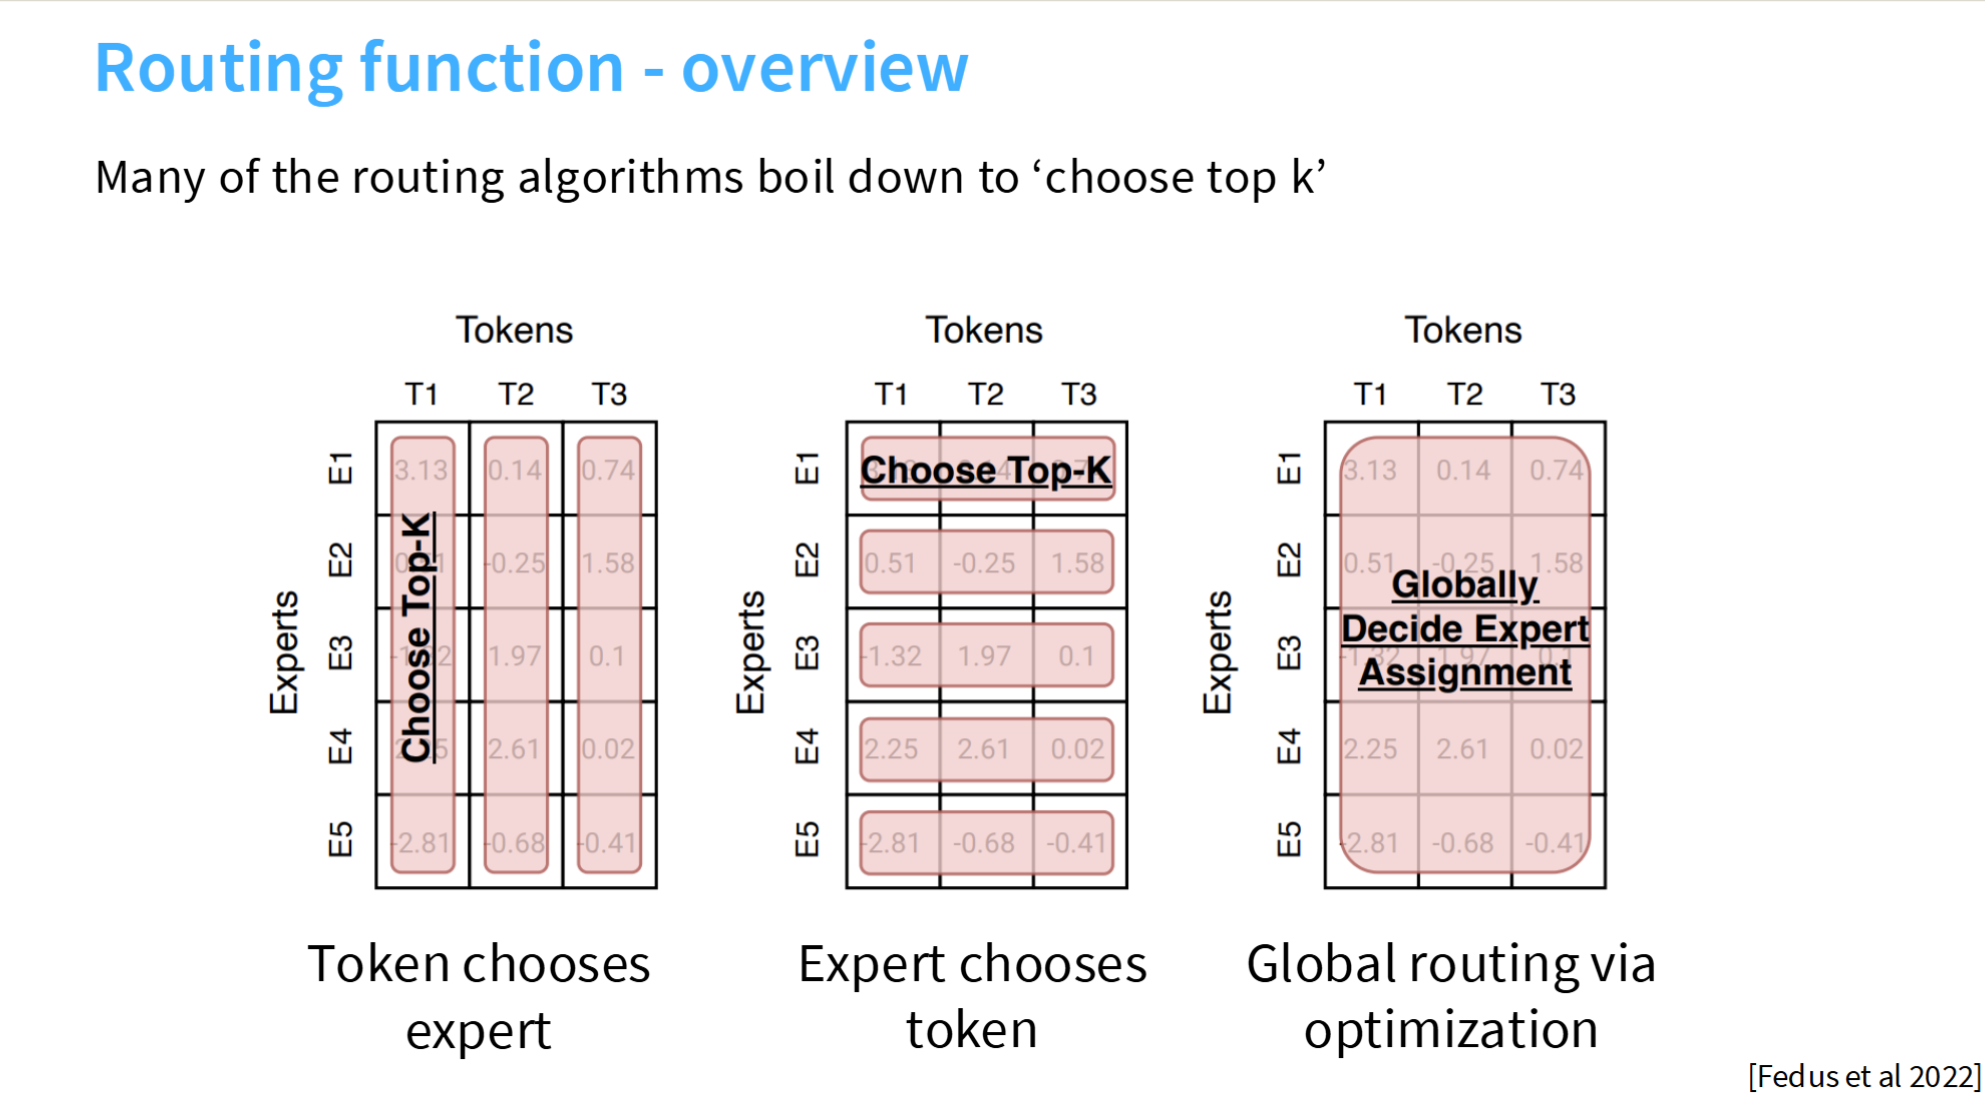
主流的路由方式就是选topk。看左侧两个图,分别是给每个token选topk的专家,以及给每个专家选topk的token。其中给token选topk专家是最主流的。最右侧的图意思是考虑一个全局最优解,不是简单的topk,后面会细说。
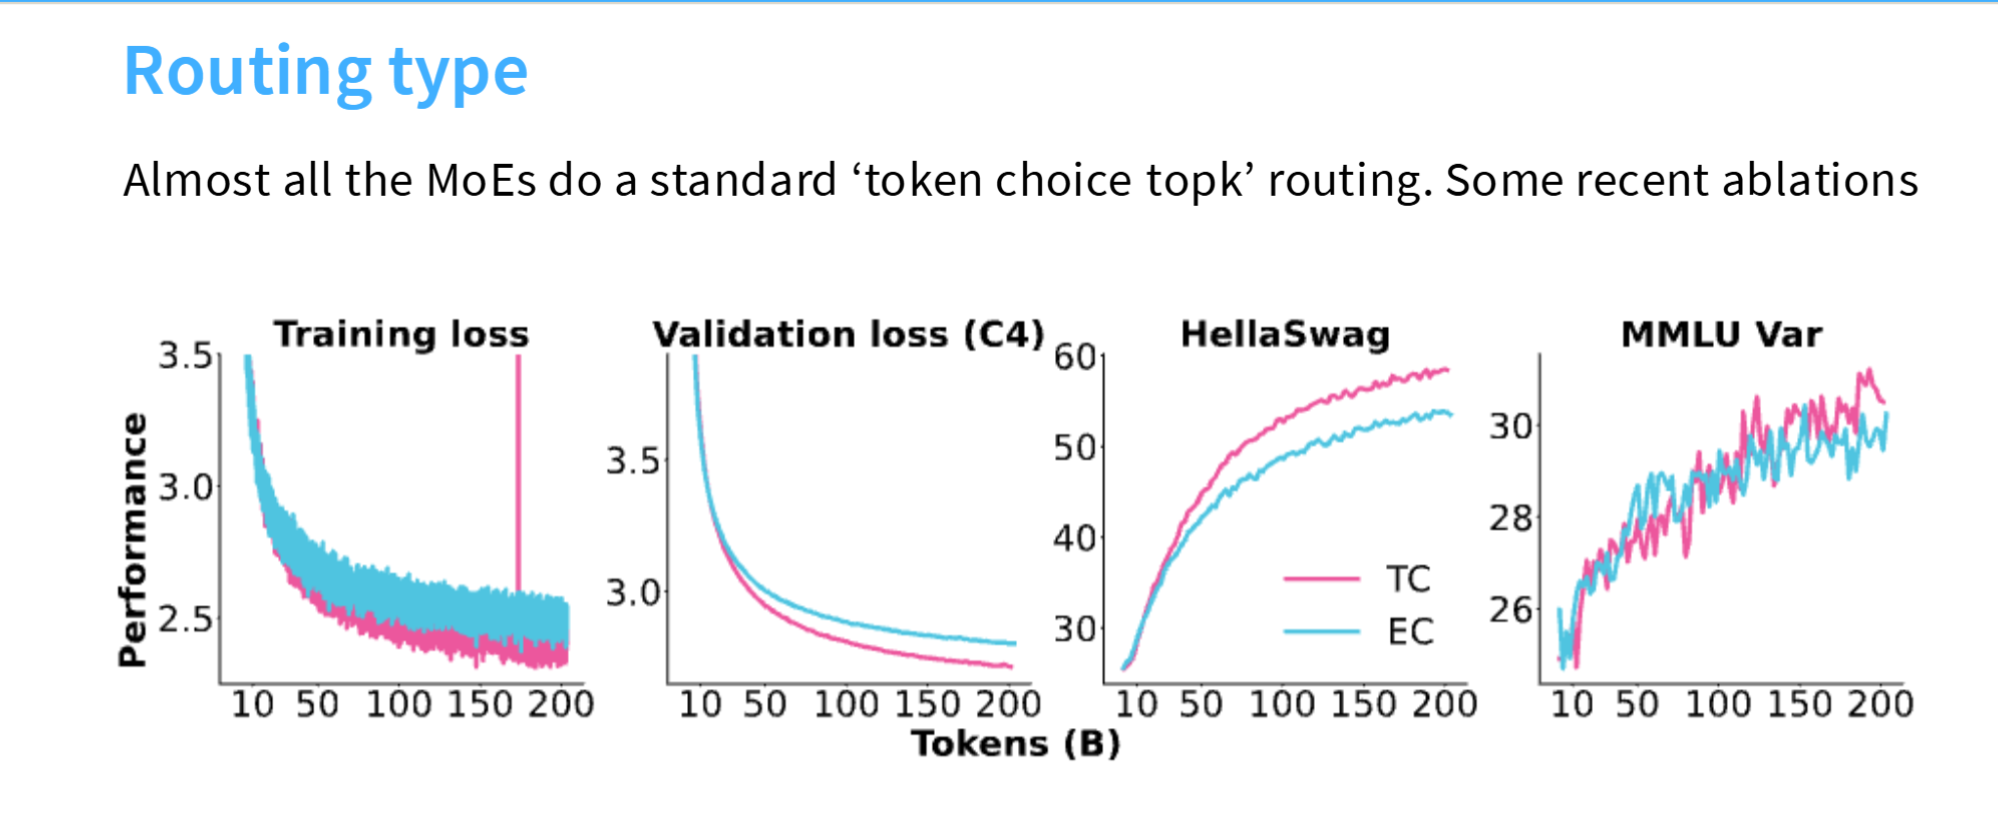
消融实验,TC,EC分别是给token路由,以及给专家路由,可以发现给token路由明显更好,这也是前面提到的每个token选topk的专家是主流的原因
几种路由
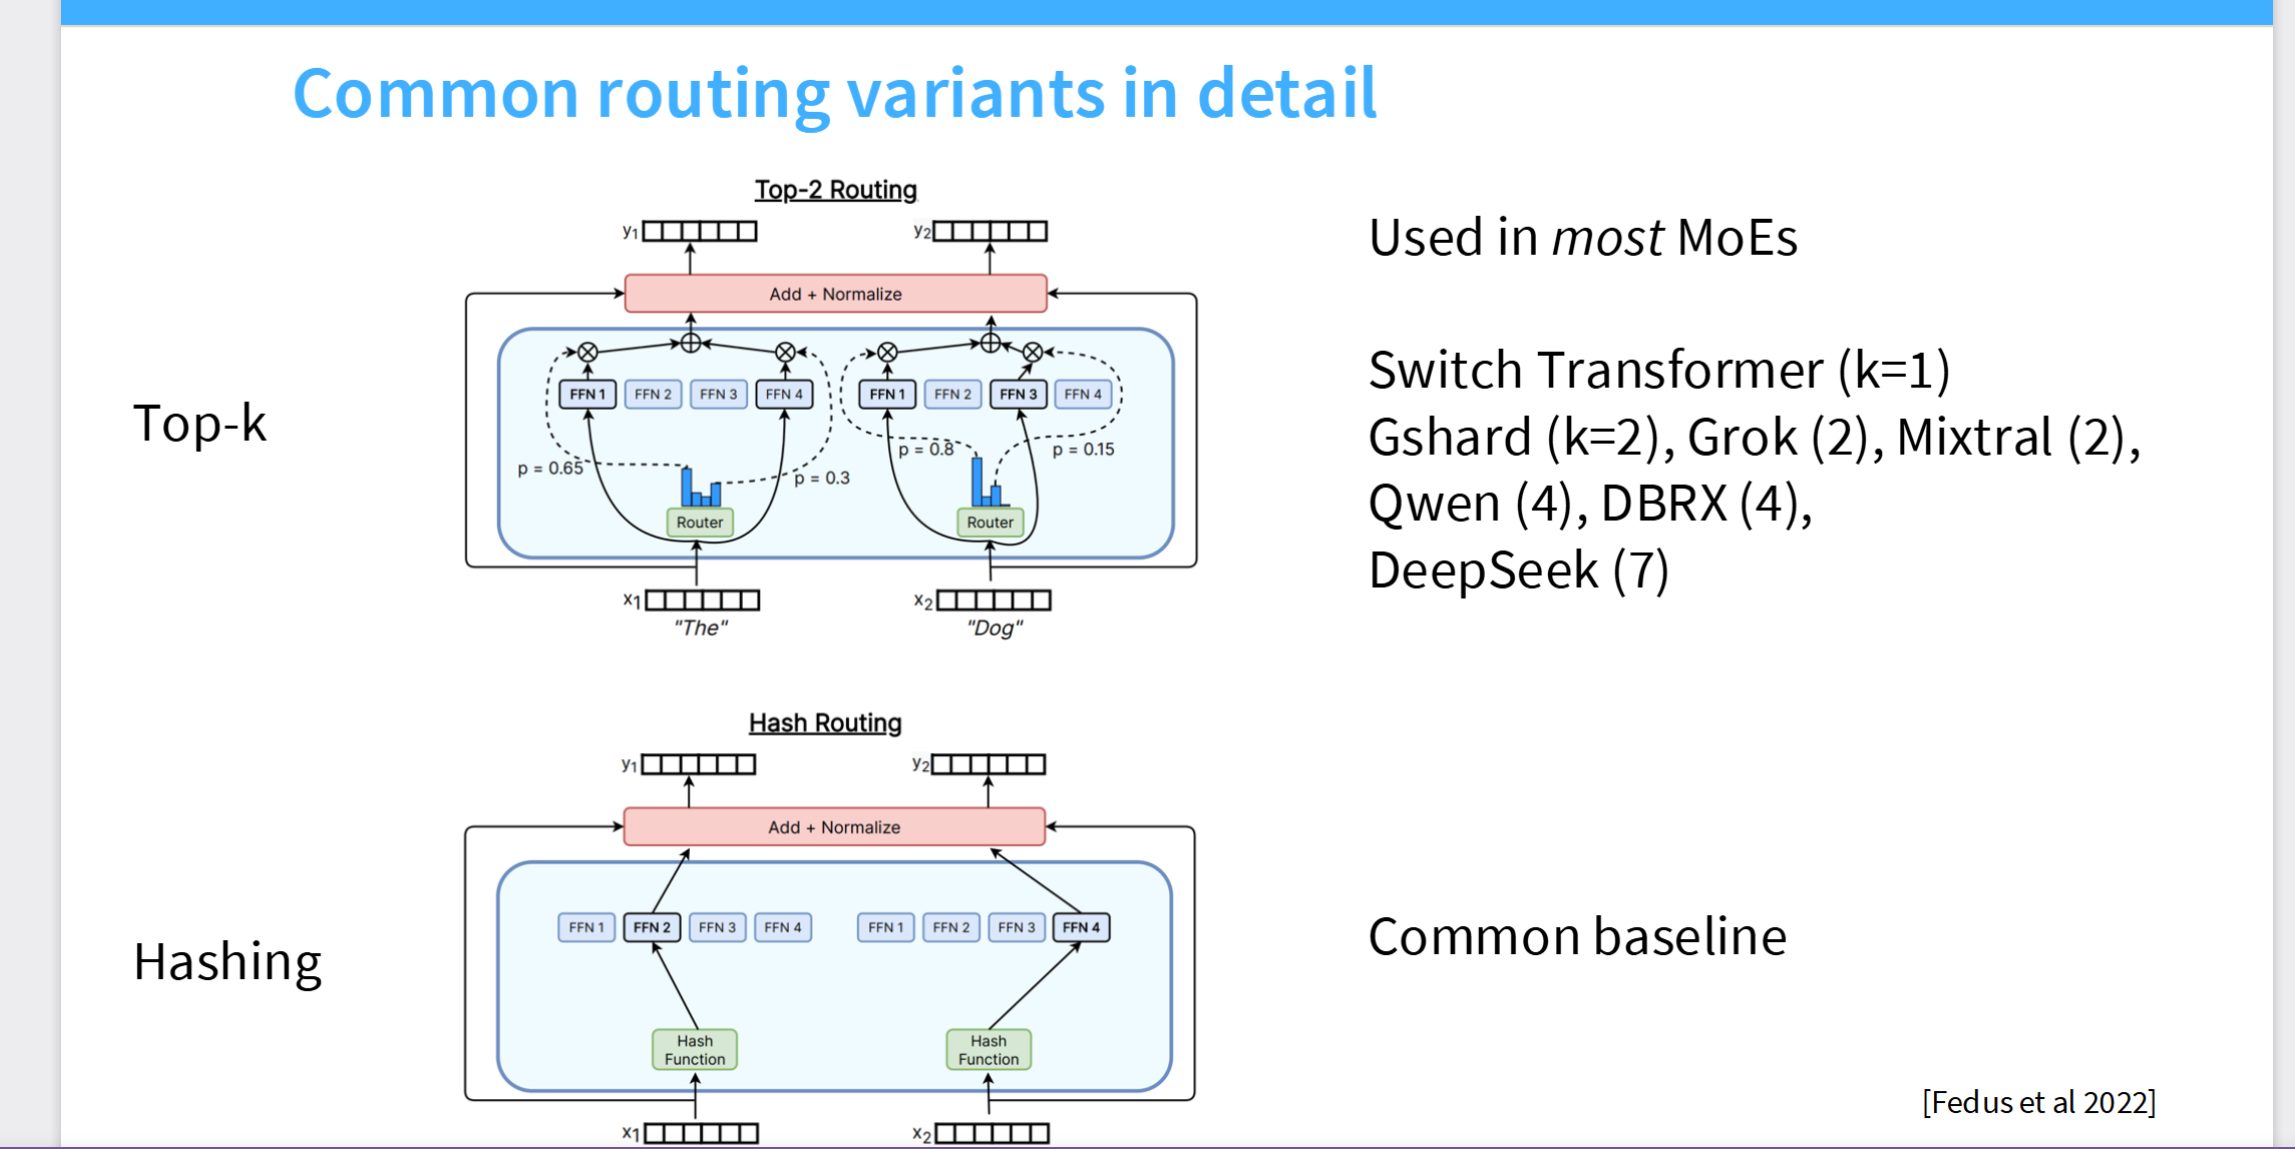
topk路由一般选哈希路由作为baseline进行对比。哈希路由是通过一个哈希函数,把token映射到专家,好处是计算量小,路由快,而且一般好的哈希函数,能天然保证负载均衡,也就是各个桶的元素是均匀的,因为哈希函数要尽量避免哈希碰撞。但缺点是这个路由没有考虑每个token的含义适合分给哪个token,是纯随机的,但因此正好适合作为baseline,检验topk的效果。
上面topk右侧标的模型和(),意思是这些主流MoE模型的激活专家个数,Deepseek是最多的,7个
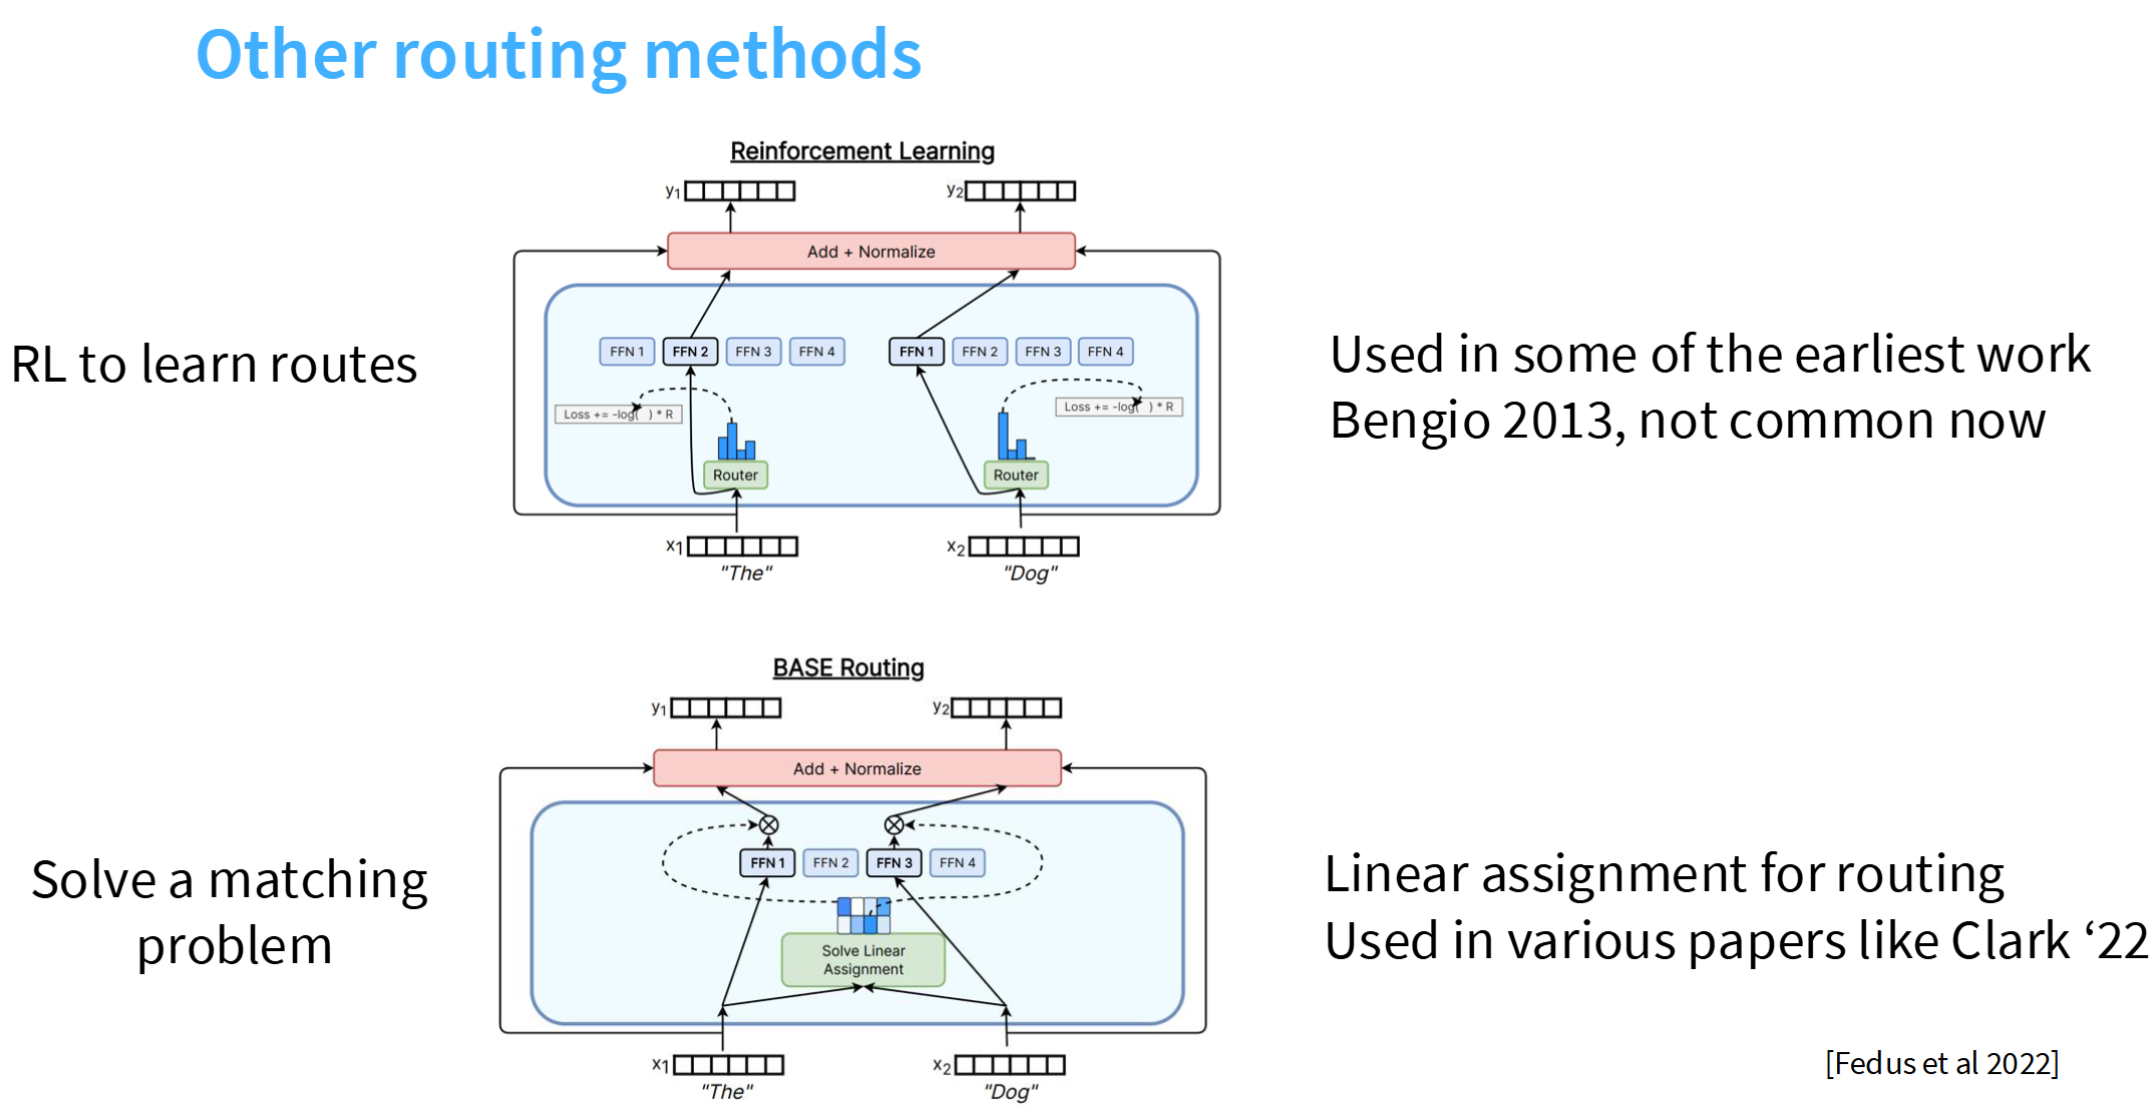
还有一些路由方式,上方图展示的是基于强化学习的路由,训练一个强化学习模型,使用交叉熵损失函数。但RL效果不好,且训练收敛很慢,现在不常用
下图的方案是,把路由问题建模成一个二分图匹配问题,这是经典算法问题,每个token和每个专家都有一个匹配得分,作为边权,现在要给每个token匹配到k个专家,使得所有匹配的边权之和最大。可以用网络流解决。这是数学意义上的全局最优解,但是一是计算复杂度更高,更致命的是网络流这种线性规划算法,不适合利用GPU并行化,这会导致路由阶段成为推理吞吐的瓶颈。
所以,综合来看,topk计算代价低,并且能取得较好的路由效果,是综合来看的最优解。
topk路由公式
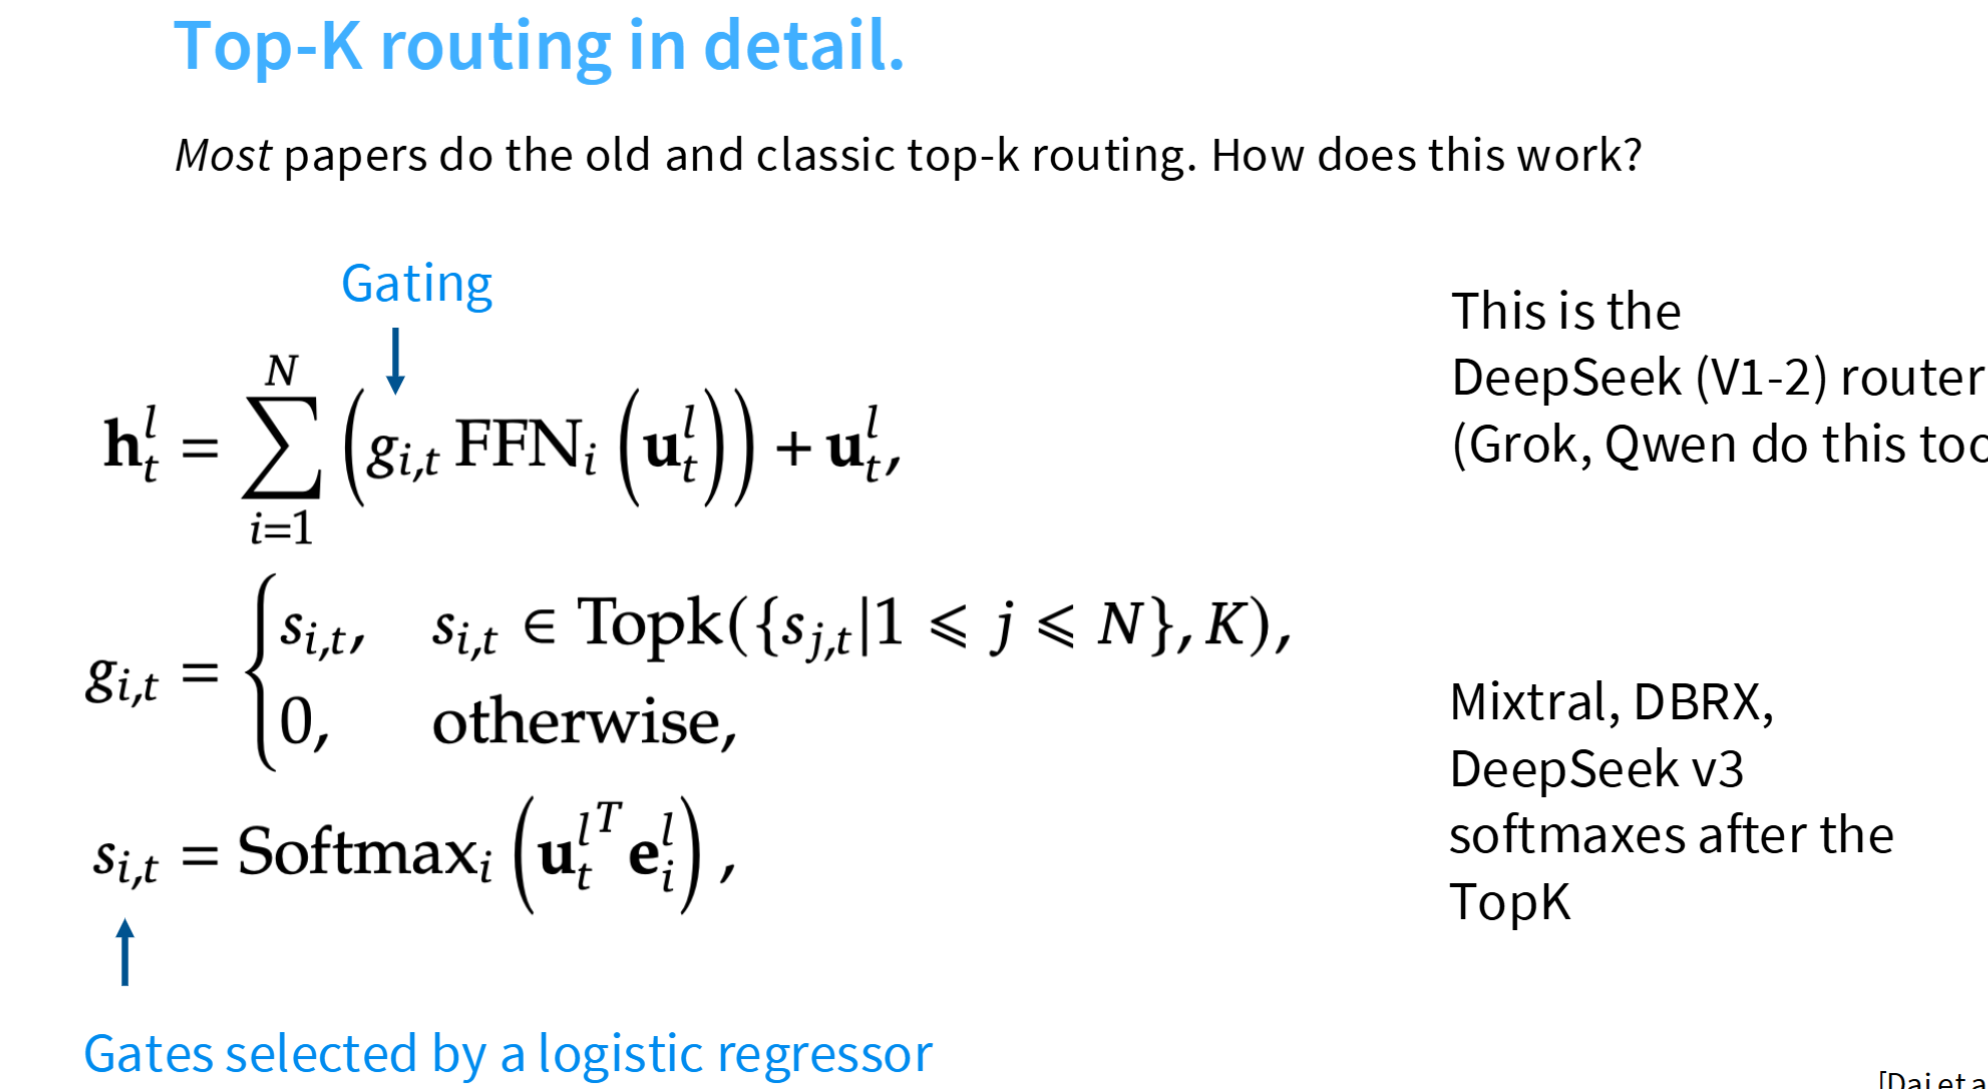
topk的具体公式如上,s是给每个token,匹配上每个专家的打分,对这个得分做topk得到g,g的映射是,如果s在topk里则保持不变,否则置零。最后用g来乘上FFN的前向传播结果,如果这个专家不在topk里,g等于0,等价于不选这个专家,这样实现可以避免ifelse,是适合GPU高吞吐的做法。
Deepseek MoE
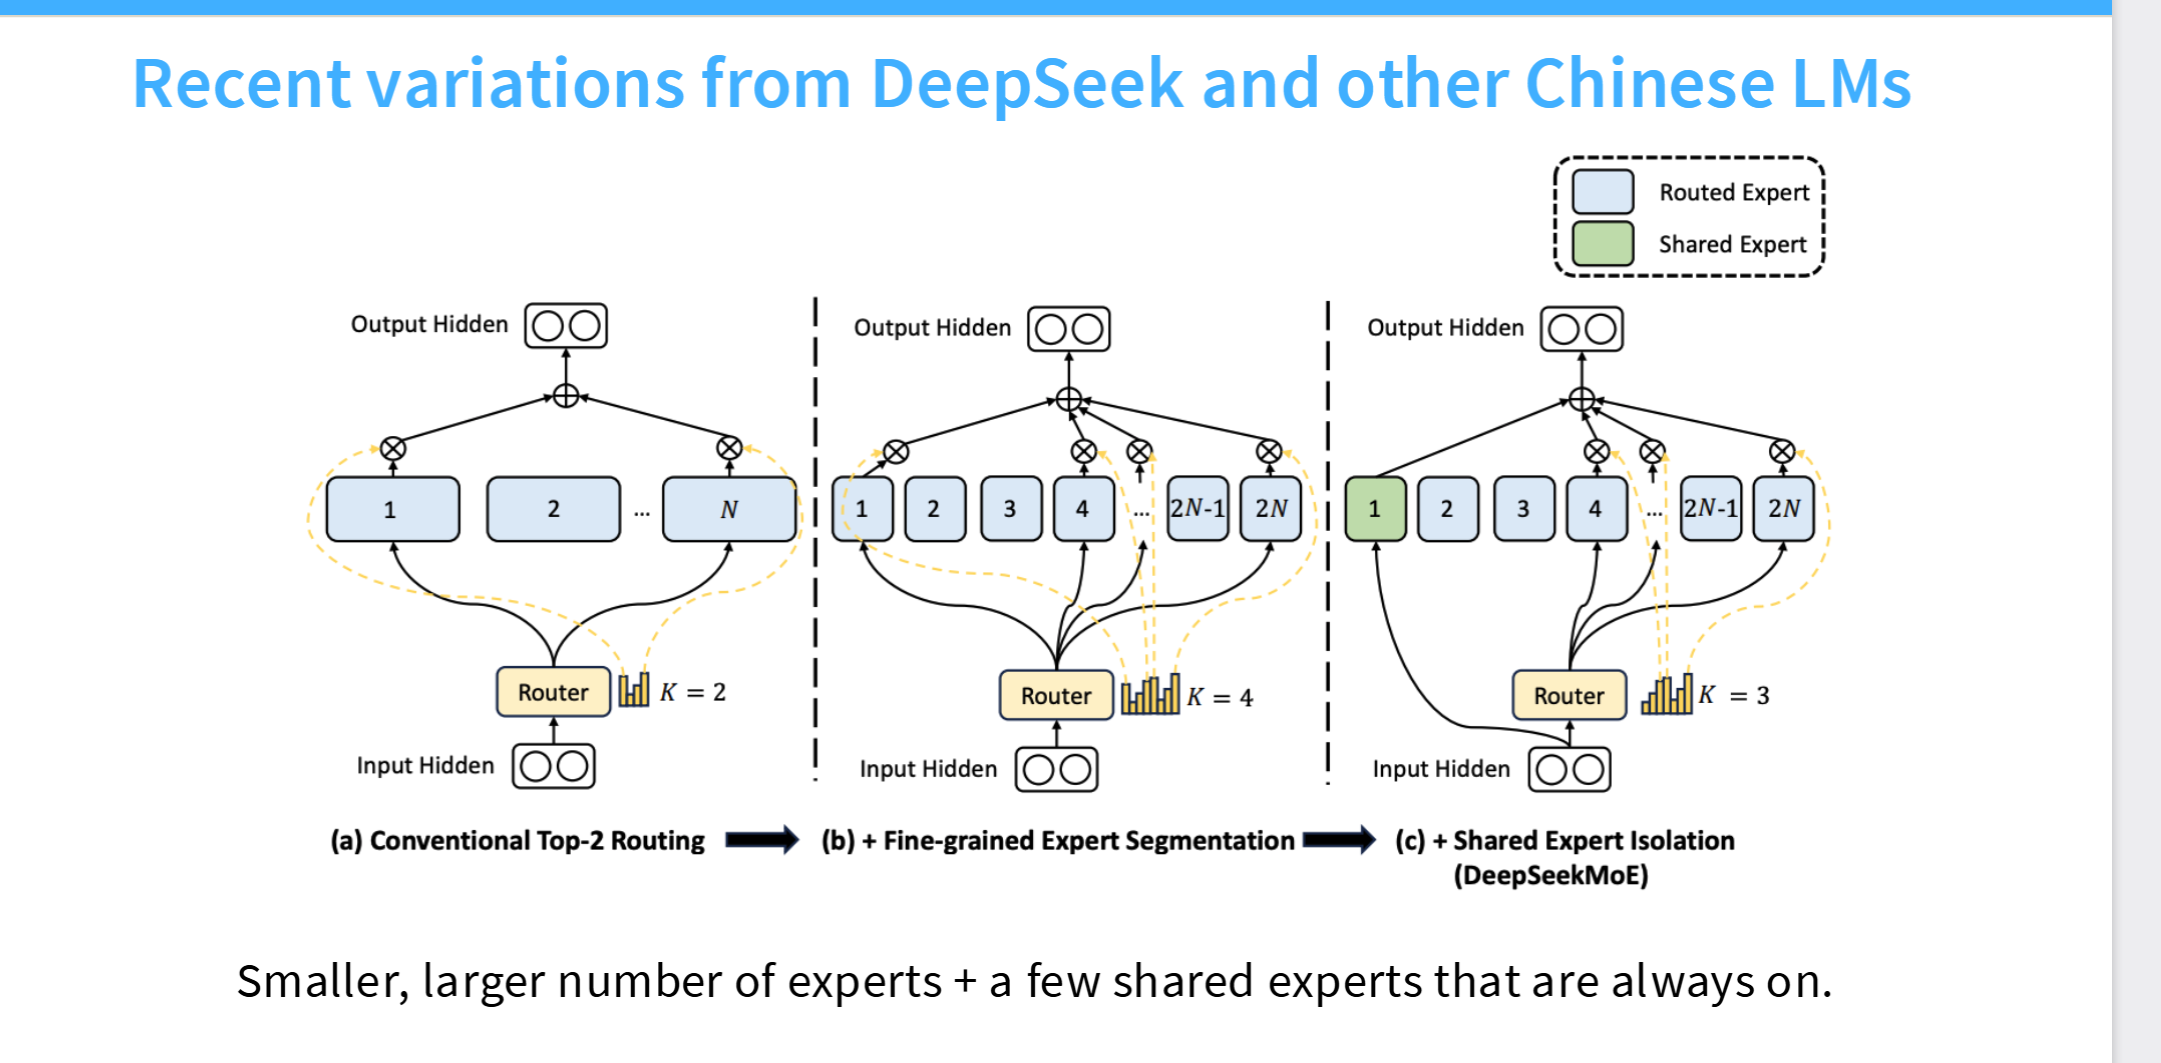
DS对传统MoE的改进有两点,一是更细粒度的专家,也就是拆成更多,更小的FFN,这样每个专家更专精。而是设一个共享专家,每次都使用
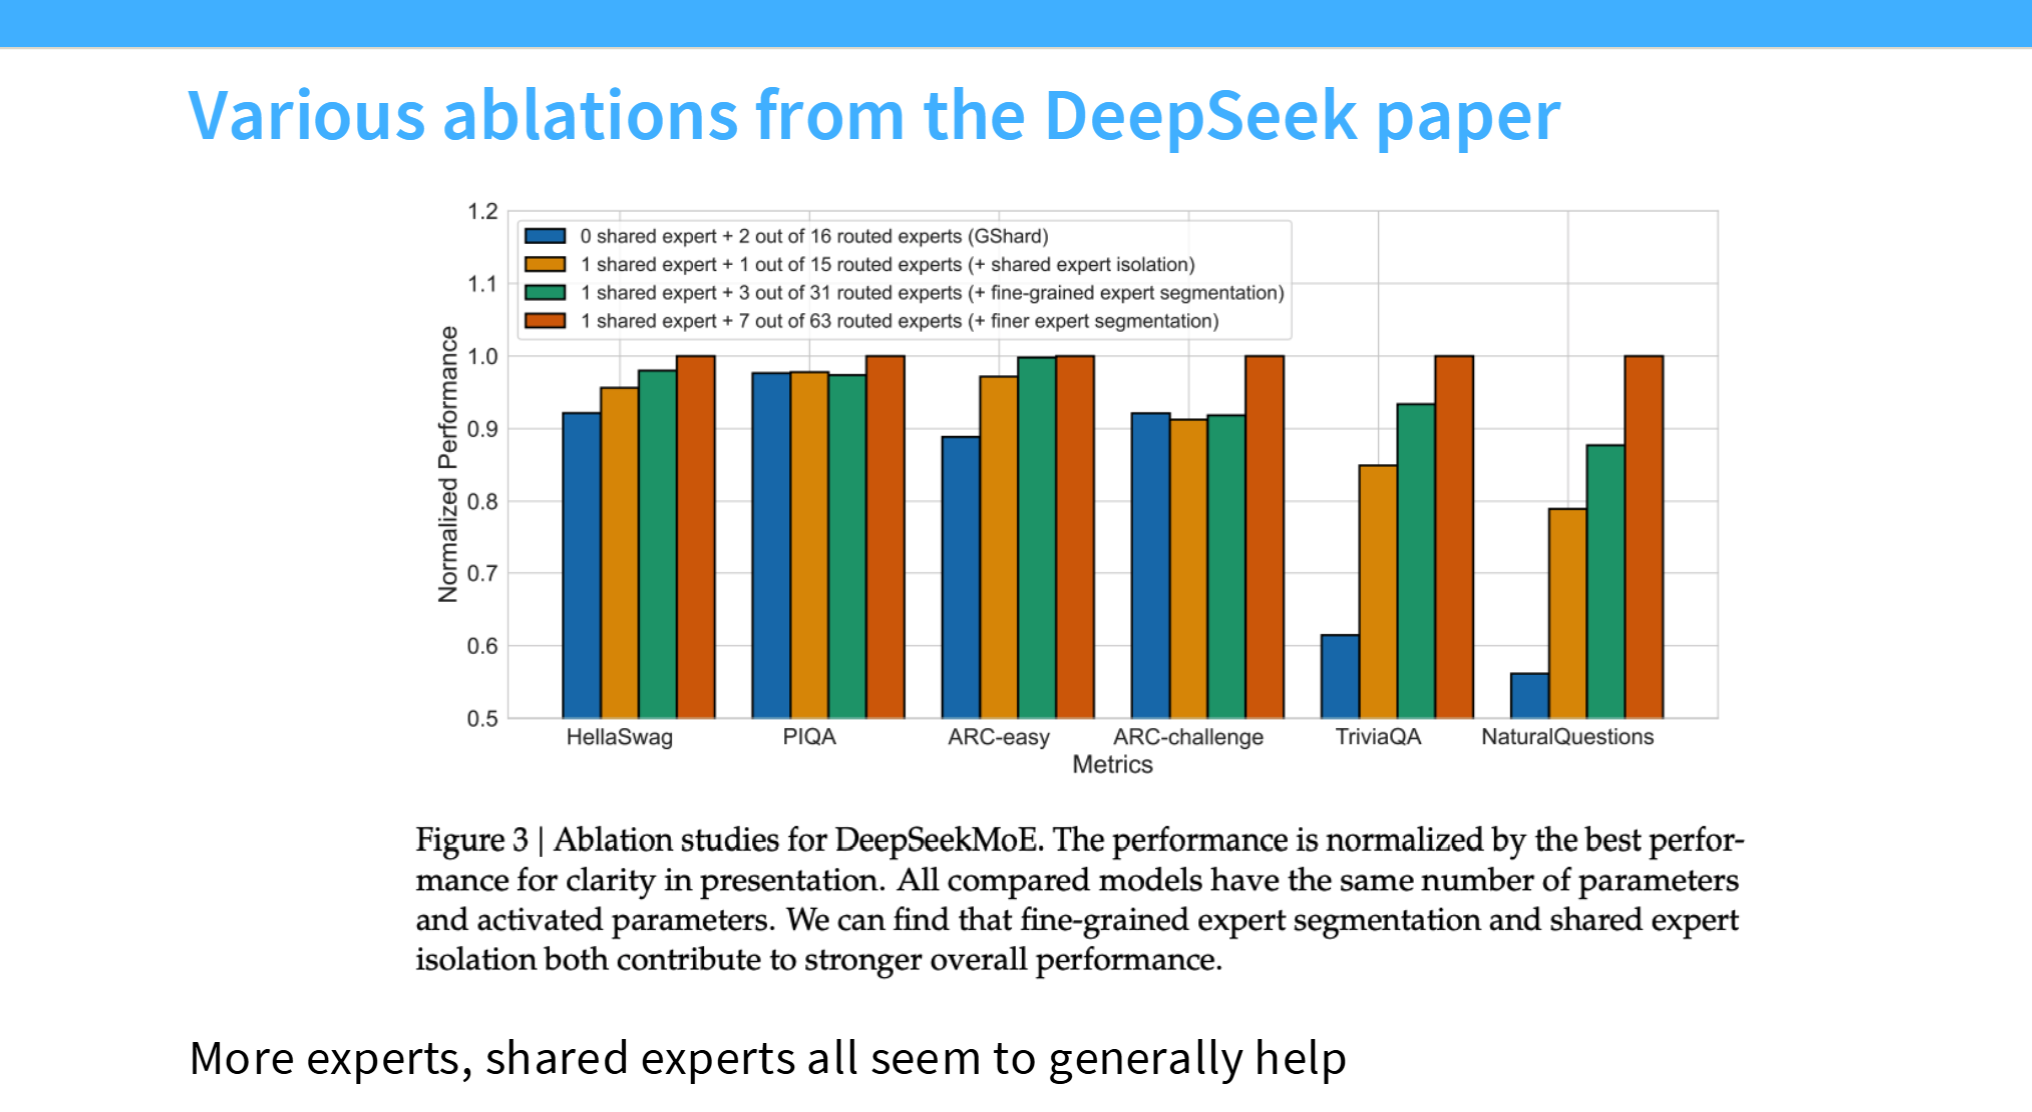
消融实验,对比可以发现增加共享专家,和细粒度划分都是有帮助的
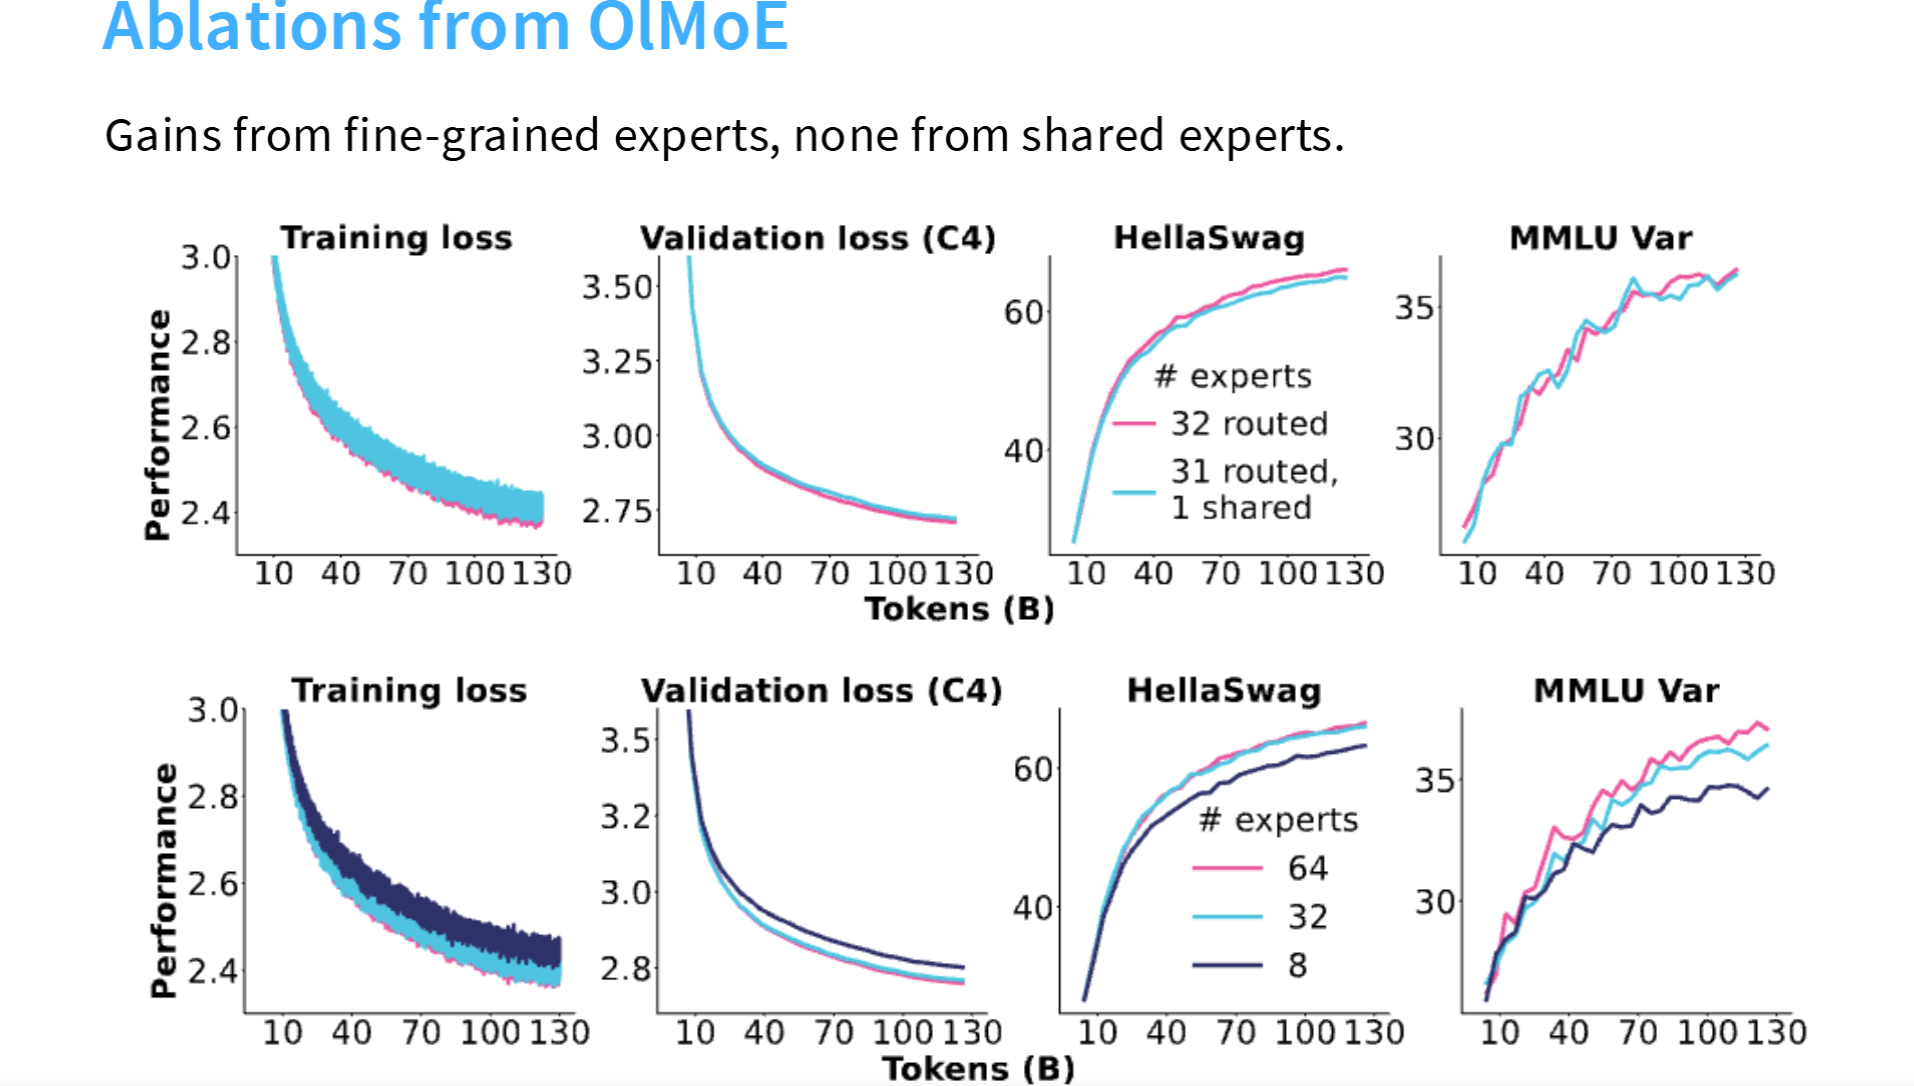
也有其他人的实验指出,收益来自细粒度专家,而不是共享专家,这里可以看到共享专家在大多数的情况下都没有更优,而增加专家个数明显更优。
专家激活比
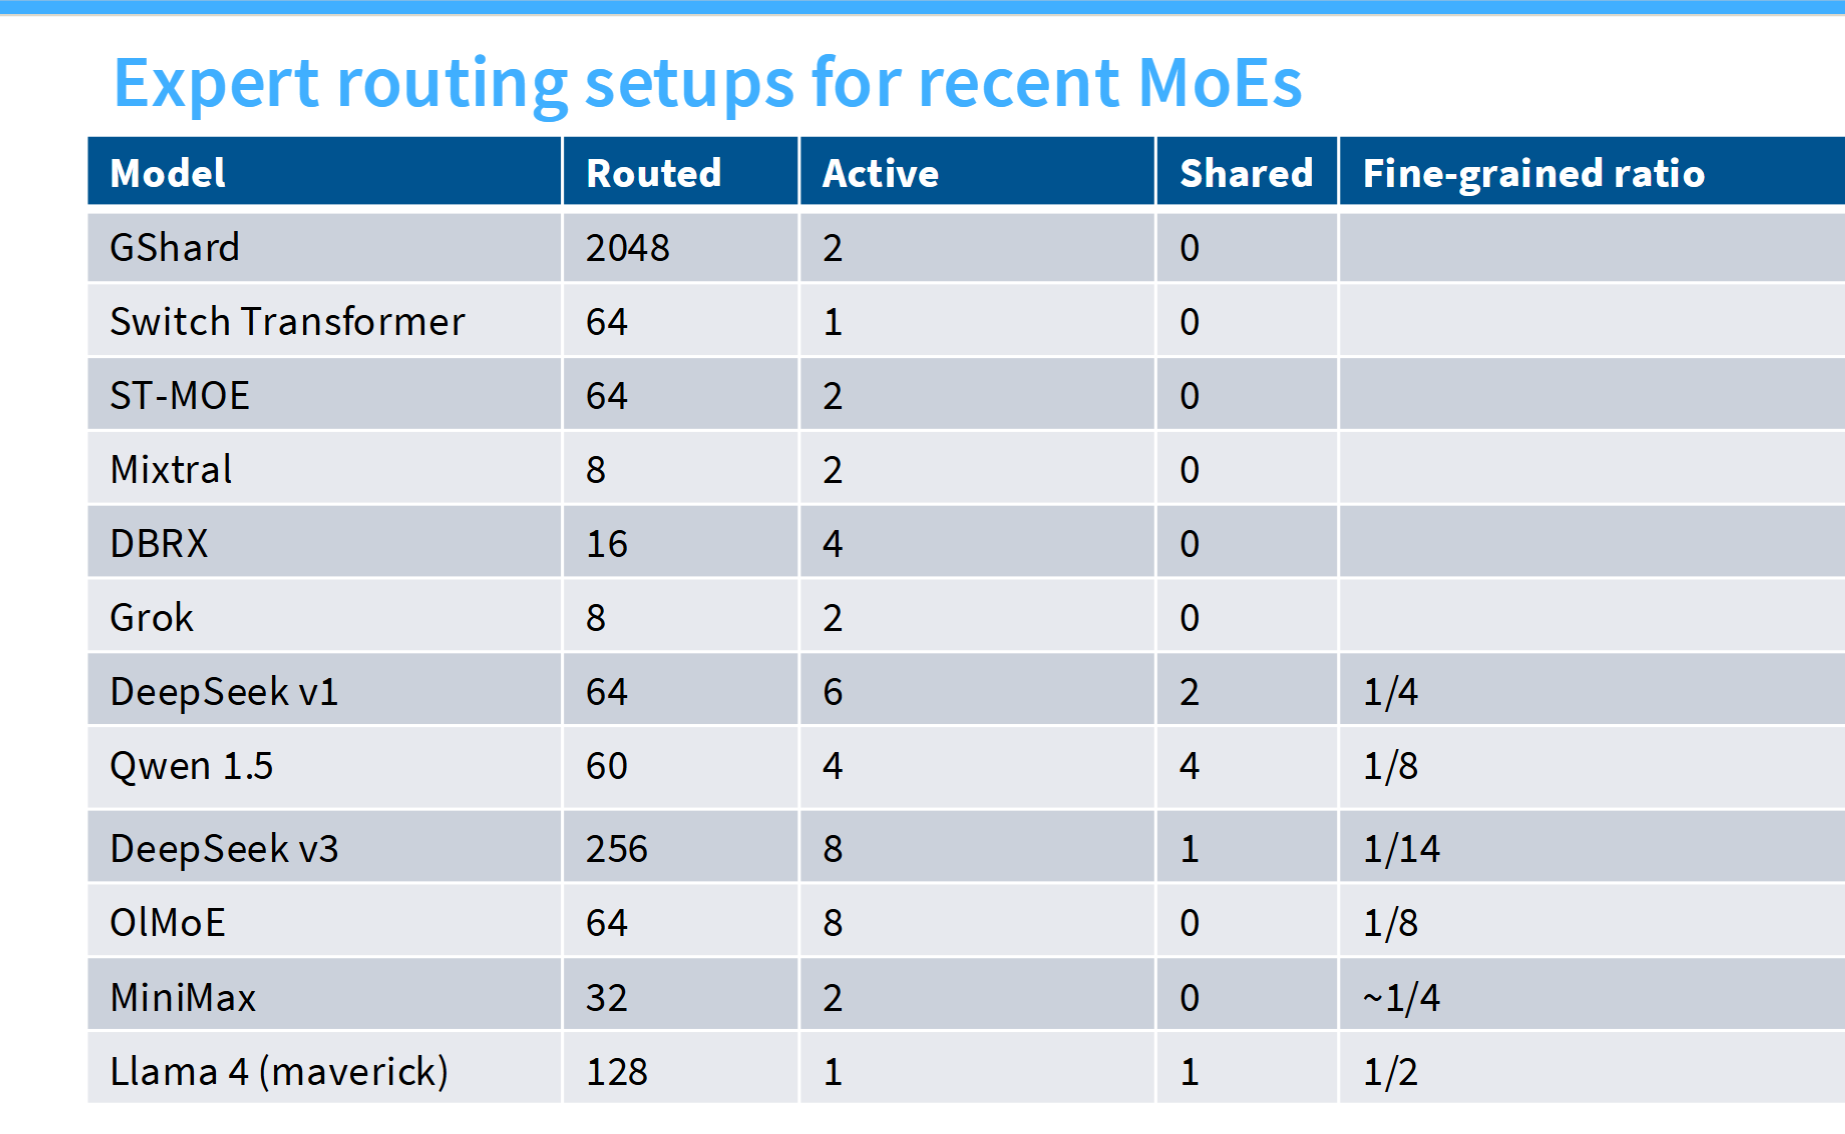
常见的模型激活专家个数/专家总数都在1/4-1/8左右