Anthropic 于 10 月 7 日发布 Claude Haiku 5.5。prompt 在 10 万 token 以内时,输入价格为每百万 token 0.10,输出0.50,均为 Haiku 4.5 的十分之一;上下文窗口从 20 万扩到 100 万,最大输出从 64K 扩到 128K,并改用 adaptive thinking 加 effort 参数控制思考深度。同时,它带来了 5 项 API 破坏性变更,temperature、assistant prefill、budget_tokens 这些旧写法会直接报错。在 Claude Code 里,haiku 别名在 Anthropic API 上已经指向 Haiku 5.5,但需要 v2.1.293 及以上版本。本文依次讲价格结构、Claude Code 里的用法和 API 迁移。
这次发布最值得关注的不是单价,而是价格表里的 10 万 token 门槛。按官方价格页,Claude 4.6 之后的模型里只有 Haiku 5.5 按 prompt 长度分档计价:超过 10 万 token,输入、输出、缓存读写全部乘以 5。
这个门槛决定了它适合放在哪里。prompt 在 10 万以内时,它的输入价格是 Sonnet 5.5 的 1/20;超过 10 万后,差距缩到 1/4,缓存读取只剩 1/2。Claude Code 的主会话每次请求都会带上完整对话历史,长会话很容易越过这条线;而 subagent 从空白上下文启动,只做检索或汇总,起点是 0,离这条线比主会话远得多。
所以 Haiku 5.5 的合理位置是短上下文的工作单元:分类、抽取、路由,以及 Claude Code 里的 subagent。把它当作长会话的主模型来省钱,实际节省会远小于价格表上的十倍。
每百万 token $0.10 与官方「省 75%」口径
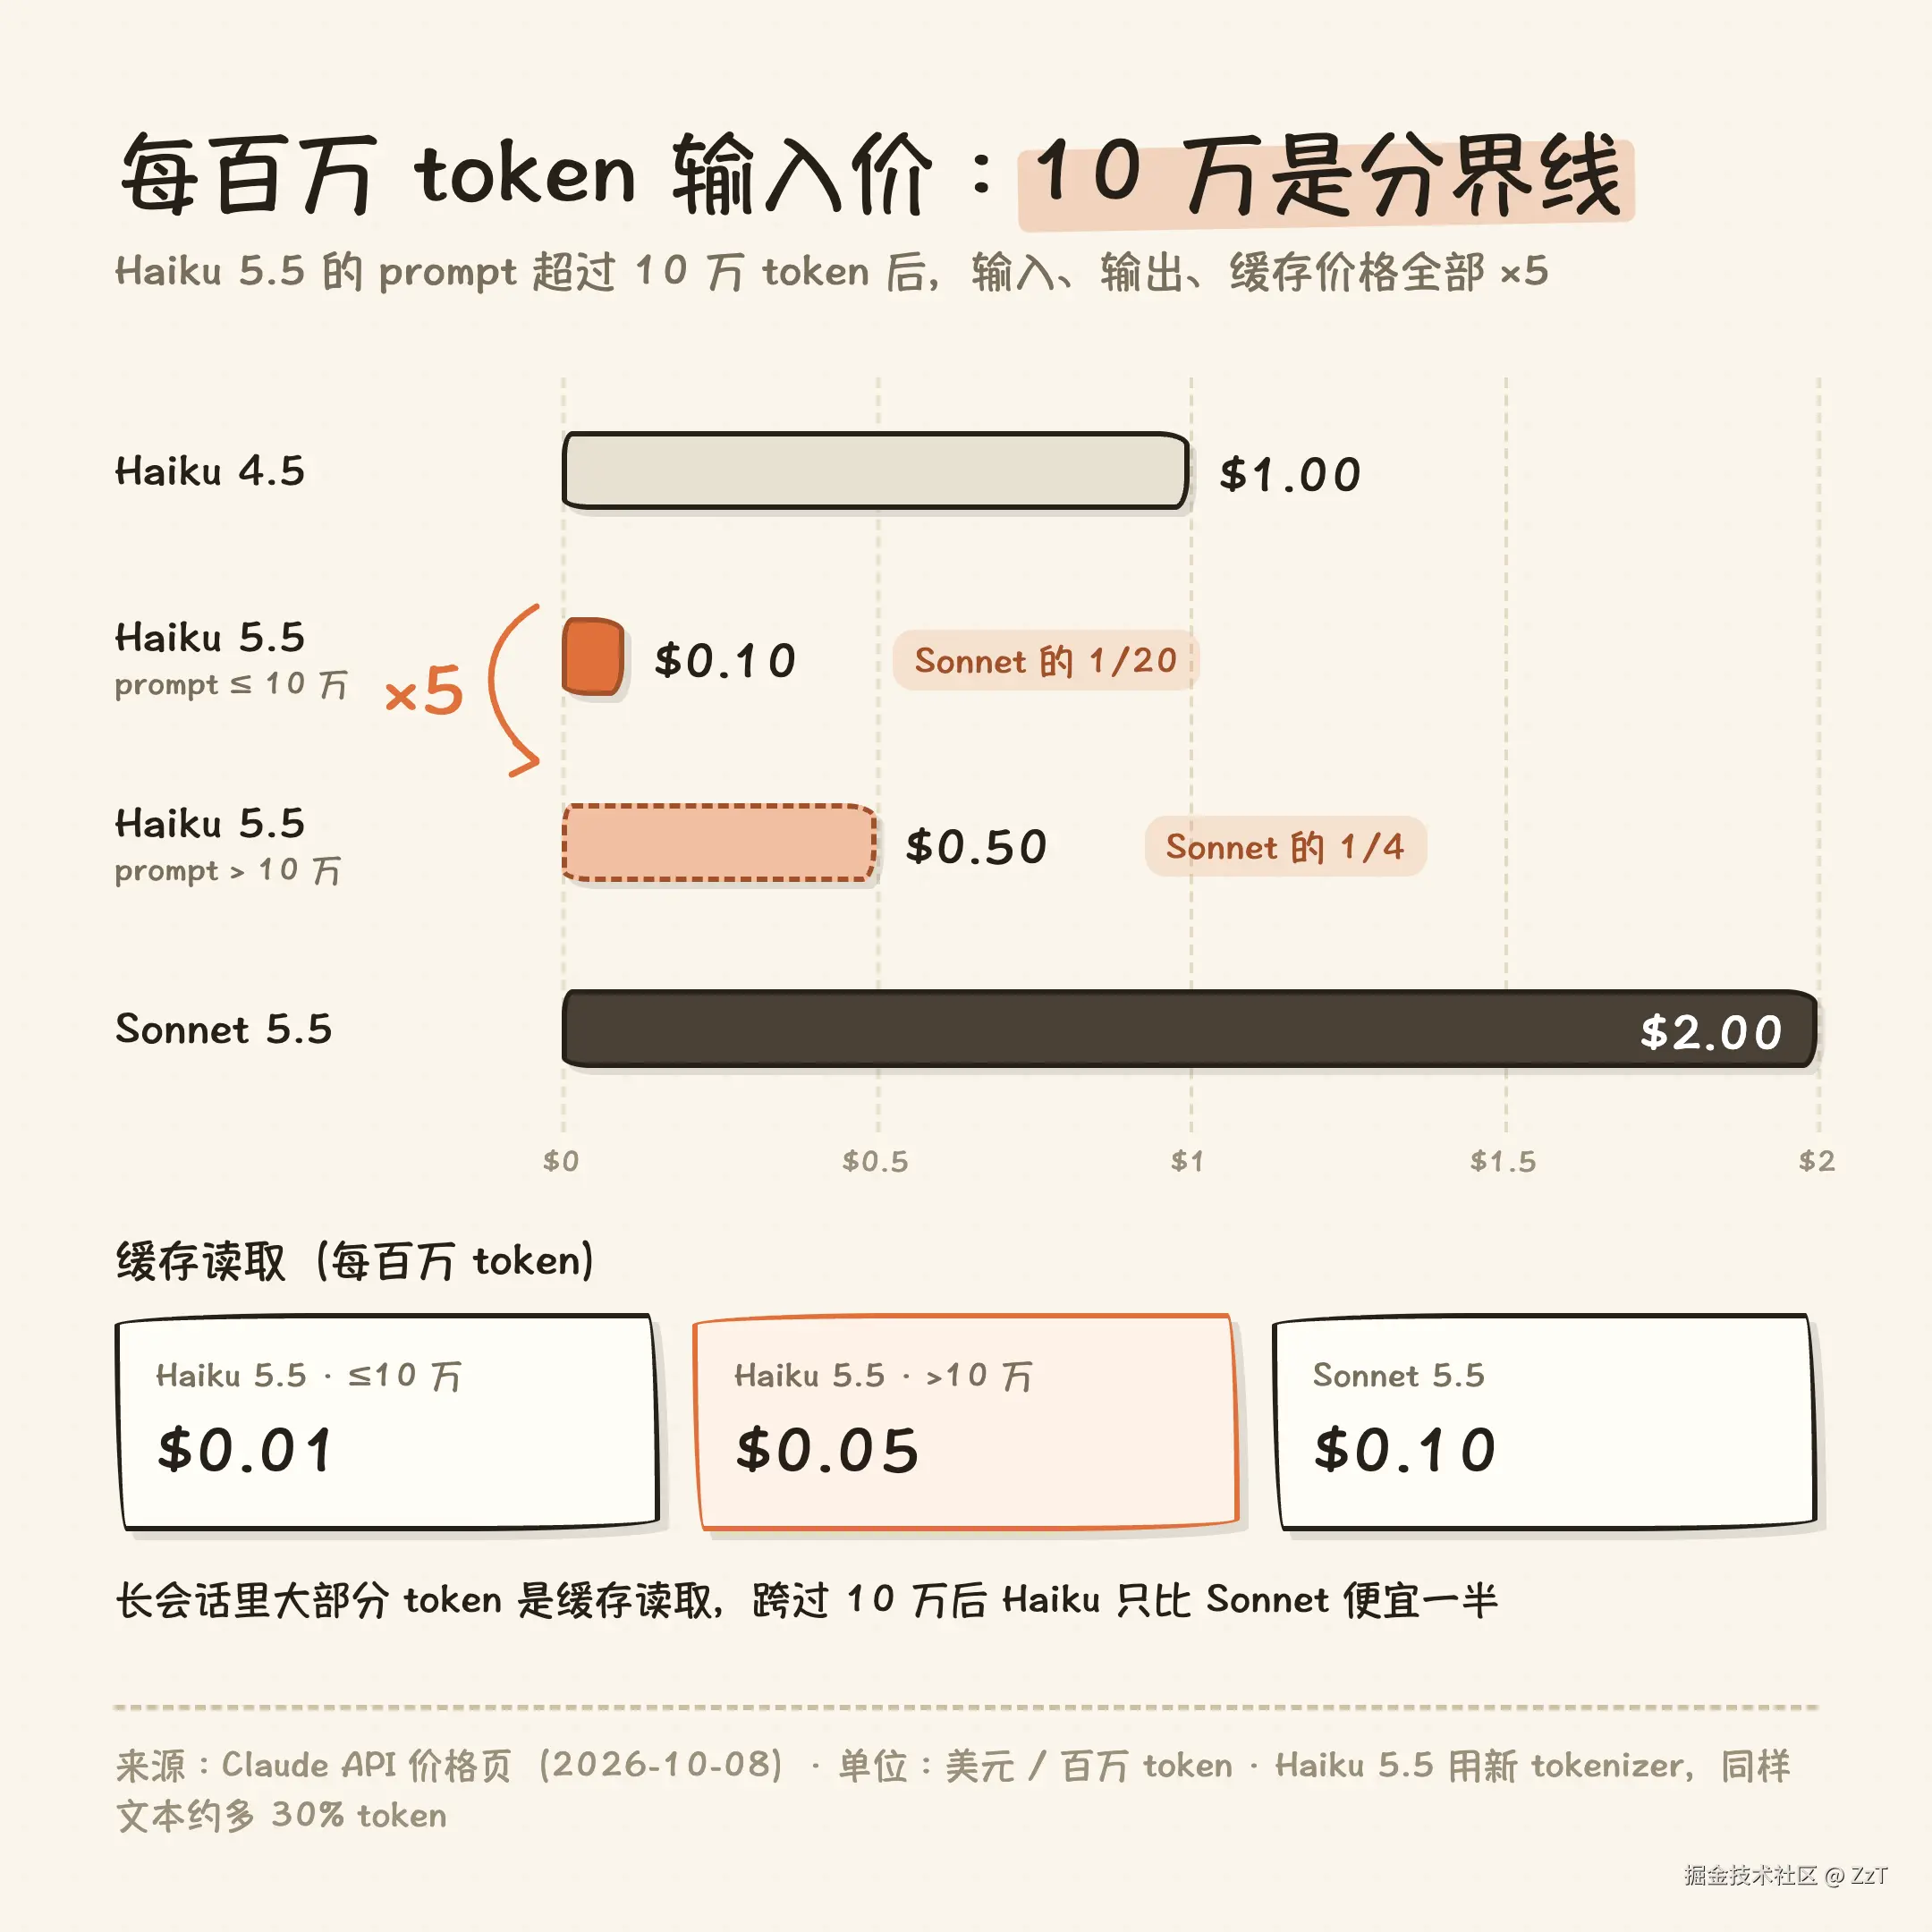
价格对比如下(每百万 token,美元):
| 模型 | 输入 | 输出 | 缓存读取 |
|---|---|---|---|
| Haiku 4.5 | 1 | 5 | 0.10 |
| Haiku 5.5(prompt ≤ 10 万) | 0.10 | 0.50 | 0.01 |
| Haiku 5.5(prompt > 10 万) | 0.50 | 2.50 | 0.05 |
| Sonnet 5.5 | 2 | 10 | 0.10 |
单价降了 90%,但发布页给出的整体口径是运行成本降低 75%,10 万以内的请求降低 90%。发布页没有说明 75% 的计算方式。文档里有两项事实会让实际账单的降幅小于单价降幅:
- tokenizer 换代:Haiku 5.5 使用 Claude 4.7 之后的新 tokenizer,同样的文本比 Haiku 4.5 多出约 30% 的 token。
- adaptive thinking 默认开启:思考 token 按输出计费。在 Claude Code 里,Haiku 5.5 的思考无法关闭,只能通过 effort 调低。
按 tokenizer 这一项折算,同一段文本的输入成本约为 Haiku 4.5 的 13%,而不是 10%。
Batch API 仍然打五折,10 万以内的 Haiku 5.5 批处理输入价格为每百万 token $0.05。
在 Claude Code 里的三种用法
先确认版本:官方文档写明 Haiku 5.5 需要 Claude Code v2.1.293 及以上,低于这个版本需要先升级。
1. 切换主会话模型。 在会话里执行 /model claude-haiku-5-5,或者启动时用 claude --model claude-haiku-5-5。在 Anthropic API 上,所有套餐都直接使用 100 万上下文,不需要加 [1m] 后缀。按上一节的分析,这种用法只适合短任务。
2. 给 subagent 指定 Haiku。 这是收益最大的用法。在 subagent 定义的 frontmatter 里写:
yaml
---
name: repo-scout
description: 只读检索代码库,返回文件位置和摘要
tools: Read, Grep, Glob
model: haiku
effort: low
---
Claude Code 按以下顺序决定 subagent 用哪个模型:调用时传入的 model 参数 → frontmatter 的 model 字段 → 环境变量 CLAUDE_CODE_SUBAGENT_MODEL → 主会话模型。
需要注意,内置的 Explore subagent 默认跟随主会话的模型,并不会自动换成 Haiku。想让检索类任务跑在 Haiku 上,最直接的做法是自定义一个 model: haiku 的只读 subagent。
3. 调 effort。 Haiku 5.5 支持 low、medium、high、xhigh、max 五档,默认 medium。检索和汇总这类任务用 low 即可。effort 可以写在 subagent 的 frontmatter 里,也可以在会话中用 /effort 调整。
另一个限制是 haiku 别名只在 Anthropic API 上指向 Haiku 5.5。在 Amazon Bedrock、Google Cloud、Microsoft Foundry 和 Claude Platform on AWS 上,这个别名仍然指向 Haiku 4.5。这些平台的用户需要用环境变量 ANTHROPIC_DEFAULT_HAIKU_MODEL 显式指定模型。
API 迁移中的 5 项破坏性变更
如果你在业务代码里直接调用 Haiku,迁移前要逐项检查官方列出的 5 项破坏性变更:
| 变更 | 改法 |
|---|---|
temperature、top_p、top_k 设为非默认值时返回 400 |
删掉这三个参数 |
| assistant prefill 返回错误 | messages 必须以 user 消息结尾 |
手动 budget_tokens 返回错误 |
改用 adaptive thinking 加 effort |
computer use 旧工具 computer_20250124 不再可用 |
换成 computer_toolset_20260801 |
| 修改历史轮次会让 thinking block 失效 | 回传 thinking block 时,对话只能追加不能改 |
前两项对分类、抽取类代码的冲击最直接。很多管道靠 temperature: 0 求稳定输出,靠 prefill 一个 { 强制模型输出 JSON,这两种写法在 Haiku 5.5 上都会报错。
另有三项行为变化,不会报错,但会让旧代码悄悄出错:
- 响应可能以 thinking block 开头,读取「第一个 content block」当答案的代码要改成按
type字段筛选。 - 安全分类器可能拒绝请求,客户端需要处理
stop_reason: "refusal"。 max_tokens现在包含思考 token。设得过小时,模型可能刚写完 thinking 就被截断,正文为空。
适用场景
| 场景 | 建议 |
|---|---|
| 分类、抽取、路由,prompt 在 10 万以内 | 直接换用,先处理上面 5 项破坏性变更 |
| Claude Code 里的检索、汇总类 subagent | 自定义 subagent,写 model: haiku 加 effort: low |
| Claude Code 长会话的主模型 | 继续用 Sonnet 或 Opus;超过 10 万 token 后 Haiku 的输入价只剩 Sonnet 的 1/4,缓存读取剩 1/2 |
| Bedrock、Google Cloud、Foundry 用户 | haiku 别名仍指向 4.5,用 ANTHROPIC_DEFAULT_HAIKU_MODEL 指定 |
发布页列出的基准成绩包括 Terminal-Bench 4.0 得分 39.2%、OSWorld 2.1 离线子集 72.4%,目前还没有独立评测。对 Claude Code 用户来说,决定能省多少钱的是任务的上下文长度,而不是这些分数。